Przykład: sofy, narożniki i pięciu dostawców tkanin i pianki
Fikcyjny producent mebli tapicerowanych kupuje tkaniny u trzech dostawców (A, B, E), a piankę u dwóch (C, D). Z dwóch lat (listopad 2024 – październik 2026) ma 2500 zamówień: dostawcę, datę, wartość (tys. zł), termin z oferty, termin po ewentualnym przesunięciu i datę dostawy. Kierownik zaopatrzenia pyta: który dostawca tkanin jest pewniejszy – A czy B – i ile tkaniny trzymać na zapas?
Czas realizacji (dni od zamówienia do dostawy) to typowy temat pracy z zaopatrzenia – inne projekty opisuje wpis statystyka w pracy z logistyki. Dostawców porównamy na medianie i 90. centylu regresją kwantylową; procedurę na innym przykładzie opisuje wpis regresja kwantylowa krok po kroku.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każdy dostawca ma „zwykły” czas realizacji (A – 13 dni, B – 10) i szansę opóźnienia (A – 7%, B – 28%), częstszego przy dużych zamówieniach i jesienią, w szczycie sezonu meblowego. Dostawca B obiecuje 14 dni, ale gdy dostawa się spóźnia, w 60% przypadków przesuwa termin. Dostawca D od listopada 2025 r. spóźnia się rzadziej (8% zamiast 25%). Pełna lista parametrów jest przy kodzie. Dane pobierzesz jako czas-realizacji-dostawy-meble.csv. W dniu analizy (10 listopada 2026 r.) 2473 zamówienia były dostarczone, a 27 – w toku (rysunek 6).
Rysunek 1: przy skośnym czasie realizacji średnia myli
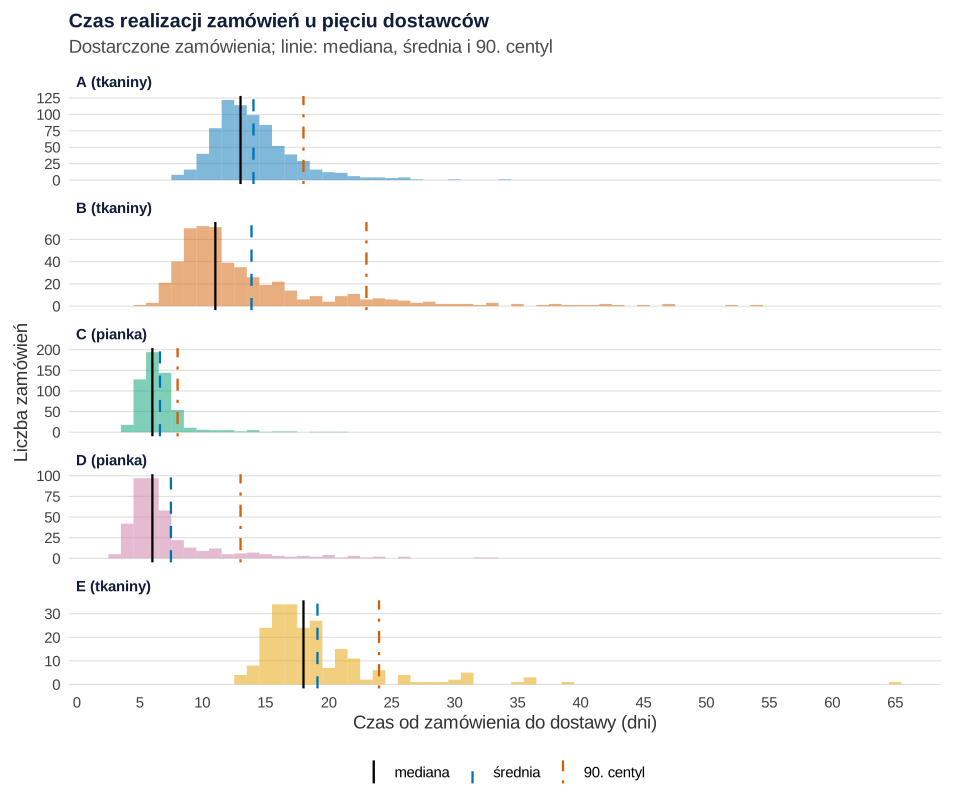
set.seed(760)).Co widać. Wszystkie rozkłady są prawoskośne. Średni czas realizacji tkanin u A i B jest prawie taki sam: 14.03 i 13.87 dnia. Mediana jest lepsza u B (11 vs 13 dni), ale 90. centyl – wyraźnie gorszy (23 vs 18 dni). SD u B jest ponad dwa razy większe (7.33 vs 3.28).
Jak może zmylić. Ranking według średniej uznałby A i B za równych: u B szybsza typowa dostawa i rzadkie długie opóźnienia się znoszą. A szwalnię zatrzymuje właśnie ogon.
Podpis do pracy:
Rysunek 2: ta sama średnia, inny ogon
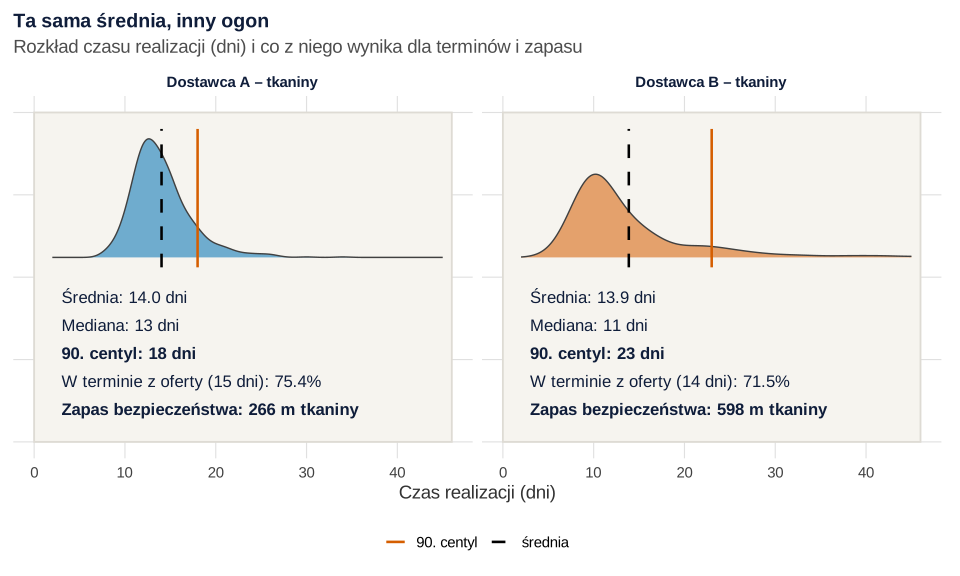
Co widać. Linia średniej stoi u obu dostawców w tym samym miejscu. U B szczyt rozkładu jest wcześniej, ale ogon sięga dalej – i to on podwaja potrzebny zapas tkaniny (598 zamiast 266 m przy tym samym zużyciu).
Jak może zmylić. To surowe rozkłady; porównanie przy tej samej wartości i porze zamówienia daje dopiero model (rysunek 3). Terminowość i zapas omawiamy przy rysunkach 4 i 5.
Podpis do pracy:
Rysunek 3: regresja kwantylowa – dostawca, wartość zamówienia i pora roku
Regresja MNK opisuje średnią, a regresja kwantylowa – wybrany kwantyl τ (mediana: τ = .5, 90. centyl: τ = .9). Minimalizuje sumę asymetrycznie ważonych bezwzględnych reszt (Koenker i Hallock, 2001):
Odniesienie: dostawca A, 12 tys. zł, zima–wiosna. βB(0.9) to różnica 90. centyli B i A przy tej samej wartości i porze; βw – zmiana przy dwukrotnie większym zamówieniu. Przedziały liczymy bootstrapem par (1000 powtórzeń), bo klasyczne przybliżenia bywają wrażliwe na niejednakowy rozkład błędów (Kocherginsky i in., 2005), a ogony dostawców się różnią.
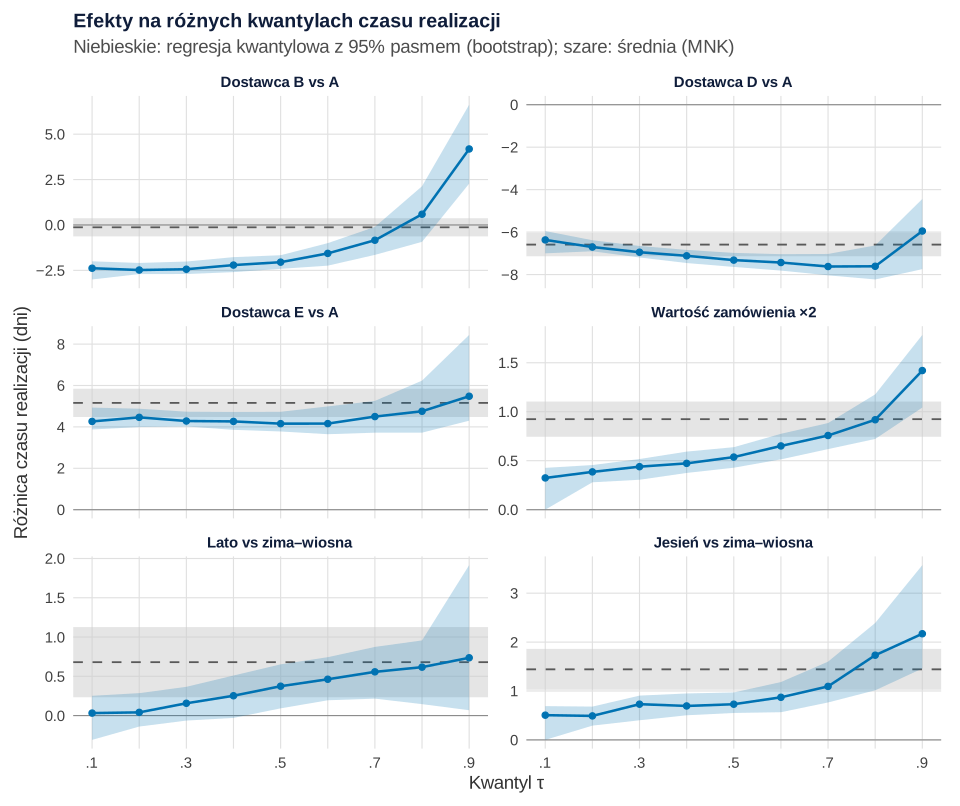
Co widać. MNK mówi: B nie różni się od A (−0.13 dnia, 95% CI [−0.63, 0.37]). Regresja kwantylowa pokazuje dwa przeciwne efekty: w medianie B jest szybszy o 2.05 dnia [−2.41, −1.66], a w 90. centylu wolniejszy o 4.18 dnia [2.28, 6.62]. Różnica tych współczynników to 6.23 dnia [4.51, 8.67]. Wartość zamówienia i jesień też działają głównie w ogonie: podwojenie wartości wydłuża medianę o 0.54, a 90. centyl o 1.42 dnia; jesień – o 0.73 i 2.17 dnia. E jest wolniejszy o 4.2–5.5 dnia na całym rozkładzie – tu średnia wystarcza. Taki wykres współczynników w funkcji τ od razu pokazuje, czy różnica dotyczy środka, czy ogona.
Jak może zmylić. Współczynnik dotyczy kwantyla rozkładu, nie każdego zamówienia: dłuższy o 4 dni 90. centyl nie znaczy, że każda dostawa B trwa 4 dni dłużej. Przy τ = .9 pasma są szersze, bo w ogonie jest mało obserwacji (u E: [4.30, 8.44]).
Dla zamówienia za 12 tys. zł zimą lub wiosną model przewiduje medianę 13.2 dnia u A i 11.1 u B, a 90. centyl – 17.4 [16.6, 17.8] i 21.6 dnia [19.6, 24.0]. Zamówienie u B za 48 tys. zł jesienią ma 90. centyl 26.6 dnia.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: niezawodność – dostawy w terminie i przesuwane terminy
Druga miara niezawodności to odsetek dostaw w terminie z oferty, z przedziałem ufności dla proporcji Wilsona – Brown i in. (2001) zalecają go zamiast przedziału Walda o chaotycznym pokryciu. W R: prop.test(x, n, correct = FALSE).
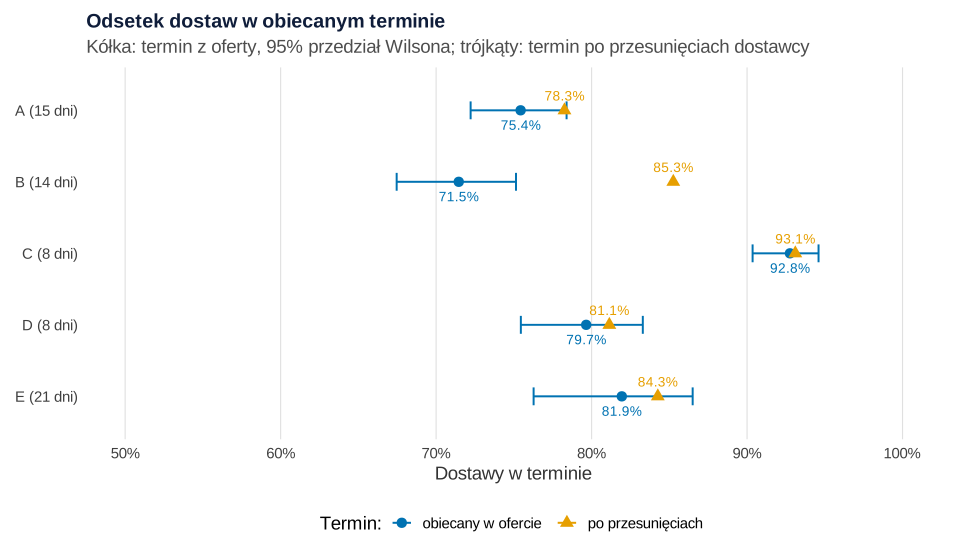
Co widać. Według terminu z oferty A dostarcza na czas 75.4% zamówień [72.2, 78.4], a B – 71.5% [67.5, 75.1]. B przesunął jednak termin w 95 zamówieniach (A – w 29) i według terminu „aktualnego” ma 85.3% dostaw na czas, więcej niż A (78.3%). Odchylenie od obietnicy też ma ogon: mediana to 3 dni przed terminem u B i 2 u A, ale 90. centyl – 9 i 3 dni po terminie.
Jak może zmylić. Kto obiecuje dłuższy termin (E – 21 dni), łatwiej go dotrzymuje, więc porównuj też sam czas realizacji. Przy mniejszej liczbie zamówień przedział Walda się przesuwa – u E [76.8, 87.1] wobec Wilsona [76.3, 86.5].
Podpis do pracy:
Rysunek 5: zapas bezpieczeństwa z rozkładu popytu w czasie realizacji
Zapas bezpieczeństwa chroni przed brakiem tkaniny do czasu dostawy, a popyt w tym czasie zależy od dziennego zużycia i długości realizacji. Zapas przy niepewnym popycie rozwija wpis model gazeciarza i zapas bezpieczeństwa; tu sprawdzamy, co zmienia ogon czasu realizacji. Typowy wzór zakłada rozkład normalny:
gdzie L to czas realizacji, μd i σd – średnia i SD dziennego zużycia, z = 1.645 dla celu 95%. Eppen i Martin (1988) pokazali, że ta standardowa procedura może dawać wyniki dalekie od zamierzonych, i liczyli zapas z rozkładu czasu dostawy z danych historycznych. Tak robimy: 20 000 cykli, czas realizacji losowany z dostaw A lub B, dzienne zużycie – średnio 40 m, SD 15 m (ustalone ręcznie).
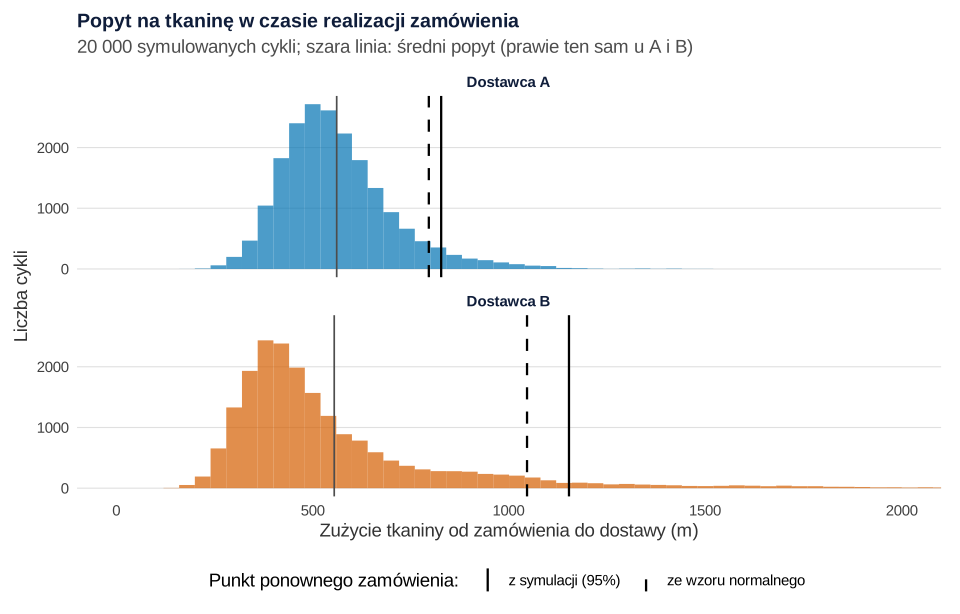
set.seed(7604)).Co widać. Średnie zużycie w czasie realizacji jest prawie takie samo (561.1 m u A, 554.9 m u B), ale dla 95% cykli bez braku A wymaga 266 m zapasu bezpieczeństwa, a B – 598 m. To 332 m więcej, ok. 12 603 zł zamrożonych w magazynie przy 38 zł/m – na jedną tkaninę. Wzór normalny daje za mało (235 i 491 m): 93.5% i 93.3% cykli bez braku (błąd Monte Carlo 0.15 pp). Wzór bez zmienności czasu realizacji (z · σd · √E(L)) daje 92 m i tylko 77.5–79.2%.
Jak może zmylić. Symulacja zakłada, że przyszłość wygląda jak ostatnie dwa lata. Błędy prognozy zużycia w kolejnych dniach realizacji bywają skorelowane, więc zapas „na dzień razy liczba dni” jest za mały (Prak i in., 2017) – wtedy losuj błędy prognozy. Narastanie wahań zamówień w górę łańcucha pokazuje wpis o efekcie byczego bicza.
Podpis do pracy:
Rysunek 6: zamówienia w toku zaniżają ogon
Niedostarczone zamówienia to obserwacje cenzurowane: wiemy tylko, że czas realizacji przekracza czas do dnia analizy. Bez nich z ostatnich tygodni zostają same szybkie dostawy.
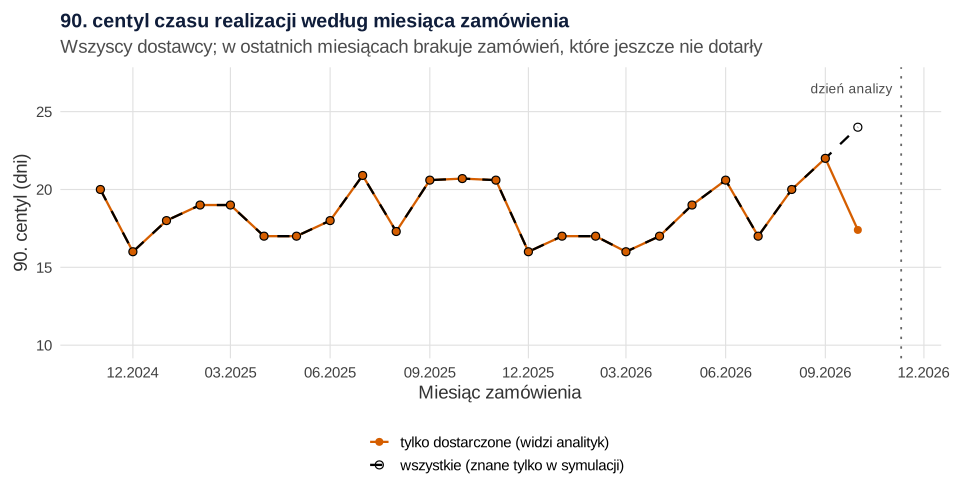
Co widać. Dla zamówień z października 2026 r. 90. centyl z dostarczonych to 17.4 dnia, a prawdziwy – 24 dni. Ze 144 zamówień tego miesiąca 27 było w toku: 13 u B, 8 u A i 6 u E – czyli u dostawców z długim ogonem.
Jak może zmylić. „Ostatni miesiąc się poprawił” to typowe złudzenie raportów zaopatrzenia. Pomiń miesiące niekompletne albo użyj analizy przeżycia – centyle odczytasz z krzywej Kaplana–Meiera. Standardowe metody wymagają założeń o mechanizmie cenzurowania, często nieznanym (Leung i in., 1997); tu wynika on tylko z dnia analizy.
Podpis do pracy:
Co z tym zrobić w firmie
- Porównuj dostawców na medianie i 90. centylu. „A: 13.2 / 17.4 dnia, B: 11.1 / 21.6 dnia” mówi więcej niż „oba po 14 dni”.
- Planuj szycie według 90. centyla. U B duże zamówienie jesienią to 26.6 dnia, nie 14 z oferty – składaj je wcześniej albo dziel.
- Licz zapas z rozkładu czasu realizacji. Jeśli B jest tańszy, różnica w cenie musi pokryć utrzymanie ok. 330 m dodatkowej tkaniny w każdym wzorze. W umowie zapisuj ogon: „90% dostaw w 18 dniach”, nie „średnio 14 dni”.
- Mierz terminowość według pierwszej obietnicy. Przesunięty termin zapisuj w osobnej kolumnie – inaczej najczęściej przesuwający dostawca wygląda najlepiej.
- Odświeżaj ocenę co kwartał, z przedziałami. Dostawcy się zmieniają (pułapki niżej).
Jak opisać w pracy
Opisz definicję czasu realizacji, zamówienia w toku, model, kwantyle i metodę przedziałów. Przy kilkudziesięciu dostawcach zamówienia są w nich zagnieżdżone – losuj w bootstrapie całych dostawców. Średnią skośnej zmiennej modeluje też regresja gamma (wpis o częstości i wysokości szkód), ale o ogonie mówi dopiero regresja kwantylowa. Pomoc w takiej analizie znajdziesz w ofercie dla studentów.
| Predyktor | MNK: b [95% CI] | Mediana: b [95% CI] | 90. centyl: b [95% CI] |
|---|---|---|---|
| Wyraz wolny (A, 12 tys. zł, zima–wiosna) | 13.40 [13.02, 13.79] | 13.19 [12.94, 13.42] | 17.43 [16.61, 17.76] |
| Dostawca B (vs A) | −0.13 [−0.63, 0.37] | −2.05 [−2.41, −1.66] | 4.18 [2.28, 6.62] |
| Dostawca C (vs A) | −7.43 [−7.92, −6.94] | −7.19 [−7.44, −6.97] | −9.49 [−9.94, −8.64] |
| Dostawca D (vs A) | −6.59 [−7.13, −6.04] | −7.32 [−7.64, −6.98] | −5.95 [−7.74, −4.44] |
| Dostawca E (vs A) | 5.16 [4.48, 5.84] | 4.16 [3.78, 4.73] | 5.48 [4.30, 8.44] |
| Wartość zamówienia ×2 | 0.92 [0.74, 1.10] | 0.54 [0.43, 0.64] | 1.42 [1.04, 1.78] |
| Lato (vs zima–wiosna) | 0.68 [0.23, 1.13] | 0.37 [0.09, 0.65] | 0.74 [0.07, 1.92] |
| Jesień (vs zima–wiosna) | 1.44 [1.02, 1.86] | 0.73 [0.55, 0.97] | 2.17 [1.46, 3.57] |
Kod R: dane, regresja kwantylowa, terminowość, zapas i cenzurowanie
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, z których korzystają kolejne; przepis 6 (karta, rysunek 2) używa wyników przepisów 1, 3 i 4. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(760)), 2 (set.seed(7602), bootstrap) i 4 (set.seed(7604), symulacja zapasu); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: udział dostawców w zamówieniach (A 30%, B 22%, C 24%, D 16%, E 8%; jesienią o 30% więcej zamówień); zwykły czas realizacji (A 13, B 10, C 6, D 5.5, E 17 dni) z rozrzutem log-normalnym (SD logarytmu 0.12–0.20); szansę opóźnienia przy zamówieniu za 12 tys. zł zimą lub wiosną (A 7%, B 28%, C 5%, D 25% – od 1.11.2025 r. 8%, E 10%) i średnią długość opóźnienia (A 6, B 11, C 4, D 7, E 8 dni; rozkład gamma o kształcie 1.5); na każde podwojenie wartości zamówienia +0.45 na skali logitu opóźnienia i +0.04 na skali log czasu zwykłej realizacji; lato +0.5 i jesień +0.9 (logit) oraz +0.02 i +0.05 (log czasu); wartość zamówienia z rozkładu log-normalnego (mediana 12 tys. zł, 2–80 tys. zł); termin z oferty (A 15, B 14, C 8, D 8, E 21 dni); szansę przesunięcia terminu przy spóźnieniu (B 60%, A 15%, pozostali 10%); dzień analizy 10.11.2026 r.; dzienne zużycie tkaniny (średnia 40 m, SD 15 m) i cenę 38 zł/m. Po pierwszym uruchomieniu nie zmieniano parametrów danych ani ziaren; poprawiono tylko wygląd rysunków (przezroczystość słupków na rysunku 1, położenie etykiet i wysokość rysunku 4, zamiana przestarzałej funkcji geom_errorbarh(), tło karty) i dopisano wydruk współczynników dla wszystkich τ, punktów ponownego zamówienia i zakresu 90. centyla w miesiącach kompletnych. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w ok. 30 sekund (prawie cały czas zajmuje bootstrap).
1. Dane: 2500 zamówień u pięciu dostawców – Rysunek 1
R
# Przepis 1. Fikcyjny producent mebli tapicerowanych: zamówienia tkanin i pianki u 5 dostawców
# (1 listopada 2024 – 31 października 2026), czas realizacji w dniach. Rysunek 1.
library(ggplot2)
options(width = 110)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol_dost <- c(A = "#0072B2", B = "#D55E00", C = "#009E73", D = "#CC79A7", E = "#E69F00")
kol <- c(mediana = "#000000", P90 = "#D55E00", srednia = "#0072B2", szary = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                 # znak minus (−) w etykietach rysunków

# ---- Parametry ustalone ręcznie (prawda, której analityk nie zna) ----
set.seed(760)
dostawcy <- c("A", "B", "C", "D", "E")
material <- c(A = "tkaniny", B = "tkaniny", C = "pianka", D = "pianka", E = "tkaniny")
udzial   <- c(A = 0.30, B = 0.22, C = 0.24, D = 0.16, E = 0.08)   # udział w liczbie zamówień
baza     <- c(A = 13, B = 10, C = 6, D = 5.5, E = 17)            # typowy czas realizacji (dni), bez opóźnień
rozrzut  <- c(A = 0.18, B = 0.20, C = 0.15, D = 0.20, E = 0.12)  # SD log czasu „zwykłej” realizacji
p_opozn  <- c(A = 0.07, B = 0.28, C = 0.05, D = 0.25, E = 0.10)  # szansa opóźnienia (zima–wiosna, 12 tys. zł)
dl_opozn <- c(A = 6, B = 11, C = 4, D = 7, E = 8)                # średnia długość opóźnienia (dni)
obietnica <- c(A = 15, B = 14, C = 8, D = 8, E = 21)             # termin obiecany w ofercie (dni)
p_przesun <- c(A = 0.15, B = 0.60, C = 0.10, D = 0.10, E = 0.10) # szansa przesunięcia terminu, gdy dostawa się spóźni
p_D_rok2 <- 0.08                         # dostawca D od 1.11.2025: nowa linia cięcia pianki, mniej opóźnień
b_wartosc_logit <- 0.45                  # na każde podwojenie wartości zamówienia (skala logitu opóźnienia)
b_wartosc_baza  <- 0.04                  # na każde podwojenie wartości (skala log czasu zwykłej realizacji)
b_pora_logit <- c("zima–wiosna" = 0, lato = 0.5, jesień = 0.9)   # szczyt sezonu meblowego jesienią
b_pora_baza  <- c("zima–wiosna" = 0, lato = 0.02, jesień = 0.05)
start <- as.Date("2024-11-01"); koniec <- as.Date("2026-10-31")
dzien_analizy <- as.Date("2026-11-10")   # stan danych w dniu analizy

n <- 2500
dni <- seq(start, koniec, by = "day")
miesiac <- as.integer(format(dni, "%m"))
waga_dnia <- ifelse(miesiac %in% 9:11, 1.3, 1)                   # jesienią więcej zamówień
z <- data.frame(dostawca = sample(dostawcy, n, replace = TRUE, prob = udzial),
                data_zamowienia = sort(sample(dni, n, replace = TRUE, prob = waga_dnia)))
z$material <- material[z$dostawca]
z$wartosc_tys_zl <- round(pmin(pmax(rlnorm(n, log(12), 0.7), 2), 80), 1)
m <- as.integer(format(z$data_zamowienia, "%m"))
z$pora <- factor(ifelse(m %in% 9:11, "jesień", ifelse(m %in% 6:8, "lato", "zima–wiosna")),
                 levels = c("zima–wiosna", "lato", "jesień"))
podw <- log2(z$wartosc_tys_zl / 12)                              # liczba podwojeń względem 12 tys. zł
p0 <- ifelse(z$dostawca == "D" & z$data_zamowienia >= as.Date("2025-11-01"), p_D_rok2, p_opozn[z$dostawca])
p <- plogis(qlogis(p0) + b_wartosc_logit * podw + b_pora_logit[as.character(z$pora)])
zwykly <- baza[z$dostawca] * exp(rnorm(n, 0, rozrzut[z$dostawca]) + b_wartosc_baza * podw +
                                 b_pora_baza[as.character(z$pora)])
opozn <- rbinom(n, 1, p) * rgamma(n, shape = 1.5, scale = dl_opozn[z$dostawca] / 1.5)
z$czas_prawdziwy_dni <- pmax(2, round(zwykly + opozn))          # tego w firmie nie ma dla zamówień w toku
z$termin_obiecany_dni <- unname(obietnica[z$dostawca])
# Gdy dostawa się spóźnia, dostawca czasem przesuwa termin („nowa data”) – zwykle tuż przed dostawą
spoz <- z$czas_prawdziwy_dni > z$termin_obiecany_dni
przes <- spoz & runif(n) < p_przesun[z$dostawca]
z$termin_aktualny_dni <- ifelse(przes, z$czas_prawdziwy_dni + sample(-1:2, n, replace = TRUE), z$termin_obiecany_dni)
z$data_dostawy <- z$data_zamowienia + z$czas_prawdziwy_dni
z$dostarczone <- as.integer(z$data_dostawy <= dzien_analizy)
z$czas_realizacji_dni <- ifelse(z$dostarczone == 1, z$czas_prawdziwy_dni, NA)
z$data_dostawy[z$dostarczone == 0] <- NA
z$dostawca <- factor(z$dostawca, levels = dostawcy)
z$id <- sprintf("Z%04d", seq_len(n))
dane <- z[, c("id", "dostawca", "material", "data_zamowienia", "wartosc_tys_zl", "pora", "termin_obiecany_dni",
              "termin_aktualny_dni", "data_dostawy", "dostarczone", "czas_realizacji_dni", "czas_prawdziwy_dni")]
write.csv(dane, "czas-realizacji-dostawy-meble.csv", row.names = FALSE, fileEncoding = "UTF-8")

# ---- Opis danych ----
c(zamowien = nrow(dane), dostarczonych = sum(dane$dostarczone), w_toku = sum(dane$dostarczone == 0))
d <- subset(dane, dostarczone == 1)                               # analizujemy zamówienia dostarczone
skos <- function(x) mean((x - mean(x))^3) / sd(x)^3
opis <- do.call(rbind, lapply(split(d$czas_realizacji_dni, d$dostawca), function(x)
  c(n = length(x), srednia = mean(x), SD = sd(x), mediana = median(x),
    P90 = unname(quantile(x, 0.9)), P95 = unname(quantile(x, 0.95)), max = max(x), skosnosc = skos(x))))
round(opis, 2)
round(c(srednia = mean(d$czas_realizacji_dni), mediana = median(d$czas_realizacji_dni),
        P90 = unname(quantile(d$czas_realizacji_dni, 0.9)), skosnosc = skos(d$czas_realizacji_dni)), 2)

# ---- Rysunek 1: rozkład czasu realizacji z medianą, średnią i 90. centylem ----
st <- data.frame(dostawca = factor(rownames(opis), levels = dostawcy), opis)
st <- rbind(data.frame(dostawca = st$dostawca, miara = "mediana", x = st$mediana),
            data.frame(dostawca = st$dostawca, miara = "średnia", x = st$srednia),
            data.frame(dostawca = st$dostawca, miara = "90. centyl", x = st$P90))
st$miara <- factor(st$miara, levels = c("mediana", "średnia", "90. centyl"))
d$etykieta <- factor(paste0(d$dostawca, " (", d$material, ")"),
                     levels = paste0(dostawcy, " (", material[dostawcy], ")"))
st$etykieta <- levels(d$etykieta)[as.integer(st$dostawca)]
st$etykieta <- factor(st$etykieta, levels = levels(d$etykieta))
p1 <- ggplot(d, aes(x = czas_realizacji_dni)) +
  geom_histogram(aes(fill = dostawca), binwidth = 1, boundary = 0.5, alpha = 0.5, show.legend = FALSE) +
  geom_vline(data = st, aes(xintercept = x, linetype = miara, colour = miara), linewidth = 0.8) +
  facet_wrap(~ etykieta, ncol = 1, scales = "free_y", strip.position = "top") +
  scale_fill_manual(values = kol_dost) +
  scale_colour_manual(values = c(mediana = "#000000", "średnia" = "#0072B2", "90. centyl" = "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c(mediana = "solid", "średnia" = "dashed", "90. centyl" = "dotdash"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 70, 5)) +
  labs(title = "Czas realizacji zamówień u pięciu dostawców",
       subtitle = "Dostarczone zamówienia; linie: mediana, średnia i 90. centyl",
       x = "Czas od zamówienia do dostawy (dni)", y = "Liczba zamówień") +
  motyw + theme(panel.grid.major.x = element_blank(), strip.text = element_text(hjust = 0))
p1   # zapis: ggsave("czas-realizacji-rozklad.svg", p1, width = 10, height = 8.4)
Wynik w R
     zamowien dostarczonych        w_toku
         2500          2473            27
    n srednia   SD mediana P90   P95 max skosnosc
A 745   14.03 3.28      13  18 20.00  34     1.40
B 529   13.87 7.33      11  23 28.00  54     2.33
C 580    6.60 2.03       6   8 10.00  21     3.15
D 403    7.47 4.38       6  13 17.00  33     2.63
E 216   19.11 5.53      18  24 30.25  65     3.65
 srednia  mediana      P90 skosnosc
   11.63    11.00    19.00     1.78
2. Regresja kwantylowa z bootstrapem – Rysunek 3
R
# Przepis 2. Regresja kwantylowa czasu realizacji: dostawca, wartość zamówienia, pora roku. Rysunek 3.
# Korzysta z obiektów przepisu 1: d (zamówienia dostarczone), kol_dost, motyw, minus.
library(quantreg)

d$podwojenia <- log2(d$wartosc_tys_zl / 12)            # 0 = 12 tys. zł; +1 = zamówienie dwa razy większe
wzor <- czas_realizacji_dni ~ dostawca + podwojenia + pora   # odniesienie: dostawca A, zima–wiosna, 12 tys. zł

# Średnia (MNK) – dla porównania
m_mnk <- lm(wzor, data = d)
round(cbind(b = coef(m_mnk), confint(m_mnk)), 2)

# Regresja kwantylowa dla mediany i 90. centyla (czas w pełnych dniach, więc rozwiązanie bywa
# niejednoznaczne – quantreg ostrzega o tym komunikatem „solution may be nonunique”, który pomijamy)
m_q <- suppressWarnings(rq(wzor, tau = c(0.5, 0.9), data = d))
round(coef(m_q), 2)

# Bootstrap par (losowanie zamówień ze zwracaniem), 1000 powtórzeń, kwantyle τ = .1, .2, …, .9
set.seed(7602)
taus <- seq(0.1, 0.9, by = 0.1)
X <- model.matrix(wzor, data = d); y <- d$czas_realizacji_dni
oszac <- sapply(taus, function(t) suppressWarnings(rq.fit(X, y, tau = t)$coefficients))   # 8 × 9
colnames(oszac) <- taus
round(oszac, 2)                                          # współczynniki dla τ = .1, …, .9
B <- 1000
boot <- array(NA, c(B, ncol(X), length(taus)), dimnames = list(NULL, colnames(X), taus))
for (b in seq_len(B)) {
  i <- sample(nrow(X), replace = TRUE)
  for (k in seq_along(taus)) boot[b, , k] <- suppressWarnings(rq.fit(X[i, ], y[i], tau = taus[k])$coefficients)
}
ci <- function(x) quantile(x, c(0.025, 0.975), na.rm = TRUE)
tabela <- function(t) {
  k <- which(abs(taus - t) < 1e-9)
  cbind(b = oszac[, k], t(apply(boot[, , k], 2, ci)))
}
cat("Mediana (τ = .5), 95% CI z bootstrapu:\n"); print(round(tabela(0.5), 2))
cat("90. centyl (τ = .9), 95% CI z bootstrapu:\n"); print(round(tabela(0.9), 2))

# Czy dostawca B różni się od A bardziej w ogonie niż w medianie? Różnica współczynników τ = .9 i τ = .5
roznica_B <- boot[, "dostawcaB", "0.9"] - boot[, "dostawcaB", "0.5"]
round(c(roznica = unname(oszac["dostawcaB", 9] - oszac["dostawcaB", 5]), ci(roznica_B)), 2)

# Przewidywana mediana i 90. centyl dla zamówienia standardowego (12 tys. zł, zima–wiosna)
przewid <- function(k) {
  b <- boot[, , k]; o <- oszac[, k]
  sapply(c("A", "B", "C", "D", "E"), function(s) {
    v <- c(1, as.numeric(paste0("dostawca", s) == colnames(X)[-1]))
    c(oszac = sum(o * v), ci(b %*% v))
  })
}
cat("Zamówienie standardowe – mediana:\n"); print(round(przewid(5), 1))
cat("Zamówienie standardowe – 90. centyl:\n"); print(round(przewid(9), 1))
# Ten sam dostawca B jesienią i przy zamówieniu za 48 tys. zł (dwa podwojenia)
v_B <- c(1, 1, 0, 0, 0, 2, 0, 1)
round(c(mediana = sum(oszac[, 5] * v_B), P90 = sum(oszac[, 9] * v_B)), 1)

# ---- Rysunek 3: współczynniki w funkcji τ z 95% pasmem z bootstrapu i średnia (MNK) ----
wybrane <- c(dostawcaB = "Dostawca B vs A", dostawcaD = "Dostawca D vs A", dostawcaE = "Dostawca E vs A",
             podwojenia = "Wartość zamówienia ×2", poralato = "Lato vs zima–wiosna",
             "porajesień" = "Jesień vs zima–wiosna")
proces <- do.call(rbind, lapply(names(wybrane), function(v) data.frame(
  zmienna = wybrane[[v]], tau = taus, b = oszac[v, ],
  dolna = apply(boot[, v, ], 2, ci)[1, ], gorna = apply(boot[, v, ], 2, ci)[2, ])))
mnk <- data.frame(zmienna = wybrane, b = coef(m_mnk)[names(wybrane)],
                  dolna = confint(m_mnk)[names(wybrane), 1], gorna = confint(m_mnk)[names(wybrane), 2])
proces$zmienna <- factor(proces$zmienna, levels = wybrane); mnk$zmienna <- factor(mnk$zmienna, levels = wybrane)
p3 <- ggplot(proces, aes(x = tau, y = b)) +
  geom_rect(data = mnk, aes(xmin = -Inf, xmax = Inf, ymin = dolna, ymax = gorna), inherit.aes = FALSE,
            fill = "grey80", alpha = 0.5) +
  geom_hline(data = mnk, aes(yintercept = b), linetype = "dashed", colour = "grey35") +
  geom_hline(yintercept = 0, colour = "grey55", linewidth = 0.4) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = "#0072B2", alpha = 0.22) +
  geom_line(colour = "#0072B2", linewidth = 0.9) + geom_point(colour = "#0072B2", size = 1.8) +
  facet_wrap(~ zmienna, ncol = 2, scales = "free_y") +
  scale_x_continuous(breaks = taus, labels = c(".1", "", ".3", "", ".5", "", ".7", "", ".9")) +
  scale_y_continuous(labels = function(x) minus(format(x, trim = TRUE))) +
  labs(title = "Efekty na różnych kwantylach czasu realizacji",
       subtitle = "Niebieskie: regresja kwantylowa z 95% pasmem (bootstrap); szare: średnia (MNK)",
       x = "Kwantyl τ", y = "Różnica czasu realizacji (dni)") +
  motyw
p3   # zapis: ggsave("czas-realizacji-wspolczynniki-tau.svg", p3, width = 10, height = 8.4)
Wynik w R
                b 2.5 % 97.5 %
(Intercept) 13.40 13.02  13.79
dostawcaB   -0.13 -0.63   0.37
dostawcaC   -7.43 -7.92  -6.94
dostawcaD   -6.59 -7.13  -6.04
dostawcaE    5.16  4.48   5.84
podwojenia   0.92  0.74   1.10
poralato     0.68  0.23   1.13
porajesień   1.44  1.02   1.86
            tau= 0.5 tau= 0.9
(Intercept)    13.19    17.43
dostawcaB      -2.05     4.18
dostawcaC      -7.19    -9.49
dostawcaD      -7.32    -5.95
dostawcaE       4.16     5.48
podwojenia      0.54     1.42
poralato        0.37     0.74
porajesień      0.73     2.17
              0.1   0.2   0.3   0.4   0.5   0.6   0.7   0.8   0.9
(Intercept) 10.59 11.44 12.03 12.57 13.19 13.77 14.56 15.52 17.43
dostawcaB   -2.38 -2.48 -2.44 -2.21 -2.05 -1.56 -0.84  0.59  4.18
dostawcaC   -5.76 -6.28 -6.56 -6.86 -7.19 -7.55 -8.04 -8.54 -9.49
dostawcaD   -6.37 -6.70 -6.95 -7.12 -7.32 -7.43 -7.62 -7.61 -5.95
dostawcaE    4.26  4.46  4.28  4.26  4.16  4.16  4.50  4.75  5.48
podwojenia   0.32  0.39  0.44  0.47  0.54  0.65  0.76  0.92  1.42
poralato     0.03  0.04  0.16  0.25  0.37  0.46  0.56  0.62  0.74
porajesień   0.51  0.49  0.73  0.69  0.73  0.87  1.09  1.73  2.17
Mediana (τ = .5), 95% CI z bootstrapu:
                b  2.5% 97.5%
(Intercept) 13.19 12.94 13.42
dostawcaB   -2.05 -2.41 -1.66
dostawcaC   -7.19 -7.44 -6.97
dostawcaD   -7.32 -7.64 -6.98
dostawcaE    4.16  3.78  4.73
podwojenia   0.54  0.43  0.64
poralato     0.37  0.09  0.65
porajesień   0.73  0.55  0.97
90. centyl (τ = .9), 95% CI z bootstrapu:
                b  2.5% 97.5%
(Intercept) 17.43 16.61 17.76
dostawcaB    4.18  2.28  6.62
dostawcaC   -9.49 -9.94 -8.64
dostawcaD   -5.95 -7.74 -4.44
dostawcaE    5.48  4.30  8.44
podwojenia   1.42  1.04  1.78
poralato     0.74  0.07  1.92
porajesień   2.17  1.46  3.57
roznica    2.5%   97.5%
   6.23    4.51    8.67
Zamówienie standardowe – mediana:
         A    B   C   D    E
oszac 13.2 11.1 6.0 5.9 17.3
2.5%  12.9 10.8 5.8 5.6 17.1
97.5% 13.4 11.4 6.1 6.1 17.8
Zamówienie standardowe – 90. centyl:
         A    B   C    D    E
oszac 17.4 21.6 7.9 11.5 22.9
2.5%  16.6 19.6 7.6  9.6 21.8
97.5% 17.8 24.0 8.5 12.7 25.7
mediana     P90
   12.9    26.6
3. Terminowość: przedział Wilsona i odchylenie od obietnicy – Rysunek 4
R
# Przepis 3. Niezawodność: odsetek dostaw w terminie (przedział Wilsona) i odchylenie od obietnicy. Rysunek 4.
# Korzysta z obiektów przepisu 1: d, dostawcy, kol_dost, motyw. Niczego nie losuje.

wilson <- function(x, n) {                              # przedział Wilsona = prop.test bez poprawki na ciągłość
  ci <- suppressWarnings(prop.test(x, n, correct = FALSE)$conf.int)
  c(odsetek = 100 * x / n, dolna = 100 * ci[1], gorna = 100 * ci[2])
}
d$opoznienie_dni <- d$czas_realizacji_dni - d$termin_obiecany_dni   # > 0 = po obiecanym terminie
term <- do.call(rbind, lapply(dostawcy, function(s) {
  x <- d[d$dostawca == s, ]
  data.frame(dostawca = s, n = nrow(x), obietnica_dni = x$termin_obiecany_dni[1],
             rbind(wilson(sum(x$czas_realizacji_dni <= x$termin_obiecany_dni), nrow(x))),
             w_terminie_aktualnym = 100 * mean(x$czas_realizacji_dni <= x$termin_aktualny_dni),
             przesuniete_terminy = sum(x$termin_aktualny_dni != x$termin_obiecany_dni),
             sr_dni_po_terminie = mean(pmax(x$opoznienie_dni, 0)),
             mediana_odchylenia = median(x$opoznienie_dni),
             P90_odchylenia = unname(quantile(x$opoznienie_dni, 0.9)))
}))
print(cbind(term[, 1:3], round(term[, -(1:3)], 1)), row.names = FALSE)
# Przedział Walda dla porównania (dostawca E – najmniej zamówień)
x_E <- sum(d$dostawca == "E" & d$czas_realizacji_dni <= d$termin_obiecany_dni); n_E <- sum(d$dostawca == "E")
p_E <- x_E / n_E
round(100 * c(Wald_dolna = p_E - 1.96 * sqrt(p_E * (1 - p_E) / n_E), Wald_gorna = p_E + 1.96 * sqrt(p_E * (1 - p_E) / n_E)), 1)

# ---- Rysunek 4: odsetek w terminie według terminu z oferty i według terminu przesuniętego ----
r4 <- rbind(data.frame(dostawca = term$dostawca, termin = "obiecany w ofercie", odsetek = term$odsetek,
                       dolna = term$dolna, gorna = term$gorna),
            data.frame(dostawca = term$dostawca, termin = "po przesunięciach", odsetek = term$w_terminie_aktualnym,
                       dolna = NA, gorna = NA))
r4$dostawca <- factor(paste0(r4$dostawca, " (", term$obietnica_dni[match(r4$dostawca, term$dostawca)], " dni)"),
                      levels = rev(paste0(term$dostawca, " (", term$obietnica_dni, " dni)")))
p4 <- ggplot(r4, aes(x = odsetek, y = dostawca, colour = termin, shape = termin)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.7, orientation = "y", na.rm = TRUE) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.1f%%", odsetek), vjust = ifelse(termin == "po przesunięciach", -1.0, 2.0)),
            size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = c("obiecany w ofercie" = "#0072B2", "po przesunięciach" = "#E69F00"), name = "Termin:") +
  scale_shape_manual(values = c("obiecany w ofercie" = 16, "po przesunięciach" = 17), name = "Termin:") +
  scale_x_continuous(breaks = seq(50, 100, 10), labels = function(x) paste0(x, "%")) +
  coord_cartesian(xlim = c(50, 100)) +
  labs(title = "Odsetek dostaw w obiecanym terminie",
       subtitle = "Kółka: termin z oferty, 95% przedział Wilsona; trójkąty: termin po przesunięciach dostawcy",
       x = "Dostawy w terminie", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("czas-realizacji-terminowosc.svg", p4, width = 10, height = 5.8)
Wynik w R
 dostawca   n obietnica_dni odsetek dolna gorna w_terminie_aktualnym przesuniete_terminy sr_dni_po_terminie
        A 745            15    75.4  72.2  78.4                 78.3                  29                0.9
        B 529            14    71.5  67.5  75.1                 85.3                  95                2.5
        C 580             8    92.8  90.4  94.6                 93.1                   2                0.3
        D 403             8    79.7  75.5  83.3                 81.1                   6                1.3
        E 216            21    81.9  76.3  86.5                 84.3                   6                1.2
 mediana_odchylenia P90_odchylenia
                 -2              3
                 -3              9
                 -2              0
                 -2              5
                 -3              3
Wald_dolna Wald_gorna
      76.8       87.1
4. Zapas bezpieczeństwa: symulacja dla dostawców A i B – Rysunek 5
R
# Przepis 4. Zapas bezpieczeństwa tkaniny przy dostawcy A i B: ta sama średnia, inny ogon. Rysunek 5.
# Korzysta z obiektu d z przepisu 1. Popyt na tkaninę w czasie realizacji – symulacja.
set.seed(7604)
zuzycie_sr <- 40; zuzycie_sd <- 15     # dzienne zużycie jednej tkaniny obiciowej (m), ustalone ręcznie
cena_m <- 38                           # cena metra tkaniny (zł), ustalona ręcznie
cel <- 0.95                            # cel: 95% cykli zamówienia bez braku (cykliczny poziom obsługi)
z <- qnorm(cel)
cykle <- 20000
sym <- lapply(c("A", "B"), function(s) {
  L <- d$czas_realizacji_dni[d$dostawca == s]
  Ls <- sample(L, cykle, replace = TRUE)                 # czas realizacji z rozkładu empirycznego dostawcy
  popyt <- rnorm(cykle, zuzycie_sr * Ls, zuzycie_sd * sqrt(Ls))   # popyt w czasie realizacji (suma L dni)
  sr_popyt <- zuzycie_sr * mean(L)
  pkt_sym <- unname(quantile(popyt, cel))                # punkt ponownego zamówienia z symulacji
  zapas_wzor <- z * sqrt(mean(L) * zuzycie_sd^2 + zuzycie_sr^2 * var(L))   # wzór z założeniem normalności
  zapas_bez_L <- z * zuzycie_sd * sqrt(mean(L))          # wzór, który pomija zmienność czasu realizacji
  list(popyt = popyt, wynik = c(sr_L = mean(L), SD_L = sd(L), P95_L = unname(quantile(L, 0.95)),
    sr_popyt = sr_popyt, punkt_symulacja = pkt_sym, punkt_wzor = sr_popyt + zapas_wzor,
    zapas_symulacja = pkt_sym - sr_popyt, zapas_wzor = zapas_wzor, zapas_bez_L = zapas_bez_L,
    obsluga_wzor = 100 * mean(popyt <= sr_popyt + zapas_wzor),
    obsluga_bez_L = 100 * mean(popyt <= sr_popyt + zapas_bez_L)))
})
names(sym) <- c("A", "B")
wyn <- sapply(sym, `[[`, "wynik")
round(wyn, 1)
# Błąd Monte Carlo odsetka cykli bez braku (pp) przy 20 000 cyklach
round(100 * sqrt(0.95 * 0.05 / cykle), 2)
# Ile więcej zapasu wymaga dostawca B (m i zł zamrożone w magazynie)
round(c(metry = unname(wyn["zapas_symulacja", "B"] - wyn["zapas_symulacja", "A"]),
        zl = unname(wyn["zapas_symulacja", "B"] - wyn["zapas_symulacja", "A"]) * cena_m), 0)

# ---- Rysunek 5: rozkład popytu w czasie realizacji i punkt ponownego zamówienia ----
r5 <- rbind(data.frame(dostawca = "A", popyt = sym$A$popyt), data.frame(dostawca = "B", popyt = sym$B$popyt))
linie <- data.frame(dostawca = rep(c("A", "B"), each = 2),
                    rodzaj = rep(c("z symulacji (95%)", "ze wzoru normalnego"), 2),
                    x = c(wyn["sr_popyt", "A"] + wyn["zapas_symulacja", "A"], wyn["sr_popyt", "A"] + wyn["zapas_wzor", "A"],
                          wyn["sr_popyt", "B"] + wyn["zapas_symulacja", "B"], wyn["sr_popyt", "B"] + wyn["zapas_wzor", "B"]))
srednie <- data.frame(dostawca = c("A", "B"), x = wyn["sr_popyt", ])
r5$dostawca <- factor(paste("Dostawca", r5$dostawca)); linie$dostawca <- factor(paste("Dostawca", linie$dostawca))
srednie$dostawca <- factor(paste("Dostawca", srednie$dostawca))
p5 <- ggplot(r5, aes(x = popyt)) +
  geom_histogram(aes(fill = dostawca), binwidth = 40, boundary = 0, alpha = 0.7, show.legend = FALSE) +
  geom_vline(data = srednie, aes(xintercept = x), colour = "grey30", linewidth = 0.6) +
  geom_vline(data = linie, aes(xintercept = x, linetype = rodzaj), colour = "#000000", linewidth = 0.8) +
  facet_wrap(~ dostawca, ncol = 1) +
  scale_fill_manual(values = c("Dostawca A" = "#0072B2", "Dostawca B" = "#D55E00")) +
  scale_linetype_manual(values = c("z symulacji (95%)" = "solid", "ze wzoru normalnego" = "dashed"),
                        name = "Punkt ponownego zamówienia:") +
  coord_cartesian(xlim = c(0, 2000)) +
  labs(title = "Popyt na tkaninę w czasie realizacji zamówienia",
       subtitle = "20 000 symulowanych cykli; szara linia: średni popyt (prawie ten sam u A i B)",
       x = "Zużycie tkaniny od zamówienia do dostawy (m)", y = "Liczba cykli") +
  motyw + theme(panel.grid.major.x = element_blank())
p5   # zapis: ggsave("czas-realizacji-zapas.svg", p5, width = 10, height = 6.4)
Wynik w R
                    A      B
sr_L             14.0   13.9
SD_L              3.3    7.3
P95_L            20.0   28.0
sr_popyt        561.1  554.9
punkt_symulacja 827.2 1152.6
punkt_wzor      795.7 1045.8
zapas_symulacja 266.0  597.7
zapas_wzor      234.6  490.9
zapas_bez_L      92.4   91.9
obsluga_wzor     93.5   93.3
obsluga_bez_L    79.2   77.5
[1] 0.15
metry    zl
  332 12603
5. Pułapki: zamówienia w toku i zmiana u dostawcy D – Rysunek 6
R
# Przepis 5. Pułapki: zamówienia w toku (cenzurowanie) i zmiana u dostawcy D w czasie. Rysunek 6.
# Korzysta z obiektów przepisu 1: dane, d, dzien_analizy, motyw. Niczego nie losuje.

# Zamówienia w toku w dniu analizy – według dostawcy
table(dane$dostawca[dane$dostarczone == 0])
# 90. centyl według miesiąca zamówienia: tylko dostarczone (to widzi analityk) i wszystkie (znane w symulacji)
dane$miesiac <- as.Date(format(dane$data_zamowienia, "%Y-%m-01"))
mies <- do.call(rbind, lapply(split(dane, dane$miesiac), function(x) data.frame(
  miesiac = x$miesiac[1], n = nrow(x), w_toku = sum(x$dostarczone == 0),
  P90_dostarczone = unname(quantile(x$czas_realizacji_dni, 0.9, na.rm = TRUE)),
  P90_wszystkie = unname(quantile(x$czas_prawdziwy_dni, 0.9)))))
print(tail(mies, 4), row.names = FALSE)
range(mies$P90_dostarczone[mies$w_toku == 0])           # zakres w miesiącach kompletnych

# Dostawca D: rok 1 i rok 2 (od listopada 2025 r. mniej opóźnień)
D <- subset(d, dostawca == "D")
D$rok <- ifelse(D$data_zamowienia >= as.Date("2025-11-01"), "rok 2", "rok 1")
round(t(sapply(split(D$czas_realizacji_dni, D$rok), function(x)
  c(n = length(x), srednia = mean(x), mediana = median(x), P90 = unname(quantile(x, 0.9))))), 1)
round(c(P90_razem = unname(quantile(D$czas_realizacji_dni, 0.9))), 1)

# ---- Rysunek 6: 90. centyl według miesiąca zamówienia ----
r6 <- rbind(data.frame(miesiac = mies$miesiac, P90 = mies$P90_dostarczone, wersja = "tylko dostarczone (widzi analityk)"),
            data.frame(miesiac = mies$miesiac, P90 = mies$P90_wszystkie, wersja = "wszystkie (znane tylko w symulacji)"))
p6 <- ggplot(r6, aes(x = miesiac, y = P90, colour = wersja, linetype = wersja, shape = wersja)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.4) +
  geom_vline(xintercept = dzien_analizy, colour = "grey40", linetype = "dotted") +
  annotate("text", x = dzien_analizy - 8, y = 26.5, label = "dzień analizy", hjust = 1, size = 3.6, colour = "grey30") +
  scale_colour_manual(values = c("#D55E00", "#000000"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 1), name = NULL) +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  scale_y_continuous(limits = c(10, 27)) +
  labs(title = "90. centyl czasu realizacji według miesiąca zamówienia",
       subtitle = "Wszyscy dostawcy; w ostatnich miesiącach brakuje zamówień, które jeszcze nie dotarły",
       x = "Miesiąc zamówienia", y = "90. centyl (dni)") +
  motyw + theme(legend.direction = "vertical")
p6   # zapis: ggsave("czas-realizacji-cenzurowanie.svg", p6, width = 10, height = 5.2)
Wynik w R
 A  B  C  D  E
 8 13  0  0  6
    miesiac   n w_toku P90_dostarczone P90_wszystkie
 2026-07-01 101      0            17.0            17
 2026-08-01 102      0            20.0            20
 2026-09-01 127      0            22.0            22
 2026-10-01 144     27            17.4            24
[1] 16 22
        n srednia mediana P90
rok 1 212     8.1       6  15
rok 2 191     6.7       6   9
P90_razem
       13
6. Grafika: karta „ta sama średnia, inny ogon” – Rysunek 2
R
# Przepis 6. Grafika: karta „ta sama średnia, inny ogon” – dostawcy A i B. Rysunek 2.
# Korzysta z obiektów przepisów 1, 3 i 4: d, opis, term, wyn, motyw. Niczego nie losuje.
karta <- do.call(rbind, lapply(c("A", "B"), function(s) {
  g <- density(d$czas_realizacji_dni[d$dostawca == s], adjust = 1.6, from = 2, to = 45)
  data.frame(dostawca = s, x = g$x, g = g$y)
}))
karta$y <- 0.56 + 0.36 * karta$g / max(karta$g)
karta$panel <- factor(paste("Dostawca", karta$dostawca, "– tkaniny"))
liczby <- function(s) c(
  sprintf("Średnia: %.1f dni", opis[s, "srednia"]),
  sprintf("Mediana: %.0f dni", opis[s, "mediana"]),
  sprintf("90. centyl: %.0f dni", opis[s, "P90"]),
  sprintf("W terminie z oferty (%d dni): %.1f%%", term$obietnica_dni[term$dostawca == s], term$odsetek[term$dostawca == s]),
  sprintf("Zapas bezpieczeństwa: %.0f m tkaniny", wyn["zapas_symulacja", s]))
teksty <- do.call(rbind, lapply(c("A", "B"), function(s) data.frame(
  panel = paste("Dostawca", s, "– tkaniny"), x = 3, y = c(0.44, 0.355, 0.27, 0.185, 0.10),
  etykieta = liczby(s), gruby = c(FALSE, FALSE, TRUE, FALSE, TRUE))))
znaczniki <- data.frame(panel = rep(levels(karta$panel), each = 2), rodzaj = rep(c("średnia", "90. centyl"), 2),
                        x = c(opis["A", "srednia"], opis["A", "P90"], opis["B", "srednia"], opis["B", "P90"]))
p2 <- ggplot() +
  annotate("rect", xmin = 0, xmax = 46, ymin = 0, ymax = 1, fill = "#f6f4ef", colour = "#dedbd4") +
  geom_ribbon(data = karta, aes(x = x, ymin = 0.56, ymax = y, fill = dostawca), alpha = 0.55, show.legend = FALSE) +
  geom_line(data = karta, aes(x = x, y = y), colour = "grey25", linewidth = 0.5) +
  geom_segment(data = znaczniki, aes(x = x, xend = x, y = 0.53, yend = 0.95, linetype = rodzaj, colour = rodzaj),
               linewidth = 0.9) +
  geom_text(data = teksty, aes(x = x, y = y, label = etykieta, fontface = ifelse(gruby, "bold", "plain")),
            hjust = 0, size = 4.4, colour = "#0f1d3a") +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = c(A = "#0072B2", B = "#D55E00")) +
  scale_colour_manual(values = c("średnia" = "#000000", "90. centyl" = "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("średnia" = "dashed", "90. centyl" = "solid"), name = NULL) +
  scale_x_continuous(limits = c(0, 46), breaks = c(0, 10, 20, 30, 40)) +
  scale_y_continuous(limits = c(0, 1)) +
  labs(title = "Ta sama średnia, inny ogon",
       subtitle = "Rozkład czasu realizacji (dni) i co z niego wynika dla terminów i zapasu",
       x = "Czas realizacji (dni)", y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.y = element_blank())
p2   # zapis: ggsave("czas-realizacji-karta-ogon.svg", p2, width = 10, height = 6)
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw (odległość barw ΔE w CIELAB)
library(colorspace)
pary <- list("dostawca A – dostawca B" = c("#0072B2", "#D55E00"),
             "dostawca C – dostawca D" = c("#009E73", "#CC79A7"),
             "dostawca A – dostawca E" = c("#0072B2", "#E69F00"),
             "dostawca B – dostawca E" = c("#D55E00", "#E69F00"),
             "dostawca D – dostawca B" = c("#CC79A7", "#D55E00"),
             "termin z oferty – po przesunięciach" = c("#0072B2", "#E69F00"),
             "mediana – 90. centyl" = c("#000000", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) { lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2)) }
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                    widzenie_typowe deuteranopia protanopia
dostawca A – dostawca B                       114.6        108.3       91.9
dostawca C – dostawca D                        87.5         18.1       36.2
dostawca A – dostawca E                       120.2        121.5      109.3
dostawca B – dostawca E                        33.4         18.4       24.9
dostawca D – dostawca B                        74.3         70.2       71.9
termin z oferty – po przesunięciach           120.2        121.5      109.3
mediana – 90. centyl                           93.9         85.4       71.8
czerwony – zielony (do unikania)              121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję kwantylową i bootstrap liczono pakietem quantreg (funkcje rq i rq.fit), regresję MNK funkcją lm, a przedział Wilsona funkcją prop.test (pakiet stats). Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- quantreg (wersja 6.1): Koenker, R. (2025). quantreg: Quantile regression (R package version 6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.quantreg
- SparseM (wersja 1.84.2, ładowany przez quantreg): Koenker, R. (2024). SparseM: Sparse linear algebra (R package version 1.84-2) [Computer software]. https://doi.org/10.32614/CRAN.package.SparseM
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zmiana dostawcy w czasie. Dostawca D miał 90. centyl 15 dni w pierwszym roku i 9 w drugim; z obu lat razem – 13 dni. Oceniaj na ostatnich 12 miesiącach albo dodaj do modelu interakcję rok × dostawca.
- Termin przesuwany przez dostawcę. Licz terminowość od pierwszej obietnicy. Według terminu po przesunięciach B ma 85.3% dostaw na czas, według oferty – 71.5%.
- Zamówienia w toku. Pominięte zaniżają ogon ostatnich tygodni (17.4 zamiast 24 dni w październiku – rysunek 6).
- Różne definicje czasu realizacji. Od złożenia czy potwierdzenia, dni kalendarzowe czy robocze, pierwsza czy ostatnia część dostawy częściowej – ustal to przed analizą.
- Mało danych w ogonie. Przy ok. 200 zamówieniach (E) różnica 90. centyli ma przedział [4.30, 8.44] dnia. 95. czy 99. centyla nie raportuj z kilkudziesięciu dostaw.
Najczęstsze pytania
Jak porównać czas dostaw różnych dostawców?
Opisz rozkład czasu realizacji każdego dostawcy (mediana, 90. centyl, odsetek w terminie), a różnice oszacuj regresją kwantylową dla mediany i 90. centyla z kontrolą wartości zamówienia i pory roku. Przedziały ufności licz bootstrapem. Średnia wystarcza tylko wtedy, gdy dostawcy różnią się przesunięciem całego rozkładu, a nie ogonem.
Dlaczego 90. centyl czasu dostawy jest ważniejszy niż średnia?
Bo braki materiału i przestoje powodują nieliczne, bardzo długie dostawy, a średnia miesza je z typowymi. W przykładzie dwaj dostawcy mieli średnio 14 dni, ale 90. centyl 18 i 23 dni – i to on decydował o zapasie bezpieczeństwa oraz o terminie, który można obiecać klientowi.
Jak policzyć zapas bezpieczeństwa przy zmiennym czasie dostawy?
Wzór z normalnym rozkładem popytu w czasie realizacji (z razy pierwiastek z E(L)·σ²d + μ²d·Var(L)) bywa za mały przy długim ogonie. Pewniej jest zasymulować tysiące cykli: losować czas realizacji z historii dostaw, zsumować zużycie w tym czasie i odczytać 95. centyl. W przykładzie wzór dawał 93.3–93.5% cykli bez braku zamiast 95%.
Jak policzyć przedział ufności dla odsetka dostaw w terminie?
Użyj przedziału Wilsona: w R prop.test(x, n, correct = FALSE)$conf.int. Ma lepsze pokrycie niż przedział Walda, zwłaszcza przy odsetkach blisko 100% i kilkuset zamówieniach. Licz terminowość od terminu z oferty, a przesunięty termin raportuj osobno.
Co zrobić z zamówieniami, które jeszcze nie dotarły w dniu analizy?
To obserwacje cenzurowane: wiesz tylko, że dostawa trwa dłużej niż dotąd. Pominięcie ich zaniża czas realizacji ostatnich tygodni – w przykładzie 90. centyl za październik spadł z 24 do 17.4 dnia. Pomiń niekompletne miesiące albo użyj metod analizy przeżycia.
Powiązane hasła
Przeczytaj też
Regresja kwantylowa krok po kroku
Model dla kilku τ, błędy standardowe, wykres współczynników w funkcji τ, test równości nachyleń i porównanie z MNK – na jednym przykładzie w R.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikEfekt byczego bicza
Łańcuch ręczników papierowych: iloraz wariancji zamówień na 4 szczeblach, wzór Chena, partie, promocje i co pomaga – symulacja z kodem R.
Czytaj →PoradnikCzęstość i wysokość szkód – składka
Ubezpieczenie telefonów i laptopów: Poisson z offsetem, regresja gamma, bootstrap składki, Tweedie i Gini na polisach testowych – z kodem R.
Czytaj →Piszesz pracę o dostawcach, zaopatrzeniu albo zapasach?
Pomożemy przygotować dane o zamówieniach, porównać dostawców regresją kwantylową, policzyć terminowość i zapas bezpieczeństwa oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Eppen, G. D., & Martin, R. K. (1988). Determining safety stock in the presence of stochastic lead time and demand. Management Science, 34(11), 1380–1390. https://doi.org/10.1287/mnsc.34.11.1380
- Kocherginsky, M., He, X., & Mu, Y. (2005). Practical confidence intervals for regression quantiles. Journal of Computational and Graphical Statistics, 14(1), 41–55. https://doi.org/10.1198/106186005x27563
- Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143–156. https://doi.org/10.1257/jep.15.4.143
- Leung, K.-M., Elashoff, R. M., & Afifi, A. A. (1997). Censoring issues in survival analysis. Annual Review of Public Health, 18(1), 83–104. https://doi.org/10.1146/annurev.publhealth.18.1.83
- Prak, D., Teunter, R., & Syntetos, A. (2017). On the calculation of safety stocks when demand is forecasted. European Journal of Operational Research, 256(2), 454–461. https://doi.org/10.1016/j.ejor.2016.06.035 ● Otwarty dostęp
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{eppen1988determining, author={Eppen, Gary D. and Martin, R. Kipp}, title={{Determining safety stock in the presence of stochastic lead time and demand}}, journal={Management Science}, year={1988}, volume={34}, number={11}, pages={1380--1390}, doi={10.1287/mnsc.34.11.1380}}@article{kocherginsky2005practical, author={Kocherginsky, Masha and He, Xuming and Mu, Yunming}, title={{Practical confidence intervals for regression quantiles}}, journal={Journal of Computational and Graphical Statistics}, year={2005}, volume={14}, number={1}, pages={41--55}, doi={10.1198/106186005x27563}}@article{koenker2001quantile, author={Koenker, Roger and Hallock, Kevin F.}, title={{Quantile regression}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={143--156}, doi={10.1257/jep.15.4.143}}@article{leung1997censoring, author={Leung, Kwan-Moon and Elashoff, Robert M. and Afifi, Abdelmonem A.}, title={{Censoring issues in survival analysis}}, journal={Annual Review of Public Health}, year={1997}, volume={18}, number={1}, pages={83--104}, doi={10.1146/annurev.publhealth.18.1.83}}@article{prak2017calculation, author={Prak, Dennis and Teunter, Ruud and Syntetos, Aris}, title={{On the calculation of safety stocks when demand is forecasted}}, journal={European Journal of Operational Research}, year={2017}, volume={256}, number={2}, pages={454--461}, doi={10.1016/j.ejor.2016.06.035}}