Przykład: ubezpieczenie telefonów i laptopów
Fikcyjny ubezpieczyciel chroni telefony i laptopy od zbitego ekranu, zalania, awarii i kradzieży. W 2025 r. miał 50 000 polis: część trwała cały rok, część kupiono w ciągu roku, a sprzedaż przez internet ruszyła 1 kwietnia. Razem to 30 146 polisoroków (lat ochrony) i 6 162 szkody o średnim koszcie 752.6 zł.
Dla każdej polisy znamy rodzaj, cenę i wiek urządzenia, kanał sprzedaży (sklep przy zakupie sprzętu, sklep internetowy, „później” – polisa dokupiona do używanego urządzenia), wiek klienta, ekspozycję (część roku pod ochroną) oraz liczbę i koszt szkód. Pytanie działu produktu: ile kosztuje ryzyko jednej polisy na rok, zależnie od jej cech? To składka czysta, czyli wartość oczekiwana kosztu szkód na polisorok – średnio 153.8 zł.
Składkę czystą rozkłada się na dwie części:
Iloczyn jest poprawny, jeśli przy danych cechach polisy liczba szkód i ich koszt są niezależne. Każdą część liczymy osobnym uogólnionym modelem liniowym z łączem logarytmicznym (Nelder i Wedderburn, 1972).
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie), m.in. bazową częstość 0.16 szkody na polisorok, 1.60 razy większą dla polis „później” i 1.50 razy większą dla klientów w wieku 18–25 lat; 5% szkód to szkody całkowite (kradzież, zniszczenie). Ziaren nie zmienialiśmy. Dane: szkody-sprzet-polisy.csv (polisy) i szkody-sprzet-szkody.csv (szkody).
Taryfy i rezerwy ubezpieczeniowe podlegają regulacjom i pracy aktuariusza; ten wpis pokazuje wyłącznie metodę statystyczną na danych fikcyjnych.
Rysunek 1: szkody na polisę czy na polisorok?
Polisa kupiona w październiku chroniła sprzęt przez kwartał. Liczba szkód na polisę miesza ryzyko z długością ochrony.
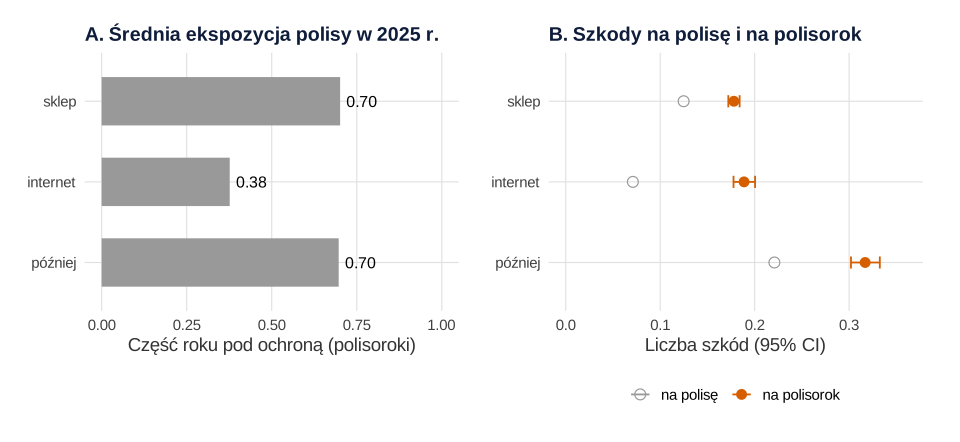
set.seed(761)).Co widać. Polisy z internetu chroniły sprzęt średnio przez 0.38 roku, pozostałe – przez 0.70. Na polisę internet ma najmniej szkód (0.0711 wobec 0.1248 w sklepie). Na polisorok jest odwrotnie: 0.1888, 95% CI [0.1776, 0.2004], wobec 0.1780 [0.1721, 0.1841] w sklepie. Polisy dokupione „później” mają 0.3169 szkody na polisorok, 95% CI [0.3020, 0.3325].
Jak może zmylić. To surowe częstości: kanał „później” to częściej starsze urządzenia. Wpływy cech oddziela dopiero model.
Podpis do pracy:
Częstość: regresja Poissona z offsetem
Ekspozycję wprowadza się do modelu jako offset: log(ekspozycji) ze współczynnikiem ustalonym na 1. Model opisuje wtedy liczbę szkód na polisorok, a exp(b) to iloraz częstości (IRR) (Frome, 1983). Ten sam zabieg na innym przykładzie – skargach na 1000 zamówień – pokazuje wpis o porównywaniu punktów usługowych.
Bez offsetu kanał internetowy dostaje IRR = 0.569, czyli wygląda na o 43% bezpieczniejszy. Z offsetem IRR wynosi 1.060, 95% CI [0.988, 1.138], a prawdziwa wartość to 1.10. Pozostałe współczynniki prawie się nie zmieniają.
Klienci różnią się ostrożnością, której cechy polisy nie opisują, więc wariancja liczby szkód przekracza poissonowską – to nadmierna dyspersja. Statystyka Pearsona / df wynosi tu 1.08 – niewiele, bo większość polis ma zero szkód. Regresja ujemna dwumianowa szacuje parametr θ = 1.66 (SE 0.16) i ma niższe AIC (36 095 wobec 36 260). IRR z obu modeli są prawie takie same (np. 1.624 i 1.620 dla kanału „później”), ale ujemny dwumianowy uwzględnia dodatkową wariancję w błędach standardowych. Procedurę wyboru między modelami dla zliczeń opisuje wpis regresja dla zliczeń krok po kroku.
Wysokość: regresja gamma na samych szkodach
Model wysokości dopasowujemy tylko do polis, na których wystąpiła szkoda – tu do 6 162 pojedynczych szkód. Koszt jest dodatni i prawostronnie skośny: mediana 452.4 zł, średnia 752.6 zł, maksimum 12 000 zł. W regresji gamma z łączem logarytmicznym odchylenie standardowe rośnie razem ze średnią, a exp(b) to iloraz średnich kosztów.
Duże szkody. Kilka kradzieży drogich laptopów potrafi przestawić współczynniki, więc koszt ucinamy na progu 4000 zł, ustalonym przed analizą, a nadwyżkę rozkładamy na wszystkie polisy jako narzut. Powyżej progu było 102 szkody (1.66%) i 3.11% kosztów, więc narzut wynosi 3.21% kosztów uciętych. Próg to decyzja aktuarialna, nie statystyczna; inne sposoby postępowania z ogonem opisuje hasło średnia ucinana i winsoryzacja.
Rysunek 2: co zmienia częstość, a co wysokość
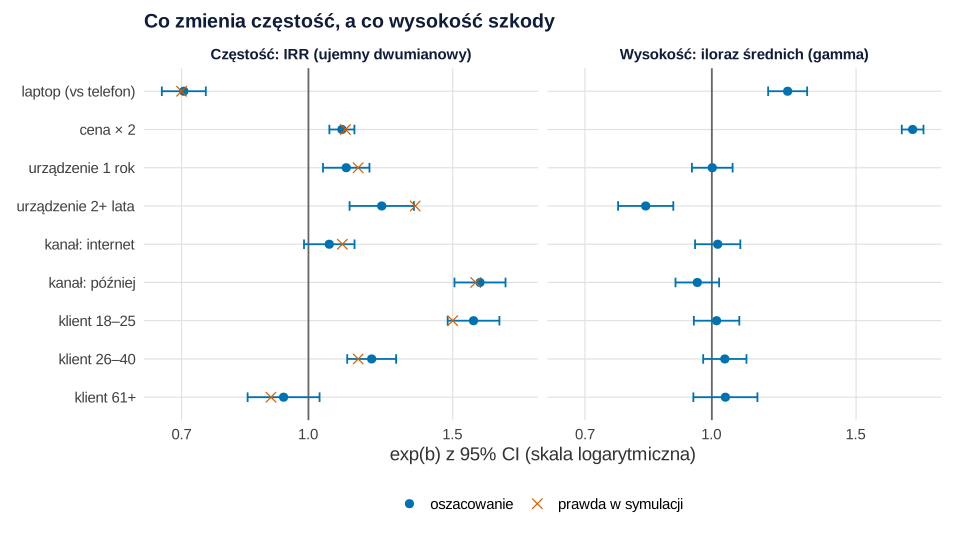
set.seed(761)).Co widać. Wiek klienta i kanał zmieniają tylko częstość: klient 18–25 lat ma IRR = 1.591, 95% CI [1.479, 1.711], polisa „później” – 1.620 [1.508, 1.740]. Cena działa głównie na wysokość: dwa razy droższe urządzenie to szkoda średnio 1.758 razy droższa [1.706, 1.813], a częstość tylko 1.099 razy większa [1.061, 1.138]. Laptop ma rzadsze szkody (IRR = 0.704 [0.662, 0.749]), ale droższe (1.238 [1.172, 1.307]). Urządzenie 2+ lata ma szkody częstsze (1.229), ale tańsze (0.830 [0.768, 0.897]). Osiem z dziewięciu przedziałów częstości obejmuje prawdziwe wartości; dla urządzenia 2+ lata (prawda 1.35) górna granica wynosi 1.345.
Jak może zmylić. W panelu wysokości nie ma krzyżyków, bo prawdziwy koszt to mieszanina napraw i szkód całkowitych. Dlatego iloraz dla laptopa (1.238) jest mniejszy niż ustawione 1.35 dla samych napraw.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czy rozkład gamma pasuje do kosztów?
Z dopasowanego modelu losujemy po jednym koszcie dla każdej szkody i porównujemy ten rozkład z danymi.
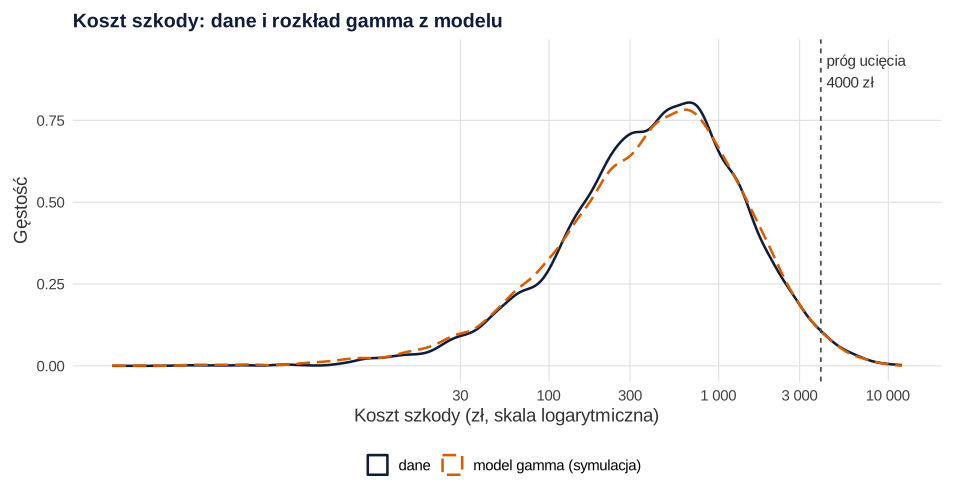
set.seed(7611)).Co widać. Krzywe prawie się pokrywają. Mediana kosztu to 452 zł w danych i 449 zł w modelu, 99. centyl – 4547 i 4507 zł, 99.9. centyl – 7855 i 7713 zł. Szacowany parametr kształtu wynosi 1.17 (dyspersja 0.857), czyli rozrzut jest duży: odchylenie standardowe jest bliskie średniej.
Jak może zmylić. Wykres ukrywa, że 286 szkód całkowitych ma inny mechanizm. Przy większym ich udziale lepszy byłby dla nich osobny model.
Podpis do pracy:
Rysunek 4: składka dla czterech profili
Dla profilu mnożymy przewidywaną częstość (dla roku ochrony) przez przewidywany koszt i przez 1 + narzut. Przedział daje bootstrap polis (Efron, 1979): 300 razy losujemy polisy ze zwracaniem – szkody idą ze swoją polisą – i liczymy od nowa oba modele i narzut.
Dla porównania liczymy jeden model zamiast dwóch: regresję Tweedie kosztu szkód na polisorok z wagą równą ekspozycji. Rozkład Tweedie z 1 < p < 2 to poissonowska liczba szkód o kosztach gamma (Smyth i Jørgensen, 2002). Wybór p i porównanie z modelem dwuczęściowym pokazuje wpis o przychodzie na klienta.
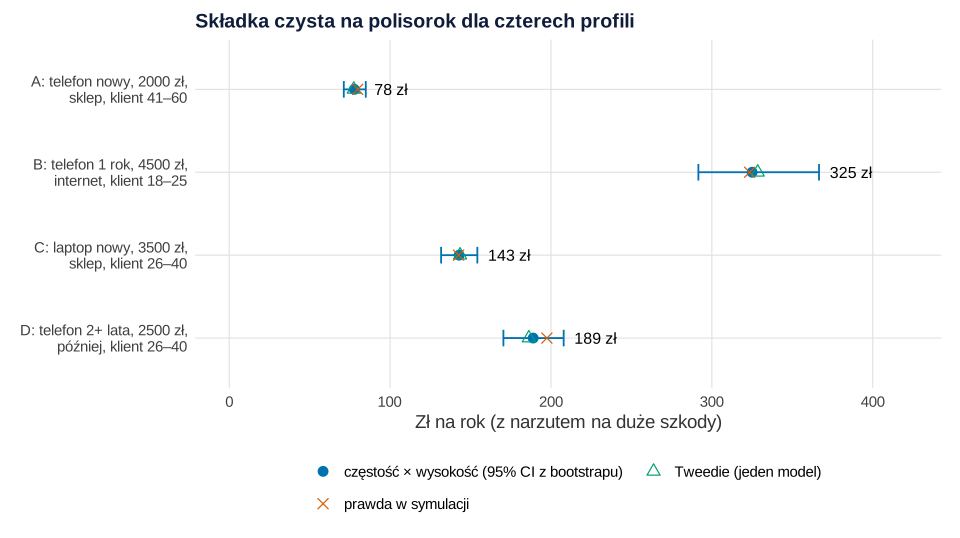
set.seed(7612)).Co widać. Profil A ma składkę 77.8 zł, 95% CI [71.2, 84.9], a profil B – 325.0 zł [291.6, 366.6], czyli ponad cztery razy więcej. W B składa się na to wysoka częstość (0.328 na rok) i wysoki koszt szkody (961.5 zł). Laptop C ma rzadkie, ale drogie szkody: 0.142 × 975.0 zł daje 142.9 zł [131.7, 154.2]. Tweedie (p = 1.508) daje prawie to samo (77.4–328.5 zł), a prawdziwe składki mieszczą się we wszystkich przedziałach.
Jak może zmylić. Przedział dotyczy średniej, a nie kosztu pojedynczego klienta – ten zwykle wynosi 0 zł albo kilkaset złotych.
Podpis do pracy:
Rysunek 5: czy model rozróżnia ryzyko? Krzywa Lorenza i Gini
Dobra taryfa odróżnia polisy ryzykowne od bezpiecznych. Modele dopasowujemy na losowych 70% polis, a oceniamy na pozostałych 30%. Polisy testowe porządkujemy od najniższej składki z modelu i rysujemy uporządkowaną krzywą Lorenza: skumulowany udział polisoroków (czyli składki płaskiej, jednakowej dla wszystkich) na osi poziomej i skumulowany udział kosztów szkód na pionowej. Wskaźnik Giniego to dwukrotność pola między krzywą a przekątną (Frees i in., 2011).
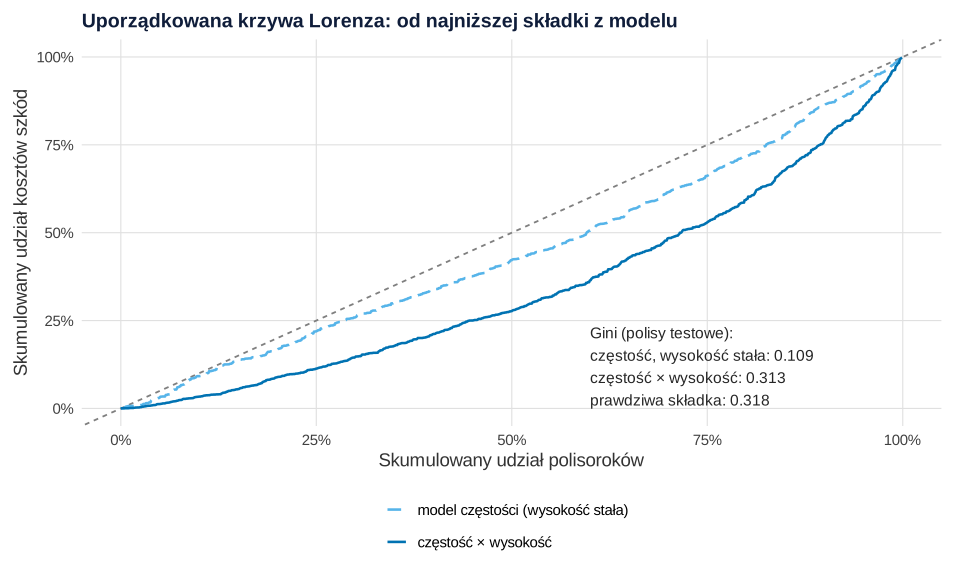
set.seed(7613)).Co widać. Sama częstość rozróżnia ryzyko słabo: Gini = 0.109, 95% CI [0.059, 0.152]. Model częstość × wysokość osiąga 0.313 [0.276, 0.350], prawie tyle co prawdziwa składka znana z symulacji (0.318). Wysokość szkody podnosi Giniego o 0.204 [0.158, 0.252], bo cena działa głównie na koszt szkody. W kwintylach składki z modelu koszty szkód na polisorok rosną od 70.7 do 319.9 zł, przy składkach od 58.1 do 298.7 zł.
Jak może zmylić. Gini mierzy kolejność, nie poziom – podwojenie wszystkich składek go nie zmienia. Dlatego sprawdź też iloraz szkód do składki w grupach (tu od 0.93 do 1.22 w kwintylach). Przedziały z bootstrapu polis testowych pomijają niepewność dopasowania modeli.
Podpis do pracy:
Rysunek 6: karta „składka = częstość × wysokość”
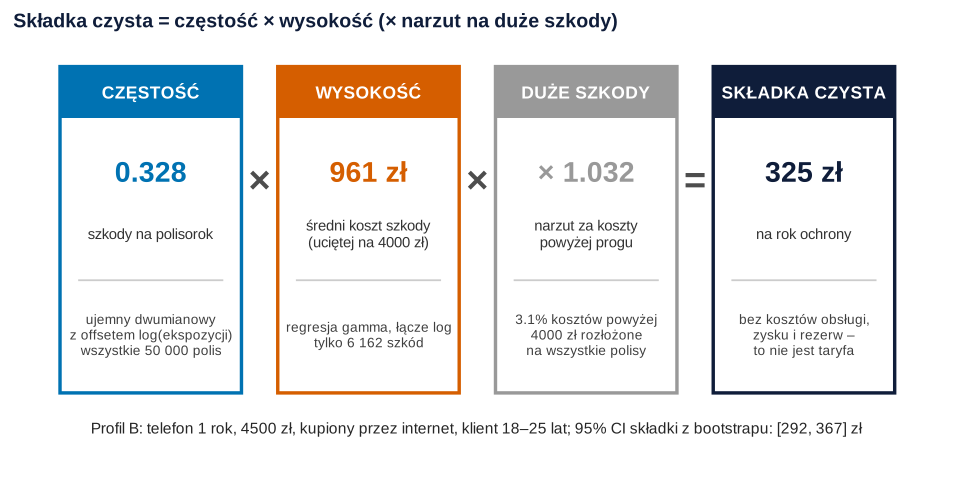
set.seed(761) i set.seed(7612)).Co widać. Każda liczba ma inną próbę: częstość – wszystkie polisy, wysokość – tylko szkody, narzut – tylko ogon.
Jak może zmylić. Składka czysta nie jest ceną – do taryfy dochodzą koszty, marża i korekty spoza modelu.
Co z tym zrobić w firmie
- Zawsze licz na polisorok. Model bez offsetu dał tu nowemu kanałowi internetowemu fałszywą, 43-procentową przewagę.
- Raportuj częstość i wysokość osobno. Młody klient to głównie częstość, a drogi sprzęt – wysokość; to podpowiada różne działania, np. udział własny w szkodzie przy drogim sprzęcie.
- Ustal próg dużych szkód przed analizą i opisz, jak rozkładasz nadwyżkę.
- Oceniaj model na danych, których nie widział: wskaźnikiem Giniego (kolejność) i ilorazem szkód do składki w grupach (poziom).
- Dla małych grup użyj wiarygodności. Gdy grupa klientów ma za mało polisoroków na własną częstość, łącz jej doświadczenie ze średnią portfela – zob. wiarygodność Bühlmanna. Szkody zgłoszone później, które w danych jeszcze nie są wypłacone, opisuje wpis o trójkącie szkód i rezerwach.
Jak opisać w pracy
Ogólne wskazówki: statystyka w pracy z finansów i rachunkowości. Analizę rozkładu skośnej zmiennej przez kwantyle zamiast średniej pokazuje sąsiedni wpis o czasie realizacji dostaw.
| Profil | Częstość na rok | Średni koszt szkody, zł | Składka czysta, zł [95% CI] | Tweedie, zł |
|---|---|---|---|---|
| A: telefon nowy, 2000 zł, sklep, 41–60 lat | 0.156 | 481.6 | 77.8 [71.2, 84.9] | 77.4 |
| B: telefon 1 rok, 4500 zł, internet, 18–25 lat | 0.328 | 961.5 | 325.0 [291.6, 366.6] | 328.5 |
| C: laptop nowy, 3500 zł, sklep, 26–40 lat | 0.142 | 975.0 | 142.9 [131.7, 154.2] | 143.5 |
| D: telefon 2+ lata, 2500 zł, później, 26–40 lat | 0.383 | 477.5 | 188.9 [170.4, 207.9] | 186.2 |
Kod R: dane, częstość, wysokość, składka i Gini
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Ziarna: dane – set.seed(761), losowanie kosztów z modelu gamma (Rysunek 3) – set.seed(7611), bootstrap składki – set.seed(7612), podział na próbę uczącą i testową – set.seed(7613), bootstrap Giniego (1000 powtórzeń) – set.seed(7614). Ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 50 000 polis (62% telefonów), ceny z rozkładu lognormalnego (mediana 2200 zł dla telefonów i 3600 zł dla laptopów, przycięte do 400–12 000 zł), udziały kanałów (55% sklep, 30% internet, 15% później), wiek urządzenia zależny od kanału, udziały grup wieku klienta (22, 38, 28 i 12%), 40% kontynuacji z pełną ekspozycją i start kanału internetowego 1 kwietnia, bazową częstość 0.16 na polisorok, ilorazy częstości (laptop 0.70, urządzenie 1 rok 1.15, 2+ lata 1.35, internet 1.10, później 1.60, klient 18–25 lat 1.50, 26–40 lat 1.15, 61+ lat 0.90), współczynnik 0.15 przy log(ceny/2000), niejednorodność klientów z rozkładu gamma o kształcie 1.5, średni koszt naprawy 420 zł dla telefonu za 2000 zł z elastycznością 0.8 względem ceny (laptop × 1.35, urządzenie 2+ lata × 0.85), kształt rozkładu gamma 1.3, 5% szkód całkowitych wypłacanych w wysokości ceny × 1, 0.8 lub 0.6 (zależnie od wieku urządzenia) i próg ucięcia 4000 zł. Po pierwszym uruchomieniu zmieniono tylko analizę, nie dane: cenę w modelach wpisano jako log2 zamiast log (iloraz dla ceny dwa razy wyższej), liczbę powtórzeń bootstrapu składki zmniejszono z 400 do 300 (czas liczenia), a z porównania na Rysunku 5 usunięto model z samym rodzajem urządzenia, bo przy dwóch wartościach składki kolejność polis w grupach jest dowolna i Gini nie jest jednoznaczny. Przepis 1 zapisuje dane do dwóch plików CSV w katalogu roboczym. Cały kod liczy się ok. 40 s, z czego najwięcej bootstrap w przepisie 4.
1. Dane: polisy, ekspozycja i szkody w 2025 r.
R
# Przepis 1. Fikcyjny ubezpieczyciel sprzętu elektronicznego: 50 000 polis w 2025 r., szkody i ich koszty
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (prawdziwy model, którego w realnych danych nie znamy)
N <- 50000
lambda0 <- 0.16                                       # szkody na polisorok: telefon nowy, 2000 zł, sklep, klient 41–60 lat
irr_prawda <- c(laptop = 0.70, wiek_urz_1 = 1.15, wiek_urz_2 = 1.35, internet = 1.10, pozniej = 1.60,
                k18_25 = 1.50, k26_40 = 1.15, k61 = 0.90)
b_cena_czest <- 0.15                                  # częstość: + 0.15 na jednostkę log(cena / 2000)
theta <- 1.5                                          # niejednorodność klientów (rozkład gamma, średnia 1)
sev0 <- 420                                           # średni koszt naprawy (zł): telefon nowy, 2000 zł
b_cena_sev <- 0.80                                    # elastyczność kosztu naprawy względem ceny
sev_laptop <- 1.35; sev_wiek2 <- 0.85                 # iloraz średnich: laptop, urządzenie 2+ lata
ksztalt <- 1.3                                        # kształt rozkładu gamma kosztu naprawy
p_kradziez <- 0.05                                    # odsetek szkód całkowitych (kradzież, zniszczenie)

set.seed(761)
polisy <- data.frame(id = 1:N)
polisy$urzadzenie <- factor(sample(c("telefon", "laptop"), N, TRUE, c(0.62, 0.38)), c("telefon", "laptop"))
polisy$cena <- round(ifelse(polisy$urzadzenie == "telefon", exp(rnorm(N, log(2200), 0.55)),
                            exp(rnorm(N, log(3600), 0.45))), -1)
polisy$cena <- pmin(pmax(polisy$cena, 400), 12000)
polisy$kanal <- factor(sample(c("sklep", "internet", "później"), N, TRUE, c(0.55, 0.30, 0.15)),
                       c("sklep", "internet", "później"))
# wiek urządzenia: przy zakupie w sklepie i w internecie zwykle nowe, „później” – starsze
polisy$wiek_urz <- factor(ifelse(polisy$kanal == "później", sample(c("0", "1", "2+"), N, TRUE, c(0.2, 0.5, 0.3)),
                                 sample(c("0", "1", "2+"), N, TRUE, c(0.75, 0.2, 0.05))), c("0", "1", "2+"))
polisy$wiek_klienta <- factor(sample(c("18–25", "26–40", "41–60", "61+"), N, TRUE, c(0.22, 0.38, 0.28, 0.12)),
                              c("41–60", "18–25", "26–40", "61+"))
# ekspozycja: polisy kontynuowane cały rok; nowe od daty zakupu; kanał internetowy ruszył 1 kwietnia 2025
start <- ifelse(runif(N) < 0.40, 0, runif(N, 0, 1))
start[polisy$kanal == "internet"] <- runif(sum(polisy$kanal == "internet"), 0.25, 1)
polisy$ekspozycja <- round(pmax(1 - start, 1 / 365), 4)   # część roku 2025 pod ochroną (polisoroki)

lp <- log(lambda0) + b_cena_czest * log(polisy$cena / 2000) +
  log(ifelse(polisy$urzadzenie == "laptop", irr_prawda[["laptop"]], 1)) +
  log(c("0" = 1, "1" = irr_prawda[["wiek_urz_1"]], "2+" = irr_prawda[["wiek_urz_2"]])[as.character(polisy$wiek_urz)]) +
  log(c(sklep = 1, internet = irr_prawda[["internet"]], "później" = irr_prawda[["pozniej"]])[as.character(polisy$kanal)]) +
  log(c("41–60" = 1, "18–25" = irr_prawda[["k18_25"]], "26–40" = irr_prawda[["k26_40"]],
        "61+" = irr_prawda[["k61"]])[as.character(polisy$wiek_klienta)])
polisy$czestosc_prawda <- exp(lp)                     # oczekiwane szkody na polisorok (prawda)
polisy$liczba_szkod <- rpois(N, polisy$czestosc_prawda * rgamma(N, theta, theta) * polisy$ekspozycja)

# Koszt każdej szkody: naprawa ~ gamma, część szkód całkowita (kradzież) = cena po amortyzacji
mu_naprawy <- sev0 * (polisy$cena / 2000)^b_cena_sev * ifelse(polisy$urzadzenie == "laptop", sev_laptop, 1) *
  ifelse(polisy$wiek_urz == "2+", sev_wiek2, 1)
amort <- c("0" = 1, "1" = 0.8, "2+" = 0.6)[as.character(polisy$wiek_urz)]
polisy$wysokosc_prawda <- (1 - p_kradziez) * mu_naprawy + p_kradziez * polisy$cena * amort
idx <- rep(polisy$id, polisy$liczba_szkod)
calk <- runif(length(idx)) < p_kradziez
szkody <- data.frame(id = idx, rodzaj = ifelse(calk, "całkowita", "naprawa"),
                     koszt = round(ifelse(calk, polisy$cena[idx] * amort[idx],
                                          rgamma(length(idx), ksztalt, ksztalt / mu_naprawy[idx])), 2))
szkody <- cbind(szkody, polisy[idx, c("urzadzenie", "cena", "kanal", "wiek_urz", "wiek_klienta")])
polisy$suma_szkod <- as.numeric(tapply(szkody$koszt, factor(szkody$id, levels = polisy$id), sum, default = 0))
polisy$skladka_prawda <- polisy$czestosc_prawda * polisy$wysokosc_prawda   # składka czysta na polisorok (prawda)

write.csv(polisy[, c("id", "urzadzenie", "cena", "kanal", "wiek_urz", "wiek_klienta", "ekspozycja",
                     "liczba_szkod", "suma_szkod")], "szkody-sprzet-polisy.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(szkody[, c("id", "rodzaj", "koszt")], "szkody-sprzet-szkody.csv", row.names = FALSE, fileEncoding = "UTF-8")

data.frame(polisy = N, polisoroki = round(sum(polisy$ekspozycja)), szkody = nrow(szkody),
           czestosc = round(nrow(szkody) / sum(polisy$ekspozycja), 4), sredni_koszt = round(mean(szkody$koszt), 1),
           skladka_czysta = round(sum(szkody$koszt) / sum(polisy$ekspozycja), 1),
           ze_szkoda_proc = round(100 * mean(polisy$liczba_szkod > 0), 2))
Wynik w R
  polisy polisoroki szkody czestosc sredni_koszt skladka_czysta ze_szkoda_proc
1  50000      30146   6162   0.2044        752.6          153.8          10.77
2. Częstość: ekspozycja, Poisson z offsetem i ujemny dwumianowy – Rysunek 1
R
# Przepis 2. Częstość szkód: ekspozycja, regresja Poissona z offsetem i ujemna dwumianowa – Rysunek 1
# Korzysta z obiektów polisy, kol, motyw i minus() (przepis 1).
library(MASS)
library(patchwork)

# Surowo: szkody na polisę a szkody na polisorok w kanałach sprzedaży
kan <- do.call(rbind, lapply(split(polisy, polisy$kanal), function(x) {
  n <- sum(x$liczba_szkod); e <- sum(x$ekspozycja)
  data.frame(kanal = x$kanal[1], polisy = nrow(x), sr_ekspozycja = mean(x$ekspozycja), szkody = n,
             na_polise = n / nrow(x), na_polisorok = n / e,
             dol = qchisq(0.025, 2 * n) / 2 / e, gora = qchisq(0.975, 2 * n + 2) / 2 / e)  # dokładny CI Poissona
}))
rownames(kan) <- NULL
cbind(kan[1:2], round(kan[3], 3), kan[4], round(kan[5:8], 4))

wzor <- liczba_szkod ~ urzadzenie + log2(cena / 2000) + wiek_urz + kanal + wiek_klienta
m_bez <- glm(wzor, family = poisson, data = polisy)                                  # bez offsetu (błąd)
m_poi <- glm(update(wzor, . ~ . + offset(log(ekspozycja))), family = poisson, data = polisy)
m_nb <- glm.nb(update(wzor, . ~ . + offset(log(ekspozycja))), data = polisy)

# Nadrozproszenie w modelu Poissona: statystyka Pearsona / stopnie swobody (≈ 1, gdy Poisson pasuje)
data.frame(pearson_df = round(sum(residuals(m_poi, "pearson")^2) / df.residual(m_poi), 3),
           theta_nb = round(m_nb$theta, 2), theta_se = round(m_nb$SE.theta, 2),
           AIC_poisson = round(AIC(m_poi), 1), AIC_nb = round(AIC(m_nb), 1))

# Ilorazy częstości (IRR) z 95% CI: bez offsetu, Poisson z offsetem, ujemny dwumianowy z offsetem
irr <- function(m) {
  s <- summary(m)$coefficients[-1, ]
  data.frame(wsp = rownames(s), irr = exp(s[, 1]), dol = exp(s[, 1] - 1.96 * s[, 2]), gora = exp(s[, 1] + 1.96 * s[, 2]))
}
tab <- merge(merge(irr(m_bez)[1:2], irr(m_poi)[1:2], by = "wsp", suffixes = c("_bez", "_poisson")),
             irr(m_nb), by = "wsp")
names(tab)[4:6] <- c("irr_nb", "dol_nb", "gora_nb")
cbind(tab[1], round(tab[-1], 3))

kan$kanal_et <- factor(kan$kanal, levels = rev(levels(polisy$kanal)))
pA <- ggplot(kan, aes(sr_ekspozycja, kanal_et)) +
  geom_col(fill = kol[["szary"]], width = 0.6) +
  geom_text(aes(label = sprintf("%.2f", sr_ekspozycja)), hjust = -0.2, size = 4.2) +
  scale_x_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(title = "A. Średnia ekspozycja polisy w 2025 r.", x = "Część roku pod ochroną (polisoroki)", y = NULL) +
  motyw
dl <- rbind(data.frame(kanal_et = kan$kanal_et, miara = "na polisę", wartosc = kan$na_polise, dol = NA, gora = NA),
            data.frame(kanal_et = kan$kanal_et, miara = "na polisorok", wartosc = kan$na_polisorok,
                       dol = kan$dol, gora = kan$gora))
pB <- ggplot(dl, aes(wartosc, kanal_et, colour = miara, shape = miara)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.15, orientation = "y", na.rm = TRUE) +
  geom_point(size = 3.4) +
  scale_colour_manual(values = c("na polisę" = kol[["szary"]], "na polisorok" = kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c("na polisę" = 1, "na polisorok" = 16), name = NULL) +
  scale_x_continuous(limits = c(0, 0.36)) +
  labs(title = "B. Szkody na polisę i na polisorok", x = "Liczba szkód (95% CI)", y = NULL) +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("szkody-ekspozycja-kanaly.svg", p1, width = 10, height = 4.6)
Wynik w R
     kanal polisy sr_ekspozycja szkody na_polise na_polisorok    dol   gora
1    sklep  27374         0.701   3417    0.1248       0.1780 0.1721 0.1841
2 internet  15039         0.377   1069    0.0711       0.1888 0.1776 0.2004
3  później   7587         0.697   1676    0.2209       0.3169 0.3020 0.3325
  pearson_df theta_nb theta_se AIC_poisson AIC_nb
1       1.08     1.66     0.16       36260  36095
                wsp irr_bez irr_poisson irr_nb dol_nb gora_nb
1     kanalinternet   0.569       1.060  1.060  0.988   1.138
2      kanalpóźniej   1.616       1.624  1.620  1.508   1.740
3   log2(cena/2000)   1.094       1.099  1.099  1.061   1.138
4  urzadzenielaptop   0.699       0.704  0.704  0.662   0.749
5 wiek_klienta18–25   1.613       1.593  1.591  1.479   1.711
6 wiek_klienta26–40   1.204       1.193  1.194  1.115   1.279
7   wiek_klienta61+   0.934       0.930  0.933  0.843   1.032
8         wiek_urz1   1.115       1.110  1.112  1.042   1.187
9        wiek_urz2+   1.221       1.224  1.229  1.123   1.345
3. Wysokość: ucięcie dużych szkód i regresja gamma – Rysunki 2 i 3
R
# Przepis 3. Wysokość szkody: regresja gamma z łączem log, duże szkody i ucięcie – Rysunki 2 i 3
# Korzysta z obiektów polisy, szkody, irr_prawda, m_nb, irr() (przepisy 1–2), kol, motyw i minus().
prog <- 4000                                          # próg ucięcia szkody (zł), ustalony przed analizą
szkody$koszt_u <- pmin(szkody$koszt, prog)
nad <- sum(szkody$koszt - szkody$koszt_u)              # część kosztów powyżej progu
narzut <- nad / sum(szkody$koszt_u)                    # rozkładana na wszystkie polisy jako narzut
data.frame(szkody = nrow(szkody), powyzej_progu = sum(szkody$koszt > prog),
           proc_szkod = round(100 * mean(szkody$koszt > prog), 2),
           proc_kosztow = round(100 * nad / sum(szkody$koszt), 2), narzut_proc = round(100 * narzut, 2),
           calkowite = sum(szkody$rodzaj == "całkowita"), mediana = round(median(szkody$koszt), 1),
           srednia = round(mean(szkody$koszt), 1), maks = max(szkody$koszt))

wzor_s <- koszt_u ~ urzadzenie + log2(cena / 2000) + wiek_urz + kanal + wiek_klienta
m_gam <- glm(wzor_s, family = Gamma(link = "log"), data = szkody)
m_gam_pelny <- glm(update(wzor_s, koszt ~ .), family = Gamma(link = "log"), data = szkody)  # bez ucięcia
c(dyspersja = round(summary(m_gam)$dispersion, 3), ksztalt = round(1 / summary(m_gam)$dispersion, 2),
  dyspersja_bez_uciecia = round(summary(m_gam_pelny)$dispersion, 3))
ilo <- function(m) {                                  # ilorazy średnich exp(b) z 95% CI (Wald, SE z dyspersją)
  s <- summary(m)$coefficients[-1, ]
  data.frame(wsp = rownames(s), exp_b = exp(s[, 1]), dol = exp(s[, 1] - 1.96 * s[, 2]),
             gora = exp(s[, 1] + 1.96 * s[, 2]), p = s[, 4])
}
sev <- ilo(m_gam); rownames(sev) <- NULL
cbind(sev[1], round(sev[2:4], 3), p = signif(sev$p, 2))

# Rysunek 2: współczynniki obu modeli obok prawdziwych wartości z symulacji
nazwy <- c(urzadzenielaptop = "laptop (vs telefon)", "log2(cena/2000)" = "cena × 2",
           wiek_urz1 = "urządzenie 1 rok", "wiek_urz2+" = "urządzenie 2+ lata", kanalinternet = "kanał: internet",
           "kanalpóźniej" = "kanał: później", "wiek_klienta18–25" = "klient 18–25", "wiek_klienta26–40" = "klient 26–40",
           "wiek_klienta61+" = "klient 61+")
prawda_cz <- c(urzadzenielaptop = irr_prawda[["laptop"]], "log2(cena/2000)" = 2^b_cena_czest,
               wiek_urz1 = irr_prawda[["wiek_urz_1"]], "wiek_urz2+" = irr_prawda[["wiek_urz_2"]],
               kanalinternet = irr_prawda[["internet"]], "kanalpóźniej" = irr_prawda[["pozniej"]],
               "wiek_klienta18–25" = irr_prawda[["k18_25"]], "wiek_klienta26–40" = irr_prawda[["k26_40"]],
               "wiek_klienta61+" = irr_prawda[["k61"]])
wsp <- rbind(data.frame(model = "Częstość: IRR (ujemny dwumianowy)", irr(m_nb)[, 1:4],
                        prawda = prawda_cz[irr(m_nb)$wsp]),
             data.frame(model = "Wysokość: iloraz średnich (gamma)", setNames(sev[, 1:4], c("wsp", "irr", "dol", "gora")),
                        prawda = NA))
wsp$etykieta <- factor(nazwy[wsp$wsp], levels = rev(nazwy))
p2 <- ggplot(wsp, aes(irr, etykieta)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(aes(shape = "oszacowanie"), size = 2.8, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda, shape = "prawda w symulacji"), size = 3, colour = kol[["pomaranczowy"]], na.rm = TRUE) +
  scale_shape_manual(values = c("oszacowanie" = 16, "prawda w symulacji" = 4), name = NULL) +
  scale_x_log10(breaks = c(0.5, 0.7, 1, 1.5, 2, 3)) +
  facet_wrap(~model) +
  labs(title = "Co zmienia częstość, a co wysokość szkody", x = "exp(b) z 95% CI (skala logarytmiczna)", y = NULL) +
  motyw
p2   # zapis: ggsave("szkody-wspolczynniki.svg", p2, width = 10, height = 5.6)

# Rysunek 3: rozkład kosztu szkody – dane a rozkład gamma z modelu (symulacja z dopasowanych średnich)
set.seed(7611)
k_hat <- 1 / summary(m_gam_pelny)$dispersion
sym <- rgamma(nrow(szkody), k_hat, k_hat / fitted(m_gam_pelny))
porown <- rbind(data.frame(zrodlo = "dane", koszt = szkody$koszt),
                data.frame(zrodlo = "model gamma (symulacja)", koszt = sym))
q <- sapply(c(0.5, 0.9, 0.99, 0.999), function(a) c(dane = unname(quantile(szkody$koszt, a)), model = unname(quantile(sym, a))))
colnames(q) <- c("q50", "q90", "q99", "q99.9"); round(q)
p3 <- ggplot(porown, aes(koszt, colour = zrodlo, linetype = zrodlo)) +
  geom_density(linewidth = 0.9, adjust = 0.8) +
  geom_vline(xintercept = prog, linetype = "22", colour = "grey30") +
  annotate("text", x = prog * 1.08, y = 0.95, label = sprintf("próg ucięcia\n%d zł", prog), hjust = 0, vjust = 1,
           size = 4, colour = "grey20") +
  scale_colour_manual(values = c("dane" = kol[["granat"]], "model gamma (symulacja)" = kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("dane" = "solid", "model gamma (symulacja)" = "42"), name = NULL) +
  scale_x_log10(breaks = c(30, 100, 300, 1000, 3000, 10000), labels = function(x) format(x, big.mark = " ")) +
  labs(title = "Koszt szkody: dane i rozkład gamma z modelu", x = "Koszt szkody (zł, skala logarytmiczna)",
       y = "Gęstość") +
  motyw
p3   # zapis: ggsave("szkody-wysokosc-rozklad.svg", p3, width = 10, height = 5.2)
Wynik w R
  szkody powyzej_progu proc_szkod proc_kosztow narzut_proc calkowite mediana srednia  maks
1   6162           102       1.66         3.11        3.21       286   452.4   752.6 12000
            dyspersja               ksztalt dyspersja_bez_uciecia
                0.857                 1.170                 0.900
                wsp exp_b   dol  gora        p
1  urzadzenielaptop 1.238 1.172 1.307  2.9e-14
2   log2(cena/2000) 1.758 1.706 1.813 3.5e-261
3         wiek_urz1 1.001 0.946 1.060  9.7e-01
4        wiek_urz2+ 0.830 0.768 0.897  2.7e-06
5     kanalinternet 1.017 0.954 1.083  6.1e-01
6      kanalpóźniej 0.960 0.903 1.021  1.9e-01
7 wiek_klienta18–25 1.013 0.951 1.080  6.8e-01
8 wiek_klienta26–40 1.037 0.976 1.102  2.4e-01
9   wiek_klienta61+ 1.039 0.949 1.137  4.1e-01
      q50  q90  q99 q99.9
dane  452 1741 4547  7855
model 449 1775 4507  7713
4. Składka dla profili, bootstrap polis i Tweedie – Rysunek 4
R
# Przepis 4. Składka czysta dla profili = częstość × wysokość × (1 + narzut), CI z bootstrapu polis, Tweedie – Rysunek 4
# Korzysta z obiektów polisy, szkody, m_poi, m_nb (przepis 2), m_gam, prog, narzut (przepis 3), kol, motyw.
library(mgcv)
profile <- data.frame(
  profil = c("A: telefon nowy, 2000 zł,\nsklep, klient 41–60", "B: telefon 1 rok, 4500 zł,\ninternet, klient 18–25",
             "C: laptop nowy, 3500 zł,\nsklep, klient 26–40", "D: telefon 2+ lata, 2500 zł,\npóźniej, klient 26–40"),
  urzadzenie = factor(c("telefon", "telefon", "laptop", "telefon"), levels(polisy$urzadzenie)),
  cena = c(2000, 4500, 3500, 2500), wiek_urz = factor(c("0", "1", "0", "2+"), levels(polisy$wiek_urz)),
  kanal = factor(c("sklep", "internet", "sklep", "później"), levels(polisy$kanal)),
  wiek_klienta = factor(c("41–60", "18–25", "26–40", "26–40"), levels(polisy$wiek_klienta)), ekspozycja = 1)
skladka <- function(m_cz, m_w, nowe, narzut) {
  cz <- predict(m_cz, nowe, type = "response")          # szkody na polisorok (offset = log 1 = 0)
  w <- predict(m_w, nowe, type = "response")            # średni koszt szkody uciętej (zł)
  data.frame(czestosc = cz, wysokosc = w, skladka = cz * w * (1 + narzut))
}
wyn <- cbind(profil = sub("\n", " ", profile$profil), skladka(m_nb, m_gam, profile, narzut))
# prawdziwa składka czysta z parametrów symulacji (dla tych samych profili)
lp_p <- log(lambda0) + b_cena_czest * log(profile$cena / 2000) +
  log(c(telefon = 1, laptop = irr_prawda[["laptop"]])[as.character(profile$urzadzenie)]) +
  log(c("0" = 1, "1" = irr_prawda[["wiek_urz_1"]], "2+" = irr_prawda[["wiek_urz_2"]])[as.character(profile$wiek_urz)]) +
  log(c(sklep = 1, internet = irr_prawda[["internet"]], "później" = irr_prawda[["pozniej"]])[as.character(profile$kanal)]) +
  log(c("41–60" = 1, "18–25" = irr_prawda[["k18_25"]], "26–40" = irr_prawda[["k26_40"]],
        "61+" = irr_prawda[["k61"]])[as.character(profile$wiek_klienta)])
mu_n <- sev0 * (profile$cena / 2000)^b_cena_sev * ifelse(profile$urzadzenie == "laptop", sev_laptop, 1) *
  ifelse(profile$wiek_urz == "2+", sev_wiek2, 1)
am <- c("0" = 1, "1" = 0.8, "2+" = 0.6)[as.character(profile$wiek_urz)]
wyn$prawda <- exp(lp_p) * ((1 - p_kradziez) * mu_n + p_kradziez * profile$cena * am)

# Bootstrap polis: losujemy polisy ze zwracaniem (szkody idą razem ze swoją polisą) i liczymy oba modele od nowa.
# Wagi = ile razy polisa trafiła do próby (to samo co powielenie wierszy, ale szybciej); częstość – Poisson
# z offsetem (ta sama średnia co ujemny dwumianowy, a niepewność z nadrozproszenia niesie sam bootstrap).
X_cz <- model.matrix(m_poi); off <- log(polisy$ekspozycja); y_cz <- polisy$liczba_szkod
X_w <- model.matrix(m_gam); y_w <- szkody$koszt_u; wiersz_polisy <- match(szkody$id, polisy$id)
X_prof <- model.matrix(delete.response(terms(m_poi)), profile)
B <- 300
set.seed(7612)
boot_skl <- t(replicate(B, {
  w <- tabulate(sample.int(nrow(polisy), replace = TRUE), nrow(polisy))
  b_cz <- glm.fit(X_cz, y_cz, weights = w, offset = off, family = poisson())$coefficients
  ws <- w[wiersz_polisy]
  b_w <- glm.fit(X_w, y_w, weights = ws, family = Gamma(link = "log"))$coefficients
  narz <- sum(ws * (szkody$koszt - y_w)) / sum(ws * y_w)
  as.vector(exp(X_prof %*% b_cz) * exp(X_prof %*% b_w) * (1 + narz))
}))
wyn$dol <- apply(boot_skl, 2, quantile, 0.025); wyn$gora <- apply(boot_skl, 2, quantile, 0.975)

# Jeden model zamiast dwóch: regresja Tweedie (parametr mocy p szacowany) na kosztach uciętych na polisorok
polisy$suma_u <- as.numeric(tapply(szkody$koszt_u, factor(szkody$id, levels = polisy$id), sum, default = 0))
m_tw <- gam(I(suma_u / ekspozycja) ~ urzadzenie + log2(cena / 2000) + wiek_urz + kanal + wiek_klienta,
            family = tw(link = "log"), weights = ekspozycja, data = polisy, method = "ML")
p_tw <- m_tw$family$getTheta(TRUE)
wyn$tweedie <- predict(m_tw, profile, type = "response") * (1 + narzut)
c(p_tweedie = round(p_tw, 3), B = B)
cbind(wyn[1], czestosc = round(wyn$czestosc, 3), round(wyn[3:8], 1))

wyk <- data.frame(profil = factor(profile$profil, rev(profile$profil)), wyn[, c("skladka", "dol", "gora", "prawda", "tweedie")])
p4 <- ggplot(wyk, aes(y = profil)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(aes(x = skladka, shape = "częstość × wysokość (95% CI z bootstrapu)"), size = 3.4, colour = kol[["niebieski"]]) +
  geom_point(aes(x = tweedie, shape = "Tweedie (jeden model)"), size = 3, colour = kol[["zielony"]]) +
  geom_point(aes(x = prawda, shape = "prawda w symulacji"), size = 3.2, colour = kol[["pomaranczowy"]]) +
  geom_text(aes(x = gora, label = sprintf("%.0f zł", skladka)), hjust = -0.25, size = 4.2) +
  scale_shape_manual(values = c("częstość × wysokość (95% CI z bootstrapu)" = 16, "Tweedie (jeden model)" = 2,
                                "prawda w symulacji" = 4), name = NULL) +
  scale_x_continuous(limits = c(0, max(wyk$gora) * 1.15)) +
  guides(shape = guide_legend(nrow = 2)) +
  labs(title = "Składka czysta na polisorok dla czterech profili", x = "Zł na rok (z narzutem na duże szkody)", y = NULL) +
  motyw
p4   # zapis: ggsave("szkody-skladka-profile.svg", p4, width = 10, height = 5.6)
Wynik w R
p_tweedie         B
    1.508   300.000
                                              profil czestosc wysokosc skladka prawda   dol  gora tweedie
1      A: telefon nowy, 2000 zł, sklep, klient 41–60    0.156    481.6    77.8   79.8  71.2  84.9    77.4
2  B: telefon 1 rok, 4500 zł, internet, klient 18–25    0.328    961.5   325.0  323.4 291.6 366.6   328.5
3       C: laptop nowy, 3500 zł, sklep, klient 26–40    0.142    975.0   142.9  142.6 131.7 154.2   143.5
4 D: telefon 2+ lata, 2500 zł, później, klient 26–40    0.383    477.5   188.9  197.4 170.4 207.9   186.2
5. Uporządkowana krzywa Lorenza i wskaźnik Giniego – Rysunek 5
R
# Przepis 5. Czy model rozróżnia ryzyko? Uporządkowana krzywa Lorenza i wskaźnik Giniego na polisach testowych – Rysunek 5
# Korzysta z obiektów polisy, szkody, prog (przepisy 1, 3), kol, motyw.
set.seed(7613)
polisy$zbior <- ifelse(runif(nrow(polisy)) < 0.7, "uczacy", "testowy")
ucz <- polisy[polisy$zbior == "uczacy", ]; test <- polisy[polisy$zbior == "testowy", ]
sz_ucz <- szkody[szkody$id %in% ucz$id, ]
f_cz <- liczba_szkod ~ urzadzenie + log2(cena / 2000) + wiek_urz + kanal + wiek_klienta + offset(log(ekspozycja))
f_w <- koszt_u ~ urzadzenie + log2(cena / 2000) + wiek_urz + kanal + wiek_klienta
m_cz_u <- glm(f_cz, family = poisson, data = ucz)
m_w_u <- glm(f_w, family = Gamma(link = "log"), data = sz_ucz)
narz_u <- sum(sz_ucz$koszt - sz_ucz$koszt_u) / sum(sz_ucz$koszt_u)
nowe <- transform(test, ekspozycja = 1)
sr_w <- mean(sz_ucz$koszt_u)                          # średni koszt szkody w zbiorze uczącym (jedna liczba)
test$s_czestosc <- predict(m_cz_u, nowe, type = "response") * sr_w * (1 + narz_u)
test$s_pelny <- predict(m_cz_u, nowe, type = "response") * predict(m_w_u, nowe, type = "response") * (1 + narz_u)
test$s_prawda <- test$skladka_prawda

# Uporządkowana krzywa Lorenza: polisy od najniższej do najwyższej składki z modelu; na osi X skumulowany udział
# składki płaskiej (jednakowa stawka za polisorok = udział ekspozycji), na osi Y skumulowany udział szkód.
lorenz <- function(skl, eksp, szk) {
  o <- order(skl)                                     # składka płaska jest stała, więc relatywność ~ skl
  data.frame(x = c(0, cumsum(eksp[o]) / sum(eksp)), y = c(0, cumsum(szk[o]) / sum(szk)))
}
gini <- function(skl, eksp, szk) {
  l <- lorenz(skl, eksp, szk)
  1 - 2 * sum(diff(l$x) * (head(l$y, -1) + tail(l$y, -1)) / 2)   # 2 × pole między przekątną a krzywą
}
modele <- c(s_czestosc = "model częstości (wysokość stała)",
            s_pelny = "częstość × wysokość", s_prawda = "prawdziwa składka (symulacja)")
g <- sapply(names(modele), function(m) gini(test[[m]], test$ekspozycja, test$suma_szkod))
set.seed(7614)
gb <- replicate(1000, {
  i <- sample.int(nrow(test), replace = TRUE)
  sapply(names(modele), function(m) gini(test[[m]][i], test$ekspozycja[i], test$suma_szkod[i]))
})
data.frame(model = modele, gini = round(g, 3), dol = round(apply(gb, 1, quantile, 0.025), 3),
           gora = round(apply(gb, 1, quantile, 0.975), 3), row.names = NULL)
roz <- gb["s_pelny", ] - gb["s_czestosc", ]          # o ile wysokość poprawia rozróżnianie ryzyka
c(roznica = round(g[["s_pelny"]] - g[["s_czestosc"]], 3), dol = round(quantile(roz, 0.025), 3),
  gora = round(quantile(roz, 0.975), 3))

# Wskaźnik szkodowości w kwintylach składki z pełnego modelu (szkody / składka, test)
test$kw <- cut(test$s_pelny, quantile(test$s_pelny, 0:5 / 5), include.lowest = TRUE, labels = 1:5)
kw <- do.call(rbind, lapply(split(test, test$kw), function(x)
  data.frame(kwintyl = x$kw[1], skladka_sr = round(sum(x$s_pelny * x$ekspozycja) / sum(x$ekspozycja), 1),
             szkody_na_polisorok = round(sum(x$suma_szkod) / sum(x$ekspozycja), 1),
             szkodowosc = round(sum(x$suma_szkod) / sum(x$s_pelny * x$ekspozycja), 2))))
rownames(kw) <- NULL; kw

krz <- do.call(rbind, lapply(names(modele)[-3], function(m)
  cbind(model = modele[[m]], lorenz(test[[m]], test$ekspozycja, test$suma_szkod))))
krz <- krz[c(TRUE, rep(FALSE, 9)) | krz$x %in% c(0, 1), ]   # co 10. punkt wystarczy do wykresu
krz$model <- factor(krz$model, modele[-3])
p5 <- ggplot(krz, aes(x, y, colour = model, linetype = model)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "22") +
  geom_line(linewidth = 0.9) +
  annotate("text", x = 0.6, y = 0.12, hjust = 0, size = 4.1, colour = "grey15",
           label = sprintf("Gini (polisy testowe):\nczęstość, wysokość stała: %.3f\nczęstość × wysokość: %.3f\nprawdziwa składka: %.3f",
                           g[["s_czestosc"]], g[["s_pelny"]], g[["s_prawda"]])) +
  scale_colour_manual(values = setNames(c(kol[["blekit"]], kol[["niebieski"]]), modele[-3]), name = NULL) +
  scale_linetype_manual(values = setNames(c("42", "solid"), modele[-3]), name = NULL) +
  scale_x_continuous(labels = scales::percent) + scale_y_continuous(labels = scales::percent) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "Uporządkowana krzywa Lorenza: od najniższej składki z modelu",
       x = "Skumulowany udział polisoroków", y = "Skumulowany udział kosztów szkód") +
  motyw
p5   # zapis: ggsave("szkody-lorenz-gini.svg", p5, width = 10, height = 6)
Wynik w R
                             model  gini   dol  gora
1 model częstości (wysokość stała) 0.109 0.059 0.152
2              częstość × wysokość 0.313 0.276 0.350
3    prawdziwa składka (symulacja) 0.318 0.281 0.354
   roznica   dol.2.5% gora.97.5%
     0.204      0.158      0.252
  kwintyl skladka_sr szkody_na_polisorok szkodowosc
1       1       58.1                70.7       1.22
2       2       94.0                96.2       1.02
3       3      127.6               118.3       0.93
4       4      172.3               180.6       1.05
5       5      298.7               319.9       1.07
6. Grafika: karta „składka = częstość × wysokość” – Rysunek 6
R
# Przepis 6. Karta „składka = częstość × wysokość” z liczbami profilu B – Rysunek 6
# Korzysta z obiektów wyn (przepis 4), narzut, prog, szkody (przepis 3), polisy, kol i motyw (przepis 1).
b <- wyn[2, ]
karty <- data.frame(
  x = c(1, 3.4, 5.8, 8.2), kolor = c(kol[["niebieski"]], kol[["pomaranczowy"]], kol[["szary"]], kol[["granat"]]),
  naglowek = c("CZĘSTOŚĆ", "WYSOKOŚĆ", "DUŻE SZKODY", "SKŁADKA CZYSTA"),
  liczba = c(sprintf("%.3f", b$czestosc), sprintf("%.0f zł", b$wysokosc), sprintf("× %.3f", 1 + narzut),
             sprintf("%.0f zł", b$skladka)),
  jednostka = c("szkody na polisorok", "średni koszt szkody\n(uciętej na 4000 zł)", "narzut za koszty\npowyżej progu",
                "na rok ochrony"),
  model = c(sprintf("ujemny dwumianowy\nz offsetem log(ekspozycji)\nwszystkie %s polis", format(nrow(polisy), big.mark = " ")),
            sprintf("regresja gamma, łącze log\ntylko %s szkód", format(nrow(szkody), big.mark = " ")),
            sprintf("%.1f%% kosztów powyżej\n%d zł rozłożone\nna wszystkie polisy", 100 * sum(szkody$koszt - szkody$koszt_u) / sum(szkody$koszt), prog),
            "bez kosztów obsługi,\nzysku i rezerw –\nto nie jest taryfa"))
znaki <- data.frame(x = c(2.2, 4.6, 7.0), y = 3.15, z = c("×", "×", "="))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 1, xmax = x + 1, ymin = 0.4, ymax = 4.6), fill = "white", colour = karty$kolor, linewidth = 1.2) +
  geom_rect(aes(xmin = x - 1, xmax = x + 1, ymin = 3.95, ymax = 4.6), fill = karty$kolor, colour = karty$kolor) +
  geom_text(aes(x, 4.27, label = naglowek), colour = "white", fontface = "bold", size = 4.6) +
  geom_text(aes(x, 3.25, label = liczba), colour = karty$kolor, fontface = "bold", size = 7.5) +
  geom_text(aes(x, 2.45, label = jednostka), colour = "grey20", size = 3.9, lineheight = 0.95) +
  geom_segment(aes(x = x - 0.8, xend = x + 0.8, y = 1.85, yend = 1.85), colour = "grey80") +
  geom_text(aes(x, 1.15, label = model), colour = "grey25", size = 3.6, lineheight = 0.95) +
  geom_text(data = znaki, aes(x, y, label = z), size = 10, colour = "grey30", fontface = "bold") +
  annotate("text", x = 4.6, y = -0.05, size = 4.1, colour = "grey15",
           label = sprintf("Profil B: telefon 1 rok, 4500 zł, kupiony przez internet, klient 18–25 lat; 95%% CI składki z bootstrapu: [%.0f, %.0f] zł",
                           b$dol, b$gora)) +
  scale_x_continuous(limits = c(-0.05, 9.25)) + scale_y_continuous(limits = c(-0.3, 4.7)) +
  labs(title = "Składka czysta = częstość × wysokość (× narzut na duże szkody)", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6   # zapis: ggsave("szkody-karta-skladka.svg", p6, width = 10, height = 5)
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – niebieski" = c("#56B4E9", "#0072B2"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "zielony – pomarańczowy" = c("#009E73", "#D55E00"),
             "granat – pomarańczowy" = c("#0f1d3a", "#D55E00"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – niebieski                          26.4         24.7       24.6
niebieski – zielony                         70.1         55.4       58.0
zielony – pomarańczowy                     102.4         53.5       37.3
granat – pomarańczowy                      101.6         96.6       81.5
szary – pomarańczowy                        77.2         62.9       56.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję Poissona i gamma policzono funkcją glm() pakietu stats, regresję ujemną dwumianową – pakietem MASS, a regresję Tweedie z szacowanym parametrem mocy – pakietem mgcv (rodzina tw()). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, osie opisano funkcjami pakietu scales, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- mgcv (wersja 1.9-4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
Pułapki
- Ekspozycja niepełna. Polisy kupione lub rozwiązane w ciągu roku mają krótszą ochronę; bez offsetu kanał z młodymi polisami wygląda na bezpieczny.
- Szkody jeszcze niezgłoszone. Szkody z grudnia bywają zgłaszane w styczniu, więc dane „na dziś” zaniżają częstość – zob. trójkąt szkód.
- Nadużycia. Zawyżone lub zmyślone szkody trafiają do danych jak prawdziwe. Proste modele klasyfikacji, np. regresja logistyczna, wypadały w porównaniach podobnie jak metody złożone (Viaene i in., 2002); zob. wykrywanie nietypowych transakcji.
- Selekcja klientów. Ubezpieczenie kupuje ten, kto się go spodziewa potrzebować. Wysoka częstość kanału „później” opisuje osoby, które dokupiły ochronę, a nie wszystkich właścicieli używanych telefonów. Przeniesienie wyniku na inną populację to błąd selekcji. Chiappori i Salanié (2000) zaproponowali prosty test asymetrii informacji w danych ubezpieczeniowych i w swoich danych komunikacyjnych jej nie znaleźli – trzeba ją sprawdzać, a nie zakładać.
- Zależność częstości i wysokości. Iloczyn dwóch modeli zakłada, że przy danych cechach koszt szkody nie zależy od liczby szkód. Sprawdź średni koszt według liczby szkód na polisie.
Najczęstsze pytania
Jak policzyć składkę czystą z danych o szkodach?
Podziel ją na dwie części: oczekiwaną liczbę szkód na rok ochrony i oczekiwany koszt jednej szkody, i pomnóż przewidywania obu modeli dla danego profilu. W przykładzie telefon za 4500 zł kupiony przez internet przez klienta w wieku 18–25 lat ma 0.328 szkody na rok i średni koszt szkody 961.5 zł, co z narzutem 3.21% na duże szkody daje 325.0 zł, 95% CI [291.6, 366.6].
Po co offset w regresji Poissona dla szkód?
Bo polisy mają różny czas ochrony. Offset log(ekspozycji) sprawia, że model opisuje szkody na polisorok, a nie na polisę. W przykładzie kanał internetowy ruszył w kwietniu, więc jego polisy chroniły sprzęt średnio 0.38 roku; bez offsetu wyglądał na o 43% bezpieczniejszy (IRR = 0.569), z offsetem IRR = 1.060, 95% CI [0.988, 1.138].
Dlaczego regresja gamma dla kosztu szkody, a nie zwykła regresja?
Koszt szkody jest dodatni i prawostronnie skośny, a jego rozrzut rośnie ze średnią – tak zakłada model gamma. Z łączem logarytmicznym exp(b) jest ilorazem średnich kosztów: w przykładzie dwa razy droższe urządzenie miało szkody średnio 1.758 razy droższe. Model dopasowuje się tylko do szkód, a nie do wszystkich polis.
Model dwuczęściowy czy Tweedie do składki?
Oba dają podobne średnie: w przykładzie składki z Tweedie (p = 1.508) różniły się od iloczynu częstości i wysokości o kilka złotych. Model dwuczęściowy pokazuje, czy różnica między klientami wynika z liczby szkód, czy z ich kosztu, a Tweedie to jedno równanie, łatwiejsze w utrzymaniu.
Jak sprawdzić, czy model taryfowy dobrze rozróżnia ryzyko?
Na polisach, których model nie widział, uporządkuj je od najniższej składki i narysuj uporządkowaną krzywą Lorenza kosztów szkód; wskaźnik Giniego to dwukrotność pola między krzywą a przekątną. W przykładzie model częstość × wysokość miał Gini = 0.313, 95% CI [0.276, 0.350], prawie tyle co prawdziwa składka (0.318). Poziom sprawdź osobno, ilorazem szkód do składki w grupach.
Powiązane hasła
Przeczytaj też
Przychód z zerami: dwie części i Tweedie
12 000 graczy gry mobilnej, 93% zer: logit × gamma, smearing, Tweedie z profilem p, kalibracja i test A/B przychodu – z kodem R.
Czytaj →PoradnikTrójkąt szkód – chain-ladder i rezerwy
Ubezpieczyciel mienia małych firm: chain-ladder ręcznie, ten sam wynik z GLM, rozkład rezerwy z bootstrapu i reszty wg roku kalendarzowego – w R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →Piszesz pracę o ubezpieczeniach albo modelujesz szkody w firmie?
Pomożemy dobrać modele częstości i wysokości szkód, uwzględnić ekspozycję, ocenić model na nowych danych i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chiappori, P.-A., & Salanié, B. (2000). Testing for asymmetric information in insurance markets. Journal of Political Economy, 108(1), 56–78. https://doi.org/10.1086/262111
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Frees, E. W., Meyers, G., & Cummings, A. D. (2011). Summarizing insurance scores using a Gini index. Journal of the American Statistical Association, 106(495), 1085–1098. https://doi.org/10.1198/jasa.2011.tm10506
- Frome, E. L. (1983). The analysis of rates using Poisson regression models. Biometrics, 39(3), 665–674. https://doi.org/10.2307/2531094
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Smyth, G. K., & Jørgensen, B. (2002). Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling. ASTIN Bulletin, 32(1), 143–157. https://doi.org/10.2143/ast.32.1.1020 ● Otwarty dostęp
- Viaene, S., Derrig, R. A., Baesens, B., & Dedene, G. (2002). A comparison of state-of-the-art classification techniques for expert automobile insurance claim fraud detection. Journal of Risk and Insurance, 69(3), 373–421. https://doi.org/10.1111/1539-6975.00023
Cytowania BibTeX
@article{chiappori2000testing, author={Chiappori, Pierre-Andr{\'e} and Salani{\'e}, Bernard}, title={{Testing for asymmetric information in insurance markets}}, journal={Journal of Political Economy}, year={2000}, volume={108}, number={1}, pages={56--78}, doi={10.1086/262111}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{frees2011summarizing, author={Frees, Edward W. and Meyers, Glenn and Cummings, A. David}, title={{Summarizing insurance scores using a Gini index}}, journal={Journal of the American Statistical Association}, year={2011}, volume={106}, number={495}, pages={1085--1098}, doi={10.1198/jasa.2011.tm10506}}@article{frome1983analysis, author={Frome, Edward L.}, title={{The analysis of rates using Poisson regression models}}, journal={Biometrics}, year={1983}, volume={39}, number={3}, pages={665--674}, doi={10.2307/2531094}}@article{nelder1972generalized, author={Nelder, J. A. and Wedderburn, R. W. M.}, title={{Generalized linear models}}, journal={Journal of the Royal Statistical Society: Series A (General)}, year={1972}, volume={135}, number={3}, pages={370--384}, doi={10.2307/2344614}}@article{smyth2002fitting, author={Smyth, Gordon K. and Jørgensen, Bent}, title={{Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling}}, journal={ASTIN Bulletin}, year={2002}, volume={32}, number={1}, pages={143--157}, doi={10.2143/ast.32.1.1020}}@article{viaene2002comparison, author={Viaene, Stijn and Derrig, Richard A. and Baesens, Bart and Dedene, Guido}, title={{A comparison of state-of-the-art classification techniques for expert automobile insurance claim fraud detection}}, journal={Journal of Risk and Insurance}, year={2002}, volume={69}, number={3}, pages={373--421}, doi={10.1111/1539-6975.00023}}