Przykład: grupowe NNW w 120 firmach
Fikcyjny ubezpieczyciel sprzedaje grupowe ubezpieczenie następstw nieszczęśliwych wypadków (NNW) 120 firmom z trzech branż: biura i usługi, handel i magazyny, produkcja i budowa. Dla każdej firmy i roku 2020–2025 zna średnią liczbę ubezpieczonych pracowników (pracownikolata) i liczbę szkód (poszkodowanych ze świadczeniem).
Firmy mają od 6 do 844 pracowników (mediana 41). Razem to 63 898 pracownikolat i 3431 szkód, czyli 5.37 szkody na 100 pracowników rocznie. W 27.36% par „firma × rok” nie było żadnej szkody.
Pytanie: firma z sześcioma pracownikami miała w pięć lat cztery szkody – ważyć jej wynik czy średnią portfela? Odpowiada teoria wiarygodności (Bühlmann, 1967): składka to średnia ważona obu, a wagę wyznaczają dane.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każda firma ma stałą prawdziwą częstość szkód; parametry ustawiliśmy ręcznie (lista przy kodzie), m.in. średnie branż 2.5, 4.5 i 7.0 wypadku na 100 pracowników i 3% wypadków z kilkoma poszkodowanymi. Dwie sytuacje dopisaliśmy ręcznie na potrzeby pułapek: firma biurowa F027 w 2023 r. otwiera magazyn, a w małej firmie handlowej F079 w 2022 r. w wypadku busa ucierpiało 6 pracowników. Ziaren 763 i 7631 nie zmienialiśmy; po pierwszym uruchomieniu wymieniliśmy tylko trzy firmy do rachunku krok po kroku (pierwotnie wybrana mała firma miała historię równą średniej). Dane: wiarygodnosc-nnw-120-firm.csv.
Taryfy i składki ubezpieczeniowe podlegają regulacjom i pracy aktuariusza; ten wpis pokazuje wyłącznie metodę statystyczną na danych fikcyjnych.
Wszystkie oszacowania liczymy z lat 2020–2024, a rok 2025 zostawiamy jako sprawdzian – jak w walidacji w czasie.
Rysunek 1: rozchwiany wskaźnik małej firmy
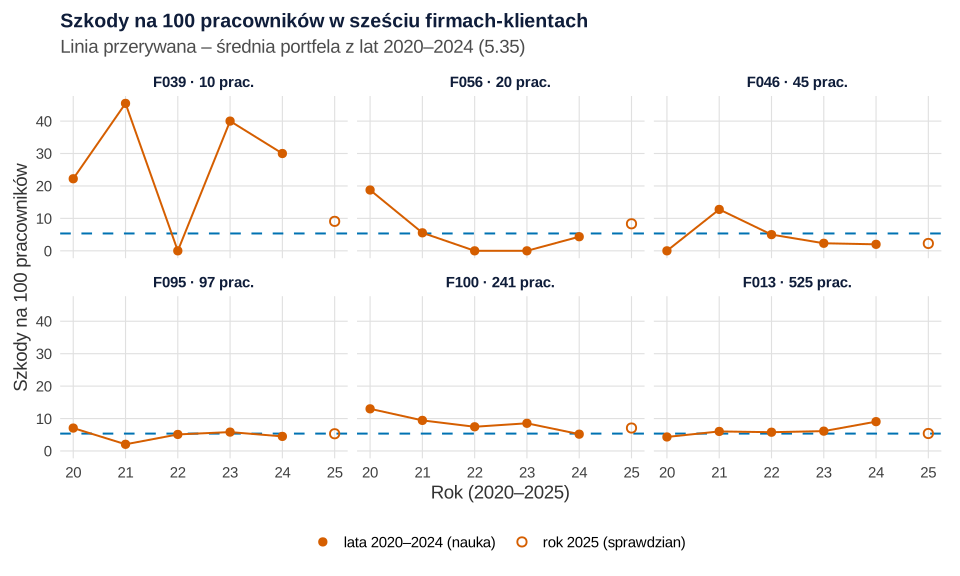
set.seed(763)).Co widać. Firma F039 z 10 pracownikami miała kolejno 22.2, 45.5, 0.0, 40.0 i 30.0 szkody na 100 pracowników. Jedna szkoda to u niej 10 punktów. Firma F013 z 525 pracownikami waha się między 4.3 a 9.1. Mediana odchylenia standardowego rocznego wskaźnika to 5.74 w firmach do 25 pracowników, 2.97 w firmach 26–100 i 1.72 w większych.
Jak może zmylić. Rozrzut małej firmy to w dużej części przypadek, ale z wykresu nie wiadomo, ile w nim prawdziwej różnicy ryzyka – to szacuje model.
Podpis do pracy:
Model Bühlmanna–Strauba: dwie wariancje i współczynnik Z
Model Bühlmanna–Strauba (opisany przez Bühlmanna i Strauba w 1970 r.) zakłada, że każda firma ma stałą oczekiwaną częstość, a roczne wskaźniki wahają się wokół niej tym mocniej, im mniej ma pracowników. Potrzebne są dwie wariancje:
- wariancja w firmie s² – jak bardzo wskaźnik jednej firmy skacze z roku na rok, przeliczona na jednego pracownika (odpowiednik wariancji wewnątrzgrupowej);
- wariancja między firmami a – jak bardzo różnią się prawdziwe częstości firm (odpowiednik wariancji międzygrupowej).
Obie liczymy wzorami momentów z lat 2020–2024, z wagami równymi pracownikolatom. Historia firmy to jej średnia ważona: wszystkie szkody z pięciu lat podzielone przez wszystkie pracownikolata. Dalej:
gdzie w to pracownikolata firmy, a μ – średnia portfela ważona współczynnikami Z. Z to część odchylenia od średniej, którą firma „zachowuje”. Ma ten sam sens co rzetelność średniej grupy, znana z ICC.
W naszym portfelu s² = 946.3, a = 9.294, więc k = 101.8 pracownikolat, a μ = 5.176. Odchylenie prawdziwych częstości firm to √a = 3.05, choć surowe historie firm mają odchylenie 3.98 – nadwyżkę dokłada przypadek. Gdyby szkody były czystym procesem Poissona, s² wynosiłoby około 100 × średnia portfela = 535.2. Wyższe s² to skutek wypadków z kilkoma poszkodowanymi i wahań z roku na rok.
| Firma | Pracownicy | Pracownikolata w | Szkody 2020–2024 | Historia (na 100) | Z = w / (w + 101.8) | Składka (na 100) |
|---|---|---|---|---|---|---|
| F043 | 6 | 32 | 4 | 12.5 | .239 | 6.93 |
| F114 | 36 | 182 | 0 | 0.0 | .641 | 1.86 |
| F116 | 114 | 571 | 75 | 13.1 | .849 | 11.93 |
Rachunek dla F043: Z = 32 / (32 + 101.8) = .239, składka = 5.176 + .239 × (12.5 − 5.176) = 6.93. Firma zachowuje niecałą jedną czwartą swojej złej historii. F114 przez pięć lat nie miała szkody i dostaje 1.86, a nie zero. F116 ma 571 pracownikolat, więc jej wysoki wskaźnik w dużej części zostaje (11.93).
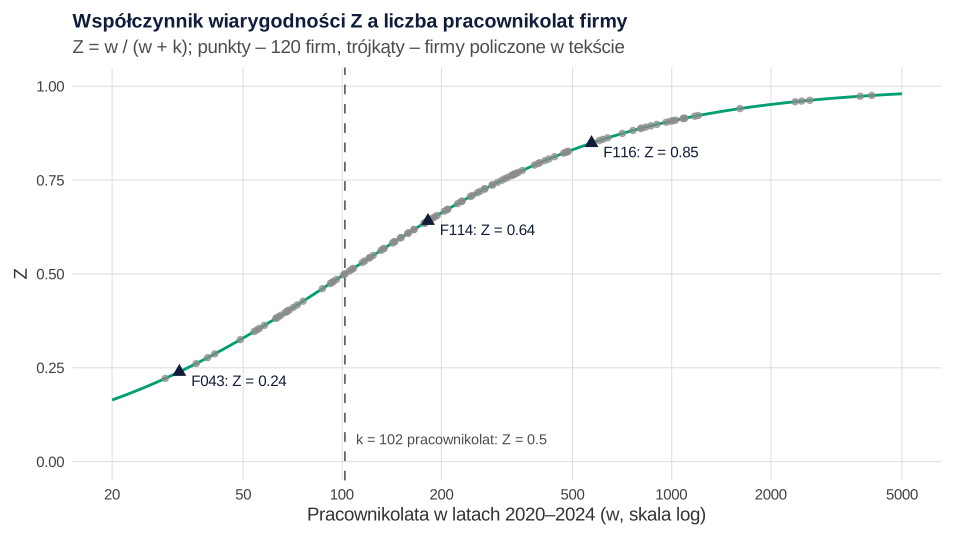
set.seed(763)).Co widać. Z rośnie szybko do około 100 pracownikolat, potem coraz wolniej. Firma z około 20 pracownikami (100 pracownikolat w pięć lat) dostaje Z ≈ 0.5. Mediana Z w portfelu to .672; 27 firm ma Z poniżej .5, a 15 – powyżej .9.
Jak może zmylić. Z zależy tylko od w, nie od liczby szkód. A k to cecha tego portfela: w innym portfelu czy okresie wyjdzie inne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: od historii firmy do składki
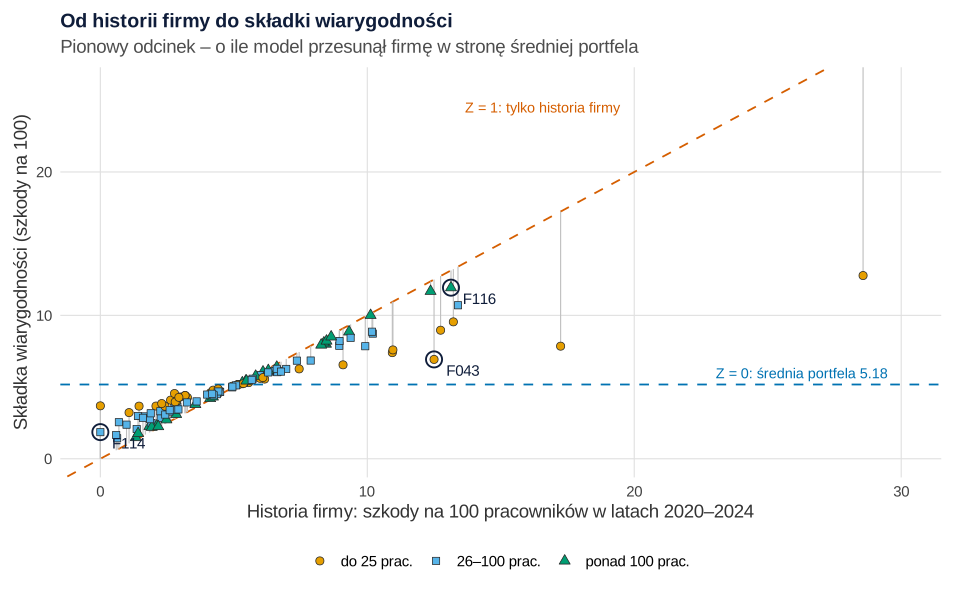
set.seed(763)).Co widać. Historie firm rozciągają się od 0 do 28.57 szkody na 100 pracowników, a składki – od 1.43 do 12.78. Im mniejsza firma, tym większe przesunięcie: średnio o 2.15 punktu w firmach do 25 pracowników, o 0.73 w firmach 26–100 i o 0.25 w większych. To regresja do średniej wbudowana w składkę z góry, zanim przyjdzie rozczarowanie w następnym roku.
Jak może zmylić. Ściąganie nie oznacza, że mała firma jest „naprawdę przeciętna”. F040 z historią 17.24 to naprawdę firma wysokiego ryzyka – jej prawdziwa częstość (znana tylko w symulacji) to 17.13 – a dostaje składkę 7.85, bo ma tylko 29 pracownikolat (Z = .22). Wiarygodność minimalizuje błąd przeciętnie w portfelu, nie w każdej firmie.
Podpis do pracy:
Rysunek 4: to samo w modelu mieszanym
Model Bühlmanna–Strauba to model z efektem losowym firmy. Składka wiarygodności jest predykcją efektu losowego: najlepszym liniowym nieobciążonym predyktorem, który wyprowadza się tak samo w hodowli zwierząt, krigingu i taryfikacji (Robinson, 1991). Dlatego da się ją policzyć w pakiecie do modeli mieszanych (Nelder i Verrall, 1997).
Model lmer(wskaznik ~ 1 + (1 | firma), weights = pracownicy) z pakietu lme4 (Bates i in., 2015) ma strukturę Bühlmanna–Strauba (wariancja reszty = σ²/pracownicy), a wariancje szacuje metodą REML: σ² = 951.95, τ² = 7.472, więc k = 127.4 zamiast 101.8. Te wariancje wstawione do wzoru na Z dają predykcje z lmer co do 15. miejsca po przecinku.
Drugi model liczy wprost liczbę szkód: uogólniony model mieszany z rozkładem ujemnym dwumianowym i offsetem log(pracowników/100), w pakiecie glmmTMB (Brooks i in., 2017). Ściąga na skali logarytmu.
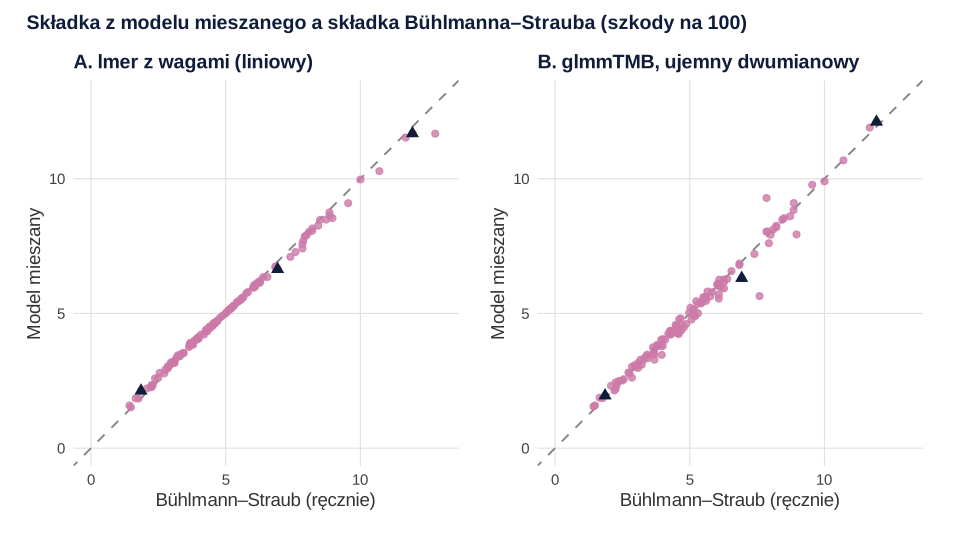
set.seed(763)).Co widać. Korelacja z rachunkiem ręcznym wynosi .999 dla lmer i .988 dla glmmTMB; mediana różnicy w modelu ujemnym dwumianowym to 0.10 punktu. Dla F043 trzy metody dają 6.93, 6.64 i 6.31, dla F116 – 11.93, 11.68 i 12.11.
Jak może zmylić. Model mieszany nie usuwa decyzji: wybór rozkładu, wag i metody szacowania wariancji zmienia k, a przez to składki małych firm. To samo ściąganie pokazują wpisy o modelu mieszanym w obrazkach i o efektach skrzyżowanych.
Podpis do pracy:
Rysunek 5: sprawdzian na roku 2025
Czy ściąganie się opłaca? Porównujemy trzy prognozy na 2025 r.: historię firmy, średnią portfela (5.35) i składkę wiarygodności, miarą RMSE ważoną liczbą pracowników. Szkody jednego roku są głośne, więc losujemy też 200 nowych portfeli i mierzymy błąd względem prawdziwej częstości, znanej tylko w symulacji.
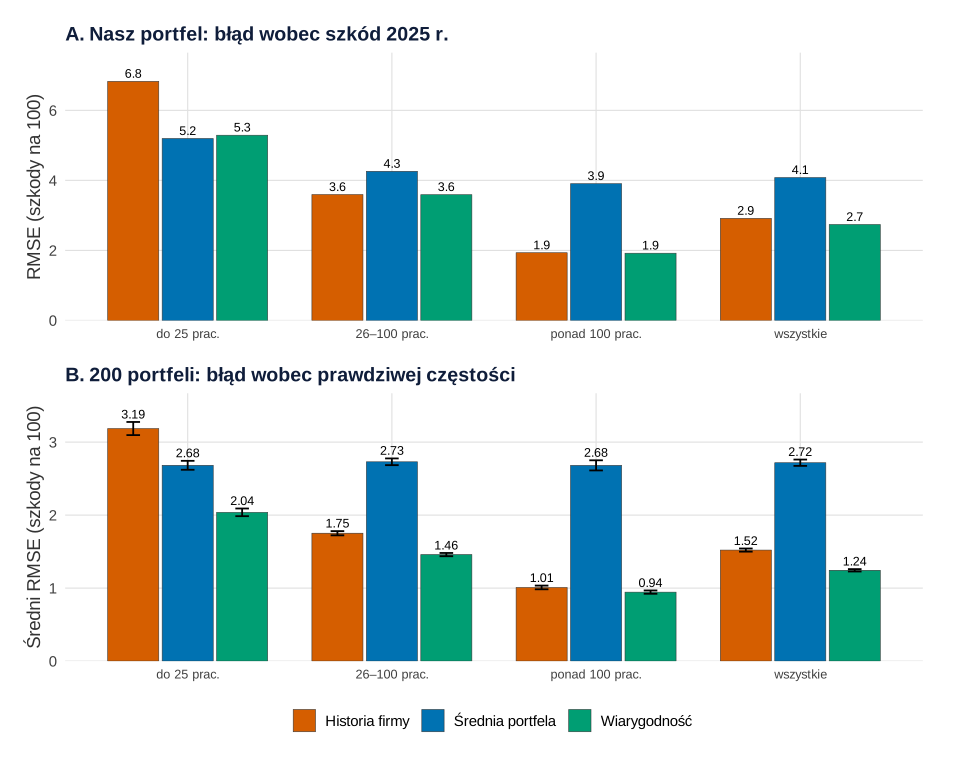
set.seed(763) i set.seed(7631)).Co widać. W naszym portfelu RMSE dla wszystkich firm wynosi 2.91 dla historii, 4.08 dla średniej i 2.74 dla wiarygodności. W 200 portfelach wiarygodność daje 1.24 wobec 1.52 dla historii i 2.72 dla średniej (błąd Monte Carlo 0.01–0.02), a mniejszy błąd niż historia miała w 99% portfeli. Największy zysk jest w małych firmach: 2.04 wobec 3.19, ale też w dużych nie traci (0.94 wobec 1.01).
Jak może zmylić. W naszym portfelu w małych firmach średnia wypadła minimalnie lepiej (5.19 wobec 5.29). Jeden rok szkód małej firmy to głównie szum – przewagę metody pokazują dopiero powtórzenia lub dłuższy okres.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: karta „Z – od średniej portfela do historii firmy”
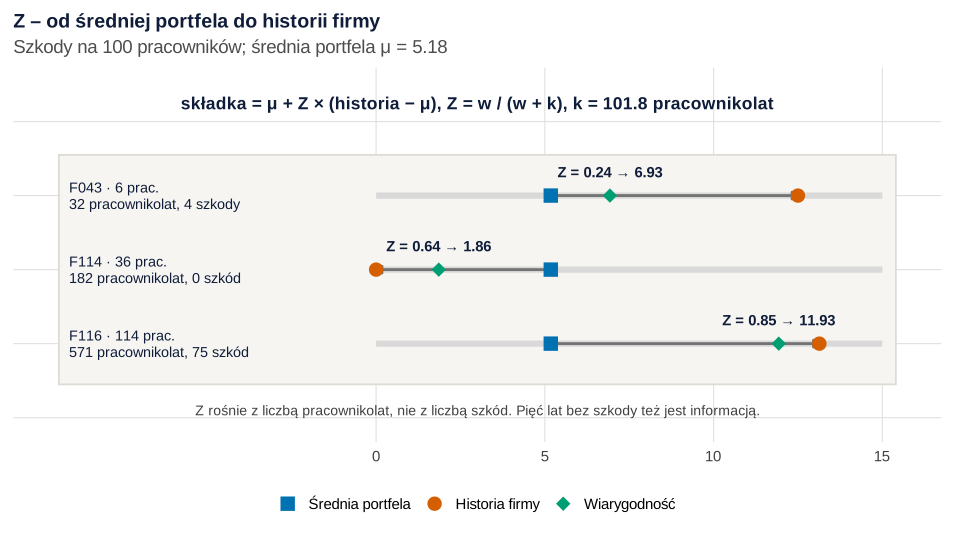
set.seed(763)).Co widać. Składka leży między średnią a historią, w miejscu wyznaczonym przez Z: mała F043 blisko średniej, duża F116 blisko swojej historii.
Jak może zmylić. Karta pokazuje tylko częstość szkód. Wysokość świadczeń, koszty i narzuty to osobne elementy kalkulacji – zob. wpis o częstości i wysokości szkód.
Co z tym zrobić w firmie
- Nie licz składki małej grupy z jej własnych lat. Z = .24 mówi, ile historii firmy z 6 pracownikami warto użyć. Licz Z z pracownikolat, nie z liczby lat.
- Oszacuj k na własnym portfelu i sprawdź prognozę na ostatnim roku, jak na Rysunku 5.
- Wybierz właściwą średnią. Gdy branże różnią się częstością, średnią odniesienia powinna być średnia branży (zob. Pułapki). Podobnie łączy się wiarygodność z modelem GLM dla czynników taryfowych o wielu poziomach (Ohlsson, 2008).
- Tłumacz klientom zmianę składki kartą z Rysunku 6: zły rok małej firmy podnosi składkę tylko trochę, a lata bez szkód też się liczą.
Jak opisać w pracy
Ogólne wskazówki: statystyka w pracy z finansów i rachunkowości; zapis modelu mieszanego – jak opisać wyniki modelu mieszanego. Podobny problem „mało danych, skrajny wynik” w marketingu opisują wpisy o kampanii miesiąca i wskaźniku zaangażowania postów.
Kod R: dane, model Bühlmanna–Strauba, modele mieszane i sprawdzian
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję generuj(), przepis 3 – funkcję buhlmann_straub(); korzystają z nich następne. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują dwa przepisy: przepis 1 (set.seed(763)) i przepis 6 (200 nowych portfeli, set.seed(7631)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 120 firm (40 biur i usług, 45 firm handlowych i magazynowych, 35 produkcyjnych i budowlanych), średnie częstości branż 2.5, 4.5 i 7.0 wypadku na 100 pracowników, różnice firm w branży z rozkładu gamma o CV = 0.35, zatrudnienie w 2020 r. z rozkładu logarytmiczno-normalnego (mediana 45, odchylenie 1.0 w skali log, ucięte do 6–900), zmianę zatrudnienia o średnio 0 i odchyleniu 0.04 rocznie (skala log) z szumem 0.08, wahania częstości z roku na rok (gamma, CV = 0.2), 3% wypadków z dodatkowymi 1–6 poszkodowanymi, a także dwie sytuacje do pułapek: firmę biurową (najbliższą 20 pracownikom), która w 2023 r. zatrudnia 5 razy więcej osób przy częstości 7.0, i małą firmę handlową (najbliższą 15 pracownikom) z wypadkiem busa w 2022 r. (6 poszkodowanych). Po pierwszym uruchomieniu zmieniono tylko trzy firmy liczone krok po kroku (F043, F114, F116 zamiast firm wybranych automatycznie według wielkości); parametry danych zostały bez zmian. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 120 firm, lata 2020–2025
R
# Przepis 1. Fikcyjny ubezpieczyciel: grupowe ubezpieczenie NNW pracowników 120 firm-klientów, lata 2020–2025
library(ggplot2)
options(width = 110)                                   # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Historia firmy" = "#D55E00", "Średnia portfela" = "#0072B2", "Wiarygodność" = "#009E73",
         "Model mieszany" = "#CC79A7", szary = "grey55", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)            # znak minus (−) w etykietach rysunków

# Generator portfela; parametry ustalone ręcznie (lista na stronie)
generuj <- function(I = 120, lata = 2020:2025) {
  branze <- c("biura i usługi", "handel i magazyny", "produkcja i budowa")
  sr_branzy <- c(2.5, 4.5, 7.0)                         # średnia liczba szkód na 100 pracowników w branży
  cv_firmy <- 0.35                                     # zmienność prawdziwej częstości firm w branży
  f <- data.frame(firma = sprintf("F%03d", 1:I),
                  branza = sample(rep(branze, c(40, 45, 35))),
                  baza = pmin(pmax(round(exp(rnorm(I, log(45), 1.0))), 6), 900),   # pracownicy w 2020 r.
                  trend = rnorm(I, 0, 0.04))                                       # zmiana zatrudnienia rocznie
  f$theta <- sr_branzy[match(f$branza, branze)] * rgamma(I, shape = 1 / cv_firmy^2, rate = 1 / cv_firmy^2)
  d <- merge(f, data.frame(rok = lata))
  d <- d[order(d$firma, d$rok), ]
  d$pracownicy <- pmax(round(d$baza * exp(d$trend * (d$rok - lata[1]) + rnorm(nrow(d), 0, 0.08))), 4)
  d$theta_rok <- d$theta * rgamma(nrow(d), shape = 25, rate = 25)                # wahania z roku na rok (CV 0.2)
  d$wypadki <- rpois(nrow(d), d$pracownicy * d$theta_rok / 100)
  # zwykle 1 poszkodowany na wypadek; w 3% wypadków dodatkowo 1–6 osób
  d$szkody <- d$wypadki + sapply(d$wypadki, function(n) sum(rbinom(n, 1, 0.03) * sample(1:6, n, TRUE)))
  d$prawdziwa <- d$theta * (1 + 0.03 * 3.5)            # oczekiwane szkody na 100 pracowników (tylko w symulacji)
  d$wskaznik <- 100 * d$szkody / d$pracownicy           # szkody na 100 pracowników (pracownikolat)
  d
}

set.seed(763)
d <- generuj()
# Dwie sytuacje dopisane ręcznie, żeby pokazać pułapki:
# (1) firma biurowa, która w 2023 r. otwiera magazyn: 5 razy więcej pracowników i częstość jak w produkcji
biuro <- unique(d[d$branza == "biura i usługi", c("firma", "baza")])
rosnaca <- biuro$firma[which.min(abs(biuro$baza - 20))]
r <- d$firma == rosnaca & d$rok >= 2023
d$pracownicy[r] <- d$pracownicy[r] * 5
d$theta_rok[r] <- 7.0 * d$theta_rok[r] / d$theta[r]
d$theta[r] <- 7.0; d$prawdziwa[r] <- 7.0               # prawdziwa częstość (znana tylko w symulacji)
d$wypadki[r] <- rpois(sum(r), d$pracownicy[r] * d$theta_rok[r] / 100)
d$szkody[r] <- d$wypadki[r]
# (2) mała firma handlowa z jednym wypadkiem busa w 2022 r. (6 poszkodowanych pracowników)
handel <- unique(d[d$branza == "handel i magazyny", c("firma", "baza")])
bus <- handel$firma[which.min(abs(handel$baza - 15))]
b <- d$firma == bus & d$rok == 2022
d$wypadki[b] <- d$wypadki[b] + 1
d$szkody[b] <- d$szkody[b] + 6

d$wskaznik <- 100 * d$szkody / d$pracownicy             # przeliczenie po dopisanych zmianach
dane <- d[, c("firma", "branza", "rok", "pracownicy", "wypadki", "szkody", "wskaznik")]
dane$wskaznik <- round(dane$wskaznik, 3)
write.csv(dane, "wiarygodnosc-nnw-120-firm.csv", row.names = FALSE)   # plik w katalogu roboczym

# Podsumowanie portfela
c(firmy = length(unique(d$firma)), wiersze = nrow(d), pracownikolata = sum(d$pracownicy),
  szkody = sum(d$szkody), wypadki = sum(d$wypadki))
round(c(wskaznik_portfela = 100 * sum(d$szkody) / sum(d$pracownicy),
        odsetek_lat_bez_szkody = 100 * mean(d$szkody == 0)), 2)
summary(round(tapply(d$pracownicy, d$firma, mean)))    # średnie zatrudnienie firm w latach 2020–2025
c(rosnaca = rosnaca, bus = bus)
Wynik w R
         firmy        wiersze pracownikolata         szkody        wypadki
           120            720          63898           3431           3066
     wskaznik_portfela odsetek_lat_bez_szkody
                  5.37                  27.36
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   6.00   21.00   41.00   88.76   94.00  844.00
rosnaca     bus
 "F027"  "F079"
2. Rozchwiany wskaźnik małych firm: Rysunek 1
R
# Przepis 2. Rozchwiany wskaźnik małych firm: Rysunek 1
# Korzysta z obiektów d, kol, motyw, rosnaca i bus (przepis 1). Bez losowania.
nauka <- d[d$rok <= 2024, ]                            # lata 1–5: z nich liczymy składkę na rok 6 (2025)
sr_portfela <- 100 * sum(nauka$szkody) / sum(nauka$pracownicy)
sr_zatr <- tapply(nauka$pracownicy, nauka$firma, mean)
kandydaci <- sr_zatr[!names(sr_zatr) %in% c(rosnaca, bus)]
szesc <- sapply(c(10, 20, 45, 100, 250, 600), function(n) names(kandydaci)[which.min(abs(kandydaci - n))])
h <- d[d$firma %in% szesc, ]
h$etykieta <- factor(paste0(h$firma, " · ", round(sr_zatr[h$firma]), " prac."),
                     levels = paste0(szesc, " · ", round(sr_zatr[szesc]), " prac."))
h$okres <- ifelse(h$rok <= 2024, "lata 2020–2024 (nauka)", "rok 2025 (sprawdzian)")

p1 <- ggplot(h, aes(rok, wskaznik)) +
  geom_hline(yintercept = sr_portfela, colour = kol[["Średnia portfela"]], linetype = 2, linewidth = 0.7) +
  geom_line(data = h[h$rok <= 2024, ], colour = kol[["Historia firmy"]], linewidth = 0.7) +
  geom_point(aes(shape = okres), colour = kol[["Historia firmy"]], size = 2.6, stroke = 1) +
  scale_shape_manual(values = c(16, 1), name = NULL) +
  facet_wrap(~ etykieta, nrow = 2) +
  scale_x_continuous(breaks = 2020:2025, labels = c("20", "21", "22", "23", "24", "25")) +
  labs(title = "Szkody na 100 pracowników w sześciu firmach-klientach",
       subtitle = sprintf("Linia przerywana – średnia portfela z lat 2020–2024 (%.2f)", sr_portfela),
       x = "Rok (2020–2025)", y = "Szkody na 100 pracowników") +
  motyw

round(sr_portfela, 2)
# Wskaźnik w kolejnych latach (wiersze: firmy od najmniejszej)
tab <- with(h, tapply(round(wskaznik, 1), list(firma, rok), sum))[szesc, ]
cbind(pracownicy = round(sr_zatr[szesc]), tab)
# Rozrzut rocznego wskaźnika (odchylenie standardowe lat 2020–2024) według wielkości firmy
klasa <- cut(sr_zatr, c(0, 25, 100, Inf), labels = c("do 25", "26–100", "ponad 100"))
sd_firmy <- tapply(nauka$wskaznik, nauka$firma, sd)
round(tapply(sd_firmy, klasa, median), 2)
p1   # zapis: ggsave("wiarygodnosc-historia-szesciu-firm.svg", p1, width = 10, height = 6)
Wynik w R
[1] 5.35
     pracownicy 2020 2021 2022 2023 2024 2025
F039         10 22.2 45.5  0.0 40.0 30.0  9.1
F056         20 18.8  5.6  0.0  0.0  4.3  8.3
F046         45  0.0 12.8  5.0  2.3  2.0  2.3
F095         97  7.1  2.1  5.1  5.8  4.5  5.3
F100        241 13.0  9.4  7.5  8.5  5.2  7.1
F013        525  4.3  6.0  5.8  6.1  9.1  5.4
    do 25    26–100 ponad 100
     5.74      2.97      1.72
3. Model Bühlmanna–Strauba ręcznie: Rysunek 2
R
# Przepis 3. Model Bühlmanna–Strauba liczony ręcznie (lata 2020–2024) i współczynnik Z: Rysunek 2
# Korzysta z obiektów nauka, kol i motyw (przepisy 1–2). Bez losowania.
buhlmann_straub <- function(x, w, grupa) {             # x – wskaźnik w roku, w – waga (pracownicy)
  w_i <- tapply(w, grupa, sum)                         # pracownikolata firmy w latach nauki
  X_i <- tapply(w * x, grupa, sum) / w_i               # ważona średnia firmy = historia firmy
  n_i <- tapply(x, grupa, length)
  s2 <- sum(w * (x - X_i[grupa])^2) / sum(n_i - 1)     # wariancja w firmie (na 1 pracownikorok)
  W <- sum(w_i); X_w <- sum(w_i * X_i) / W             # średnia portfela ważona pracownikolatami
  a <- (sum(w_i * (X_i - X_w)^2) - (length(w_i) - 1) * s2) / (W - sum(w_i^2) / W)   # wariancja między firmami
  k <- s2 / a
  Z <- w_i / (w_i + k)
  mu <- sum(Z * X_i) / sum(Z)                          # średnia portfela ważona wiarygodnością
  list(s2 = s2, a = a, k = k, X_w = X_w, mu = mu,
       firmy = data.frame(firma = names(w_i), w = as.numeric(w_i), historia = as.numeric(X_i),
                          Z = as.numeric(Z), skladka = as.numeric(mu + Z * (X_i - mu))))
}
bs <- buhlmann_straub(nauka$wskaznik, nauka$pracownicy, nauka$firma)
round(unlist(bs[c("s2", "a", "k", "X_w", "mu")]), 3)
c(sqrt_a = round(sqrt(bs$a), 2), sd_historii = round(sd(bs$firmy$historia), 2),
  s2_gdyby_poisson = round(100 * bs$X_w, 1))         # przy czystym procesie Poissona s² ≈ 100 × średnia

# Trzy firmy policzone krok po kroku (wybrane ręcznie: mała z kilkoma szkodami, średnia bez szkód, duża)
trzy <- c("F043", "F114", "F116")
f3 <- bs$firmy[match(trzy, bs$firmy$firma), ]
f3$pracownicy <- round(as.numeric(sr_zatr[trzy]))
f3$szkody <- as.numeric(tapply(nauka$szkody, nauka$firma, sum)[trzy])
f3$Z_recznie <- sprintf("%.0f / (%.0f + %.1f)", f3$w, f3$w, bs$k)
print(f3[, c("firma", "pracownicy", "w", "szkody", "historia", "Z_recznie", "Z", "skladka")], digits = 3, row.names = FALSE)

# Rozkład Z w portfelu
round(quantile(bs$firmy$Z, c(0, .25, .5, .75, 1)), 3)
c(Z_ponizej_pol = sum(bs$firmy$Z < 0.5), Z_powyzej_090 = sum(bs$firmy$Z > 0.9))

krzywa <- data.frame(w = exp(seq(log(20), log(5000), length.out = 200)))
krzywa$Z <- krzywa$w / (krzywa$w + bs$k)
p2 <- ggplot(bs$firmy, aes(w, Z)) +
  geom_line(data = krzywa, colour = kol[["Wiarygodność"]], linewidth = 1) +
  geom_point(colour = kol[["szary"]], alpha = 0.7, size = 1.8) +
  geom_point(data = f3, colour = kol[["granat"]], size = 3.2, shape = 17) +
  geom_text(data = f3, aes(label = sprintf("%s: Z = %.2f", firma, Z)), hjust = -0.12, vjust = 1.3,
            size = 4, colour = kol[["granat"]]) +
  geom_vline(xintercept = bs$k, linetype = 2, colour = "grey40") +
  annotate("text", x = bs$k * 1.08, y = 0.06, hjust = 0, size = 3.8, colour = "grey30",
           label = sprintf("k = %.0f pracownikolat: Z = 0.5", bs$k)) +
  scale_x_log10(breaks = c(20, 50, 100, 200, 500, 1000, 2000, 5000)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(title = "Współczynnik wiarygodności Z a liczba pracownikolat firmy",
       subtitle = "Z = w / (w + k); punkty – 120 firm, trójkąty – firmy policzone w tekście",
       x = "Pracownikolata w latach 2020–2024 (w, skala log)", y = "Z") +
  motyw
p2   # zapis: ggsave("wiarygodnosc-wspolczynnik-z.svg", p2, width = 10, height = 5.6)
Wynik w R
     s2       a       k     X_w      mu
946.280   9.294 101.814   5.352   5.176
          sqrt_a      sd_historii s2_gdyby_poisson
            3.05             3.98           535.20
 firma pracownicy   w szkody historia           Z_recznie     Z skladka
  F043          6  32      4     12.5   32 / (32 + 101.8) 0.239    6.93
  F114         36 182      0      0.0 182 / (182 + 101.8) 0.641    1.86
  F116        114 571     75     13.1 571 / (571 + 101.8) 0.849   11.93
   0%   25%   50%   75%  100%
0.222 0.514 0.672 0.822 0.975
Z_ponizej_pol Z_powyzej_090
           27            15
4. Od historii do składki: Rysunek 3
R
# Przepis 4. Składka wiarygodności a historia firmy: Rysunek 3
# Korzysta z obiektów bs, f3, sr_zatr, kol i motyw (przepisy 1–3). Bez losowania.
fb <- bs$firmy
fb$klasa <- cut(sr_zatr[fb$firma], c(0, 25, 100, Inf), labels = c("do 25 prac.", "26–100 prac.", "ponad 100 prac."))
p3 <- ggplot(fb, aes(historia, skladka)) +
  geom_abline(slope = 1, intercept = 0, colour = kol[["Historia firmy"]], linetype = 2) +
  geom_hline(yintercept = bs$mu, colour = kol[["Średnia portfela"]], linetype = 2) +
  geom_segment(aes(xend = historia, yend = historia), colour = "grey75", linewidth = 0.4) +
  geom_point(aes(shape = klasa, fill = klasa), size = 2.6, colour = "grey15", stroke = 0.4) +
  geom_point(data = f3, size = 5, shape = 1, colour = kol[["granat"]], stroke = 1) +
  geom_text(data = f3, aes(label = firma), hjust = -0.35, vjust = 1.5, size = 4, colour = kol[["granat"]]) +
  annotate("text", x = 19.5, y = 24.5, label = "Z = 1: tylko historia firmy", hjust = 1, size = 3.8,
           colour = kol[["Historia firmy"]]) +
  annotate("text", x = 29.5, y = bs$mu + 0.8, label = sprintf("Z = 0: średnia portfela %.2f", bs$mu), hjust = 1,
           size = 3.8, colour = kol[["Średnia portfela"]]) +
  scale_shape_manual(values = c(21, 22, 24), name = NULL) +
  scale_fill_manual(values = c("#E69F00", "#56B4E9", "#009E73"), name = NULL) +
  coord_cartesian(xlim = c(0, 30), ylim = c(0, 26)) +
  labs(title = "Od historii firmy do składki wiarygodności",
       subtitle = "Pionowy odcinek – o ile model przesunął firmę w stronę średniej portfela",
       x = "Historia firmy: szkody na 100 pracowników w latach 2020–2024", y = "Składka wiarygodności (szkody na 100)") +
  motyw

# Najwyższe i najniższe wartości: historia a składka
rbind(historia = range(fb$historia), skladka = range(fb$skladka))
# Średnie przesunięcie |składka − historia| według wielkości firmy
round(tapply(abs(fb$skladka - fb$historia), fb$klasa, mean), 2)
# Firmy bez żadnej szkody w 5 latach
fb[fb$historia == 0, c("firma", "w", "Z", "skladka")]
# Firma z wysoką historią, która naprawdę ma wysokie ryzyko (prawdziwa częstość znana tylko w symulacji)
cbind(fb[fb$firma == "F040", c("firma", "w", "historia", "Z", "skladka")],
      prawdziwa = d$prawdziwa[d$firma == "F040" & d$rok == 2025])
p3   # zapis: ggsave("wiarygodnosc-od-historii-do-skladki.svg", p3, width = 10, height = 6.2)
Wynik w R
             [,1]     [,2]
historia 0.000000 28.57143
skladka  1.428766 12.77723
    do 25 prac.    26–100 prac. ponad 100 prac.
           2.15            0.73            0.25
    firma   w         Z  skladka
78   F078  41 0.2870858 3.690035
114  F114 182 0.6412640 1.856813
   firma  w historia        Z skladka prawdziwa
40  F040 29 17.24138 0.221688 7.85074  17.12737
5. Modele mieszane (lme4, glmmTMB): Rysunek 4
R
# Przepis 5. To samo ściąganie w modelu mieszanym (lme4, glmmTMB): Rysunek 4
# Korzysta z obiektów nauka, bs, f3, kol i motyw (przepisy 1–4). Bez losowania.
library(lme4)
library(glmmTMB)
library(patchwork)

# (a) Liniowy model mieszany z wagami: wariancja reszty = sigma² / pracownicy, efekt losowy firmy
m_lin <- lmer(wskaznik ~ 1 + (1 | firma), data = nauka, weights = pracownicy, REML = TRUE)
sigma2 <- sigma(m_lin)^2; tau2 <- as.numeric(VarCorr(m_lin)$firma)
round(c(sigma2 = sigma2, tau2 = tau2, k_model = sigma2 / tau2, wyraz_wolny = fixef(m_lin)[[1]]), 3)
pred_lin <- coef(m_lin)$firma[bs$firmy$firma, 1]

# (b) Ta sama formuła Bühlmanna–Strauba z wariancjami z modelu (sigma², tau²) zamiast z momentów
Z_m <- bs$firmy$w / (bs$firmy$w + sigma2 / tau2)
mu_m <- sum(Z_m * bs$firmy$historia) / sum(Z_m)
max(abs(mu_m + Z_m * (bs$firmy$historia - mu_m) - pred_lin))     # różnica: tylko błąd numeryczny

# (c) Uogólniony model mieszany dla liczby szkód: ujemny dwumianowy (nbinom1), offset log(pracowników / 100)
m_nb <- glmmTMB(szkody ~ 1 + (1 | firma), offset = log(pracownicy / 100), family = nbinom1, data = nauka)
re <- ranef(m_nb)$cond$firma
pred_nb <- exp(fixef(m_nb)$cond[[1]] + re[bs$firmy$firma, 1])
round(c(sd_firm_log = sqrt(as.numeric(VarCorr(m_nb)$cond$firma)), nadrozproszenie = sigma(m_nb)), 3)

por <- data.frame(firma = bs$firmy$firma, bs = bs$firmy$skladka, lin = pred_lin, nb = pred_nb)
round(c(r_lin = cor(por$bs, por$lin), r_nb = cor(por$bs, por$nb),
        max_roznica_lin = max(abs(por$bs - por$lin)), mediana_roznicy_nb = median(abs(por$bs - por$nb))), 3)
print(cbind(f3[, c("firma", "historia")], BS = f3$skladka, lmer = pred_lin[match(f3$firma, por$firma)],
            glmmTMB = pred_nb[match(f3$firma, por$firma)]), digits = 3, row.names = FALSE)

panel <- function(y, tytul) {
  ggplot(por, aes(bs, .data[[y]])) +
    geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = 2) +
    geom_point(colour = kol[["Model mieszany"]], size = 2, alpha = 0.8) +
    geom_point(data = por[por$firma %in% f3$firma, ], colour = kol[["granat"]], shape = 17, size = 3) +
    coord_equal(xlim = c(0, 13), ylim = c(0, 13)) +
    labs(title = tytul, x = "Bühlmann–Straub (ręcznie)", y = "Model mieszany") + motyw
}
p4 <- panel("lin", "A. lmer z wagami (liniowy)") + panel("nb", "B. glmmTMB, ujemny dwumianowy") +
  plot_annotation(title = "Składka z modelu mieszanego a składka Bühlmanna–Strauba (szkody na 100)",
                  theme = motyw)
p4   # zapis: ggsave("wiarygodnosc-model-mieszany.svg", p4, width = 10, height = 5.6)
Wynik w R
     sigma2        tau2     k_model wyraz_wolny
    951.954       7.472     127.407       5.173
[1] 3.552714e-15
    sd_firm_log nadrozproszenie
          0.551           0.624
             r_lin               r_nb    max_roznica_lin mediana_roznicy_nb
             0.999              0.988              1.105              0.101
 firma historia    BS  lmer glmmTMB
  F043     12.5  6.93  6.64    6.31
  F114      0.0  1.86  2.13    1.95
  F116     13.1 11.93 11.68   12.11
6. Sprawdzian na roku 2025 i 200 portfeli: Rysunek 5
R
# Przepis 6. Ocena: prognoza roku 2025 z lat 2020–2024 – historia, średnia, wiarygodność: Rysunek 5
# Korzysta z obiektów d, generuj(), buhlmann_straub(), kol i motyw (przepisy 1–3). Losuje: set.seed(7631).
library(patchwork)
klasy <- c("do 25 prac.", "26–100 prac.", "ponad 100 prac.")
ocen <- function(d) {                                  # błąd prognozy roku 2025 według wielkości firmy
  n <- d[d$rok <= 2024, ]; t <- d[d$rok == 2025, ]
  b <- buhlmann_straub(n$wskaznik, n$pracownicy, n$firma)
  t <- t[match(b$firmy$firma, t$firma), ]
  prog <- list("Historia firmy" = b$firmy$historia, "Średnia portfela" = rep(b$X_w, nrow(t)),
               "Wiarygodność" = b$firmy$skladka)
  klasa <- cut(tapply(n$pracownicy, n$firma, mean)[t$firma], c(0, 25, 100, Inf), labels = klasy)
  rmse <- function(cel, p, g) sqrt(sum(t$pracownicy[g] * (cel[g] - p[g])^2) / sum(t$pracownicy[g]))
  do.call(rbind, lapply(names(prog), function(m) do.call(rbind, lapply(c(klasy, "wszystkie"), function(k) {
    g <- if (k == "wszystkie") rep(TRUE, nrow(t)) else klasa == k
    data.frame(metoda = m, klasa = k, wobec_2025 = rmse(t$wskaznik, prog[[m]], g),
               wobec_prawdy = rmse(t$prawdziwa, prog[[m]], g)) }))))
}
# (a) nasz portfel: błąd względem szkód, które naprawdę zdarzyły się w 2025 r. (ważony pracownikami)
e1 <- ocen(d)
print(e1, digits = 3, row.names = FALSE)

# (b) 200 nowych portfeli z tego samego generatora: błąd względem prawdziwej częstości (znanej w symulacji)
set.seed(7631)
R <- 200
sym <- do.call(rbind, lapply(1:R, function(r) cbind(powt = r, ocen(generuj()))))
agg <- aggregate(wobec_prawdy ~ metoda + klasa, data = sym, FUN = function(x) c(sr = mean(x), se = sd(x) / sqrt(R)))
agg <- data.frame(agg[, 1:2], sr = agg$wobec_prawdy[, "sr"], se = agg$wobec_prawdy[, "se"])
print(agg, digits = 3, row.names = FALSE)
# W ilu portfelach wiarygodność dała mniejszy błąd niż historia i niż średnia (wszystkie firmy)
w <- reshape(sym[sym$klasa == "wszystkie", c("powt", "metoda", "wobec_prawdy")], idvar = "powt",
             timevar = "metoda", direction = "wide")
c(lepsza_od_historii = mean(w[["wobec_prawdy.Wiarygodność"]] < w[["wobec_prawdy.Historia firmy"]]),
  lepsza_od_sredniej = mean(w[["wobec_prawdy.Wiarygodność"]] < w[["wobec_prawdy.Średnia portfela"]]))

e1$klasa <- factor(e1$klasa, c(klasy, "wszystkie")); agg$klasa <- factor(agg$klasa, c(klasy, "wszystkie"))
e1$metoda <- factor(e1$metoda, names(kol)[1:3]); agg$metoda <- factor(agg$metoda, names(kol)[1:3])
agg$gora <- agg$sr + 1.96 * agg$se                    # etykieta nad odcinkiem błędu Monte Carlo
e1$gora <- e1$wobec_2025
slupki <- function(dane, y, tytul, os, cyfry) {
  ggplot(dane, aes(klasa, .data[[y]], fill = metoda)) +
    geom_col(position = position_dodge(0.8), width = 0.75, colour = "grey20", linewidth = 0.2) +
    geom_text(aes(y = gora, label = formatC(.data[[y]], format = "f", digits = cyfry)),
              position = position_dodge(0.8), vjust = -0.4, size = 3.3) +
    scale_fill_manual(values = kol[1:3], name = NULL) +
    scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
    labs(title = tytul, x = NULL, y = os) + motyw +
    theme(axis.text.x = element_text(size = rel(0.85)))
}
p5 <- slupki(e1, "wobec_2025", "A. Nasz portfel: błąd wobec szkód 2025 r.", "RMSE (szkody na 100)", 1) +
  (slupki(agg, "sr", "B. 200 portfeli: błąd wobec prawdziwej częstości", "Średni RMSE (szkody na 100)", 2) +
     geom_errorbar(aes(ymin = sr - 1.96 * se, ymax = sr + 1.96 * se), position = position_dodge(0.8), width = 0.2)) +
  plot_layout(ncol = 1, guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("wiarygodnosc-ocena-prognozy-2025.svg", p5, width = 10, height = 8)
Wynik w R
           metoda           klasa wobec_2025 wobec_prawdy
   Historia firmy     do 25 prac.       6.83        4.012
   Historia firmy    26–100 prac.       3.60        1.518
   Historia firmy ponad 100 prac.       1.93        0.939
   Historia firmy       wszystkie       2.91        1.431
 Średnia portfela     do 25 prac.       5.19        2.519
 Średnia portfela    26–100 prac.       4.26        2.432
 Średnia portfela ponad 100 prac.       3.91        3.276
 Średnia portfela       wszystkie       4.08        3.025
     Wiarygodność     do 25 prac.       5.29        2.185
     Wiarygodność    26–100 prac.       3.59        1.313
     Wiarygodność ponad 100 prac.       1.92        0.913
     Wiarygodność       wszystkie       2.74        1.133
           metoda           klasa    sr      se
   Historia firmy    26–100 prac. 1.752 0.01466
 Średnia portfela    26–100 prac. 2.731 0.02341
     Wiarygodność    26–100 prac. 1.459 0.01136
   Historia firmy     do 25 prac. 3.186 0.04598
 Średnia portfela     do 25 prac. 2.682 0.03116
     Wiarygodność     do 25 prac. 2.038 0.02688
   Historia firmy ponad 100 prac. 1.009 0.01297
 Średnia portfela ponad 100 prac. 2.681 0.03551
     Wiarygodność ponad 100 prac. 0.945 0.01157
   Historia firmy       wszystkie 1.521 0.01109
 Średnia portfela       wszystkie 2.718 0.02217
     Wiarygodność       wszystkie 1.244 0.00839
lepsza_od_historii lepsza_od_sredniej
              0.99               1.00
7. Pułapki: duża szkoda, zmiana wielkości, branże
R
# Przepis 7. Pułapki: rok z dużą szkodą, firma, która urosła, i branże jako osobne grupy
# Korzysta z obiektów d, nauka, bs, buhlmann_straub(), rosnaca i bus (przepisy 1–3). Bez losowania.
test <- d[d$rok == 2025, ]; test <- test[match(bs$firmy$firma, test$firma), ]
rmse <- function(cel, p) sqrt(sum(test$pracownicy * (cel - p)^2) / sum(test$pracownicy))

# (a) Wypadek busa: 6 poszkodowanych z jednego zdarzenia. Wiarygodność liczona na liczbie wypadków,
#     a liczba poszkodowanych na wypadek – ze średniej portfela
nauka$wsk_wypadki <- 100 * nauka$wypadki / nauka$pracownicy
bw <- buhlmann_straub(nauka$wsk_wypadki, nauka$pracownicy, nauka$firma)
osob_na_wypadek <- sum(nauka$szkody) / sum(nauka$wypadki)
skladka_wyp <- bw$firmy$skladka * osob_na_wypadek
round(c(k_szkody = bs$k, k_wypadki = bw$k, osob_na_wypadek = osob_na_wypadek), 3)
nauka[nauka$firma == bus, c("rok", "pracownicy", "wypadki", "szkody")]
i <- bs$firmy$firma == bus
round(c(historia = bs$firmy$historia[i], Z_szkody = bs$firmy$Z[i], skladka_szkody = bs$firmy$skladka[i],
        Z_wypadki = bw$firmy$Z[i], skladka_wypadki = skladka_wyp[i], prawdziwa = test$prawdziwa[i]), 2)
round(c(rmse_szkody = rmse(test$prawdziwa, bs$firmy$skladka), rmse_wypadki = rmse(test$prawdziwa, skladka_wyp)), 3)

# (b) Firma biurowa, która w 2023 r. otworzyła magazyn (5 razy więcej pracowników)
nauka[nauka$firma == rosnaca, c("rok", "pracownicy", "szkody")]
j <- bs$firmy$firma == rosnaca
ost <- nauka[nauka$firma == rosnaca & nauka$rok >= 2023, ]              # tylko lata po zmianie
w2 <- sum(ost$pracownicy); X2 <- 100 * sum(ost$szkody) / w2; Z2 <- w2 / (w2 + bs$k)
round(c(skladka_5_lat = bs$firmy$skladka[j], skladka_2_lata = bs$mu + Z2 * (X2 - bs$mu), Z_2_lata = Z2,
        wskaznik_2025 = test$wskaznik[j], prawdziwa = test$prawdziwa[j]), 2)

# (c) Branże: osobny model Bühlmanna–Strauba w każdej branży (średnia branży zamiast średniej portfela)
br <- do.call(rbind, lapply(split(nauka, nauka$branza), function(x) {
  b <- buhlmann_straub(x$wskaznik, x$pracownicy, x$firma)
  cbind(b$firmy, branza = x$branza[1], k = b$k, mu = b$mu) }))
print(unique(br[, c("branza", "k", "mu")]), digits = 3, row.names = FALSE)
br <- br[match(bs$firmy$firma, br$firma), ]
round(c(rmse_portfel = rmse(test$prawdziwa, bs$firmy$skladka), rmse_branze = rmse(test$prawdziwa, br$skladka),
        rmse_portfel_2025 = rmse(test$wskaznik, bs$firmy$skladka), rmse_branze_2025 = rmse(test$wskaznik, br$skladka)), 3)
Wynik w R
       k_szkody       k_wypadki osob_na_wypadek
        101.814          80.150           1.117
     rok pracownicy wypadki szkody
79  2020         15       0      0
199 2021         15       0      0
319 2022         15       2      7
439 2023         14       1      1
559 2024         14       0      0
       historia        Z_szkody  skladka_szkody       Z_wypadki skladka_wypadki       prawdziwa
          10.96            0.42            7.59            0.48            4.92            3.96
 rmse_szkody rmse_wypadki
       1.133        1.022
     rok pracownicy szkody
27  2020         19      0
147 2021         18      0
267 2022         21      0
387 2023         90      9
507 2024        100      7
 skladka_5_lat skladka_2_lata       Z_2_lata  wskaznik_2025      prawdziwa
          6.08           7.29           0.65           7.37           7.00
             branza   k   mu
     biura i usługi 270 2.86
  handel i magazyny 285 4.53
 produkcja i budowa 497 8.22
     rmse_portfel       rmse_branze rmse_portfel_2025  rmse_branze_2025
            1.133             1.091             2.741             2.659
8. Grafika: karta „Z – od średniej portfela do historii firmy”: Rysunek 6
R
# Przepis 8. Grafika: karta „Z – od średniej portfela do historii firmy”: Rysunek 6
# Korzysta z obiektów bs, f3, kol i motyw (przepisy 1–3). Bez losowania.
k3 <- f3; k3$y <- 3:1
szkod <- function(n) ifelse(n == 1, "szkoda", ifelse(n %% 10 %in% 2:4 & !(n %% 100 %in% 12:14), "szkody", "szkód"))
k3$opis <- sprintf("%s · %d prac.\n%.0f pracownikolat, %d %s", k3$firma, k3$pracownicy, k3$w, k3$szkody, szkod(k3$szkody))
pkt <- rbind(data.frame(y = k3$y, x = bs$mu, rola = "Średnia portfela"),
             data.frame(y = k3$y, x = k3$historia, rola = "Historia firmy"),
             data.frame(y = k3$y, x = k3$skladka, rola = "Wiarygodność"))
pkt$rola <- factor(pkt$rola, c("Średnia portfela", "Historia firmy", "Wiarygodność"))
p6 <- ggplot() +
  annotate("rect", xmin = -9.4, xmax = 15.4, ymin = 0.45, ymax = 3.55, fill = "#f7f5f1", colour = "#dedbd4") +
  geom_segment(data = k3, aes(x = 0, xend = 15, y = y, yend = y), colour = "grey85", linewidth = 2.2) +
  geom_segment(data = k3, aes(x = bs$mu, xend = historia, y = y, yend = y), colour = "grey45", linewidth = 1,
               arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  geom_point(data = pkt, aes(x, y, colour = rola, shape = rola), size = 4.2, stroke = 1.3) +
  geom_text(data = k3, aes(x = -9.1, y = y, label = opis), hjust = 0, size = 3.8, lineheight = 0.95,
            colour = kol[["granat"]]) +
  geom_text(data = k3, aes(x = skladka, y = y + 0.32,
                           label = sprintf("Z = %.2f → %.2f", Z, skladka)), size = 3.9, fontface = "bold",
            colour = kol[["granat"]]) +
  annotate("text", x = 3, y = 4.25, size = 4.6, colour = kol[["granat"]], fontface = "bold",
           label = sprintf("składka = μ + Z × (historia − μ),   Z = w / (w + k),   k = %.1f pracownikolat", bs$k)) +
  annotate("text", x = 3, y = 0.1, size = 3.7, colour = "grey25",
           label = "Z rośnie z liczbą pracownikolat, nie z liczbą szkód. Pięć lat bez szkody też jest informacją.") +
  scale_colour_manual(values = kol[c("Średnia portfela", "Historia firmy", "Wiarygodność")], name = NULL) +
  scale_shape_manual(values = c(15, 16, 18), name = NULL) +
  scale_x_continuous(breaks = seq(0, 15, 5), limits = c(-9.5, 15.5)) +
  scale_y_continuous(limits = c(-0.1, 4.5)) +
  labs(title = "Z – od średniej portfela do historii firmy",
       subtitle = sprintf("Szkody na 100 pracowników; średnia portfela μ = %.2f", bs$mu), x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.y = element_blank())
p6   # zapis: ggsave("wiarygodnosc-karta-z.svg", p6, width = 10, height = 5.6)
9. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("historia – średnia" = c("#D55E00", "#0072B2"),
             "historia – wiarygodność" = c("#D55E00", "#009E73"),
             "średnia – wiarygodność" = c("#0072B2", "#009E73"),
             "małe – duże firmy (Rys. 3)" = c("#E69F00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
historia – średnia                         114.6        108.3       91.9
historia – wiarygodność                    102.4         53.5       37.3
średnia – wiarygodność                      70.1         55.4       58.0
małe – duże firmy (Rys. 3)                  88.7         66.3       51.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i model Bühlmanna–Strauba (wzory momentów) – pakiet stats i funkcje bazowe R. Liniowy model mieszany policzono pakietem lme4, model ujemny dwumianowy z efektem losowym – pakietem glmmTMB. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a paletę sprawdzono pakietem colorspace. Pakiet actuar, który ma gotową funkcję do modelu Bühlmanna–Strauba, nie jest tu potrzebny – wzory mieszczą się w kilku wierszach. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- glmmTMB (wersja 1.1.15.2): Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
Pułapki
- Rok z dużą szkodą. F079 (14–15 pracowników) miała w 2022 r. wypadek busa z 6 poszkodowanymi. Historia 10.96, Z = .42 i składka 7.59 – prawie dwa razy więcej niż prawdziwa częstość 3.96. Gdy wiarygodność liczymy na liczbie wypadków, a liczbę poszkodowanych na wypadek (1.117) bierzemy ze średniej portfela, składka F079 spada do 4.92, a RMSE całego portfela wobec prawdy – z 1.133 do 1.022. Zdarzenia masowe oddzielaj od zwykłej częstości.
- Zmiana wielkości firmy. F027 miała 18–21 pracowników bez żadnej szkody, a od 2023 r. z nowym magazynem 90–100 pracowników i 16 szkód w dwa lata. Model z pięciu lat daje 6.08, model tylko z lat po zmianie 7.29 (Z = .65); w 2025 r. wskaźnik wyniósł 7.37 przy prawdziwej częstości 7.00. Po zmianie profilu firmy stara historia opisuje inne ryzyko.
- Branża jako grupa. Osobny model w każdej branży ma średnie 2.86, 4.53 i 8.22 oraz większe k (270, 285, 497), bo część różnic wyjaśnia już branża; RMSE wobec prawdy spada z 1.133 do 1.091. Kilka poziomów grupowania naraz obsługują modele wielopoziomowe dla liczby szkód (Antonio i in., 2010).
- Trend i szkody zgłoszone później. Model zakłada stałą częstość firmy, więc wspólny trend portfela usuń wcześniej. Ostatni rok bywa niepełny – zob. trójkąt szkód. Inny problem z należnościami firm-klientów opisuje wpis o zaległościach w opłatach.
Najczęstsze pytania
Co to jest współczynnik wiarygodności Z w ubezpieczeniach grupowych?
To waga, z jaką do składki wchodzi własna historia szkód grupy: składka = średnia portfela + Z × (historia − średnia portfela). W modelu Bühlmanna–Strauba Z = w / (w + k), gdzie w to wielkość ekspozycji (np. pracownikolata), a k to stosunek wariancji w grupie do wariancji między grupami. W przykładzie k = 101.8, więc firma z 32 pracownikolatami ma Z = .24, a z 571 – Z = .85.
Jak policzyć k w modelu Bühlmanna–Strauba?
Potrzebne są dwie wariancje z danych z kilku lat. Wariancja w firmie s² to ważona suma kwadratów odchyleń rocznych wskaźników od średniej firmy podzielona przez liczbę lat minus jeden, zsumowaną po firmach. Wariancja między firmami a to rozrzut średnich firm pomniejszony o część wynikającą z s². W przykładzie s² = 946.3, a = 9.29, więc k = s²/a = 101.8 pracownikolat.
Czy grupa bez żadnej szkody powinna mieć składkę zero?
Nie. Pięć lat bez szkody to informacja, ale nie dowód zerowego ryzyka. W przykładzie firma z 36 pracownikami (182 pracownikolata) bez szkód dostała Z = .64 i składkę 1.86 szkody na 100 pracowników zamiast 0 – mniej niż średnia portfela 5.18, ale wyraźnie więcej niż zero.
Czy model mieszany daje to samo co wiarygodność Bühlmanna?
Tak, jeśli ma tę samą strukturę: liniowy model z losowym wyrazem wolnym firmy i wagami równymi liczbie pracowników daje predykcje ze wzoru Bühlmanna–Strauba. Różni się tylko szacowaniem wariancji (REML zamiast momentów), dlatego w przykładzie k wyszło 127.4 zamiast 101.8, a korelacja składek – .999. Model ujemny dwumianowy dla liczby szkód (glmmTMB) dał korelację .988.
Co zrobić z rokiem, w którym grupa miała jedną bardzo dużą szkodę?
Oddziel zdarzenia masowe od zwykłej częstości. W przykładzie wypadek busa z 6 poszkodowanymi podniósł składkę małej firmy do 7.59 przy prawdziwej częstości 3.96. Gdy wiarygodność policzono na liczbie wypadków, a liczbę poszkodowanych na wypadek wzięto ze średniej portfela, składka spadła do 4.92, a błąd całego portfela zmalał z 1.133 do 1.022.
Powiązane hasła
Przeczytaj też
Częstość i wysokość szkód – składka
Ubezpieczenie telefonów i laptopów: Poisson z offsetem, regresja gamma, bootstrap składki, Tweedie i Gini na polisach testowych – z kodem R.
Czytaj →PoradnikTrójkąt szkód – chain-ladder i rezerwy
Ubezpieczyciel mienia małych firm: chain-ladder ręcznie, ten sam wynik z GLM, rozkład rezerwy z bootstrapu i reszty wg roku kalendarzowego – w R.
Czytaj →PoradnikModel mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o taryfikacji albo analizujesz szkodowość grup?
Pomożemy dobrać model wiarygodności lub model mieszany, oszacować wariancje, sprawdzić prognozę na kolejnym roku i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Antonio, K., Frees, E. W., & Valdez, E. A. (2010). A multilevel analysis of intercompany claim counts. ASTIN Bulletin, 40(1), 151–177. https://doi.org/10.2143/ast.40.1.2049223
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/rj-2017-066 ● Otwarty dostęp
- Bühlmann, H. (1967). Experience rating and credibility. ASTIN Bulletin, 4(3), 199–207. https://doi.org/10.1017/s0515036100008989 ● Otwarty dostęp
- Nelder, J. A., & Verrall, R. J. (1997). Credibility theory and generalized linear models. ASTIN Bulletin, 27(1), 71–82. https://doi.org/10.2143/ast.27.1.563206 ● Otwarty dostęp: pełny tekst
- Ohlsson, E. (2008). Combining generalized linear models and credibility models in practice. Scandinavian Actuarial Journal, 2008(4), 301–314. https://doi.org/10.1080/03461230701878612
- Robinson, G. K. (1991). That BLUP is a good thing: The estimation of random effects. Statistical Science, 6(1), 15–32. https://doi.org/10.1214/ss/1177011926 ● Otwarty dostęp
Cytowania BibTeX
@article{antonio2010multilevel, author={Antonio, Katrien and Frees, Edward W. and Valdez, Emiliano A.}, title={{A multilevel analysis of intercompany claim counts}}, journal={ASTIN Bulletin}, year={2010}, volume={40}, number={1}, pages={151--177}, doi={10.2143/ast.40.1.2049223}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{brooks2017glmmtmb, author={Brooks, Mollie E. and Kristensen, Kasper and van Benthem, Koen J. and Magnusson, Arni and Berg, Casper W. and Nielsen, Anders and Skaug, Hans J. and M{\"a}chler, Martin and Bolker, Benjamin M.}, title={{glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling}}, journal={The R Journal}, year={2017}, volume={9}, number={2}, pages={378--400}, doi={10.32614/rj-2017-066}}@article{buhlmann1967experience, author={B{\"u}hlmann, Hans}, title={{Experience rating and credibility}}, journal={ASTIN Bulletin}, year={1967}, volume={4}, number={3}, pages={199--207}, doi={10.1017/s0515036100008989}}@article{nelder1997credibility, author={Nelder, J. A. and Verrall, R. J.}, title={{Credibility theory and generalized linear models}}, journal={ASTIN Bulletin}, year={1997}, volume={27}, number={1}, pages={71--82}, doi={10.2143/ast.27.1.563206}}@article{ohlsson2008combining, author={Ohlsson, Esbj{\"o}rn}, title={{Combining generalized linear models and credibility models in practice}}, journal={Scandinavian Actuarial Journal}, year={2008}, volume={2008}, number={4}, pages={301--314}, doi={10.1080/03461230701878612}}@article{robinson1991that, author={Robinson, G. K.}, title={{That BLUP is a good thing: The estimation of random effects}}, journal={Statistical Science}, year={1991}, volume={6}, number={1}, pages={15--32}, doi={10.1214/ss/1177011926}}