Przykład: ubezpieczyciel mienia małych firm i szkody, których jeszcze nie wypłacono
Fikcyjny ubezpieczyciel ubezpiecza mienie małych firm: warsztaty, sklepy, biura. Pożar czy zalanie zdarza się w danym roku, ale pieniądze płyną latami: szkodę zgłasza się z opóźnieniem, likwidator ustala jej rozmiar, firma odbudowuje lokal i przysyła kolejne faktury. Na koniec 2025 r. część szkód z lat 2016–2025 nie jest jeszcze w pełni wypłacona. Zarząd pyta: ile pieniędzy odłożyć na wypłaty za szkody, które już się zdarzyły? Ta kwota to rezerwa szkodowa.
Dane to wypłaty w tys. zł według roku zajścia szkody (2016–2025) i roku rozwoju (1 = rok zajścia, 2 = rok następny…). Dla szkód z 2016 r. znamy 10 lat wypłat, dla szkód z 2025 r. – tylko pierwszy. Razem 55 komórek i 95.90 mln zł wypłat. Rezerwy i taryfy w prawdziwym ubezpieczycielu podlegają regulacjom i pracy aktuariusza; tu pokazujemy samą metodę statystyczną.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Liczba polis rośnie z 4000 do 6200, oczekiwana wartość szkód to 2.2 tys. zł na polisę, a wypłaty rozkładają się na lata rozwoju według stałego wzorca (38% w pierwszym roku, 24% w drugim… 1.5% po dziesiątym). Wypłaty w komórkach losujemy z nadrozproszonego rozkładu Poissona (wariancja = 10 × średnia). Ukryliśmy dwa kłopoty: od 2023 r. naprawy są droższe o 20% (materiały, robocizna), a w 2021 r. wypłacono jedną dużą szkodę z 2020 r. – pożar hali za 1.2 mln zł. Znamy też przyszłe wypłaty, których ubezpieczyciel jeszcze nie widzi: 24.83 mln zł bez ogona. Ziarna to 762 (dane) i 7621 (bootstrap). Po pierwszym uruchomieniu zmieniliśmy (bez zmiany ziaren) rozproszenie z 25 na 10, wariant wzrostu kosztów (łagodniejsze wersje ginęły w szumie) i dużą szkodę (z 1.5 mln zł w 2022 r. na 1.2 mln zł w 2020 r., żeby nie nakładała się na skok kosztów). Dane pobierzesz jako trojkat-szkod-wyplaty.csv.
Rysunek 1: trójkąt rozwoju szkód
Ułóż skumulowane wypłaty w tabelę: wiersz to rok zajścia, kolumna to rok rozwoju. Znane komórki tworzą trójkąt, a ostatnia przekątna to stan na koniec 2025 r. Puste komórki pod przekątną trzeba uzupełnić. Rezerwa = prognozowana wartość ostateczna − to, co już wypłacono.
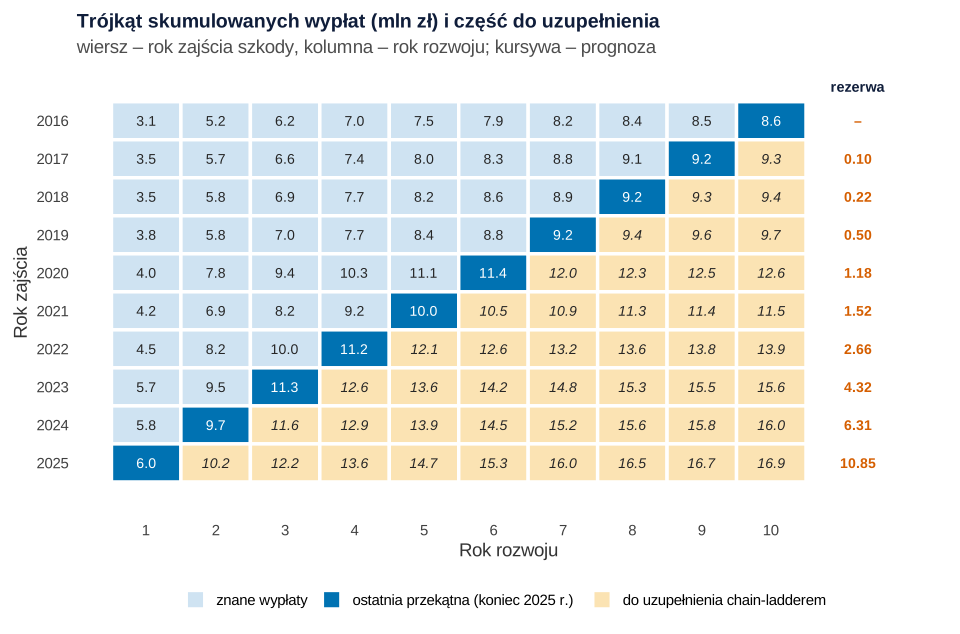
set.seed(762)).Co widać. Szkody z 2025 r. dały dotąd 6.03 mln zł, a według prognozy kosztują 16.88 mln zł – rezerwa 10.85 mln zł. Im młodszy rok zajścia, tym większa część kwoty jest jeszcze przed nami.
Jak może zmylić. Kursywa wygląda równie precyzyjnie jak dane, a jest prognozą (rysunki 3 i 4).
Podpis do pracy:
Rysunek 2: metoda chain-ladder liczona ręcznie
Chain-ladder zakłada, że każdy rok zajścia „dojrzewa” w tym samym tempie. Tempo mierzy współczynnik rozwoju: ile razy rosną skumulowane wypłaty z roku rozwoju j do j + 1. Liczymy go jako średnią ważoną – sumę z kolumny j + 1 dzielimy przez sumę z kolumny j, tylko dla lat zajścia, które znają obie kolumny:
Potem mnożymy ostatnią znaną wartość wiersza przez kolejne współczynniki. Tę samą logikę mnożnika z przeszłych sezonów stosuje metoda pick-up w prognozie obłożenia z krzywej rezerwacji.
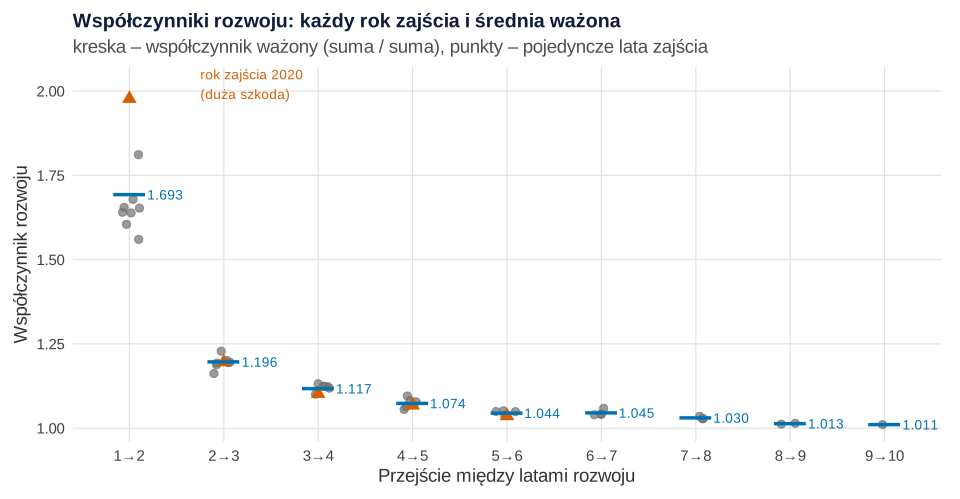
set.seed(762)).Co widać. Z roku 1 do 2 wypłaty rosną średnio 1.693 razy, z roku 9 do 10 już tylko 1.011 razy. Iloczyn wszystkich współczynników to 2.799: tyle razy, według metody, wzrosną wypłaty szkód z 2025 r. (6.03 × 2.799 = 16.88 mln zł). Łączna rezerwa wynosi 27.66 mln zł.
Jak może zmylić. Jeden rok z dużą szkodą (2020, współczynnik bliski 2) podnosi średnią dla całego portfela. Kreska ważona wygląda stabilnie także wtedy, gdy tempo wypłat w ostatnich latach się zmieniło (zob. pułapki).
Podpis do pracy:
Chain-ladder jako model Poissona nadrozproszonego
Te same rezerwy daje regresja Poissona dla wypłat przyrostowych (nie skumulowanych) z dwoma czynnikami: rokiem zajścia i rokiem rozwoju. Model pozwala na wariancję większą niż średnia – to rodzina quasi-Poissona (Renshaw i Verrall, 1998; England i Verrall, 2002). Krok po kroku o modelach zliczeń piszemy w poradniku regresja dla zliczeń; tu „zliczeniem” są złotówki, co dopuszcza właśnie podejście quasi-wiarygodności (Gardner i in., 1995).
W przykładzie model ma 19 parametrów na 55 komórkach (36 stopni swobody reszt). Rezerwy z glm() zgadzają się z ręcznym chain-ladderem co do grosza w każdym roku: razem 27.66 mln zł. Współczynnik rozproszenia φ = 19.9 – wariancja wypłaty w komórce to ok. 20 × jej średnia (w tys. zł). W R jest gotowy pakiet ChainLadder, ale wszystko tu da się policzyć funkcjami podstawowymi.
Rysunek 3: rozkład rezerwy z bootstrapu reszt Pearsona
Jedna liczba 27.66 mln zł nie mówi, ile może być więcej. Rozkład rezerwy daje bootstrap reszt Pearsona w wersji Englanda i Verralla (England i Verrall, 2002; Pinheiro i in., 2003):
- Dopasuj model i policz reszty Pearsona (y − μ)/√μ, z poprawką na liczbę parametrów.
- Losuj reszty ze zwracaniem i zbuduj pseudotrójkąt: μ + reszta × √μ.
- Policz na nim chain-ladder i przyszłe wypłaty.
- Dodaj losowość samych wypłat: każdą przyszłą komórkę wylosuj z rozkładu gamma o tej średniej i wariancji φ × średnia.
- Powtórz 5000 razy.
Krok 4 dodaje losowość samych wypłat do błędu oszacowania. Losowanie z rozkładu w kroku 4 to element bootstrapu parametrycznego; idea bootstrapu pochodzi od Efrona (1979).
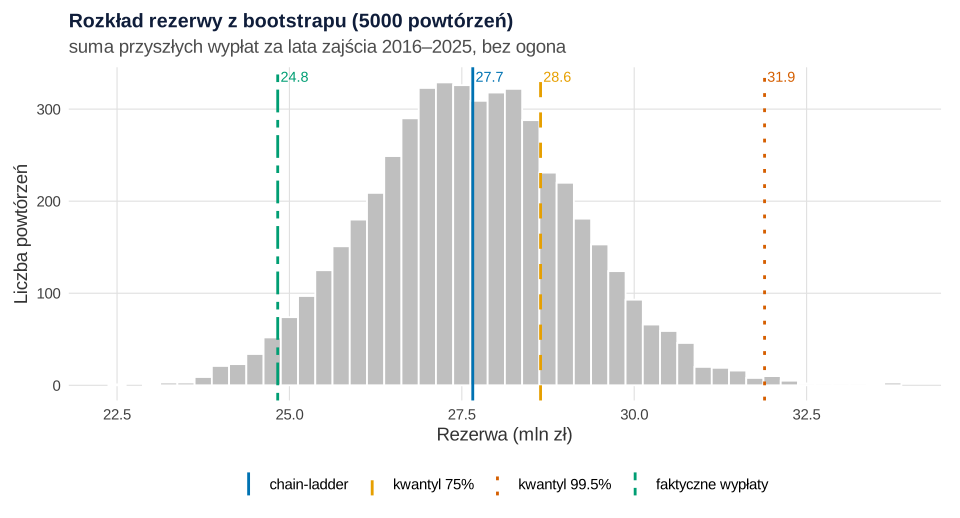
set.seed(7621)).Co widać. Średnia z bootstrapu (27.66 mln zł) pokrywa się z chain-ladderem, odchylenie standardowe to 1.51 mln zł (współczynnik zmienności 5.5%). Kwantyl 75% wynosi 28.64 mln zł, 95% – 30.17 mln zł, a 99.5% – 31.89 mln zł. Żeby pokryć wypłaty z prawdopodobieństwem 75%, trzeba dołożyć do oszacowania 0.98 mln zł, a dla 99.5% – 4.23 mln zł. Kwantyl 99.5% to ta sama logika co w VaR dla ryzyka kursowego.
Jak może zmylić. Faktyczne przyszłe wypłaty (24.83 mln zł) leżą na 2.7. centylu rozkładu. Bootstrap mierzy niepewność przy założeniu, że model jest dobry. Nie wie o skoku kosztów w 2023 r. ani o dużej szkodzie, więc cały rozkład stoi w złym miejscu. Najpierw sprawdź reszty (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: niepewność rezerwy w każdym roku zajścia
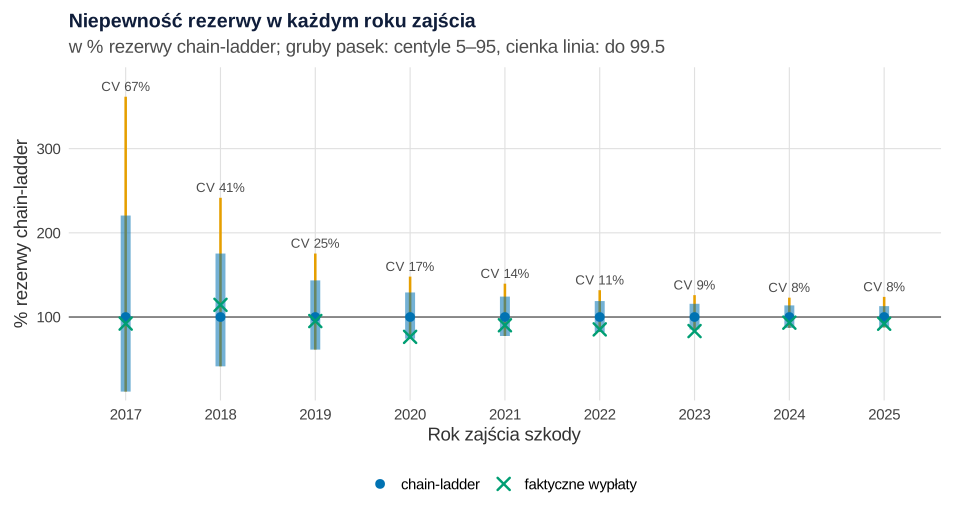
set.seed(7621)).Co widać. Względna niepewność maleje z wielkością rezerwy: dla 2017 r. rezerwa to 0.10 mln zł z CV 67%, dla 2025 r. 10.85 mln zł z CV 8%. Stare lata mają mało do wypłaty, ale ta resztka jest bardzo niepewna.
Jak może zmylić. Kwantyli 99.5% z lat nie sumuj: 99.5% dla całości (31.89 mln zł) jest mniejszy niż suma kwantyli lat, bo złe wyniki rzadko trafiają się we wszystkich latach naraz. W latach 2020–2023 faktyczne wypłaty są niższe od rezerwy – to znów skok kosztów i duża szkoda.
Podpis do pracy:
Rysunek 5: reszty według roku kalendarzowego – czy jest inflacja?
Chain-ladder zakłada, że wypłata zależy tylko od roku zajścia i roku rozwoju. Wzrost cen napraw działa jednak w roku kalendarzowym (rok zajścia + rok rozwoju − 1), czyli wzdłuż przekątnych trójkąta. Sprawdzisz to na wykresie reszt według roku kalendarzowego; inne wzorce złamanych założeń pokazuje galeria wykresów reszt.
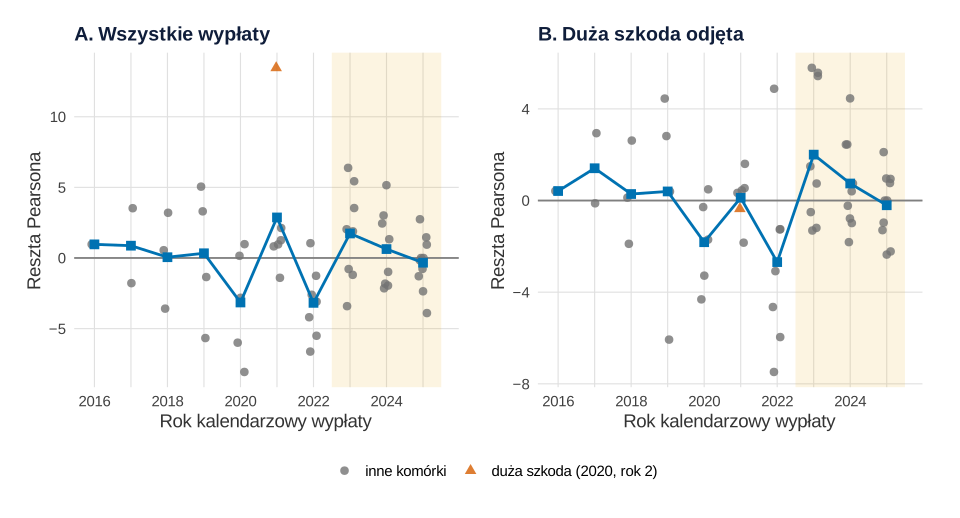
Co widać. Panel A: duża szkoda ma resztę 13.46 i zawyża φ z 12.0 do 19.9 – jest obserwacją odstającą, którą trzeba traktować osobno. Panel B: średnia reszta spada do −2.69 w 2022 r. i skacze do +2.00 w 2023 r. Model z dodatkowym efektem „wypłata od 2023 r.” jest istotnie lepszy: F(1, 35) = 11.77, p = .002 (porównanie dewiancji). Wypłaty od 2023 r. są o 15.6% wyższe, 95% CI [6.4, 25.7] – ukryliśmy 20%.
Jak może zmylić. Stałej, równej inflacji w całym okresie wykres nie pokaże: chain-ladder wchłania ją w współczynniki rozwoju i poziomy lat. Widać tylko zmianę tempa. A zmiana tempa w ostatnich latach wchodzi do współczynników i jest przenoszona na przyszłość jak „normalny” rozwój. Model z efektem roku kalendarzowego i bez dużej szkody daje 25.97 mln zł zamiast 27.66 – bliżej faktycznych 24.83 mln zł.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Podawaj rezerwę z rozkładem, nie jedną liczbą. Oszacowanie najlepsze (27.66 mln zł), kwantyl 75% (28.64) i 99.5% (31.89) to trzy różne odpowiedzi na trzy pytania: ile się spodziewamy, ile odłożyć ostrożnie, ile przy bardzo złym scenariuszu.
- Zanim policzysz bootstrap, obejrzyj reszty. Rozkład z rysunku 3 jest wąski i mylący, bo model nie wiedział o skoku kosztów. Wykres reszt według roku kalendarzowego zajmuje minutę.
- Duże szkody licz osobno. Pożar hali to nie „rozwój” portfela. Wyłącz go z trójkąta i zarezerwuj indywidualnie (zwykle robi to likwidator).
- Pytaj likwidatorów o zmiany. Szybsze wypłaty czy droższe naprawy przesuwają współczynniki bardziej niż losowość.
- Łącz rezerwę ze składką. Rezerwa mówi, ile kosztowały szkody z przeszłości; ile pobierać za nowe polisy, pokazuje wpis o częstości i wysokości szkód, a ile ufać historii jednego klienta – wpis o wiarygodności Bühlmanna. Szersze tło daje statystyka w pracy z finansów i rachunkowości.
Jak opisać w pracy
Mack (1993) wyprowadził wzór na błąd standardowy rezerwy chain-ladder bez założeń o rozkładzie; w pracy możesz podać go obok bootstrapu jako drugie oszacowanie niepewności. Napisz, czy rezerwa zawiera ogon, czy duże szkody wyłączono i jak sprawdzono efekt roku kalendarzowego.
| Rok zajścia | Wypłacono do 2025 r. | Wartość ostateczna | Rezerwa | SD (bootstrap) | Kwantyl 99.5% |
|---|---|---|---|---|---|
| 2016 | 8.61 | 8.61 | 0.00 | – | – |
| 2017 | 9.24 | 9.34 | 0.10 | 0.07 | 0.35 |
| 2018 | 9.17 | 9.39 | 0.22 | 0.09 | 0.53 |
| 2019 | 9.16 | 9.66 | 0.50 | 0.13 | 0.88 |
| 2020 | 11.45 | 12.63 | 1.18 | 0.20 | 1.74 |
| 2021 | 10.01 | 11.53 | 1.52 | 0.22 | 2.12 |
| 2022 | 11.24 | 13.90 | 2.66 | 0.30 | 3.51 |
| 2023 | 11.32 | 15.64 | 4.32 | 0.40 | 5.45 |
| 2024 | 9.67 | 15.98 | 6.31 | 0.51 | 7.76 |
| 2025 | 6.03 | 16.88 | 10.85 | 0.84 | 13.44 |
| Razem | 95.90 | 123.56 | 27.66 | 1.51 | 31.89 |
Kod R: trójkąt, chain-ladder, GLM, bootstrap i reszty
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę kol, motyw motyw i funkcję minus(), a przepis 2 – funkcje wspolczynniki() i uzupelnij(), z których korzystają następne. Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(762)) i 4 (set.seed(7621)); rozrzut punktów na rysunkach 2 i 5 ma stałe ziarna 1 i 2. Ręcznie ustalono: lata 2016–2025, liczbę polis (od 4000 do 6200), wartość szkód na polisę (2.2 tys. zł), wzorzec wypłat (38, 24, 12, 8, 5.5, 4, 3, 2, 1.2 i 0.8% w latach rozwoju 1–10; 1.5% po 10. roku), rozproszenie (wariancja = 10 × średnia), skok kosztów o 20% od roku kalendarzowego 2023, dużą szkodę (1.2 mln zł, rok zajścia 2020, rok rozwoju 2), liczbę powtórzeń bootstrapu (5000), lata do ekstrapolacji ogona (4–9) i tempo szybszej likwidacji (45%). Po pierwszym uruchomieniu zmieniono rozproszenie (z 25 na 10), wariant wzrostu kosztów i dużą szkodę – opis przy danych na początku wpisu; ziaren nie zmieniano. Zmieniono też rysunek 4 (skala w procentach rezerwy zamiast mln zł, bo małe lata były niewidoczne). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: wypłaty wg roku zajścia i roku rozwoju
R
# Przepis 1. Fikcyjny ubezpieczyciel mienia małych firm: wypłaty szkód wg roku zajścia i roku rozwoju
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(znane = "#0072B2", prognoza = "#E69F00", akcent = "#D55E00", prawda = "#009E73", szary = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-(?=[0-9])", "−", x, perl = TRUE)   # znak minus (−) w etykietach

# Parametry ustalone ręcznie (kwoty w tys. zł)
lata <- 2016:2025                                   # lata zajścia szkody
n_lat <- length(lata)
polisy <- round(seq(4000, 6200, length.out = n_lat))  # liczba polis mienia małych firm w danym roku
szkoda_na_polise <- 2.2                              # oczekiwana wartość wszystkich szkód na polisę (tys. zł)
wzorzec <- c(0.38, 0.24, 0.12, 0.08, 0.055, 0.04, 0.03, 0.02, 0.012, 0.008)  # udział wypłat w latach rozwoju 1–10
ogon <- 1 - sum(wzorzec)                             # 1.5% wypłat przychodzi po 10. roku rozwoju
phi <- 10                                            # rozproszenie: wariancja wypłaty = 10 × średnia
skok_kosztow <- 1.20                                 # od 2023 r. naprawy i odbudowa droższe o 20% (materiały, robocizna)
duza_szkoda <- c(rok = 2020, rozwoj = 2, kwota = 1200)  # jeden pożar hali (tys. zł) wypłacony w 2021 r.

set.seed(762)
kw <- expand.grid(rok_zajscia = lata, rok_rozwoju = 1:n_lat)
kw$rok_kalendarzowy <- kw$rok_zajscia + kw$rok_rozwoju - 1
mnoznik <- ifelse(kw$rok_kalendarzowy >= 2023, skok_kosztow, 1)    # wypłaty w latach kalendarzowych 2023+
kw$srednia <- polisy[kw$rok_zajscia - 2015] * szkoda_na_polise * wzorzec[kw$rok_rozwoju] * mnoznik
kw$wyplata <- phi * rpois(nrow(kw), kw$srednia / phi)                       # nadrozproszony Poisson
jest_duza <- kw$rok_zajscia == duza_szkoda[["rok"]] & kw$rok_rozwoju == duza_szkoda[["rozwoj"]]
kw$wyplata[jest_duza] <- kw$wyplata[jest_duza] + duza_szkoda[["kwota"]]
kw$znane <- kw$rok_kalendarzowy <= 2025                                     # stan na koniec 2025 r.

# Trójkąt: przyrostowy (wypłaty w danym roku) i skumulowany (wypłaty od początku)
przyrost <- xtabs(wyplata ~ rok_zajscia + rok_rozwoju, data = kw)
przyrost <- matrix(przyrost, n_lat, dimnames = list(lata, 1:n_lat))
przyrost[!matrix(kw$znane, n_lat)] <- NA
skum <- t(apply(przyrost, 1, cumsum))
prawda_kwadrat <- matrix(kw$wyplata, n_lat, dimnames = list(lata, 1:n_lat))   # pełny kwadrat – znamy, bo dane są fikcyjne
prawdziwa_rezerwa <- rowSums(prawda_kwadrat * !matrix(kw$znane, n_lat))

dane <- subset(kw, znane, c(rok_zajscia, rok_rozwoju, rok_kalendarzowy, wyplata))
dane$wyplata_skumulowana <- skum[cbind(dane$rok_zajscia - 2015, dane$rok_rozwoju)]
write.csv(dane, "trojkat-szkod-wyplaty.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(polisy_2016 = polisy[1], polisy_2025 = polisy[n_lat], ogon_proc = 100 * ogon, komorki_znane = nrow(dane))
round(skum / 1000, 2)                                # trójkąt skumulowanych wypłat (mln zł)
c(wyplacono_mln = round(sum(dane$wyplata) / 1000, 2),
  prawdziwa_rezerwa_bez_ogona_mln = round(sum(prawdziwa_rezerwa) / 1000, 2))
Wynik w R
  polisy_2016   polisy_2025     ogon_proc komorki_znane
       4000.0        6200.0           1.5          55.0
        1    2     3     4     5     6    7    8    9   10
2016 3.13 5.18  6.22  7.04  7.49  7.86 8.19 8.42 8.52 8.61
2017 3.54 5.68  6.60  7.42  8.00  8.31 8.80 9.11 9.24   NA
2018 3.54 5.80  6.92  7.74  8.17  8.57 8.92 9.17   NA   NA
2019 3.75 5.85  6.95  7.65  8.38  8.81 9.16   NA   NA   NA
2020 3.97 7.85  9.39 10.35 11.05 11.45   NA   NA   NA   NA
2021 4.20 6.89  8.23  9.25 10.01    NA   NA   NA   NA   NA
2022 4.50 8.15 10.01 11.24    NA    NA   NA   NA   NA   NA
2023 5.73 9.47 11.32    NA    NA    NA   NA   NA   NA   NA
2024 5.76 9.67    NA    NA    NA    NA   NA   NA   NA   NA
2025 6.03   NA    NA    NA    NA    NA   NA   NA   NA   NA
                  wyplacono_mln prawdziwa_rezerwa_bez_ogona_mln
                          95.90                           24.83
2. Chain-ladder ręcznie: Rysunek 2
R
# Przepis 2. Metoda chain-ladder liczona ręcznie: współczynniki rozwoju, uzupełnienie trójkąta, rezerwa
# Współczynnik rozwoju z roku j do j+1: suma C[i, j+1] / suma C[i, j] po latach zajścia, które znają oba lata
wspolczynniki <- function(C) {
  n <- ncol(C)
  sapply(1:(n - 1), function(j) { i <- which(!is.na(C[, j + 1])); sum(C[i, j + 1]) / sum(C[i, j]) })
}
uzupelnij <- function(C, f) {                         # mnoży ostatnią znaną wartość przez kolejne współczynniki
  for (j in 2:ncol(C)) { brak <- is.na(C[, j]); C[brak, j] <- C[brak, j - 1] * f[j - 1] }
  C
}
f <- wspolczynniki(skum)
pelny <- uzupelnij(skum, f)
ostatnia <- skum[cbind(1:n_lat, n_lat:1)]             # ostatnia przekątna: wypłacono do końca 2025 r.
ostateczna <- pelny[, n_lat]
rezerwa <- ostateczna - ostatnia

# Pojedyncze współczynniki (rok po roku) – do rysunku 2
indyw <- do.call(rbind, lapply(1:(n_lat - 1), function(j) {
  i <- which(!is.na(skum[, j + 1]))
  data.frame(rok_rozwoju = j, rok_zajscia = lata[i], f = skum[i, j + 1] / skum[i, j])
}))
p2 <- ggplot(indyw, aes(factor(paste0(rok_rozwoju, "→", rok_rozwoju + 1)), f)) +
  geom_point(data = subset(indyw, rok_zajscia != 2020), colour = kol[["szary"]], alpha = 0.7, size = 2.4, position = position_jitter(width = 0.12, seed = 1)) +
  geom_point(data = subset(indyw, rok_zajscia == 2020), colour = kol[["akcent"]], shape = 17, size = 3.4) +
  geom_point(data = data.frame(j = 1:(n_lat - 1), f = f), aes(j, f), shape = 95, size = 14, colour = kol[["znane"]]) +
  geom_text(data = data.frame(j = 1:(n_lat - 1), f = f), aes(j, f, label = sprintf("%.3f", f)),
            nudge_x = 0.38, size = 3.6, colour = kol[["znane"]]) +
  annotate("text", x = 1.75, y = 2.02, label = "rok zajścia 2020\n(duża szkoda)", colour = kol[["akcent"]], size = 3.6, hjust = 0) +
  labs(title = "Współczynniki rozwoju: każdy rok zajścia i średnia ważona",
       subtitle = "kreska – współczynnik ważony (suma / suma), punkty – pojedyncze lata zajścia",
       x = "Przejście między latami rozwoju", y = "Współczynnik rozwoju") + motyw
# ggsave("rys2-wspolczynniki.svg", p2, width = 10, height = 5.2)

round(f, 3)
round(cumprod(rev(f)), 3)                            # od roku rozwoju 10, 9, … do 1: ile razy wzrośnie suma
tab_cl <- data.frame(rok = lata, wyplacono = round(ostatnia), ostateczna = round(ostateczna),
                     rezerwa = round(rezerwa), prawdziwa = round(prawdziwa_rezerwa))
tab_cl
c(wyplacono_mln = round(sum(ostatnia) / 1000, 2), ostateczna_mln = round(sum(ostateczna) / 1000, 2),
  rezerwa_razem_mln = round(sum(rezerwa) / 1000, 2), prawdziwa_bez_ogona_mln = round(sum(prawdziwa_rezerwa) / 1000, 2))
p2
Wynik w R
[1] 1.693 1.196 1.117 1.074 1.044 1.045 1.030 1.013 1.011
[1] 1.011 1.024 1.055 1.103 1.152 1.237 1.382 1.653 2.799
      rok wyplacono ostateczna rezerwa prawdziwa
2016 2016      8610       8610       0         0
2017 2017      9240       9338      98        90
2018 2018      9170       9388     218       250
2019 2019      9160       9664     504       480
2020 2020     11450      12627    1177       900
2021 2021     10010      11529    1519      1370
2022 2022     11240      13901    2661      2270
2023 2023     11320      15642    4322      3600
2024 2024      9670      15984    6314      5890
2025 2025      6030      16876   10846      9980
          wyplacono_mln          ostateczna_mln       rezerwa_razem_mln prawdziwa_bez_ogona_mln
                  95.90                  123.56                   27.66                   24.83
3. GLM quasi-Poissona daje te same rezerwy
R
# Przepis 3. Ten sam wynik z GLM: Poisson nadrozproszony (quasipoisson) z efektami roku zajścia i roku rozwoju
dl <- data.frame(y = as.vector(przyrost), az = factor(rep(lata, n_lat)), dev = factor(rep(1:n_lat, each = n_lat)))
dl$kal <- as.integer(as.character(dl$az)) + as.integer(dl$dev) - 1
uczace <- !is.na(dl$y)
m <- glm(y ~ az + dev, family = quasipoisson(link = "log"), data = dl[uczace, ])
dl$mu <- predict(m, newdata = dl, type = "response")
rezerwa_glm <- tapply(dl$mu[!uczace], dl$az[!uczace], sum, default = 0)   # rok 2016 jest już pełny

phi_hat <- sum(residuals(m, type = "pearson")^2) / df.residual(m)   # współczynnik rozproszenia
c(parametry = length(coef(m)), komorki = sum(uczace), df_reszt = df.residual(m), phi = round(phi_hat, 1))
round(cbind(chain_ladder = rezerwa, glm = rezerwa_glm, roznica = rezerwa - rezerwa_glm), 2)
c(razem_cl = round(sum(rezerwa), 2), razem_glm = round(sum(rezerwa_glm), 2))
Wynik w R
parametry   komorki  df_reszt       phi
     19.0      55.0      36.0      19.9
     chain_ladder      glm roznica
2016         0.00     0.00       0
2017        97.61    97.61       0
2018       218.45   218.45       0
2019       504.16   504.16       0
2020      1177.49  1177.49       0
2021      1518.74  1518.74       0
2022      2660.88  2660.88       0
2023      4321.55  4321.55       0
2024      6314.29  6314.29       0
2025     10845.64 10845.64       0
 razem_cl razem_glm
 27658.81  27658.81
4. Bootstrap reszt Pearsona: Rysunki 3 i 4
R
# Przepis 4. Niepewność rezerwy: bootstrap reszt Pearsona (England i Verrall) z losowaniem przyszłych wypłat
B <- 5000
n_obs <- sum(uczace); p_par <- length(coef(m))
mu_z <- dl$mu[uczace]
r_adj <- (dl$y[uczace] - mu_z) / sqrt(mu_z) * sqrt(n_obs / (n_obs - p_par))   # reszty z poprawką na liczbę parametrów
przyszle <- which(!uczace)

set.seed(7621)
boot <- matrix(NA_real_, B, n_lat, dimnames = list(NULL, lata))
for (b in 1:B) {
  y_b <- mu_z + sample(r_adj, n_obs, replace = TRUE) * sqrt(mu_z)          # pseudotrójkąt przyrostowy
  P <- matrix(NA_real_, n_lat, n_lat); P[uczace] <- y_b
  C <- t(apply(P, 1, cumsum))
  Cp <- uzupelnij(C, wspolczynniki(C))                                       # chain-ladder na pseudodanych
  inc <- cbind(Cp[, 1], t(apply(Cp, 1, diff)))[przyszle]                     # oczekiwane przyszłe wypłaty
  sym <- ifelse(inc > 0, rgamma(length(inc), shape = pmax(inc, 1e-8) / phi_hat, scale = phi_hat), 0)  # losowość wypłat
  boot[b, ] <- tapply(sym, factor(dl$az[przyszle], levels = lata), sum, default = 0)
}
razem <- rowSums(boot)
q <- quantile(razem, c(0.5, 0.75, 0.95, 0.995))
c(chain_ladder = round(sum(rezerwa)), srednia = round(mean(razem)), sd = round(sd(razem)),
  cv_proc = round(100 * sd(razem) / mean(razem), 1))
round(q)
c(margines_75 = round(q[[2]] - sum(rezerwa)), margines_995 = round(q[[4]] - sum(rezerwa)),
  prawdziwa_bez_ogona = round(sum(prawdziwa_rezerwa)),
  centyl_prawdziwej = round(100 * mean(razem <= sum(prawdziwa_rezerwa)), 1))
po_latach <- data.frame(rok = lata, cl = rezerwa, sd = apply(boot, 2, sd),
                        q05 = apply(boot, 2, quantile, 0.05), q95 = apply(boot, 2, quantile, 0.95),
                        q995 = apply(boot, 2, quantile, 0.995), prawda = prawdziwa_rezerwa)
po_latach$cv_proc <- 100 * po_latach$sd / pmax(po_latach$cl, 1)
round(po_latach[-1, -1])

d3 <- data.frame(razem = razem / 1000)
linie <- data.frame(x = c(sum(rezerwa), q[[2]], q[[4]], sum(prawdziwa_rezerwa)) / 1000,
                    co = factor(c("chain-ladder", "kwantyl 75%", "kwantyl 99.5%", "faktyczne wypłaty"),
                                levels = c("chain-ladder", "kwantyl 75%", "kwantyl 99.5%", "faktyczne wypłaty")))
p3 <- ggplot(d3, aes(razem)) +
  geom_histogram(binwidth = 0.25, fill = "grey75", colour = "white") +
  geom_vline(data = linie, aes(xintercept = x, colour = co, linetype = co), linewidth = 1) +
  geom_text(data = linie, aes(x = x, y = Inf, label = sprintf("%.1f", x), colour = co), vjust = 1.4, hjust = -0.1,
            size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["znane"]], kol[["prognoza"]], kol[["akcent"]], kol[["prawda"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted", "twodash"), name = NULL) +
  labs(title = "Rozkład rezerwy z bootstrapu (5000 powtórzeń)",
       subtitle = "suma przyszłych wypłat za lata zajścia 2016–2025, bez ogona", x = "Rezerwa (mln zł)",
       y = "Liczba powtórzeń") + motyw
# ggsave("rys3-bootstrap.svg", p3, width = 10, height = 5.2)

d4 <- po_latach[-1, ]                               # względem rezerwy chain-ladder (= 100%)
p4 <- ggplot(d4, aes(factor(rok))) +
  geom_hline(yintercept = 100, colour = "grey50") +
  geom_linerange(aes(ymin = 100 * q05 / cl, ymax = 100 * q995 / cl), colour = kol[["prognoza"]], linewidth = 0.9) +
  geom_linerange(aes(ymin = 100 * q05 / cl, ymax = 100 * q95 / cl), colour = kol[["znane"]], linewidth = 3.5, alpha = 0.55) +
  geom_point(aes(y = 100, shape = "chain-ladder"), colour = kol[["znane"]], size = 3) +
  geom_point(aes(y = 100 * prawda / cl, shape = "faktyczne wypłaty"), colour = kol[["prawda"]], size = 3.4, stroke = 1.3) +
  geom_text(aes(y = 100 * q995 / cl, label = sprintf("CV %.0f%%", cv_proc)), vjust = -0.6, size = 3.5, colour = "grey30") +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0.03, 0.1))) +
  labs(title = "Niepewność rezerwy w każdym roku zajścia",
       subtitle = "w % rezerwy chain-ladder; gruby pasek: centyle 5–95, cienka linia: do 99.5",
       x = "Rok zajścia szkody", y = "% rezerwy chain-ladder") + motyw
# ggsave("rys4-rezerwa-lata.svg", p4, width = 10, height = 5.2)
p3
p4
Wynik w R
chain_ladder      srednia           sd      cv_proc
     27659.0      27656.0       1512.0          5.5
  50%   75%   95% 99.5%
27625 28642 30165 31891
        margines_75        margines_995 prawdziwa_bez_ogona   centyl_prawdziwej
              983.0              4232.0             24830.0                 2.7
        cl  sd  q05   q95  q995 prawda cv_proc
2017    98  65   11   215   353     90      67
2018   218  90   91   383   528    250      41
2019   504 128  309   723   884    480      25
2020  1177 197  874  1521  1742    900      17
2021  1519 218 1177  1887  2120   1370      14
2022  2661 298 2188  3165  3507   2270      11
2023  4322 403 3682  5000  5446   3600       9
2024  6314 512 5503  7183  7763   5890       8
2025 10846 839 9508 12243 13440   9980       8
5. Reszty wg roku kalendarzowego i efekt 2023 r.: Rysunek 5
R
# Przepis 5. Sprawdzenie założeń: reszty Pearsona wg roku kalendarzowego, duża szkoda i skok kosztów
dz <- dl[uczace, ]
dz$duza <- dz$az == "2020" & dz$dev == "2"
dz$reszta <- residuals(m, type = "pearson")
round(dz$reszta[dz$duza], 2)                          # reszta komórki z dużą szkodą

# Duża szkoda osobno: odejmujemy ją z trójkąta (jest już wypłacona, nie ma się „rozwijać”)
dz$y_bez <- dz$y - ifelse(dz$duza, duza_szkoda[["kwota"]], 0)
m_bez <- glm(y_bez ~ az + dev, family = quasipoisson, data = dz)
dz$reszta_bez <- residuals(m_bez, type = "pearson")
round(c(phi_z_duza = phi_hat, phi_bez_duzej = summary(m_bez)$dispersion), 1)
round(tapply(dz$reszta_bez, dz$kal, mean), 2)          # średnia reszta w roku kalendarzowym

# Test: czy wypłaty od 2023 r. są wyższe, niż przewiduje chain-ladder? (efekt roku kalendarzowego)
dz$od2023 <- as.integer(dz$kal >= 2023)
m_kal <- update(m_bez, . ~ . + od2023)
anova(m_bez, m_kal, test = "F")
round(exp(c(mnoznik = coef(m_kal)[["od2023"]], confint.default(m_kal)["od2023", ])), 3)

# Rezerwa w trzech wariantach (przyszłe lata kalendarzowe – na poziomie kosztów z lat 2023–2025)
przysz <- dl[!uczace, ]; przysz$od2023 <- 1
c(chain_ladder = round(sum(rezerwa)), bez_duzej = round(sum(predict(m_bez, przysz, type = "response"))),
  bez_duzej_i_z_efektem_2023 = round(sum(predict(m_kal, przysz, type = "response"))),
  prawdziwa_bez_ogona = round(sum(prawdziwa_rezerwa)))

sr <- function(r) data.frame(kal = sort(unique(dz$kal)), reszta = as.vector(tapply(r, dz$kal, mean)))
rysuj <- function(r, tytul) {
  ggplot(data.frame(kal = dz$kal, reszta = r, duza = dz$duza), aes(kal, reszta)) +
    annotate("rect", xmin = 2022.5, xmax = 2025.5, ymin = -Inf, ymax = Inf, fill = kol[["prognoza"]], alpha = 0.12) +
    geom_hline(yintercept = 0, colour = "grey50") +
    geom_point(aes(shape = duza, colour = duza), size = 2.6, alpha = 0.8, position = position_jitter(width = 0.12, seed = 2)) +
    geom_line(data = sr(r), colour = kol[["znane"]], linewidth = 1) +
    geom_point(data = sr(r), colour = kol[["znane"]], size = 3, shape = 15) +
    scale_colour_manual(values = c(kol[["szary"]], kol[["akcent"]]), labels = c("inne komórki", "duża szkoda (2020, rok 2)"),
                        name = NULL, drop = FALSE) +
    scale_shape_manual(values = c(16, 17), labels = c("inne komórki", "duża szkoda (2020, rok 2)"), name = NULL, drop = FALSE) +
    scale_x_continuous(breaks = 2016:2025, labels = c("2016", "", "2018", "", "2020", "", "2022", "", "2024", "")) +
    scale_y_continuous(labels = minus) +
    labs(title = tytul, x = "Rok kalendarzowy wypłaty", y = "Reszta Pearsona") + motyw
}
dz$duza <- factor(dz$duza, levels = c(FALSE, TRUE))
p5 <- patchwork::wrap_plots(rysuj(dz$reszta, "A. Wszystkie wypłaty"),
                            rysuj(dz$reszta_bez, "B. Duża szkoda odjęta"), ncol = 2, guides = "collect") &
  theme(legend.position = "bottom")
# ggsave("rys5-reszty.svg", p5, width = 10, height = 5.4)
p5
Wynik w R
[1] 13.46
   phi_z_duza phi_bez_duzej
         19.9          12.0
 2016  2017  2018  2019  2020  2021  2022  2023  2024  2025
 0.42  1.41  0.28  0.40 -1.82  0.12 -2.69  2.00  0.74 -0.21
Analysis of Deviance Table

Model 1: y_bez ~ az + dev
Model 2: y_bez ~ az + dev + od2023
  Resid. Df Resid. Dev Df Deviance      F   Pr(>F)
1        36     433.10
2        35     324.05  1   109.05 11.772 0.001559 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
mnoznik   2.5 %  97.5 %
  1.156   1.064   1.257
              chain_ladder                  bez_duzej bez_duzej_i_z_efektem_2023        prawdziwa_bez_ogona
                     27659                      27652                      25970                      24830
6. Pułapki: duża szkoda, ogon i szybsza likwidacja
R
# Przepis 6. Pułapki: duża szkoda w roku zajścia, współczynnik ogona i przyspieszona likwidacja
# a) Duża szkoda: rezerwa wg lat zajścia z nią i bez niej
rez_bez <- tapply(predict(m_bez, przysz, type = "response"), przysz$az, sum, default = 0)
round(rbind(z_duza = rezerwa, bez_duzej = rez_bez)[, c("2020", "2023", "2024", "2025")])

# b) Ogon: po 10. roku rozwoju wypłaty jeszcze trwają; ekstrapolacja log(f − 1) liniowo w roku rozwoju
j <- 4:9
dopas <- lm(log(f[j] - 1) ~ j)
f_dalej <- 1 + exp(predict(dopas, data.frame(j = 10:30)))
ogon_f <- prod(f_dalej)
ogon_rezerwa <- sum(ostateczna) * (ogon_f - 1)
prawdziwy_ogon <- sum(polisy * szkoda_na_polise * ogon * skok_kosztow)   # znamy, bo dane są fikcyjne
c(wspolczynnik_ogona = round(ogon_f, 4), rezerwa_ogona = round(ogon_rezerwa), prawdziwy_ogon = round(prawdziwy_ogon))

# c) Przyspieszona likwidacja: w roku zajścia 2025 w 1. roku wypłacono 45% zamiast 38% wartości szkód
ostateczna_2025 <- polisy[n_lat] * szkoda_na_polise * sum(wzorzec) * skok_kosztow   # prawdziwa wartość (bez ogona)
czynnik_ze_starego_tempa <- sum(wzorzec) / wzorzec[1]                              # z ilu „38%” składa się całość
c(prawdziwa_ostateczna = round(ostateczna_2025),
  cl_gdy_tempo_bez_zmian = round(ostateczna_2025 * wzorzec[1] / sum(wzorzec) * czynnik_ze_starego_tempa),
  cl_gdy_likwidacja_szybsza = round(ostateczna_2025 * 0.45 / sum(wzorzec) * czynnik_ze_starego_tempa),
  zawyzenie_proc = round(100 * (0.45 / wzorzec[1] - 1), 1))
Wynik w R
          2020 2023 2024  2025
z_duza    1177 4322 6314 10846
bez_duzej 1054 4405 6458 10681
wspolczynnik_ogona      rezerwa_ogona     prawdziwy_ogon
            1.0229          2829.0000          2020.0000
     prawdziwa_ostateczna    cl_gdy_tempo_bez_zmian cl_gdy_likwidacja_szybsza            zawyzenie_proc
                  16122.0                   16122.0                   19092.0                      18.4
7. Grafika: trójkąt z częścią do uzupełnienia: Rysunek 1
R
# Przepis 7. Grafika: trójkąt skumulowanych wypłat z częścią do uzupełnienia
siatka <- expand.grid(rok = lata, rozwoj = 1:n_lat)
siatka$wartosc <- pelny[cbind(siatka$rok - 2015, siatka$rozwoj)] / 1000
siatka$typ <- ifelse(siatka$rok + siatka$rozwoj - 1 <= 2025, "znane", "prognoza")
siatka$typ[siatka$rok + siatka$rozwoj - 1 == 2025] <- "przekatna"
siatka$typ <- factor(siatka$typ, levels = c("znane", "przekatna", "prognoza"))
boczne <- data.frame(rok = lata, tekst = ifelse(rezerwa > 0, sprintf("%.2f", rezerwa / 1000), "–"))
p1 <- ggplot(siatka, aes(rozwoj, rok)) +
  geom_tile(aes(fill = typ), colour = "white", linewidth = 1.2) +
  geom_text(aes(label = sprintf("%.1f", wartosc), fontface = ifelse(typ == "prognoza", "italic", "plain"),
                colour = typ == "przekatna"), size = 3.7, show.legend = FALSE) +
  annotate("text", x = 11.25, y = 2015.1, label = "rezerwa", size = 3.8, fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = boczne, aes(x = 11.25, y = rok, label = tekst), size = 3.7, colour = kol[["akcent"]], fontface = "bold") +
  scale_fill_manual(values = c(znane = "#cfe3f2", przekatna = "#0072B2", prognoza = "#fbe3b3"),
                    labels = c("znane wypłaty", "ostatnia przekątna (koniec 2025 r.)", "do uzupełnienia chain-ladderem"),
                    name = NULL) +
  scale_colour_manual(values = c("grey15", "white")) +
  scale_x_continuous(breaks = 1:10, expand = expansion(add = c(0.5, 1.2))) +
  scale_y_reverse(breaks = lata, expand = expansion(add = c(0.9, 0.5))) +
  coord_cartesian(clip = "off") +
  labs(title = "Trójkąt skumulowanych wypłat (mln zł) i część do uzupełnienia",
       subtitle = "wiersz – rok zajścia szkody, kolumna – rok rozwoju; kursywa – prognoza", x = "Rok rozwoju",
       y = "Rok zajścia") + motyw + theme(panel.grid.major = element_blank())
# ggsave("rys1-trojkat.svg", p1, width = 10, height = 6.4)
p1
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
roznica <- function(k) {                             # odległość dwóch barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB"))
  sqrt(sum((lab[1, ] - lab[2, ])^2))
}
pary <- list("znane – prognoza (tło)" = c("#cfe3f2", "#fbe3b3"), "chain-ladder – kwantyl 75%" = c("#0072B2", "#E69F00"),
             "kwantyl 99.5% – faktyczne" = c("#D55E00", "#009E73"), "chain-ladder – faktyczne" = c("#0072B2", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
znane – prognoza (tło)                      36.4         37.9       35.2
chain-ladder – kwantyl 75%                 120.2        121.5      109.3
kwantyl 99.5% – faktyczne                  102.4         53.5       37.3
chain-ladder – faktyczne                    70.1         55.4       58.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, model quasi-Poissona (glm), test F (anova) i bootstrap – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Duże szkody w trójkącie. Pożar hali (1.2 mln zł) podnosi współczynnik 1→2 i przesuwa rezerwę między latami: bez niego rezerwa 2020 r. spada z 1.18 do 1.05 mln zł, 2025 r. – z 10.85 do 10.68 mln zł, a 2024 r. rośnie z 6.31 do 6.46 mln zł. Łącznie prawie bez zmian (27.65 wobec 27.66 mln zł), ale w innym portfelu może być inaczej.
- Zmiana tempa likwidacji. Jeśli od 2025 r. likwidatorzy wypłacają w pierwszym roku 45% wartości szkód zamiast 38%, chain-ladder potraktuje wyższy start jak większą szkodę: wartość ostateczna 2025 r. wyjdzie 19.09 zamiast 16.12 mln zł (o 18.4% za dużo). Gdy wypłaty zwalniają, metoda zaniża rezerwę. Podobną rolę odgrywa opóźnienie zgłoszeń w prognozie roszczeń gwarancyjnych.
- Mało danych w ogonie. Współczynnik 9→10 liczymy z jednego roku zajścia, a po 10. roku nic nie wiemy. Współczynnik ogona z ekstrapolacji log(f − 1) po latach 4–9 wynosi 1.0229, co daje 2.83 mln zł dodatkowej rezerwy; ukryliśmy 2.02 mln zł. Krzywe parametryczne do ekstrapolacji ogona opisują England i Verrall (2002) – i warto pokazać, jak bardzo wynik zależy od wyboru lat.
Kolejny wpis serii dotyczy wiarygodności Bühlmanna – też o tym, ile ufać krótkiej historii.
Najczęstsze pytania
Jak policzyć współczynniki rozwoju w metodzie chain-ladder?
Dla każdego przejścia z roku rozwoju j do j + 1 podziel sumę skumulowanych wypłat w kolumnie j + 1 przez sumę w kolumnie j, biorąc tylko lata zajścia, które znają obie kolumny. To średnia ważona wielkością wypłat. W przykładzie współczynnik z roku 1 do 2 wynosi 1.693, a z roku 9 do 10 – 1.011; ich iloczyn 2.799 mówi, ile razy wzrosną wypłaty najmłodszego roku zajścia.
Czy metoda chain-ladder to model statystyczny?
Tak – te same rezerwy daje uogólniony model liniowy dla wypłat przyrostowych z efektami roku zajścia i roku rozwoju, rodziną quasi-Poissona i linkiem logarytmicznym (Renshaw i Verrall, 1998). W przykładzie glm() odtworzył rezerwę 27.66 mln zł co do grosza. Model daje też reszty i współczynnik rozproszenia, potrzebne do bootstrapu i diagnostyki.
Jak oszacować niepewność rezerwy szkodowej?
Najczęściej bootstrapem reszt Pearsona: losujesz reszty, budujesz pseudotrójkąty, liczysz na nich chain-ladder i dodajesz losowość przyszłych wypłat (England i Verrall, 2002). Z 5000 powtórzeń otrzymasz rozkład rezerwy, jej odchylenie standardowe i kwantyle, np. 75% i 99.5%. Wzór Macka (1993) daje błąd standardowy bez założeń o rozkładzie.
Dlaczego bootstrap rezerwy może dać zbyt wąski przedział?
Bo mierzy niepewność przy założeniu, że model jest poprawny. W przykładzie faktyczne przyszłe wypłaty wypadły na 2.7. centylu rozkładu, bo model nie uwzględniał skoku kosztów od 2023 r. ani dużej szkody. Przed bootstrapem obejrzyj reszty według roku kalendarzowego i wyłącz duże szkody.
Co to jest współczynnik ogona w trójkącie szkód?
To mnożnik za wypłaty po ostatnim roku rozwoju widocznym w trójkącie. Szacuje się go, ekstrapolując spadające współczynniki rozwoju, np. log(f − 1) liniowo w roku rozwoju. W przykładzie współczynnik ogona 1.0229 dodał 2.83 mln zł rezerwy; wynik silnie zależy od wyboru lat do ekstrapolacji, więc pokaż jego wrażliwość.
Powiązane hasła
Przeczytaj też
Częstość i wysokość szkód – składka
Ubezpieczenie telefonów i laptopów: Poisson z offsetem, regresja gamma, bootstrap składki, Tweedie i Gini na polisach testowych – z kodem R.
Czytaj →PoradnikWiarygodność Bühlmanna
Grupowe NNW w 120 firmach: wariancje w firmie i między firmami, współczynnik Z, składka wiarygodności, model mieszany i sprawdzian – z kodem R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikVaR i expected shortfall – ryzyko kursowe
3 mln euro należności i 10 dni: VaR i ES metodą historyczną, normalną i GARCH, reguła √10 i test wsteczny Kupca – z kodem R.
Czytaj →Piszesz pracę o rezerwach albo ryzyku ubezpieczeniowym?
Pomożemy przygotować trójkąt, policzyć chain-ladder i bootstrap rezerwy, sprawdzić założenia i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- England, P. D., & Verrall, R. J. (2002). Stochastic claims reserving in general insurance. British Actuarial Journal, 8(3), 443–518. https://doi.org/10.1017/s1357321700003809
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Mack, T. (1993). Distribution-free calculation of the standard error of chain ladder reserve estimates. ASTIN Bulletin, 23(2), 213–225. https://doi.org/10.2143/ast.23.2.2005092 ● Otwarty dostęp
- Pinheiro, P. J. R., Andrade e Silva, J. M., & De Lourdes Centeno, M. (2003). Bootstrap methodology in claim reserving. Journal of Risk and Insurance, 70(4), 701–714. https://doi.org/10.1046/j.0022-4367.2003.00071.x ● Otwarty dostęp: pełny tekst
- Renshaw, A. E., & Verrall, R. J. (1998). A stochastic model underlying the chain-ladder technique. British Actuarial Journal, 4(4), 903–923. https://doi.org/10.1017/s1357321700000222
Cytowania BibTeX
@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{england2002stochastic, author={England, P. D. and Verrall, R. J.}, title={{Stochastic claims reserving in general insurance}}, journal={British Actuarial Journal}, year={2002}, volume={8}, number={3}, pages={443--518}, doi={10.1017/s1357321700003809}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{mack1993distribution, author={Mack, Thomas}, title={{Distribution-free calculation of the standard error of chain ladder reserve estimates}}, journal={ASTIN Bulletin}, year={1993}, volume={23}, number={2}, pages={213--225}, doi={10.2143/ast.23.2.2005092}}@article{pinheiro2003bootstrap, author={Pinheiro, Paulo J. R. and Andrade e Silva, Jo{\~a}o Manuel and De Lourdes Centeno, Maria}, title={{Bootstrap methodology in claim reserving}}, journal={Journal of Risk and Insurance}, year={2003}, volume={70}, number={4}, pages={701--714}, doi={10.1046/j.0022-4367.2003.00071.x}}@article{renshaw1998stochastic, author={Renshaw, A. E. and Verrall, R. J.}, title={{A stochastic model underlying the chain-ladder technique}}, journal={British Actuarial Journal}, year={1998}, volume={4}, number={4}, pages={903--923}, doi={10.1017/s1357321700000222}}