Przykład: wiertarki, szlifierki i 24 miesiące gwarancji
Fikcyjny producent elektronarzędzi sprzedaje dwa modele wiertarek i szlifierkę kątową: wiertarkę W1 i szlifierkę S1 od 36 miesięcy, nową wiertarkę W2 od 11. miesiąca. Gwarancja trwa 24 miesiące od zakupu. Firma pyta: ile zgłoszeń gwarancyjnych przyjdzie w ciągu najbliższego roku, ile to będzie kosztować i który model wiertarki psuje się częściej?
Firma zna liczbę sprzedanych sztuk w każdym miesiącu (kohorcie) i każde zgłoszenie: model, miesiąc sprzedaży i wiek narzędzia w dniu awarii. O sztukach bez zgłoszenia wie tylko, że do dziś działały albo skończyła się im gwarancja. To obserwacje cenzurowane: znamy dolną granicę czasu do awarii, a nie sam czas. Ten sam problem pojawia się przy rezygnacji z czekania na infolinii; odsetek zwrotów produktów to inny problem.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Czas do awarii każdej sztuki wylosowaliśmy z rozkładu Weibulla o ręcznie ustalonych parametrach (lista przy kodzie): wiertarka W1 zużywa się z wiekiem (kształt 1.8), W2 ma wczesne awarie (kształt 0.7), a szlifierka psuje się w stałym tempie (kształt 1.0). Sprzedano 194 050 sztuk, a do dnia analizy (koniec 36. miesiąca) przyszło 5193 zgłoszenia: 1851 dla W1, 1002 dla W2 i 2340 dla S1. Dane: roszczenia-gwarancyjne-elektronarzedzia.csv (wiersz = zgłoszenie albo grupa sztuk kohorty bez zgłoszenia, kolumna liczba).
Rysunek 1: krzywa „wanny” – trzy fazy awarii
Życie wyrobu opisuje krzywa hazardu – ryzyko awarii w danym miesiącu wśród sztuk, które jeszcze działają.
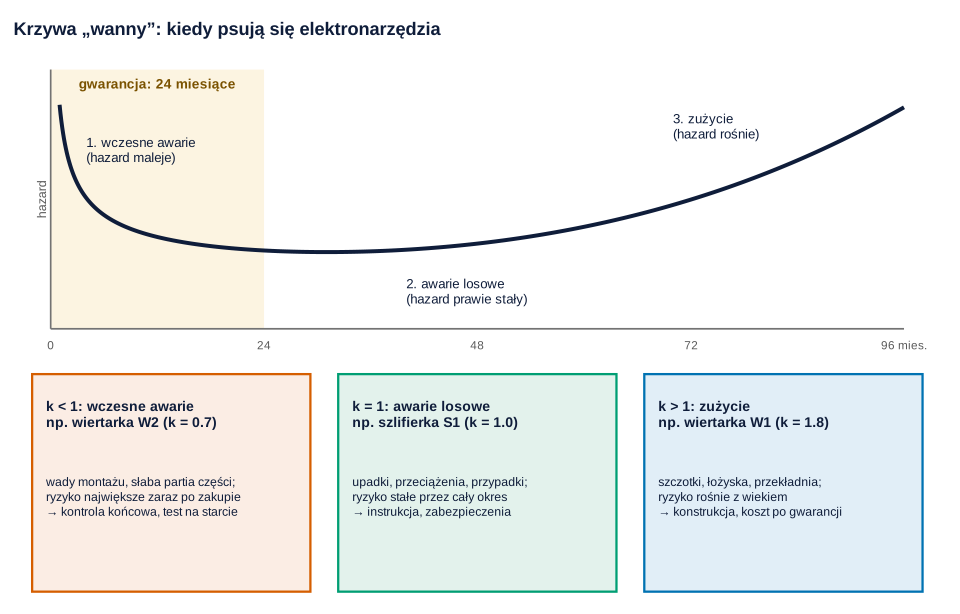
Co widać. Na początku ryzyko maleje (wady montażu), potem jest prawie stałe (upadki, przeciążenia), na końcu rośnie (zużycie). Rozkład Weibulla, który Weibull (1951) zaproponował jako rozkład o szerokim zastosowaniu, opisuje każdą z tych faz osobno: parametr kształtu k < 1 daje hazard malejący, k = 1 stały (rozkład wykładniczy), k > 1 rosnący.
F(t) to odsetek sztuk, które do wieku t zepsuły się, a λ (skala) to wiek, do którego psuje się 63.2% sztuk.
Jak może zmylić. Jeden rozkład Weibulla ma hazard monotoniczny, więc całej „wanny” nie opisze. Oszacowane k mówi, która faza dominuje w 24 miesiącach gwarancji, a nie co będzie po 5 latach.
Rysunek 2: dlaczego „zgłoszenia / sprzedane” zaniża awaryjność
Najprostszy wskaźnik to zgłoszenia podzielone przez sprzedane sztuki. Panel B porównuje go z trzema innymi liczbami. Estymator Kaplana–Meiera (Kaplan i Meier, 1958) liczy odsetek awarii do wieku 24 miesięcy tylko wśród sztuk, które do danego wieku były obserwowane.
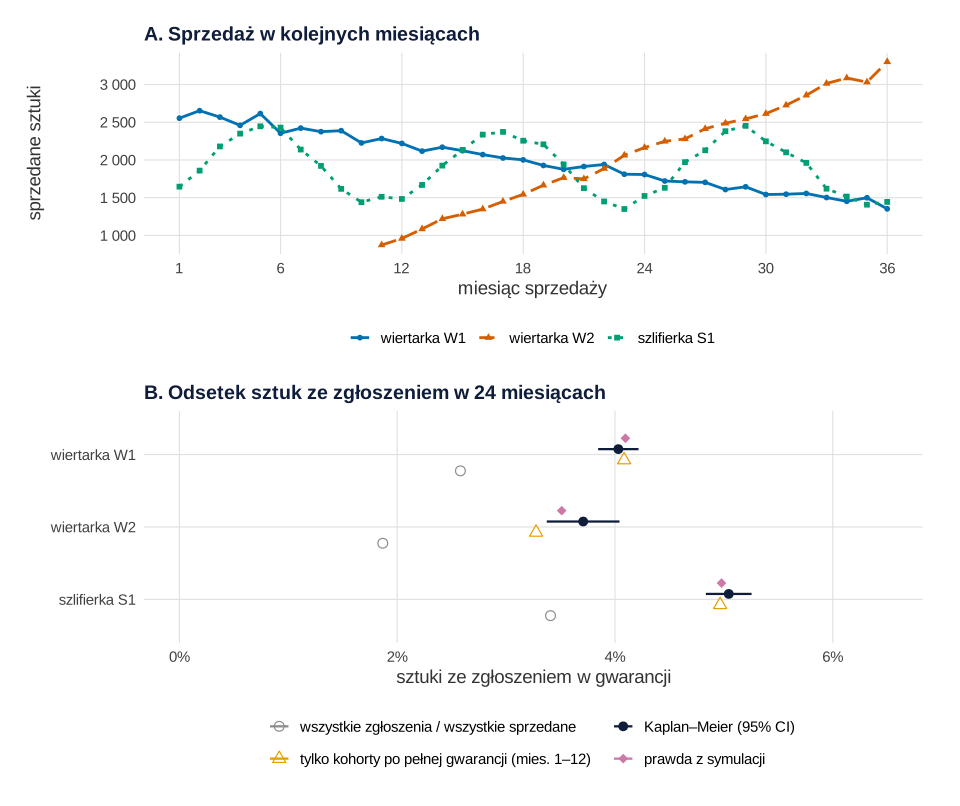
Co widać – panel A. Sprzedaż W1 maleje, a W2 szybko rośnie – wiele sztuk W2 miało mało czasu, żeby się zepsuć.
Co widać – panel B. Wskaźnik „zgłoszenia / sprzedane” daje 2.58% dla W1, 1.87% dla W2 i 3.41% dla S1, a prawdziwy odsetek awarii w gwarancji to 4.10%, 3.51% i 4.98%. Zaniżenie jest największe dla W2 – modelu o najmłodszych sztukach. Kaplan–Meier daje 4.03% (95% CI [3.85, 4.22]), 3.71% [3.37, 4.04] i 5.04% [4.83, 5.25]. Same kohorty po pełnej gwarancji (sprzedaż w miesiącach 1–12) też trafiają blisko, ale dla W2 zostaje 1832 sztuki, a 51 822 wypada z analizy.
Jak może zmylić. Naiwny wskaźnik spada, gdy sprzedaż rośnie – nawet przy stałej jakości. Porównuje wiek sztuk, a nie ich jakość.
Rysunek 3: model Weibulla i wykres Weibulla
Kaplan–Meier nie sięga poza najstarszą sztukę i nie daje parametrów do porównań. Dlatego dopasowujemy model Weibulla metodą największej wiarygodności: zgłoszenie wnosi do wiarygodności gęstość w wieku awarii, a sztuka bez zgłoszenia – prawdopodobieństwo przetrwania do swojego wieku. Dzięki wagom w survreg() tysiąc sztuk z kohorty to jeden wiersz. Sprawdzamy dopasowanie wykresem Weibulla: log(−log(1 − F)) względem log(t). Dla rozkładu Weibulla punkty leżą na prostej o nachyleniu k. Ten sposób kreślenia danych z czasami awarii przemieszanymi z czasami pracy sprawnych sztuk opisał Nelson (1972); jego wersję z hazardem omawia hasło estymator Nelsona–Aalena.
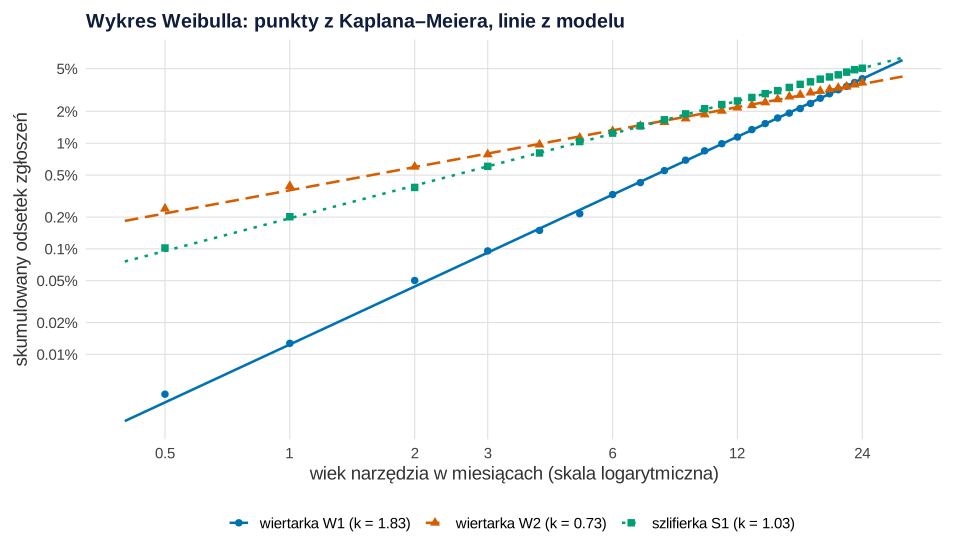
Co widać. Punkty każdego produktu leżą na prostej, więc rozkład Weibulla pasuje. Oszacowany kształt wynosi 1.83 (95% CI [1.75, 1.90]) dla W1, 0.73 [0.69, 0.77] dla W2 i 1.03 [0.99, 1.07] dla S1 – blisko ukrytych 1.8, 0.7 i 1.0. Przedział dla szlifierki obejmuje 1 (stały hazard). Model przewiduje, że w 12 miesięcy zgłoszenie będzie miało 1.15% sztuk W1, 2.19% W2 i 2.50% S1, a w 24 miesiące – 4.03%, 3.60% i 5.05%. Test ilorazu wiarygodności odrzuca wspólny kształt dla obu wiertarek, χ²(1) = 720.47, p < .001.
Jak może zmylić. Prosta nie dowodzi, że model sprawdzi się po 24 miesiącach. Wygięte punkty sugerują dwie przyczyny awarii (zob. pułapki).
Rysunek 4: hazard – wczesne awarie czy zużycie?
Kształt łatwiej zrozumieć jako hazard: zgłoszenia w miesiącu na 1000 sztuk, które dotąd działały. Pasma niepewności liczymy bootstrapem parametrycznym: z dopasowanego modelu losujemy 1000 nowych zbiorów zgłoszeń o tej samej strukturze kohort i w każdym dopasowujemy model od nowa. Davison i Hinkley (1997) opisują to podejście jako bootstrap w sytuacji, w której model z parametrami w pełni określa rozkład danych.
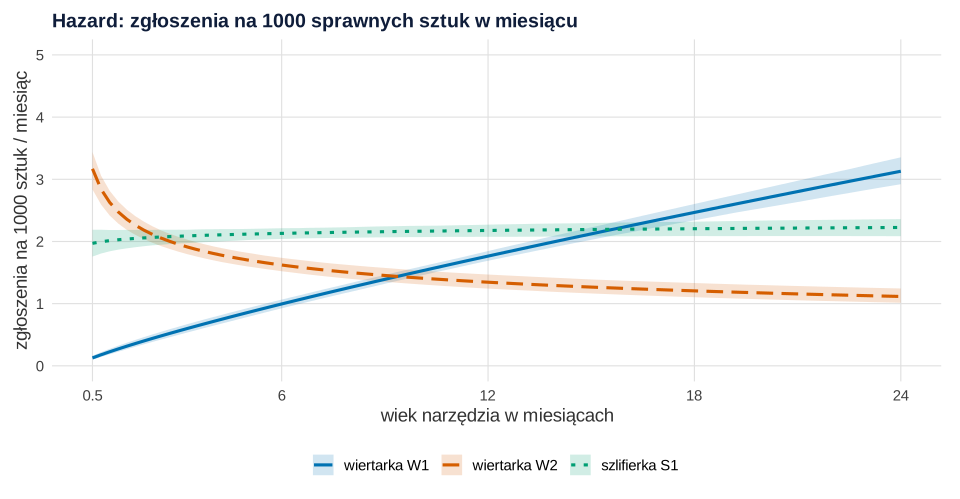
Co widać. W1 ma w 1. miesiącu 0.23 zgłoszenia na 1000 sztuk, w 12. – 1.76, w 24. – 3.13: zużycie. W2 spada z 2.63 do 1.12 – kłopot leży w pierwszych tygodniach (montaż, partia części). Szlifierka trzyma się ok. 2 zgłoszeń.
Jak może zmylić. Wąskie pasma opisują tylko niepewność losową przy dobrym modelu; błędu w wyborze rozkładu nie pokażą.
Rysunek 5: prognoza zgłoszeń na kolejne 12 miesięcy
Prognozę składamy z kohort. Sztuka, która dziś ma a miesięcy i nie miała zgłoszenia, zgłosi awarię w wieku od a do b (najwyżej 24 miesiące) z prawdopodobieństwem:
Mnożymy je przez liczbę sztuk w kohorcie i sumujemy. Przyszłą sprzedaż dodaje się tą samą metodą; tu jej nie liczymy. Kalbfleisch, Lawless i Robinson (1991) prognozują tak liczbę i koszt zgłoszeń z błędami standardowymi, na modelu Poissona. My w każdej z 1000 prób bootstrapu liczymy oczekiwaną liczbę zgłoszeń i losujemy, ile ich przyjdzie. Daje to przedział predykcji, a nie tylko przedział ufności dla średniej.
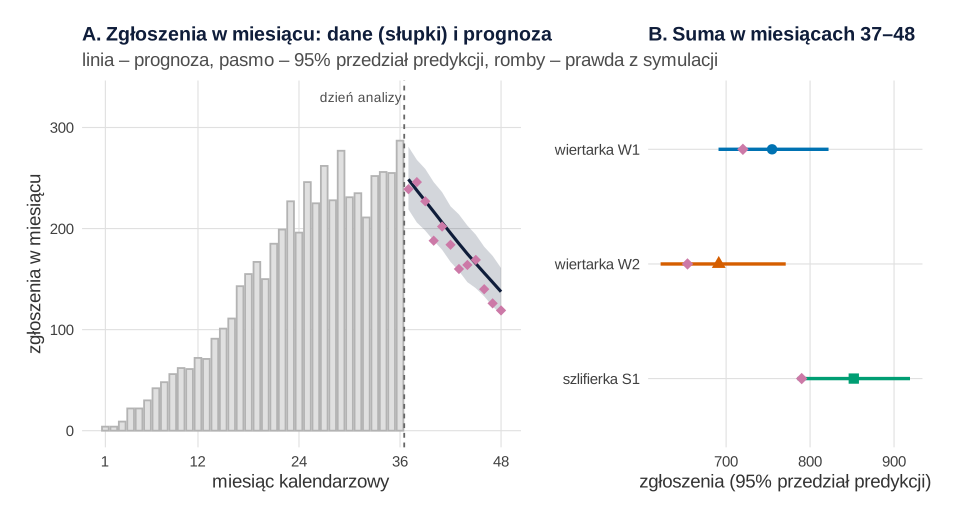
Co widać – panel A. Prognoza maleje z 248.8 zgłoszenia w 37. miesiącu do 137.5 w 48., bo sztuki wychodzą z gwarancji.
Co widać – panel B. Razem prognoza wynosi 2298 zgłoszeń, 95% CI dla wartości oczekiwanej [2233, 2376], a 95% przedział predykcji [2185, 2415]. Przy kosztach jednego zgłoszenia 240 zł (W1), 210 zł (W2) i 190 zł (S1) rezerwa na rok to 488 185 zł, 95% przedział predykcji [464 150, 513 811].
Jak może zmylić. Prawda z symulacji to 2164 zgłoszenia – tuż poniżej przedziału. Część różnicy to błąd oszacowania, część pech: przy prawdziwych parametrach oczekiwana liczba to 2255.8. Przedział 95% czasem nie trafia – prognozę aktualizuj co miesiąc.
Rysunek 6: który model wiertarki jest lepszy?
Lawless (1998) wymienia porównanie grup produktów obok prognozy wśród głównych zastosowań baz zgłoszeń gwarancyjnych. Porównujemy krzywe F(t) wiertarek i koszt gwarancji na sztukę (odsetek zgłoszeń w 24 miesiącach × koszt zgłoszenia).
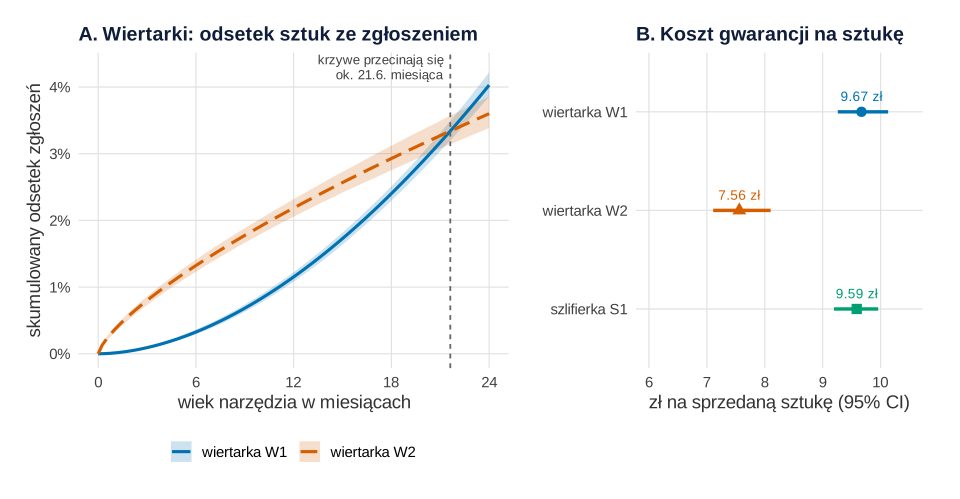
Co widać – panel A. Po 6 i 12 miesiącach W2 ma więcej zgłoszeń niż W1: różnica 1.00 pp (95% CI [0.90, 1.09]) i 1.03 pp [0.88, 1.18]. Krzywe przecinają się ok. 21.6. miesiąca, a po 24 miesiącach W2 ma o 0.43 pp mniej zgłoszeń, 95% CI [−0.72, −0.12].
Co widać – panel B. Gwarancja kosztuje 9.67 zł na sztukę W1 (95% CI [9.26, 10.13]), 7.56 zł na sztukę W2 [7.11, 8.10] i 9.59 zł na sztukę S1 [9.19, 9.96].
Jak może zmylić. Odpowiedź zależy od horyzontu: po pół roku W2 to „gorszy model”, po dwóch latach – „tańszy w gwarancji”. A awarie W1 po gwarancji przyspieszają – firma za nie nie płaci, ale klient pamięta.
Co z tym zrobić w firmie
- Usuń z raportów wskaźnik „zgłoszenia / sprzedane”. Zastąp go odsetkiem zgłoszeń w ustalonym wieku (6, 12, 24 miesiące) – tu naiwny wskaźnik zaniżał awaryjność W2 prawie dwukrotnie.
- Kształt k wskazuje dział, który ma działać. W2 (k = 0.73) – produkcja i kontrola końcowa: test pracy na stanowisku albo kontrola dostaw części (plan próbkowania opisuje wpis o kontroli odbiorczej i krzywej OC, a stabilność procesu – zdolność procesu Cp i Cpk). W1 (k = 1.83) – konstrukcja: trwalsze szczotki i łożyska.
- Rezerwę gwarancyjną licz z kohort i podawaj z przedziałem. Tu 488 185 zł na rok, z górną granicą 513 811 zł. Porównuj co miesiąc prognozę z napływem zgłoszeń.
- Przed decyzją o przedłużeniu gwarancji do 36 miesięcy policz F(36) z modelu jako scenariusz: dla W1 z rosnącym hazardem koszt wzrośnie najbardziej, a dane z wieku powyżej 24 miesięcy nie istnieją. Pokaż wynik dla kilku rozkładów, np. Weibulla i lognormalnego (analiza wrażliwości).
- Porównuj modele w kilku punktach czasu, nie jedną liczbą. Podobną zmianę obrazu w zależności od horyzontu widać we wpisie o cenie biletu a czasie do spektaklu. Więcej tematów prac z danymi firmowymi zebraliśmy we wpisach statystyka w pracy inżynierskiej i statystyka w pracy z finansów i rachunkowości.
Jak opisać w pracy
W Metodzie opisz zdarzenie, cenzurowanie, model i niepewność; w Wynikach – kształt, odsetki w ustalonym wieku i prognozę. Ogólny opis analizy przeżycia w pracy znajdziesz we wpisie Kaplan–Meier i model Coxa krok po kroku.
Kod R: dane, Kaplan–Meier, model Weibulla, bootstrap parametryczny i prognoza
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Kaplan–Meier i model Weibulla to pakiet survival (funkcje survfit() i survreg() z wagami równymi liczbie sztuk), bootstrap parametryczny i prognoza z kohort są napisane ręcznie w bazowym R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p2–p7), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Do większych analiz niezawodności istnieją wyspecjalizowane pakiety (np. WeibullR); tu wystarcza survival.
Losują przepis 1 (set.seed(756)), 4 (set.seed(7561)), 5 (set.seed(7562)) i 8 (set.seed(7563)); ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 36 miesięcy sprzedaży i dzień analizy na koniec 36. miesiąca, gwarancję 24 miesiące, sprzedaż w połowie miesiąca (uproszczenie), średnią sprzedaż miesięczną (W1: z 2600 do 1400 sztuk, W2: od 11. miesiąca z 900 do 3200, S1: 1900 sztuk ± 25% w rytmie rocznym; liczby z rozkładu Poissona), parametry Weibulla (kształt 1.8, 0.7 i 1.0; skala 140, 2800 i 470 miesięcy dla W1, W2 i S1), koszt jednego zgłoszenia (240, 210 i 190 zł), średnie opóźnienie wpisu do bazy 1.5 miesiąca w przepisie 8 oraz liczbę prób bootstrapu (1000). Po pierwszym uruchomieniu parametrów danych ani ziaren nie zmieniano. Zmieniono: (1) w przepisie 4 funkcja survreg() dostała wartości startowe z oszacowań – bez nich dla szlifierki 57 z 1000 prób nie zbiegło; (2) w poglądowej krzywej „wanny” (przepis 7) skalę składnika zużycia zmieniono ze 110 na 150 miesięcy i oś zaczęto od 1. miesiąca, bo krzywa wychodziła poza rysunek; (3) poprawki wyglądu rysunków (etykiety osi, kształt w legendzie). Całość liczy się w kilkanaście sekund.
1. Paleta, motyw i dane
R
# Przepis 1. Fikcyjny producent elektronarzędzi: sprzedaż miesięczna przez 36 miesięcy
# i zgłoszenia w 24-miesięcznej gwarancji (dane symulowane)
library(ggplot2)
library(patchwork)
library(survival)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_prod <- c("wiertarka W1" = "#0072B2", "wiertarka W2" = "#D55E00", "szlifierka S1" = "#009E73")
kol <- c(granat = "#0f1d3a", prawda = "#CC79A7", szary = "grey55", jasny = "grey88", zolty = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ------------------------------------------------------------------
miesiecy   <- 36       # sprzedaż w miesiącach 1–36; analiza na koniec 36. miesiąca
gwarancja  <- 24       # miesiące gwarancji od daty sprzedaży klientowi
# Prawdziwy czas do awarii (miesiące) z rozkładu Weibulla: F(t) = 1 − exp(−(t / skala)^ksztalt)
ksztalt <- c("wiertarka W1" = 1.8, "wiertarka W2" = 0.7, "szlifierka S1" = 1.0)
skala   <- c("wiertarka W1" = 140, "wiertarka W2" = 2800, "szlifierka S1" = 470)
start   <- c("wiertarka W1" = 1, "wiertarka W2" = 11, "szlifierka S1" = 1)   # pierwszy miesiąc sprzedaży
koszt_zgl <- c("wiertarka W1" = 240, "wiertarka W2" = 210, "szlifierka S1" = 190)  # zł za jedno zgłoszenie
m <- 1:miesiecy
sprzedaz_oczek <- list(                                 # średnia sprzedaż w miesiącu (sztuki)
  "wiertarka W1"  = 2600 - 1200 * (m - 1) / 35,         # starszy model, sprzedaż maleje
  "wiertarka W2"  = ifelse(m < 11, 0, 900 + 2300 * (m - 11) / 25),  # nowy model od 11. miesiąca
  "szlifierka S1" = 1900 * (1 + 0.25 * sin(2 * pi * (m - 2) / 12)))  # sezon wiosenny

set.seed(756)
sprzedaz <- do.call(rbind, lapply(names(ksztalt), function(p)
  data.frame(produkt = p, miesiac = m, sprzedane = rpois(miesiecy, sprzedaz_oczek[[p]]))))
sprzedaz$produkt <- factor(sprzedaz$produkt, levels = names(ksztalt))
# Każda sztuka: data sprzedaży (uproszczenie: połowa miesiąca) i prawdziwy czas do awarii
szt <- sprzedaz[rep(seq_len(nrow(sprzedaz)), sprzedaz$sprzedane), c("produkt", "miesiac")]
szt$t_awarii <- rweibull(nrow(szt), shape = ksztalt[as.character(szt$produkt)],
                         scale = skala[as.character(szt$produkt)])
szt$wiek_analiza <- miesiecy - (szt$miesiac - 0.5)        # wiek sztuki w dniu analizy (miesiące)
szt$cenzura <- pmin(szt$wiek_analiza, gwarancja)          # do kiedy widzimy zgłoszenia tej sztuki
szt$zgloszenie <- as.integer(szt$t_awarii <= szt$cenzura)  # awaria w gwarancji i przed dniem analizy

# Dane, które firma naprawdę ma: zgłoszenia (wiek sztuki przy zgłoszeniu) + liczba sprzedanych w kohortach.
# Sztuki bez zgłoszenia nie są śledzone – w kohorcie wiemy tylko, ile ich jest i ile mają miesięcy.
zgl <- szt[szt$zgloszenie == 1, ]
dane <- rbind(
  data.frame(produkt = zgl$produkt, miesiac_sprzedazy = zgl$miesiac, wiek_mies = round(zgl$t_awarii, 2),
             zgloszenie = 1L, liczba = 1L),
  do.call(rbind, lapply(split(szt[szt$zgloszenie == 0, ], ~ produkt + miesiac, drop = TRUE), function(d)
    data.frame(produkt = d$produkt[1], miesiac_sprzedazy = d$miesiac[1], wiek_mies = d$cenzura[1],
               zgloszenie = 0L, liczba = nrow(d)))))
dane$wiek_mies <- pmax(dane$wiek_mies, 0.01)
rownames(dane) <- NULL
write.csv(dane, "roszczenia-gwarancyjne-elektronarzedzia.csv", row.names = FALSE)

# Prawda (tylko w symulacji): zgłoszenia w kolejnych 12 miesiącach z już sprzedanych sztuk
szt$mies_awarii <- szt$miesiac - 0.5 + szt$t_awarii      # miesiąc kalendarzowy awarii
przysz <- szt[szt$zgloszenie == 0 & szt$t_awarii <= gwarancja & szt$mies_awarii <= miesiecy + 12, ]
prawda_12 <- table(factor(przysz$produkt, levels = names(ksztalt)),
                   factor(ceiling(przysz$mies_awarii), levels = miesiecy + 1:12))

# Podsumowanie danych
agg <- aggregate(cbind(sprzedane = liczba, zgloszenia = liczba * zgloszenie) ~ produkt, dane, sum)
agg
c(sztuk = sum(agg$sprzedane), zgloszen = sum(agg$zgloszenia), wierszy_csv = nrow(dane))
round(100 * (1 - exp(-(gwarancja / skala)^ksztalt)), 2)  # prawdziwy % zgłoszeń w 24 miesiącach
rowSums(prawda_12)                                       # prawdziwa liczba zgłoszeń w miesiącach 37–48
Wynik w R
        produkt sprzedane zgloszenia
1  wiertarka W1     71733       1851
2  wiertarka W2     53654       1002
3 szlifierka S1     68663       2340
      sztuk    zgloszen wierszy_csv
     194050        5193        5291
 wiertarka W1  wiertarka W2 szlifierka S1
         4.10          3.51          4.98
 wiertarka W1  wiertarka W2 szlifierka S1
          720           654           790
2. Naiwny wskaźnik, pełne kohorty i Kaplan–Meier: Rysunek 2
R
# Przepis 2. Sprzedaż w kohortach i odsetek zgłoszeń w 24 miesiącach: naiwnie vs Kaplan–Meier (Rysunek 2)
# Korzysta z obiektów przepisu 1: sprzedaz, dane, ksztalt, skala, start, gwarancja, kol_prod, kol, motyw. Nie losuje.

# (a) Naiwnie: wszystkie zgłoszenia / wszystkie sprzedane (także sztuki sprzedane wczoraj)
nai <- aggregate(cbind(n = liczba, z = liczba * zgloszenie) ~ produkt, dane, sum)
nai$proc <- 100 * nai$z / nai$n
# (b) Tylko kohorty, które przeszły już całą gwarancję (sprzedane w miesiącach 1–12)
pel <- aggregate(cbind(n = liczba, z = liczba * zgloszenie) ~ produkt, subset(dane, miesiac_sprzedazy <= 12), sum)
pel$proc <- 100 * pel$z / pel$n
# (c) Kaplan–Meier: każda sztuka bez zgłoszenia jest obserwacją cenzurowaną w swoim wieku (wagi = liczba sztuk)
km <- survfit(Surv(wiek_mies, zgloszenie) ~ produkt, data = dane, weights = liczba)
s24 <- summary(km, times = gwarancja - 0.01, extend = TRUE)
kmF <- data.frame(produkt = sub("produkt=", "", s24$strata), proc = 100 * (1 - s24$surv),
                  dolna = 100 * (1 - s24$upper), gorna = 100 * (1 - s24$lower))
prawda <- 100 * (1 - exp(-(gwarancja / skala)^ksztalt))
tab2 <- data.frame(produkt = nai$produkt, naiwnie = nai$proc, pelne_kohorty = pel$proc,
                   n_pelne = pel$n, km_24 = kmF$proc, km_dolna = kmF$dolna, km_gorna = kmF$gorna, prawda = prawda)
print(tab2, digits = 3, row.names = FALSE)

# Rysunek 2
pA <- ggplot(subset(sprzedaz, miesiac >= start[as.character(produkt)]), aes(miesiac, sprzedane, colour = produkt, linetype = produkt)) +
  geom_line(linewidth = 1) + geom_point(aes(shape = produkt), size = 1.6) +
  scale_colour_manual(values = kol_prod, name = NULL) + scale_linetype_manual(values = c("solid", "42", "12"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_x_continuous(breaks = c(1, 6, 12, 18, 24, 30, 36)) + scale_y_continuous(labels = function(x) format(x, big.mark = " ")) +
  labs(title = "A. Sprzedaż w kolejnych miesiącach", x = "miesiąc sprzedaży", y = "sprzedane sztuki") + motyw
est <- rbind(data.frame(produkt = tab2$produkt, metoda = "wszystkie zgłoszenia / wszystkie sprzedane", proc = tab2$naiwnie,
                        dolna = NA, gorna = NA),
             data.frame(produkt = tab2$produkt, metoda = "tylko kohorty po pełnej gwarancji (mies. 1–12)",
                        proc = tab2$pelne_kohorty, dolna = NA, gorna = NA),
             data.frame(produkt = tab2$produkt, metoda = "Kaplan–Meier (95% CI)", proc = tab2$km_24,
                        dolna = tab2$km_dolna, gorna = tab2$km_gorna),
             data.frame(produkt = tab2$produkt, metoda = "prawda z symulacji", proc = tab2$prawda, dolna = NA, gorna = NA))
est$metoda <- factor(est$metoda, levels = unique(est$metoda))
est$produkt <- factor(est$produkt, levels = rev(names(kol_prod)))
pB <- ggplot(est, aes(proc, produkt, colour = metoda, shape = metoda)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", linewidth = 0.8, na.rm = TRUE,
                 position = position_dodge(width = 0.6)) +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["zolty"]], kol[["granat"]], kol[["prawda"]]), name = NULL) +
  scale_shape_manual(values = c(1, 2, 16, 18), name = NULL) +
  scale_x_continuous(limits = c(0, 6.5), labels = function(x) paste0(x, "%")) +
  labs(title = "B. Odsetek sztuk ze zgłoszeniem w 24 miesiącach", x = "sztuki ze zgłoszeniem w gwarancji", y = NULL) +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2)) + motyw
p2 <- pA / pB + plot_layout(heights = c(1, 1.15))
p2   # zapis: ggsave("roszczenia-gwarancyjne-cenzurowanie.svg", p2, width = 10, height = 8.4)
Wynik w R
       produkt naiwnie pelne_kohorty n_pelne km_24 km_dolna km_gorna prawda
  wiertarka W1    2.58          4.08   29117  4.03     3.85     4.22   4.10
  wiertarka W2    1.87          3.28    1832  3.71     3.37     4.04   3.51
 szlifierka S1    3.41          4.97   23019  5.04     4.83     5.25   4.98
3. Model Weibulla i wykres Weibulla: Rysunek 3
R
# Przepis 3. Model Weibulla metodą największej wiarygodności i wykres Weibulla (Rysunek 3)
# Korzysta z obiektów przepisów 1–2: dane, km, ksztalt, skala, gwarancja, kol_prod, kol, motyw. Nie losuje.

# survreg: log(T) = log(skala) + (1 / kształt) · błąd; strata(produkt) = osobny kształt dla każdego produktu.
# Wagi = liczba sztuk w wierszu; sztuki bez zgłoszenia wchodzą jako obserwacje cenzurowane.
fit <- survreg(Surv(wiek_mies, zgloszenie) ~ 0 + produkt + strata(produkt), data = dane, weights = liczba,
               dist = "weibull")
prod <- names(kol_prod)
par_w <- data.frame(produkt = prod, ksztalt = 1 / fit$scale, skala = exp(coef(fit)))
V <- vcov(fit)                                 # kolejność: log(skala) × 3, log(1 / kształt) × 3
se_logk <- sqrt(diag(V))[4:6]
par_w$k_dolna <- exp(-log(fit$scale) - 1.96 * se_logk)
par_w$k_gorna <- exp(-log(fit$scale) + 1.96 * se_logk)
Fw <- function(t, k, l) 1 - exp(-(t / l)^k)    # dystrybuanta Weibulla
par_w$F12 <- 100 * Fw(12, par_w$ksztalt, par_w$skala)
par_w$F24 <- 100 * Fw(gwarancja, par_w$ksztalt, par_w$skala)
par_w$prawdziwy_k <- ksztalt
print(par_w, digits = 3, row.names = FALSE)

# Czy oba modele wiertarek mają ten sam kształt? Test ilorazu wiarygodności (wspólny vs osobny kształt)
dw <- subset(dane, produkt != "szlifierka S1"); dw$produkt <- droplevels(dw$produkt)
f_wsp <- survreg(Surv(wiek_mies, zgloszenie) ~ produkt, data = dw, weights = liczba, dist = "weibull")
f_osob <- survreg(Surv(wiek_mies, zgloszenie) ~ produkt + strata(produkt), data = dw, weights = liczba, dist = "weibull")
lr <- 2 * (f_osob$loglik[2] - f_wsp$loglik[2])
round(c(LR = lr, df = 1, p = pchisq(lr, 1, lower.tail = FALSE)), 4)

# Wykres Weibulla: log(−log(1 − F)) względem log(t). Dla rozkładu Weibulla punkty leżą na prostej o nachyleniu k.
skm <- summary(km, times = c(0.5, 1:24), extend = TRUE)
wp <- data.frame(produkt = factor(sub("produkt=", "", skm$strata), levels = prod), t = skm$time, F = 1 - skm$surv)
wp <- subset(wp, F > 0)
linie <- do.call(rbind, lapply(seq_along(prod), function(i) {
  t <- exp(seq(log(0.4), log(30), length.out = 100))
  data.frame(produkt = factor(prod[i], levels = prod), t = t, F = Fw(t, par_w$ksztalt[i], par_w$skala[i]))
}))
etyk <- sprintf("%s (k = %.2f)", prod, par_w$ksztalt)       # kształt z modelu w legendzie
br_F <- c(0.0001, 0.0002, 0.0005, 0.001, 0.002, 0.005, 0.01, 0.02, 0.05)
p3 <- ggplot(wp, aes(log(t), log(-log(1 - F)), colour = produkt, shape = produkt)) +
  geom_line(data = linie, aes(linetype = produkt), linewidth = 0.9) +
  geom_point(size = 2.2) +
  scale_colour_manual(values = kol_prod, labels = etyk, name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), labels = etyk, name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "12"), labels = etyk, name = NULL) +
  scale_x_continuous(breaks = log(c(0.5, 1, 2, 3, 6, 12, 24)), labels = c("0.5", "1", "2", "3", "6", "12", "24"),
                     limits = log(c(0.4, 30))) +
  scale_y_continuous(breaks = log(-log(1 - br_F)), labels = paste0(100 * br_F, "%")) +
  labs(title = "Wykres Weibulla: punkty z Kaplana–Meiera, linie z modelu",
       x = "wiek narzędzia w miesiącach (skala logarytmiczna)", y = "skumulowany odsetek zgłoszeń") + motyw
p3   # zapis: ggsave("roszczenia-gwarancyjne-wykres-weibulla.svg", p3, width = 10, height = 5.8)
Wynik w R
       produkt ksztalt skala k_dolna k_gorna  F12  F24 prawdziwy_k
  wiertarka W1    1.83   138   1.753   1.903 1.15 4.03         1.8
  wiertarka W2    0.73  2218   0.691   0.772 2.19 3.60         0.7
 szlifierka S1    1.03   424   0.994   1.070 2.50 5.05         1.0
      LR       df        p
720.4654   1.0000   0.0000
4. Bootstrap parametryczny i hazard: Rysunek 4
R
# Przepis 4. Bootstrap parametryczny i funkcja hazardu z 95% pasmem (Rysunek 4)
# Korzysta z obiektów przepisów 1–3: dane, par_w, prod, Fw, gwarancja, miesiecy, kol_prod, motyw.
# Losuje: set.seed(7561).

# Kohorty: liczba sprzedanych i wiek, do którego widzimy zgłoszenia (cenzurowanie)
koh <- aggregate(liczba ~ produkt + miesiac_sprzedazy, dane, sum)
koh$cenzura <- pmin(miesiecy - (koh$miesiac_sprzedazy - 0.5), gwarancja)
# Jedna próba z dopasowanego modelu: w kohorcie liczba awarii ~ dwumianowy(N, F(cenzura)),
# czasy awarii z rozkładu Weibulla uciętego do [0, cenzura]; potem ten sam model od nowa
# (start z oszacowań z danych – bez niego survreg czasem nie zbiega przy rozkładzie bliskim wykładniczemu)
dopasuj <- function(d, k0, l0) {
  f <- survreg(Surv(wiek_mies, zgloszenie) ~ 1, data = d, weights = liczba, dist = "weibull",
               init = c(log(l0), log(1 / k0)))
  c(k = 1 / f$scale, l = exp(unname(coef(f))))
}
proba <- function(kh, k, l) {
  Fc <- Fw(kh$cenzura, k, l)
  nz <- rbinom(nrow(kh), kh$liczba, Fc)
  i <- rep(seq_len(nrow(kh)), nz)
  t <- l * (-log(1 - runif(length(i)) * Fc[i]))^(1 / k)          # odwrotna dystrybuanta uciętego Weibulla
  rbind(data.frame(wiek_mies = pmax(round(t, 2), 0.01), zgloszenie = 1L, liczba = 1L),
        data.frame(wiek_mies = kh$cenzura, zgloszenie = 0L, liczba = kh$liczba - nz))
}
B <- 1000
set.seed(7561)
boot <- lapply(seq_along(prod), function(i) {
  kh <- subset(koh, produkt == prod[i])
  t(replicate(B, dopasuj(proba(kh, par_w$ksztalt[i], par_w$skala[i]), par_w$ksztalt[i], par_w$skala[i])))
})
names(boot) <- prod
# 95% przedziały percentylowe dla kształtu i dla odsetka zgłoszeń w 24 miesiącach
t(sapply(prod, function(p) {
  F24 <- 100 * Fw(gwarancja, boot[[p]][, "k"], boot[[p]][, "l"])
  round(c(k_dolna = unname(quantile(boot[[p]][, "k"], .025)), k_gorna = unname(quantile(boot[[p]][, "k"], .975)),
          F24_dolna = unname(quantile(F24, .025)), F24_gorna = unname(quantile(F24, .975))), 3)
}))

# Hazard Weibulla h(t) = (k / l) · (t / l)^(k − 1): zgłoszenia na 1000 sprawnych sztuk w miesiącu
haz <- function(t, k, l) (k / l) * (t / l)^(k - 1)
tt <- seq(0.5, 24, by = 0.25)
hz <- do.call(rbind, lapply(seq_along(prod), function(i) {
  hb <- sapply(tt, function(t) haz(t, boot[[i]][, "k"], boot[[i]][, "l"]))
  data.frame(produkt = factor(prod[i], levels = prod), t = tt, h = 1000 * haz(tt, par_w$ksztalt[i], par_w$skala[i]),
             dolna = 1000 * apply(hb, 2, quantile, .025), gorna = 1000 * apply(hb, 2, quantile, .975))
}))
round(xtabs(h ~ produkt + t, subset(hz, t %in% c(1, 6, 12, 24))), 2)
p4 <- ggplot(hz, aes(t, h, colour = produkt, fill = produkt)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.18, colour = NA) +
  geom_line(aes(linetype = produkt), linewidth = 1.1) +
  scale_colour_manual(values = kol_prod, name = NULL) + scale_fill_manual(values = kol_prod, name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "12"), name = NULL) +
  scale_x_continuous(breaks = c(0.5, 6, 12, 18, 24), labels = c("0.5", "6", "12", "18", "24")) +
  coord_cartesian(ylim = c(0, 5)) +
  labs(title = "Hazard: zgłoszenia na 1000 sprawnych sztuk w miesiącu",
       x = "wiek narzędzia w miesiącach", y = "zgłoszenia na 1000 sztuk / miesiąc") + motyw
p4   # zapis: ggsave("roszczenia-gwarancyjne-hazard.svg", p4, width = 10, height = 5.2)
Wynik w R
              k_dolna k_gorna F24_dolna F24_gorna
wiertarka W1    1.752   1.902     3.859     4.221
wiertarka W2    0.697   0.775     3.385     3.858
szlifierka S1   0.995   1.071     4.839     5.241
               t
produkt            1    6   12   24
  wiertarka W1  0.23 1.00 1.76 3.13
  wiertarka W2  2.63 1.62 1.35 1.12
  szlifierka S1 2.01 2.13 2.18 2.23
5. Prognoza zgłoszeń na 12 miesięcy: Rysunek 5
R
# Przepis 5. Prognoza liczby zgłoszeń w miesiącach 37–48 z kohort sprzedaży (Rysunek 5)
# Korzysta z obiektów przepisów 1–4: dane, koh, par_w, boot, prod, Fw, gwarancja, miesiecy, B, prawda_12, ksztalt, skala,
# koszt_zgl, kol_prod, kol, motyw. Losuje: set.seed(7562).

# Sztuki wciąż w gwarancji i bez zgłoszenia (ryzyko) w każdej kohorcie
zg_koh <- aggregate(zgloszenie ~ produkt + miesiac_sprzedazy, subset(dane, zgloszenie == 1), sum)
koh2 <- merge(koh, zg_koh, all.x = TRUE); koh2$zgloszenie[is.na(koh2$zgloszenie)] <- 0
koh2$ryzyko <- koh2$liczba - koh2$zgloszenie
koh2$wiek <- miesiecy - (koh2$miesiac_sprzedazy - 0.5)
koh2 <- subset(koh2, wiek < gwarancja)                       # kohorty, którym zostało coś z gwarancji
# Prawdopodobieństwo warunkowe: zgłoszenie w miesiącu kalendarzowym 36 + h, jeśli do dziś bez zgłoszenia
p_mies <- function(wiek, k, l) {
  sapply(1:12, function(h) {
    a <- pmin(wiek + h - 1, gwarancja); b <- pmin(wiek + h, gwarancja)
    (Fw(b, k, l) - Fw(a, k, l)) / (1 - Fw(wiek, k, l))
  })                                                         # macierz: kohorty × 12 miesięcy
}
prognoza <- function(p, k, l) {                              # oczekiwana liczba zgłoszeń w miesiącach 37–48
  kh <- subset(koh2, produkt == p); colSums(kh$ryzyko * p_mies(kh$wiek, k, l))
}
pkt <- sapply(seq_along(prod), function(i) prognoza(prod[i], par_w$ksztalt[i], par_w$skala[i]))
colnames(pkt) <- prod

# Niepewność: (1) parametry z bootstrapu parametrycznego (przepis 4), (2) losowość samych zgłoszeń
set.seed(7562)
sym <- lapply(seq_along(prod), function(i) {
  kh <- subset(koh2, produkt == prod[i])
  oczek <- matrix(NA, B, 12); real <- matrix(NA, B, 12)
  for (b in 1:B) {
    pm <- p_mies(kh$wiek, boot[[i]][b, "k"], boot[[i]][b, "l"])
    oczek[b, ] <- colSums(kh$ryzyko * pm)
    real[b, ] <- rowSums(sapply(seq_len(nrow(kh)), function(j)
      rmultinom(1, kh$ryzyko[j], c(pm[j, ], 1 - sum(pm[j, ])))[1:12]))
  }
  list(oczek = oczek, real = real)
})
names(sym) <- prod
suma_oczek <- Reduce(`+`, lapply(sym, function(s) rowSums(s$oczek)))
suma_real <- Reduce(`+`, lapply(sym, function(s) rowSums(s$real)))
tab5 <- rbind(t(sapply(prod, function(p) c(prognoza = sum(pkt[, p]),
                                           ci = quantile(rowSums(sym[[p]]$oczek), c(.025, .975)),
                                           pi = quantile(rowSums(sym[[p]]$real), c(.025, .975)),
                                           prawda = sum(prawda_12[p, ])))),
              razem = c(sum(pkt), quantile(suma_oczek, c(.025, .975)), quantile(suma_real, c(.025, .975)),
                        sum(prawda_12)))
round(tab5, 1)
# Tylko w symulacji: oczekiwana liczba zgłoszeń przy prawdziwych parametrach (bez błędu oszacowania)
round(sum(sapply(prod, function(p) sum(prognoza(p, ksztalt[[p]], skala[[p]])))), 1)
# Koszt gwarancji w kolejnych 12 miesiącach (rezerwa) – zł
rez <- Reduce(`+`, lapply(prod, function(p) rowSums(sym[[p]]$real) * koszt_zgl[[p]]))
round(c(rezerwa_zl = sum(colSums(pkt) * koszt_zgl[prod]), quantile(rez, c(.025, .975))))

# Rysunek 5: prognoza miesięczna (wszystkie produkty) z 95% przedziałem predykcji i prawdą
mies <- data.frame(miesiac = miesiecy + 1:12, prognoza = rowSums(pkt),
                   dolna = apply(Reduce(`+`, lapply(sym, `[[`, "real")), 2, quantile, .025),
                   gorna = apply(Reduce(`+`, lapply(sym, `[[`, "real")), 2, quantile, .975),
                   prawda = colSums(prawda_12))
hist_m <- aggregate(liczba ~ m, transform(subset(dane, zgloszenie == 1),
                    m = ceiling(miesiac_sprzedazy - 0.5 + wiek_mies)), sum)
round(mies[c(1, 6, 12), ], 1)
pA <- ggplot() +
  geom_col(data = hist_m, aes(m, liczba), fill = kol[["jasny"]], colour = "grey70", width = 0.8) +
  geom_ribbon(data = mies, aes(miesiac, ymin = dolna, ymax = gorna), fill = kol[["granat"]], alpha = 0.18) +
  geom_line(data = mies, aes(miesiac, prognoza), colour = kol[["granat"]], linewidth = 1.1) +
  geom_point(data = mies, aes(miesiac, prawda), colour = kol[["prawda"]], shape = 18, size = 3.2) +
  geom_vline(xintercept = miesiecy + 0.5, linetype = "22", colour = "grey40") +
  annotate("text", x = miesiecy + 0.2, y = 330, label = "dzień analizy", hjust = 1, size = 3.6, colour = "grey30") +
  scale_x_continuous(breaks = c(1, 12, 24, 36, 48)) +
  labs(title = "A. Zgłoszenia w miesiącu: dane (słupki) i prognoza",
       subtitle = "linia – prognoza, pasmo – 95% przedział predykcji, romby – prawda z symulacji",
       x = "miesiąc kalendarzowy", y = "zgłoszenia w miesiącu") + motyw
cal <- do.call(rbind, lapply(prod, function(p) data.frame(produkt = factor(p, levels = prod),
  prognoza = sum(pkt[, p]), dolna = quantile(rowSums(sym[[p]]$real), .025),
  gorna = quantile(rowSums(sym[[p]]$real), .975), prawda = sum(prawda_12[p, ]))))
pB <- ggplot(cal, aes(prognoza, produkt)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = produkt), width = 0, orientation = "y", linewidth = 1.2) +
  geom_point(aes(colour = produkt, shape = produkt), size = 3.2) +
  geom_point(aes(x = prawda), colour = kol[["prawda"]], shape = 18, size = 3.6) +
  scale_colour_manual(values = kol_prod, guide = "none") + scale_shape_manual(values = c(16, 17, 15), guide = "none") +
  scale_y_discrete(limits = rev(prod)) +
  labs(title = "B. Suma w miesiącach 37–48", x = "zgłoszenia (95% przedział predykcji)", y = NULL) + motyw
p5 <- pA + pB + plot_layout(widths = c(1.6, 1))
p5   # zapis: ggsave("roszczenia-gwarancyjne-prognoza.svg", p5, width = 10, height = 5.2)
Wynik w R
              prognoza ci.2.5% ci.97.5% pi.2.5% pi.97.5% prawda
wiertarka W1     754.7   720.1    792.6     691      822    720
wiertarka W2     691.2   640.5    751.9     622      771    654
szlifierka S1    852.1   810.5    890.9     785      919    790
razem           2298.0  2232.9   2376.3    2185     2415   2164
[1] 2255.8
rezerwa_zl       2.5%      97.5%
    488185     464150     513811
   miesiac prognoza dolna gorna prawda
37      37    248.8   219   281    239
42      42    195.5   167   222    184
48      48    137.5   115   161    119
6. Porównanie wiertarek i koszt gwarancji: Rysunek 6
R
# Przepis 6. Dwa modele wiertarek: skumulowany odsetek zgłoszeń i koszt gwarancji na sztukę (Rysunek 6)
# Korzysta z obiektów przepisów 1–4: par_w, boot, prod, Fw, gwarancja, koszt_zgl, kol_prod, motyw. Nie losuje
# (przedziały z prób bootstrapu z przepisu 4; próby dla W1 i W2 są niezależne, więc różnicę liczymy parami).

tt <- seq(0, 24, by = 0.25)
krzywe <- do.call(rbind, lapply(1:2, function(i) {
  Fb <- sapply(tt, function(t) Fw(t, boot[[i]][, "k"], boot[[i]][, "l"]))
  data.frame(produkt = factor(prod[i], levels = prod), t = tt, F = 100 * Fw(tt, par_w$ksztalt[i], par_w$skala[i]),
             dolna = 100 * apply(Fb, 2, quantile, .025), gorna = 100 * apply(Fb, 2, quantile, .975))
}))
# Kiedy krzywe się przecinają? F_W1(t) = F_W2(t)
przec <- uniroot(function(t) Fw(t, par_w$ksztalt[1], par_w$skala[1]) - Fw(t, par_w$ksztalt[2], par_w$skala[2]),
                 c(6, 60))$root
round(c(przeciecie_mies = przec), 1)
# Różnica W2 − W1 w punktach procentowych po 6, 12 i 24 miesiącach (95% CI z bootstrapu)
t(sapply(c(6, 12, 24), function(t) {
  d <- 100 * (Fw(t, boot[[2]][, "k"], boot[[2]][, "l"]) - Fw(t, boot[[1]][, "k"], boot[[1]][, "l"]))
  round(c(miesiac = t, roznica_pp = 100 * (Fw(t, par_w$ksztalt[2], par_w$skala[2]) -
                                           Fw(t, par_w$ksztalt[1], par_w$skala[1])),
          dolna = unname(quantile(d, .025)), gorna = unname(quantile(d, .975))), 2)
}))
# Koszt gwarancji na sprzedaną sztukę = odsetek zgłoszeń w 24 miesiącach × koszt jednego zgłoszenia
koszt <- do.call(rbind, lapply(seq_along(prod), function(i) {
  kb <- Fw(gwarancja, boot[[i]][, "k"], boot[[i]][, "l"]) * koszt_zgl[[prod[i]]]
  data.frame(produkt = factor(prod[i], levels = prod), koszt_zgl = koszt_zgl[[prod[i]]],
             zl_na_szt = Fw(gwarancja, par_w$ksztalt[i], par_w$skala[i]) * koszt_zgl[[prod[i]]],
             dolna = unname(quantile(kb, .025)), gorna = unname(quantile(kb, .975)))
}))
print(koszt, digits = 3, row.names = FALSE)

pA <- ggplot(krzywe, aes(t, F, colour = produkt, fill = produkt)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.2, colour = NA) +
  geom_line(aes(linetype = produkt), linewidth = 1.1) +
  geom_vline(xintercept = przec, linetype = "22", colour = "grey40") +
  annotate("text", x = przec - 0.4, y = 4.3, label = sprintf("krzywe przecinają się\nok. %.1f. miesiąca", przec),
           hjust = 1, size = 3.5, colour = "grey25", lineheight = 0.95) +
  scale_colour_manual(values = kol_prod[1:2], name = NULL) + scale_fill_manual(values = kol_prod[1:2], name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  scale_x_continuous(breaks = c(0, 6, 12, 18, 24)) + scale_y_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "A. Wiertarki: odsetek sztuk ze zgłoszeniem", x = "wiek narzędzia w miesiącach",
       y = "skumulowany odsetek zgłoszeń") + motyw
pB <- ggplot(koszt, aes(zl_na_szt, produkt, colour = produkt, shape = produkt)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", linewidth = 1.2) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.2f zł", zl_na_szt)), vjust = -1.1, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = kol_prod, guide = "none") + scale_shape_manual(values = c(16, 17, 15), guide = "none") +
  scale_y_discrete(limits = rev(prod)) + scale_x_continuous(limits = c(6, 10.5)) +
  labs(title = "B. Koszt gwarancji na sztukę", x = "zł na sprzedaną sztukę (95% CI)", y = NULL) + motyw
p6 <- pA + pB + plot_layout(widths = c(1.5, 1))
p6   # zapis: ggsave("roszczenia-gwarancyjne-porownanie-wiertarek.svg", p6, width = 10, height = 5.2)
Wynik w R
przeciecie_mies
           21.6
     miesiac roznica_pp dolna gorna
[1,]       6       1.00  0.90  1.09
[2,]      12       1.03  0.88  1.18
[3,]      24      -0.43 -0.72 -0.12
       produkt koszt_zgl zl_na_szt dolna gorna
  wiertarka W1       240      9.67  9.26 10.13
  wiertarka W2       210      7.56  7.11  8.10
 szlifierka S1       190      9.59  9.19  9.96
7. Grafika: krzywa „wanny”: Rysunek 1
R
# Przepis 7. Grafika: krzywa „wanny” – trzy fazy hazardu i trzy produkty z przykładu (Rysunek 1)
# Korzysta z obiektów przepisu 1: ksztalt, gwarancja, kol_prod, kol. Nie losuje – krzywa jest ilustracją
# (suma trzech hazardów Weibulla o kształcie 0.5, 1 i 4, parametry dobrane ręcznie pod czytelny rysunek).

t <- seq(1, 96, by = 0.1)                                  # miesiące użytkowania (8 lat)
h_wcz <- (0.5 / 4000) * (t / 4000)^(0.5 - 1)                 # wczesne awarie: hazard maleje
h_los <- rep(0.0016, length(t))                              # awarie losowe: hazard stały
h_zuz <- (4 / 150) * (t / 150)^(4 - 1)                       # zużycie: hazard rośnie
h <- 1000 * (h_wcz + h_los + h_zuz)
w <- function(x) h[which.min(abs(t - x))]                   # hazard (na 1000 sztuk / miesiąc) w wieku x
round(c(h_1 = w(1), h_24 = w(24), h_minimum = min(h), t_minimum = t[which.min(h)], h_96 = w(96)), 2)
sx <- function(x) 4 + x * 92 / 96; sy <- function(y) 30 + y * 2.6   # krzywa w górnej części grafiki
krz <- data.frame(x = sx(t), y = sy(h))
karty <- data.frame(x0 = c(2, 35, 68), x1 = c(32, 65, 98), y0 = 1, y1 = 25,
                    fill = c("#FBEDE4", "#E3F2EC", "#E1EEF7"), brzeg = kol_prod[c(2, 3, 1)])
tytuly <- c(sprintf("k < 1: wczesne awarie\nnp. wiertarka W2 (k = %.1f)", ksztalt[["wiertarka W2"]]),
            sprintf("k = 1: awarie losowe\nnp. szlifierka S1 (k = %.1f)", ksztalt[["szlifierka S1"]]),
            sprintf("k > 1: zużycie\nnp. wiertarka W1 (k = %.1f)", ksztalt[["wiertarka W1"]]))
opisy <- c("wady montażu, słaba partia części;\nryzyko największe zaraz po zakupie\n→ kontrola końcowa, test na starcie",
           "upadki, przeciążenia, przypadki;\nryzyko stałe przez cały okres\n→ instrukcja, zabezpieczenia",
           "szczotki, łożyska, przekładnia;\nryzyko rośnie z wiekiem\n→ konstrukcja, koszt po gwarancji")
p7 <- ggplot() +
  annotate("rect", xmin = sx(0), xmax = sx(gwarancja), ymin = sy(0), ymax = sy(11), fill = kol[["zolty"]], alpha = 0.12) +
  annotate("text", x = sx(gwarancja / 2), y = sy(10.4), label = "gwarancja: 24 miesiące", size = 3.6,
           colour = "#7a5200", fontface = 2) +
  annotate("segment", x = sx(0), xend = sx(96), y = sy(0), yend = sy(0), colour = "grey45") +
  annotate("segment", x = sx(0), xend = sx(0), y = sy(0), yend = sy(11), colour = "grey45") +
  annotate("text", x = sx(c(0, 24, 48, 72, 96)), y = sy(0) - 1.8, label = c("0", "24", "48", "72", "96 mies."),
           size = 3.1, colour = "grey35") +
  annotate("text", x = sx(0) - 1, y = sy(5.5), label = "hazard", angle = 90, size = 3.3, colour = "grey35") +
  geom_line(data = krz, aes(x, y), colour = kol[["granat"]], linewidth = 1.4) +
  annotate("text", x = sx(c(4, 40, 70)), y = sy(c(7.6, 1.6, 8.6)),
           label = c("1. wczesne awarie\n(hazard maleje)", "2. awarie losowe\n(hazard prawie stały)",
                     "3. zużycie\n(hazard rośnie)"), size = 3.5, colour = "#0f1d3a", lineheight = 0.95, hjust = 0) +
  geom_rect(data = karty, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1), fill = karty$fill, colour = karty$brzeg,
            linewidth = 0.8) +
  annotate("text", x = karty$x0 + 1.5, y = 20.6, label = tytuly, hjust = 0, size = 3.7, fontface = 2,
           colour = "#0f1d3a", lineheight = 0.95) +
  annotate("text", x = karty$x0 + 1.5, y = 11.5, label = opisy, hjust = 0, size = 3.25, colour = "#0f1d3a",
           lineheight = 1) +
  coord_cartesian(xlim = c(0, 100), ylim = c(0, 62), expand = FALSE, clip = "off") +
  labs(title = "Krzywa „wanny”: kiedy psują się elektronarzędzia", x = NULL, y = NULL) +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p7   # zapis: ggsave("roszczenia-gwarancyjne-krzywa-wanny.svg", p7, width = 10, height = 6.4)
Wynik w R
      h_1      h_24 h_minimum t_minimum      h_96
     9.51      3.32      3.26     31.00      9.40
8. Pułapka: opóźnienie zgłoszeń
R
# Przepis 8. Pułapka: opóźnienie zgłoszeń – co się dzieje, gdy ostatnie awarie nie dotarły jeszcze do bazy
# Korzysta z obiektów przepisów 1 i 3: szt, prod, gwarancja, miesiecy, Fw. Losuje: set.seed(7563).

opoznienie_sr <- 1.5        # średnie opóźnienie wpisu zgłoszenia do bazy (miesiące, rozkład wykładniczy; ręcznie)
set.seed(7563)
szt$wpis <- szt$miesiac - 0.5 + szt$t_awarii + rexp(nrow(szt), 1 / opoznienie_sr)   # miesiąc wpisu do bazy
ocen <- function(koniec, wymagaj_wpisu) {                    # dane „na dzień koniec”, model Weibulla na produkt
  w <- miesiecy - (szt$miesiac - 0.5); c_ <- pmin(koniec - (szt$miesiac - 0.5), gwarancja)
  ok <- c_ > 0
  z <- szt$t_awarii <= c_ & (!wymagaj_wpisu | szt$wpis <= miesiecy)
  sapply(prod, function(p) {
    i <- ok & szt$produkt == p
    d <- data.frame(t = pmax(ifelse(z[i], szt$t_awarii[i], c_[i]), 0.01), z = as.integer(z[i]))
    f <- survreg(Surv(t, z) ~ 1, data = d, dist = "weibull")
    c(k = 1 / f$scale, F24 = 100 * Fw(gwarancja, 1 / f$scale, exp(unname(coef(f)))), zgl = sum(d$z))
  })
}
wyn <- list("bez opóźnienia" = ocen(miesiecy, FALSE), "z opóźnieniem" = ocen(miesiecy, TRUE),
            "z opóźnieniem, data analizy −3 mies." = ocen(miesiecy - 3, TRUE))
round(sapply(wyn, function(x) x["k", ]), 3)      # kształt k
round(sapply(wyn, function(x) x["F24", ]), 2)    # % sztuk ze zgłoszeniem w 24 miesiącach
c(brakujacych_zgloszen = sum(wyn[[1]]["zgl", ] - wyn[[2]]["zgl", ]))
Wynik w R
              bez opóźnienia z opóźnieniem z opóźnieniem, data analizy −3 mies.
wiertarka W1           1.827         1.795                                1.814
wiertarka W2           0.731         0.700                                0.718
szlifierka S1          1.032         1.022                                1.041
              bez opóźnienia z opóźnieniem z opóźnieniem, data analizy −3 mies.
wiertarka W1            4.03          3.77                                 3.97
wiertarka W2            3.60          3.07                                 3.40
szlifierka S1           5.05          4.75                                 4.99
brakujacych_zgloszen
                 381
9. Sprawdzenie palety (deuteranopia)
R
# Przepis 9. Czy paleta jest czytelna przy zaburzeniach widzenia barw? (colorspace::deutan, protan)
# Nie korzysta z innych przepisów. Nie losuje.
library(colorspace)
pary <- list("W1 – W2" = c("#0072B2", "#D55E00"), "W1 – S1" = c("#0072B2", "#009E73"),
             "W2 – S1" = c("#D55E00", "#009E73"), "prognoza – prawda" = c("#0f1d3a", "#CC79A7"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
W1 – W2                                    114.6        108.3       91.9
W1 – S1                                     70.1         55.4       58.0
W2 – S1                                    102.4         53.5       37.3
prognoza – prawda                           60.7         54.4       45.7
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, bootstrap parametryczny i prognoza z kohort – pakiety base i stats; Kaplan–Meier i model Weibulla – pakiet survival). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Opóźnienie zgłoszeń. Awaria z ostatnich tygodni często nie trafiła jeszcze do bazy. Gdy w symulacji wpis do bazy opóźniliśmy średnio o 1.5 miesiąca, zabrakło 381 zgłoszeń, a odsetek w 24 miesiącach spadł dla W2 z 3.60% do 3.07%. Cofnięcie daty analizy o 3 miesiące (zgłoszenia wpisane do dziś, ale z awarii do 33. miesiąca) podniosło wynik do 3.40%. Kalbfleisch i in. (1991) pokazują, jak wprost uwzględnić rozkład opóźnienia w modelu. To pokrewne danym uciętym: części zdarzeń w ogóle nie widać.
- Data sprzedaży ≠ początek użytkowania. Przy dacie wysyłki do sklepu czas na półce wlicza się do „wieku” i zawyża czasy do awarii. Używaj daty z paragonu albo sprawdź wrażliwość wyniku na czas na półce.
- Mieszanina dwóch przyczyn awarii. Wada fabryczna części sztuk plus zużycie reszty dają na wykresie Weibulla łamaną, a jeden model – „średni” kształt. Rozdziel zgłoszenia według kodu usterki.
- Nie każda awaria to zgłoszenie. Model opisuje zgłoszenia – do kosztu gwarancji to wystarczy, do oceny niezawodności nie.
- Ponowne zgłoszenia tej samej sztuki. Tu liczymy tylko pierwsze zgłoszenie. Naprawiona sztuka może wrócić, więc pełny koszt wymaga osobnego modelu dla zdarzeń powtarzalnych.
Najczęstsze pytania
Jak policzyć odsetek zgłoszeń gwarancyjnych, gdy część produktów jest jeszcze w gwarancji?
Potraktuj sztuki bez zgłoszenia jako obserwacje cenzurowane w ich obecnym wieku i użyj estymatora Kaplana–Meiera albo modelu parametrycznego, np. Weibulla. Dzielenie wszystkich zgłoszeń przez wszystkie sprzedane sztuki zaniża wynik, bo młode sztuki nie zdążyły się zepsuć. W przykładzie naiwny wskaźnik dał 1.87%, a prawdziwy odsetek w 24 miesiącach to 3.51%.
Co oznacza parametr kształtu rozkładu Weibulla w danych gwarancyjnych?
Kształt k < 1 oznacza hazard malejący, czyli wczesne awarie (wady montażu, słabe partie części); k = 1 – stałe ryzyko, jak w rozkładzie wykładniczym; k > 1 – zużycie rosnące z wiekiem. W przykładzie wiertarka W2 miała k = 0.73, szlifierka 1.03, a wiertarka W1 1.83.
Jak prognozować liczbę zgłoszeń gwarancyjnych na kolejny rok?
Dla każdej kohorty sprzedaży policz prawdopodobieństwo warunkowe awarii w kolejnych miesiącach wśród sztuk, które dotąd działały i są w gwarancji, pomnóż przez ich liczbę i zsumuj. Niepewność weź z bootstrapu parametrycznego, dodając losowość samych zgłoszeń. W przykładzie wyszło 2298 zgłoszeń, 95% przedział predykcji [2185, 2415].
Co to jest wykres Weibulla?
To wykres log(−log(1 − F)) względem logarytmu czasu, gdzie F to skumulowany odsetek awarii, np. z estymatora Kaplana–Meiera. Gdy dane pochodzą z rozkładu Weibulla, punkty leżą na prostej o nachyleniu równym parametrowi kształtu. Wygięta linia punktów sugeruje mieszaninę przyczyn awarii albo inny rozkład.
Jak porównać awaryjność dwóch modeli produktu?
Porównaj skumulowany odsetek zgłoszeń w kilku ustalonych punktach wieku, np. 6, 12 i 24 miesiące, z przedziałami ufności, a nie jedną liczbą. W przykładzie nowa wiertarka miała po 12 miesiącach o 1.03 pp więcej zgłoszeń, ale po 24 miesiącach o 0.43 pp mniej, bo krzywe przecięły się ok. 21.6. miesiąca.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikZwroty produktów: model i koszt w marży
Sklep z obuwiem: odsetek zwrotów z modelu mieszanego, ranking modeli, zamówienia dwóch rozmiarów, koszt zwrotów i darmowe zwroty – z kodem R.
Czytaj →PoradnikKontrola odbiorcza i krzywa OC
Huta szkła i przetwórnia: plan (n, c) z ryzyka α i β, krzywa OC, AOQL, plan podwójny i sezon z dryfem jakości – z kodem R.
Czytaj →Analizujesz awarie, reklamacje albo zgłoszenia gwarancyjne w pracy?
Pomożemy przygotować dane z cenzurowaniem, dopasować model Weibulla, policzyć prognozę z przedziałem i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/cbo9780511802843 ● Otwarty dostęp: pełny tekst
- Kalbfleisch, J. D., Lawless, J. F., & Robinson, J. A. (1991). Methods for the analysis and prediction of warranty claims. Technometrics, 33(3), 273–285. https://doi.org/10.1080/00401706.1991.10484834
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Lawless, J. F. (1998). Statistical analysis of product warranty data. International Statistical Review, 66(1), 41–60. https://doi.org/10.1111/j.1751-5823.1998.tb00405.x
- Nelson, W. (1972). Theory and applications of hazard plotting for censored failure data. Technometrics, 14(4), 945–966. https://doi.org/10.1080/00401706.1972.10488991
- Weibull, W. (1951). A statistical distribution function of wide applicability. Journal of Applied Mechanics, 18(3), 293–297. https://doi.org/10.1115/1.4010337 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{davison1997bootstrap, author={Davison, A. C. and Hinkley, D. V.}, title={{Bootstrap methods and their application}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511802843}}@article{kalbfleisch1991methods, author={Kalbfleisch, J. D. and Lawless, J. F. and Robinson, J. A.}, title={{Methods for the analysis and prediction of warranty claims}}, journal={Technometrics}, year={1991}, volume={33}, number={3}, pages={273--285}, doi={10.1080/00401706.1991.10484834}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{lawless1998statistical, author={Lawless, J. F.}, title={{Statistical analysis of product warranty data}}, journal={International Statistical Review}, year={1998}, volume={66}, number={1}, pages={41--60}, doi={10.1111/j.1751-5823.1998.tb00405.x}}@article{nelson1972theory, author={Nelson, Wayne}, title={{Theory and applications of hazard plotting for censored failure data}}, journal={Technometrics}, year={1972}, volume={14}, number={4}, pages={945--966}, doi={10.1080/00401706.1972.10488991}}@article{weibull1951statistical, author={Weibull, Waloddi}, title={{A statistical distribution function of wide applicability}}, journal={Journal of Applied Mechanics}, year={1951}, volume={18}, number={3}, pages={293--297}, doi={10.1115/1.4010337}}