Przykład: spółdzielnia mieszkaniowa i 4000 lokali
Fikcyjna spółdzielnia mieszkaniowa ma 4000 lokali: mieszkania własnościowe, lokatorskie i lokale użytkowe. Opłata miesięczna zależy od powierzchni. Księgowość ma stan rozliczeń na koniec każdego miesiąca z trzech lat (2023–2025). Zarząd pyta: kto spłaci zaległość sam, czy przypomnienie coś zmienia i komu wysłać je najpierw?
Wpis dotyczy tylko przypomnień i kolejności kontaktu – nie windykacji ani przepisów. Opóźnienia faktur między firmami (czas do zapłaty, ryzyko konkurencyjne, prognoza wpływów) opisuje wpis opóźnienia płatności faktur w analizie przeżycia.
W pierwszym półroczu 2026 roku spółdzielnia przeprowadziła eksperyment. Każdy lokal, który miał zaległość na koniec miesiąca (od stycznia do czerwca, tylko pierwszy raz), trafiał losowo do jednej z trzech grup: brak przypomnienia, list albo SMS + list. Przypomnienie wysyłano 10. dnia następnego miesiąca. Do eksperymentu weszło 1313 lokali (438, 438 i 437). Mediana zaległości to 681 zł, ale co czwarty lokal zalegał ponad 1764 zł.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każdy lokal ma ukrytą „solidność” płatniczą. Tempo spłaty maleje z liczbą nieopłaconych miesięcy, kwotą i liczbą wcześniejszych zaległości. Przypomnienie przyspiesza spłatę najbardziej u lokali z jednym miesiącem zaległości i wcześniejszymi zaległościami, mniej u lokali z jednym miesiącem i rzadkimi zaległościami, a prawie wcale u lokali z dwoma i więcej miesiącami. Po pierwszym uruchomieniu zmieniliśmy kilka parametrów (lista przy kodzie R): pierwsza wersja dawała 31.8% lokali z zaległością, ze stanu „2+ miesiące” prawie nikt nie wychodził (96.2% zostawało), a grupa „2 miesiące” w eksperymencie liczyła około 100 lokali. Ziarna 764 nie zmienialiśmy. Dane eksperymentu: zaleglosci-spoldzielnia-eksperyment.csv.
Rysunek 1: ile lokali zalega i jak przechodzą między stanami
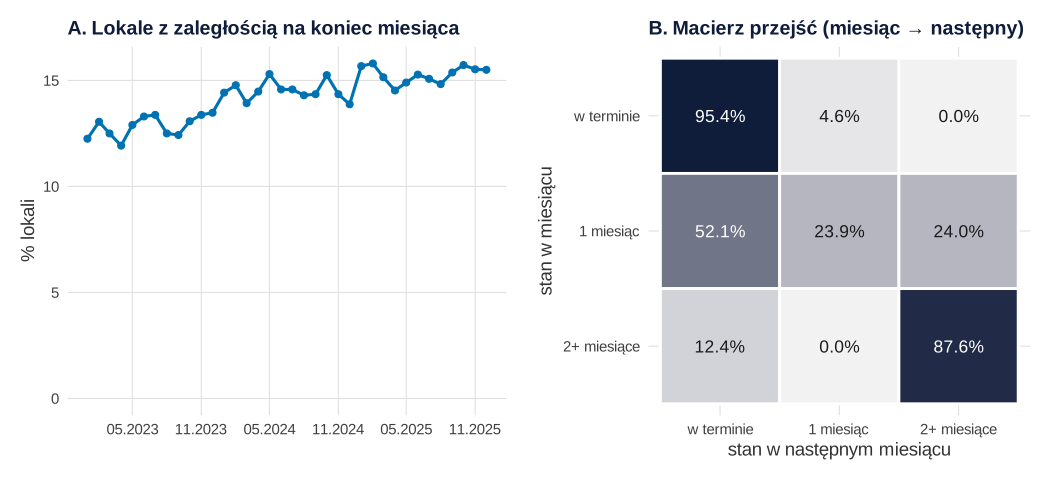
set.seed(764)).Co widać. Na koniec miesiąca zalega średnio 14.2% lokali (od 11.9% do 15.8%), ale w ciągu trzech lat zaległość miało 2934 z 4000 lokali. Macierz przejść pokazuje, co dzieje się miesiąc później: z jednego miesiąca zaległości 52.1% lokali wraca do stanu „w terminie”, a 24.0% przechodzi do „2+ miesiące”. Ze stanu „2+” wraca tylko 12.4% miesięcznie. Technikę dla wyborów marek opisuje wpis przechodzenie klientów między markami.
Jak może zmylić. Macierz uśrednia wszystkie lokale, a lokal, który raz zapomniał, ma inne szanse niż stały dłużnik. Dlatego dalej modelujemy szansę spłaty z cechami lokalu.
Podpis do pracy:
Rysunek 2: model szansy spłaty w 60 dni i jego kalibracja
Jeden wiersz to lokal z zaległością na koniec miesiąca; wynik – czy do końca drugiego kolejnego miesiąca zaległość zniknęła. Regresję logistyczną uczymy na stanach z lat 2023–2024 (13 133 lokalo-miesięcy, 2459 lokali), a sprawdzamy na stanach z 2025 roku (6093) – to walidacja w czasie, jak we wpisie przeciek danych i walidacja w czasie. Przedziały ilorazów szans są odporne na to, że ten sam lokal występuje w wielu miesiącach.
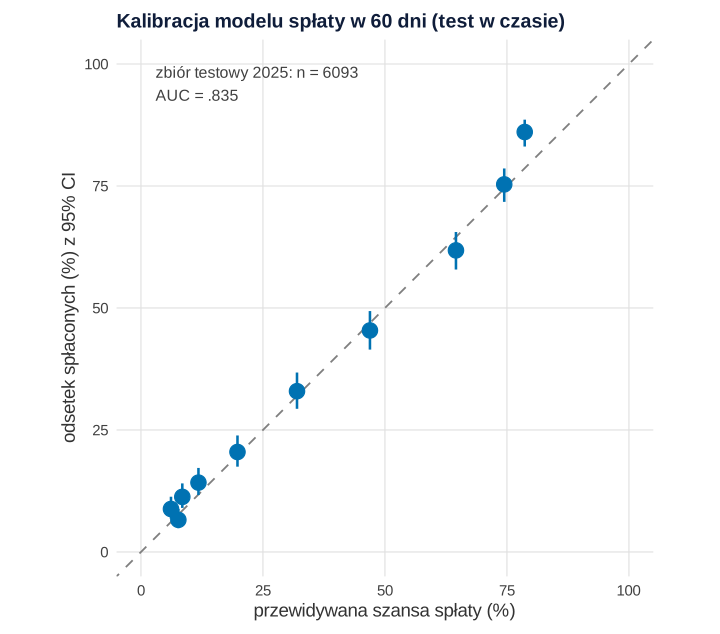
set.seed(764)).Co widać. Szansa spłaty maleje z długością zaległości: 2 miesiące wobec jednego – OR = 0.53, 95% CI [0.45, 0.61]; 3 i więcej – OR = 0.39, 95% CI [0.30, 0.50]. Każdy miesiąc z zaległością w poprzednim roku obniża szansę (OR = 0.83, 95% CI [0.82, 0.85]), podobnie dwa razy większa kwota (OR = 0.85, 95% CI [0.77, 0.94]) i lokal użytkowy wobec własnościowego (OR = 0.75, 95% CI [0.61, 0.94]). W teście AUC = .835, średnia przewidywana szansa 35.0% wobec obserwowanych 36.3%. Kalibracja jest dobra: wyraz wolny 0.08, nachylenie 0.99 (idealnie 0 i 1; Steyerberg i in., 2010). Tylko w górnej grupie model zaniża szansę (78.6% wobec 86.1%).
Jak może zmylić. Model opisuje świat bez przypomnień. Zastosowany do lokali z grupy kontrolnej eksperymentu przewidział 56.1%, a spłaciło 63.2%: w eksperymencie liczymy 60 dni od wysyłki, nie do końca miesiąca, i każdy lokal wchodzi raz. Model mówi też tylko, kto spłaci sam, nie – komu przypomnienie pomoże.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: eksperyment z przypomnieniem
Dzięki losowemu przydziałowi różnicę odsetków spłat można przypisać przypomnieniu. To ta sama logika co w teście wyłączenia reklamy: liczy się przyrost względem kontroli, nie odsetek spłat w grupie z przypomnieniem.
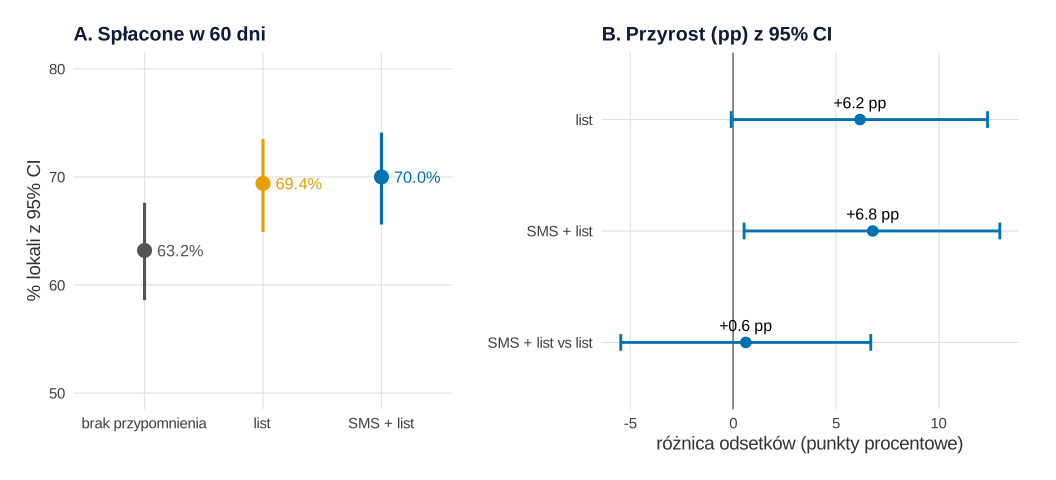
set.seed(764)).Co widać. Bez przypomnienia w 60 dni spłaciło 63.2% lokali, 95% CI [58.6, 67.6]. List podniósł odsetek do 69.4%, a SMS z listem – do 70.0%. Przyrost dla SMS + list to 6.8 pp, 95% CI [0.5, 13.0] (przedział Newcombe’a, zalecany dla różnicy proporcji; Newcombe, 1998); dla samego listu 6.2 pp, 95% CI [−0.1, 12.4]. Test χ² dla trzech grup: χ²(2) = 5.62, p = .060. Przy przyjętych kosztach (list 3.20 zł, SMS 0.10 zł) jedna dodatkowa spłata kosztuje około 49–52 zł.
Jak może zmylić. Większość spłat w grupie z przypomnieniem to lokale, które spłaciłyby i tak – 63 na 100 spłaca bez niczego. Raport „70% adresatów spłaciło po przypomnieniu” przypisałby przypomnieniu dziesięć razy więcej, niż daje. Różnica SMS + list wobec samego listu (0.6 pp, 95% CI [−5.5, 6.7]) jest niepewna; podobny efekt SMS-ów w spłacie pożyczek opisują Cadena i Schoar (2011), a przypomnień w oszczędzaniu – Karlan i in. (2016).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czas do spłaty – Kaplan–Meier
Lokale z czerwca mamy obserwowane krócej niż te ze stycznia, więc czas do spłaty opisujemy krzywą Kaplana–Meiera (Kaplan i Meier, 1958), która uwzględnia obserwacje cenzurowane w dniu analizy (30 września 2026).
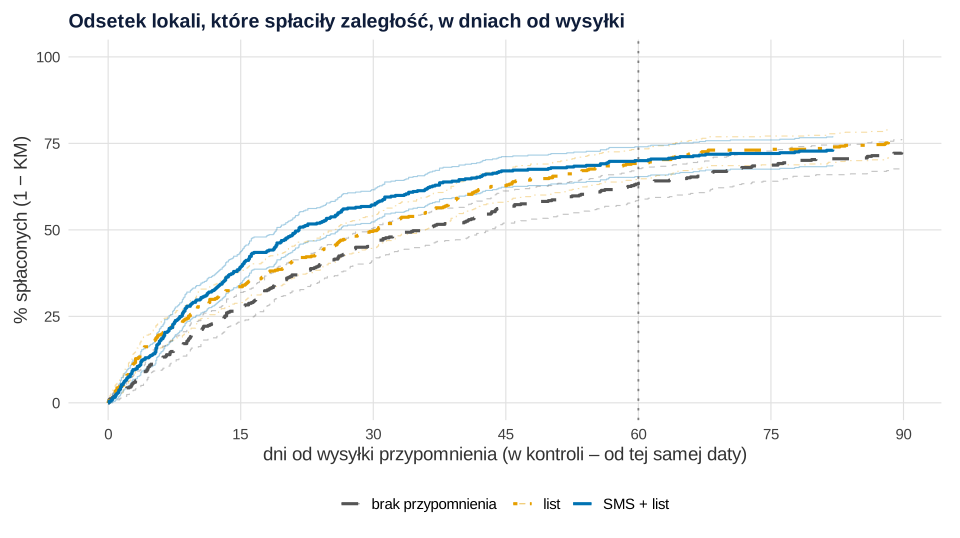
set.seed(764)).Co widać. Przypomnienie przyspiesza spłatę. Po 30 dniach spłaciło 57.2% lokali z SMS-em i listem wobec 46.1% bez przypomnienia; mediana czasu do spłaty to 21.6 dnia, 95% CI [19.0, 26.0], wobec 35.5 dnia, 95% CI [29.8, 43.4]. Po 90 dniach krzywe się schodzą (73.2% wobec 72.4%).
Jak może zmylić. Test log-rank nie wykazuje różnicy: χ²(2) = 3.41, p = .182 – bo ostatecznie spłaca podobny odsetek. Wybierz miarę przed eksperymentem: odsetek w 30 albo 60 dni, medianę czasu albo kwotę. Dla płynności liczą się też dwa tygodnie wcześniejszych wpłat.
Zdanie do Wyników:
Rysunek 5: ryzyko ≠ przyrost
Średni przyrost 6.8 pp ukrywa duże różnice. Dzielimy lokale na trzy grupy według tego, co spółdzielnia wie w dniu wysyłki: długość zaległości i liczba miesięcy z zaległością w poprzednim roku (częste = co najmniej 3).
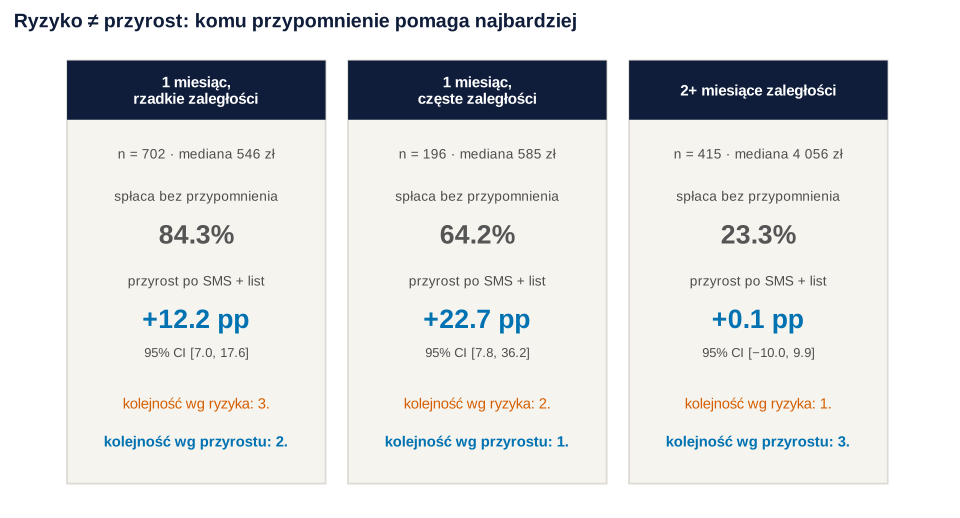
set.seed(764)).Co widać. Lokale z zaległością za 2 i więcej miesięcy mają największe ryzyko – bez przypomnienia spłaca 23.3% – i właśnie im przypomnienie nie pomaga (+0.1 pp, 95% CI [−10.0, 9.9]). Najwięcej zyskują lokale z jednym miesiącem i częstymi zaległościami: +22.7 pp, 95% CI [7.8, 36.2]. Różnica przyrostu między grupami jest istotna (test ilorazu wiarygodności dla interakcji grupa × przypomnienie: χ²(2) = 13.85, p < .001). To samo zjawisko w utrzymaniu klientów opisała Ascarza (2018): klienci najbardziej zagrożeni odejściem nie są najlepszymi adresatami działań.
Jak może zmylić. Środkowa grupa ma tylko 196 lokali, więc przedział jest szeroki. Grupy ustal przed analizą – podgrupy wybrane po fakcie dają przypadkowe „odkrycia”.
Podpis do pracy:
Rysunek 6: komu przypominać najpierw
Załóżmy, że spółdzielnia może wysłać SMS z listem 30% zalegających (394 z 1313). Porównujemy trzy kolejności: według przewidywanego przyrostu z modelu logistycznego z interakcją przypomnienia z cechami lokalu (dopasowanego w dwóch połówkach na krzyż, żeby lokal nie oceniał sam siebie), według ryzyka (najpierw najmniejsza szansa spłaty z rysunku 2) i losowo. Metody szacowania przyrostu (T-learner, las przyczynowy, krzywa Qini) opisuje wpis modelowanie uplift: komu wysłać kupon, a przegląd – Devriendt i in. (2018).
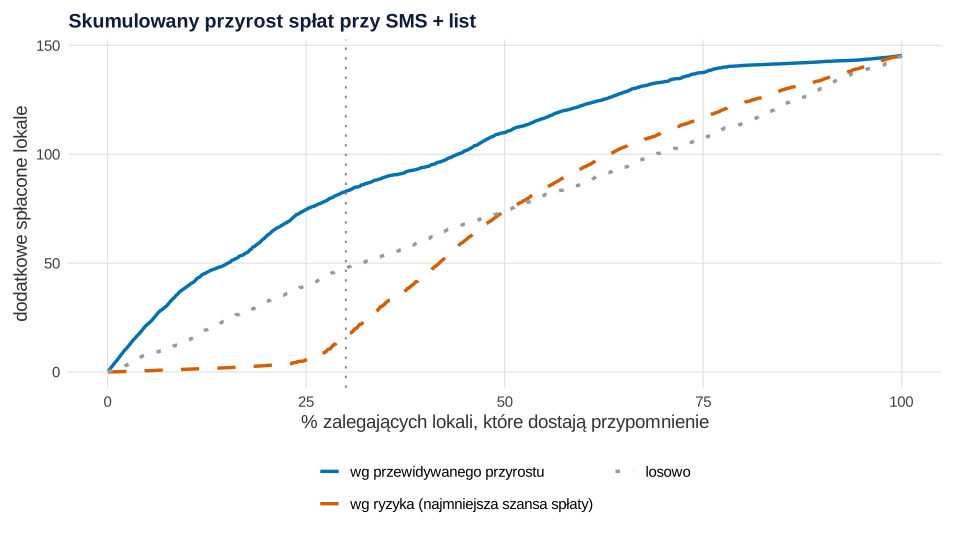
set.seed(764)).Co widać. Przy budżecie na 30% lokali kolejność według przyrostu daje 83 dodatkowe spłaty, losowa – 48, a według ryzyka – 17. Przypomnienie dla wszystkich dałoby 145. Kolejność według ryzyka zaczyna od lokali z długą zaległością, którym przypomnienie nie pomaga. Na samych danych, bez znajomości prawdy: w górnych 30% według przyrostu SMS z listem podniósł odsetek spłat o 16.4 pp, 95% CI [6.8, 25.7], a w górnych 30% według ryzyka – o 3.4 pp, 95% CI [−6.7, 13.2].
Jak może zmylić. Model przyrostu jest niedokładny: korelacja przewidywanego i prawdziwego przyrostu to .66. Gdy celem jest kwota, a nie liczba lokali, różnica maleje: 54 734 zł wobec 33 408 zł (ryzyko) i 36 896 zł (losowo), bo duże zaległości są w grupie, której przypomnienie nie pomaga. To odpowiednik wykresu gain z przyrostem na osi pionowej.
Zdanie do Wyników:
Co z tym zrobić w firmie
- Mierz przyrost, nie odsetek spłat po przypomnieniu. Zostaw losową grupę bez przypomnienia (np. 10–20% zalegających) także po eksperymencie – inaczej nie odróżnisz działania przypomnienia od spłat, które i tak by przyszły.
- Kolejność wysyłki według przyrostu. Najpierw lokale z jednym miesiącem zaległości, zwłaszcza te, które zalegały już wcześniej. Lokalom z długą zaległością przypomnienie nie pomaga – one potrzebują innej formy kontaktu (rozmowa o rozłożeniu płatności), którą warto sprawdzić osobnym eksperymentem.
- Tańszy kanał najpierw. SMS z listem nie dał wyraźnie więcej niż sam list. Kolejny eksperyment: sam SMS wobec samego listu – SMS kosztuje ułamek listu.
- Model ryzyka (rysunek 2) zostaw do planowania wpływów, nie do wyboru adresatów przypomnień. Sprawdzaj jego kalibrację co kwartał.
Podobny problem w ocenie składek grup o różnej historii opisuje wpis wiarygodność Bühlmanna, a inne tematy finansowe – statystyka w pracy z finansów i rachunkowości.
Jak opisać w pracy
Tabela do Wyników:
| Grupa lokali | n | Spłata bez przypomnienia (%) | Spłata po SMS + list (%) | Przyrost (pp) [95% CI] |
|---|---|---|---|---|
| 1 miesiąc, rzadkie zaległości | 702 | 84.3 | 96.5 | 12.2 [7.0, 17.6] |
| 1 miesiąc, częste zaległości | 196 | 64.2 | 86.9 | 22.7 [7.8, 36.2] |
| 2+ miesiące zaległości | 415 | 23.3 | 23.3 | 0.1 [−10.0, 9.9] |
Układ rozdziałów: jak napisać pracę z finansów i rachunkowości.
Kod R: przejścia, model spłaty, eksperyment i kolejność wysyłki
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy 1–6 po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z obiektów poprzednich. Przepis 7 jest samodzielny. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 6 – każdy zaczyna się od własnego set.seed(764). Ziarno 764 ustalono raz i nie zmieniano go. Pozostałe przepisy nie losują, więc uruchomione po przepisie 1 dadzą te same liczby co na stronie. Ręcznie ustalono (przepis 1): liczbę lokali (4000), udziały typów, rozkład powierzchni i stawki za m², szansę nowej zaległości, dzienne tempo spłaty i jego zależność od długości zaległości, kwoty, historii, typu i ukrytej solidności, odsetek zaległości rosnących o kolejny miesiąc, podatność grup na przypomnienie i siłę działania listu i SMS-u. Po pierwszym uruchomieniu zmieniono: bazowe tempo spłaty (0.022 → 0.035), spadek tempa z miesiącem (0.5 → 0.3), z kwotą (0.3 → 0.2) i z solidnością (0.8 → 0.6), szansę nowej zaległości (wyraz wolny −2.9 → −3.3, solidność −1.0 → −0.7), odsetek zaległości rosnących (40% → 50%), podział podatności (liczba miesięcy → trzy grupy) i siłę przypomnień (0.35 → 0.4 i 0.65 → 0.75). Przyjęte koszty listu i SMS-u (przepis 3) i budżet 30% (przepis 6) też są ręczne. Kolumny u, p0_prawda i p2_prawda to ukryty mechanizm, którego spółdzielnia nie zna – używa ich tylko przepis 6 (krzywe z prawdą); w pliku CSV ich nie ma. Cały kod liczy się w kilka sekund.
1. Dane, odsetek zalegających i macierz przejść: Rysunek 1
R
# Rysunek 1. Fikcyjna spółdzielnia mieszkaniowa: opłaty miesięczne 4000 lokali (2023–2025),
# odsetek lokali z zaległością i macierz przejść; dane eksperymentu z przypomnieniem (I półrocze 2026)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (sprawdzenie przy deuteranopii w przepisie 7) i prosty motyw
kol_grupa <- c("brak przypomnienia" = "#555555", "list" = "#E69F00", "SMS + list" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Wszystkie parametry poniżej ustalono ręcznie (dane są fikcyjne).
set.seed(764)                                   # ziarno ustalone raz, bez dobierania pod wynik
n <- 4000
typy <- c("mieszkanie własnościowe", "mieszkanie lokatorskie", "lokal użytkowy")
lokale <- data.frame(lokal = sprintf("L%04d", 1:n),
                     typ = factor(sample(typy, n, replace = TRUE, prob = c(0.62, 0.30, 0.08)), typy))
uzytk <- lokale$typ == "lokal użytkowy"
lokale$pow <- round(ifelse(uzytk, exp(rnorm(n, log(75), 0.4)), exp(rnorm(n, log(50), 0.3))), 1)   # m²
lokale$oplata <- round(lokale$pow * ifelse(uzytk, 16, 11))           # opłata miesięczna w zł
u <- rnorm(n)                                    # ukryta „solidność” płatnicza (firma jej nie zna)
typ_ef <- c(0, -0.15, -0.35)[as.integer(lokale$typ)]

# Dzienne „tempo spłaty” całej zaległości – ten sam mechanizm w historii i w eksperymencie
tempo <- function(m, kwota, hist12, typ_ef, u)
  exp(log(0.035) + 0.6 * u - 0.3 * (pmin(m, 4) - 1) - 0.2 * log2(kwota / 1000) - 0.06 * hist12 + typ_ef)

# Łańcuch miesięczny: m = liczba nieopłaconych miesięcy na koniec miesiąca.
# 12 miesięcy rozbiegu (2022) + 36 miesięcy danych (2023–2025) + 6 miesięcy eksperymentu (2026)
T_all <- 12 + 36 + 6
M <- matrix(0L, n, T_all)
for (t in 2:T_all) {
  m0 <- M[, t - 1]
  h12 <- if (t > 2) rowSums(M[, max(1, t - 13):(t - 2), drop = FALSE] > 0) else rep(0, n)
  mies <- (t - 1) %% 12 + 1                      # 1 = styczeń
  q <- plogis(-3.3 - 0.7 * u + 0.3 * uzytk + 0.25 * (mies %in% 1:2) + 0.1 * h12)   # nowa zaległość
  p_splata <- 1 - exp(-30 * tempo(pmax(m0, 1), pmax(m0, 1) * lokale$oplata, h12, typ_ef, u))
  r <- runif(n); r2 <- runif(n)
  M[, t] <- ifelse(m0 == 0, as.integer(r < q),
                   ifelse(r < p_splata, 0L, ifelse(r2 < 0.5, m0, pmin(m0 + 1L, 12L))))
}
miesiace <- seq(as.Date("2022-01-01"), by = "month", length.out = T_all)
dane_hist <- 13:48                                # 2023-01 … 2025-12
stan <- function(m) factor(ifelse(m == 0, "w terminie", ifelse(m == 1, "1 miesiąc", "2+ miesiące")),
                           c("w terminie", "1 miesiąc", "2+ miesiące"))

# Odsetek lokali z zaległością na koniec miesiąca (2023–2025)
odsetek <- data.frame(miesiac = miesiace[dane_hist], proc = 100 * colMeans(M[, dane_hist] > 0))
round(range(odsetek$proc), 1)
round(mean(odsetek$proc), 1)
sum(rowSums(M[, dane_hist] > 0) > 0)              # lokale z co najmniej jedną zaległością w 3 lata

# Macierz przejść miesiąc → następny miesiąc (wszystkie pary miesięcy 2023–2025)
od <- stan(as.vector(M[, dane_hist[-36]])); do <- stan(as.vector(M[, dane_hist[-1]]))
przejscia <- table(od, do)
przejscia
round(100 * prop.table(przejscia, 1), 1)

# Dane eksperymentu: lokale z zaległością na koniec stycznia–czerwca 2026, każdy lokal raz (pierwszy raz)
wejscie <- apply(M[, 49:54] > 0, 1, function(x) if (any(x)) which(x)[1] else NA) + 48
eks <- data.frame(lokale, u = u, typ_ef = typ_ef, t = wejscie)[!is.na(wejscie), ]
eks$m <- M[cbind(as.integer(rownames(eks)), eks$t)]
eks$hist12 <- sapply(seq_len(nrow(eks)), function(j) sum(M[as.integer(rownames(eks))[j], (eks$t[j] - 12):(eks$t[j] - 1)] > 0))
eks$kwota <- eks$m * eks$oplata
eks$wysylka <- seq(as.Date("2022-02-10"), by = "month", length.out = T_all)[eks$t]   # 10. dzień następnego miesiąca
eks$grupa <- factor(sample(rep(names(kol_grupa), length.out = nrow(eks))), names(kol_grupa))   # losowanie 1:1:1
# Ukryta podatność na przypomnienie: największa przy 1 miesiącu zaległości i wcześniejszych zaległościach,
# mniejsza przy 1 miesiącu bez historii (i tak spłacają), prawie żadna przy 2+ miesiącach (brak pieniędzy)
g <- ifelse(eks$m >= 2, 0.15, ifelse(eks$hist12 >= 3, 1.4, 0.9))
lam0 <- tempo(eks$m, eks$kwota, eks$hist12, eks$typ_ef, eks$u)
lam <- lam0 * exp(c(0, 0.4, 0.75)[as.integer(eks$grupa)] * g)
czas <- rexp(nrow(eks), lam)                                             # dni od wysyłki do spłaty całości
eks$p0_prawda <- 1 - exp(-60 * lam0)                                     # prawda znana z symulacji
eks$p2_prawda <- 1 - exp(-60 * lam0 * exp(0.75 * g))                     # gdyby wysłano SMS + list
obs <- as.numeric(as.Date("2026-09-30") - eks$wysylka)                  # dzień analizy 30.09.2026
eks$dni <- round(pmin(czas, obs), 1)
eks$splata <- as.integer(czas <= obs)
eks$splata60 <- as.integer(czas <= 60)
eks$m_kat <- factor(ifelse(eks$m >= 3, "3+", as.character(eks$m)), c("1", "2", "3+"))
nrow(eks)
table(eks$grupa)
table(eks$m_kat)
round(quantile(eks$kwota, c(.25, .5, .75)))

d1a <- odsetek
p1a <- ggplot(d1a, aes(miesiac, proc)) + geom_line(colour = "#0072B2", linewidth = 1.1) +
  geom_point(colour = "#0072B2", size = 2) +
  scale_y_continuous(limits = c(0, NA)) + scale_x_date(date_labels = "%m.%Y", date_breaks = "6 months") +
  labs(title = "A. Lokale z zaległością na koniec miesiąca", x = NULL, y = "% lokali") + motyw
d1b <- as.data.frame(round(100 * prop.table(przejscia, 1), 1))
p1b <- ggplot(d1b, aes(do, od, fill = Freq)) + geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sprintf("%.1f%%", Freq), colour = Freq > 50), size = 4.6, show.legend = FALSE) +
  scale_fill_gradient(low = "#f2f2f2", high = "#0f1d3a", guide = "none") +
  scale_colour_manual(values = c("grey10", "white")) + scale_y_discrete(limits = rev) +
  labs(title = "B. Macierz przejść (miesiąc → następny)", x = "stan w następnym miesiącu", y = "stan w miesiącu") + motyw +
  theme(panel.grid = element_blank())
p1 <- p1a + p1b + plot_layout(widths = c(1.15, 1))
p1
# ggsave("zaleglosci-wzorce-macierz-przejsc.svg", p1, width = 11, height = 5)
Wynik w R
[1] 11.9 15.8
[1] 14.2
[1] 2934
             do
od            w terminie 1 miesiąc 2+ miesiące
  w terminie      114673      5480           0
  1 miesiąc         3789      1737        1746
  2+ miesiące       1561         0       11014
             do
od            w terminie 1 miesiąc 2+ miesiące
  w terminie        95.4       4.6         0.0
  1 miesiąc         52.1      23.9        24.0
  2+ miesiące       12.4       0.0        87.6
[1] 1313

brak przypomnienia               list         SMS + list
               438                438                437

  1   2  3+
898  82 333
 25%  50%  75%
 496  681 1764
2. Model szansy spłaty i kalibracja: Rysunek 2
R
# Rysunek 2. Model szansy uregulowania zaległości w 60 dni (regresja logistyczna) i jego kalibracja
# (wymaga obiektów z przepisu 1: M, lokale, dane_hist, miesiace, eks, motyw)
library(sandwich)

# Jeden wiersz = lokal z zaległością na koniec miesiąca t; wynik: zaległość spłacona do końca miesiąca t + 2
mig <- lapply(dane_hist[dane_hist <= 46], function(t) {
  i <- which(M[, t] > 0)
  data.frame(lokal = lokale$lokal[i], typ = lokale$typ[i], t = t, m = M[i, t], kwota = M[i, t] * lokale$oplata[i],
             hist12 = rowSums(M[i, (t - 12):(t - 1), drop = FALSE] > 0),
             y = as.integer(M[i, t + 1] == 0 | M[i, t + 2] == 0))
})
mig <- do.call(rbind, mig)
mig$m_kat <- factor(ifelse(mig$m >= 3, "3+", as.character(mig$m)), c("1", "2", "3+"))
ucz <- subset(mig, t <= 36)                       # uczenie: stany z 2023–2024
test <- subset(mig, t >= 37)                      # test w czasie: stany ze stycznia–października 2025
c(uczenie = nrow(ucz), test = nrow(test), lokale_uczenie = length(unique(ucz$lokal)))
round(100 * c(uczenie = mean(ucz$y), test = mean(test$y)), 1)

model <- glm(y ~ m_kat + log2(kwota / 1000) + hist12 + typ, family = binomial, data = ucz)
V <- vcovCL(model, cluster = ~ lokal)             # błędy odporne na wiele miesięcy tego samego lokalu
se <- sqrt(diag(V))
round(cbind(OR = exp(coef(model)), dolna = exp(coef(model) - 1.96 * se), gorna = exp(coef(model) + 1.96 * se))[-1, ], 2)

# Ocena na zbiorze testowym: AUC (statystyka c), kalibracja ogólna i nachylenie kalibracji
test$p <- predict(model, test, type = "response")
lp <- qlogis(test$p)
auc <- function(p, y) { r <- rank(p); (sum(r[y == 1]) - sum(y == 1) * (sum(y == 1) + 1) / 2) / (sum(y == 1) * sum(y == 0)) }
round(auc(test$p, test$y), 3)
round(100 * c(przewidywane = mean(test$p), obserwowane = mean(test$y)), 1)
round(c(wyraz_wolny = unname(coef(glm(test$y ~ offset(lp), family = binomial))[1]),
        nachylenie = unname(coef(glm(test$y ~ lp, family = binomial))[2])), 2)

# Wykres kalibracji: 10 grup przewidywanego prawdopodobieństwa, odsetek obserwowany z przedziałem Wilsona
test$dec <- cut(test$p, unique(quantile(test$p, 0:10 / 10)), include.lowest = TRUE, labels = FALSE)
kal <- do.call(rbind, lapply(split(test, test$dec), function(d) {
  ci <- prop.test(sum(d$y), nrow(d), correct = FALSE)$conf.int
  data.frame(n = nrow(d), przew = 100 * mean(d$p), obs = 100 * mean(d$y), dolna = 100 * ci[1], gorna = 100 * ci[2])
}))
round(kal, 1)

# Ten sam model zastosowany do lokali z eksperymentu (używany w przepisie 6 do kolejności „wg ryzyka”)
eks$p_hist <- predict(model, eks, type = "response")
kontrola <- eks$grupa == "brak przypomnienia"
round(100 * c(przewidywane = mean(eks$p_hist[kontrola]), obserwowane_60_dni = mean(eks$splata60[kontrola])), 1)

p2 <- ggplot(kal, aes(przew, obs)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey50") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0, colour = "#0072B2", linewidth = 0.9) +
  geom_point(aes(size = n), colour = "#0072B2") +
  scale_size_area(max_size = 5, guide = "none") +
  coord_equal(xlim = c(0, 100), ylim = c(0, 100)) +
  annotate("text", x = 3, y = 96, hjust = 0, size = 4.2, colour = "grey25",
           label = sprintf("zbiór testowy 2025: n = %d\nAUC = %s", nrow(test), sub("^0", "", sprintf("%.3f", auc(test$p, test$y))))) +
  labs(title = "Kalibracja modelu spłaty w 60 dni (test w czasie)",
       x = "przewidywana szansa spłaty (%)", y = "odsetek spłaconych (%) z 95% CI") + motyw
p2
# ggsave("zaleglosci-kalibracja-modelu.svg", p2, width = 7.5, height = 6.6)
Wynik w R
       uczenie           test lokale_uczenie
         13133           6093           2459
uczenie    test
   39.9    36.3
                            OR dolna gorna
m_kat2                    0.53  0.45  0.61
m_kat3+                   0.39  0.30  0.50
log2(kwota/1000)          0.85  0.77  0.94
hist12                    0.83  0.82  0.85
typmieszkanie lokatorskie 0.85  0.75  0.95
typlokal użytkowy         0.75  0.61  0.94
[1] 0.835
przewidywane  obserwowane
        35.0         36.3
wyraz_wolny  nachylenie
       0.08        0.99
     n przew  obs dolna gorna
1  613   6.2  8.8   6.8  11.3
2  608   7.7  6.6   4.9   8.8
3  611   8.5 11.3   9.0  14.0
4  605  11.8 14.2  11.7  17.2
5  610  19.8 20.5  17.5  23.9
6  610  32.0 33.0  29.3  36.8
7  608  46.9 45.4  41.5  49.4
8  610  64.6 61.8  57.9  65.6
9  608  74.4 75.3  71.8  78.6
10 610  78.6 86.1  83.1  88.6
      przewidywane obserwowane_60_dni
              56.1               63.2
3. Eksperyment – odsetki i przyrost: Rysunek 3
R
# Rysunek 3. Eksperyment: brak przypomnienia vs list vs SMS + list – odsetek spłat w 60 dni i przyrost
# (wymaga obiektów z przepisu 1: eks, kol_grupa, motyw)
library(patchwork)
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int[1:2]       # przedział Wilsona
tab <- do.call(rbind, lapply(levels(eks$grupa), function(g) {
  d <- eks[eks$grupa == g, ]; ci <- wilson(sum(d$splata60), nrow(d))
  data.frame(grupa = g, n = nrow(d), splacone = sum(d$splata60), proc = 100 * mean(d$splata60),
             dolna = 100 * ci[1], gorna = 100 * ci[2])
}))
tab$grupa <- factor(tab$grupa, levels(eks$grupa))
tab[, 4:6] <- round(tab[, 4:6], 1); tab
chisq.test(table(eks$grupa, eks$splata60))

# Przyrost względem kontroli w punktach procentowych – przedział Newcombe’a (z dwóch przedziałów Wilsona)
newcombe <- function(x1, n1, x0, n0) {
  p1 <- x1 / n1; p0 <- x0 / n0; c1 <- wilson(x1, n1); c0 <- wilson(x0, n0)
  100 * c(roznica = p1 - p0, dolna = p1 - p0 - sqrt((p1 - c1[1])^2 + (c0[2] - p0)^2),
          gorna = p1 - p0 + sqrt((c1[2] - p1)^2 + (p0 - c0[1])^2))
}
k <- tab[1, ]
przyrost <- rbind("list" = newcombe(tab$splacone[2], tab$n[2], k$splacone, k$n),
                  "SMS + list" = newcombe(tab$splacone[3], tab$n[3], k$splacone, k$n),
                  "SMS + list vs list" = newcombe(tab$splacone[3], tab$n[3], tab$splacone[2], tab$n[2]))
round(przyrost, 1)
# Koszt na jeden dodatkowy spłacony lokal (przyjęte koszty: list 3.20 zł, SMS 0.10 zł)
koszt <- c("list" = 3.20, "SMS + list" = 3.30)
round(koszt / (przyrost[1:2, "roznica"] / 100), 1)
# Kwota spłacona w 60 dni na lokal w grupie (zł) – cel „pieniądze”, nie „liczba lokali”
round(tapply(eks$kwota * eks$splata60, eks$grupa, mean))

p3a <- ggplot(tab, aes(grupa, proc, colour = grupa)) +
  geom_pointrange(aes(ymin = dolna, ymax = gorna), size = 0.9, linewidth = 1.1) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), nudge_x = 0.3, size = 4.3, show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, guide = "none") + scale_y_continuous(limits = c(50, 80)) +
  labs(title = "A. Spłacone w 60 dni", x = NULL, y = "% lokali z 95% CI") + motyw
d3b <- data.frame(porownanie = factor(rownames(przyrost), rev(rownames(przyrost))), przyrost)
p3b <- ggplot(d3b, aes(roznica, porownanie)) + geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, orientation = "y", colour = "#0072B2", linewidth = 1) +
  geom_point(size = 3.2, colour = "#0072B2") +
  geom_text(aes(label = sprintf("%+.1f pp", roznica)), vjust = -1, size = 4.2) +
  labs(title = "B. Przyrost (pp) z 95% CI", x = "różnica odsetków (punkty procentowe)", y = NULL) + motyw
p3 <- p3a + p3b + plot_layout(widths = c(1, 1.1))
p3
# ggsave("zaleglosci-eksperyment-przyrost.svg", p3, width = 11, height = 5)
Wynik w R
               grupa   n splacone proc dolna gorna
1 brak przypomnienia 438      277 63.2  58.6  67.6
2               list 438      304 69.4  64.9  73.5
3         SMS + list 437      306 70.0  65.6  74.1

	Pearson's Chi-squared test

data:  table(eks$grupa, eks$splata60)
X-squared = 5.6166, df = 2, p-value = 0.06031

                   roznica dolna gorna
list                   6.2  -0.1  12.4
SMS + list             6.8   0.5  13.0
SMS + list vs list     0.6  -5.5   6.7
      list SMS + list
      51.9       48.7
brak przypomnienia               list         SMS + list
               549                741                692
4. Czas do spłaty – Kaplan–Meier: Rysunek 4
R
# Rysunek 4. Czas od wysyłki do spłaty całej zaległości – Kaplan–Meier w trzech grupach eksperymentu
# (wymaga obiektów z przepisu 1: eks, kol_grupa, motyw)
library(survival)
km <- survfit(Surv(dni, splata) ~ grupa, data = eks)
s <- summary(km, times = c(14, 30, 60, 90))
data.frame(grupa = sub("grupa=", "", s$strata), dzien = s$time, splacone_proc = round(100 * (1 - s$surv), 1),
           dolna = round(100 * (1 - s$upper), 1), gorna = round(100 * (1 - s$lower), 1))
km                                                  # mediany czasu do spłaty (dni)
lr <- survdiff(Surv(dni, splata) ~ grupa, data = eks)   # test log-rank
round(c(chi2 = lr$chisq, p = pchisq(lr$chisq, df = 2, lower.tail = FALSE)), 3)
sum(eks$splata == 0 & eks$dni < 90)                  # lokale cenzurowane przed 90. dniem (dzień analizy)

d4 <- data.frame(dzien = km$time, splacone = 100 * (1 - km$surv), dolna = 100 * (1 - km$upper),
                 gorna = 100 * (1 - km$lower), grupa = rep(sub("grupa=", "", names(km$strata)), km$strata))
d4 <- rbind(data.frame(dzien = 0, splacone = 0, dolna = 0, gorna = 0, grupa = levels(eks$grupa)), d4)
d4$grupa <- factor(d4$grupa, levels(eks$grupa))
d4 <- subset(d4, dzien <= 90)
p4 <- ggplot(d4, aes(dzien, splacone, colour = grupa, linetype = grupa)) +
  geom_step(aes(y = dolna), alpha = 0.35, linewidth = 0.4) + geom_step(aes(y = gorna), alpha = 0.35, linewidth = 0.4) +
  geom_step(linewidth = 1.1) + geom_vline(xintercept = 60, colour = "grey50", linetype = "dotted") +
  scale_colour_manual(values = kol_grupa, name = NULL) +
  scale_linetype_manual(values = c("dashed", "dotdash", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 90, 15)) + scale_y_continuous(limits = c(0, 100)) +
  labs(title = "Odsetek lokali, które spłaciły zaległość, w dniach od wysyłki",
       x = "dni od wysyłki przypomnienia (w kontroli – od tej samej daty)", y = "% spłaconych (1 − KM)") + motyw
p4
# ggsave("zaleglosci-kaplan-meier-grupy.svg", p4, width = 10, height = 5.6)
Wynik w R
                grupa dzien splacone_proc dolna gorna
1  brak przypomnienia    14          26.5  22.2  30.5
2  brak przypomnienia    30          46.1  41.2  50.6
3  brak przypomnienia    60          63.5  58.7  67.7
4  brak przypomnienia    90          72.4  67.9  76.3
5                list    14          33.1  28.5  37.4
6                list    30          49.8  44.9  54.2
7                list    60          69.4  64.8  73.4
8                list    90          75.4  71.0  79.1
9          SMS + list    14          37.3  32.6  41.7
10         SMS + list    30          57.2  52.3  61.6
11         SMS + list    60          70.0  65.4  74.0
12         SMS + list    90          73.2  68.7  77.1
Call: survfit(formula = Surv(dni, splata) ~ grupa, data = eks)

                           n events median 0.95LCL 0.95UCL
grupa=brak przypomnienia 438    366   35.5    29.8    43.4
grupa=list               438    367   30.4    25.7    35.9
grupa=SMS + list         437    364   21.6    19.0    26.0
 chi2     p
3.413 0.182
[1] 3
5. Ryzyko i przyrost w grupach lokali: Rysunek 5
R
# Rysunek 5. Karta „ryzyko ≠ przyrost”: trzy grupy lokali, szansa spłaty bez przypomnienia i przyrost
# (wymaga obiektów z przepisów 1–3: eks z kolumną p_hist, newcombe, motyw)
eks$segment <- factor(ifelse(eks$m >= 2, "2+ miesiące zaległości",
                             ifelse(eks$hist12 >= 3, "1 miesiąc, częste zaległości", "1 miesiąc, rzadkie zaległości")),
                      c("1 miesiąc, rzadkie zaległości", "1 miesiąc, częste zaległości", "2+ miesiące zaległości"))
seg <- do.call(rbind, lapply(levels(eks$segment), function(s) {
  d <- eks[eks$segment == s, ]; k <- d$grupa == "brak przypomnienia"; w <- d$grupa == "SMS + list"
  pr <- newcombe(sum(d$splata60[w]), sum(w), sum(d$splata60[k]), sum(k))
  data.frame(segment = s, n = nrow(d), mediana_kwoty = median(d$kwota), szansa_model = 100 * mean(d$p_hist),
             bez_przyp = 100 * mean(d$splata60[k]), sms_list = 100 * mean(d$splata60[w]),
             przyrost = pr[1], dolna = pr[2], gorna = pr[3], row.names = NULL)
}))
seg$kolejnosc_ryzyko <- rank(seg$szansa_model)    # 1 = najmniejsza szansa spłaty (największe ryzyko)
seg$kolejnosc_przyrost <- rank(-seg$przyrost)     # 1 = największy przyrost
seg[, 3:9] <- round(seg[, 3:9], 1); seg
# Czy przyrost różni się między grupami? Test ilorazu wiarygodności dla interakcji (kontrola vs SMS + list)
d2g <- droplevels(subset(eks, grupa != "list"))
anova(glm(splata60 ~ grupa + segment, binomial, d2g), glm(splata60 ~ grupa * segment, binomial, d2g), test = "LRT")

karta <- data.frame(x = 1:3, seg)
p5 <- ggplot(karta) +
  geom_rect(aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 0, ymax = 10), fill = "#f6f4ef", colour = "#dedbd4") +
  geom_rect(aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 8.6, ymax = 10), fill = "#0f1d3a") +
  geom_text(aes(x, 9.3, label = sub(", ", ",\n", segment)), colour = "white", fontface = "bold", size = 4, lineheight = 0.9) +
  geom_text(aes(x, 7.8, label = sprintf("n = %d · mediana %s zł", n, format(round(mediana_kwoty), big.mark = " "))),
            size = 3.6, colour = "grey30") +
  geom_text(aes(x, 6.8, label = "spłaca bez przypomnienia"), size = 3.6, colour = "grey30") +
  geom_text(aes(x, 5.9, label = sprintf("%.1f%%", bez_przyp)), size = 7, fontface = "bold", colour = "#555555") +
  geom_text(aes(x, 4.8, label = "przyrost po SMS + list"), size = 3.6, colour = "grey30") +
  geom_text(aes(x, 3.9, label = sprintf("%+.1f pp", przyrost)), size = 7, fontface = "bold", colour = "#0072B2") +
  geom_text(aes(x, 3.1, label = gsub("-", "\u2212", sprintf("95%% CI [%.1f, %.1f]", dolna, gorna))), size = 3.4, colour = "grey30") +
  geom_text(aes(x, 1.9, label = sprintf("kolejność wg ryzyka: %d.", kolejnosc_ryzyko)), size = 3.9, colour = "#D55E00") +
  geom_text(aes(x, 1.0, label = sprintf("kolejność wg przyrostu: %d.", kolejnosc_przyrost)), size = 3.9,
            colour = "#0072B2", fontface = "bold") +
  scale_x_continuous(limits = c(0.5, 3.5)) + scale_y_continuous(limits = c(0, 10)) +
  labs(title = "Ryzyko ≠ przyrost: komu przypomnienie pomaga najbardziej") + motyw +
  theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p5
# ggsave("zaleglosci-karta-ryzyko-przyrost.svg", p5, width = 10, height = 5.4)
Wynik w R
                        segment   n mediana_kwoty szansa_model bez_przyp
1 1 miesiąc, rzadkie zaległości 702         546.5         76.0      84.3
2  1 miesiąc, częste zaległości 196         585.0         54.6      64.2
3        2+ miesiące zaległości 415        4056.0         18.3      23.3
  sms_list przyrost dolna gorna kolejnosc_ryzyko kolejnosc_przyrost
1     96.5     12.2   7.0  17.6                3                  2
2     86.9     22.7   7.8  36.2                2                  1
3     23.3      0.1 -10.0   9.9                1                  3
Analysis of Deviance Table

Model 1: splata60 ~ grupa + segment
Model 2: splata60 ~ grupa * segment
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       871     731.15
2       869     717.30  2   13.846 0.0009847 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
6. Kolejność wysyłki i skumulowany przyrost: Rysunek 6
R
# Rysunek 6. Komu przypominać najpierw: kolejność wg przewidywanego przyrostu, wg ryzyka i losowa
# (wymaga obiektów z przepisów 1–3: eks z kolumną p_hist, newcombe, motyw)
set.seed(764)
eks$w <- as.integer(eks$grupa == "SMS + list")
d6 <- subset(eks, grupa != "list")                   # model przyrostu: kontrola vs SMS + list
fold <- sample(rep(1:2, length.out = nrow(eks)))     # dwukrotne dopasowanie krzyżowe (cross-fitting)
eks$przyrost_hat <- NA
for (f in 1:2) {
  m6 <- glm(splata60 ~ w * (m_kat + log2(kwota / 1000) + hist12 + typ), binomial, data = d6[fold[eks$grupa != "list"] != f, ])
  nowe <- eks[fold == f, ]
  eks$przyrost_hat[fold == f] <- predict(m6, transform(nowe, w = 1), type = "response") -
    predict(m6, transform(nowe, w = 0), type = "response")
}
round(cor(eks$przyrost_hat, eks$p2_prawda - eks$p0_prawda), 2)   # zgodność z prawdziwym przyrostem
round(cor(eks$p_hist, eks$p2_prawda - eks$p0_prawda), 2)        # ryzyko a prawdziwy przyrost

kolejnosci <- list("wg przewidywanego przyrostu" = order(-eks$przyrost_hat),
                   "wg ryzyka (najmniejsza szansa spłaty)" = order(eks$p_hist),
                   "losowo" = sample(nrow(eks)))
prawdziwy <- eks$p2_prawda - eks$p0_prawda           # znany tylko w symulacji
d6c <- do.call(rbind, lapply(names(kolejnosci), function(k) {
  o <- kolejnosci[[k]]
  data.frame(kolejnosc = k, proc = 100 * seq_along(o) / length(o), dodatkowe = cumsum(prawdziwy[o]),
             dodatkowe_zl = cumsum((prawdziwy * eks$kwota)[o]))
}))
d6c$kolejnosc <- factor(d6c$kolejnosc, names(kolejnosci))
# Ile dodatkowych spłat (lokali) i złotych, gdy przypomnienie dostaje 30% zalegających
budzet <- round(0.3 * nrow(eks))
sapply(kolejnosci, function(o) c(lokale = sum(prawdziwy[o[1:budzet]]), zl = sum((prawdziwy * eks$kwota)[o[1:budzet]]))) |> round()
round(sum(prawdziwy))                                  # przypomnienie dla wszystkich

# Sprawdzenie na danych (bez prawdy): różnica odsetków spłat SMS + list − kontrola w górnych 30% każdej kolejności
sapply(kolejnosci[1:2], function(o) {
  gora <- seq_len(nrow(eks)) %in% o[1:budzet]; d <- eks[gora, ]
  newcombe(sum(d$splata60[d$w == 1]), sum(d$w == 1),
           sum(d$splata60[d$grupa == "brak przypomnienia"]), sum(d$grupa == "brak przypomnienia"))
}) |> round(1)

p6 <- ggplot(d6c, aes(proc, dodatkowe, colour = kolejnosc, linetype = kolejnosc)) +
  geom_line(linewidth = 1.2) + geom_vline(xintercept = 30, colour = "grey50", linetype = "dotted") +
  scale_colour_manual(values = c("#0072B2", "#D55E00", "#999999"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Skumulowany przyrost spłat przy SMS + list",
       x = "% zalegających lokali, które dostają przypomnienie", y = "dodatkowe spłacone lokale") + motyw
p6
# ggsave("zaleglosci-kolejnosc-skumulowany-przyrost.svg", p6, width = 10, height = 5.6)
Wynik w R
[1] 0.66
[1] 0.34
       wg przewidywanego przyrostu wg ryzyka (najmniejsza szansa spłaty) losowo
lokale                          83                                    17     48
zl                           54734                                 33408  36896
[1] 145
        wg przewidywanego przyrostu wg ryzyka (najmniejsza szansa spłaty)
roznica                        16.4                                   3.4
dolna                           6.8                                  -6.7
gorna                          25.7                                  13.2
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("kontrola – list" = c("#555555", "#E69F00"),
             "kontrola – SMS + list" = c("#555555", "#0072B2"),
             "list – SMS + list" = c("#E69F00", "#0072B2"),
             "przyrost – ryzyko" = c("#0072B2", "#D55E00"),
             "ryzyko – losowo" = c("#D55E00", "#999999"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
kontrola – list                             83.9         82.1       76.3
kontrola – SMS + list                       42.6         45.6       40.4
list – SMS + list                          120.2        121.5      109.3
przyrost – ryzyko                          114.6        108.3       91.9
ryzyko – losowo                             77.2         62.9       56.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, macierz przejść, regresja logistyczna (glm()), przedziały Wilsona (prop.test()), test χ² i test ilorazu wiarygodności – bazowy R (pakiety stats i base); błędy standardowe odporne na klastrowanie (vcovCL()) – pakiet sandwich; estymator Kaplana–Meiera (survfit()) i test log-rank (survdiff()) – pakiet survival. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Spłacili po przypomnieniu” to nie efekt przypomnienia. Bez grupy kontrolnej 70% spłat wygląda na sukces; przyrost to 6.8 pp (rysunek 3).
- Kolejność według ryzyka. Najpierw najbardziej zagrożeni – czyli ci, którym przypomnienie nie pomaga: 17 zamiast 83 dodatkowych spłat (rysunek 6).
- Kwota czy liczba lokali. Odsetek lokali bez zaległości i odzyskana kwota prowadzą do różnych decyzji – duże zaległości są tam, gdzie przypomnienie nie działa. Ustal cel przed eksperymentem.
- Jeden horyzont. Po 30 dniach różnica jest wyraźna, po 90 – prawie żadna (rysunek 4). Podaj horyzont w Metodzie.
- Model przeniesiony w nowe warunki. Inna definicja wyniku albo inna populacja psują kalibrację (56.1% przewidywane wobec 63.2% obserwowanych w kontroli).
- Ten sam lokal wiele razy. Licz błędy odporne na klastrowanie albo bierz jeden epizod na lokal.
Najczęstsze pytania
Jak sprawdzić, czy przypomnienie o zaległej opłacie działa?
Wylosuj zalegających do grup z przypomnieniem i bez niego, a potem porównaj odsetki spłat w ustalonym horyzoncie, np. 60 dni. Efektem jest różnica między grupami, nie odsetek spłat po przypomnieniu. W przykładzie spłaciło 70.0% lokali po SMS-ie z listem i 63.2% bez przypomnienia – przyrost 6.8 pp, 95% CI [0.5, 13.0].
Czy przypominać najpierw tym, którzy mają największe zaległości?
Niekoniecznie. Najbardziej zagrożeni często nie reagują na przypomnienie, bo brakuje im pieniędzy, a nie pamięci. W przykładzie lokale z zaległością za 2 i więcej miesięcy miały przyrost +0.1 pp, a lokale z jednym miesiącem i częstymi zaległościami +22.7 pp. Kolejność ustalaj według przewidywanego przyrostu z eksperymentu, nie według ryzyka.
Jak ocenić model przewidujący spłatę zaległości?
Sprawdź go na późniejszych danych niż te, na których powstał: dyskryminację (AUC) i kalibrację – czy przewidywane prawdopodobieństwa zgadzają się z odsetkami spłat. W przykładzie AUC = .835, wyraz wolny kalibracji 0.08, nachylenie 0.99. Po zmianie warunków (inna definicja wyniku) model zaniżył szansę spłaty o 7 pp, więc kalibrację sprawdzaj ponownie.
Dlaczego test log-rank nie pokazał różnicy, skoro przypomnienie przyspieszyło spłatę?
Bo po dłuższym czasie spłaca podobny odsetek lokali w każdej grupie: przypomnienie skraca czas (mediana 21.6 wobec 35.5 dnia), ale po 90 dniach odsetki są zbliżone. Test porównuje całe krzywe, więc wybierz miarę główną przed eksperymentem – odsetek w 30 lub 60 dni albo medianę czasu.
Co to jest macierz przejść w analizie zaległości?
Tabela, która pokazuje, jaka część lokali w danym stanie (w terminie, 1 miesiąc zaległości, 2+ miesiące) jest miesiąc później w każdym ze stanów. W przykładzie z jednego miesiąca zaległości 52.1% wracało do stanu „w terminie”, a z 2+ miesięcy tylko 12.4% miesięcznie. To opis średni – szanse konkretnego lokalu modeluj regresją.
Powiązane hasła
Przeczytaj też
Modelowanie uplift: komu wysłać kupon
Przekonywalni, pewniacy i „nie przeszkadzać”: T-learner, las przyczynowy, krzywa Qini i zysk kampanii na przykładzie sklepu z grami, z kodem R.
Czytaj →PoradnikOpóźnienia płatności faktur w analizie przeżycia
Hurtownia, 20 tys. faktur: cenzurowanie, Kaplan–Meier, Cox z klientem jako klastrem, windykacja jako CIF i prognoza wpływów.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →Piszesz pracę o należnościach albo planujesz eksperyment z przypomnieniami?
Pomożemy zaplanować losowanie, dobrać miarę główną, policzyć przyrost i model spłaty oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ascarza, E. (2018). Retention futility: Targeting high-risk customers might be ineffective. Journal of Marketing Research, 55(1), 80–98. https://doi.org/10.1509/jmr.16.0163 ● Otwarty dostęp: pełny tekst
- Cadena, X., & Schoar, A. (2011). Remembering to pay? Reminders vs. financial incentives for loan payments. National Bureau of Economic Research. https://doi.org/10.3386/w17020 ● Otwarty dostęp
- Devriendt, F., Moldovan, D., & Verbeke, W. (2018). A literature survey and experimental evaluation of the state-of-the-art in uplift modeling: A stepping stone toward the development of prescriptive analytics. Big Data, 6(1), 13–41. https://doi.org/10.1089/big.2017.0104
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Karlan, D., McConnell, M., Mullainathan, S., & Zinman, J. (2016). Getting to the top of mind: How reminders increase saving. Management Science, 62(12), 3393–3411. https://doi.org/10.1287/mnsc.2015.2296 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ascarza2018retention, author={Ascarza, Eva}, title={{Retention futility: Targeting high-risk customers might be ineffective}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={80--98}, doi={10.1509/jmr.16.0163}}@techreport{cadena2011remembering, author={Cadena, Ximena and Schoar, Antoinette}, title={{Remembering to pay? Reminders vs. financial incentives for loan payments}}, year={2011}, eid={17020}, institution={National Bureau of Economic Research}, doi={10.3386/w17020}}@article{devriendt2018literature, author={Devriendt, Floris and Moldovan, Darie and Verbeke, Wouter}, title={{A literature survey and experimental evaluation of the state-of-the-art in uplift modeling: A stepping stone toward the development of prescriptive analytics}}, journal={Big Data}, year={2018}, volume={6}, number={1}, pages={13--41}, doi={10.1089/big.2017.0104}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{karlan2016getting, author={Karlan, Dean and McConnell, Margaret and Mullainathan, Sendhil and Zinman, Jonathan}, title={{Getting to the top of mind: How reminders increase saving}}, journal={Management Science}, year={2016}, volume={62}, number={12}, pages={3393--3411}, doi={10.1287/mnsc.2015.2296}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}