Sześć typowych projektów w pracy ze stomatologii
Prace dyplomowe ze stomatologii i higieny stomatologicznej łączą kilka bardzo różnych rodzajów danych. Ten sam student może policzyć wskaźnik PUWZ u kolegów z roku, zbadać ankietą lęk przed wizytą u dentysty i porównać w laboratorium siłę wiązania dwóch materiałów. Każdy z tych celów wymaga innego modelu. Jest też cecha, która wyróżnia ten kierunek: jeden pacjent ma wiele zębów, a każdy ząb ma kilka powierzchni. Jeżeli analizujesz zęby albo powierzchnie tak, jakby należały do różnych osób, wynik może wyglądać na pewniejszy, niż jest naprawdę. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Wskaźnik PUWZ (DMFT) | Czy nawyki higieniczne i dieta wiążą się z liczbą zębów z próchnicą, usuniętych i wypełnionych? | zliczenia 0, 1, 2…, dużo zer | regresja ujemna dwumianowa, porównanie z modelem z nadmiarem zer | iloraz częstości (IRR) z 95% CI |
| 2. Materiały in vitro | Czy systemy łączące różnią się siłą wiązania? | wynik ciągły (MPa) w 3 grupach próbek | ANOVA Welcha, test Gamesa–Howella | ω² i różnice średnich z 95% CI |
| 3. Kilka zębów u pacjenta | Czy dwa materiały wypełnień różnią się zmianą barwy po roku? | wiele wypełnień u osoby, split-mouth albo grupy równoległe | model mieszany z losowym wyrazem wolnym pacjenta | różnica średnich z 95% CI, ICC, efekt schematu |
| 4. Kalibracja badaczy | Czy dwóch badaczy tak samo ocenia próchnicę i liczy PUWZ? | kody porządkowe 0–6 i zliczenia od dwóch osób | kappa ważona, ICC | κ, κw, ICC z 95% CI |
| 5. Ankieta lęku i wiedzy | Kto bardziej boi się wizyty i czy lęk wiąże się z rzadszymi kontrolami? | suma skali 5–25, test wiedzy, tak/nie | test Welcha, χ², regresja logistyczna, korelacja Spearmana | g Hedgesa, OR, φ, ρ |
| 6. Higiena przed i po | Czy instruktaż zmniejsza odsetek powierzchni z płytką bardziej niż zwykła wizyta? | odsetek 0–100% przed i po w dwóch grupach | ANCOVA z pomiarem wyjściowym | skorygowana różnica z 95% CI, cząstkowe η² |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnej rzeczywistej populacji, materiału ani metody leczenia. Ten wpis dotyczy wyłącznie analizy danych: nie zawiera zaleceń klinicznych i nie rozstrzyga, który materiał lub sposób postępowania jest lepszy. Pełny kod znajdziesz w sekcji Przykład w R. Nie wiesz, który test pasuje do Twojej hipotezy? Pomoże kreator doboru testu, a cały proces od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: pacjent, ząb czy powierzchnia?
Najpierw ustal jednostkę analizy. W badaniu stomatologicznym możesz zbierać dane na trzech poziomach: osoby (np. PUWZ, lęk, nawyki), zęba (np. stan wypełnienia) i powierzchni (np. kod próchnicy na powierzchni żującej). Obserwacje z tej samej jamy ustnej są do siebie podobne, bo łączy je ta sama ślina, dieta, higiena i ten sam operator. Masood i in. (2015) policzyli to na danych z dużego brytyjskiego badania stanu uzębienia dorosłych: efekt schematu dla zębów z próchnicą w obrębie osoby wyniósł 6.0, a dla powierzchni w obrębie osoby aż 38.0. Autorzy podkreślają, że pominięcie tego skupienia prowadzi do przeszacowania wpływu interwencji i znaczenia czynników ryzyka. Pojęcie wyjaśnia hasło efekt schematu, a problem liczenia zależnych obserwacji jako niezależnych – hasło pseudoreplikacja.
Zgody i dane. Badanie z udziałem pacjentów, także ankietowe, zwykle wymaga opinii komisji bioetycznej – sprawdź regulamin swojej uczelni i zasady opisane w haśle zgoda komisji bioetycznej. Jeśli korzystasz z dokumentacji gabinetu, ustal z promotorem i administratorem danych, na jakiej podstawie możesz ją wykorzystać, i pracuj na pliku bez nazwisk i numerów dokumentacji. Wstęp pracy może przywoływać dane o próchnicy w Polsce tylko z cytowanym źródłem i datą odczytu – nie przepisuj liczb z drugiej ręki.
Kalibracja przed badaniem, nie po nim. Jeśli wskaźniki ocenia więcej niż jedna osoba albo ta sama osoba w kilku terminach, zaplanuj sprawdzenie zgodności przed zbieraniem danych właściwych (projekt 4). Niska zgodność wykryta po badaniu oznacza zwykle, że części danych nie da się obronić.
Projekt 1. Wskaźnik PUWZ: zliczenia z nadmiarem zer
PUWZ (w literaturze angielskiej DMFT) to suma zębów z próchnicą (P), usuniętych z powodu próchnicy (U) i wypełnionych (W). Jest to zliczenie: liczba całkowita od zera do liczby zębów. Przy niskim poziomie próchnicy rozkład ma wiele zer i długi prawy ogon. Böhning i in. (1999) pokazali na danych z badania profilaktyki próchnicy, że nadmiar zer narusza zależność między średnią a wariancją zakładaną w modelu Poissona, i zaproponowali do takich danych model Poissona z nadmiarem zer (ZIP). Preisser i in. (2012) w przeglądzie zastosowań do wskaźników próchnicy zauważyli, że modele z nadmiarem zer stają się coraz popularniejsze właśnie dlatego, że coraz więcej dzieci i młodych dorosłych ma wynik zero.
Przykład: 300 studentów w wieku 19–26 lat. Zmienna zależna to PUWZ, a predyktory to szczotkowanie zębów co najmniej dwa razy dziennie (tak/nie), codzienne picie słodzonych napojów (tak/nie) i wiek. Średni PUWZ wynosił 1.29, wariancja 3.70, mediana 0, a 51.7% osób (155 z 300) miało PUWZ = 0. Wariancja niemal trzy razy większa od średniej to sygnał, że model Poissona nie wystarczy. W pracy pokaż tabelę liczebności (ile osób ma 0, 1, 2… zębów), a nie tylko średnią z odchyleniem standardowym.
Poisson, ujemna dwumianowa czy model z nadmiarem zer?
W regresji Poissona współczynnik rozproszenia wyniósł 2.73, a model przewidywał tylko 87.5 osób z PUWZ = 0 wobec 155 obserwowanych. Regresja ujemna dwumianowa (NB) przewidywała 150.4 zera i miała znacznie mniejsze AIC (932.2 wobec 1106.8). Model z nadmiarem zer w wersji ujemnej dwumianowej (ZINB) i model hurdle odtwarzały liczbę zer dokładnie (155.2 i 155.0), ale ich AIC było niższe od modelu NB tylko o 2–3 punkty (930.0 i 929.2). Rysunek 1 pokazuje, że NB i ZINB opisują cały rozkład podobnie, a model Poissona wyraźnie zaniża liczbę zer i zawyża liczbę jedynek.
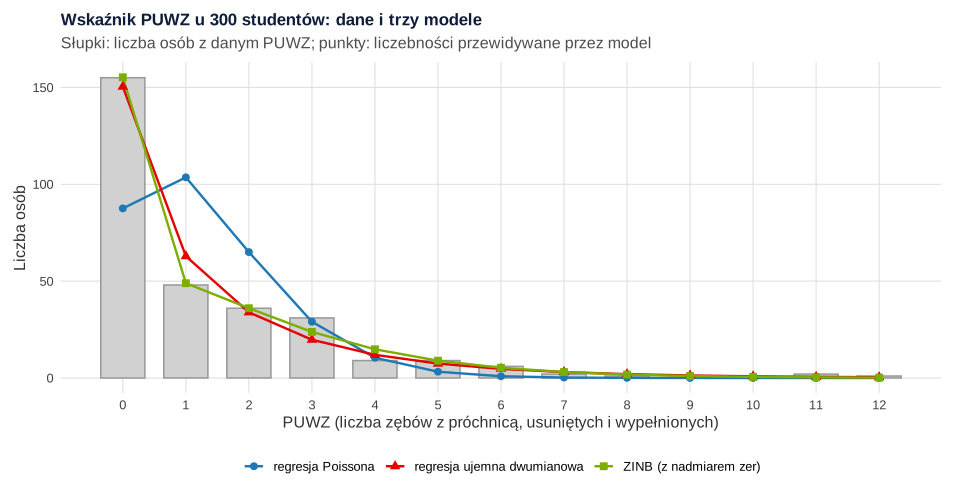
Model z nadmiarem zer ma dwie części: część „zerową” (szansa, że osoba należy do grupy bez doświadczenia próchnicy) i część zliczeniową (ile zębów u osób podatnych). W przykładzie efekt słodzonych napojów rozłożył się na obie części i żadna z nich osobno nie była wyraźna: w części zliczeniowej IRR = 1.20, 95% CI [0.84, 1.72], a w części zerowej OR = 0.63, 95% CI [0.27, 1.43]. Preisser i in. (2012) wskazują, że to częste źródło błędnych interpretacji: współczynniki części zliczeniowej dotyczą tylko ukrytej klasy osób podatnych, a nie całej badanej populacji. Jeśli pytasz o efekt „dla wszystkich”, porównaj średnie przewidywane przez model. Średni PUWZ przewidywany przy codziennym piciu słodzonych napojów wyniósł 1.59, a bez nich 1.14, czyli iloraz 1.40, 95% CI bootstrapowy [0.99, 2.03] – prawie tyle samo co w zwykłym modelu NB.
Interpretacja i raport
Skoro model NB dobrze odtwarza liczbę zer, a prostszy model łatwiej opisać, w pracy licencjackiej czy magisterskiej możesz go uznać za główny, a ZINB pokazać jako analizę wrażliwości. W modelu NB osoby szczotkujące zęby co najmniej dwa razy dziennie miały średnio o 35% niższy PUWZ, IRR = 0.65, 95% CI [0.44, 0.97], p = .034. Związek codziennego picia słodzonych napojów z PUWZ był w tej próbie niepewny, IRR = 1.39, 95% CI [0.96, 2.00], p = .079, a wieku – nieistotny, IRR = 1.02, p = .621. Pamiętaj, że to badanie przekrojowe: szczotkowanie deklarowane dziś nie musi odpowiadać zachowaniom sprzed lat, które złożyły się na obecny wynik. Gdy interesują Cię składowe wskaźnika osobno, np. sam komponent W, pamiętaj, że zależy on także od dostępu do leczenia. Wszystkie kroki – od współczynnika rozproszenia po porównanie modeli ZIP, ZINB i hurdle – opisujemy w poradniku regresja dla zliczeń krok po kroku.
Projekt 2. Porównanie materiałów w badaniu in vitro
Badania laboratoryjne to częsty temat prac w stomatologii zachowawczej i protetyce: porównuje się np. siłę wiązania systemów łączących, twardość, chropowatość albo szczelność brzeżną materiałów. Statystycznie to zwykle porównanie kilku średnich, więc punktem wyjścia jest jednoczynnikowa ANOVA. Kim (2014) w serii notatek statystycznych dla badaczy stomatologicznych przypomina, że przy trzech i więcej grupach nie należy robić serii testów t, bo łączny błąd I rodzaju rośnie z liczbą porównań.
Przykład: 45 próbek, po 15 dla trzech systemów łączących (S1, S2, S3), wynik to wytrzymałość połączenia na ścinanie w MPa. Średnie wynosiły 15.95 (SD = 3.02), 22.73 (SD = 6.96) i 19.47 (SD = 4.91). Odchylenie standardowe w grupie S2 było ponad dwa razy większe niż w S1, dlatego zamiast klasycznej ANOVA wybierz ANOVA Welcha, która nie zakłada równych wariancji. Wynik: F(2, 25.21) = 7.23, p = .003, ω² = .19, 95% CI [.01, .38]. Do porównań parami użyj testu Gamesa–Howella, który również nie zakłada równych wariancji. System S2 dawał wyższe wartości niż S1 o 6.79 MPa, 95% CI [1.81, 11.76], p = .007, a pozostałe różnice były nieistotne (S3 vs S1: 3.53 MPa, p = .066; S3 vs S2: −3.26 MPa, p = .316). Wybór testu post hoc szerzej omawia wpis testy post hoc – który wybrać, a wykonanie w programie z menu – ANOVA w jamovi.
Uwaga na jednostkę analizy także w laboratorium. Jeżeli z jednego zęba wycinasz kilka próbek, próbki z tego samego zęba nie są niezależne. Liczebnością w teście jest wtedy liczba zębów, a nie próbek: uśrednij wyniki w obrębie zęba albo użyj modelu mieszanego z losowym efektem zęba. W metodzie opisz też, skąd pochodziły zęby, jak losowano je do grup i czy osoba wykonująca pomiar wiedziała, który to materiał. Rodzaj zniszczenia połączenia (np. adhezyjne, kohezyjne, mieszane) to zmienna kategorialna – porównaj go między grupami testem χ² albo dokładnym testem Fishera.
Projekt 3. Kilka zębów u jednego pacjenta: split-mouth i model mieszany
To najważniejszy statystycznie projekt w tym wpisie, bo dotyczy problemu specyficznego dla stomatologii. Porównujesz dwa materiały kompozytowe, a wynikiem jest zmiana barwy wypełnienia po 12 miesiącach (ΔE z pomiaru spektrofotometrem; im większa wartość, tym większa zmiana). U jednego pacjenta jest kilka wypełnień. Możliwe są dwa schematy, a błąd analizy działa w nich w przeciwne strony.
Schemat A: split-mouth – zysk z porównania w obrębie pacjenta
W schemacie split-mouth każdy pacjent dostaje oba materiały, np. losowo po różnych stronach łuku. Lesaffre i in. (2009) opisują, że dzięki temu z oszacowania efektu usuwa się dużą część zmienności między pacjentami, ale schemat ma swoje wymagania: efekt jednego leczenia nie może „przenikać” na drugą stronę jamy ustnej, a strony muszą być porównywalne. Pandis i in. (2017) przygotowali rozszerzenie wytycznych CONSORT dla badań z randomizacją wewnątrz osoby – sięgnij po nie, pisząc rozdział o metodzie. Ten sam schemat w kosmetologii nazywa się split-face; szczegółowe omówienie analizy par znajdziesz we wpisie statystyka w pracy z kosmetologii.
Przykład: 30 pacjentów, u każdego 4 wypełnienia – 2 materiałem A i 2 materiałem B (razem 120 wypełnień). Średnia ΔE wynosiła 2.74 (SD = 0.92) dla A i 2.32 (SD = 0.87) dla B, różnica B − A = −0.42. Trzy analizy dały to samo oszacowanie, ale różną precyzję:
- Błędnie – 120 wypełnień jako niezależne obserwacje (test Welcha): SE = 0.164, 95% CI [−0.74, −0.09], p = .012.
- Średnia pacjenta dla każdego materiału i test t dla prób zależnych: SE = 0.109, 95% CI [−0.64, −0.20], t(29) = −3.84, p < .001, dz = −0.70.
- Model mieszany z losowym wyrazem wolnym pacjenta: SE = 0.111, 95% CI [−0.64, −0.20], p < .001.
W schemacie split-mouth zignorowanie pacjenta „zabiera” korzyść z porównania w obrębie osoby: błąd standardowy wyniósł 0.164 zamiast 0.111, a przedział ufności był wyraźnie szerszy. Tu wniosek się nie zmienił, ale przy mniejszym efekcie test na niezależnych wypełnieniach mógłby nie wykryć różnicy, którą wykrywa analiza par.
Schemat B: grupy równoległe – fałszywa pewność
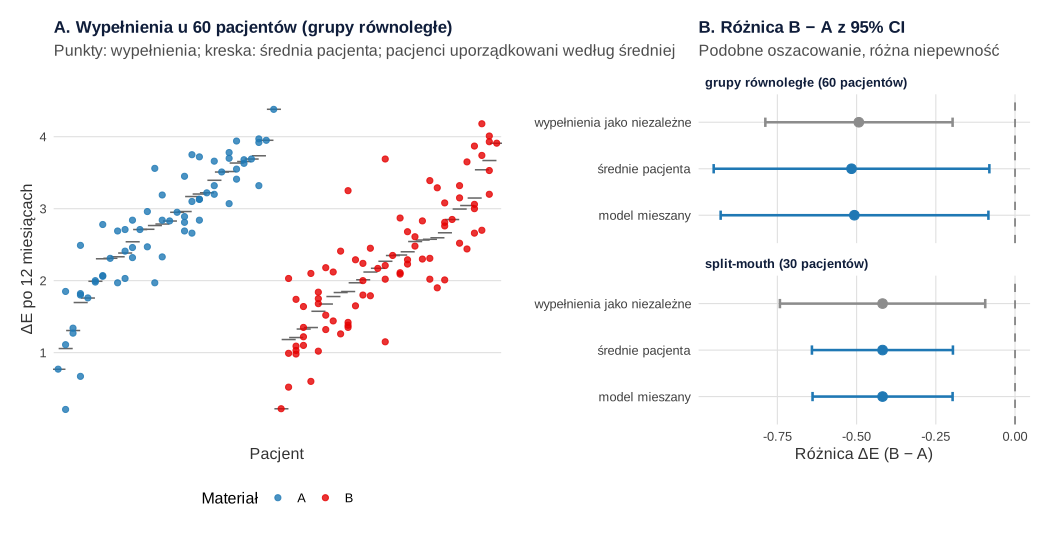
W drugim schemacie 60 pacjentów losowo przydzielono do materiału A albo B, a każdy miał od 1 do 4 wypełnień (razem 144, średnio 2.4 na osobę). Tu porównanie odbywa się między pacjentami, więc 144 wypełnienia nie są 144 niezależnymi informacjami. Korelacja wewnątrzklasowa wypełnień tego samego pacjenta wyniosła .62, a efekt schematu 1 + (2.4 − 1) × .62 = 1.87. Oznacza to, że 144 wypełnienia niosą tyle informacji co około 77 niezależnych obserwacji.
| Metoda analizy | Różnica B − A | SE | 95% CI | df | p |
|---|---|---|---|---|---|
| Wypełnienia jako niezależne (błąd) | −0.49 | 0.150 | [−0.79, −0.20] | 137.6 | .001 |
| Średnia pacjenta, test Welcha | −0.52 | 0.217 | [−0.95, −0.08] | 57.7 | .021 |
| Model mieszany (1 | pacjent) | −0.51 | 0.211 | [−0.93, −0.08] | 55.4 | .020 |
Analiza błędna dała błąd standardowy 0.150 zamiast 0.211 i wartość p = .001 zamiast .020. To nie przypadek tej jednej próby. W 2000 symulowanych powtórzeniach tego schematu bez żadnej różnicy między materiałami test na wypełnieniach dawał p < .05 w 15.5% prób, a test na średnich pacjentów – w 5.1%, czyli zgodnie z założonym poziomem istotności. Rysunek 2 zestawia oba schematy.
Co z tego wynika dla Twojej pracy
Najprostsza poprawna analiza to sprowadzenie danych do poziomu pacjenta: średnia (albo odsetek) dla osoby i zwykły test. Model mieszany jest lepszy, gdy liczba zębów u pacjentów jest różna, gdy chcesz uwzględnić cechy zęba (np. ząb przedni czy trzonowy, rodzaj ubytku) albo gdy wynik jest binarny (np. czy wypełnienie utrzymało się) – wtedy użyj uogólnionego modelu mieszanego albo GEE, opisanych we wpisie GEE czy model mieszany. Przy planowaniu liczebności pomnóż wymaganą liczbę niezależnych obserwacji przez efekt schematu albo licz od razu liczbę pacjentów. Jak opisać model z losowym efektem, pokazuje wpis jak opisać wyniki modelu mieszanego.
Projekt 4. Kalibracja badaczy: kappa i ICC
Wskaźniki stomatologiczne ocenia człowiek, więc ich rzetelność zależy od badacza. Ismail i in. (2007) opisali system ICDAS, w którym stan każdej powierzchni zęba klasyfikuje się na siedmiostopniowej skali porządkowej od powierzchni zdrowej do rozległego ubytku. W ich badaniu zgodność sześciu badaczy wyrażona współczynnikami kappa mieściła się między 0.59 a 0.82. W pracy dyplomowej zgodność sprawdzasz zwykle przed badaniem, na kilkudziesięciu powierzchniach albo pacjentach ocenianych niezależnie przez dwie osoby.
Przykład: dwóch badaczy niezależnie oceniło te same 120 powierzchni w kodach 0–6. Zgodność procentowa wyniosła 73.3%, a kappa Cohena κ = .65. Kappa nieważona traktuje każdą niezgodność jednakowo, tymczasem pomyłka o jeden kod (2 zamiast 3) jest mniej poważna niż pomyłka o pięć. Dlatego dla skali porządkowej podaj kappę ważoną, którą wprowadził Cohen (1968): z wagami liniowymi κw = .86, a z kwadratowymi κw = .96. Zawsze napisz, które wagi wybrałeś, bo – jak widać – wynik bardzo od nich zależy.
Dla zmiennych ilościowych, np. PUWZ policzonego przez dwóch badaczy u 40 osób, użyj współczynnika ICC. Koo i Li (2016) zalecają, aby zawsze podać model, typ i definicję ICC, a interpretować go na podstawie 95% przedziału ufności, a nie samej wartości punktowej. Przy kalibracji, w której liczy się zgodność bezwzględna, wybierz model dwuczynnikowy z zgodnością bezwzględną dla pojedynczego pomiaru, ICC(A,1). W przykładzie ICC(A,1) = .90, 95% CI [.82, .95], a drugi badacz liczył średnio o 0.15 zęba więcej. Według progów Koo i Li przedział obejmuje zgodność od dobrej do doskonałej. Przegląd miar zgodności i ich pułapek znajdziesz we wpisie zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Projekt 5. Ankieta: lęk stomatologiczny i wiedza o profilaktyce
Ankiety wśród studentów, pacjentów lub rodziców to najczęstszy typ pracy z higieny stomatologicznej. Lęk przed leczeniem stomatologicznym mierzy się gotowymi skalami. Przykładem jest Zmodyfikowana Skala Lęku Stomatologicznego (MDAS): Humphris i in. (2009) opisują ją jako krótki kwestionariusz samoopisowy z pięcioma pytaniami, których odpowiedzi sumuje się do wyniku od 5 do 25, i przyjmują wynik 19 jako punkt odcięcia dla wysokiego lęku. Taki próg to narzędzie przesiewowe, a nie rozpoznanie, więc w pracy pisz o „wyniku powyżej progu”, a nie o „pacjentach z fobią”. Przed użyciem skali sprawdź, czy istnieje polska wersja, kto ją udostępnia i na jakich warunkach, i nie przepisuj treści pytań do załącznika bez zgody.
Przykład: 250 studentów (155 kobiet, 95 mężczyzn) wypełniło MDAS, test wiedzy o profilaktyce (12 pytań, liczba poprawnych) i pytanie, czy w ostatnich 12 miesiącach byli na wizycie kontrolnej. Rzetelność MDAS była dobra, α = .84, a średni wynik wyniósł 13.79 (SD = 4.23). Wyniki przeanalizowano trzema prostymi testami:
- Płeć: kobiety miały wyższy wynik niż mężczyźni, 14.34 vs 12.89, test Welcha t(214.4) = 2.71, p = .007, g = 0.35, 95% CI [0.09, 0.60]. Różnica jest więc niewielka, a przedział szeroki.
- Wysoki lęk a kontrole: 37 osób (14.8%, 95% CI [10.9, 19.7]) miało wynik co najmniej 19. Wśród nich na kontroli było 35.1%, a wśród pozostałych 73.7%, χ²(1) = 21.56, p < .001, φ = .29. Szanse odbycia kontroli były u osób z wynikiem powyżej progu ponad pięć razy mniejsze, OR = 0.19, 95% CI [0.09, 0.40].
- Lęk a wiedza: wyższy lęk wiązał się z mniejszą liczbą poprawnych odpowiedzi w teście wiedzy, ρ = −.37, p < .001.
Badanie jest przekrojowe, więc nie wiesz, czy lęk zniechęca do wizyt, czy brak wizyt podtrzymuje lęk. Próba studentów nie jest losowa, więc odsetek 14.8% opisuje badaną grupę, a nie populację. Test wiedzy analizuj też na poziomie pytań (odsetek poprawnych odpowiedzi, trudność i moc różnicująca) – procedurę opisujemy w poradniku ankieta wiedzy – analiza krok po kroku, a rzetelność skali w jamovi we wpisie alfa Cronbacha i omega w jamovi.
Projekt 6. Instruktaż higieny jamy ustnej: pomiar przed i po
Typowa praca z higieny stomatologicznej sprawdza, czy instruktaż albo program edukacyjny poprawia higienę. Wynikiem bywa odsetek powierzchni zębów z płytką nazębną (0–100%) przed instruktażem i kilka tygodni po nim. Najczęstszy błąd to badanie jednej grupy i test t dla prób zależnych: spadek płytki po instruktażu może wynikać z samego faktu badania, z tego, że pacjent wie, że zostanie oceniony, albo z regresji do średniej, gdy do badania wybrano osoby z wysokim wynikiem.
Przykład: 80 osób losowo przydzielono do instruktażu albo zwykłej wizyty, po 40 osób. W grupie kontrolnej odsetek powierzchni z płytką spadł z 57.2% do 50.9%, czyli o 6.4 punktu, 95% CI [3.9, 8.8], t(39) = −5.21, p < .001. Gdyby badanie miało tylko grupę z instruktażem (spadek o 15.9 punktu z 55.7% do 39.9%), cały spadek przypisano by instruktażowi. Właściwe porównanie to ANCOVA: pomiar po instruktażu jako zmienna zależna, grupa jako czynnik i pomiar wyjściowy jako współzmienna. Po uwzględnieniu pomiaru wyjściowego odsetek powierzchni z płytką był w grupie z instruktażem niższy o 9.9 punktu procentowego, 95% CI [6.4, 13.4], t(77) = −5.66, p < .001, cząstkowe η² = .29.
Jeżeli instruktaż prowadzono całymi klasami albo grupami zajęciowymi, wracasz do problemu z projektu 3: jednostką losowania jest klasa, a nie osoba. Taki schemat opisuje wpis o randomizacji klastrowej.
Jak opisać analizę statystyczną w pracy ze stomatologii
W rozdziale o metodach napisz wprost, co było jednostką analizy (pacjent, ząb, powierzchnia, próbka) i jak uwzględniono zależność obserwacji z tej samej jamy ustnej. Dodaj informację o kalibracji badaczy. Poniżej wzór akapitu dla projektów 1, 3 i 4; opis wyników możesz potem sprawdzić w generatorze opisu wyników APA.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie. Do powtórki przed kolokwium przydadzą się zadania ze statystyki medycznej z rozwiązaniami.
Przykład w R: zęby zagnieżdżone w pacjentach i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą projektu 3: ten sam problem pokazany w schemacie split-mouth i w schemacie grup równoległych, porównanie trzech metod analizy, korelacja wewnątrzklasowa, efekt schematu i symulacja fałszywie istotnych wyników. Przepis 2 dotyczy wskaźnika PUWZ, przepis 3 – pozostałych projektów, a przepis 4 – rysunków. Każdy przepis tworzy własne dane symulowane. Modele mieszane liczy pakiet lme4 (stopnie swobody Satterthwaite'a – lmerTest), a modele z nadmiarem zer – pakiet pscl.
1. Projekt 3: wypełnienia zagnieżdżone w pacjentach – split-mouth, grupy równoległe, model mieszany i symulacja
R
# Projekt 3: dwa materiały kompozytowe, kilka wypełnień u tego samego pacjenta (dane symulowane).
# Wynik: zmiana barwy wypełnienia po 12 miesiącach, ΔE (spektrofotometr; im więcej, tym większa zmiana).
# Schemat A (split-mouth): 30 pacjentów, u każdego 4 wypełnienia – 2 materiałem A i 2 materiałem B.
# Schemat B (grupy równoległe): 60 pacjentów losowo przydzielonych do A albo B, 1–4 wypełnienia u osoby.
suppressPackageStartupMessages({ library(lme4); library(lmerTest) })
set.seed(41701)

## Schemat A: split-mouth ----------------------------------------------------------------------
nA <- 30
sm <- data.frame(pacjent = factor(rep(1:nA, each = 4)), material = factor(rep(c("A", "A", "B", "B"), nA)))
uA <- rnorm(nA, 0, 0.55)                                   # różnice między pacjentami (dieta, higiena, nawyki)
sm$dE <- round(2.6 + uA[sm$pacjent] - 0.35 * (sm$material == "B") + rnorm(nrow(sm), 0, 0.60), 2)
aggregate(dE ~ material, sm, function(x) round(c(M = mean(x), SD = sd(x)), 2))

# A1. Błąd: 120 wypełnień jak 120 niezależnych osób (test Welcha)
tA <- t.test(dE ~ material, data = sm)
# A2. Średnia na pacjenta dla każdego materiału i test t dla prób zależnych (n = 30 par)
pm <- aggregate(dE ~ pacjent + material, sm, mean)
roz <- pm$dE[pm$material == "B"] - pm$dE[pm$material == "A"]
tP <- t.test(roz)
# A3. Model mieszany z losowym wyrazem wolnym pacjenta
mA <- lmer(dE ~ material + (1 | pacjent), data = sm)
wiersz <- function(nazwa, est, se, ci, p, df) data.frame(metoda = nazwa, roznica_B_A = round(unname(est), 3), SE = round(unname(se), 3),
  CI_d = round(ci[1], 3), CI_g = round(ci[2], 3), t = round(unname(est / se), 2), df = round(unname(df), 1), p = signif(unname(p), 3), row.names = NULL)
cA <- summary(mA)$coefficients["materialB", ]
ciA <- cA["Estimate"] + c(-1, 1) * qt(.975, cA["df"]) * cA["Std. Error"]
rbind(wiersz("niezależne wypełnienia (Welch)", diff(tA$estimate), tA$stderr, -rev(tA$conf.int), tA$p.value, tA$parameter),
      wiersz("średnie pacjenta, t dla par", tP$estimate, tP$stderr, tP$conf.int, tP$p.value, tP$parameter),
      wiersz("model mieszany (1 | pacjent)", cA["Estimate"], cA["Std. Error"], ciA, cA["Pr(>|t|)"], cA["df"]))
vcA <- as.data.frame(VarCorr(mA))$vcov
round(c(var_pacjent = vcA[1], var_reszta = vcA[2], ICC = vcA[1] / sum(vcA)), 3)
# Wielkość efektu w obrębie pacjenta: d_z dla różnic średnich pacjenta
round(c(d_z = mean(roz) / sd(roz)), 2)

## Schemat B: grupy równoległe, kilka wypełnień u pacjenta ------------------------------------
nB <- 60
m_i <- sample(1:4, nB, replace = TRUE, prob = c(.20, .30, .30, .20))
grupa <- rep(c("A", "B"), each = nB / 2)
rb <- data.frame(pacjent = factor(rep(1:nB, m_i)), material = factor(rep(grupa, m_i)))
uB <- rnorm(nB, 0, 0.55)
rb$dE <- round(2.6 + uB[rb$pacjent] - 0.35 * (rb$material == "B") + rnorm(nrow(rb), 0, 0.60), 2)
c(wypelnienia = nrow(rb), pacjenci = nB, srednio_na_pacjenta = round(mean(m_i), 2))
table(material = rb$material)

# B1. Błąd: wypełnienia jako niezależne obserwacje
tB <- t.test(dE ~ material, data = rb)
# B2. Jedna liczba na pacjenta (średnia jego wypełnień) i test Welcha (n = 60)
pmB <- aggregate(dE ~ pacjent + material, rb, mean)
tB2 <- t.test(dE ~ material, data = pmB)
# B3. Model mieszany
mB <- lmer(dE ~ material + (1 | pacjent), data = rb)
cB <- summary(mB)$coefficients["materialB", ]
ciB <- cB["Estimate"] + c(-1, 1) * qt(.975, cB["df"]) * cB["Std. Error"]
rbind(wiersz("niezależne wypełnienia (Welch)", diff(tB$estimate), tB$stderr, -rev(tB$conf.int), tB$p.value, tB$parameter),
      wiersz("średnie pacjenta (Welch)", diff(tB2$estimate), tB2$stderr, -rev(tB2$conf.int), tB2$p.value, tB2$parameter),
      wiersz("model mieszany (1 | pacjent)", cB["Estimate"], cB["Std. Error"], ciB, cB["Pr(>|t|)"], cB["df"]))
vcB <- as.data.frame(VarCorr(mB))$vcov
iccB <- vcB[1] / sum(vcB)
round(c(ICC = iccB, efekt_schematu = 1 + (mean(m_i) - 1) * iccB,
        efektywna_liczba_obserwacji = nrow(rb) / (1 + (mean(m_i) - 1) * iccB)), 2)

## Symulacja: jak często test na wypełnieniach „wykrywa” różnicę, której nie ma? -----------------
# 2000 powtórzeń schematu B bez różnicy między materiałami; odsetek wyników p < .05
set.seed(41702)
jeden <- function() {
  m <- sample(1:4, nB, replace = TRUE, prob = c(.20, .30, .30, .20))
  d <- data.frame(pacjent = rep(1:nB, m), material = rep(rep(c("A", "B"), each = nB / 2), m))
  d$dE <- 2.6 + rnorm(nB, 0, 0.55)[d$pacjent] + rnorm(nrow(d), 0, 0.60)
  sr <- aggregate(dE ~ pacjent + material, d, mean)
  c(wypelnienia = t.test(dE ~ material, d)$p.value < .05, srednie_pacjenta = t.test(dE ~ material, sr)$p.value < .05)
}
round(100 * rowMeans(replicate(2000, jeden())), 1)
Wynik w R
  material dE.M dE.SD
1        A 2.74  0.92
2        B 2.32  0.87
                          metoda roznica_B_A    SE   CI_d   CI_g     t    df        p
1 niezależne wypełnienia (Welch)      -0.418 0.164 -0.742 -0.094 -2.56 117.5 0.011900
2    średnie pacjenta, t dla par      -0.418 0.109 -0.641 -0.196 -3.84  29.0 0.000613
3   model mieszany (1 | pacjent)      -0.418 0.111 -0.639 -0.197 -3.76  89.0 0.000307
var_pacjent  var_reszta         ICC
      0.439       0.372       0.541
 d_z
-0.7
        wypelnienia            pacjenci srednio_na_pacjenta
              144.0                60.0                 2.4
material
 A  B
65 79
                          metoda roznica_B_A    SE   CI_d   CI_g     t    df       p
1 niezależne wypełnienia (Welch)      -0.493 0.150 -0.788 -0.197 -3.30 137.6 0.00125
2       średnie pacjenta (Welch)      -0.516 0.217 -0.951 -0.081 -2.38  57.7 0.02090
3   model mieszany (1 | pacjent)      -0.507 0.211 -0.929 -0.084 -2.40  55.4 0.01960
                        ICC              efekt_schematu efektywna_liczba_obserwacji
                       0.62                        1.87                       77.04
     wypelnienia srednie_pacjenta
            15.5              5.1
2. Projekt 1: PUWZ – Poisson, regresja ujemna dwumianowa, ZINB i hurdle
R
# Projekt 1: wskaźnik PUWZ (DMFT) u studentów – zliczenia z nadmiarem zer (dane symulowane).
# 300 osób w wieku 19–26 lat; PUWZ = liczba zębów z próchnicą (P) + usuniętych z powodu próchnicy (U)
# + wypełnionych (W). Predyktory: szczotkowanie co najmniej 2 razy dziennie (tak/nie),
# codzienne słodzone napoje (tak/nie), wiek (lata).
suppressPackageStartupMessages({ library(MASS); library(pscl) })
set.seed(41703)
n <- 300
wiek <- sample(19:26, n, replace = TRUE)
szczot <- factor(rbinom(n, 1, .70), 0:1, c("nie", "tak"))
napoje <- factor(rbinom(n, 1, .35), 0:1, c("nie", "tak"))
# część osób nie ma żadnego doświadczenia próchnicy („zera strukturalne”), u pozostałych liczba ma rozkład NB
p_zero <- plogis(-1.0 + 0.9 * (szczot == "tak") - 0.8 * (napoje == "tak"))
mu <- exp(0.85 + 0.06 * (wiek - 22) - 0.35 * (szczot == "tak") + 0.45 * (napoje == "tak"))
puwz <- ifelse(rbinom(n, 1, p_zero) == 1, 0, rnbinom(n, mu = mu, size = 2.5))
puwz <- pmin(puwz, 28)
p1 <- data.frame(wiek, szczot, napoje, puwz)

# Krok 1. Opis rozkładu
round(c(M = mean(p1$puwz), Wariancja = var(p1$puwz), Me = median(p1$puwz),
        Zera_proc = 100 * mean(p1$puwz == 0), Max = max(p1$puwz)), 2)
table(p1$puwz)

# Krok 2. Poisson i współczynnik rozproszenia
m_p <- glm(puwz ~ szczot + napoje + wiek, family = poisson, data = p1)
round(sum(residuals(m_p, type = "pearson")^2) / df.residual(m_p), 2)

# Krok 3. Ujemna dwumianowa, ZINB i hurdle NB
m_nb <- glm.nb(puwz ~ szczot + napoje + wiek, data = p1)
m_zinb <- zeroinfl(puwz ~ szczot + napoje + wiek | szczot + napoje, dist = "negbin", data = p1)
m_hnb <- hurdle(puwz ~ szczot + napoje + wiek | szczot + napoje, dist = "negbin", data = p1)
round(c(AIC_Poisson = AIC(m_p), AIC_NB = AIC(m_nb), AIC_ZINB = AIC(m_zinb), AIC_hurdle = AIC(m_hnb)), 1)

# Krok 4. Ile zer przewiduje każdy model?
round(c(obserwowane = sum(p1$puwz == 0), Poisson = sum(dpois(0, fitted(m_p))),
        NB = sum(dnbinom(0, mu = fitted(m_nb), size = m_nb$theta)),
        ZINB = sum(predict(m_zinb, type = "prob")[, 1]), hurdle = sum(predict(m_hnb, type = "prob")[, 1])), 1)

# Krok 5. IRR z 95% CI w modelu ujemnym dwumianowym
b <- coef(m_nb); se <- sqrt(diag(vcov(m_nb)))
round(cbind(IRR = exp(b), CI_d = exp(b - 1.96 * se), CI_g = exp(b + 1.96 * se), z = b / se), 3)[-1, ]
signif(2 * pnorm(-abs(b / se))[-1], 3)

# Krok 6. ZINB: dwie części modelu i efekt „dla wszystkich” (średnia przewidywana tak vs nie)
round(exp(cbind(OR_lub_IRR = coef(m_zinb), confint(m_zinb))), 3)
sr_napoje <- sapply(c("nie", "tak"), function(v) mean(predict(m_zinb, transform(p1, napoje = factor(v, levels = c("nie", "tak"))), type = "response")))
round(c(srednia_nie = sr_napoje[[1]], srednia_tak = sr_napoje[[2]], iloraz_srednich = sr_napoje[[2]] / sr_napoje[[1]]), 4)
# Przedział ufności dla ilorazu średnich z ZINB: bootstrap nieparametryczny (500 prób)
set.seed(41704)
iloraz <- function(d) { m <- zeroinfl(puwz ~ szczot + napoje + wiek | szczot + napoje, dist = "negbin", data = d)
  s <- sapply(c("nie", "tak"), function(v) mean(predict(m, transform(d, napoje = factor(v, levels = c("nie", "tak"))), type = "response")))
  s[[2]] / s[[1]] }
boot_il <- replicate(500, iloraz(p1[sample(n, replace = TRUE), ]))
round(quantile(boot_il, c(.025, .975)), 3)
Wynik w R
        M Wariancja        Me Zera_proc       Max
     1.29      3.70      0.00     51.67     12.00

  0   1   2   3   4   5   6   7   8  11  12
155  48  36  31   9   9   6   2   1   2   1
[1] 2.73
AIC_Poisson      AIC_NB    AIC_ZINB  AIC_hurdle
     1106.8       932.2       930.0       929.2
obserwowane     Poisson          NB        ZINB      hurdle
      155.0        87.5       150.4       155.2       155.0
            IRR  CI_d  CI_g      z
szczottak 0.654 0.443 0.967 -2.126
napojetak 1.387 0.963 1.998  1.758
wiek      1.020 0.943 1.103  0.495
szczottak napojetak      wiek
   0.0335    0.0787    0.6210
                  OR_lub_IRR 2.5 % 97.5 %
count_(Intercept)      0.841 0.142  4.985
count_szczottak        0.842 0.572  1.239
count_napojetak        1.202 0.842  1.715
count_wiek             1.041 0.966  1.121
zero_(Intercept)       0.351 0.116  1.056
zero_szczottak         2.138 0.792  5.773
zero_napojetak         0.625 0.274  1.425
    srednia_nie     srednia_tak iloraz_srednich
         1.1379          1.5879          1.3954
 2.5% 97.5%
0.992 2.030
3. Projekty 2, 4, 5 i 6: materiały, zgodność badaczy, ankieta i higiena przed i po
R
# Projekty 2, 4, 5 i 6: materiały in vitro, zgodność badaczy, ankieta lęku i wiedzy, higiena przed i po (dane symulowane).
suppressPackageStartupMessages({ library(effectsize); library(irr) })

## Projekt 2. Siła wiązania trzech systemów łączących (in vitro) -----------------------------------
# 45 próbek, każda z innego zęba (15 na system); wytrzymałość na ścinanie w MPa.
set.seed(41705)
sbs <- data.frame(system = factor(rep(c("S1", "S2", "S3"), each = 15)))
sbs$MPa <- round(rnorm(45, c(17, 23, 21)[as.integer(sbs$system)], c(3.5, 5.5, 4.5)[as.integer(sbs$system)]), 1)
aggregate(MPa ~ system, sbs, function(x) round(c(M = mean(x), SD = sd(x)), 2))
tapply(sbs$MPa, sbs$system, function(x) round(shapiro.test(x)$p.value, 3))
oneway.test(MPa ~ system, data = sbs)                       # ANOVA Welcha
a2 <- aov(MPa ~ system, data = sbs); summary(a2)
omega_squared(a2, partial = FALSE, alternative = "two.sided")
gh <- suppressMessages(as.data.frame(rstatix::games_howell_test(sbs, MPa ~ system)))
cbind(gh[, c("group1", "group2")], round(gh[, c("estimate", "conf.low", "conf.high")], 2), p.adj = round(gh$p.adj, 3))

## Projekt 4. Kalibracja badaczy: ICDAS (kody 0–6) i PUWZ ---------------------------------------
# Dwóch badaczy ocenia niezależnie te same 120 powierzchni zębów (kod 0–6) i liczy PUWZ u 40 osób.
set.seed(41706)
prawda <- sample(0:6, 120, replace = TRUE, prob = c(.40, .15, .15, .10, .08, .07, .05))
ocena <- function(x) pmin(6, pmax(0, x + sample(c(-1, 0, 1), length(x), replace = TRUE, prob = c(.12, .76, .12))))
icdas <- data.frame(badacz1 = ocena(prawda), badacz2 = ocena(prawda))
round(100 * mean(icdas$badacz1 == icdas$badacz2), 1)          # zgodność procentowa
k0 <- kappa2(icdas, weight = "unweighted"); kl <- kappa2(icdas, weight = "equal"); kq <- kappa2(icdas, weight = "squared")
round(c(kappa = k0$value, kappa_liniowa = kl$value, kappa_kwadratowa = kq$value), 3)
puwz_prawda <- rnbinom(40, mu = 3, size = 2)
puwz2 <- data.frame(b1 = pmax(0, puwz_prawda + sample(-1:1, 40, TRUE, c(.15, .70, .15))),
                    b2 = pmax(0, puwz_prawda + sample(-1:1, 40, TRUE, c(.10, .65, .25))))
ic <- icc(puwz2, model = "twoway", type = "agreement", unit = "single")
round(c(ICC_A1 = ic$value, CI_d = ic$lbound, CI_g = ic$ubound), 3)
round(c(srednia_roznica_b2_b1 = mean(puwz2$b2 - puwz2$b1)), 2)

## Projekt 5. Ankieta: lęk stomatologiczny (MDAS) i wiedza o profilaktyce ------------------------
# 250 studentów; MDAS: 5 pytań 1–5, suma 5–25 (Humphris i in., 2009); wynik ≥ 19 – przesiewowo wysoki lęk.
# Wiedza: test 12 pytań (liczba poprawnych); kontrola stomatologiczna w ostatnich 12 miesiącach (tak/nie).
set.seed(41707)
n5 <- 250
plec <- factor(sample(c("kobieta", "mężczyzna"), n5, TRUE, prob = c(.62, .38)))
lek <- rnorm(n5, 0.30 * (plec == "kobieta"), 1)
mdas_poz <- sapply(1:5, function(j) pmin(5, pmax(1, round(2.6 + 0.85 * lek + rnorm(n5, 0, .75)))))
colnames(mdas_poz) <- paste0("mdas", 1:5)
ank <- data.frame(plec, mdas_poz)
ank$MDAS <- rowSums(mdas_poz)
ank$wiedza <- rbinom(n5, 12, plogis(0.6 - 0.25 * lek))
ank$kontrola <- factor(rbinom(n5, 1, plogis(0.9 - 0.7 * lek)), 0:1, c("nie", "tak"))
round(psych::alpha(mdas_poz)$total$raw_alpha, 2)
round(c(M = mean(ank$MDAS), SD = sd(ank$MDAS), Me = median(ank$MDAS)), 2)
aggregate(MDAS ~ plec, ank, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
t.test(MDAS ~ plec, data = ank)
print(hedges_g(MDAS ~ plec, data = ank, pooled_sd = FALSE)); cat("\n")
ank$wysoki <- factor(ank$MDAS >= 19, c(FALSE, TRUE), c("< 19", "≥ 19"))
x5 <- sum(ank$wysoki == "≥ 19"); ci5 <- prop.test(x5, n5, correct = FALSE)$conf.int
round(c(n_wysoki = x5, proc = 100 * x5 / n5, CI_d = 100 * ci5[1], CI_g = 100 * ci5[2]), 1)
tab5 <- table(ank$wysoki, ank$kontrola); tab5
round(100 * prop.table(tab5, 1), 1)                          # odsetki w wierszach
ch5 <- chisq.test(tab5, correct = FALSE); ch5
round(c(phi = sqrt(unname(ch5$statistic) / n5), min_oczekiwana = min(ch5$expected)), 2)
m5 <- glm(kontrola ~ wysoki, family = binomial, data = ank)
round(exp(cbind(OR = coef(m5), suppressMessages(confint(m5))))[2, ], 2)
cor.test(ank$MDAS, ank$wiedza, method = "spearman", exact = FALSE)

## Projekt 6. Instruktaż higieny jamy ustnej: przed i po, z grupą kontrolną -----------------------
# 80 osób losowo przydzielonych: instruktaż (n = 40) albo zwykła wizyta (n = 40).
# Wynik: odsetek powierzchni zębów z płytką (0–100%) przed i 4 tygodnie po.
set.seed(41708)
hig <- data.frame(grupa = factor(rep(c("kontrola", "instruktaż"), each = 40), levels = c("kontrola", "instruktaż")))
hig$przed <- round(pmin(100, pmax(5, rnorm(80, 55, 15))))
hig$po <- round(pmin(100, pmax(0, 12 + 0.70 * hig$przed - 12 * (hig$grupa == "instruktaż") + rnorm(80, 0, 9))))
aggregate(cbind(przed, po) ~ grupa, hig, function(x) round(c(M = mean(x), SD = sd(x)), 1))
# Zmiana w każdej grupie osobno (test t dla prób zależnych)
sapply(split(hig, hig$grupa), function(d) { t <- t.test(d$po, d$przed, paired = TRUE)
  round(c(zmiana = unname(t$estimate), CI_d = t$conf.int[1], CI_g = t$conf.int[2], t = unname(t$statistic), p = t$p.value), 4) })
# ANCOVA: pomiar po skorygowany o pomiar przed
m6 <- lm(po ~ przed + grupa, data = hig)
round(cbind(b = coef(m6), confint(m6), t = summary(m6)$coefficients[, 3]), 3)
signif(summary(m6)$coefficients["grupainstruktaż", 4], 3); df.residual(m6)
eta_squared(m6, partial = TRUE, alternative = "two.sided")   # grupa wpisana po pomiarze przed
Wynik w R
  system MPa.M MPa.SD
1     S1 15.95   3.02
2     S2 22.73   6.96
3     S3 19.47   4.91
   S1    S2    S3
0.987 0.577 0.627

	One-way analysis of means (not assuming equal variances)

data:  MPa and system
F = 7.2337, num df = 2.000, denom df = 25.213, p-value = 0.00329

            Df Sum Sq Mean Sq F value Pr(>F)
system       2  345.6  172.81    6.35 0.0039 **
Residuals   42 1143.1   27.22
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter | Omega2 |       95% CI
---------------------------------
system    |   0.19 | [0.01, 0.38]
  group1 group2 estimate conf.low conf.high p.adj
1     S1     S2     6.79     1.81     11.76 0.007
2     S1     S3     3.53    -0.20      7.25 0.066
3     S2     S3    -3.26    -8.74      2.22 0.316
[1] 73.3
           kappa    kappa_liniowa kappa_kwadratowa
           0.651            0.862            0.957
ICC_A1   CI_d   CI_g
 0.902  0.823  0.947
srednia_roznica_b2_b1
                 0.15
[1] 0.84
    M    SD    Me
13.79  4.23 13.50
       plec MDAS.M MDAS.SD MDAS.n
1   kobieta  14.34    4.33 155.00
2 mężczyzna  12.89    3.91  95.00

	Welch Two Sample t-test

data:  MDAS by plec
t = 2.7124, df = 214.4, p-value = 0.007223
alternative hypothesis: true difference in means between group kobieta and group mężczyzna is not equal to 0
95 percent confidence interval:
 0.3937504 2.4877436
sample estimates:
  mean in group kobieta mean in group mężczyzna
               14.33548                12.89474

Hedges' g |       95% CI
------------------------
0.35      | [0.09, 0.60]

- Estimated using un-pooled SD.
n_wysoki     proc     CI_d     CI_g
    37.0     14.8     10.9     19.7

       nie tak
  < 19  56 157
  ≥ 19  24  13

        nie  tak
  < 19 26.3 73.7
  ≥ 19 64.9 35.1

	Pearson's Chi-squared test

data:  tab5
X-squared = 21.556, df = 1, p-value = 3.437e-06

           phi min_oczekiwana
          0.29          11.84
    OR  2.5 % 97.5 %
  0.19   0.09   0.40

	Spearman's rank correlation rho

data:  ank$MDAS and ank$wiedza
S = 3563819, p-value = 1.848e-09
alternative hypothesis: true rho is not equal to 0
sample estimates:
       rho
-0.3685284

       grupa przed.M przed.SD po.M po.SD
1   kontrola    57.2     14.5 50.9  13.0
2 instruktaż    55.7     15.6 39.9  14.1
       kontrola instruktaż
zmiana  -6.3500   -15.8500
CI_d    -8.8173   -18.9129
CI_g    -3.8827   -12.7871
t       -5.2058   -10.4671
p        0.0000     0.0000
                     b   2.5 % 97.5 %      t
(Intercept)      8.607   1.461 15.753  2.398
przed            0.739   0.622  0.856 12.551
grupainstruktaż -9.905 -13.387 -6.423 -5.664
[1] 2.44e-07
[1] 77
# Effect Size for ANOVA (Type I)

Parameter | Eta2 (partial) |       95% CI
-----------------------------------------
przed     |           0.68 | [0.57, 0.76]
grupa     |           0.29 | [0.14, 0.44]
4. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b417-rysunki.R > b417-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", trzeci = "#7CAE00", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output(suppressMessages({ for (f in c("b417-1-zeby-zagniezdzone.R", "b417-2-puwz-zliczenia.R")) source(f) })))

# Rysunek 1. Wypełnienia zagnieżdżone w pacjentach (schemat B) i różnica B − A według metody analizy
sr <- aggregate(dE ~ pacjent, rb, mean)
rb$kolejnosc <- factor(rb$pacjent, levels = sr$pacjent[order(rb$material[match(sr$pacjent, rb$pacjent)], sr$dE)])
rA <- ggplot(rb, aes(kolejnosc, dE, colour = material)) +
  stat_summary(aes(group = pacjent), fun = mean, geom = "point", shape = 95, size = 6, colour = "grey40") +
  geom_point(size = 1.8, alpha = .8) +
  scale_colour_manual(values = c(A = KOLORY[["drugi"]], B = KOLORY[["akcent"]]), name = "Materiał") +
  labs(title = "A. Wypełnienia u 60 pacjentów (grupy równoległe)",
       subtitle = "Punkty: wypełnienia; kreska: średnia pacjenta; pacjenci uporządkowani według średniej",
       x = "Pacjent", y = "ΔE po 12 miesiącach") +
  theme_metodolog(12) + theme(axis.text.x = element_blank(), panel.grid.major.x = element_blank())
wyn <- rbind(cbind(schemat = "split-mouth (30 pacjentów)",
                   rbind(wiersz("wypełnienia jako niezależne", diff(tA$estimate), tA$stderr, -rev(tA$conf.int), tA$p.value, tA$parameter),
                         wiersz("średnie pacjenta", tP$estimate, tP$stderr, tP$conf.int, tP$p.value, tP$parameter),
                         wiersz("model mieszany", cA["Estimate"], cA["Std. Error"], ciA, cA["Pr(>|t|)"], cA["df"]))),
             cbind(schemat = "grupy równoległe (60 pacjentów)",
                   rbind(wiersz("wypełnienia jako niezależne", diff(tB$estimate), tB$stderr, -rev(tB$conf.int), tB$p.value, tB$parameter),
                         wiersz("średnie pacjenta", diff(tB2$estimate), tB2$stderr, -rev(tB2$conf.int), tB2$p.value, tB2$parameter),
                         wiersz("model mieszany", cB["Estimate"], cB["Std. Error"], ciB, cB["Pr(>|t|)"], cB["df"]))))
wyn$metoda <- factor(wyn$metoda, levels = rev(c("wypełnienia jako niezależne", "średnie pacjenta", "model mieszany")))
print(wyn[, c("schemat", "metoda", "roznica_B_A", "SE", "CI_d", "CI_g")], row.names = FALSE)
rB <- ggplot(wyn, aes(roznica_B_A, metoda, colour = metoda == "wypełnienia jako niezależne")) +
  geom_vline(xintercept = 0, linetype = 2, colour = "grey45") +
  geom_errorbar(aes(xmin = CI_d, xmax = CI_g), width = .2, orientation = "y", linewidth = .9) + geom_point(size = 3) +
  facet_wrap(~ schemat, ncol = 1) +
  scale_colour_manual(values = c(`TRUE` = "grey55", `FALSE` = KOLORY[["drugi"]]), guide = "none") +
  labs(title = "B. Różnica B − A z 95% CI", subtitle = "Podobne oszacowanie, różna niepewność", x = "Różnica ΔE (B − A)", y = NULL) +
  theme_metodolog(12) + theme(strip.text = element_text(face = "bold", colour = KOLORY[["granat"]], hjust = 0))
zapisz_svg(rA + rB + plot_layout(widths = c(1.35, 1)), "../statystyka-stomatologia-zeby-zagniezdzone.svg", szer = 11, wys = 5.6)

# Rysunek 2. PUWZ: rozkład obserwowany i liczebności przewidywane przez trzy modele
kk <- 0:12
d2 <- data.frame(k = kk, obserwowane = sapply(kk, function(i) sum(p1$puwz == i)),
                 Poisson = sapply(kk, function(i) sum(dpois(i, fitted(m_p)))),
                 NB = sapply(kk, function(i) sum(dnbinom(i, mu = fitted(m_nb), size = m_nb$theta))),
                 ZINB = colSums(predict(m_zinb, type = "prob", at = kk)))
print(round(d2, 1), row.names = FALSE)
dl <- rbind(data.frame(k = kk, model = "regresja Poissona", ocz = d2$Poisson),
            data.frame(k = kk, model = "regresja ujemna dwumianowa", ocz = d2$NB),
            data.frame(k = kk, model = "ZINB (z nadmiarem zer)", ocz = d2$ZINB))
r2 <- ggplot(d2, aes(k, obserwowane)) + geom_col(fill = "grey82", colour = "grey60", width = .7) +
  geom_line(data = dl, aes(k, ocz, colour = model), linewidth = .85) + geom_point(data = dl, aes(k, ocz, colour = model, shape = model), size = 2.4) +
  scale_colour_manual(values = c("regresja Poissona" = KOLORY[["drugi"]], "regresja ujemna dwumianowa" = KOLORY[["akcent"]],
                                 "ZINB (z nadmiarem zer)" = KOLORY[["trzeci"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) + scale_x_continuous(breaks = kk) +
  labs(title = "Wskaźnik PUWZ u 300 studentów: dane i trzy modele",
       subtitle = "Słupki: liczba osób z danym PUWZ; punkty: liczebności przewidywane przez model",
       x = "PUWZ (liczba zębów z próchnicą, usuniętych i wypełnionych)", y = "Liczba osób") + theme_metodolog(12)
zapisz_svg(r2, "../statystyka-stomatologia-puwz-modele.svg", szer = 10, wys = 5.2)
Wynik w R
                         schemat                      metoda roznica_B_A    SE   CI_d   CI_g
      split-mouth (30 pacjentów) wypełnienia jako niezależne      -0.418 0.164 -0.742 -0.094
      split-mouth (30 pacjentów)            średnie pacjenta      -0.418 0.109 -0.641 -0.196
      split-mouth (30 pacjentów)              model mieszany      -0.418 0.111 -0.639 -0.197
 grupy równoległe (60 pacjentów) wypełnienia jako niezależne      -0.493 0.150 -0.788 -0.197
 grupy równoległe (60 pacjentów)            średnie pacjenta      -0.516 0.217 -0.951 -0.081
 grupy równoległe (60 pacjentów)              model mieszany      -0.507 0.211 -0.929 -0.084
Zapisano ../statystyka-stomatologia-zeby-zagniezdzone.svg: w HTML width="1100" height="560" (44 KB)
  k obserwowane Poisson    NB  ZINB
  0         155    87.5 150.4 155.2
  1          48   103.6  62.9  48.9
  2          36    65.0  33.9  36.0
  3          31    29.0  19.7  23.8
  4           9    10.4  11.9  14.8
  5           9     3.2   7.4   8.9
  6           6     0.9   4.7   5.2
  7           2     0.2   3.0   3.0
  8           1     0.1   2.0   1.7
  9           0     0.0   1.3   1.0
 10           0     0.0   0.9   0.6
 11           2     0.0   0.6   0.3
 12           1     0.0   0.4   0.2
Zapisano ../statystyka-stomatologia-puwz-modele.svg: w HTML width="1000" height="520" (16 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), lm(), aov(), oneway.test(), t.test(), chisq.test(), prop.test() i cor.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- pscl (wersja 1.5.9): Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2023). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac ze stomatologii
- Zęby albo powierzchnie liczone jak niezależne osoby. W schemacie grup równoległych daje to zbyt małe wartości p – w symulacji 15.5% fałszywych wyników istotnych zamiast 5% – a w split-mouth marnuje korzyść z porównania w obrębie pacjenta.
- Brak informacji o jednostce analizy w rozdziale o metodzie i w tabelach („n = 144” bez dopisku, że to wypełnienia u 60 pacjentów).
- PUWZ analizowany testem t albo regresją liniową, bez opisu rozkładu, odsetka zer i nadmiernego rozproszenia.
- Model z nadmiarem zer wybrany automatycznie i współczynniki jego części zliczeniowej opisane jako efekt dla całej próby.
- Seria testów t zamiast ANOVA przy porównaniu trzech i więcej materiałów oraz klasyczna ANOVA mimo wyraźnie nierównych wariancji.
- Kilka próbek z jednego zęba liczonych jako niezależne w badaniu in vitro.
- Kappa nieważona dla skali porządkowej albo kappa ważona bez informacji o wagach; ICC bez podania modelu i typu.
- Próg skali lęku opisany jak diagnoza i odsetki z próby wygodnej uogólniane na populację.
- Badanie przed–po bez grupy kontrolnej, w którym cały spadek płytki przypisuje się instruktażowi.
- Wnioski kliniczne z pracy statystycznej, np. zalecanie materiału na podstawie jednej małej próby.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej ze stomatologii?
Zależy to od typu wyniku i od tego, co jest jednostką analizy. Wskaźnik PUWZ analizuj regresją ujemną dwumianową, wynik ciągły w kilku grupach materiałów – ANOVA Welcha z testem Gamesa–Howella, kilka zębów u tego samego pacjenta – modelem mieszanym, a odsetki – testem chi-kwadrat z przedziałami ufności. Przy każdej analizie podaj wielkość efektu: IRR, ω², różnicę średnich, OR albo g Hedgesa z 95% CI.
Czy zęby jednego pacjenta można traktować jako niezależne obserwacje?
Nie. Zęby i powierzchnie z tej samej jamy ustnej są do siebie podobne, więc test, który traktuje je jak różne osoby, w schemacie grup równoległych daje zbyt małe wartości p. Policz średnią lub odsetek dla pacjenta albo użyj modelu mieszanego z losowym efektem pacjenta. W schemacie split-mouth analizuj różnice w obrębie pacjenta.
Jak analizować wskaźnik PUWZ, gdy wielu badanych ma wynik zero?
Opisz rozkład (średnią, wariancję, odsetek zer i tabelę liczebności), dopasuj regresję Poissona, sprawdź nadmierne rozproszenie i porównaj przewidywaną liczbę zer z obserwowaną. Zwykle lepsza jest regresja ujemna dwumianowa. Model z nadmiarem zer wybierz wtedy, gdy wyraźnie lepiej odtwarza zera, i pamiętaj, że jego części nie opisują efektu dla całej próby.
Jak sprawdzić zgodność dwóch badaczy oceniających próchnicę?
Przed badaniem właściwym niech obaj badacze niezależnie ocenią te same powierzchnie albo tych samych pacjentów. Dla kodów porządkowych, np. ICDAS, podaj kappę ważoną i napisz, jakie wagi zastosowałeś, a dla wyników liczbowych, np. PUWZ, ICC z podanym modelem i typem oraz 95% przedziałem ufności.
Czy wynik skali lęku stomatologicznego powyżej progu oznacza fobię?
Nie. Punkt odcięcia w kwestionariuszu takim jak MDAS służy do badań przesiewowych i opisu grupy, a nie do rozpoznania. W pracy pisz o odsetku osób z wynikiem powyżej progu, podaj źródło progu i przedział ufności dla odsetka oraz nie uogólniaj wyniku próby wygodnej na całą populację.
Powiązane hasła
Przeczytaj też
Jak napisać pracę z medycyny i stomatologii
Materiał i metody, definicje rozpoznań i wyników, diagram włączenia, STROBE, Tabela 1, czas obserwacji, kalibracja badaczy oraz ząb a pacjent – na dwóch fikcyjnych przykładach klinicznych.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę ze stomatologii i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – wskaźnika PUWZ, badań materiałów, kilku zębów u pacjenta albo ankiety – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Böhning, D., Dietz, E., Schlattmann, P., Mendonça, L., & Kirchner, U. (1999). The zero-inflated Poisson model and the decayed, missing and filled teeth index in dental epidemiology. Journal of the Royal Statistical Society: Series A (Statistics in Society), 162(2), 195–209. https://doi.org/10.1111/1467-985x.00130
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Humphris, G. M., Dyer, T. A., & Robinson, P. G. (2009). The modified dental anxiety scale: UK general public population norms in 2008 with further psychometrics and effects of age. BMC Oral Health, 9(1), Article 20. https://doi.org/10.1186/1472-6831-9-20 ● Otwarty dostęp
- Ismail, A. I., Sohn, W., Tellez, M., Amaya, A., Sen, A., Hasson, H., & Pitts, N. B. (2007). The International Caries Detection and Assessment System (ICDAS): An integrated system for measuring dental caries. Community Dentistry and Oral Epidemiology, 35(3), 170–178. https://doi.org/10.1111/j.1600-0528.2007.00347.x ● Otwarty dostęp
- Kim, H.-Y. (2014). Analysis of variance (ANOVA) comparing means of more than two groups. Restorative Dentistry & Endodontics, 39(1), 74–77. https://doi.org/10.5395/rde.2014.39.1.74 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lesaffre, E., Philstrom, B., Needleman, I., & Worthington, H. (2009). The design and analysis of split-mouth studies: What statisticians and clinicians should know. Statistics in Medicine, 28(28), 3470–3482. https://doi.org/10.1002/sim.3634
- Masood, M., Masood, Y., & Newton, J. T. (2015). The clustering effects of surfaces within the tooth and teeth within individuals. Journal of Dental Research, 94(2), 281–288. https://doi.org/10.1177/0022034514559408 ● Otwarty dostęp: pełny tekst
- Pandis, N., Chung, B., Scherer, R. W., Elbourne, D., & Altman, D. G. (2017). CONSORT 2010 statement: Extension checklist for reporting within person randomised trials. BMJ, 357, Article j2835. https://doi.org/10.1136/bmj.j2835 ● Otwarty dostęp
- Preisser, J. S., Stamm, J. W., Long, D. L., & Kincade, M. E. (2012). Review and recommendations for zero-inflated count regression modeling of dental caries indices in epidemiological studies. Caries Research, 46(4), 413–423. https://doi.org/10.1159/000338992 ● Otwarty dostęp
Cytowania BibTeX
@article{bohning1999zero, author={Böhning, Dankmar and Dietz, Ekkehart and Schlattmann, Peter and Mendonça, L. and Kirchner, U.}, title={{The zero-inflated Poisson model and the decayed, missing and filled teeth index in dental epidemiology}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={1999}, volume={162}, number={2}, pages={195--209}, doi={10.1111/1467-985x.00130}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{humphris2009modified, author={Humphris, Gerry M. and Dyer, Tom A. and Robinson, Peter G.}, title={{The modified dental anxiety scale: UK general public population norms in 2008 with further psychometrics and effects of age}}, journal={BMC Oral Health}, year={2009}, volume={9}, number={1}, eid={20}, doi={10.1186/1472-6831-9-20}}@article{ismail2007international, author={Ismail, Amid I. and Sohn, Woosung and Tellez, Marisol and Amaya, Ashley and Sen, Ananda and Hasson, Hana and Pitts, Nigel B.}, title={{The International Caries Detection and Assessment System (ICDAS): An integrated system for measuring dental caries}}, journal={Community Dentistry and Oral Epidemiology}, year={2007}, volume={35}, number={3}, pages={170--178}, doi={10.1111/j.1600-0528.2007.00347.x}}@article{kim2014analysis, author={Kim, Hae-Young}, title={{Analysis of variance (ANOVA) comparing means of more than two groups}}, journal={Restorative Dentistry \& Endodontics}, year={2014}, volume={39}, number={1}, pages={74--77}, doi={10.5395/rde.2014.39.1.74}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lesaffre2009design, author={Lesaffre, Emmanuel and Philstrom, Bruce and Needleman, Ian and Worthington, Helen}, title={{The design and analysis of split-mouth studies: What statisticians and clinicians should know}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={28}, pages={3470--3482}, doi={10.1002/sim.3634}}@article{masood2015clustering, author={Masood, Mohd and Masood, Yaghma and Newton, Tim}, title={{The clustering effects of surfaces within the tooth and teeth within individuals}}, journal={Journal of Dental Research}, year={2015}, volume={94}, number={2}, pages={281--288}, doi={10.1177/0022034514559408}}@article{pandis2017consort, author={Pandis, Nikolaos and Chung, Bryan and Scherer, Roberta W. and Elbourne, Diana and Altman, Douglas G.}, title={{CONSORT 2010 statement: Extension checklist for reporting within person randomised trials}}, journal={BMJ}, year={2017}, volume={357}, eid={j2835}, doi={10.1136/bmj.j2835}}@article{preisser2012review, author={Preisser, John S. and Stamm, J. W. and Long, D. Leann and Kincade, M. E.}, title={{Review and recommendations for zero-inflated count regression modeling of dental caries indices in epidemiological studies}}, journal={Caries Research}, year={2012}, volume={46}, number={4}, pages={413--423}, doi={10.1159/000338992}}