Pięć typowych projektów w pracy z kosmetologii
Prace dyplomowe z kosmetologii mają dwie wyraźne odmiany. Pierwsza to badanie zabiegu lub preparatu: mierzysz skórę przed serią zabiegów i po niej albo porównujesz dwie połowy twarzy tej samej osoby. Druga to badanie ankietowe, w którym pytasz klientki o satysfakcję, nawyki pielęgnacyjne albo wiedzę o fotoprotekcji. Każda z tych odmian wymaga innych analiz, a najwięcej błędów pojawia się tam, gdzie te same osoby są mierzone więcej niż raz. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Parametry skóry przed i po serii zabiegów | Czy nawilżenie i TEWL zmieniły się po serii? | pomiary aparaturowe u tych samych osób | test t dla prób zależnych albo Wilcoxona, korekta Holma | dz z 95% CI |
| 2. Split-face | Czy preparat działa lepiej niż podłoże? | dwie połowy twarzy tej samej osoby | test t dla prób zależnych na różnicach zmian | różnica średnich z 95% CI, dz |
| 3. Satysfakcja z zabiegu | Czy klientki są bardziej zadowolone z zabiegu A niż B? | pozycje Likerta 1–5 | test Manna–Whitneya, odsetek odpowiedzi najwyższych | korelacja rangowo-dwuseryjna |
| 4. Ocena zdjęć przez ekspertów | Czy dwie oceniające zgadzają się co do poprawy? | ocena porządkowa 0–4 | kappa ważona | κw z 95% CI |
| 5. Ankieta o nawykach | Czy codzienne stosowanie filtra zależy od wieku? | kategorie | chi-kwadrat niezależności | V Craméra |
Wszystkie dane w przykładach są symulowane. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy w swoim programie. Jeśli Twoja praca dotyczy raczej pacjentów niż klientek gabinetu, zajrzyj też do poradników statystyka w pracy z pielęgniarstwa i statystyka dla fizjoterapeuty.
Zanim zaczniesz: schemat, pomiar i zgody
Najpierw nazwij schemat badania. Pomiar tej samej grupy przed i po zabiegu to schemat pretest–posttest bez grupy kontrolnej. Dwie połowy twarzy tej samej osoby to badanie wewnątrz osoby (ang. within-person, split-face, split-body). Porównanie klientek dwóch różnych zabiegów to schemat międzygrupowy. Od tej decyzji zależy cały plan analiz: dane z jednej osoby nie są niezależne, więc nie wolno ich analizować testami dla dwóch niezależnych grup.
Ustandaryzuj pomiar aparaturowy. Nawilżenie naskórka, przeznaskórkowa utrata wody (TEWL), sebum czy pH skóry silnie zależą od warunków. Rogiers (2001) w wytycznych EEMCO dla nauk kosmetycznych podkreśla, że na TEWL wpływa wiele zmiennych i bez standaryzacji warunków trudno o powtarzalne wyniki. du Plessis i in. (2013) wymieniają cztery grupy czynników: związane z osobą badaną, czynniki zewnętrzne (np. wcześniej użyte kosmetyki), warunki otoczenia oraz aparaturę i sposób pomiaru. W praktyce opisz w pracy, w jakim pomieszczeniu mierzyłaś, ile trwała aklimatyzacja, o której porze dnia, w którym miejscu skóry i ile razy powtarzałaś pomiar. Konkretne wartości (np. czas aklimatyzacji, zakres temperatury) weź z wytycznych lub instrukcji producenta aparatu i zacytuj je. Jeśli wykonujesz kilka odczytów w jednym miejscu, analizuj ich średnią, a nie pojedynczy odczyt.
Jednostki aparatu to nie wartości bezwzględne. Wiele aparatów do pomiaru nawilżenia podaje wynik w jednostkach umownych (j.u.), właściwych dla danego urządzenia. Wyniki z różnych aparatów nie są więc wprost porównywalne. Porównuj zmianę u tej samej osoby zmierzoną tym samym aparatem, a w dyskusji nie zestawiaj surowych liczb z badaniami wykonanymi innym urządzeniem.
Formalności załatw przed badaniem. Badanie z udziałem ludzi, zwłaszcza z zabiegiem lub nowym preparatem, wymaga zwykle opinii komisji bioetycznej i świadomej zgody uczestniczek. Zasady zależą od uczelni, więc sprawdź je u promotora i w regulaminie komisji. Zgody nie da się uzyskać wstecz.
Projekt 1. Parametry skóry przed serią zabiegów i po niej
Przykład: 40 klientek przeszło serię zabiegów nawilżających. Przed pierwszym i po ostatnim zabiegu zmierzono w tych samych warunkach cztery parametry: nawilżenie naskórka (j.u.), TEWL (g/m²/h), poziom sebum (µg/cm²) i pH skóry. Pytanie brzmi: które parametry się zmieniły i jak bardzo?
Test dla prób zależnych i wielkość efektu
Każda klientka ma dwa pomiary, więc właściwy jest test t dla prób zależnych. Test pracuje na różnicach „po − przed” i jego założenie normalności dotyczy rozkładu tych różnic, a nie surowych wyników. Nawilżenie wzrosło z 41.24 j.u. (SD = 8.28) do 47.50 j.u. (SD = 9.73), średnio o 6.26 j.u., 95% CI [3.78, 8.73], t(39) = 5.11, p < .001. Wzrost wystąpił u 87.5% klientek.
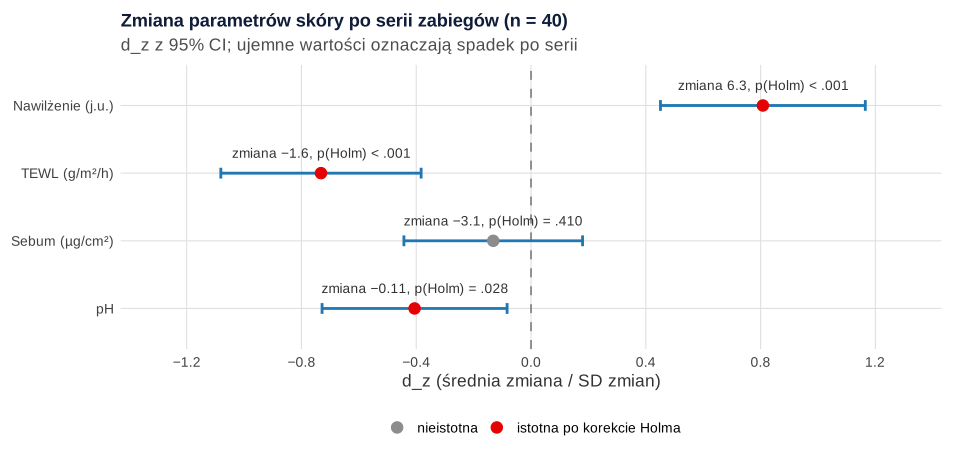
Wielkość efektu w schemacie zależnym podaj jako dz, czyli średnią zmianę podzieloną przez odchylenie standardowe zmian (wielkość efektu dla prób zależnych). Tutaj dz = 0.81, 95% CI [0.45, 1.16]. Lakens (2013) wyjaśnia, że w schematach wewnątrzosobniczych są różne miary d, a wybór trzeba jasno opisać, bo dz zależy od korelacji między pomiarami. Dunlap i in. (1996) pokazali, że liczenie d wprost ze statystyki t testu zależnego, bez uwzględnienia tej korelacji, zawyża efekt, gdy porównuje się go z badaniami międzygrupowymi. Napisz więc wprost, którą miarę podajesz.
Cztery parametry, czyli cztery testy
Mierząc kilka parametrów, wykonujesz kilka testów, a razem z ich liczbą rośnie szansa na przypadkowy wynik istotny (problem wielokrotnych porównań). Prostym rozwiązaniem jest korekta Holma (Holm, 1979), mocniejsza od zwykłej korekty Bonferroniego. Drugie rozwiązanie to wskazanie z góry jednego parametru głównego (np. nawilżenia) i opisanie pozostałych jako drugorzędnych. Obie strategie omawiamy w poradniku poprawki na wielokrotne porównania.
| Parametr | Przed M (SD) | Po M (SD) | Zmiana [95% CI] | t(39) | dz | p (Holm) |
|---|---|---|---|---|---|---|
| Nawilżenie (j.u.) | 41.24 (8.28) | 47.50 (9.73) | 6.26 [3.78, 8.73] | 5.11 | 0.81 | < .001 |
| TEWL (g/m²/h) | 14.16 (3.36) | 12.59 (4.10) | −1.57 [−2.26, −0.89] | −4.63 | −0.73 | < .001 |
| Sebum (µg/cm²) | 98.90 (32.58) | 95.78 (39.40) | −3.13 [−10.72, 4.47] | −0.83 | −0.13 | .410 |
| pH | 5.41 (0.43) | 5.30 (0.50) | −0.11 [−0.20, −0.02] | −2.57 | −0.41 | .028 |
Po korekcie istotne pozostały zmiany nawilżenia, TEWL i pH. Spadek pH jest jednak mały: 0.11 jednostki. Zanim nazwiesz go efektem zabiegu, zastanów się, czy taka różnica ma znaczenie dla skóry i czy nie mieści się w błędzie pomiaru aparatu. Jak ocenić, czy zmiana przekracza błąd pomiaru, pokazujemy w poradniku RCI, MDC i MCID.
Kiedy test Wilcoxona
Różnice sebum miały wyraźnie nienormalny rozkład (test Shapiro–Wilka, p = .002), co przy sebum zdarza się często. Wtedy obok testu t albo zamiast niego podaj test Wilcoxona dla par. W tym przykładzie oba testy prowadzą do tego samego wniosku (dla sebum p = .410 w teście t i p = .276 w teście Wilcoxona). Test rangowy i jego wielkość efektu opisujemy w poradniku testy nieparametryczne krok po kroku, a oba warianty testu t – w poradniku test t Studenta krok po kroku.
Czego ten schemat nie udowodni
Bez grupy kontrolnej nie oddzielisz działania zabiegu od pory roku, zmiany pielęgnacji domowej czy samego przyzwyczajenia do pomiaru. Dochodzi do tego regresja do średniej. Barnett i in. (2005) opisują, że gdy do badania kwalifikuje się osoby z nietypowo złym wynikiem wyjściowym (np. tylko klientki z bardzo suchą skórą), kolejny pomiar wypada zwykle bliżej średniej nawet bez żadnego zabiegu. W pracy pisz więc „po serii zabiegów nawilżenie było wyższe”, a nie „zabieg zwiększa nawilżenie”. Jeśli możesz dodać grupę porównawczą, analizuj wynik końcowy z pomiarem wyjściowym jako kowariantem. Tę strategię opisujemy w poradniku ANCOVA w badaniu przed i po.
du Plessis i in. (2013) zalecają podawać wyniki TEWL i nawilżenia jako różnicę albo zmianę procentową. Zmianę procentową możesz pokazać opisowo, ale testy licz na różnicach w jednostkach pomiaru, bo procent zależy od wartości wyjściowej (zob. zmiana procentowa).
Projekt 2. Badanie split-face: preparat na jednej połowie twarzy
Schemat split-face jest w kosmetologii bardzo atrakcyjny. Każda osoba jest kontrolą dla samej siebie, więc różnice między osobami (typ skóry, wiek, styl życia) w dużej części znikają z porównania. Lesaffre i in. (2009) opisują analogiczny schemat split-mouth w stomatologii: dzięki niemu z oszacowania efektu usuwa się dużą część zmienności między osobami, ale schemat ma też znane od lat pułapki. Pandis i in. (2017) wskazują, że badania randomizowane wewnątrz osoby prowadzi się najczęściej w okulistyce, stomatologii i dermatologii.
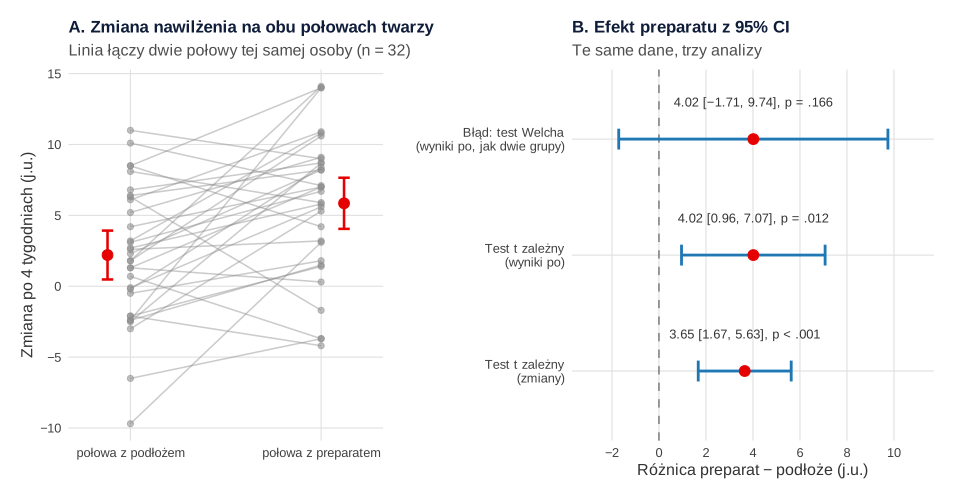
Przykład: 32 uczestniczki przez 4 tygodnie nakładały serum na jedną połowę twarzy, a samo podłoże (preparat bez składnika aktywnego) na drugą. Stronę z serum wylosowano osobno dla każdej osoby. Nawilżenie zmierzono na obu połowach przed badaniem i po nim. Na połowie z serum wzrosło średnio o 5.85 j.u. (SD = 5.01), a na połowie z podłożem o 2.20 j.u. (SD = 4.78).
Właściwa analiza: różnica w obrębie osoby
Dla każdej osoby policz, o ile bardziej wzrosło nawilżenie na połowie z serum niż na połowie z podłożem. Średnia tych różnic to efekt preparatu: 3.65 j.u., 95% CI [1.67, 5.63], t(31) = 3.76, p < .001, dz = 0.67, 95% CI [0.28, 1.05]. Test Wilcoxona daje ten sam wniosek (V = 437, p = .001). U 75.0% uczestniczek większą poprawę odnotowano po stronie z serum. Wyniki obu połówek tej samej osoby po 4 tygodniach korelowały na poziomie r = .75. Ta silna korelacja jest źródłem przewagi schematu: odejmując połówki, usuwasz to, co wspólne dla obu.
Najczęstszy błąd: połówki jako dwie niezależne grupy
Na rysunku 2B widać, co się dzieje, gdy wyniki z połowy z serum i połowy z podłożem potraktuje się jak dwie niezależne grupy po 32 osoby. Test Welcha daje t(58.43) = 1.40, p = .166, a przedział ufności dla różnicy [−1.71, 9.74] jest prawie trzy razy szerszy niż w analizie zależnej. Wniosek zmienia się z „preparat działa” na „brak różnicy”, choć dane są te same. To nie jest teoretyczny problem. W przeglądzie 54 dermatologicznych badań randomizowanych wewnątrz osoby 14 (26.9%) użyło testu dla obserwacji niezależnych, pomijając korelację między miejscami na ciele tej samej osoby (Leducq i in., 2023).
Test t dla prób zależnych na samych wynikach końcowych jest poprawny (t(31) = 2.68, p = .012), ale mniej precyzyjny niż analiza zmian, bo nie korzysta z pomiaru wyjściowego obu połówek. Wybierz analizę przed zebraniem danych i zapisz ją w planie pracy.
Przenikanie, losowanie strony i zaślepienie
- Efekt przenikania. Preparat może przejść na drugą połowę twarzy (przy nakładaniu, przez ręcznik, poduszkę) albo działać ogólnoustrojowo. Wtedy połowa z podłożem też się poprawia, a efekt jest zaniżony. Leducq i in. (2023) zauważają, że przenikanie (ang. carry-across) uchodzi za główny problem metodologiczny takich badań, a żadne z przeanalizowanych badań go nie oceniło. Opisz w ograniczeniach, jak próbowałaś go ograniczyć. Pokrewne zjawisko w schematach z kolejnymi okresami opisujemy w haśle efekt przeniesienia.
- Losowanie strony. Stronę z preparatem losuj osobno dla każdej osoby (randomizacja), najlepiej w równych liczbach lewych i prawych. W przykładzie efekt nie zależał od wylosowanej strony (lewa: 3.41 j.u., prawa: 3.89 j.u., t(29.29) = −0.24, p = .811). To tylko kontrola, a nie główna analiza.
- Zaślepienie. Jeśli preparaty wyglądają podobnie, oznacz je kodami, tak aby ani uczestniczka, ani osoba mierząca nie wiedziała, która strona dostała serum (ślepa ocena wyniku).
- Raport. Rozszerzenie CONSORT dla badań wewnątrz osoby rozszerza 16 punktów listy CONSORT 2010 oraz dodaje zmodyfikowany schemat przepływu i tabelę charakterystyki wyjściowej (Pandis i in., 2017). Nawet jeśli Twoje badanie jest małe, przejdź przez tę listę przy pisaniu rozdziału metodologicznego.
Projekt 3. Satysfakcja klientek z zabiegu
Przykład: 120 klientek oceniło zabieg w sześciu autorskich pozycjach od 1 („zdecydowanie nie”) do 5 („zdecydowanie tak”): efekt, komfort, informacja przed zabiegiem, czas trwania, gotowość polecenia i ocena ogólna. 58 osób przeszło peeling chemiczny, a 62 mikrodermabrazję. Rzetelność skali była dobra (alfa Cronbacha = .85), więc wynik policzono jako średnią z pozycji. Średnia wyniosła 4.28 (SD = 0.62), ale 48.3% wszystkich odpowiedzi stanowiła ocena „5”, a 13.3% klientek wybrało ją we wszystkich pozycjach. To typowy efekt sufitu.
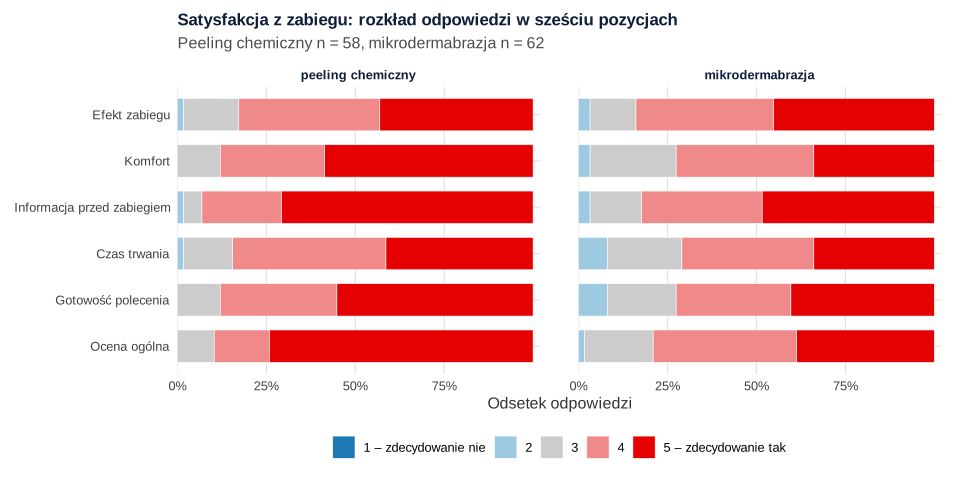
Sullivan i Artino (2013) przypominają, że pojedyncza pozycja skali Likerta jest porządkowa, więc opisuj ją medianą i rozkładem odpowiedzi. Wynik całej skali możesz analizować testami parametrycznymi, jeśli połączenie pozycji uzasadniają dowody rzetelności lub struktury. Przy silnie skośnym rozkładzie bezpieczniejszy jest jednak test rangowy. Klientki po peelingu oceniały zabieg wyżej (Me = 4.58, Q1–Q3: 4.21–4.83) niż po mikrodermabrazji (Me = 4.33, Q1–Q3: 3.83–4.67). Wynik testu Manna–Whitneya: W = 2361, p = .003, korelacja rangowo-dwuseryjna r = .31, 95% CI [.12, .49].
Obok średniej podaj dla każdej pozycji odsetek ocen najwyższych z 95% CI (przedział ufności dla proporcji). Pokazuje on, gdzie jest miejsce na poprawę. W całej próbie ocenę „5” za informację przed zabiegiem dało 59.2% klientek, 95% CI [50.2, 67.5], a za czas trwania tylko 37.5%, 95% CI [29.4, 46.4]. Pamiętaj, że klientki same wybrały zabieg, więc grupy mogą różnić się oczekiwaniami i stanem skóry. To porównanie opisuje związek, a nie przewagę jednego zabiegu. Pełną analizę ankiety satysfakcji, z wykresem skumulowanym i kodowaniem pytań otwartych, opisujemy w poradniku analiza ankiety satysfakcji pacjentów.
Projekt 4. Ocena zdjęć przed i po przez ekspertów
Efekt zabiegu na przebarwienia, zmarszczki czy trądzik często ocenia się na zdjęciach. Wtedy wynik zależy od osoby oceniającej i trzeba pokazać, że oceny są powtarzalne. Przykład: dwie doświadczone kosmetolożki niezależnie oceniły 60 par zdjęć (przed i po) w autorskiej skali 0–4, od „brak poprawy” do „wyraźna poprawa”. Nie wiedziały, którą klientkę oceniają ani jaki zabieg wykonano.
Oceny pokrywały się dokładnie w 53.3% par, a w 96.7% różniły się najwyżej o jeden punkt. Zwykła kappa Cohena traktuje każdą niezgodność jednakowo i wynosi tylko κ = .41, 95% CI [.25, .57]. Przy skali porządkowej różnica 3 i 4 jest jednak mniej poważna niż różnica 0 i 4. Cohen (1968) zaproponował w tym celu kappę ważoną, w której niezgodności mają wagi zależne od odległości. Z wagami kwadratowymi κw = .83, 95% CI [.76, .90]. W pracy podaj obie liczby, rodzaj wag i macierz zgodności w aneksie. Wybór między kappą, ICC i alfą Krippendorffa oraz paradoksy kappy omawiamy w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Gdy ocena ekspertów jest głównym wynikiem, ustal zasady przed badaniem: te same warunki fotografowania, kolejność zdjęć wylosowaną dla każdej oceniającej i próbę treningową na zdjęciach spoza badania. Jeśli zamiast autorskiej skali używasz opublikowanej skali oceny poprawy estetycznej, opisz ją według publikacji autorów i nie przedrukowuj jej opisu kategorii bez zgody (wzór opisu narzędzia znajdziesz w poradniku o opisie narzędzia badawczego).
Projekt 5. Ankieta o nawykach pielęgnacyjnych
Część prac z kosmetologii to badania ankietowe: nawyki pielęgnacyjne, wiedza o fotoprotekcji, korzystanie z gabinetów. Przykład: 240 kobiet odpowiedziało, czy codziennie stosuje krem z filtrem. Odsetek osób stosujących filtr codziennie wynosił 50.0% w grupie 18–25 lat (46 z 92), 30.7% w grupie 26–40 lat (27 z 88) i 26.7% w grupie 41 lat i więcej (16 z 60). Test chi-kwadrat niezależności: χ²(2) = 10.92, p = .004, V Craméra = .21. Najmniejsza liczebność oczekiwana wynosiła 22.2, więc warunek testu był spełniony. Reszty standaryzowane skorygowane pokazują, że wynik „robi” głównie najmłodsza grupa (3.27 w komórce „codziennie”). Odczytywanie reszt i tabel większych niż 2 × 2 pokazujemy w poradniku test chi-kwadrat krok po kroku.
Ankieta internetowa rozesłana w mediach społecznościowych gabinetu albo na grupach o pielęgnacji nie daje próby reprezentatywnej. Osoby zainteresowane pielęgnacją odpowiadają chętniej, więc odsetki opisuj jako cechę badanej próby, a nie „Polek”. Jak przygotować pytania, opisujemy w poradniku jak zrobić ankietę do pracy dyplomowej.
Jak opisać analizę statystyczną w pracy
Rozdział o metodach powinien pozwolić innej osobie powtórzyć badanie. W pracy z kosmetologii opisz przede wszystkim warunki pomiaru aparaturowego, sposób losowania strony w badaniu split-face, zaślepienie i liczbę uczestniczek, które ukończyły badanie. Poniżej wzór akapitu o analizie statystycznej dla projektów 1 i 2.
Jeśli potrzebujesz pomocy w doborze analiz do swojego projektu albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 2 z pełną analizą badania split-face. Wielkości efektu liczy pakiet effectsize, a kappę – pakiet psych.
1. Projekt 1: cztery parametry skóry przed i po – test t dla prób zależnych, dz, Wilcoxon i korekta Holma
R
# Projekt 1: parametry skóry przed serią zabiegów i po niej – jedna grupa (dane symulowane).
# 40 klientek, seria zabiegów nawilżających; pomiary w tych samych warunkach przed pierwszym
# i po ostatnim zabiegu: nawilżenie naskórka (jednostki umowne aparatu, j.u.), TEWL (g/m²/h),
# sebum (µg/cm²) i pH skóry.
suppressPackageStartupMessages(library(effectsize))
set.seed(7101)
n <- 40
baza <- rnorm(n)                                    # wspólna „kondycja skóry” klientki
naw_przed  <- round(42 + 8 * (0.8 * baza + 0.6 * rnorm(n)), 1)
naw_po     <- round(naw_przed + rnorm(n, 5.5, 6.5), 1)
tewl_przed <- round(exp(log(14) + 0.25 * (-0.6 * baza + 0.8 * rnorm(n))), 1)
tewl_po    <- round(pmax(4, tewl_przed + rnorm(n, -1.1, 2.6)), 1)
seb_przed  <- round(pmax(10, rnorm(n, 92, 30)))
seb_po     <- round(pmax(10, seb_przed + rnorm(n, -3, 24)))
ph_przed   <- round(rnorm(n, 5.40, 0.38), 2)
ph_po      <- round(ph_przed + rnorm(n, -0.04, 0.30), 2)
p1 <- data.frame(id = 1:n, naw_przed, naw_po, tewl_przed, tewl_po, seb_przed, seb_po, ph_przed, ph_po)

param <- c(naw = "Nawilżenie (j.u.)", tewl = "TEWL (g/m²/h)", seb = "Sebum (µg/cm²)", ph = "pH")
wyn <- do.call(rbind, lapply(names(param), function(k) {
  x <- p1[[paste0(k, "_przed")]]; y <- p1[[paste0(k, "_po")]]; r <- y - x
  tt <- t.test(y, x, paired = TRUE)
  dz <- repeated_measures_d(y, x, method = "z", adjust = FALSE)
  wx <- suppressWarnings(wilcox.test(y, x, paired = TRUE, exact = FALSE))
  data.frame(parametr = param[[k]], M_przed = mean(x), SD_przed = sd(x), M_po = mean(y), SD_po = sd(y),
             zmiana = mean(r), CI_d = tt$conf.int[1], CI_g = tt$conf.int[2], t = unname(tt$statistic),
             df = unname(tt$parameter), p = tt$p.value, d_z = dz$d, dz_lo = dz$CI_low, dz_hi = dz$CI_high,
             r_pp = cor(x, y), p_wilcoxon = wx$p.value)
}))
wyn$p_holm <- p.adjust(wyn$p, method = "holm")
num <- sapply(wyn, is.numeric)
w2 <- wyn; w2[num] <- lapply(wyn[num], round, 4); w2[c("p", "p_wilcoxon", "p_holm")] <- lapply(wyn[c("p", "p_wilcoxon", "p_holm")], signif, 4)
print(w2[, 1:9], row.names = FALSE)
print(w2[, c(1, 10:17)], row.names = FALSE)
# Normalność różnic (orientacyjnie) – test Shapiro–Wilka dla każdej różnicy
round(sapply(names(param), function(k) shapiro.test(p1[[paste0(k, "_po")]] - p1[[paste0(k, "_przed")]])$p.value), 3)
# Odsetek klientek, u których nawilżenie wzrosło
round(100 * mean(p1$naw_po > p1$naw_przed), 1)
Wynik w R
          parametr M_przed SD_przed    M_po   SD_po  zmiana     CI_d    CI_g       t
 Nawilżenie (j.u.) 41.2425   8.2825 47.4975  9.7324  6.2550   3.7790  8.7310  5.1099
     TEWL (g/m²/h) 14.1600   3.3585 12.5875  4.0954 -1.5725  -2.2596 -0.8854 -4.6293
    Sebum (µg/cm²) 98.9000  32.5756 95.7750 39.4049 -3.1250 -10.7151  4.4651 -0.8328
                pH  5.4082   0.4293  5.2958  0.4984 -0.1125  -0.2012 -0.0238 -2.5664
          parametr df         p     d_z   dz_lo   dz_hi   r_pp p_wilcoxon    p_holm
 Nawilżenie (j.u.) 39 8.850e-06  0.8079  0.4510  1.1648 0.6413  1.647e-05 0.0000354
     TEWL (g/m²/h) 39 4.003e-05 -0.7320 -1.0809 -0.3830 0.8520  1.501e-04 0.0001201
    Sebum (µg/cm²) 39 4.100e-01 -0.1317 -0.4429  0.1796 0.7988  2.761e-01 0.4100000
                pH 39 1.423e-02 -0.4058 -0.7282 -0.0834 0.8316  1.552e-02 0.0284600
  naw  tewl   seb    ph
0.406 0.435 0.002 0.784
[1] 87.5
2. Projekt 2: pełna analiza badania split-face
R
# Projekt 2: badanie split-face – preparat na jednej połowie twarzy, podłoże (placebo) na drugiej (dane symulowane).
# 32 uczestniczki; strona z preparatem losowana; nawilżenie (j.u.) przed i po 4 tygodniach na obu połowach.
suppressPackageStartupMessages(library(effectsize))
set.seed(7102)
n <- 32
osoba <- rnorm(n, 0, 7.5)                           # różnice między osobami – wspólne dla obu połówek
strona_preparat <- sample(rep(c("lewa", "prawa"), n / 2))
przed_prep <- round(40 + osoba + rnorm(n, 0, 3), 1)
przed_pod  <- round(40 + osoba + rnorm(n, 0, 3), 1)
po_prep    <- round(przed_prep + 6.0 + 0.4 * osoba + rnorm(n, 0, 4), 1)
po_pod     <- round(przed_pod  + 3.0 + 0.4 * osoba + rnorm(n, 0, 4), 1)
p2 <- data.frame(id = 1:n, strona_preparat, przed_prep, przed_pod, po_prep, po_pod)
p2$zm_prep <- p2$po_prep - p2$przed_prep
p2$zm_pod  <- p2$po_pod - p2$przed_pod
p2$roznica <- p2$zm_prep - p2$zm_pod                # efekt preparatu u każdej osoby

round(c(M_przed_prep = mean(p2$przed_prep), M_przed_pod = mean(p2$przed_pod),
        M_po_prep = mean(p2$po_prep), SD_po_prep = sd(p2$po_prep),
        M_po_pod = mean(p2$po_pod), SD_po_pod = sd(p2$po_pod),
        M_zm_prep = mean(p2$zm_prep), SD_zm_prep = sd(p2$zm_prep),
        M_zm_pod = mean(p2$zm_pod), SD_zm_pod = sd(p2$zm_pod)), 2)
# Korelacja połówek twarzy tej samej osoby (po 4 tygodniach)
round(cor(p2$po_prep, p2$po_pod), 2)
# Analiza właściwa: test t dla prób zależnych na zmianach (preparat − podłoże)
t.test(p2$zm_prep, p2$zm_pod, paired = TRUE)
dz <- repeated_measures_d(p2$zm_prep, p2$zm_pod, method = "z", adjust = FALSE); dz
suppressWarnings(wilcox.test(p2$zm_prep, p2$zm_pod, paired = TRUE, exact = FALSE))
# Błąd: połówki potraktowane jak dwie niezależne grupy (test t Welcha na wynikach po 4 tygodniach)
t.test(p2$po_prep, p2$po_pod)
# Dla porównania: test t dla prób zależnych na wynikach po 4 tygodniach
t.test(p2$po_prep, p2$po_pod, paired = TRUE)
# Czy efekt zależy od wylosowanej strony? (kontrola, nie główna analiza)
t.test(roznica ~ strona_preparat, data = p2)
round(100 * mean(p2$roznica > 0), 1)
Wynik w R
M_przed_prep  M_przed_pod    M_po_prep   SD_po_prep     M_po_pod    SD_po_pod    M_zm_prep   SD_zm_prep
       39.90        39.54        45.76        12.78        41.74         9.93         5.85         5.01
    M_zm_pod    SD_zm_pod
        2.20         4.78
[1] 0.75

	Paired t-test

data:  p2$zm_prep and p2$zm_pod
t = 3.7639, df = 31, p-value = 0.0007008
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 1.672215 5.627785
sample estimates:
mean difference
           3.65

d (z) |       95% CI
--------------------
0.67  | [0.28, 1.05]

	Wilcoxon signed rank test with continuity correction

data:  p2$zm_prep and p2$zm_pod
V = 437, p-value = 0.001257
alternative hypothesis: true location shift is not equal to 0


	Welch Two Sample t-test

data:  p2$po_prep and p2$po_pod
t = 1.4033, df = 58.425, p-value = 0.1658
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -1.711353  9.742603
sample estimates:
mean of x mean of y
 45.75625  41.74063


	Paired t-test

data:  p2$po_prep and p2$po_pod
t = 2.6807, df = 31, p-value = 0.01166
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.9604817 7.0707683
sample estimates:
mean difference
       4.015625


	Welch Two Sample t-test

data:  roznica by strona_preparat
t = -0.24116, df = 29.29, p-value = 0.8111
alternative hypothesis: true difference in means between group lewa and group prawa is not equal to 0
95 percent confidence interval:
 -4.501589  3.551589
sample estimates:
 mean in group lewa mean in group prawa
             3.4125              3.8875

[1] 75
3. Projekty 3–5: satysfakcja, zgodność ekspertów i ankieta o fotoprotekcji
R
# Projekt 3: satysfakcja klientek po dwóch rodzajach zabiegu; projekt 4: ocena zdjęć przez dwóch ekspertów;
# projekt 5: ankieta o codziennej fotoprotekcji (dane symulowane).
suppressPackageStartupMessages({ library(effectsize); library(psych) })
set.seed(7103)
# --- Projekt 3: 6 autorskich pozycji 1–5 (efekt, komfort, informacja przed zabiegiem, czas, gotowość polecenia, ogólna ocena)
nA <- 58; nB <- 62
zabieg <- factor(c(rep("peeling chemiczny", nA), rep("mikrodermabrazja", nB)), levels = c("peeling chemiczny", "mikrodermabrazja"))
lat <- rnorm(nA + nB, ifelse(zabieg == "peeling chemiczny", 0.55, 0), 1)
progi <- c(-2.6, -1.7, -0.7, 0.35)
poz <- sapply(1:6, function(j) { y <- 0.75 * lat + rnorm(nA + nB, 0, 0.65) + c(0, .1, .25, -.15, .05, .15)[j]
  as.integer(cut(y, c(-Inf, progi, Inf))) })
colnames(poz) <- c("efekt", "komfort", "informacja", "czas", "polecenie", "ogolna")
p3 <- data.frame(id = seq_len(nA + nB), zabieg, poz)
p3$wynik <- rowMeans(poz)
round(psych::alpha(poz, warnings = FALSE)$total[c("raw_alpha", "std.alpha")], 2)
round(c(M = mean(p3$wynik), SD = sd(p3$wynik), proc_5_wszystkie = 100 * mean(p3$wynik == 5),
        proc_odp_5 = 100 * mean(poz == 5)), 2)
aggregate(wynik ~ zabieg, p3, function(x) round(c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                                                  Q3 = unname(quantile(x, .75)), M = mean(x)), 2))
suppressWarnings(wilcox.test(wynik ~ zabieg, data = p3, exact = FALSE))
rank_biserial(wynik ~ zabieg, data = p3)
# Odsetek „5” w każdej pozycji z 95% CI Wilsona
wilson <- function(k, n) { z <- qnorm(.975); p <- k / n; c0 <- p + z^2 / (2 * n); h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(proc = 100 * p, lo = 100 * (c0 - h) / (1 + z^2 / n), hi = 100 * (c0 + h) / (1 + z^2 / n)) }
round(t(sapply(colnames(poz), function(v) wilson(sum(p3[[v]] == 5), nrow(p3)))), 1)

# --- Projekt 4: dwóch ekspertów ocenia 60 par zdjęć (przed/po) w skali 0–4 (brak poprawy … wyraźna poprawa)
set.seed(7104)
prawda <- sample(0:4, 60, TRUE, prob = c(.10, .22, .30, .25, .13))
ekspert1 <- pmin(4, pmax(0, prawda + sample(c(-1, 0, 1), 60, TRUE, prob = c(.15, .70, .15))))
ekspert2 <- pmin(4, pmax(0, prawda + sample(c(-1, 0, 1), 60, TRUE, prob = c(.20, .62, .18))))
p4 <- data.frame(zdjecie = 1:60, ekspert1, ekspert2)
table(ekspert1 = factor(ekspert1, 0:4), ekspert2 = factor(ekspert2, 0:4))
round(c(zgodnosc_dokladna = 100 * mean(ekspert1 == ekspert2), zgodnosc_pm1 = 100 * mean(abs(ekspert1 - ekspert2) <= 1)), 1)
k <- psych::cohen.kappa(cbind(ekspert1, ekspert2)); round(k$confid, 2)

# --- Projekt 5: codzienne stosowanie kremu z filtrem a wiek (ankieta, N = 240)
set.seed(7105)
wiek <- factor(sample(c("18–25", "26–40", "41 i więcej"), 240, TRUE, prob = c(.42, .35, .23)), levels = c("18–25", "26–40", "41 i więcej"))
spf <- factor(ifelse(runif(240) < c(.52, .40, .27)[as.integer(wiek)], "codziennie", "rzadziej"), levels = c("codziennie", "rzadziej"))
p5 <- data.frame(id = 1:240, wiek, spf)
tab <- table(p5$wiek, p5$spf); tab
round(100 * prop.table(tab, 1), 1)
ch <- chisq.test(tab); ch
round(ch$expected, 1)
round(ch$stdres, 2)
cv <- cramers_v(tab, adjust = FALSE); cv
Wynik w R
 raw_alpha std.alpha
      0.85      0.85
               M               SD proc_5_wszystkie       proc_odp_5
            4.28             0.62            13.33            48.33
             zabieg wynik.n wynik.Me wynik.Q1 wynik.Q3 wynik.M
1 peeling chemiczny   58.00     4.58     4.21     4.83    4.44
2  mikrodermabrazja   62.00     4.33     3.83     4.67    4.12

	Wilcoxon rank sum test with continuity correction

data:  wynik by zabieg
W = 2361, p-value = 0.002974
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.31              | [0.12, 0.49]
           proc   lo   hi
efekt      44.2 35.6 53.1
komfort    45.8 37.2 54.7
informacja 59.2 50.2 67.5
czas       37.5 29.4 46.4
polecenie  47.5 38.8 56.4
ogolna     55.8 46.9 64.4
        ekspert2
ekspert1 0 1 2 3 4
       0 4 2 1 0 0
       1 2 7 3 0 0
       2 0 1 7 4 1
       3 0 0 5 6 7
       4 0 0 0 2 8
zgodnosc_dokladna      zgodnosc_pm1
             53.3              96.7
                 lower estimate upper
unweighted kappa  0.25     0.41  0.57
weighted kappa    0.76     0.83  0.90

              codziennie rzadziej
  18–25               46       46
  26–40               27       61
  41 i więcej         16       44

              codziennie rzadziej
  18–25             50.0     50.0
  26–40             30.7     69.3
  41 i więcej       26.7     73.3

	Pearson's Chi-squared test

data:  tab
X-squared = 10.915, df = 2, p-value = 0.004265


              codziennie rzadziej
  18–25             34.1     57.9
  26–40             32.6     55.4
  41 i więcej       22.2     37.8

              codziennie rzadziej
  18–25             3.27    -3.27
  26–40            -1.56     1.56
  41 i więcej      -1.93     1.93
Cramer's V |       95% CI
-------------------------
0.21       | [0.09, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
4. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b71-rysunki.R > b71-rysunki-wynik.txt
library(ggplot2)
theme_metodolog <- function(base_size = 12) theme_minimal(base_size = base_size)
zapisz_svg <- function(p, plik, szer = 10, wys = 5) ggsave(plik, p, width = szer, height = wys)
suppressPackageStartupMessages({ library(patchwork); library(openxlsx) })
pdf(NULL)
invisible(capture.output({ for (f in c("b71-1-parametry-skory.R", "b71-2-split-face.R", "b71-3-satysfakcja-oceny.R")) source(f) }))

# Rysunek 1: split-face – zmiana na obu połowach twarzy i trzy sposoby analizy
d1 <- rbind(data.frame(id = p2$id, polowa = "podłoże", zmiana = p2$zm_pod),
            data.frame(id = p2$id, polowa = "preparat", zmiana = p2$zm_prep))
d1$x <- ifelse(d1$polowa == "podłoże", 1, 2)
sr <- aggregate(zmiana ~ polowa + x, d1, function(v) c(M = mean(v), lo = t.test(v)$conf.int[1], hi = t.test(v)$conf.int[2]))
sr <- do.call(data.frame, sr); names(sr) <- c("polowa", "x", "M", "lo", "hi"); print(sr, digits = 3)
rA <- ggplot(d1, aes(x, zmiana)) +
  geom_line(aes(group = id), colour = KOLORY[["dane"]], alpha = .45) +
  geom_point(colour = KOLORY[["dane"]], alpha = .55, size = 1.8) +
  geom_errorbar(data = sr, aes(x = x + c(-.12, .12), ymin = lo, ymax = hi), inherit.aes = FALSE, width = .06, colour = KOLORY[["akcent"]], linewidth = .9) +
  geom_point(data = sr, aes(x = x + c(-.12, .12), y = M), colour = KOLORY[["akcent"]], size = 3.4) +
  scale_x_continuous(breaks = 1:2, labels = c("połowa z podłożem", "połowa z preparatem"), limits = c(.75, 2.25)) +
  labs(title = "A. Zmiana nawilżenia na obu połowach twarzy", subtitle = "Linia łączy dwie połowy tej samej osoby (n = 32)",
       x = NULL, y = "Zmiana po 4 tygodniach (j.u.)") + scale_y_continuous(labels = function(x) gsub("-", "−", x)) + theme_metodolog(12)
t_w <- t.test(p2$po_prep, p2$po_pod); t_pp <- t.test(p2$po_prep, p2$po_pod, paired = TRUE); t_pz <- t.test(p2$zm_prep, p2$zm_pod, paired = TRUE)
d2 <- data.frame(metoda = factor(c("Błąd: test Welcha\n(wyniki po, jak dwie grupy)", "Test t zależny\n(wyniki po)", "Test t zależny\n(zmiany)"),
                                 levels = rev(c("Błąd: test Welcha\n(wyniki po, jak dwie grupy)", "Test t zależny\n(wyniki po)", "Test t zależny\n(zmiany)"))),
                 M = c(diff(rev(t_w$estimate)), t_pp$estimate, t_pz$estimate),
                 lo = c(t_w$conf.int[1], t_pp$conf.int[1], t_pz$conf.int[1]), hi = c(t_w$conf.int[2], t_pp$conf.int[2], t_pz$conf.int[2]),
                 p = c(t_w$p.value, t_pp$p.value, t_pz$p.value))
d2$etyk <- gsub("-", "−", sprintf("%.2f [%.2f, %.2f], %s", d2$M, d2$lo, d2$hi, sapply(d2$p, apa_p))); print(d2[, c("M", "lo", "hi", "p")], digits = 3)
rB <- ggplot(d2, aes(M, metoda)) + geom_vline(xintercept = 0, linetype = 2, colour = "grey50") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = .18, orientation = "y", colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(colour = KOLORY[["akcent"]], size = 3.4) +
  geom_text(aes(x = M, label = etyk), nudge_y = .32, size = 3.4, colour = "grey20") +
  scale_x_continuous(limits = c(-3, 11), breaks = seq(-2, 10, 2), labels = function(x) gsub("-", "−", x)) +
  labs(title = "B. Efekt preparatu z 95% CI", subtitle = "Te same dane, trzy analizy", x = "Różnica preparat − podłoże (j.u.)", y = NULL) +
  theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.15)), "../statystyka-kosmetologia-split-face.svg", szer = 10, wys = 5.2)

# Rysunek 2: zmiana czterech parametrów skóry – d_z z 95% CI i p po korekcie Holma
d3 <- wyn; d3$parametr <- factor(d3$parametr, levels = rev(d3$parametr))
d3$etyk <- sprintf("zmiana %s, p(Holm) %s", ifelse(abs(d3$zmiana) < 1, sprintf("%.2f", d3$zmiana), sprintf("%.1f", d3$zmiana)),
                   sub("^p ", "", sapply(d3$p_holm, apa_p)))
d3$etyk <- gsub("-", "−", d3$etyk); print(d3[, c("parametr", "d_z", "dz_lo", "dz_hi", "p_holm")], digits = 3)
r2 <- ggplot(d3, aes(d_z, parametr)) + geom_vline(xintercept = 0, linetype = 2, colour = "grey50") +
  geom_errorbar(aes(xmin = dz_lo, xmax = dz_hi), width = .16, orientation = "y", colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(aes(colour = p_holm < .05), size = 3.6) +
  geom_text(aes(label = etyk), nudge_y = .3, size = 3.6, colour = "grey20") +
  scale_colour_manual(values = c(`TRUE` = KOLORY[["akcent"]], `FALSE` = KOLORY[["neutralny"]]), labels = c(`TRUE` = "istotna po korekcie Holma", `FALSE` = "nieistotna"), name = NULL) +
  scale_x_continuous(limits = c(-1.3, 1.3), breaks = seq(-1.2, 1.2, .4), labels = function(x) gsub("-", "−", sprintf("%.1f", x))) +
  labs(title = "Zmiana parametrów skóry po serii zabiegów (n = 40)", subtitle = "d_z z 95% CI; ujemne wartości oznaczają spadek po serii",
       x = "d_z (średnia zmiana / SD zmian)", y = NULL) + theme_metodolog(13)
zapisz_svg(r2, "../statystyka-kosmetologia-zmiana-parametrow.svg", szer = 10, wys = 4.8)

# Rysunek 3: rozkład odpowiedzi w pozycjach satysfakcji według zabiegu
et <- c(efekt = "Efekt zabiegu", komfort = "Komfort", informacja = "Informacja przed zabiegiem", czas = "Czas trwania", polecenie = "Gotowość polecenia", ogolna = "Ocena ogólna")
d4 <- do.call(rbind, lapply(names(et), function(v) { tb <- prop.table(table(p3$zabieg, factor(p3[[v]], 1:5)), 1)
  data.frame(pozycja = et[[v]], zabieg = rep(rownames(tb), 5), odp = rep(colnames(tb), each = 2), proc = 100 * as.vector(tb)) }))
d4$odp <- factor(d4$odp, levels = 5:1); d4$zabieg <- factor(d4$zabieg, levels = levels(p3$zabieg)); d4$pozycja <- factor(d4$pozycja, levels = rev(et))
print(subset(d4, odp == "5"), digits = 3, row.names = FALSE)
r3 <- ggplot(d4, aes(proc, pozycja, fill = odp)) + geom_col(width = .7, colour = "white", linewidth = .2) +
  facet_wrap(~ zabieg) +
  scale_fill_manual(values = c(`5` = KOLORY[["akcent"]], `4` = "#f08a8a", `3` = "grey80", `2` = "#9ecae1", `1` = KOLORY[["drugi"]]),
                    breaks = as.character(1:5), labels = c("1 – zdecydowanie nie", "2", "3", "4", "5 – zdecydowanie tak"), name = NULL) +
  scale_x_continuous(breaks = c(0, 25, 50, 75), labels = function(x) paste0(x, "%"), expand = expansion(mult = c(0, .02))) +
  labs(title = "Satysfakcja z zabiegu: rozkład odpowiedzi w sześciu pozycjach", subtitle = "Peeling chemiczny n = 58, mikrodermabrazja n = 62",
       x = "Odsetek odpowiedzi", y = NULL) + theme_metodolog(12) + theme(panel.spacing = unit(2, "lines"))
zapisz_svg(r3, "../statystyka-kosmetologia-satysfakcja.svg", szer = 10, wys = 5)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z kosmetologii – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("P1_parametry", "P2_split_face", "P3_satysfakcja", "P4_eksperci", "P5_fotoprotekcja"),
  zawartosc = c("40 klientek: nawilżenie (j.u.), TEWL (g/m²/h), sebum (µg/cm²) i pH przed serią zabiegów i po niej",
                "32 uczestniczki split-face: nawilżenie (j.u.) przed i po 4 tygodniach na połowie z preparatem i z podłożem; wylosowana strona",
                "120 klientek: 6 pozycji satysfakcji 1–5 i wynik (średnia pozycji) według rodzaju zabiegu",
                "60 par zdjęć ocenionych przez dwóch ekspertów w skali 0–4 (0 = brak poprawy, 4 = wyraźna poprawa)",
                "240 respondentek: grupa wieku i codzienne stosowanie kremu z filtrem"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
for (ark in list(list("Opis", opis), list("P1_parametry", p1), list("P2_split_face", p2[, 1:6]), list("P3_satysfakcja", p3),
                 list("P4_eksperci", p4), list("P5_fotoprotekcja", p5))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
saveWorkbook(wb, "../statystyka-kosmetologia-dane-przyklad.xlsx", overwrite = TRUE)
# Kontrola pliku: arkusze, liczba wierszy i metadane autora
sapply(getSheetNames("../statystyka-kosmetologia-dane-przyklad.xlsx"), function(s) nrow(read.xlsx("../statystyka-kosmetologia-dane-przyklad.xlsx", s)))
tmp <- tempfile(); unzip("../statystyka-kosmetologia-dane-przyklad.xlsx", exdir = tmp)
core <- paste(readLines(file.path(tmp, "docProps", "core.xml"), warn = FALSE, encoding = "UTF-8"), collapse = "")
cat("creator:", sub(".*<dc:creator>(.*?)</dc:creator>.*", "\\1", core), "| lastModifiedBy:",
    sub(".*<cp:lastModifiedBy>(.*?)</cp:lastModifiedBy>.*", "\\1", core), "\n")
cat("rozmiar KB:", round(file.info("../statystyka-kosmetologia-dane-przyklad.xlsx")$size / 1024), "\n")
Wynik w R
    polowa x    M   lo   hi
1  podłoże 1 2.20 0.48 3.93
2 preparat 2 5.85 4.05 7.66
     M    lo   hi        p
1 4.02 -1.71 9.74 0.165808
2 4.02  0.96 7.07 0.011662
3 3.65  1.67 5.63 0.000701
Zapisano ../statystyka-kosmetologia-split-face.svg: w HTML width="1000" height="520" (26 KB)
           parametr    d_z  dz_lo   dz_hi   p_holm
1 Nawilżenie (j.u.)  0.808  0.451  1.1648 3.54e-05
2     TEWL (g/m²/h) -0.732 -1.081 -0.3830 1.20e-04
3    Sebum (µg/cm²) -0.132 -0.443  0.1796 4.10e-01
4                pH -0.406 -0.728 -0.0834 2.85e-02
Zapisano ../statystyka-kosmetologia-zmiana-parametrow.svg: w HTML width="1000" height="480" (8 KB)
                    pozycja            zabieg odp proc
              Efekt zabiegu peeling chemiczny   5 43.1
              Efekt zabiegu  mikrodermabrazja   5 45.2
                    Komfort peeling chemiczny   5 58.6
                    Komfort  mikrodermabrazja   5 33.9
 Informacja przed zabiegiem peeling chemiczny   5 70.7
 Informacja przed zabiegiem  mikrodermabrazja   5 48.4
               Czas trwania peeling chemiczny   5 41.4
               Czas trwania  mikrodermabrazja   5 33.9
         Gotowość polecenia peeling chemiczny   5 55.2
         Gotowość polecenia  mikrodermabrazja   5 40.3
               Ocena ogólna peeling chemiczny   5 74.1
               Ocena ogólna  mikrodermabrazja   5 38.7
Zapisano ../statystyka-kosmetologia-satysfakcja.svg: w HTML width="1000" height="500" (19 KB)
            Opis     P1_parametry    P2_split_face   P3_satysfakcja
               5               40               32              120
     P4_eksperci P5_fotoprotekcja
              60              240
creator: Metodolog.pl | lastModifiedBy: Metodolog.pl
rozmiar KB: 26
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), shapiro.test(), p.adjust() i chisq.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizach prac z kosmetologii
- Dwie połowy twarzy albo dwa pomiary tej samej osoby analizowane jak niezależne grupy. W przykładzie zmieniło to wniosek z p < .001 na p = .166.
- Brak standaryzacji pomiaru aparaturowego albo brak jej opisu: pora dnia, aklimatyzacja, miejsce pomiaru, liczba odczytów.
- Porównywanie jednostek umownych z różnych aparatów w dyskusji wyników.
- Kilka parametrów skóry bez korekty na wielokrotne testy i bez wskazania parametru głównego.
- „Zabieg jest skuteczny” na podstawie schematu przed i po bez grupy kontrolnej. Wzrost mogą wyjaśniać pora roku, pielęgnacja domowa i regresja do średniej.
- Brak wielkości efektu albo d bez informacji, czy chodzi o dz, czy o miarę opartą na odchyleniach standardowych pomiarów.
- Średnia pojedynczej pozycji satysfakcji jako jedyny opis przy silnym efekcie sufitu.
- Zwykła kappa przy skali porządkowej albo kappa ważona bez podania rodzaju wag.
- Uogólnianie wyników ankiety z mediów społecznościowych na całą populację.
Najczęstsze pytania
Jak przeanalizować badanie split-face w pracy magisterskiej?
Dla każdej uczestniczki policz różnicę między połową twarzy z preparatem a połową z podłożem (najlepiej różnicę zmian od pomiaru wyjściowego) i porównaj średnią tych różnic z zerem testem t dla prób zależnych albo testem Wilcoxona dla par. Podaj średnią różnicę z 95% CI i dz. Opisz losowanie strony, zaślepienie i możliwość przenikania preparatu na drugą połowę.
Jaki test wybrać do pomiarów skóry przed i po zabiegu kosmetycznym?
Gdy te same osoby zmierzono dwa razy, użyj testu t dla prób zależnych, a przy wyraźnie nienormalnym rozkładzie różnic – testu Wilcoxona dla par. Jeśli mierzysz kilka parametrów (np. nawilżenie, TEWL, sebum, pH), skoryguj wartości p metodą Holma albo wskaż z góry jeden parametr główny.
Czy wyniki z korneometru można porównywać z innymi badaniami?
Ostrożnie. Aparaty do pomiaru nawilżenia podają zwykle wynik w jednostkach umownych właściwych dla urządzenia, a na pomiar wpływają warunki otoczenia, pora dnia i miejsce na skórze. Porównuj przede wszystkim zmianę u tych samych osób zmierzoną tym samym aparatem w ustandaryzowanych warunkach i opisz te warunki w pracy.
Czy w pracy z kosmetologii potrzebna jest grupa kontrolna?
Nie zawsze jest wymagana, ale bez niej nie przypiszesz zmiany samemu zabiegowi, bo ten sam efekt mogą dać pora roku, pielęgnacja domowa i regresja do średniej. Alternatywą jest schemat split-face z podłożem na drugiej połowie twarzy. W pracy bez kontroli pisz o zmianie po zabiegu, a nie o jego skuteczności.
Jak policzyć zgodność dwóch ekspertów oceniających zdjęcia przed i po zabiegu?
Przy ocenie w skali porządkowej (np. 0–4) policz kappę ważoną i podaj rodzaj wag, a obok odsetek ocen dokładnie zgodnych i różniących się o jeden punkt. Ekspertki powinny oceniać niezależnie, bez wiedzy o przydziale zabiegu, a zdjęcia muszą być wykonane w tych samych warunkach.
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →Piszesz pracę z kosmetologii i nie wiesz, jak policzyć wyniki zabiegu?
Pomożemy dobrać analizy do Twojego schematu – przed i po, split-face albo ankiety – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiała samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- du Plessis, J., Stefaniak, A., Eloff, F., John, S., Agner, T., Chou, T.-C., Nixon, R., Steiner, M., Franken, A., Kudla, I., & Holness, L. (2013). International guidelines for the in vivo assessment of skin properties in non-clinical settings: Part 2. Transepidermal water loss and skin hydration. Skin Research and Technology, 19(3), 265–278. https://doi.org/10.1111/srt.12037 ● Otwarty dostęp
- Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989x.1.2.170
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Leducq, S., Dugard, A., Allemang-Trivalle, A., Giraudeau, B., & Maruani, A. (2023). Design and methodological issues of within-person (split-body) randomized controlled trials evaluating a topical treatment: A systematic review. Dermatology, 239(5), 720–731. https://doi.org/10.1159/000530149 ● Otwarty dostęp: pełny tekst
- Lesaffre, E., Philstrom, B., Needleman, I., & Worthington, H. (2009). The design and analysis of split-mouth studies: What statisticians and clinicians should know. Statistics in Medicine, 28(28), 3470–3482. https://doi.org/10.1002/sim.3634
- Pandis, N., Chung, B., Scherer, R. W., Elbourne, D., & Altman, D. G. (2017). CONSORT 2010 statement: Extension checklist for reporting within person randomised trials. BMJ, 357, Article j2835. https://doi.org/10.1136/bmj.j2835 ● Otwarty dostęp
- Rogiers, V. (2001). EEMCO guidance for the assessment of transepidermal water loss in cosmetic sciences. Skin Pharmacology and Applied Skin Physiology, 14(2), 117–128. https://doi.org/10.1159/000056341
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{duplessis2013international, author={du Plessis, Johan and Stefaniak, Aleksandr and Eloff, Fritz and John, Swen and Agner, Tove and Chou, Tzu-Chieh and Nixon, Rosemary and Steiner, Markus and Franken, Anja and Kudla, Irena and Holness, Linn}, title={{International guidelines for the in vivo assessment of skin properties in non-clinical settings: Part 2. Transepidermal water loss and skin hydration}}, journal={Skin Research and Technology}, year={2013}, volume={19}, number={3}, pages={265--278}, doi={10.1111/srt.12037}}@article{dunlap1996metaanalysis, author={Dunlap, William P. and Cortina, Jose M. and Vaslow, Joel B. and Burke, Michael J.}, title={{Meta-analysis of experiments with matched groups or repeated measures designs}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={170--177}, doi={10.1037/1082-989x.1.2.170}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{leducq2023design, author={Leducq, Sophie and Dugard, Amandine and Allemang-Trivalle, Aude and Giraudeau, Bruno and Maruani, Annabel}, title={{Design and methodological issues of within-person (split-body) randomized controlled trials evaluating a topical treatment: A systematic review}}, journal={Dermatology}, year={2023}, volume={239}, number={5}, pages={720--731}, doi={10.1159/000530149}}@article{lesaffre2009design, author={Lesaffre, Emmanuel and Philstrom, Bruce and Needleman, Ian and Worthington, Helen}, title={{The design and analysis of split-mouth studies: What statisticians and clinicians should know}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={28}, pages={3470--3482}, doi={10.1002/sim.3634}}@article{pandis2017consort, author={Pandis, Nikolaos and Chung, Bryan and Scherer, Roberta W. and Elbourne, Diana and Altman, Douglas G.}, title={{CONSORT 2010 statement: Extension checklist for reporting within person randomised trials}}, journal={BMJ}, year={2017}, volume={357}, eid={j2835}, doi={10.1136/bmj.j2835}}@article{rogiers2001eemco, author={Rogiers, Vera}, title={{EEMCO guidance for the assessment of transepidermal water loss in cosmetic sciences}}, journal={Skin Pharmacology and Applied Skin Physiology}, year={2001}, volume={14}, number={2}, pages={117--128}, doi={10.1159/000056341}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}