Smartfon jako domyślne urządzenie respondenta
Link do ankiety internetowej trafia dziś zwykle do skrzynki, którą respondent sprawdza na telefonie. Peterson i in. (2017) dokumentują szybki wzrost udziału smartfonów w ankietach internetowych i pokazują, że zależy on od typu badania i źródła próby. Nie zakładaj więc żadnego odsetka z literatury. Sprawdź go w swoim pilotażu albo w poprzedniej edycji badania: typ urządzenia zapisuje większość narzędzi ankietowych jako paradane.
Ten wpis jest dla badacza, który projektuje ankietę internetową albo ma już dane i musi odpowiedzieć recenzentowi, czy urządzenie wpłynęło na wyniki. Ogólne pułapki układu na telefonie, z przykładami z audytów ankiet, opisuje wpis najczęstsze błędy w ankietach, a wybór programu – narzędzia do ankiet online. Tu idziemy dalej: które decyzje projektowe mają na małym ekranie największe znaczenie i jak policzyć ich wpływ.
Peterson i in. (2017) porządkują pierwszą decyzję tak: udział ze smartfonów możesz zablokować, zniechęcać do niego albo go dopuścić. Jeśli go dopuszczasz, musisz też zdecydować, czy kwestionariusz optymalizować pod urządzenia mobilne. Couper i in. (2017) opisują te wybory w ramach całkowitego błędu badania. Wykluczenie użytkowników telefonów zmienia pokrycie i brak odpowiedzi, a ich dopuszczenie bez dostosowania ankiety może zwiększyć błąd pomiaru. Projekt mobile-first oznacza, że ankietę projektujesz najpierw na mały ekran dotykowy, a dopiero potem sprawdzasz ją na komputerze. Odwrotna kolejność kończy się zwykle tabelą, którą na telefonie trzeba przewijać w poziomie.
Efekt urządzenia: kto odpowiada i jak odpowiada
Różnica wskaźników jakości między smartfonem a komputerem ma ten sam podwójny charakter co efekt trybu w ankiecie mieszanej. Częściowo wynika z selekcji, czyli z tego, kto wybiera telefon. Częściowo z pomiaru, czyli z tego, jak ta sama osoba odpowiada na małym ekranie. Rozkład tej różnicy na dwa składniki i metody ich rozdzielenia omawiamy szczegółowo we wpisie o ankiecie mieszanej i efekcie trybu. Tutaj wystarczy to, co mówią badania nad urządzeniami.
- Osoby z telefonem są inne. W probabilistycznych panelach internetowych osoby odpowiadające na urządzeniach mobilnych różniły się od użytkowników komputerów demografią. Smartfonów używali głównie młodzi (de Bruijne i Wijnant, 2014, w Social Science Computer Review).
- Część gorszej jakości to selekcja. W panelu LISS błąd pomiaru był większy na smartfonach i tabletach, ale u tych samych osób nie zmieniał się po zmianie urządzenia między falami. Lugtig i Toepoel (2016) wiążą więc różnicę z autoselekcją do urządzenia.
- Przy wygodnym układzie urządzenie niewiele zmienia. W randomizowanym eksperymencie naprzemiennym te same osoby na smartfonie częściej robiły coś innego jednocześnie, ale odpowiadały co najmniej równie starannie jak na komputerze. Wyjątkiem były małe suwaki i selektory daty (Antoun i in., 2017).
Wniosek dla analizy: surowe porównanie urządzeń nie mówi, czy ankieta działa na telefonie gorzej. Pokazuje błąd selekcji razem z efektem projektu. Wniosek dla projektu: masz wpływ na układ ankiety, nie na to, kto sięgnie po telefon.
Zasady projektu mobile-first
Strony: jedno pytanie na ekranie czy przewijanie
W eksperymencie, w którym respondenci wypełniali ankietę na urządzeniu mobilnym, układ przewijany dawał krótszy czas wypełniania, mniej problemów technicznych i lepsze oceny kwestionariusza niż układ stronicowany. Odsetek przerwań był niższy, ale różnica nie była istotna (Mavletova i Couper, 2014). Podobnie krótszy czas przy przewijaniu raportują de Bruijne i Wijnant w eksperymencie opisanym w Public Opinion Quarterly (2014). Skrajny format „jedno pytanie na ekranie” ma swój koszt: w formacie pytanie po pytaniu na smartfonie stale widoczny przycisk „dalej” wyraźnie zwiększał braki odpowiedzi (Revilla i Couper, 2018). Praktyczny kompromis to krótkie strony z kilkoma pytaniami na jeden temat, bez przewijania w poziomie, z przyciskiem „dalej” pod ostatnim pytaniem strony.
Siatki pytań
Couper i Peterson (2017) w analizie ankiet studenckich ustalili, że tylko około jednej piątej dłuższego czasu na smartfonach przypada na ładowanie stron. Dużą część reszty tłumaczyło dodatkowe przewijanie, zwłaszcza w pytaniach tabelarycznych. Kiedy siatkę zachować, jak ją rozbić i ile pozycji zmieścić na ekranie, opisujemy we wpisie o pytaniach matrycowych. Dla telefonu reguła jest krótka: nie dopuść do tabeli szerszej niż ekran. Jeśli narzędzie samo zamienia siatkę na listę pytań na wąskim ekranie, sprawdź, jak wygląda ta lista i czy etykiety skali są przy każdej pozycji.
Przyciski, suwaki i skale
Antoun i in. (2017) zauważyli, że na ekranie dotykowym respondenci mieli kłopot z dokładnym ustawieniem małego uchwytu suwaka i kółka wyboru daty. Jeśli potrzebujesz skali ciągłej, przeczytaj o pułapkach wartości domyślnej w haśle skala VAS. Ci sami autorzy (de Bruijne i Wijnant, 2014, Public Opinion Quarterly) zalecają ostrożność przy skalach poziomych i skalach z wieloma kategoriami. Na telefonie bezpieczniejszy jest pionowy układ przycisków z pełną etykietą przy każdej kategorii i polem dotyku obejmującym cały wiersz.
Pytania otwarte
W eksperymencie Mavletovej (2013) odpowiedzi na pytania otwarte były na telefonie krótsze niż na komputerze. Odsetek odpowiedzi społecznie niepożądanych i odpowiedzi niemerytorycznych był podobny. Ogranicz więc pytania otwarte do tych, które naprawdę analizujesz. Zadawaj je konkretnie, a do liczb używaj pola liczbowego z zakresem. Jeśli długość odpowiedzi otwartej jest dla Ciebie zmienną, porównuj ją między urządzeniami tylko z kontrolą cech respondentów.
Długość, czas i przerwania
Na telefonie w tym samym eksperymencie ankietę rzadziej kończono (Mavletova, 2013). Każda zbędna strona to więc większe obciążenie respondenta, a na końcu ankiety więcej zmęczenia. Ponieważ ankieta na smartfonie trwa dłużej, jeden próg czasu dla wszystkich urządzeń przy wykrywaniu zbyt szybkiego wypełniania łatwiej oznaczy osoby z komputerem. Progi wyznaczaj względem mediany w obrębie urządzenia, a krzywą przerwań i czasy stron analizuj jak we wpisie o paradanych w ankiecie online.
| Element | Ryzyko na telefonie | Co zrobić |
|---|---|---|
| Siatka pytań | Przewijanie w poziomie, dłuższy czas, jednolite odpowiedzi | Pozycje jedna pod drugą albo kilka krótkich bloków; etykiety skali przy każdej pozycji |
| Suwak, kółko daty | Niedokładne ustawienie wartości | Przyciski albo pole liczbowe; jeśli suwak, to szeroki i bez wartości domyślnej |
| Skala pozioma, wiele kategorii | Ucięte etykiety, przypadkowe dotknięcia | Pionowe przyciski z pełnymi etykietami; mniej kategorii |
| Pytanie otwarte | Krótsze odpowiedzi | Tylko pytania, które analizujesz; konkretne polecenie; pole liczbowe do liczb |
| Długa ankieta | Więcej przerwań, dłuższy czas | Skróć; zapisuj stronę przerwania i urządzenie |
Przed startem sprawdź każdą ścieżkę na kilku telefonach według listy z wpisu test techniczny ankiety online.
Przykład: urządzenie i losowo przydzielony układ ankiety
Najlepszy dowód, że projekt działa na telefonie, daje mały eksperyment wbudowany w ankietę. W symulacji 3000 osób zaczyna ankietę. Urządzenie wybiera sam respondent: smartfon wybrało 1526 osób, komputer 1474. Osoby z telefonem były młodsze (średnio 38.8 wobec 54.3 roku). Narzędzie losowo pokazuje połowie osób baterię 8 pytań jako siatkę, a drugiej połowie w układzie mobile-first, czyli pytanie pod pytaniem z pionowymi przyciskami. Mierzymy trzy rzeczy: przerwanie ankiety, straightlining (identyczna odpowiedź we wszystkich 8 pozycjach, liczony u osób, które skończyły) i czas wypełnienia. W danych straightlining jest częstszy u osób młodszych i mniej zaangażowanych w temat. Zaangażowanie mierzy pytanie na początku ankiety.
| Urządzenie i układ | Przerwania | Straightlining (kończący) | Mediana czasu |
|---|---|---|---|
| Komputer, mobile-first | 5.5% | 5.5% | 11.0 min |
| Komputer, siatka | 6.3% | 5.6% | 11.3 min |
| Smartfon, mobile-first | 7.2% | 7.5% | 12.4 min |
| Smartfon, siatka | 17.4% | 20.3% | 14.4 min |
Do analizy użyj regresji logistycznej z interakcją urządzenie × układ oraz wiekiem, wykształceniem i zaangażowaniem. Współczynnik interakcji na skali logitów trudno przełożyć na decyzję projektową, dlatego podaj wyniki jako różnice odsetków, czyli średnie efekty krańcowe (AME) z pakietu marginaleffects. Na smartfonie siatka zwiększyła odsetek straightliningu o 12.6 punktu procentowego, 95% CI [9.0, 16.3]. Na komputerze nie zmieniła go wcale: −0.1 punktu, 95% CI [−2.5, 2.3]. Różnica tych dwóch efektów wyniosła 12.7 punktu, 95% CI [8.4, 17.0], p < .001. To jest efekt interakcji na skali odsetków, i to efekt przyczynowy, bo układ był losowany w obrębie każdej grupy urządzeń.
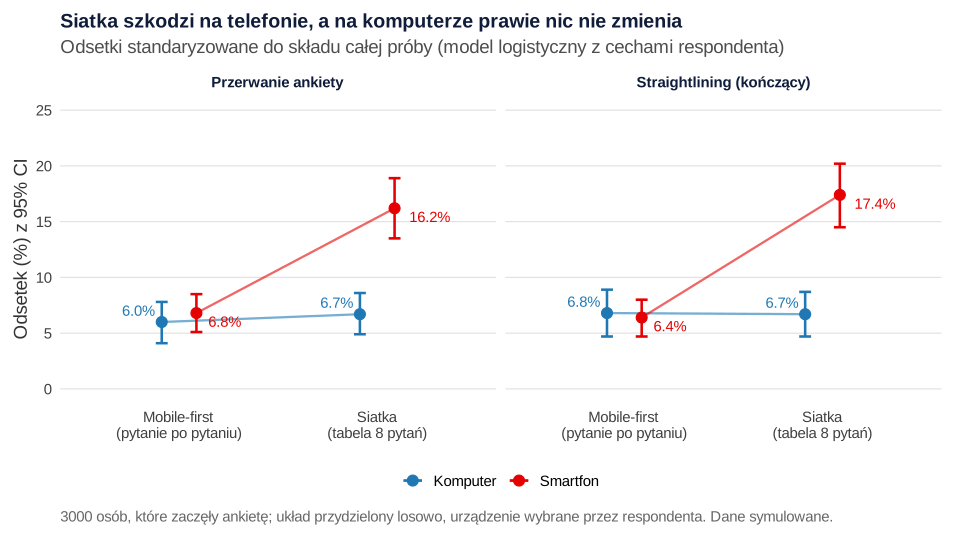
Rysunek 1 pokazuje odsetki standaryzowane, czyli takie, jakie dałaby cała próba na danym urządzeniu i w danym układzie. Po usunięciu różnic w składzie grup układ mobile-first na telefonie wypada tak samo jak na komputerze: 6.4% straightliningu wobec 6.8%. Siatka na telefonie daje 17.4% straightliningu i 16.2% przerwań. Mediana czasu wzrosła w niej do 14.4 minuty.
Efekt urządzenia: surowo i z kontrolą cech respondenta
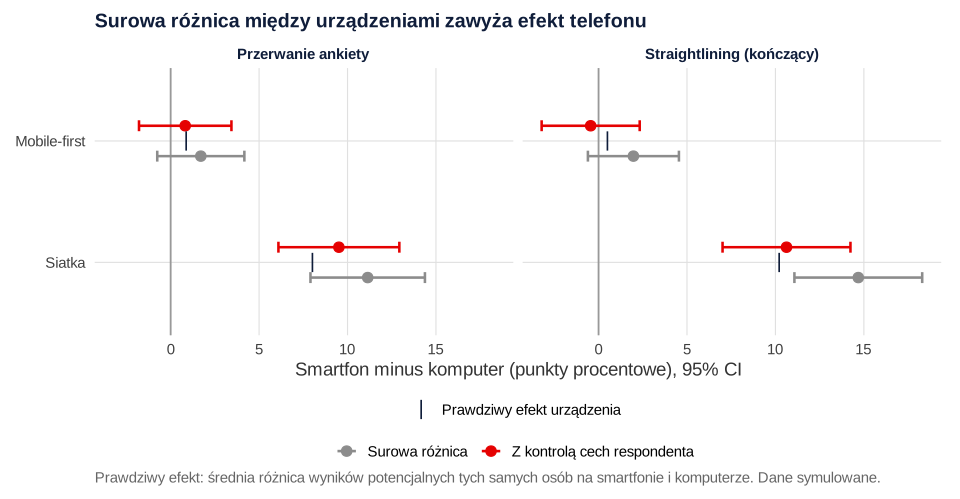
Recenzent częściej pyta odwrotnie: czy osoby z telefonem odpowiadały gorzej? Tu urządzenia nikt nie losował, więc porównanie surowe i porównanie z kontrolą cech dają różne odpowiedzi. Ponieważ dane są symulowane, znamy też prawdziwy efekt urządzenia. Każda osoba ma dwa wyniki potencjalne: jak odpowiedziałaby na smartfonie i jak na komputerze.
| Wynik i układ | Surowa różnica [95% CI] | Z kontrolą cech [95% CI] | Prawdziwy efekt |
|---|---|---|---|
| Straightlining, siatka | 14.7 [11.1, 18.3] | 10.6 [7.0, 14.2] | 10.2 |
| Straightlining, mobile-first | 2.0 [−0.6, 4.5] | −0.4 [−3.2, 2.3] | 0.5 |
| Przerwanie, siatka | 11.1 [7.9, 14.4] | 9.5 [6.1, 12.9] | 8.0 |
| Przerwanie, mobile-first | 1.7 [−0.8, 4.2] | 0.8 [−1.8, 3.4] | 0.9 |
Surowa różnica zawyża efekt telefonu, bo telefon wybierają młodsi, a młodsi w tych danych częściej odpowiadają jednolicie. Po kontroli wieku, wykształcenia i zaangażowania oszacowania zbliżają się do prawdy (Rysunek 2). Zwróć uwagę na wiersz „straightlining, mobile-first”. Surowa różnica 2.0 punktu sugeruje gorsze odpowiedzi na telefonie, choć dobrze zaprojektowana ankieta prawie ich nie pogarsza.
Ziarno losowania wybraliśmy tak, żeby jedna próba była typowa. Rysunek 3 pokazuje 300 powtórzeń całego badania. Surowa różnica zawyżała efekt telefonu na straightlining średnio o 2.76 punktu w układzie mobile-first i o 4.55 punktu w siatce. Przy przerwaniach zawyżenie wyniosło 0.98 i 1.32 punktu. Z kontrolą cech obciążenie mieściło się między −0.06 a 0.14 punktu. Odchylenie standardowe oszacowań między powtórzeniami wynosiło 1.3–1.9 punktu, więc pojedyncza próba może odbiegać od prawdy o kilka punktów w obie strony.
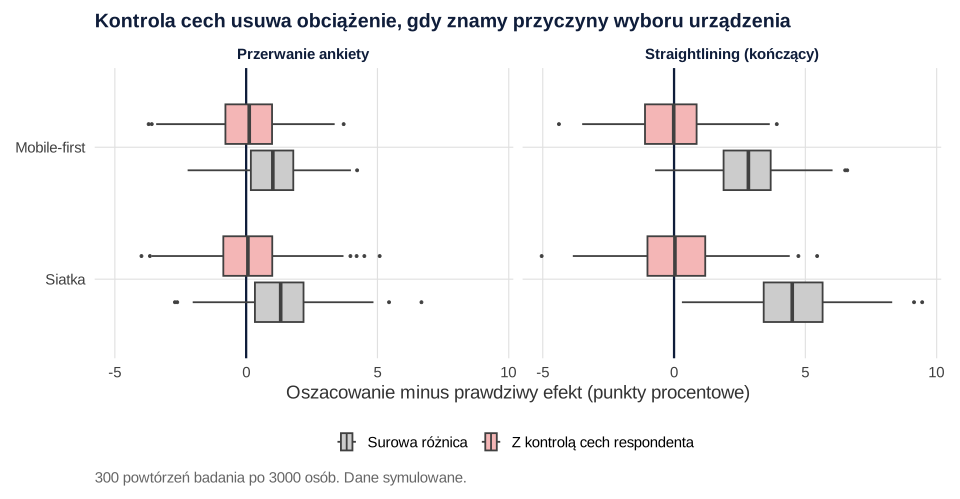
Dwa zastrzeżenia. Po pierwsze, korekta zadziałała, bo w symulacji wybór urządzenia zależał tylko od zmiennych, które mierzymy. W prawdziwych danych zawsze zostaje selekcja przez cechy niemierzone, dlatego wynik dla urządzenia opisuj jako związek po kontroli, a nie efekt przyczynowy. Po drugie, straightlining liczymy tylko u osób, które skończyły ankietę. Siatka na telefonie zwiększała też przerwania, więc w tej grupie mogło odpaść więcej mniej zaangażowanych osób. Odsetek straightliningu bywa wtedy zaniżony. Przerwania i jakość odpowiedzi raportuj zawsze razem.
Jak opisać urządzenie i układ w artykule
Podaj odsetek wypełnień na każdym urządzeniu i porównanie składu grup. Opisz, czy ankietę optymalizowano pod telefon i czy układ był losowany. Wskaż, jakie cechy kontrolowano i na jakiej skali podajesz efekty. Jeśli wyniki opierasz tylko na osobach, które skończyły ankietę, napisz to wprost.
Jeśli recenzent pyta o jakość danych z telefonów, możemy przygotować taką analizę razem z opisem w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi korzysta z funkcji z pierwszego). Pierwszy zapisuje dane, które widzi badacz, do pliku ankieta-telefon.csv (możesz go pobrać tutaj). Potrzebny pakiet: marginaleffects.
1. Urządzenie, układ i jakość odpowiedzi
R
# Krok 1. Ankieta online: urządzenie (smartfon albo komputer) i losowo przydzielony układ ankiety (dane symulowane)
# Urządzenie wybiera respondent (selekcja), układ losuje narzędzie ankietowe (eksperyment).
suppressPackageStartupMessages(library(marginaleffects))

generuj <- function(n) {
  wiek <- round(runif(n, 18, 75))
  wyzsze <- rbinom(n, 1, plogis(0.2 - 0.02 * (wiek - 45)))
  zaang <- rnorm(n)                                  # zaangażowanie w temat (mierzone na początku ankiety, z-score)
  smartfon <- rbinom(n, 1, plogis(0.4 - 0.07 * (wiek - 45) - 0.4 * wyzsze))
  siatka <- sample(rep(0:1, length.out = n))         # 1 = bateria 8 pytań w tabeli, 0 = mobile-first: pytanie po pytaniu
  # Prawdopodobieństwa w obu „światach” urządzenia (wyniki potencjalne); efekt telefonu zależy od układu
  logit_przerw <- function(s) -2.9 - 0.4 * zaang - 0.01 * (wiek - 45) + 0.15 * s + 0.1 * siatka + 0.75 * s * siatka
  logit_sl <- function(s) -2.6 - 0.5 * zaang - 0.03 * (wiek - 45) - 0.3 * wyzsze + 0.10 * s + 0.2 * siatka + 0.8 * s * siatka
  u1 <- runif(n); u2 <- runif(n)                     # te same liczby losowe w obu światach
  przerw_s <- as.integer(u1 < plogis(logit_przerw(1))); przerw_k <- as.integer(u1 < plogis(logit_przerw(0)))
  sl_s <- as.integer(u2 < plogis(logit_sl(1)));         sl_k <- as.integer(u2 < plogis(logit_sl(0)))
  # Czas wypełnienia (min): dłużej na telefonie, najdłużej w siatce na telefonie (przewijanie w poziomie)
  e <- rnorm(n, 0, 0.35)
  czas_s <- exp(log(11) + 0.12 + 0.13 * siatka + e); czas_k <- exp(log(11) + e)
  przerwanie <- ifelse(smartfon == 1, przerw_s, przerw_k)
  sl <- ifelse(przerwanie == 1, NA, ifelse(smartfon == 1, sl_s, sl_k))   # straightlining tylko u kończących
  czas <- ifelse(przerwanie == 1, NA, ifelse(smartfon == 1, czas_s, czas_k))
  data.frame(wiek, wyzsze, zaang, smartfon, siatka, przerwanie, straightlining = sl, czas,
             przerw_s, przerw_k, sl_s, sl_k)
}

set.seed(3641)
d <- generuj(3000)
d$urzadzenie <- factor(ifelse(d$smartfon == 1, "smartfon", "komputer"), levels = c("komputer", "smartfon"))
d$uklad <- factor(ifelse(d$siatka == 1, "siatka", "mobile-first"), levels = c("mobile-first", "siatka"))
write.csv(transform(d[, c("wiek", "wyzsze", "zaang", "urzadzenie", "uklad", "przerwanie", "straightlining", "czas")],
                    zaang = round(zaang, 3), czas = round(czas, 1)), "ankieta-telefon.csv", row.names = FALSE)

cat("Urządzenie:\n"); print(table(d$urzadzenie))
round(sapply(split(d[, c("wiek", "wyzsze", "zaang")], d$urzadzenie), colMeans), 3)

# Surowe odsetki: przerwania (wszyscy, którzy zaczęli) i straightlining (kończący)
odsetki <- function(y) round(100 * tapply(d[[y]], list(d$urzadzenie, d$uklad), mean, na.rm = TRUE), 1)
cat("Przerwania (%):\n"); print(odsetki("przerwanie"))
cat("Straightlining w baterii 8 pytań (% kończących):\n"); print(odsetki("straightlining"))
cat("Mediana czasu wypełnienia (min):\n"); print(round(tapply(d$czas, list(d$urzadzenie, d$uklad), median, na.rm = TRUE), 1))

# Modele logistyczne z interakcją urządzenie × układ i cechami respondenta
m_przerw <- glm(przerwanie ~ urzadzenie * uklad + wiek + wyzsze + zaang, family = binomial, data = d)
m_sl <- glm(straightlining ~ urzadzenie * uklad + wiek + wyzsze + zaang, family = binomial, data = d)
print(round(summary(m_sl)$coefficients, 3))

# Efekt urządzenia (smartfon − komputer, punkty procentowe) w każdym układzie: surowo i z kontrolą cech
efekt_urz <- function(m, y) {
  sur <- glm(reformulate("urzadzenie * uklad", y), family = binomial, data = d)
  f <- function(mod) { a <- avg_comparisons(mod, variables = "urzadzenie", by = "uklad")
    data.frame(uklad = a$uklad, est = 100 * a$estimate, dolna = 100 * a$conf.low, gorna = 100 * a$conf.high) }
  rbind(cbind(model = "surowy", f(sur)), cbind(model = "z kontrolą cech", f(m)))
}
ez_p <- efekt_urz(m_przerw, "przerwanie"); ez_s <- efekt_urz(m_sl, "straightlining")
# Prawda (znana tylko w symulacji): średnia różnica wyników potencjalnych u wszystkich, którzy zaczęli / skończyli
k <- d$przerwanie == 0
prawda_p <- tapply(d$przerw_s - d$przerw_k, d$uklad, mean) * 100
prawda_s <- tapply(d$sl_s[k] - d$sl_k[k], d$uklad[k], mean) * 100
cat("Efekt smartfona na przerwania (pp):\n"); print(ez_p, digits = 3, row.names = FALSE); print(round(prawda_p, 1))
cat("Efekt smartfona na straightlining (pp):\n"); print(ez_s, digits = 3, row.names = FALSE); print(round(prawda_s, 1))

# Efekt układu (siatka − mobile-first) osobno na komputerze i smartfonie – układ był losowany
eu <- avg_comparisons(m_sl, variables = "uklad", by = "urzadzenie")
print(data.frame(urzadzenie = eu$urzadzenie, pp = round(100 * eu$estimate, 1),
                 dolna = round(100 * eu$conf.low, 1), gorna = round(100 * eu$conf.high, 1), p = round(eu$p.value, 4)))
# Czy efekt układu różni się między urządzeniami? (różnica różnic)
hip <- avg_comparisons(m_sl, variables = "uklad", by = "urzadzenie", hypothesis = ~ pairwise)
round(c(roznica_pp = 100 * hip$estimate, dolna = 100 * hip$conf.low, gorna = 100 * hip$conf.high, p = hip$p.value), 4)

# Odsetki standaryzowane: cała próba „przełączona” kolejno na każde urządzenie i każdy układ (do rysunku 1)
stand <- function(m, nazwa) { a <- avg_predictions(m, variables = c("urzadzenie", "uklad"))
  data.frame(wynik = nazwa, urzadzenie = a$urzadzenie, uklad = a$uklad,
             proc = round(100 * a$estimate, 1), dolna = round(100 * a$conf.low, 1), gorna = round(100 * a$conf.high, 1)) }
pred <- rbind(stand(m_przerw, "Przerwanie ankiety"), stand(m_sl, "Straightlining (kończący)"))
print(pred, row.names = FALSE)
write.csv(pred, "przewidywane.csv", row.names = FALSE)
write.csv(rbind(cbind(wynik = "przerwanie", ez_p, prawda = prawda_p[ez_p$uklad]),
                cbind(wynik = "straightlining", ez_s, prawda = prawda_s[ez_s$uklad])), "efekt-urzadzenia.csv", row.names = FALSE)
Wynik w R
Urządzenie:

komputer smartfon
    1474     1526
       komputer smartfon
wiek     54.339   38.846
wyzsze    0.539    0.537
zaang    -0.015   -0.031
Przerwania (%):
         mobile-first siatka
komputer          5.5    6.3
smartfon          7.2   17.4
Straightlining w baterii 8 pytań (% kończących):
         mobile-first siatka
komputer          5.5    5.6
smartfon          7.5   20.3
Mediana czasu wypełnienia (min):
         mobile-first siatka
komputer         11.0   11.3
smartfon         12.4   14.4
                               Estimate Std. Error z value Pr(>|z|)
(Intercept)                      -1.473      0.326  -4.519    0.000
urzadzeniesmartfon               -0.075      0.236  -0.317    0.751
ukladsiatka                      -0.017      0.238  -0.070    0.944
wiek                             -0.027      0.005  -5.424    0.000
wyzsze                           -0.156      0.142  -1.100    0.271
zaang                            -0.599      0.074  -8.075    0.000
urzadzeniesmartfon:ukladsiatka    1.207      0.297   4.061    0.000
Efekt smartfona na przerwania (pp):
           model        uklad    est  dolna gorna
          surowy mobile-first  1.705 -0.757  4.17
          surowy       siatka 11.140  7.905 14.38
 z kontrolą cech mobile-first  0.824 -1.789  3.44
 z kontrolą cech       siatka  9.511  6.094 12.93
mobile-first       siatka
         0.9          8.0
Efekt smartfona na straightlining (pp):
           model        uklad    est  dolna gorna
          surowy mobile-first  1.971 -0.602  4.54
          surowy       siatka 14.685 11.073 18.30
 z kontrolą cech mobile-first -0.446 -3.218  2.33
 z kontrolą cech       siatka 10.626  7.010 14.24
mobile-first       siatka
         0.5         10.2
  urzadzenie   pp dolna gorna      p
1   komputer -0.1  -2.5   2.3 0.9445
2   smartfon 12.6   9.0  16.3 0.0000
roznica_pp      dolna      gorna          p
   12.7218     8.3965    17.0472     0.0000
                     wynik urzadzenie        uklad proc dolna gorna
        Przerwanie ankiety   komputer mobile-first  6.0   4.1   7.8
        Przerwanie ankiety   komputer       siatka  6.7   4.9   8.6
        Przerwanie ankiety   smartfon mobile-first  6.8   5.1   8.5
        Przerwanie ankiety   smartfon       siatka 16.2  13.5  18.9
 Straightlining (kończący)   komputer mobile-first  6.8   4.7   8.9
 Straightlining (kończący)   komputer       siatka  6.7   4.7   8.7
 Straightlining (kończący)   smartfon mobile-first  6.4   4.7   8.0
 Straightlining (kończący)   smartfon       siatka 17.4  14.5  20.2
2. Powtórzenia: czy próba była typowa
R
# Krok 2. Czy ziarno z kroku 1 dało typową próbę? 300 powtórzeń całego badania (wymaga funkcji generuj() z kroku 1)
jedno_badanie <- function() {
  x <- generuj(3000)
  x$urzadzenie <- factor(ifelse(x$smartfon == 1, "smartfon", "komputer"), levels = c("komputer", "smartfon"))
  x$uklad <- factor(ifelse(x$siatka == 1, "siatka", "mobile-first"), levels = c("mobile-first", "siatka"))
  k <- x$przerwanie == 0
  efekt <- function(f) 100 * avg_comparisons(glm(f, family = binomial, data = x), variables = "urzadzenie", by = "uklad")$estimate
  c(sur_przerw = efekt(przerwanie ~ urzadzenie * uklad),
    kor_przerw = efekt(przerwanie ~ urzadzenie * uklad + wiek + wyzsze + zaang),
    sur_sl = efekt(straightlining ~ urzadzenie * uklad),
    kor_sl = efekt(straightlining ~ urzadzenie * uklad + wiek + wyzsze + zaang),
    prawda_przerw = 100 * tapply(x$przerw_s - x$przerw_k, x$uklad, mean),
    prawda_sl = 100 * tapply(x$sl_s[k] - x$sl_k[k], x$uklad[k], mean))
}
set.seed(3642)
mc <- t(replicate(300, jedno_badanie()))
colnames(mc) <- paste(rep(c("sur_przerw", "kor_przerw", "sur_sl", "kor_sl", "prawda_przerw", "prawda_sl"), each = 2),
                      c("mobile-first", "siatka"), sep = "_")
uk <- c("mobile-first", "siatka")
wyn <- do.call(rbind, lapply(1:4, function(i) do.call(rbind, lapply(1:2, function(j) {
  x <- mc[, (i - 1) * 2 + j]; cel <- mc[, if (i <= 2) 8 + j else 10 + j]
  data.frame(estymator = c("surowy", "z kontrolą cech")[2 - i %% 2], wynik = c("przerwanie", "straightlining")[(i + 1) %/% 2],
             uklad = uk[j], srednia = mean(x), prawda = mean(cel), obciazenie = mean(x - cel), SD = sd(x),
             blad_MC = sd(x - cel) / sqrt(nrow(mc)))
}))))
options(width = 110)
print(wyn, digits = 2, row.names = FALSE)
write.csv(data.frame(mc[, 1:8] - mc[, c(9, 10, 9, 10, 11, 12, 11, 12)]), "mc-bledy.csv", row.names = FALSE)
Wynik w R
       estymator          wynik        uklad srednia prawda obciazenie  SD blad_MC
          surowy     przerwanie mobile-first    1.82   0.85      0.977 1.3   0.070
          surowy     przerwanie       siatka    8.80   7.48      1.321 1.5   0.082
 z kontrolą cech     przerwanie mobile-first    0.99   0.85      0.139 1.3   0.075
 z kontrolą cech     przerwanie       siatka    7.52   7.48      0.034 1.5   0.087
          surowy straightlining mobile-first    3.41   0.64      2.764 1.4   0.079
          surowy straightlining       siatka   13.40   8.86      4.547 1.9   0.098
 z kontrolą cech straightlining mobile-first    0.58   0.64     -0.063 1.5   0.086
 z kontrolą cech straightlining       siatka    8.97   8.86      0.110 1.9   0.103
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (modele glm() z pakietu stats) z pakietem marginaleffects; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Projekt na komputerze i „sprawdzenie” na telefonie na końcu. Szerokie siatki i suwaki zostają wtedy w ankiecie, bo na poprawki brakuje już czasu.
- Surowe porównanie urządzeń nazwane efektem telefonu. To suma selekcji i efektu projektu. W przykładzie surowa różnica pokazała 2.0 punktu więcej straightliningu na telefonie przy prawdziwym efekcie 0.5.
- Blokowanie telefonów „dla jakości danych”. Zamienia błąd pomiaru na błąd pokrycia i braku odpowiedzi wśród osób, które korzystają głównie z telefonu.
- Współczynnik interakcji na skali logitów jako jedyny wynik. Podaj różnice odsetków (AME) w każdej grupie i ich różnicę z przedziałem ufności.
- Jakość odpowiedzi bez przerwań. Jeśli układ zwiększa przerwania, grupa kończących się zmienia, a odsetek straightliningu może być zaniżony.
- Jeden próg czasu dla wszystkich urządzeń. Ankieta na telefonie trwa dłużej, więc wspólny próg łatwiej oznaczy osoby z komputerem.
Najczęstsze pytania
Czy ankieta wypełniana na smartfonie daje gorsze dane?
Nie musi. W eksperymencie naprzemiennym te same osoby odpowiadały na smartfonie co najmniej równie starannie jak na komputerze, a kłopot sprawiały głównie małe suwaki i selektory daty (Antoun i in., 2017). Gorsze wskaźniki u osób z telefonem często wynikają z tego, kim są te osoby, a nie z urządzenia.
Jedno pytanie na ekranie czy przewijanie w ankiecie na telefon?
Badania nie dają jednej reguły. W eksperymentach na smartfonach układ przewijany skracał czas wypełniania, ale w formacie pytanie po pytaniu ze stale widocznym przyciskiem „dalej” rosły braki odpowiedzi. Praktyczny kompromis to krótkie strony z kilkoma pytaniami na jeden temat, bez przewijania w poziomie.
Czy blokować wypełnianie ankiety na telefonie?
Zwykle nie. Blokada albo zniechęcanie wykluczają osoby, które korzystają głównie z telefonu, więc zamieniają błąd pomiaru na błąd pokrycia i braku odpowiedzi. Lepiej dopuścić telefon, zaprojektować ankietę najpierw na mały ekran i zapisywać typ urządzenia.
Jak sprawdzić, czy urządzenie wpłynęło na odpowiedzi w ankiecie?
Porównaj wskaźniki jakości (przerwania, straightlining, długość odpowiedzi otwartych) w regresji z urządzeniem i cechami, które mogą wpływać na wybór urządzenia, i podaj średnie różnice odsetków (AME). Pewniejszy wniosek o projekcie da losowy przydział układu ankiety, bo wtedy selekcja nie miesza się z efektem.
Dlaczego ankieta na telefonie trwa dłużej?
Couper i Peterson (2017) ustalili, że tylko około jednej piątej różnicy przypada na ładowanie stron, a reszta to czas spędzony na stronie, w dużej mierze na przewijaniu, zwłaszcza w siatkach pytań. Dlatego progi czasu do wykrywania zbyt szybkiego wypełniania warto ustalać osobno dla urządzeń.
Powiązane hasła
Przeczytaj też
Ankieta mieszana i efekt trybu badania
Selekcja a efekt pomiaru w ankiecie internetowo-telefonicznej: kowarianty, wagi, próba referencyjna, eksperyment i inwariancja w R.
Czytaj →PoradnikPytania matrycowe (siatki) w ankiecie
Kiedy siatka wystarcza, a kiedy zawyża alfę i korelacje między skalami: wyniki eksperymentów, zasady projektu i symulacja w R.
Czytaj →PoradnikParadane w ankiecie online
Czasy stron, speeding na poziomie strony, krzywa przerwań Kaplana–Meiera i model wielopoziomowy czasu odpowiedzi w R.
Czytaj →Część respondentów wypełniła ankietę na telefonie i recenzent pyta o jakość danych?
Pomożemy przygotować analizę wskaźników jakości według urządzenia z kontrolą cech respondentów, zaplanować eksperyment z układem ankiety i opisać wyniki tak, żebyś samodzielnie obronił(a) je przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Antoun, C., Couper, M. P., & Conrad, F. G. (2017). Effects of mobile versus PC web on survey response quality: A crossover experiment in a probability web panel. Public Opinion Quarterly, 81(S1), 280–306. https://doi.org/10.1093/poq/nfw088 ● Otwarty dostęp
- Couper, M. P., & Peterson, G. J. (2017). Why do web surveys take longer on smartphones? Social Science Computer Review, 35(3), 357–377. https://doi.org/10.1177/0894439316629932
- Couper, M. P., Antoun, C., & Mavletova, A. (2017). Mobile web surveys. In P. P. Biemer, E. de Leeuw, S. Eckman, B. Edwards, F. Kreuter, L. E. Lyberg, N. C. Tucker, & B. T. West (Eds.), Total survey error in practice (pp. 133–154). Wiley. https://doi.org/10.1002/9781119041702.ch7
- de Bruijne, M., & Wijnant, A. (2014). Improving response rates and questionnaire design for mobile web surveys. Public Opinion Quarterly, 78(4), 951–962. https://doi.org/10.1093/poq/nfu046
- de Bruijne, M., & Wijnant, A. (2014). Mobile response in web panels. Social Science Computer Review, 32(6), 728–742. https://doi.org/10.1177/0894439314525918
- Lugtig, P., & Toepoel, V. (2016). The use of PCs, smartphones, and tablets in a probability-based panel survey: Effects on survey measurement error. Social Science Computer Review, 34(1), 78–94. https://doi.org/10.1177/0894439315574248 ● Otwarty dostęp: pełny tekst
- Mavletova, A. (2013). Data quality in PC and mobile web surveys. Social Science Computer Review, 31(6), 725–743. https://doi.org/10.1177/0894439313485201
- Mavletova, A., & Couper, M. P. (2014). Mobile web survey design: Scrolling versus paging, SMS versus e-mail invitations. Journal of Survey Statistics and Methodology, 2(4), 498–518. https://doi.org/10.1093/jssam/smu015
- Peterson, G., Griffin, J., LaFrance, J., & Li, J. (2017). Smartphone participation in web surveys. In P. P. Biemer, E. de Leeuw, S. Eckman, B. Edwards, F. Kreuter, L. E. Lyberg, N. C. Tucker, & B. T. West (Eds.), Total survey error in practice (pp. 203–233). Wiley. https://doi.org/10.1002/9781119041702.ch10
- Revilla, M., & Couper, M. P. (2018). Comparing grids with vertical and horizontal item-by-item formats for PCs and smartphones. Social Science Computer Review, 36(3), 349–368. https://doi.org/10.1177/0894439317715626
Cytowania BibTeX
@article{antoun2017effects, author={Antoun, Christopher and Couper, Mick P. and Conrad, Frederick G.}, title={{Effects of mobile versus PC web on survey response quality: A crossover experiment in a probability web panel}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={280--306}, doi={10.1093/poq/nfw088}}@article{couper2017why, author={Couper, Mick P. and Peterson, Gregg J.}, title={{Why do web surveys take longer on smartphones?}}, journal={Social Science Computer Review}, year={2017}, volume={35}, number={3}, pages={357--377}, doi={10.1177/0894439316629932}}@incollection{couper2017mobile, author={Couper, Mick P. and Antoun, Christopher and Mavletova, Aigul}, title={{Mobile web surveys}}, booktitle={Total survey error in practice}, year={2017}, pages={133--154}, publisher={Wiley}, doi={10.1002/9781119041702.ch7}}@article{debruijne2014improving, author={de Bruijne, Marika and Wijnant, Arnaud}, title={{Improving response rates and questionnaire design for mobile web surveys}}, journal={Public Opinion Quarterly}, year={2014}, volume={78}, number={4}, pages={951--962}, doi={10.1093/poq/nfu046}}@article{debruijne2014mobile, author={de Bruijne, Marika and Wijnant, Arnaud}, title={{Mobile response in web panels}}, journal={Social Science Computer Review}, year={2014}, volume={32}, number={6}, pages={728--742}, doi={10.1177/0894439314525918}}@article{lugtig2016use, author={Lugtig, Peter and Toepoel, Vera}, title={{The use of PCs, smartphones, and tablets in a probability-based panel survey: Effects on survey measurement error}}, journal={Social Science Computer Review}, year={2016}, volume={34}, number={1}, pages={78--94}, doi={10.1177/0894439315574248}}@article{mavletova2013data, author={Mavletova, Aigul}, title={{Data quality in PC and mobile web surveys}}, journal={Social Science Computer Review}, year={2013}, volume={31}, number={6}, pages={725--743}, doi={10.1177/0894439313485201}}@article{mavletova2014mobile, author={Mavletova, Aigul and Couper, Mick P.}, title={{Mobile web survey design: Scrolling versus paging, SMS versus e-mail invitations}}, journal={Journal of Survey Statistics and Methodology}, year={2014}, volume={2}, number={4}, pages={498--518}, doi={10.1093/jssam/smu015}}@incollection{peterson2017smartphone, author={Peterson, Gregg and Griffin, Jamie and LaFrance, John and Li, JiaoJiao}, title={{Smartphone participation in web surveys}}, booktitle={Total survey error in practice}, year={2017}, pages={203--233}, publisher={Wiley}, doi={10.1002/9781119041702.ch10}}@article{revilla2018comparing, author={Revilla, Melanie and Couper, Mick P.}, title={{Comparing grids with vertical and horizontal item-by-item formats for PCs and smartphones}}, journal={Social Science Computer Review}, year={2018}, volume={36}, number={3}, pages={349--368}, doi={10.1177/0894439317715626}}