Po co skracać i co możesz stracić
Kwestionariusz ma 20 pozycji, a w planowanym badaniu obok niego jest jeszcze sześć innych skal. Wypełnianie się wydłuża, rośnie obciążenie respondenta i ryzyko zmęczenia. Stanton i in. (2002) zwracają uwagę, że dłuższe ankiety zajmują więcej czasu, mają więcej braków danych i więcej odmów. Metaanaliza Rolstad i in. (2011) też wskazała, że dłuższe kwestionariusze miały niższy odsetek odpowiedzi. Autorzy zastrzegają jednak, że wpływu długości nie dało się oddzielić od wpływu treści. Skrócenie skali bywa więc rozsądne. Nie jest jednak darmowe.
Czym jest skrócona wersja kwestionariusza i o ile spada jej rzetelność, wyjaśnia hasło w słowniku. Tutaj zajmujemy się samą procedurą: jak wybrać pozycje i jak sprawdzić wynik. Smith, McCarthy i Anderson (2000) opisali typowe „grzechy” autorów wersji skróconych. Najważniejszy to założenie, że trafność pełnej wersji przechodzi automatycznie na wersję krótką. Zaproponowali też kroki, które warto zaplanować przed analizą. Kruyen, Emons i Sijtsma (2013) przejrzeli testy skrócone opisane w latach 2005–2010. Wpływ skrócenia na rzetelność i trafność często oceniano w nich niewystarczająco. Jeśli dopiero budujesz narzędzie od zera, zacznij od wpisu o budowie i walidacji skali psychometrycznej.
Zanim usuniesz pierwszą pozycję
Decyzje o skróceniu podejmij przed analizą i zapisz je, najlepiej w planie analizy. Potrzebujesz odpowiedzi na pięć pytań.
| Decyzja | Pytanie | Przykład |
|---|---|---|
| Cel wyniku | Do czego posłuży wynik: badania korelacyjne, przesiewu czy decyzji o osobie? | przesiew osób o podwyższonym stresie |
| Zakres cechy | Dla jakich poziomów cechy pomiar ma być najdokładniejszy? | od średniego do wysokiego (θ od 0 do 2.5) |
| Mapa treści | Które obszary konstruktu muszą zostać? | cztery obszary, w każdym co najmniej dwie pozycje |
| Długość | Ile pozycji i jaka minimalna rzetelność? | 8 pozycji, ω ≥ .80 |
| Dwie próby | Na czym wybierasz pozycje, a na czym sprawdzasz wersję? | konstrukcyjna n = 600, walidacyjna n = 500 |
Ostatni wiersz jest kluczowy. Pozycje wybrane na jednej próbie mają oszacowania korzystnie zawyżone przez przypadek. To ten sam mechanizm co przeuczenie modelu predykcyjnego. Dlatego rzetelność i trafność wersji krótkiej sprawdzasz na nowych danych. Jeśli masz tylko jeden zbiór, podziel go losowo (walidacja krzyżowa), ale opisz to jako ograniczenie.
Przykład: skala stresu akademickiego
Symulowana skala ma 20 pozycji z odpowiedziami 1–5 i cztery obszary treści po pięć pozycji: egzaminy i oceny (E), obciążenie nauką (O), finanse (F) oraz relacje na uczelni (R). Dane wygenerowano z modelu z czynnikiem ogólnym i czynnikami specyficznymi obszarów, czyli ze struktury podobnej do modelu bifactor. Pozycje egzaminacyjne mają najwyższe ładunki ogólne. Kryterium trafności to myśli o rezygnacji ze studiów. Zależą one od stresu ogólnego, ale też wyraźnie od stresu finansowego. Próbę konstrukcyjną możesz pobrać jako plik CSV (600 osób, 20 pozycji, płeć i kryterium).
Jednoczynnikowa konfirmacyjna analiza czynnikowa (CFA) wszystkich 20 pozycji w próbie konstrukcyjnej dopasowała się umiarkowanie: CFI = .928, RMSEA = .053, SRMR = .041. Na tej próbie porównaliśmy trzy sposoby wyboru ośmiu pozycji:
- A – najwyższe ładunki. Osiem pozycji o największych ładunkach czynnikowych, bez względu na treść.
- B – ładunki z pokryciem treści. Po dwie pozycje o najwyższych ładunkach w każdym obszarze.
- C – informacja IRT z pokryciem treści. Po dwie pozycje w każdym obszarze, które dają najwięcej informacji w zakresie θ od 0 do 2.5.
Dobór według ładunków: pułapka wąskiej treści
Wersja A to E1–E4 i O1–O4. Cztery pierwsze pozycje egzaminacyjne miały ładunki .72–.83, a pozycje o finansach i relacjach tylko .34–.55. Strategia A wyrzuciła więc całe dwa obszary treści. Statystycznie wygląda to dobrze, bo pozycje podobne do siebie dają wysoką spójność wewnętrzną. Stanton i in. (2002) ostrzegają właśnie przed skracaniem przez maksymalizowanie spójności wewnętrznej. Wysoki ładunek w modelu jednoczynnikowym może wynikać z treści wspólnej dla jednego obszaru, a nie z lepszego pomiaru całego konstruktu. Wtedy wersja krótka mierzy węższą cechę niż pełna.
Dlatego najpierw ustal mapę treści, a dopiero w jej ramach wybieraj pozycje według ładunków (wersja B). Warto też sprawdzić jednowymiarowość pełnej skali i ocenę ekspertów (trafność treściowa). Jeśli obszary są ważnymi podskalami, dwie pozycje na obszar wystarczą do wyniku ogólnego. Nie wystarczą do osobnych wyników podskal.
Dobór według informacji w IRT
W teorii odpowiedzi na pozycje każda pozycja ma funkcję informacji: pokazuje, przy jakim poziomie cechy pozycja najlepiej różnicuje osoby. Informacja testu to suma informacji pozycji, a błąd standardowy θ równa się 1/√informacji. Dzięki temu możesz wybrać pozycje dla konkretnego zakresu cechy. Ładunek nie daje takiej możliwości, bo nie mówi, przy jakim poziomie cechy pozycja działa najlepiej. Dopasowaliśmy model odpowiedzi stopniowanej (GRM) w pakiecie mirt (Chalmers, 2012). Szczegóły takiej analizy opisuje wpis IRT w R krok po kroku.
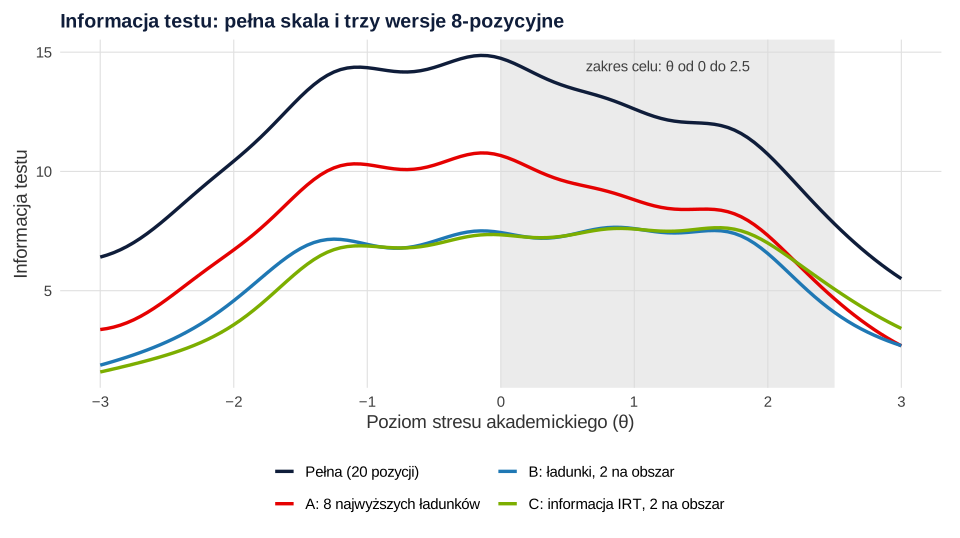
Średnia informacja w zakresie celu wyniosła 12.05 dla pełnej skali, 8.37 dla wersji A, 6.95 dla B i 7.15 dla C. Przy θ = 1.5 błąd standardowy θ wynosił odpowiednio 0.29, 0.34, 0.37 i 0.36. Wersja A jest najdokładniejsza, ale tylko dlatego, że składa się z pozycji jednego, najlepiej mierzonego obszaru. Wersja C różni się od B dwiema pozycjami: E3 zamiast E4 i F3 zamiast F4, bo dają one więcej informacji w zakresie celu. Zysk jest niewielki, ale pokazuje zasadę: przy tej samej mapie treści informacja IRT pozwala dopasować wersję do celu. Pokrycie treści kosztuje część dokładności. To świadomy kompromis, który trzeba opisać.
Sprawdzenie na nowej próbie
Wszystkie trzy wersje sprawdziliśmy na próbie walidacyjnej (n = 500). Rzetelność wyniku sumarycznego opisuje omega McDonalda z jednoczynnikowej CFA. Flora (2020) pokazuje, jak dobrać odmianę omegi do modelu pomiarowego. Wersja krótka powinna też korelować z pozycjami, których nie zawiera. Trzeci wskaźnik to trafność kryterialna.
| Wersja | ω | CFI | RMSEA | r z pozostałymi pozycjami | r z myślami o rezygnacji [95% CI] |
|---|---|---|---|---|---|
| Pełna (20) | .909 | .919 | .058 | – | .368 [.290, .441] |
| A: najwyższe ładunki | .882 | .939 | .104 | .797 | .316 [.235, .393] |
| B: ładunki, 2 na obszar | .847 | .978 | .053 | .859 | .345 [.265, .420] |
| C: informacja IRT, 2 na obszar | .843 | .957 | .074 | .837 | .335 [.255, .410] |
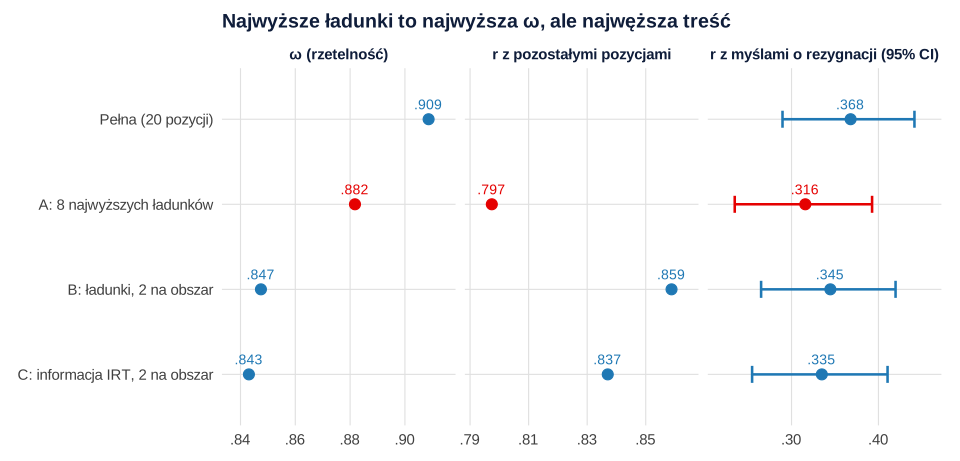
Wersja A ma najwyższą omegę spośród wersji krótkich (.882), ale RMSEA = .104 zdradza, że w gruncie rzeczy mierzy dwa obszary, a nie jedną cechę. Najsłabiej koreluje też z pominiętymi pozycjami (.797) i z kryterium (.316). Wersje B i C mają omegę około .84–.85, czyli powyżej założonego progu .80, i lepiej odtwarzają związek z kryterium. Przedziały ufności korelacji z kryterium mocno na siebie zachodzą. Przy n = 500 nie dowodzą więc różnicy między wersjami. Kierunek wynika jednak z konstrukcji wersji: kto usuwa pozycje o finansach, traci związek z wynikiem, który od finansów zależy. Credé i in. (2012) pokazali podobne zjawisko na bardzo krótkich miarach Wielkiej Piątki. Takie miary mogą zaniżać związki osobowości z zachowaniem. W prawdziwym badaniu dołóż też dowody trafności zbieżnej i różnicowej.
Korelacja z pełną wersją: korekta na wspólne pozycje
Najczęściej raportowany wskaźnik to korelacja wersji krótkiej z pełną. Policzona na tych samych odpowiedziach jest zawyżona. Pełna wersja zawiera pozycje wersji krótkiej, więc obie dzielą także ich błędy pomiaru. Levy (1967) opisał korektę tej pozornej korelacji. Prosta wersja takiej korekty odejmuje od kowariancji wspólną wariancję błędu wersji krótkiej:
Tu S to wynik wersji krótkiej, F – pełnej, a ρS to rzetelność wersji krótkiej (omega albo alfa). Wynik przybliża korelację, jaką dałyby dwie wersje wypełnione niezależnie. W symulacji mogliśmy to sprawdzić, bo te same osoby wypełniły skalę drugi raz, z nowymi błędami. Dla wersji B surowa korelacja wyniosła .959. Po korekcie spadła do .885, a przy niezależnym wypełnieniu wyniosła .895. Dla porównania pełna wersja korelowała sama ze sobą przy dwóch wypełnieniach na poziomie .918. To górna granica, której żadna wersja krótka nie przekroczy.
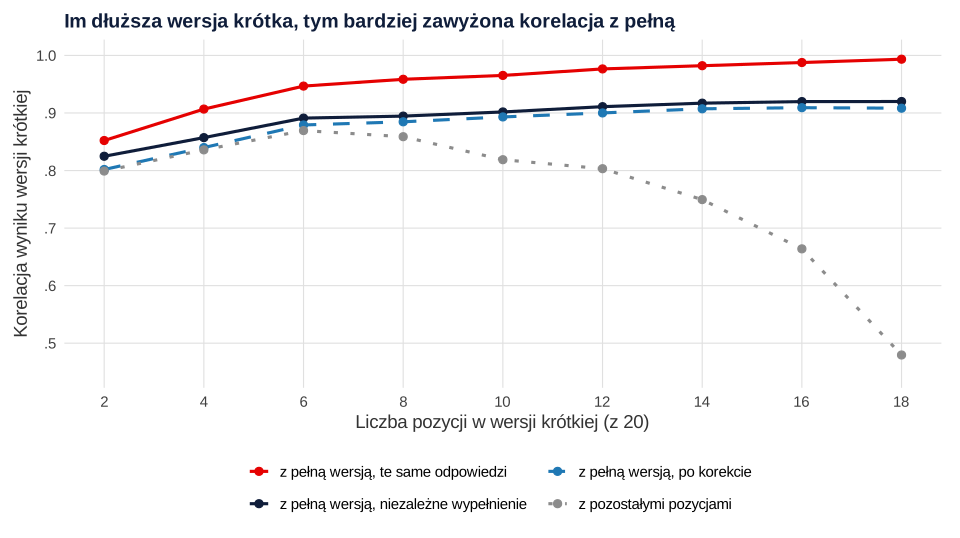
Im więcej wspólnych pozycji, tym większe zawyżenie. Przy 18 z 20 pozycji surowa korelacja wynosi .993, choć niezależne wypełnienie daje .920. Korelacja z pozostałymi pozycjami, którą podaje hasło słownikowe, jest dobrą kontrolą dla krótkich wersji. Przy długich wersjach przestaje działać, bo „pozostałe” to już tylko dwie pozycje (.480 przy 18). Najlepszy dowód daje osobne podanie obu wersji, np. w odstępie kilku dni, choć wtedy do błędu dochodzi zmiana cechy.
Inwariancja i dalsze kroki
Jeśli wersja krótka ma służyć do porównań grup, sprawdź inwariancję pomiaru. Krótka skala ma mniej pozycji, więc jedna pozycja działająca inaczej w grupach (DIF) waży w niej więcej. Putnick i Bornstein (2016) opisują typową sekwencję: model konfiguracyjny, metryczny i skalarny. W wersji C dopuściliśmy z góry korelacje reszt w parach pozycji z tego samego obszaru, bo dzielą one treść. Model konfiguracyjny dla dwóch grup płci dopasował się dobrze, χ²(32) = 34.04, CFI = .998, RMSEA = .016. Równość ładunków, Δχ²(7) = 3.67, p = .817, i wyrazów wolnych, Δχ²(7) = 7.89, p = .343, nie pogorszyła dopasowania. Marsh i in. (2005) pokazali, jak tę samą logikę wielogrupowej CFA wykorzystać do porównania wersji krótkiej z pełną i próby walidacyjnej z próbą pierwotną.
Na koniec sprawdź, czy normy i punkty odcięcia pełnej wersji nadają się do wersji krótkiej. Zwykle trzeba je ustalić od nowa, bo zmienia się zakres wyniku i jego rozkład.
Jak opisać skrócenie w artykule
Podaj kryteria wyboru pozycji ustalone przed analizą, próbę konstrukcyjną i walidacyjną, rzetelność, korelację z pełną wersją razem z metodą korekty, trafność oraz zakres sprawdzonej inwariancji. Jeśli wybór lub walidacja pozycji budzą wątpliwości recenzenta, możemy wspólnie przejrzeć analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik stres-akademicki-20-pozycji.csv (możesz go pobrać tutaj). Potrzebne pakiety: lavaan i mirt.
1. Dane, CFA, GRM i wybór trzech wersji
R
# Dane symulowane: skala stresu akademickiego, 20 pozycji 1–5, cztery obszary treści po 5 pozycji
# (E = egzaminy i oceny, O = obciążenie nauką, F = finanse, R = relacje na uczelni).
# Model generujący: czynnik ogólny + czynniki specyficzne obszarów (struktura bifactor).
# Próba konstrukcyjna (n = 600) służy do wyboru pozycji, próba walidacyjna (n = 500) – do sprawdzenia.
suppressPackageStartupMessages({library(lavaan); library(mirt)})
set.seed(3380)
obszar <- rep(c("E", "O", "F", "R"), each = 5)
pozycje <- paste0(obszar, rep(1:5, 4))
l_ogolny <- c(.78, .80, .76, .74, .45,  .68, .66, .70, .64, .42,  .58, .60, .55, .57, .40,  .62, .58, .60, .52, .38)
l_obszar <- rep(c(.40, .25, .30, .25), each = 5)
progi_baza <- c(-1.6, -0.6, 0.3, 1.2)
przesun <- c(-1.3, 0.4, 0.9, 0.2, 0,  -1.2, 0.8, 0, 0.6, 0,  0.9, -1.2, 0.5, 0, 0.3,  -1.0, 0.7, 0, 0.8, 0.2)  # „trudność” pozycji

generuj <- function(n, ogolny = rnorm(n), spec = matrix(rnorm(n * 4), n)) {
  X <- sapply(1:20, function(j) {
    f <- match(obszar[j], c("E", "O", "F", "R"))
    y <- l_ogolny[j] * ogolny + l_obszar[j] * spec[, f] + rnorm(n, 0, sqrt(1 - l_ogolny[j]^2 - l_obszar[j]^2))
    cut(y, c(-Inf, progi_baza + przesun[j], Inf), labels = FALSE)
  })
  colnames(X) <- pozycje
  data.frame(X, ogolny = ogolny, finanse = spec[, 3])
}
konstr <- generuj(600)
konstr$plec <- rbinom(600, 1, .55)
# Kryterium: myśli o rezygnacji ze studiów (zależą od stresu ogólnego i od stresu finansowego)
konstr$rezygnacja <- round(0.30 * konstr$ogolny + 0.45 * konstr$finanse + rnorm(600, 0, 0.84), 2)
write.csv(konstr[, c(pozycje, "plec", "rezygnacja")], "stres-akademicki-20-pozycji.csv", row.names = FALSE)

# 1. Jednoczynnikowa CFA wszystkich 20 pozycji: ładunki standaryzowane
cfa20 <- cfa(paste("stres =~", paste(pozycje, collapse = " + ")), data = konstr, estimator = "MLR")
lad <- subset(standardizedSolution(cfa20), op == "=~")$est.std
names(lad) <- pozycje
round(fitMeasures(cfa20, c("cfi.robust", "rmsea.robust", "srmr")), 3)

# 2. Model odpowiedzi stopniowanych (GRM) i informacja pozycji w zakresie θ od 0 do 2.5
#    (cel wersji krótkiej: odróżniać osoby o podwyższonym i wysokim stresie)
grm <- mirt(konstr[, pozycje], 1, itemtype = "graded", verbose = FALSE)
theta <- matrix(seq(-3, 3, by = 0.05))
info <- sapply(1:20, function(j) iteminfo(extract.item(grm, j), theta))
colnames(info) <- pozycje
w_celu <- theta[, 1] >= 0 & theta[, 1] <= 2.5
info_cel <- colMeans(info[w_celu, ])
print(data.frame(obszar, ladunek = round(lad, 2), a_GRM = round(coef(grm, simplify = TRUE)$items[, "a1"], 2),
                 info_0_2.5 = round(info_cel, 2)))

# 3. Trzy wersje 8-pozycyjne
wybierz_w_obszarach <- function(kryt) unlist(lapply(split(pozycje, obszar), function(p) p[order(-kryt[p])][1:2]))
wersje <- list(A_ladunki = names(sort(-lad))[1:8],               # 8 najwyższych ładunków, bez względu na treść
               B_ladunki_obszary = wybierz_w_obszarach(lad),     # 2 najwyższe ładunki w każdym obszarze
               C_informacja_obszary = wybierz_w_obszarach(info_cel))  # 2 pozycje o największej informacji w zakresie celu
wersje <- lapply(wersje, function(p) pozycje[pozycje %in% p])
print(sapply(wersje, paste, collapse = " "))
t(sapply(wersje, function(p) table(factor(substr(p, 1, 1), levels = c("E", "O", "F", "R")))))
# 4. Informacja testu (suma informacji pozycji) i błąd standardowy θ: średnio w zakresie celu i przy θ = 1.5
info_testu <- sapply(c(list(pelna_20 = pozycje), wersje), function(p) rowSums(info[, p, drop = FALSE]))
round(rbind(info_0_2.5 = colMeans(info_testu[w_celu, ]),
            SE_theta_1.5 = 1 / sqrt(info_testu[theta[, 1] == 1.5, ]),
            info_m1_0 = colMeans(info_testu[theta[, 1] >= -1 & theta[, 1] < 0, ])), 2)
Wynik w R
  cfi.robust rmsea.robust         srmr
       0.928        0.053        0.041
   obszar ladunek a_GRM info_0_2.5
E1      E    0.72  2.96       0.55
E2      E    0.83  3.22       2.38
E3      E    0.77  2.51       1.72
E4      E    0.78  2.50       1.52
E5      E    0.53  1.15       0.38
O1      O    0.56  1.49       0.30
O2      O    0.64  1.55       0.70
O3      O    0.65  1.59       0.69
O4      O    0.59  1.34       0.51
O5      O    0.35  0.69       0.14
F1      F    0.54  1.20       0.42
F2      F    0.51  1.24       0.23
F3      F    0.53  1.14       0.39
F4      F    0.53  1.15       0.39
F5      F    0.43  0.90       0.25
R1      R    0.51  1.22       0.26
R2      R    0.54  1.18       0.41
R3      R    0.55  1.24       0.44
R4      R    0.45  0.91       0.25
R5      R    0.34  0.64       0.12
                A_ladunki         B_ladunki_obszary      C_informacja_obszary
"E1 E2 E3 E4 O1 O2 O3 O4" "E2 E4 O2 O3 F1 F4 R2 R3" "E2 E3 O2 O3 F1 F3 R2 R3"
                     E O F R
A_ladunki            4 4 0 0
B_ladunki_obszary    2 2 2 2
C_informacja_obszary 2 2 2 2
             pelna_20 A_ladunki B_ladunki_obszary C_informacja_obszary
info_0_2.5      12.05      8.37              6.95                 7.15
SE_theta_1.5     0.29      0.34              0.37                 0.36
info_m1_0       14.46     10.38              7.11                 7.02
2. Walidacja na nowej próbie i inwariancja
R
# Sprawdzenie trzech wersji na NOWEJ próbie walidacyjnej (n = 500; wymaga obiektów z przepisu 1).
# W symulacji te same osoby wypełniają skalę drugi raz niezależnie (nowe błędy pomiaru) –
# daje to wartość odniesienia dla korelacji wersji krótkiej z pełną bez wspólnych błędów.
set.seed(3382)
n_w <- 500
ogolny <- rnorm(n_w); spec <- matrix(rnorm(n_w * 4), n_w)
walid <- generuj(n_w, ogolny, spec)          # pierwsze wypełnienie
powt <- generuj(n_w, ogolny, spec)           # niezależne drugie wypełnienie (tylko w symulacji)
walid$plec <- rbinom(n_w, 1, .55)
walid$rezygnacja <- 0.30 * walid$ogolny + 0.45 * walid$finanse + rnorm(n_w, 0, 0.84)

# Omega (ω total) z jednoczynnikowej CFA: (Σλ)² / ((Σλ)² + Σθ)
omega_cfa <- function(p, d) {
  m <- cfa(paste("f =~", paste(p, collapse = " + ")), data = d, estimator = "MLR", std.lv = TRUE)
  pe <- parameterEstimates(m)
  l <- pe$est[pe$op == "=~"]; th <- pe$est[pe$op == "~~" & pe$lhs == pe$rhs & pe$lhs %in% p]
  c(omega = sum(l)^2 / (sum(l)^2 + sum(th)), fitMeasures(m, c("cfi.robust", "rmsea.robust", "srmr")))
}
pelna <- rowSums(walid[, pozycje]); pelna_powt <- rowSums(powt[, pozycje])
ocen <- function(p) {
  S <- rowSums(walid[, p]); reszta <- rowSums(walid[, setdiff(pozycje, p)])
  om <- omega_cfa(p, walid)
  # Korekta na wspólne pozycje: usuń z kowariancji S z pełną wersją wariancję błędu S, (1 − ω_S)·var(S)
  r_kor <- (cov(S, pelna) - (1 - om[["omega"]]) * var(S)) / (sd(S) * sd(pelna))
  c(om, r_pelna = cor(S, pelna), r_pelna_kor = r_kor, r_pelna_niezal = cor(S, pelna_powt),
    r_reszta = cor(S, reszta), r_rezygnacja = cor(S, walid$rezygnacja))
}
wyniki <- rbind(pelna_20 = c(omega_cfa(pozycje, walid), r_pelna = 1, r_pelna_kor = NA,
                             r_pelna_niezal = cor(pelna, pelna_powt), r_reszta = NA,
                             r_rezygnacja = cor(pelna, walid$rezygnacja)),
                t(sapply(wersje, ocen)))
round(wyniki, 3)

# Przedział ufności dla korelacji z kryterium (transformacja Fishera)
sapply(c(list(pelna_20 = pozycje), wersje), function(p) {
  ct <- cor.test(rowSums(walid[, p]), walid$rezygnacja); round(c(r = unname(ct$estimate), ct$conf.int), 3) })

# Inwariancja wersji C względem płci: konfiguracyjna, metryczna, skalarna.
# Pary pozycji z tego samego obszaru mają skorelowane reszty (wspólna treść, ustalone przed analizą).
pary <- split(wersje$C_informacja_obszary, substr(wersje$C_informacja_obszary, 1, 1))
model_C <- paste(c(paste("f =~", paste(wersje$C_informacja_obszary, collapse = " + ")),
                   sapply(pary, paste, collapse = " ~~ ")), collapse = "\n")
inw <- lapply(list(konfiguracyjna = "", metryczna = "loadings", skalarna = c("loadings", "intercepts")),
              function(r) cfa(model_C, data = walid, group = "plec", estimator = "MLR", group.equal = r))
round(t(sapply(inw, fitMeasures, c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr"))), 3)
lavTestLRT(inw$konfiguracyjna, inw$metryczna, inw$skalarna)
Wynik w R
                     omega cfi.robust rmsea.robust  srmr r_pelna r_pelna_kor
pelna_20             0.909      0.919        0.058 0.045   1.000          NA
A_ladunki            0.882      0.939        0.104 0.050   0.938       0.881
B_ladunki_obszary    0.847      0.978        0.053 0.030   0.959       0.885
C_informacja_obszary 0.843      0.957        0.074 0.039   0.951       0.876
                     r_pelna_niezal r_reszta r_rezygnacja
pelna_20                      0.918       NA        0.368
A_ladunki                     0.887    0.797        0.316
B_ladunki_obszary             0.895    0.859        0.345
C_informacja_obszary          0.886    0.837        0.335
  pelna_20 A_ladunki B_ladunki_obszary C_informacja_obszary
r    0.368     0.316             0.345                0.335
     0.290     0.235             0.265                0.255
     0.441     0.393             0.420                0.410
               chisq.scaled df cfi.robust rmsea.robust  srmr
konfiguracyjna       34.036 32      0.998        0.016 0.023
metryczna            38.020 39      1.000        0.000 0.030
skalarna             45.880 46      1.000        0.000 0.034

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

                   Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
inw$konfiguracyjna 32 10531 10767 35.640
inw$metryczna      39 10521 10727 39.094     3.6671 0.000000       7     0.8172
inw$skalarna       46 10515 10692 46.963     7.8865 0.022482       7     0.3427
3. Zawyżenie korelacji a długość wersji krótkiej
R
# Zawyżenie korelacji wersji krótkiej z pełną a długość wersji krótkiej (wymaga obiektów z przepisów 1–2).
# Pozycje dodawane po kolei: najwyższy ładunek w każdym obszarze, potem drugi najwyższy itd.
kolejnosc <- unlist(lapply(1:5, function(r) sapply(split(pozycje, obszar)[c("E", "O", "F", "R")],
                                                   function(p) p[order(-lad[p])][r])))
alfa <- function(M) { m <- ncol(M); m / (m - 1) * (1 - sum(apply(M, 2, var)) / var(rowSums(M))) }
krzywa <- t(sapply(seq(2, 18, by = 2), function(k) {
  p <- kolejnosc[1:k]; S <- rowSums(walid[, p]); a <- alfa(walid[, p])
  c(k = k, alfa = a, r_pelna = cor(S, pelna),
    r_pelna_kor = (cov(S, pelna) - (1 - a) * var(S)) / (sd(S) * sd(pelna)),
    r_pelna_niezal = cor(S, pelna_powt), r_reszta = cor(S, rowSums(walid[, setdiff(pozycje, p)])))
}))
print(round(as.data.frame(krzywa), 3), row.names = FALSE)
Wynik w R
  k  alfa r_pelna r_pelna_kor r_pelna_niezal r_reszta
  2 0.679   0.852       0.802          0.825    0.799
  4 0.747   0.907       0.840          0.857    0.836
  6 0.822   0.947       0.879          0.891    0.869
  8 0.846   0.959       0.885          0.895    0.859
 10 0.878   0.965       0.893          0.902    0.819
 12 0.889   0.977       0.900          0.911    0.803
 14 0.903   0.982       0.907          0.917    0.749
 16 0.908   0.988       0.909          0.920    0.664
 18 0.909   0.993       0.908          0.920    0.480
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i mirt; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wybór i walidacja na tych samych danych. Rzetelność i trafność wersji krótkiej liczone na próbie, na której wybrano pozycje, są optymistyczne.
- Osiem najwyższych ładunków bez mapy treści. Daje wysoką spójność kosztem zawężenia konstruktu.
- Surowa korelacja z pełną wersją jako dowód równoważności. Wspólne pozycje zawyżają ją tym bardziej, im dłuższa wersja krótka.
- Normy i punkty odcięcia przeniesione z pełnej wersji. Inny zakres wyniku wymaga nowych norm.
- Cytowanie walidacji pełnej wersji. Wersja krótka potrzebuje własnych dowodów rzetelności i trafności.
- Brak zapisu, które pozycje usunięto i dlaczego. Bez tego nikt nie odtworzy wersji ani jej nie porówna.
Najczęstsze pytania
Ile pozycji powinna mieć skrócona wersja skali?
Nie ma jednej liczby. Liczbę pozycji wyznaczają trzy warunki ustalone przed analizą: minimalna rzetelność dla planowanego zastosowania, pokrycie wszystkich obszarów treści i dokładność w zakresie cechy, który Cię interesuje. W przykładzie osiem pozycji, po dwie z czterech obszarów, dało ω = .843–.847 w nowej próbie. Pamiętaj, że dwie pozycje na obszar wystarczą do wyniku ogólnego, ale nie do osobnych wyników podskal.
Czy wybierać pozycje do wersji krótkiej według ładunków czynnikowych?
Tak, ale w ramach mapy treści. Same najwyższe ładunki często pochodzą z jednego obszaru, który ma wspólną treść, więc wersja krótka mierzy węższy konstrukt. W przykładzie osiem najwyższych ładunków pominęło pozycje o finansach i relacjach: ω było najwyższe (.882), ale korelacja z kryterium spadła do .316 wobec .368 w pełnej wersji.
Jak skorygować korelację wersji skróconej z pełną?
Od kowariancji obu wyników odejmij wariancję błędu wersji krótkiej, (1 − ρS) · var(S), i podziel przez iloczyn odchyleń standardowych. Wynik przybliża korelację przy niezależnym wypełnieniu obu wersji. W przykładzie surowe r = .959 spadło po korekcie do .885, a przy niezależnym wypełnieniu wyniosło .895. Podaj w artykule obie wartości i metodę korekty.
Do czego przydaje się IRT przy skracaniu kwestionariusza?
Funkcja informacji pokazuje, przy jakim poziomie cechy każda pozycja najlepiej różnicuje osoby. Dzięki temu możesz zbudować wersję dokładną tam, gdzie jej potrzebujesz, np. przy wysokim nasileniu w badaniu przesiewowym. Ładunek w CFA nie zawiera tej informacji. W przykładzie wybór pozycji według informacji w zakresie θ od 0 do 2.5 dał nieco więcej informacji niż wybór według ładunków przy tej samej mapie treści (7.15 wobec 6.95).
Czy normy z pełnej wersji kwestionariusza pasują do wersji skróconej?
Zwykle nie. Wersja krótka ma inny zakres wyniku, inny rozkład i inną rzetelność, więc progi i normy pełnej wersji nie przenoszą się na nią wprost. Ustal je na nowo w próbie walidacyjnej, a punkty odcięcia sprawdź np. krzywą ROC na niezależnych danych.
Powiązane hasła
Przeczytaj też
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikIRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →Skracasz skalę do dużego badania albo recenzent pyta o walidację wersji krótkiej?
Pomożemy zaplanować wybór pozycji, przeprowadzić CFA i analizę IRT oraz sprawdzić rzetelność, trafność i inwariancję wersji skróconej tak, żebyś mógł(a) samodzielnie opisać i obronić decyzje.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06 ● Otwarty dostęp
- Credé, M., Harms, P., Niehorster, S., & Gaye-Valentine, A. (2012). An evaluation of the consequences of using short measures of the Big Five personality traits. Journal of Personality and Social Psychology, 102(4), 874–888. https://doi.org/10.1037/a0027403
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Kruyen, P. M., Emons, W. H. M., & Sijtsma, K. (2013). On the shortcomings of shortened tests: A literature review. International Journal of Testing, 13(3), 223–248. https://doi.org/10.1080/15305058.2012.703734 ● Otwarty dostęp: pełny tekst
- Levy, P. (1967). The correction for spurious correlation in the evaluation of short-form tests. Journal of Clinical Psychology, 23(1), 84–86. https://doi.org/10.1002/1097-4679(196701)23:1<84::aid-jclp2270230123>3.0.co;2-2
- Marsh, H. W., Ellis, L. A., Parada, R. H., Richards, G., & Heubeck, B. G. (2005). A short version of the Self Description Questionnaire II: Operationalizing criteria for short-form evaluation with new applications of confirmatory factor analyses. Psychological Assessment, 17(1), 81–102. https://doi.org/10.1037/1040-3590.17.1.81
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Rolstad, S., Adler, J., & Rydén, A. (2011). Response burden and questionnaire length: Is shorter better? A review and meta-analysis. Value in Health, 14(8), 1101–1108. https://doi.org/10.1016/j.jval.2011.06.003 ● Otwarty dostęp
- Smith, G. T., McCarthy, D. M., & Anderson, K. G. (2000). On the sins of short-form development. Psychological Assessment, 12(1), 102–111. https://doi.org/10.1037/1040-3590.12.1.102
- Stanton, J. M., Sinar, E. F., Balzer, W. K., & Smith, P. C. (2002). Issues and strategies for reducing the length of self-report scales. Personnel Psychology, 55(1), 167–194. https://doi.org/10.1111/j.1744-6570.2002.tb00108.x
Cytowania BibTeX
@article{chalmers2012mirt, author={Chalmers, R. Philip}, title={{mirt: A multidimensional item response theory package for the R environment}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={6}, pages={1--29}, doi={10.18637/jss.v048.i06}}@article{crede2012evaluation, author={Credé, Marcus and Harms, Peter and Niehorster, Sarah and Gaye-Valentine, Andrea}, title={{An evaluation of the consequences of using short measures of the Big Five personality traits}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={102}, number={4}, pages={874--888}, doi={10.1037/a0027403}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{kruyen2013shortcomings, author={Kruyen, Peter M. and Emons, Wilco H. M. and Sijtsma, Klaas}, title={{On the shortcomings of shortened tests: A literature review}}, journal={International Journal of Testing}, year={2013}, volume={13}, number={3}, pages={223--248}, doi={10.1080/15305058.2012.703734}}@article{levy1967correction, author={Levy, Philip}, title={{The correction for spurious correlation in the evaluation of short-form tests}}, journal={Journal of Clinical Psychology}, year={1967}, volume={23}, number={1}, pages={84--86}, doi={10.1002/1097-4679(196701)23:1<84::aid-jclp2270230123>3.0.co;2-2}}@article{marsh2005short, author={Marsh, Herbert W. and Ellis, Louise A. and Parada, Roberto H. and Richards, Garry and Heubeck, Bernd G.}, title={{A short version of the Self Description Questionnaire II: Operationalizing criteria for short-form evaluation with new applications of confirmatory factor analyses}}, journal={Psychological Assessment}, year={2005}, volume={17}, number={1}, pages={81--102}, doi={10.1037/1040-3590.17.1.81}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{rolstad2011response, author={Rolstad, Sindre and Adler, John and Rydén, Anna}, title={{Response burden and questionnaire length: Is shorter better? A review and meta-analysis}}, journal={Value in Health}, year={2011}, volume={14}, number={8}, pages={1101--1108}, doi={10.1016/j.jval.2011.06.003}}@article{smith2000sins, author={Smith, Gregory T. and McCarthy, Denis M. and Anderson, Kristen G.}, title={{On the sins of short-form development}}, journal={Psychological Assessment}, year={2000}, volume={12}, number={1}, pages={102--111}, doi={10.1037/1040-3590.12.1.102}}@article{stanton2002issues, author={Stanton, Jeffrey M. and Sinar, Evan F. and Balzer, William K. and Smith, Patricia C.}, title={{Issues and strategies for reducing the length of self-report scales}}, journal={Personnel Psychology}, year={2002}, volume={55}, number={1}, pages={167--194}, doi={10.1111/j.1744-6570.2002.tb00108.x}}