Co to jest model odpowiedzi stopniowanej?
Model odpowiedzi stopniowanej (ang. graded response model, GRM) to model teorii reagowania na pozycje testowe (IRT) dla pozycji z uporządkowanymi kategoriami odpowiedzi, np. pięciostopniowej skali Likerta. Zaproponowała go Samejima (1969) w monografii o szacowaniu cechy ukrytej z całego wzorca odpowiedzi ocenianych stopniowo. Każda pozycja ma jedną dyskryminację a i k − 1 progów b, gdzie k to liczba kategorii.
Jak działa GRM
GRM jest modelem kumulatywnym. Dla każdego progu opisuje krzywą logistyczną prawdopodobieństwa, że osoba o poziomie cechy θ wybierze daną kategorię lub wyższą. Próg bk to punkt na skali θ, w którym to prawdopodobieństwo wynosi .50. Prawdopodobieństwo konkretnej kategorii jest różnicą dwóch sąsiednich krzywych, dlatego progi są z definicji uporządkowane. To odróżnia GRM od modelu częściowego kredytu (PCM), którego parametry opisują przejścia między sąsiednimi kategoriami, a nie granice kategorii jak u Samejimy (Masters, 1982). Bliską analogią jest kumulatywny model logitowy z regresji porządkowej, tyle że predyktorem jest tu nieobserwowana cecha.
Przykład
Zasymulowaliśmy odpowiedzi 600 osób na 5 pozycji ocenianych od 0 do 4 i dopasowaliśmy GRM w pakiecie mirt. Pozycja 1 ma a = 2.02 i progi −1.97, −0.82, 0.37 oraz 1.40, a pozycja 5 najsłabiej różnicuje osoby (a = 0.84). Osoba o przeciętnym poziomie cechy (θ = 0) wybierze w pozycji 1 środkową kategorię z prawdopodobieństwem .517, a skrajne kategorie 0 i 4 – z prawdopodobieństwem .018 i .055.
Na rysunku
Rysunek pokazuje pozycję 1 z przykładu (a = 2.02, progi −1.97, −0.82, 0.37 i 1.40) na dwa sposoby: jako cztery krzywe kumulatywne, z których model jest zbudowany, i jako pięć krzywych kategorii, które z nich wynikają.
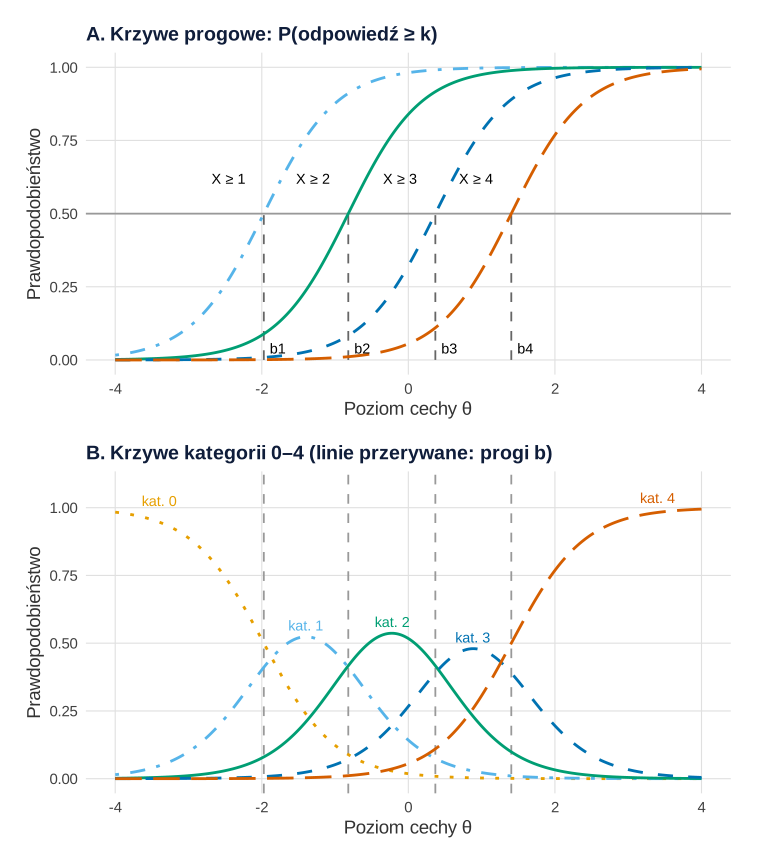
Co widać. W panelu A każda krzywa opisuje szansę odpowiedzi „co najmniej k”. Wszystkie mają to samo nachylenie a i przecinają poziom .50 dokładnie w swoich progach. Szansa odpowiedzi „co najmniej 3” nie może przekroczyć szansy „co najmniej 2”, dlatego progi są zawsze uporządkowane. Panel B powstaje przez odejmowanie sąsiednich krzywych z panelu A. Kategoria 0 dominuje przy niskim θ, a kategoria 4 przy wysokim. Kategorie środkowe mają szczyty .52 (przy θ = −1.40), .54 (−0.22) i .48 (0.88), więc każda z nich jest dla kogoś najbardziej prawdopodobną odpowiedzią.
Na co uważać. W GRM próg b nie musi leżeć tam, gdzie przecinają się krzywe sąsiednich kategorii. Tu kategorie 0 i 1 przecinają się przy θ = −1.86, a nie przy b1 = −1.97, a kategorie 3 i 4 przy 1.26 zamiast 1.40. W modelu częściowego kredytu progi są właśnie punktami przecięcia, więc tych parametrów nie porównuje się wprost. Rysunek pokazuje krzywe dopasowanego modelu, a nie odsetki odpowiedzi w danych. Nie mówi więc, czy model pasuje, ani ile informacji daje pozycja – to pokazuje funkcja informacyjna.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Dane są te same co w przykładzie (set.seed(653)).
Kod R rysunku 1
# Rysunek 1. Krzywe progowe (A) i krzywe kategorii (B) pozycji 1 w modelu odpowiedzi stopniowanej
suppressPackageStartupMessages({ library(mirt); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw; kategorie różnią się też rodzajem linii i etykietą przy krzywej
kol <- c("#E69F00", "#56B4E9", "#009E73", "#0072B2", "#D55E00")
lin <- c("dotted", "dotdash", "solid", "dashed", "longdash")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "none",
        plot.title = element_text(face = "bold"))

# Te same dane i model co w przykładzie: 600 osób, 5 pozycji w skali 0–4
set.seed(653)
a <- c(1.8, 1.4, 1.1, 2.0, 0.9)
b <- rbind(c(-2.0, -0.8, 0.4, 1.6), c(-1.5, -0.5, 0.6, 1.8),
           c(-2.2, -1.0, 0.0, 1.2), c(-1.8, -0.6, 0.5, 1.5),
           c(-2.5, -1.2, 0.2, 1.4))
dane <- simdata(a = matrix(a), d = -a * b, N = 600, itemtype = "graded")
grm <- mirt(dane, 1, itemtype = "graded", verbose = FALSE)
par1 <- coef(grm, IRTpars = TRUE, simplify = TRUE)$items[1, ]   # a, b1–b4 pozycji 1
bk <- par1[2:5]

# Prawdopodobieństwa kategorii 0–4 na siatce θ i krzywe kumulatywne P(X ≥ k)
th <- seq(-4, 4, by = 0.02)
P <- probtrace(extract.item(grm, 1), Theta = matrix(th))           # kolumny: kategorie 0–4
kum <- sapply(1:4, function(k) rowSums(P[, (k + 1):5, drop = FALSE]))

# Liczby do opisu: przy θ = b_k krzywa kumulatywna wynosi .50; szczyty krzywych kategorii 1–3
round(sapply(1:4, function(k) kum[which.min(abs(th - bk[k])), k]), 2)
round(data.frame(kategoria = 1:3, theta_szczytu = th[apply(P[, 2:4], 2, which.max)],
                 P_szczytu = apply(P[, 2:4], 2, max)), 2)                # kategorie środkowe
# Gdzie przecinają się krzywe sąsiednich kategorii (w GRM nie muszą to być progi b)
przec <- sapply(1:4, function(k) uniroot(function(t) {
  p <- probtrace(extract.item(grm, 1), Theta = matrix(t)); p[k] - p[k + 1] }, bk[k] + c(-1, 1))$root)
round(rbind(b = bk, przeciecie = przec), 2)

kumd <- data.frame(theta = rep(th, 4), P = c(kum), k = factor(rep(paste("X ≥", 1:4), each = length(th))))
pa <- ggplot(kumd, aes(theta, P, colour = k, linetype = k)) +
  geom_hline(yintercept = 0.5, colour = "grey60") +
  geom_segment(data = data.frame(b = bk), aes(x = b, xend = b, y = 0, yend = 0.5),
               inherit.aes = FALSE, linetype = "dashed", colour = "grey40") +
  geom_line(linewidth = 1) +
  annotate("text", x = bk + 0.08, y = 0.04, label = paste0("b", 1:4), hjust = 0, size = 3.8) +
  annotate("text", x = bk - 0.25, y = 0.62, label = paste("X ≥", 1:4), hjust = 1, size = 3.8) +
  scale_colour_manual(values = kol[2:5]) + scale_linetype_manual(values = lin[2:5]) +
  labs(title = "A. Krzywe progowe: P(odpowiedź ≥ k)", x = "Poziom cechy θ", y = "Prawdopodobieństwo") + motyw

katd <- data.frame(theta = rep(th, 5), P = c(P), kat = factor(rep(0:4, each = length(th))))
szczyt <- data.frame(theta = th[apply(P, 2, which.max)], P = apply(P, 2, max), kat = factor(0:4))
szczyt$theta[1] <- -3.4; szczyt$theta[5] <- 3.4                    # etykiety skrajnych kategorii przy brzegach
pb <- ggplot(katd, aes(theta, P, colour = kat, linetype = kat)) +
  geom_vline(xintercept = bk, linetype = "dashed", colour = "grey60") +
  geom_line(linewidth = 1) +
  geom_text(data = szczyt, aes(label = paste("kat.", kat)), vjust = -0.6, size = 3.8) +
  scale_colour_manual(values = kol) + scale_linetype_manual(values = lin) +
  scale_y_continuous(limits = c(0, 1.08), breaks = seq(0, 1, 0.25)) +
  labs(title = "B. Krzywe kategorii 0–4 (linie przerywane: progi b)",
       x = "Poziom cechy θ", y = "Prawdopodobieństwo") + motyw

p1 <- pa / pb
p1   # zapis: ggsave("model-odpowiedzi-stopniowanej-krzywe.svg", p1, width = 8, height = 9)
Wynik w R
[1] 0.5 0.5 0.5 0.5
    kategoria theta_szczytu P_szczytu
P.2         1         -1.40      0.52
P.3         2         -0.22      0.54
P.4         3          0.88      0.48
              b1    b2   b3   b4
b          -1.97 -0.82 0.37 1.40
przeciecie -1.86 -0.83 0.41 1.26
Jak opisać w pracy
Na co uważać
- Jednowymiarowość. GRM zakłada jedną cechę i lokalną niezależność pozycji – sprawdź jednowymiarowość skali, zanim zinterpretujesz parametry.
- Rzadkie kategorie. Kategorie wybierane przez kilka osób dają niestabilne progi; czasem trzeba je połączyć.
- Metryka. mirt podaje a w metryce logistycznej; programy ze stałą D = 1.7 pokażą inne wartości.
- Wybór modelu. GRM i uogólniony PCM nie są modelami zagnieżdżonymi, więc porównuje się je kryteriami AIC i BIC.
Analizę skali Likerta w GRM, z oceną dopasowania i funkcją informacyjną testu, pokazuje wpis IRT w R krok po kroku. Podobną analizę w R krok po kroku opisują też Zein i Akhtar (2025).
Model GRM w R
Kod symuluje odpowiedzi na pięć pozycji pięciokategorialnych, dopasowuje model odpowiedzi stopniowanej i liczy prawdopodobieństwa kategorii dla osoby o θ = 0. Liczby w tekście pochodzą z tego kodu.
Parametry a i b oraz prawdopodobieństwa kategorii
R
library(mirt)
set.seed(653)
n <- 600
a <- c(1.8, 1.4, 1.1, 2.0, 0.9)                 # dyskryminacje 5 pozycji
b <- rbind(c(-2.0, -0.8, 0.4, 1.6), c(-1.5, -0.5, 0.6, 1.8),
           c(-2.2, -1.0, 0.0, 1.2), c(-1.8, -0.6, 0.5, 1.5),
           c(-2.5, -1.2, 0.2, 1.4))                 # progi b1-b4 (5 kategorii 0-4)
d <- -a * b                                          # parametryzacja mirt: a*theta + d
dane <- simdata(a = matrix(a), d = d, N = n, itemtype = "graded")
grm <- mirt(dane, 1, itemtype = "graded", verbose = FALSE)
round(coef(grm, IRTpars = TRUE, simplify = TRUE)$items, 2)
# prawdopodobienstwa kategorii pozycji 1 dla osoby z theta = 0
round(probtrace(extract.item(grm, 1), Theta = matrix(0)), 3)
Wynik w R
          a    b1    b2   b3   b4
Item_1 2.02 -1.97 -0.82 0.37 1.40
Item_2 1.48 -1.41 -0.44 0.55 1.69
Item_3 1.13 -2.34 -1.06 0.06 1.11
Item_4 1.90 -1.86 -0.64 0.44 1.45
Item_5 0.84 -2.72 -1.17 0.29 1.67
       P.1   P.2   P.3   P.4   P.5
[1,] 0.018 0.142 0.517 0.267 0.055
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mirt). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym model GRM różni się od modelu częściowego kredytu?
GRM opisuje prawdopodobieństwo wyboru danej kategorii lub wyższej, więc jego progi są zawsze uporządkowane. PCM modeluje przejścia między sąsiednimi kategoriami, ma wspólną dyskryminację i dopuszcza progi nieuporządkowane.
Jak interpretować progi b w modelu odpowiedzi stopniowanej?
Próg bk to poziom cechy θ, przy którym szansa wyboru kategorii k lub wyższej wynosi .50. W przykładzie osoba o θ = 0 wybiera w pozycji 1 kategorię 1 lub wyższą z prawdopodobieństwem .982.
Jak dopasować model GRM w R?
W pakiecie mirt: mirt(dane, 1, itemtype = "graded"). Parametry a i b w zwykłej metryce IRT zwraca coef(model, IRTpars = TRUE, simplify = TRUE), a prawdopodobieństwa kategorii – probtrace().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
IRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Masters, G. N. (1982). A Rasch model for partial credit scoring. Psychometrika, 47(2), 149–174. https://doi.org/10.1007/bf02296272
- Samejima, F. (1969). Estimation of latent ability using a response pattern of graded scores. Psychometrika, 34(S1), 1–97. https://doi.org/10.1007/bf03372160
- Zein, R. A., & Akhtar, H. (2025). Getting started with the graded response model: An introduction and tutorial in R. International Journal of Psychology, 60(1), Article e13265. https://doi.org/10.1002/ijop.13265 ● Otwarty dostęp
Cytowania BibTeX
@article{masters1982rasch, author={Masters, Geoff N.}, title={{A Rasch model for partial credit scoring}}, journal={Psychometrika}, year={1982}, volume={47}, number={2}, pages={149--174}, doi={10.1007/bf02296272}}@article{samejima1969estimation, author={Samejima, Fumiko}, title={{Estimation of latent ability using a response pattern of graded scores}}, journal={Psychometrika}, year={1969}, volume={34}, number={S1}, pages={1--97}, doi={10.1007/bf03372160}}@article{zein2025getting, author={Zein, Rizqy Amelia and Akhtar, Hanif}, title={{Getting started with the graded response model: An introduction and tutorial in R}}, journal={International Journal of Psychology}, year={2025}, volume={60}, number={1}, eid={e13265}, doi={10.1002/ijop.13265}}