Co to jest krzywa charakterystyczna pozycji?
Krzywa charakterystyczna pozycji (ang. item characteristic curve, ICC; też item response function) pokazuje, jak prawdopodobieństwo poprawnej odpowiedzi na pozycję zależy od poziomu cechy θ. Ma kształt litery S. Reise, Ainsworth i Haviland (2005) wymieniają ją wśród trzech podstaw IRT, obok funkcji informacyjnej i niezmienniczości. ICC to także współczynnik korelacji wewnątrzklasowej – w pracy rozwijaj skrót.
Jak czytać krzywą: parametry b, a i c
- Trudność b to poziom θ, przy którym P = .50 (w modelach 1PL i 2PL). Większe b przesuwa krzywą w prawo. W modelu Rascha to jedyny parametr pozycji.
- Dyskryminacja a (model 2PL) to stromość. W punkcie θ = b krzywa rośnie o a/4 na jednostkę θ (w zapisie bez stałej 1.7, jak w pakiecie mirt).
- Zgadywanie c (model 3PL) to dolna asymptota: szansa poprawnej odpowiedzi przy bardzo niskim θ, typowa dla zadań wyboru. Przy θ = b prawdopodobieństwo wynosi (1 + c)/2, a nie .50.
Gdzie pozycja mierzy najdokładniej, mówi funkcja informacyjna. Pozycje wielokategorialne mają krzywe kategorii, jak w modelu odpowiedzi stopniowanej.
Przykład
2000 symulowanych osób rozwiązało 30 zadań. Z30 to zadanie wyboru z czterema odpowiedziami: w symulacji a = 1.8, b = 0.8 i c = .25 (wartości ustawione ręcznie). Model 2PL dał dla Z30 a = 0.78 i b = 0.24 – krzywą płaską i przesuniętą w lewo. Model z 3PL dla Z30 dał a = 1.65, b = 0.86 i c = .25. Test ilorazu wiarygodności faworyzował 3PL, χ²(1) = 22.17, p < .001. Statystyka dopasowania pozycji S-X² dla 2PL wyniosła 35.17 (df = 24, p = .066), a dla 3PL 12.60 (p = .972).
Na rysunku
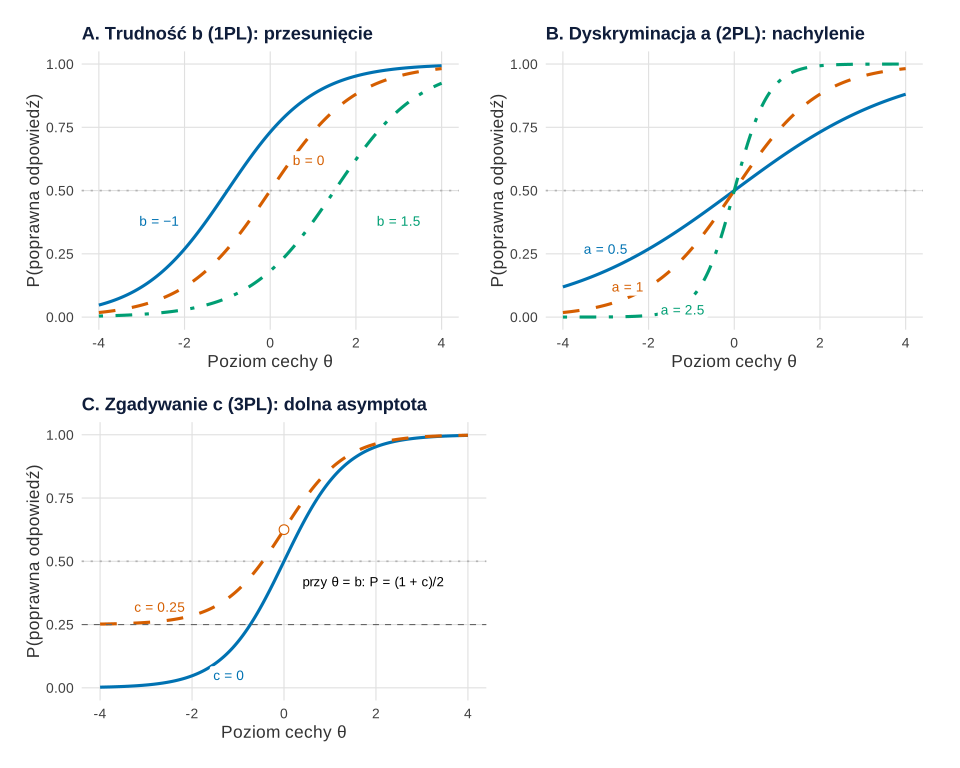
Co widać. Zmiana b przesuwa krzywą (A), zmiana a obraca ją wokół P = .50: nachylenie rośnie od 0.125 przy a = 0.5 do 0.625 przy a = 2.5 (B), a c podnosi jej dolną część (C).
Na co uważać. Krzywe o różnych a się przecinają, więc kolejność trudności zależy od θ – dlatego prosty odczyt mapy Wrighta działa dla modelu Rascha, a nie dla 2PL.
Podpis do pracy:
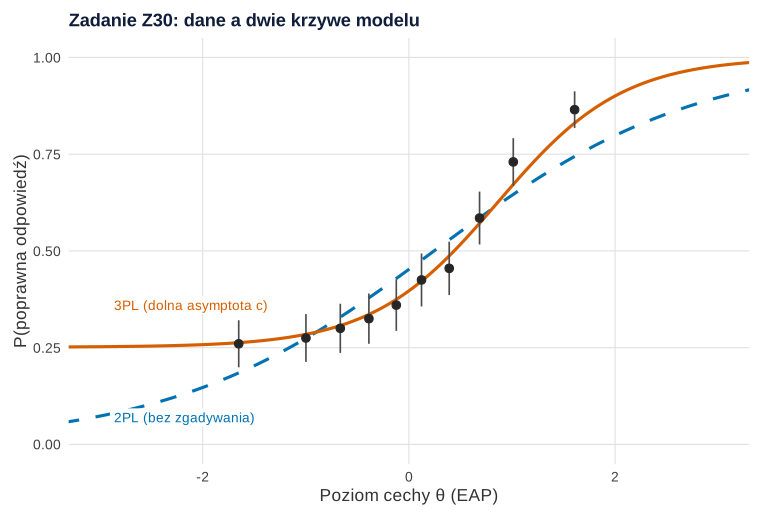
set.seed(756)).Co widać. Najsłabsza dziesiąta część osób odpowiadała poprawnie w 26% przypadków, najsilniejsza w 86%. Krzywa 2PL schodzi do zera, więc się spłaszcza: zaniża odsetki na krańcach, zawyża w środku. Mieści się w 95% przedziałach 5 z 10 grup, krzywa 3PL – wszystkich 10. Rysunek pokazał problem, którego nie wskazało S-X².
Na co uważać. Osoby pogrupowano według oszacowań θ, a nie prawdziwego θ, więc punkty są przybliżeniem. W małych próbach parametr c bywa trudny do oszacowania. Empiryczny odpowiednik krzywej bez modelu IRT pokazuje analiza pozycji testu.
Podpis do pracy:
Parametry symulacji ustawiono ręcznie tak, by zgadywanie było wyraźne; ziarna (756) nie zmieniano. Kod – w sekcji Krzywa charakterystyczna pozycji w R.
Jak opisać w pracy
Na co uważać
- Krzywa jest modelem, nie danymi. Zestaw ją z odsetkami empirycznymi, a nie tylko ze statystyką dopasowania – jak na rysunku 2. Modele 1PL–3PL omawia podręcznik Embretson i Reise (2000).
- Różne krzywe w grupach to DIF. Gdy krzywa pozycji różni się między grupami przy tym samym θ, pozycja ma zróżnicowane funkcjonowanie.
- Skala θ jest umowna. Parametry zależą od przyjętej średniej i SD cechy oraz stałej 1.7. Modele w R krok po kroku pokazuje wpis IRT w R: pakiet mirt.
Krzywa charakterystyczna pozycji w R
Kod rysuje krzywe teoretyczne 1PL, 2PL i 3PL (rysunek 1), symuluje odpowiedzi 2000 osób na 30 zadań, dopasowuje w pakiecie mirt model 2PL i model z 3PL dla zadania Z30, porównuje je i zestawia krzywe z odsetkami poprawnych odpowiedzi w dziesięciu grupach osób (rysunek 2). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Parametry krzywej, 2PL a 3PL i krzywa na tle danych
R
# Krzywa charakterystyczna pozycji: rola parametrów b, a, c (rysunek 1) i krzywa modelu a dane (rysunek 2)
suppressPackageStartupMessages({ library(mirt); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw; krzywe różnią się też rodzajem linii i mają etykiety bezpośrednie
kol <- c("#0072B2", "#D55E00", "#009E73")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "none", plot.title = element_text(face = "bold"))
icc <- function(theta, a = 1, b = 0, c = 0) c + (1 - c) * plogis(a * (theta - b))   # model 3PL bez stałej D
x <- seq(-4, 4, by = 0.02)

# Rysunek 1: trzy panele – trudność (1PL), dyskryminacja (2PL), zgadywanie (3PL)
krzywe <- function(par, etyk, a, b, c) {
  d <- do.call(rbind, lapply(seq_along(par), function(j)
    data.frame(theta = x, P = icc(x, a[j], b[j], c[j]), krzywa = etyk[j])))
  d$krzywa <- factor(d$krzywa, levels = etyk); d
}
panel <- function(d, tytul, et_x, et_y) {
  et <- data.frame(krzywa = factor(levels(d$krzywa), levels = levels(d$krzywa)), theta = et_x, P = et_y)
  ggplot(d, aes(theta, P, colour = krzywa, linetype = krzywa)) +
    geom_hline(yintercept = 0.5, colour = "grey70", linetype = "dotted") +
    geom_line(linewidth = 1.1) +
    geom_label(data = et, aes(label = krzywa), size = 3.6, linewidth = 0, fill = "white") +
    scale_colour_manual(values = kol) + scale_linetype_manual(values = c("solid", "dashed", "dotdash")) +
    scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
    labs(title = tytul, x = "Poziom cechy θ", y = "P(poprawna odpowiedź)") + motyw
}
dA <- krzywe(1:3, c("b = −1", "b = 0", "b = 1.5"), a = c(1, 1, 1), b = c(-1, 0, 1.5), c = c(0, 0, 0))
dB <- krzywe(1:3, c("a = 0.5", "a = 1", "a = 2.5"), a = c(0.5, 1, 2.5), b = c(0, 0, 0), c = c(0, 0, 0))
dC <- krzywe(1:2, c("c = 0", "c = 0.25"), a = c(1.5, 1.5), b = c(0, 0), c = c(0, 0.25))
pA <- panel(dA, "A. Trudność b (1PL): przesunięcie", c(-2.6, 0.9, 3.0), c(0.38, 0.62, 0.38))
pB <- panel(dB, "B. Dyskryminacja a (2PL): nachylenie", c(-3.0, -2.5, -1.2), c(0.27, 0.12, 0.03))
pC <- panel(dC, "C. Zgadywanie c (3PL): dolna asymptota", c(-1.2, -2.7), c(0.05, 0.32)) +
  geom_hline(yintercept = 0.25, colour = "grey40", linetype = "dashed", linewidth = 0.4) +
  annotate("point", x = 0, y = icc(0, 1.5, 0, 0.25), size = 3, shape = 21, fill = "white", colour = kol[2]) +
  annotate("text", x = 0.4, y = 0.42, hjust = 0, size = 3.5, label = "przy θ = b: P = (1 + c)/2")
p1 <- (pA | pB) / (pC | plot_spacer())

# Liczby do opisu rysunku 1: P(θ = b) i nachylenie krzywej w punkcie θ = b, czyli a(1 − c)/4
round(rbind(`1PL, a = 1` = c(P_przy_b = icc(0), nachylenie = 1 / 4),
            `2PL, a = 0.5` = c(icc(0, 0.5), 0.5 / 4), `2PL, a = 2.5` = c(icc(0, 2.5), 2.5 / 4),
            `3PL, a = 1.5, c = 0.25` = c(icc(0, 1.5, 0, 0.25), 1.5 * (1 - 0.25) / 4)), 3)

# Rysunek 2: dane symulowane – 2000 osób, 30 zadań; Z30 to zadanie wyboru, które można zgadnąć
set.seed(756)
n <- 2000; k <- 30
theta <- rnorm(n)
a <- runif(k, 0.8, 2); b <- seq(-2, 2, length.out = k); g <- rep(0, k)
a[k] <- 1.8; b[k] <- 0.8; g[k] <- 0.25                        # parametry Z30 ustawione ręcznie
G <- matrix(g, n, k, byrow = TRUE)
X <- (matrix(runif(n * k), n) < G + (1 - G) * plogis(sweep(outer(theta, a), 2, a * b))) * 1
colnames(X) <- paste0("Z", 1:k)
m2 <- mirt(X, 1, itemtype = "2PL", verbose = FALSE)
m3 <- mirt(X, 1, itemtype = c(rep("2PL", k - 1), "3PL"), verbose = FALSE)   # 3PL tylko dla Z30
par_z30 <- rbind(prawda = c(a = a[k], b = b[k], g = g[k]),
                 `2PL` = coef(m2, IRTpars = TRUE, simplify = TRUE)$items["Z30", c("a", "b", "g")],
                 `3PL` = coef(m3, IRTpars = TRUE, simplify = TRUE)$items["Z30", c("a", "b", "g")])
round(par_z30, 2)
anova(m2, m3)[, c("AIC", "BIC", "logLik", "X2", "df", "p")]
dop <- rbind(itemfit(m2, which.items = k), itemfit(m3, which.items = k))   # dopasowanie Z30: S-X2
dop$model <- c("2PL", "3PL")
dop[, c("model", "S_X2", "df.S_X2", "p.S_X2")]

# Punkty empiryczne: odsetek poprawnych odpowiedzi na Z30 w 10 grupach osób o podobnym θ (EAP z modelu 3PL)
th <- fscores(m3, method = "EAP")[, 1]
gr <- cut(th, quantile(th, 0:10 / 10), include.lowest = TRUE)
emp <- data.frame(theta = tapply(th, gr, mean), P = tapply(X[, "Z30"], gr, mean), n = as.vector(table(gr)))
emp$se <- sqrt(emp$P * (1 - emp$P) / emp$n)
round(emp[, c("theta", "P")], 2)
w_przedziale <- function(P_mod) sum(abs(P_mod - emp$P) < 1.96 * emp$se)   # ile grup ma krzywą w swoim 95% CI
c(`2PL` = w_przedziale(icc(emp$theta, par_z30["2PL", "a"], par_z30["2PL", "b"])),
  `3PL` = w_przedziale(icc(emp$theta, par_z30["3PL", "a"], par_z30["3PL", "b"], par_z30["3PL", "g"])))
mod <- rbind(data.frame(theta = x, P = icc(x, par_z30["2PL", "a"], par_z30["2PL", "b"]), model = "2PL"),
             data.frame(theta = x, P = icc(x, par_z30["3PL", "a"], par_z30["3PL", "b"], par_z30["3PL", "g"]),
                        model = "3PL"))
p2 <- ggplot(mod, aes(theta, P)) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1.1) +
  geom_linerange(data = emp, aes(ymin = P - 1.96 * se, ymax = P + 1.96 * se), colour = "grey30") +
  geom_point(data = emp, size = 2.6, colour = "grey15") +
  annotate("label", x = c(-2.9, -2.9), y = c(0.07, 0.36), hjust = 0, size = 3.6, linewidth = 0,
           label = c("2PL (bez zgadywania)", "3PL (dolna asymptota c)"), colour = kol[1:2]) +
  scale_colour_manual(values = kol[1:2]) + scale_linetype_manual(values = c("dashed", "solid")) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) + coord_cartesian(xlim = c(-3, 3)) +
  labs(title = "Zadanie Z30: dane a dwie krzywe modelu", x = "Poziom cechy θ (EAP)",
       y = "P(poprawna odpowiedź)") + motyw
p1
p2
Wynik w R
                       P_przy_b nachylenie
1PL, a = 1                0.500      0.250
2PL, a = 0.5              0.500      0.125
2PL, a = 2.5              0.500      0.625
3PL, a = 1.5, c = 0.25    0.625      0.281
          a    b    g
prawda 1.80 0.80 0.25
2PL    0.78 0.24 0.00
3PL    1.65 0.86 0.25
        AIC      BIC    logLik     X2 df p
m2 57668.94 58005.00 -28774.47
m3 57648.78 57990.43 -28763.39 22.165  1 0
  model   S_X2 df.S_X2 p.S_X2
1   2PL 35.165      24  0.066
2   3PL 12.602      24  0.972
                  theta    P
[-2.79,-1.21]     -1.65 0.26
(-1.21,-0.828]    -1.00 0.28
(-0.828,-0.521]   -0.67 0.30
(-0.521,-0.247]   -0.39 0.32
(-0.247,-0.00802] -0.12 0.36
(-0.00802,0.25]    0.12 0.42
(0.25,0.547]       0.39 0.45
(0.547,0.832]      0.69 0.58
(0.832,1.23]       1.01 0.73
(1.23,2.64]        1.61 0.86
2PL 3PL
  5  10
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mirt). Rysunki 1 i 2 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznacza parametr c na krzywej charakterystycznej pozycji?
To dolna asymptota krzywej w modelu 3PL: prawdopodobieństwo poprawnej odpowiedzi osoby o bardzo niskim poziomie cechy, np. przez zgadywanie w zadaniu wyboru. Przy c = .25 nawet najsłabsi odpowiadają poprawnie mniej więcej co czwarty raz.
Czy krzywa charakterystyczna pozycji to to samo co ICC w rzetelności ocen?
Nie. W IRT ICC to item characteristic curve, czyli krzywa odpowiedzi na pozycję. W analizie rzetelności ICC to współczynnik korelacji wewnątrzklasowej. W pracy rozwiń skrót przy pierwszym użyciu.
Jak sprawdzić, czy krzywa pozycji pasuje do danych?
Podziel osoby na kilka grup o podobnym oszacowaniu θ, policz w każdej odsetek poprawnych odpowiedzi i nanieś punkty z przedziałami na krzywą modelu. Uzupełnij to statystyką dopasowania pozycji, np. S-X².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Teoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikIRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →PoradnikPunktowanie testu wiedzy: „nie wiem” i zgadywanie
„Nie wiem” jako 0 czy brak, poprawka na zgadywanie, próg dla prawda/fałsz i punkty częściowe za kilka poprawnych odpowiedzi – na symulacji w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Embretson, S. E., & Reise, S. P. (2000). Item response theory for psychologists. Lawrence Erlbaum Associates.
- Reise, S. P., Ainsworth, A. T., & Haviland, M. G. (2005). Item response theory: Fundamentals, applications, and promise in psychological research. Current Directions in Psychological Science, 14(2), 95–101. https://doi.org/10.1111/j.0963-7214.2005.00342.x
Cytowania BibTeX
@book{embretson2000item, author={Embretson, Susan E. and Reise, Steven P.}, title={{Item response theory for psychologists}}, year={2000}, publisher={Lawrence Erlbaum Associates}}@article{reise2005item, author={Reise, Steven P. and Ainsworth, Andrew T. and Haviland, Mark G.}, title={{Item response theory: Fundamentals, applications, and promise in psychological research}}, journal={Current Directions in Psychological Science}, year={2005}, volume={14}, number={2}, pages={95--101}, doi={10.1111/j.0963-7214.2005.00342.x}}