Co to jest mapa Wrighta?
Mapa Wrighta (ang. Wright map, person–item map), nazywana też mapą osób i pozycji, to wykres, na którym osoby badane i pozycje testu leżą na jednej osi. Oś jest w logitach i pochodzi z modelu Rascha albo innego modelu IRT. Po jednej stronie osi stoi histogram poziomu cechy osób (θ), po drugiej – trudności pozycji (b). Nazwa nawiązuje do Benjamina D. Wrighta. Boone (2016) opisuje ją jako sposób wyjaśnienia, co znaczy wynik testu: które zadania osoba już opanowała, a które są poza jej zasięgiem.
Jak czytać mapę Wrighta
- Ta sama wysokość = 50%. W modelu Rascha osoba na wysokości pozycji odpowiada na nią poprawnie z prawdopodobieństwem .50. Pozycja leżąca 1 logit niżej daje jej około 73% szans, 1 logit wyżej – około 27%.
- Dopasowanie testu do osób. Porównaj środek histogramu osób ze średnią trudnością pozycji (zwykle ustaloną na 0). Duże przesunięcie w górę oznacza test za łatwy, w dół – za trudny.
- Luki. Na odcinku osi bez pozycji test słabo rozróżnia leżące tam osoby.
- Sufit i podłoga. Osoby powyżej najtrudniejszej albo poniżej najłatwiejszej pozycji to efekt sufitu lub podłogi na skali cechy.
- Kolejność pozycji. Czy zadania układają się tak, jak zakładała teoria? Budowę narzędzia wokół modelu odpowiedzi na pozycje opisuje podręcznik Wilsona (2005).
Przykład
Tych samych 500 symulowanych uczniów rozwiązało dwie wersje testu z 20 zadaniami. Do każdej wersji dopasowano model Rascha (średnia trudność zadań = 0, oceny osób metodą WLE). W wersji A zadania rozłożono na cały zakres uczniów: średnie θ wyniosło −0.02, a największa luka między sąsiednimi zadaniami miała 0.42 logitu. Wersja B była za łatwa i miała dziurę w środku. Średnie θ wyniosło 1.87, a największa luka miała 1.83 logitu (od 0.51 do 2.34) i leżało w niej 51.0% uczniów. Ponad najtrudniejszym zadaniem znalazło się 19.4% uczniów, ale komplet punktów miało tylko 1.8%. Średni błąd standardowy oceny θ wzrósł z 0.56 do 0.72.
Na rysunku
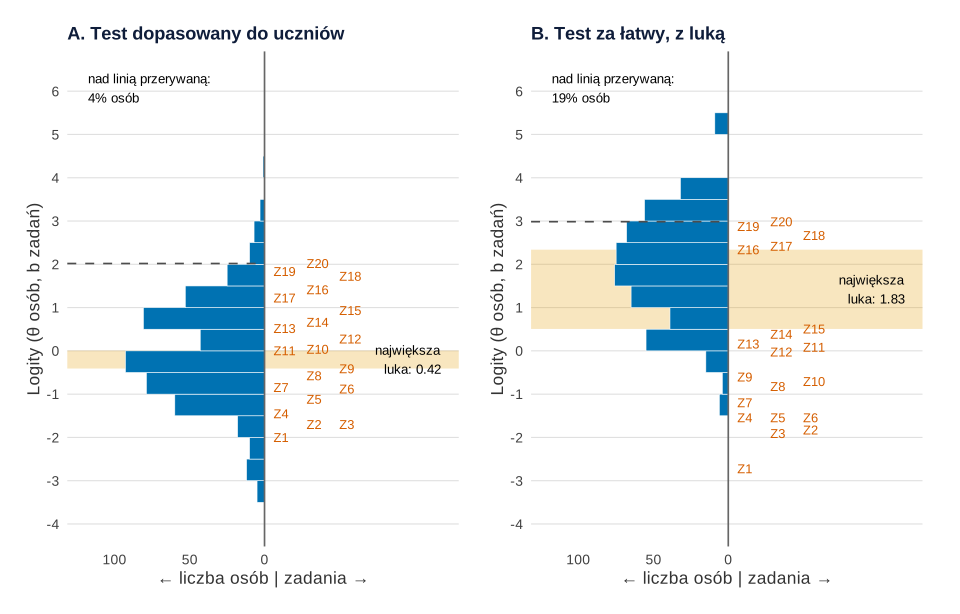
set.seed(755)).Co widać. W panelu A zadania towarzyszą słupkom osób na całej wysokości. W panelu B histogram osób przesunął się w górę, bo oś jest zakotwiczona w średniej trudności zadań, a ta spadła. Najwyższe słupki trafiają w zacieniowaną lukę, w której nie ma żadnego zadania. Nad linią przerywaną (najtrudniejsze zadanie) jest prawie co piąty uczeń.
Na co uważać. Mapa nie pokazuje, czy zadania pasują do modelu (od tego są infit i outfit), ani jak dokładnie zmierzono każdą osobę. Precyzję w funkcji θ opisuje funkcja informacyjna testu. Kształt histogramu zależy od metody oceny θ i szerokości przedziałów. Mapę testu wiedzy krok po kroku pokazuje wpis Model Rascha krok po kroku.
Podpis do pracy:
Parametry symulacji (rozkład uczniów, trudności zadań w obu wersjach) ustawiono ręcznie tak, by luka i sufit w wersji B były wyraźne; ziarna (755) nie zmieniano. Kod rysunku i liczb z przykładu jest w sekcji Mapa Wrighta w R.
Jak opisać w pracy
Na co uważać
- Zero na osi jest umowne. Napisz, co zakotwiczono: średnią trudność pozycji czy średnią osób. Od tego zależy, czy „przesunięcie” widać na osobach, czy na zadaniach.
- Model 2PL psuje prosty odczyt. Gdy pozycje mają różne dyskryminacje, ich krzywe charakterystyczne się przecinają i ta sama odległość osoba–pozycja nie oznacza dla każdej pozycji tego samego prawdopodobieństwa. Najprościej czyta się ją dla danych zgodnych z modelem Rascha, który w tej tradycji jest wzorcem pomiaru (Bond i Fox, 2015).
- Wynik surowy to za mało. Przy 1.8% osób z kompletem punktów analiza pozycji w ujęciu klasycznym łatwo przeoczy sufit, który mapa pokazuje od razu.
Mapa Wrighta w R
Kod symuluje odpowiedzi tych samych uczniów na dwie wersje testu, dopasowuje model Rascha funkcją tam.mml() z pakietu TAM, ocenia θ osób metodą WLE (tam.wle()), liczy wskaźniki dopasowania testu do osób i rysuje obie mapy w ggplot2. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Model Rascha, wskaźniki mapy i rysunek
R
# Mapa Wrighta: ci sami 500 uczniowie, dwie wersje testu z 20 zadaniami (model Rascha, pakiet TAM)
suppressPackageStartupMessages({ library(TAM); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw; osoby i zadania różnią się też stroną osi i formą (słupki / etykiety)
kol <- c(osoby = "#0072B2", zadania = "#D55E00", luka = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
        plot.title = element_text(face = "bold"))

# Dane symulowane: poziom cechy uczniów i trudności zadań w dwóch wersjach testu
set.seed(755)
n <- 500; k <- 20
theta <- rnorm(n, mean = 1, sd = 1)
b_A <- seq(-1, 3, length.out = k)                                       # A: zadania rozłożone na zakres uczniów
b_B <- c(seq(-3, -0.3, length.out = 15), seq(1.4, 2, length.out = 5))   # B: za łatwe, z luką w środku
symuluj <- function(b) {
  X <- (matrix(runif(n * k), n) < plogis(outer(theta, b, "-"))) * 1
  colnames(X) <- paste0("Z", 1:k); X
}
X_A <- symuluj(b_A); X_B <- symuluj(b_B)

# Model Rascha: średnia trudność zadań = 0 (constraint = "items"), osoby – oceny WLE
dopasuj <- function(X) {
  m <- tam.mml(X, constraint = "items", verbose = FALSE)
  w <- tam.wle(m, progress = FALSE)
  list(b = setNames(m$item$xsi.item, colnames(X)), th = w$theta, se = w$error, suma = rowSums(X))
}
A <- dopasuj(X_A); B <- dopasuj(X_B)

# Liczby do opisu: dopasowanie testu do osób, sufit i największa luka między sąsiednimi zadaniami
opis <- function(w) {
  s <- sort(w$b); i <- which.max(diff(s))
  c(theta_sr = mean(w$th), theta_sd = sd(w$th), b_min = min(w$b), b_max = max(w$b),
    luka_od = s[[i]], luka_do = s[[i + 1]], luka = diff(s)[[i]],
    proc_w_luce = 100 * mean(w$th > s[[i]] & w$th < s[[i + 1]]),
    proc_ponad_najtrudniejszym = 100 * mean(w$th > max(w$b)),
    proc_wynik_max = 100 * mean(w$suma == k), se_sr = mean(w$se))
}
round(rbind(A = opis(A), B = opis(B)), 2)

# Mapa: po lewej histogram osób (słupki w lewo, przedziały co 0.5 logitu), po prawej zadania
mapa <- function(w, tytul, szer = 0.5) {
  srodek <- function(x) floor(x / szer) * szer + szer / 2
  osoby <- as.data.frame(table(y = srodek(w$th)), responseName = "n")
  osoby$y <- as.numeric(as.character(osoby$y))
  zad <- data.frame(et = names(w$b), y = w$b)[order(w$b), ]           # zadania na dokładnej wysokości b
  zad$x <- 6 + 22 * ((seq_len(k) - 1) %% 3)                           # trzy kolumny, żeby etykiety się nie nakładały
  s <- sort(w$b); i <- which.max(diff(s))
  ponad <- 100 * mean(w$th > max(w$b))
  ggplot() +
    annotate("rect", xmin = -Inf, xmax = Inf, ymin = s[i], ymax = s[i + 1], fill = kol[["luka"]], alpha = 0.25) +
    annotate("text", x = 118, y = (s[i] + s[i + 1]) / 2, size = 3.5, hjust = 1,
             label = sprintf("największa\nluka: %.2f", diff(s)[i])) +
    geom_rect(data = osoby, aes(xmin = -n, xmax = 0, ymin = y - szer / 2, ymax = y + szer / 2),
              fill = kol[["osoby"]], colour = "white", linewidth = 0.2) +
    geom_text(data = zad, aes(x, y, label = et), colour = kol[["zadania"]], size = 3.4, hjust = 0, vjust = 0.5) +
    annotate("segment", x = -Inf, xend = 0, y = max(w$b), yend = max(w$b), linetype = "dashed", colour = "grey30") +
    annotate("text", x = -118, y = 6.4, hjust = 0, vjust = 1, size = 3.5,
             label = sprintf("nad linią przerywaną:\n%.0f%% osób", ponad)) +
    geom_vline(xintercept = 0, colour = "grey40") +
    scale_x_continuous(limits = c(-120, 118), breaks = c(-100, -50, 0), labels = c(100, 50, 0)) +
    scale_y_continuous(limits = c(-4, 6.4), breaks = -4:6) +
    labs(title = tytul, x = "\u2190 liczba osób  |  zadania \u2192", y = "Logity (θ osób, b zadań)") +
    motyw
}
p1 <- mapa(A, "A. Test dopasowany do uczniów") + mapa(B, "B. Test za łatwy, z luką")
p1
Wynik w R
  theta_sr theta_sd b_min b_max luka_od luka_do luka proc_w_luce
A    -0.02     1.18 -2.00  2.02   -0.41    0.01 0.42        18.6
B     1.87     1.22 -2.72  2.98    0.51    2.34 1.83        51.0
  proc_ponad_najtrudniejszym proc_wynik_max se_sr
A                        4.2            0.2  0.56
B                       19.4            1.8  0.72
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet TAM). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. Gotową mapę rysuje też funkcja plotPImap() z pakietu eRm. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- TAM (wersja 4.3-25): Robitzsch, A., Kiefer, T., & Wu, M. (2025). TAM: Test analysis modules [R package]. https://doi.org/10.32614/CRAN.package.TAM
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak odczytać z mapy Wrighta, czy test jest za łatwy?
Porównaj środek histogramu osób ze średnią trudnością pozycji. Jeśli osoby leżą wyraźnie wyżej, a wiele z nich jest powyżej najtrudniejszej pozycji, test jest dla tej grupy za łatwy i słabo różnicuje najlepszych.
Czym mapa Wrighta różni się od histogramu wyników surowych?
Histogram wyników surowych pokazuje tylko liczbę punktów. Mapa Wrighta umieszcza na tej samej osi trudności pozycji, więc widać, które zadania osoba o danym poziomie zwykle rozwiązuje, gdzie brakuje zadań i gdzie zaczyna się sufit.
Czy mapę Wrighta można narysować dla modelu 2PL?
Można, ale odczyt jest mniej prosty: przy różnych dyskryminacjach ta sama odległość osoby od pozycji nie oznacza dla każdej pozycji tego samego prawdopodobieństwa. Najlepiej pasuje do modelu Rascha.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model Rascha krok po kroku
Trudności w eRm, mapa Wrighta, Q3, infit i outfit z bootstrapem, rzetelność separacji, DIF i test Andersena, RSM a PCM – na jednym teście wiedzy w R.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikDobre pozycje testowe i liczebność próby w IRT
Kryteria dobrej pozycji, przykłady z badań, planowanie próby symulacją Monte Carlo w R i najważniejsze przeliczenia parametrów IRT.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bond, T. G., & Fox, C. M. (2015). Applying the Rasch model: Fundamental measurement in the human sciences (3rd ed.). Routledge. https://doi.org/10.4324/9781315814698
- Boone, W. J. (2016). Rasch analysis for instrument development: Why, when, and how? CBE—Life Sciences Education, 15(4), Article rm4. https://doi.org/10.1187/cbe.16-04-0148 ● Otwarty dostęp
- Wilson, M. (2005). Constructing measures: An item response modeling approach. Lawrence Erlbaum Associates.
Cytowania BibTeX
@book{bond2015applying, author={Bond, Trevor G. and Fox, Christine M.}, title={{Applying the Rasch model: Fundamental measurement in the human sciences}}, year={2015}, edition={3}, publisher={Routledge}, doi={10.4324/9781315814698}}@article{boone2016rasch, author={Boone, William J.}, title={{Rasch analysis for instrument development: Why, when, and how?}}, journal={CBE—Life Sciences Education}, year={2016}, volume={15}, number={4}, eid={rm4}, doi={10.1187/cbe.16-04-0148}}@book{wilson2005constructing, author={Wilson, Mark}, title={{Constructing measures: An item response modeling approach}}, year={2005}, publisher={Lawrence Erlbaum Associates}}