Co to jest wieloaspektowy model Rascha?
Wieloaspektowy model Rascha (ang. many-facet Rasch model, MFRM) to rozszerzenie modelu Rascha na sytuacje, w których wynik zależy nie tylko od osoby i zadania, ale też od innych aspektów (faset) pomiaru, najczęściej od oceniającego. Lunz, Wright i Linacre (1990) opisują go jako model, który umieszcza osoby badane, zadania i sędziów na wspólnej skali logitów. Dzięki temu wynik osoby można skorygować o surowość tego, kto ją oceniał.
Jak wygląda model
W typowej wersji logarytm szans przejścia z kategorii oceny k − 1 do k to: zdolność osoby − trudność zadania − surowość oceniającego − próg kategorii. Każdy element dostaje własną miarę z błędem standardowym oraz statystyki dopasowania (infit, outfit). Żeby fasety dało się porównać, plan oceniania musi być połączony: oceniający muszą się „zazębiać” wspólnymi pracami (Lunz i in., 1990).
Do czego służy
- Surowość sędziów. Lunz i in. (1990) pokazali na egzaminie certyfikacyjnym, że surowość sędziów może wyraźnie zmienić wynik surowy, a wyniki nieskorygowane faworyzują osoby oceniane przez łagodnych sędziów.
- Błędy oceniających. Engelhard (1994) użył MFRM do oceny wypracowań przez 15 oceniających i wykrył różnice surowości, efekt halo u dwóch osób, tendencję centralną (około 80% ocen w dwóch środkowych kategoriach) i zawężenie zakresu ocen.
- Sprawiedliwsze decyzje o zaliczeniu, gdy nie każdy jest oceniany przez tych samych sędziów.
MFRM a ICC, kappa i teoria G
ICC i kappa Cohena mówią, jak bardzo oceniający są zgodni. MFRM mówi, którzy są surowsi, którzy niespójni, i koryguje wynik osoby. Teoria generalizowalności rozkłada wariancję na fasety, ale nie daje miary dla każdego oceniającego. Przegląd wskaźników zgodności zawiera wpis zgodność sędziów.
Na rysunku
W symulacji sześciu oceniających (O1–O6) ocenia 60 prac według trzech kryteriów na skali 0–4. Każdą pracę oceniają dwie osoby z łańcucha O1–O2, O2–O3, …, O6–O1, więc plan jest połączony, a każdy oceniający widzi 20 prac. Model oszacowano funkcją tam.mml.mfr() z pakietu TAM.
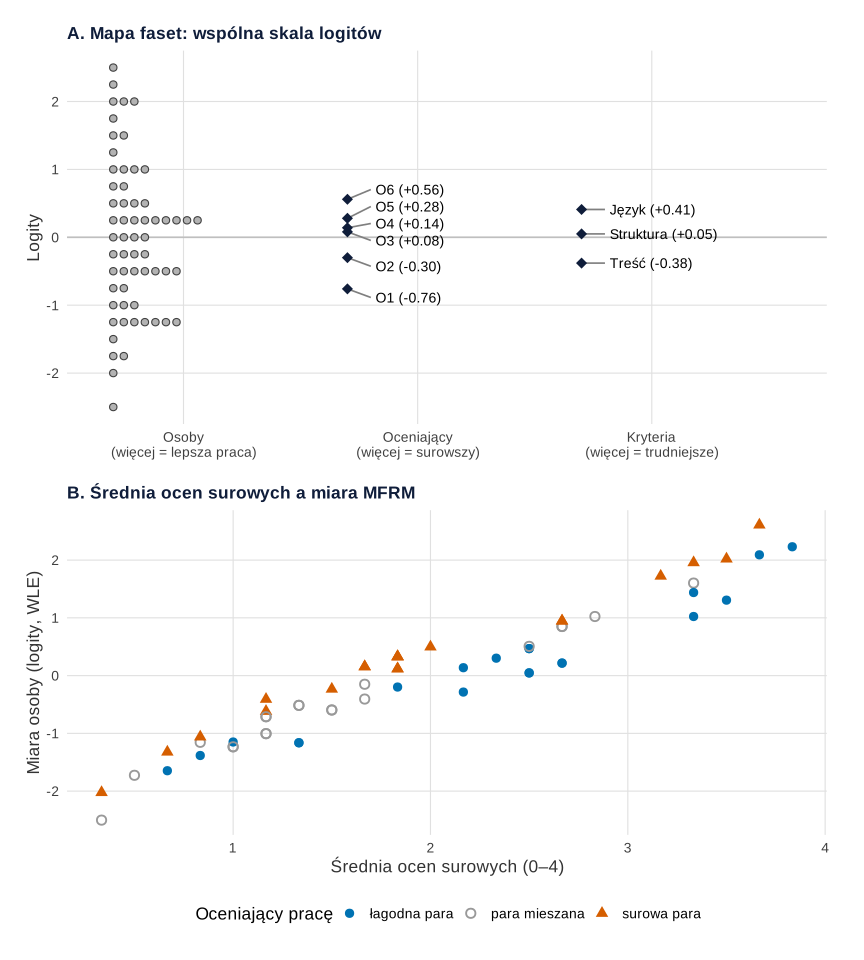
set.seed(587)).Co widać. Panel A to rozszerzona mapa Wrighta: osoby, oceniający i kryteria leżą na jednej osi logitów. O1 jest najłagodniejszy (−0.76), O6 najsurowszy (+0.56); kryterium Język jest trudniejsze od Treści o 0.79 logitu. Panel B pokazuje skutek korekty. Prace oceniane przez łagodną parę mają średnią ocen surowych 2.33, a przez surową 1.96, choć prawdziwy poziom tej drugiej grupy jest wyższy (θ = 0.24 wobec −0.09). Miara MFRM odwraca tę kolejność (0.33 wobec 0.15). Korelacja z prawdziwym poziomem rośnie z .89 dla średniej surowej do .93 dla miary MFRM.
Na co uważać. Oś jest zakotwiczona: surowości sumują się do zera, więc „0” to przeciętny oceniający z tej grupy, a nie neutralny sędzia. Oszacowania mają błąd (tu SE = 0.10 przy 20 pracach na oceniającego); różnica O3 i O4 (0.08 i 0.14) jest mniejsza niż ten błąd. Mapa nie pokazuje dopasowania (infit, outfit) ani efektu halo, a korekta działa tylko przy połączonym planie. Zgodność tych samych ocen opisują inne miary – zob. wpis zgodność sędziów.
Podpis do pracy:
Surowości oceniających, trudności kryteriów i progi skali ustawiono ręcznie tak, by różnice między sędziami były wyraźne; ziarna set.seed(587) nie zmieniano. Kod sam definiuje paletę Okabe–Ito i motyw; rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Mapa faset MFRM: osoby, oceniający i kryteria na jednej skali logitów (A)
# oraz średnia ocen surowych a miara osoby skorygowana o surowość oceniających (B)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(TAM))

# Paleta Okabe–Ito i prosty motyw
kol <- c("łagodna para" = "#0072B2", "para mieszana" = "#999999", "surowa para" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), panel.grid.minor = element_blank(),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Plan oceniania: 60 prac, 6 oceniających, 3 kryteria, skala 0–4.
# Każdą pracę oceniają dwie sąsiednie osoby z łańcucha 1-2, 2-3, ..., 6-1, więc plan jest połączony.
# Surowości, trudności kryteriów i progi ustawiono ręcznie.
n_os <- 60
surowosc <- c(-0.9, -0.5, -0.1, 0.2, 0.5, 0.8)      # logity; więcej = surowszy
trudnosc <- c(Treść = -0.5, Struktura = 0, Język = 0.5)
progi <- c(-1.5, -0.5, 0.5, 1.5)
set.seed(587)
theta <- rnorm(n_os)
plan <- data.frame(osoba = rep(1:n_os, each = 2),
                   oceniajacy = c(rbind((0:(n_os - 1)) %% 6 + 1, (1:n_os) %% 6 + 1)))
ocena <- function(eta) {                             # model kategorii częściowych z progami
  pr <- exp(cumsum(c(0, eta - progi))); sample(0:4, 1, prob = pr / sum(pr))
}
oceny <- t(sapply(seq_len(nrow(plan)), function(i)
  sapply(trudnosc, function(b) ocena(theta[plan$osoba[i]] - b - surowosc[plan$oceniajacy[i]]))))
colnames(oceny) <- names(trudnosc)

# MFRM w TAM: kryterium + oceniający + progi kryteriów
mod <- tam.mml.mfr(resp = oceny, facets = data.frame(oceniajacy = plan$oceniajacy),
                   formulaA = ~ item + oceniajacy + item:step, pid = plan$osoba, verbose = FALSE)
xf <- mod$xsi.facets
ocen <- data.frame(oceniajacy = paste0("O", 1:6), prawdziwa = surowosc,
                   oszacowana = round(xf$xsi[xf$facet == "oceniajacy"], 2),
                   SE = round(xf$se.xsi[xf$facet == "oceniajacy"], 2))   # O6 wynika z ograniczenia sumy = 0
kryt <- data.frame(kryterium = names(trudnosc), prawdziwa = unname(trudnosc),
                   oszacowana = round(xf$xsi[xf$facet == "item"], 2), SE = round(xf$se.xsi[xf$facet == "item"], 2))
print(ocen, row.names = FALSE)
print(kryt, row.names = FALSE)

wle <- tam.wle(mod, progress = FALSE)
os <- data.frame(osoba = wle$pid, miara = wle$theta)
os$srednia_surowa <- tapply(rowMeans(oceny), plan$osoba, mean)[as.character(os$osoba)]
os$theta <- theta[os$osoba]
para <- tapply(surowosc[plan$oceniajacy], plan$osoba, mean)[as.character(os$osoba)]
os$para <- factor(ifelse(para <= -0.3, "łagodna para", ifelse(para >= 0.3, "surowa para", "para mieszana")),
                  levels = names(kol))
round(c(r_surowosc = cor(ocen$prawdziwa, ocen$oszacowana),
        r_theta_srednia_surowa = cor(os$theta, os$srednia_surowa),
        r_theta_miara_MFRM = cor(os$theta, os$miara)), 2)
# Średnie w grupach prac według pary oceniających: prawdziwe θ, ocena surowa i miara MFRM
cbind(n = table(os$para), round(sapply(os[, c("theta", "srednia_surowa", "miara")], tapply, os$para, mean), 2))

# Panel A: mapa faset (osoby jako stosy punktów w przedziałach co 0.25 logitu)
os$przedzial <- round(os$miara / 0.25) * 0.25
os$x <- 0.7 + 0.045 * (ave(os$miara, os$przedzial, FUN = seq_along) - 1)
etyk <- rbind(data.frame(x = 2, y = ocen$oszacowana, lab = sprintf("%s (%+.2f)", ocen$oceniajacy, ocen$oszacowana)),
              data.frame(x = 3, y = kryt$oszacowana, lab = sprintf("%s (%+.2f)", kryt$kryterium, kryt$oszacowana)))
rozsun <- function(y, d = 0.25) {                    # rozsuwa etykiety leżące bliżej niż d logitu
  o <- order(y); z <- y[o]
  for (i in seq_along(z)[-1]) z[i] <- max(z[i], z[i - 1] + d)
  z <- z - mean(z) + mean(y); z[order(o)]
}
etyk$y_lab <- ave(etyk$y, etyk$x, FUN = rozsun)
pA <- ggplot() +
  geom_hline(yintercept = 0, colour = "grey75") +
  geom_point(data = os, aes(x, przedzial), shape = 21, fill = "grey70", colour = "grey25", size = 2.2) +
  geom_segment(data = etyk, aes(x = x - 0.3, y = y, xend = x - 0.2, yend = y_lab), colour = "grey50") +
  geom_point(data = etyk, aes(x - 0.3, y), shape = 18, size = 3.5, colour = "#0f1d3a") +
  geom_text(data = etyk, aes(x - 0.18, y_lab, label = lab), hjust = 0, size = 3.7) +
  scale_x_continuous(limits = c(0.65, 3.6), breaks = c(1, 2, 3),
                     labels = c("Osoby\n(więcej = lepsza praca)", "Oceniający\n(więcej = surowszy)",
                                "Kryteria\n(więcej = trudniejsze)")) +
  scale_y_continuous(breaks = -3:3) +
  labs(title = "A. Mapa faset: wspólna skala logitów", x = NULL, y = "Logity") +
  motyw + theme(panel.grid.major.x = element_blank())

# Panel B: ta sama średnia ocena surowa daje różną miarę zależnie od surowości pary oceniających
pB <- ggplot(os, aes(srednia_surowa, miara, colour = para, shape = para)) +
  geom_point(size = 2.6, stroke = 1) +
  scale_colour_manual(values = kol, name = "Oceniający pracę") +
  scale_shape_manual(values = c(16, 1, 17), name = "Oceniający pracę") +
  labs(title = "B. Średnia ocen surowych a miara MFRM", x = "Średnia ocen surowych (0–4)",
       y = "Miara osoby (logity, WLE)") +
  motyw

p1 <- pA / pB + plot_layout(heights = c(1.15, 1))
p1
Wynik w R
 oceniajacy prawdziwa oszacowana   SE
         O1      -0.9      -0.76 0.10
         O2      -0.5      -0.30 0.10
         O3      -0.1       0.08 0.10
         O4       0.2       0.14 0.10
         O5       0.5       0.28 0.10
         O6       0.8       0.56 0.23
 kryterium prawdziwa oszacowana  SE
     Treść      -0.5      -0.38 0.1
 Struktura       0.0       0.05 0.1
     Język       0.5       0.41 0.1
            r_surowosc r_theta_srednia_surowa     r_theta_miara_MFRM
                  0.98                   0.89                   0.93
               n theta srednia_surowa miara
łagodna para  20 -0.09           2.33  0.15
para mieszana 20 -0.51           1.57 -0.46
surowa para   20  0.24           1.96  0.33
Bibliografia oprogramowania
Wyniki i rysunek pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety TAM, ggplot2 i patchwork); rysunek zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- TAM (wersja 4.3.25): Robitzsch, A., Kiefer, T., & Wu, M. (2025). TAM: Test analysis modules [R package]. https://doi.org/10.32614/CRAN.package.TAM
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Jak opisać w pracy
Na co uważać
Model zakłada jednowymiarowość i niezależność ocen; oceny tej samej pracy przez kilku sędziów bywają od siebie zależne. Rozłączny plan oceniania uniemożliwia porównanie surowości. W R MFRM obsługują wyspecjalizowane pakiety (np. TAM); typowy pakiet do IRT, mirt, nie szacuje tego modelu wprost.
Najczęstsze pytania
Czym MFRM różni się od zwykłego modelu Rascha?
Zwykły model Rascha ma dwie fasety: osoby i pozycje. MFRM dodaje kolejne, np. oceniających lub okazje pomiaru, i szacuje dla każdego elementu miarę na tej samej skali logitów.
Czy MFRM zastępuje ICC lub kappę przy ocenie sędziów?
Nie całkiem. ICC i kappa opisują zgodność oceniających, a MFRM mierzy surowość i spójność każdego z nich i koryguje wyniki osób. W pracy często raportuje się oba podejścia.
Czy każdy oceniający musi ocenić wszystkie prace?
Nie, ale plan oceniania musi być połączony: oceniający powinni dzielić część wspólnych prac. Bez takich połączeń surowości różnych sędziów nie da się porównać na jednej skali.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model Rascha krok po kroku
Trudności w eRm, mapa Wrighta, Q3, infit i outfit z bootstrapem, rzetelność separacji, DIF i test Andersena, RSM a PCM – na jednym teście wiedzy w R.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Engelhard, G. (1994). Examining rater errors in the assessment of written composition with a many-faceted Rasch model. Journal of Educational Measurement, 31(2), 93–112. https://doi.org/10.1111/j.1745-3984.1994.tb00436.x
- Lunz, M. E., Wright, B. D., & Linacre, J. M. (1990). Measuring the impact of judge severity on examination scores. Applied Measurement in Education, 3(4), 331–345. https://doi.org/10.1207/s15324818ame0304_3
Cytowania BibTeX
@article{engelhard1994examining, author={Engelhard, George}, title={{Examining rater errors in the assessment of written composition with a many-faceted Rasch model}}, journal={Journal of Educational Measurement}, year={1994}, volume={31}, number={2}, pages={93--112}, doi={10.1111/j.1745-3984.1994.tb00436.x}}@article{lunz1990measuring, author={Lunz, Mary E. and Wright, Benjamin D. and Linacre, John M.}, title={{Measuring the impact of judge severity on examination scores}}, journal={Applied Measurement in Education}, year={1990}, volume={3}, number={4}, pages={331--345}, doi={10.1207/s15324818ame0304_3}}