RM() zwraca łatwości – trudność to −beta. Sprawdź wycelowanie na mapie osoba–pozycja, lokalną niezależność korelacjami reszt (Q3) i dopasowanie zadań średnimi kwadratami infit i outfit – najlepiej względem zakresu z bootstrapu, bo statystyki t rosną z liczebnością próby. DIF zbadasz testem Andersena i testami Walda. Niedopasowanych zadań nie usuwaj mechanicznie: najpierw treść, potem decyzja i wynik przed i po.Po co model Rascha i co sprawdzasz
Model Rascha zakłada, że szansa poprawnej odpowiedzi zależy tylko od różnicy między poziomem cechy osoby a trudnością zadania (Rasch, 1980). Wszystkie zadania mają tę samą dyskryminację, więc suma punktów wystarcza do oceny osoby. Tutaj przechodzimy całą analizę krok po kroku w R: od danych, przez trudności i mapę osoba–pozycja, po założenia, dopasowanie, rzetelność, DIF i decyzje o zadaniach. Na końcu krótko pokazujemy skalę politomiczną.
W tradycji Rascha model traktuje się jako wzorzec pomiaru (Bond i Fox, 2015): sprawdzasz, które zadania i osoby od niego odstają, i zastanawiasz się, dlaczego. W podejściu IRT dobiera się raczej model do danych. Porównanie modelu Rascha z 2PL na liczbach pokazuje wpis IRT w R krok po kroku, a miejsce Rascha wśród innych modeli – wpis teoria reagowania na pozycje testowe (IRT).
Przykład i dane
Przykład jest fikcyjny (dane symulowane). 600 studentów – po 300 z psychologii i pedagogiki – rozwiązało test wiedzy z metodologii złożony z 10 zadań punktowanych 0/1 (z01–z10). Zadania z05 i z06 dotyczą tego samego wykresu. W symulacji celowo ukryliśmy kilka problemów, które ujawniamy w kroku 8. Ziarno danych (557) i ziarna losowań w kodzie (5571, 5572, 5578) ustalono raz, bez dobierania pod wynik. Plik: model-rascha-test-wiedzy.csv. Obliczenia wykonano pakietem eRm (estymacja warunkowa, CML), a kontrolnie pakietem TAM.
Krok 1. Dane i wyniki skrajne
Zacznij od klasycznej analizy pozycji: odsetek poprawnych odpowiedzi wynosił od .80 (z01) do .17 (z10), więc test obejmuje zadania łatwe i trudne. Wyniki surowe układały się wokół środka skali (najczęściej 5 punktów, 107 osób). Zwróć uwagę na wyniki skrajne: 11 osób nie rozwiązało żadnego zadania, a 8 rozwiązało wszystkie. Dla takich osób model nie daje skończonej oceny – pakiet ją ekstrapoluje, a statystyki dopasowania i reszty liczy się bez nich. Dużo wyników skrajnych oznacza test za łatwy lub za trudny dla grupy.
Krok 2. Dopasowanie modelu i trudności zadań
Funkcja RM() szacuje trudności metodą warunkowej największej wiarygodności: warunkuje na sumie punktów, więc trudności nie zależą od rozkładu cechy w próbie. Pułapka: eRm zwraca parametry beta, czyli łatwości. Trudność to −beta – inaczej mapa i opis wyjdą odwrócone. Skala jest ustalona tak, że trudności sumują się do zera.
Trudności wyniosły od −1.67 (z01) do 1.92 (z10) logita, z błędami standardowymi 0.09–0.11.
Miary osób zależą tylko od wyniku surowego. Wynik 5 to −0.02 logita (SE = 0.72), wynik 8 to 1.76 (SE = 0.87), a ekstrapolowane wyniki 0 i 10 to −3.65 i 3.72 (SE około 1.4). Średnia miar osób wyniosła 0.02, a SD 1.37. Test jest więc dobrze wycelowany: przeciętna osoba leży tam, gdzie przeciętne zadanie.
Krok 3. Mapa osoba–pozycja
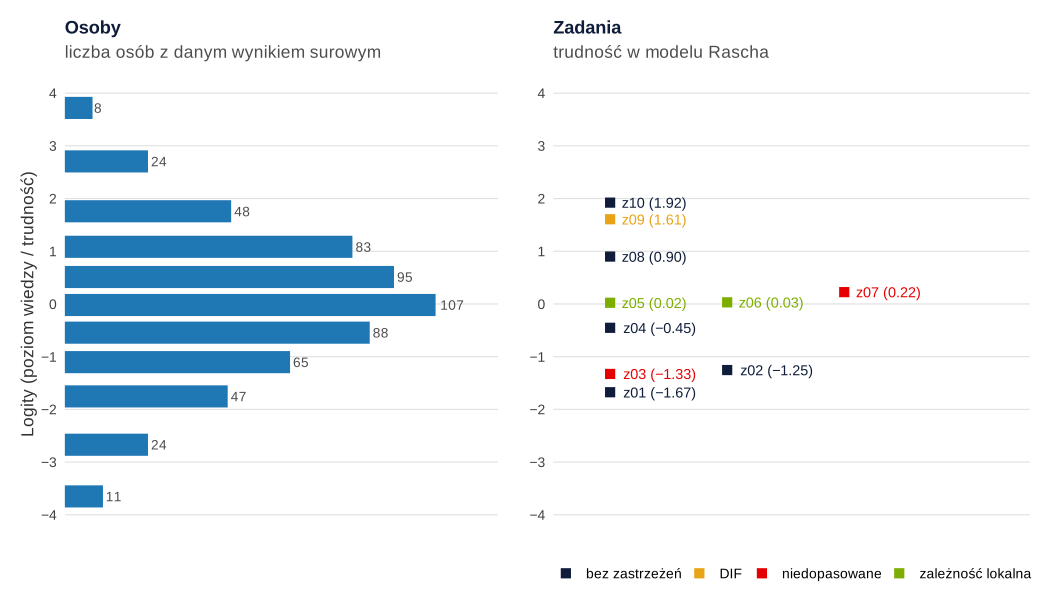
Mapa osoba–pozycja to najprostszy sposób, by zobaczyć wycelowanie testu. Zadania obejmują zakres od −1.67 do 1.92 logita, a osoby – od −3.65 do 3.72. Poniżej −2 i powyżej 2 logitów nie ma żadnego zadania. Dlatego osoby o skrajnie niskiej i wysokiej wiedzy są mierzone słabo (SE powyżej 1). Zadania z05, z06 i z07 leżą prawie w tym samym miejscu. Jedno z nich niewiele dodaje do pomiaru, jeśli test trzeba skrócić (więcej we wpisie jak skrócić kwestionariusz). Precyzję w różnych miejscach skali opisuje funkcja informacyjna testu.
Krok 4. Założenia: jednowymiarowość i lokalna niezależność
Jednowymiarowość oznacza, że wynik zależy od jednej cechy. W eRm można ją sprawdzić testem Martina-Löfa: model dopasowuje się osobno do dwóch podzbiorów zadań i porównuje z jednym modelem. Przy podziale z01–z05 / z06–z10 wyszło LR = 39.95, df = 24, p = .022. Test reaguje jednak na każde odstępstwo od modelu, także na różne dyskryminacje. Sam istotny wynik nie dowodzi więc drugiego wymiaru.
Lokalna niezależność oznacza, że po uwzględnieniu cechy odpowiedzi na zadania nie są już skorelowane. Sprawdza się ją korelacjami reszt (Q3). Christensen i in. (2017) pokazali, że jedna stała wartość krytyczna nie działa – rozkład Q3 zależy od liczby zadań, liczebności próby i liczby kategorii. Zalecają bootstrap parametryczny dla każdego zbioru danych i ocenę Q3 względem średniej korelacji reszt. Liczymy więc Q3* – maksimum minus średnia – i porównujemy z bootstrapem: wylosowaliśmy 500 zbiorów z dopasowanego modelu Rascha i policzyliśmy w nich te same statystyki.
- Średnia Q3 wyniosła −0.109, a para z05–z06 miała Q3 = 0.191. Q3* (maksimum minus średnia) = 0.300 przy 95. percentylu z bootstrapu 0.142. Zadania z05 i z06 są zależne – wspólny wykres daje im dodatkową wspólną zmienność.
- Pierwsza składowa reszt standaryzowanych miała wartość własną 1.578 przy 95. percentylu 1.368. Najsilniej tworzyły ją z05 i z06 (0.55 i 0.56). „Drugi wymiar” to więc ta sama para zadań, a nie osobna cecha.
Krok 5. Infit i outfit: dopasowanie zadań
Outfit i infit to średnie kwadraty (MNSQ) standaryzowanych reszt o wartości oczekiwanej 1. Outfit reaguje na nieoczekiwane odpowiedzi osób dalekich od poziomu zadania, a infit – bliskich (Smith i in., 2008). Wartość powyżej 1 oznacza więcej szumu, niż przewiduje model (zadanie zbyt płaskie). Wartość poniżej 1 oznacza odpowiedzi zbyt przewidywalne (zadanie zbyt strome).
Progi – ostrożnie. Smith i in. (2008) podają, że większość badań przyjmuje zakres MNSQ 0.7–1.3, choć proponowane zakresy zależą od rodzaju testu. W tym samym badaniu statystyki t silnie zależały od liczebności próby, a MNSQ były względnie stabilne. Traktuj więc progi jako punkt odniesienia, a nie regułę usuwania. Lepiej sprawdzić, jakie wartości daje twój test, gdy model jest prawdziwy. W naszym bootstrapie (te same 500 zbiorów) outfit wszystkich zadań mieścił się w przedziale 0.66–1.25, a infit w 0.82–1.07. Oba zakresy są przesunięte w dół od 1, więc wartości nieco poniżej 1 nie są w tym teście sygnałem problemu.
Na tym tle odstają dwa zadania (Tabela 1). z07 ma outfit 1.33 i infit 1.21 (t = 4.90 i 5.22) – jest za płaskie: słabiej różnicuje osoby, niż zakłada model. z03 ma outfit 0.64 i infit 0.76 (t = −3.87 i −4.90) – jest za strome i różnicuje silniej niż pozostałe. Różnicę widać na empirycznych krzywych (Rysunek 2).
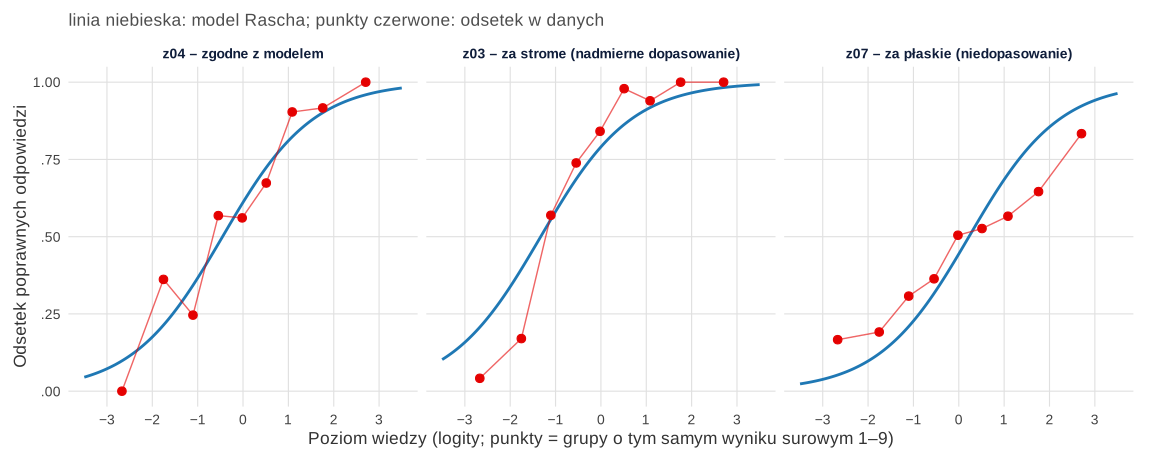
Wielkość próby zmienia t, nie MNSQ. W 200 losowych podpróbach po 150 osób mediana outfitu z07 wynosiła 1.32, a t = 2.31. Przy 300 osobach było to 1.33 i t = 3.44, a w pełnej próbie 1.33 i t = 4.90. Widać to po z02: infit 0.88 mieści się w zakresie z bootstrapu, a t = −2.43. Dlatego czytaj MNSQ i t razem.
Krok 6. Separacja i rzetelność osób
Rzetelność separacji osób (SepRel()) mówi, jaka część zróżnicowania miar osób nie jest błędem pomiaru. Wyniosła .57, a indeks separacji G = √(.57 / .43) = 1.15. To niewiele: błąd pomiaru w środku skali (SE około 0.72–0.78 logita) jest niewiele mniejszy niż rozrzut prawdziwych różnic między osobami. Taki test wystarczy do porównań średnich grup, ale nie do decyzji o pojedynczych osobach. To nie jest ten sam współczynnik co alfa Cronbacha.
Kontrolnie dopasowaliśmy ten sam model w pakiecie TAM, który szacuje parametry inną metodą (brzegowej największej wiarygodności). Po wycentrowaniu trudności różniły się najwyżej o 0.01 logita. Rzetelność ocen WLE wyniosła .58, a EAP .64. Podaj w pracy, którą rzetelność raportujesz – różne programy liczą ją różnie.
Krok 7. DIF i test Andersena
Test Andersena dzieli próbę na grupy i sprawdza, czy trudności zadań są w nich takie same (Andersen, 1973). Przy podziale według mediany wyniku surowego wyszło LR = 42.30, df = 9, p < .001. Gdy zadania różnią się dyskryminacją, ich trudności w grupie słabszych i lepszych osób się rozjeżdżają. To typowa przyczyna istotnego wyniku. Tu odpowiadało za nią głównie z07 – po jego usunięciu test przestał być istotny (krok 8).
Ten sam test z podziałem według kierunku studiów sprawdza DIF: LR = 28.70, df = 9, p = .001. Test Walda dla każdego zadania wskazał z09. Na pedagogice było ono trudniejsze o 0.82 logita (2.08 wobec 1.26; z = 3.73, p < .001). Ta różnica dotyczy osób o tym samym poziomie wiedzy, więc nie jest efektem niższej średniej grupy. Zadania z05 i z06 miały p = .009 i .012. Po korekcie Bonferroniego na 10 testów pozostało tylko z09 (p = .002). Zanim uznasz DIF w z05 i z06, rozwiąż ich zależność lokalną – przy wspólnym bodźcu różnica może wynikać z tego wspólnego składnika, a nie z samych zadań. Metody Mantela–Haenszela i regresji logistycznej oraz co dalej z pozycją z DIF opisuje wpis DIF krok po kroku.
Krok 8. Co zrobić z niedopasowanymi zadaniami
Nie usuwaj zadań mechanicznie po przekroczeniu progu. Każde usunięcie zmienia dopasowanie pozostałych zadań, a „czyszczenie” aż do braku istotnych testów dopasowuje test do jednej próby. Najpierw przeczytaj treść zadania i sprawdź klucz, dystraktory i liczbę braków (wpis jak pisać pytania testowe i dystraktory). Potem zdecyduj, zapisz uzasadnienie i pokaż wynik przed zmianą i po niej.
- Zadanie płaskie (z07). Gdy treść jest niejasna lub można je zgadnąć, usunięcie ma sens. Bez z07 test Andersena przestał być istotny (LR = 6.98, df = 8, p = .538), podobnie test Martina-Löfa (LR = 23.11, df = 19, p = .232). Rzetelność prawie się nie zmieniła (.57 i .56).
- Zadania zależne (z05 i z06). Zamiast usuwać, połącz je w jedną pozycję punktowaną 0–2 i dopasuj model częściowego kredytu. Połączona pozycja miała outfit 1.06 i infit 1.02. Rzetelność spadła z .56 do .54. Zależność lokalna zawyża rzetelność (Christensen i in., 2017), więc niższa wartość jest uczciwsza.
- Zadanie strome (z03) zostawiliśmy. Nadmierne dopasowanie zwykle traktuje się łagodniej: takie zadanie nie dodaje szumu, tylko różnicuje silniej, niż zakłada model. Opisz je jako ograniczenie.
- Zadanie z DIF (z09) – decyzja zależy od treści i celu: przeredagowanie, usunięcie albo pozostawienie z opisem. Z z09 w teście porównanie kierunków byłoby nieuczciwe wobec pedagogiki.
Co ukryliśmy w danych. W symulacji z03 miało dyskryminację 2.2, z07 – 0.35, a pozostałe zadania – 1. Zadania z05 i z06 dostały wspólny składnik losowy, a z09 było na pedagogice trudniejsze o 1 logit. Średnia wiedzy na psychologii była o 0.3 wyższa. Analiza wykryła wszystkie cztery problemy, choć żaden wskaźnik nie wykrył wszystkich.
Skala politomiczna: model skali ocen czy częściowego kredytu
Dla pozycji z kilkoma uporządkowanymi kategoriami (np. 0–3) są dwa modele z rodziny Rascha. Model skali ocen (RSM), wywodzący się z pracy Andricha (1978), zakłada tę samą strukturę progów kategorii we wszystkich pozycjach. Model częściowego kredytu (PCM) szacuje progi osobno dla każdej pozycji (Masters, 1982). W eRm służą do tego funkcje RSM() i PCM(). Modele są zagnieżdżone, więc porównasz je testem ilorazu wiarygodności.
W drugim fikcyjnym przykładzie 600 osób odpowiadało na 6 pozycji w skali 0–3. Pozycja p5 miała progi ściśnięte (0.26, 0.33 i 0.65), a p6 – rozciągnięte (−1.81, 0.71 i 2.95). PCM pasował wyraźnie lepiej: LR = 267.12, df = 10, p < .001. Wszystkie progi były uporządkowane, a MNSQ wyniosły 0.83–0.93. Dane pochodziły z PCM, więc i tu wartości poniżej 1 nie oznaczały problemu. Nieuporządkowane progi i ich skutki opisuje hasło o PCM. Klasyczne omówienie analizy skal ocen w ujęciu Rascha zawiera podręcznik Wrighta i Mastersa (1982). Gdy oceniający różnią się surowością, potrzebny jest wieloaspektowy model Rascha.
Jak opisać analizę w pracy
W rozdziale metodologicznym podaj model i metodę estymacji, program z wersją pakietu, sposób sprawdzenia założeń i kryteria dopasowania ze źródłem. W wynikach pokaż tabelę zadań, rzetelność i separację, wyniki DIF oraz każdą decyzję o zadaniu z uzasadnieniem. Jeśli test służy do ustalenia progu zaliczenia, zajrzyj do wpisu o metodzie Angoffa.
Tabela 1
Trudności zadań i statystyki dopasowania w modelu Rascha (test wiedzy z metodologii, 10 zadań)
| Zadanie | p | Trudność | SE | Outfit MNSQ | Infit MNSQ | Outfit t | Infit t |
|---|---|---|---|---|---|---|---|
| z01 | .80 | −1.67 | 0.11 | 0.82 | 0.95 | −1.43 | −0.79 |
| z02 | .74 | −1.25 | 0.10 | 0.86 | 0.88 | −1.36 | −2.43 |
| z03 | .75 | −1.33 | 0.10 | 0.64 | 0.76 | −3.87 | −4.90 |
| z04 | .60 | −0.45 | 0.09 | 0.92 | 0.98 | −1.28 | −0.48 |
| z05 | .50 | 0.02 | 0.09 | 0.99 | 0.95 | −0.11 | −1.32 |
| z06 | .50 | 0.03 | 0.09 | 0.93 | 0.98 | −1.11 | −0.53 |
| z07 | .46 | 0.22 | 0.09 | 1.33 | 1.21 | 4.90 | 5.22 |
| z08 | .32 | 0.90 | 0.09 | 0.89 | 0.93 | −1.42 | −1.64 |
| z09 | .21 | 1.61 | 0.10 | 0.88 | 0.93 | −1.03 | −1.14 |
| z10 | .17 | 1.92 | 0.11 | 0.87 | 0.87 | −0.87 | −1.93 |
Uwaga. N = 600 (dane fikcyjne); statystyki dopasowania bez 19 osób z wynikiem skrajnym. p = odsetek poprawnych odpowiedzi. Trudność w logitach (estymacja warunkowa, suma trudności = 0). Zakres MNSQ przy prawdziwym modelu (bootstrap parametryczny, 500 zbiorów): outfit 0.66–1.25, infit 0.82–1.07. Rzetelność separacji osób = .57.
Model Rascha w R – pełny kod
Kod odtwarza wszystkie liczby z tekstu i Tabeli 1. Pobierz plik model-rascha-test-wiedzy.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne przepisy korzystają z obiektów utworzonych wcześniej. Ziarna losowań (5571, 5572, 5578) i ziarno danych fikcyjnych (557) ustalono raz, bez dobierania pod wynik. Bootstrap w przepisie 3 trwa około minuty.
1. Dane, trudność klasyczna i wyniki skrajne
R
# Model Rascha: test wiedzy z metodologii, 10 zadań 0/1, 600 osób (dane fikcyjne)
options(width = 100)
dane <- read.csv("model-rascha-test-wiedzy.csv", encoding = "UTF-8")
X <- as.matrix(dane[, sprintf("z%02d", 1:10)])
table(dane$kierunek)
round(colMeans(X), 2)                 # odsetek poprawnych odpowiedzi (trudność klasyczna p)
suma <- rowSums(X)
table(suma)                           # rozkład wyników surowych 0–10
c(zero = sum(suma == 0), maks = sum(suma == 10))   # wyniki skrajne
Wynik w R
 pedagogika psychologia
        300         300
 z01  z02  z03  z04  z05  z06  z07  z08  z09  z10
0.80 0.74 0.75 0.60 0.50 0.50 0.46 0.32 0.21 0.17
suma
  0   1   2   3   4   5   6   7   8   9  10
 11  24  47  65  88 107  95  83  48  24   8
zero maks
  11    8
2. Model Rascha: trudności i miary osób
R
# Dopasowanie modelu Rascha metodą CML (pakiet eRm) (kontynuacja: X)
library(eRm)
rm1 <- RM(X)                          # domyślnie suma trudności = 0
trudnosc <- -coef(rm1)                # eRm zwraca łatwości (beta); trudność = −beta
names(trudnosc) <- colnames(X)
round(cbind(trudnosc = trudnosc, SE = rm1$se.beta), 2)
# miary osób (logity) dla każdego wyniku surowego; wyniki 0 i 10 są ekstrapolowane
pp <- person.parameter(rm1)
theta <- unname(coef(pp))             # jedna miara na osobę, w kolejności wierszy X
tab_osoby <- unique(data.frame(suma = rowSums(X), theta = theta, SE = pp$theta.table[, "Std.Error"]))
tab_osoby <- tab_osoby[order(tab_osoby$suma), ]
rownames(tab_osoby) <- NULL
round(tab_osoby, 2)
round(c(srednia_osob = mean(theta), SD_osob = sd(theta)), 2)
Wynik w R
    trudnosc   SE
z01    -1.67 0.11
z02    -1.25 0.10
z03    -1.33 0.10
z04    -0.45 0.09
z05     0.02 0.09
z06     0.03 0.09
z07     0.22 0.09
z08     0.90 0.09
z09     1.61 0.10
z10     1.92 0.11
   suma theta   SE
1     0 -3.65 1.38
2     1 -2.67 1.10
3     2 -1.75 0.86
4     3 -1.10 0.77
5     4 -0.55 0.73
6     5 -0.02 0.72
7     6  0.51 0.74
8     7  1.08 0.78
9     8  1.76 0.87
10    9  2.71 1.12
11   10  3.72 1.40
srednia_osob      SD_osob
        0.02         1.37
3. Jednowymiarowość i lokalna niezależność
R
# Założenia: jednowymiarowość i lokalna niezależność (kontynuacja: X, rm1, theta, trudnosc)
# 1. Test Martina-Löfa: zadania 1–5 a 6–10
MLoef(rm1, splitcr = rep(1:2, each = 5))
# 2. Reszty: PCA reszt standaryzowanych i Q3 (korelacje reszt surowych); osoby bez wyników skrajnych
reszty_i_q3 <- function(X, theta, b) {
  P <- plogis(outer(theta, b, "-"))
  R <- cor(X - P); q3 <- R[upper.tri(R)]
  c(lambda1 = eigen(cor((X - P) / sqrt(P * (1 - P))))$values[1],
    Q3_max = max(q3), Q3_gwiazdka = max(q3) - mean(q3))   # Q3* = maksimum minus średnia Q3
}
nie_skr <- rowSums(X) > 0 & rowSums(X) < 10
theta_hat <- theta[nie_skr]
obs <- reszty_i_q3(X[nie_skr, ], theta_hat, trudnosc)
Pm <- plogis(outer(theta_hat, trudnosc, "-"))
R <- cor(X[nie_skr, ] - Pm)
round(c(sredni_Q3 = mean(R[upper.tri(R)]), Q3_z05_z06 = R["z05", "z06"]), 3)
wektor1 <- eigen(cor((X[nie_skr, ] - Pm) / sqrt(Pm * (1 - Pm))))$vectors[, 1]   # pierwsza składowa reszt
names(wektor1) <- colnames(X)
round(wektor1 * sign(wektor1["z05"]), 2)
# 3. Bootstrap parametryczny: 500 zbiorów z dopasowanego modelu Rascha (te same theta i trudności)
#    – rozkład tych statystyk i średnich kwadratów (MNSQ), gdy model jest prawdziwy
set.seed(5571)
boot <- t(replicate(500, {
  Xs <- sim.rasch(theta_hat, trudnosc)
  Xs <- Xs[rowSums(Xs) > 0 & rowSums(Xs) < 10, ]
  ms <- RM(Xs); ps <- person.parameter(ms); fs <- itemfit(ps)
  c(reszty_i_q3(Xs, unname(coef(ps)), -coef(ms)),
    outfit_min = min(fs$i.outfitMSQ), outfit_max = max(fs$i.outfitMSQ),
    infit_min = min(fs$i.infitMSQ), infit_max = max(fs$i.infitMSQ))
}))
round(rbind(obserwowane = obs, p95_bootstrap = apply(boot[, 1:3], 2, quantile, .95)), 3)
Wynik w R
Martin-Loef-Test (split criterion: user-defined)
LR-value: 39.949
Chi-square df: 24
p-value: 0.022

 sredni_Q3 Q3_z05_z06
    -0.109      0.191
  z01   z02   z03   z04   z05   z06   z07   z08   z09   z10
-0.36 -0.11 -0.33 -0.16  0.55  0.56  0.10 -0.21 -0.21 -0.07
              lambda1 Q3_max Q3_gwiazdka
obserwowane     1.578  0.191       0.300
p95_bootstrap   1.368  0.032       0.142
4. Infit i outfit
R
# Dopasowanie pozycji: infit i outfit MNSQ oraz t (kontynuacja: X, pp, boot)
dop <- itemfit(pp)
round(data.frame(outfit_MNSQ = dop$i.outfitMSQ, infit_MNSQ = dop$i.infitMSQ,
                 outfit_t = dop$i.outfitZ, infit_t = dop$i.infitZ, row.names = colnames(X)), 2)
# Zakres MNSQ przy prawdziwym modelu: 2.5. percentyl minimum i 97.5. percentyl maksimum z 10 zadań (bootstrap)
round(c(outfit_od = quantile(boot[, "outfit_min"], .025, names = FALSE),
        outfit_do = quantile(boot[, "outfit_max"], .975, names = FALSE),
        infit_od  = quantile(boot[, "infit_min"], .025, names = FALSE),
        infit_do  = quantile(boot[, "infit_max"], .975, names = FALSE)), 2)
# Wielkość próby: mediany z 200 losowych podprób – MNSQ prawie się nie zmienia, t maleje razem z N
set.seed(5572)
mediany <- function(m) {
  w <- replicate(200, { f <- itemfit(person.parameter(RM(X[sample(nrow(X), m), ])))
                        c(f$i.outfitMSQ[c(3, 7)], f$i.outfitZ[c(3, 7)]) })
  apply(w, 1, median)
}
tab_n <- rbind("N = 150" = mediany(150), "N = 300" = mediany(300),
               "N = 600" = c(dop$i.outfitMSQ[c(3, 7)], dop$i.outfitZ[c(3, 7)]))
colnames(tab_n) <- c("MNSQ_z03", "MNSQ_z07", "t_z03", "t_z07")
round(tab_n, 2)
Wynik w R
    outfit_MNSQ infit_MNSQ outfit_t infit_t
z01        0.82       0.95    -1.43   -0.79
z02        0.86       0.88    -1.36   -2.43
z03        0.64       0.76    -3.87   -4.90
z04        0.92       0.98    -1.28   -0.48
z05        0.99       0.95    -0.11   -1.32
z06        0.93       0.98    -1.11   -0.53
z07        1.33       1.21     4.90    5.22
z08        0.89       0.93    -1.42   -1.64
z09        0.88       0.93    -1.03   -1.14
z10        0.87       0.87    -0.87   -1.93
outfit_od outfit_do  infit_od  infit_do
     0.66      1.25      0.82      1.07
        MNSQ_z03 MNSQ_z07 t_z03 t_z07
N = 150     0.63     1.32 -1.95  2.31
N = 300     0.64     1.33 -2.76  3.44
N = 600     0.64     1.33 -3.87  4.90
5. Separacja i rzetelność; kontrola w TAM
R
# Separacja i rzetelność osób (kontynuacja: X, pp)
rel <- SepRel(pp)
rel
G <- sqrt(rel$sep.rel / (1 - rel$sep.rel))           # indeks separacji osób
round(c(rzetelnosc = rel$sep.rel, separacja_G = G), 2)
# Kontrola w TAM (estymacja MML): trudności i rzetelność WLE/EAP
suppressPackageStartupMessages(library(TAM))
tm <- tam.mml(X, verbose = FALSE)
b_tam <- tm$xsi$xsi - mean(tm$xsi$xsi)                  # wycentrowane jak w eRm
round(rbind(eRm = trudnosc, TAM = b_tam), 2)
wle <- tam.wle(tm, progress = FALSE)
round(c(WLE = unique(wle$WLE.rel), EAP = tm$EAP.rel), 2)
Wynik w R
Separation Reliability: 0.5696
 rzetelnosc separacja_G
       0.57        1.15
      z01   z02   z03   z04  z05  z06  z07 z08  z09  z10
eRm -1.67 -1.25 -1.33 -0.45 0.02 0.03 0.22 0.9 1.61 1.92
TAM -1.67 -1.25 -1.33 -0.46 0.02 0.03 0.22 0.9 1.61 1.93
 WLE  EAP
0.58 0.64
6. Test Andersena i DIF
R
# DIF i test Andersena (kontynuacja: dane, rm1)
# 1. Test Andersena: podział według mediany wyniku surowego
LRtest(rm1, splitcr = "median")
# 2. Podział według kierunku studiów i test Walda dla każdego zadania
kier <- factor(dane$kierunek, levels = c("psychologia", "pedagogika"))
lr_kier <- LRtest(rm1, splitcr = kier)
lr_kier
# trudności w obu grupach (trudność = −beta) i test Walda
b_grupy <- -sapply(lr_kier$betalist, identity)
dimnames(b_grupy) <- list(colnames(X), levels(kier))
wald <- Waldtest(rm1, splitcr = kier)$coef.table
round(cbind(b_grupy, roznica = b_grupy[, 2] - b_grupy[, 1], z = wald[, 1], p = wald[, 2],
            p_Bonferroni = p.adjust(wald[, 2], "bonferroni")), 3)
Wynik w R
Andersen LR-test:
LR-value: 42.295
Chi-square df: 9
p-value:  0


Andersen LR-test:
LR-value: 28.7
Chi-square df: 9
p-value:  0.001

    psychologia pedagogika roznica      z     p p_Bonferroni
z01      -1.698     -1.672   0.027  0.123 0.902        1.000
z02      -1.360     -1.176   0.185  0.937 0.349        1.000
z03      -1.294     -1.379  -0.085 -0.427 0.669        1.000
z04      -0.557     -0.369   0.188  1.058 0.290        1.000
z05       0.243     -0.208  -0.451 -2.596 0.009        0.094
z06       0.243     -0.191  -0.435 -2.504 0.012        0.123
z07       0.308      0.130  -0.178 -1.027 0.305        1.000
z08       0.983      0.806  -0.176 -0.962 0.336        1.000
z09       1.262      2.077   0.815  3.733 0.000        0.002
z10       1.871      1.982   0.111  0.492 0.623        1.000
7. Warianty: bez z07 i z połączonymi z05–z06
R
# Co zrobić z problemami? Dwa warianty, oba do uzasadnienia treścią zadań (kontynuacja: X, rm1, pp)
# A. Bez zadania z07 (płaskie, niedopasowane)
X9 <- X[, colnames(X) != "z07"]
rm9 <- RM(X9); pp9 <- person.parameter(rm9)
LRtest(rm9, splitcr = "median")
MLoef(rm9, splitcr = rep(1:2, c(5, 4)))
# B. Dodatkowo z05 i z06 (wspólny bodziec) połączone w jedną pozycję 0–2 – model częściowego kredytu
X8 <- cbind(X9[, !colnames(X9) %in% c("z05", "z06")], z05_06 = X9[, "z05"] + X9[, "z06"])
pcm8 <- PCM(X8); pp8 <- person.parameter(pcm8)
dop8 <- itemfit(pp8)
round(data.frame(outfit_MNSQ = dop8$i.outfitMSQ, infit_MNSQ = dop8$i.infitMSQ, row.names = colnames(X8)), 2)
round(c(rzetelnosc_10 = SepRel(pp)$sep.rel, bez_z07 = SepRel(pp9)$sep.rel, z05_06_razem = SepRel(pp8)$sep.rel), 2)
Wynik w R
Andersen LR-test:
LR-value: 6.984
Chi-square df: 8
p-value:  0.538


Martin-Loef-Test (split criterion: user-defined)
LR-value: 23.112
Chi-square df: 19
p-value: 0.232

       outfit_MNSQ infit_MNSQ
z01           0.79       0.94
z02           0.84       0.88
z03           0.63       0.75
z04           0.90       0.97
z08           0.89       0.93
z09           0.87       0.93
z10           0.86       0.88
z05_06        1.06       1.02
rzetelnosc_10       bez_z07  z05_06_razem
         0.57          0.56          0.54
8. Skala 0–3: RSM a PCM
R
# Skala politomiczna 0–3: model skali ocen (RSM) a model częściowego kredytu (PCM) (dane symulowane)
set.seed(5578)
n <- 600; theta <- rnorm(n, 0, 1.2)
progi <- rbind(c(-1.5, -0.3, 1.0), c(-1.0, 0.2, 1.5), c(-2.0, -0.8, 0.5),
               c(-1.2, 0.0, 1.3), c(-0.4, -0.1, 0.2), c(-2.5, 0.0, 2.5))   # p5 – progi ściśnięte, p6 – rozciągnięte
sim_pcm <- function(theta, d) {                     # losowanie odpowiedzi 0–3 z modelu PCM
  licz <- cbind(0, t(apply(outer(theta, d, "-"), 1, cumsum)))
  pr <- exp(licz) / rowSums(exp(licz))
  apply(pr, 1, function(p) sample(0:3, 1, prob = p))
}
Y <- sapply(1:6, function(j) sim_pcm(theta, progi[j, ]))
colnames(Y) <- paste0("p", 1:6)
rsm <- RSM(Y); pcm <- PCM(Y)
lr <- 2 * (pcm$loglik - rsm$loglik); df <- pcm$npar - rsm$npar
round(c(LR = lr, df = df, p = pchisq(lr, df, lower.tail = FALSE)), 4)
round(thresholds(pcm)$threshtable[[1]][, -1], 2)    # progi PCM dla każdej pozycji
dop_pcm <- itemfit(person.parameter(pcm))
round(data.frame(outfit_MNSQ = dop_pcm$i.outfitMSQ, infit_MNSQ = dop_pcm$i.infitMSQ, row.names = colnames(Y)), 2)
Wynik w R
      LR       df        p
267.1228  10.0000   0.0000
   Threshold 1 Threshold 2 Threshold 3
p1       -0.79        0.33        1.45
p2       -0.48        0.76        1.76
p3       -1.30       -0.42        1.08
p4       -0.46        0.36        1.66
p5        0.26        0.33        0.65
p6       -1.81        0.71        2.95
   outfit_MNSQ infit_MNSQ
p1        0.89       0.89
p2        0.84       0.87
p3        0.83       0.83
p4        0.85       0.87
p5        0.83       0.84
p6        0.93       0.93
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- eRm (wersja 1.0.10): Mair, P., & Hatzinger, R. (2007). Extended Rasch modeling: The eRm package for the application of IRT models in R. Journal of Statistical Software, 20(9). https://doi.org/10.18637/jss.v020.i09
- TAM (wersja 4.3.25): Robitzsch, A., Kiefer, T., & Wu, M. (2025). TAM: Test analysis modules [R package]. https://doi.org/10.32614/CRAN.package.TAM
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Odwrócony znak trudności – eRm podaje łatwości (beta); trudność to −beta.
- Usuwanie zadań po samym progu MNSQ lub t, bez czytania treści i bez porównania wyników przed i po.
- Ocena dopasowania samymi statystykami t w dużej próbie – wtedy istotne jest prawie wszystko.
- Pominięcie lokalnej niezależności przy zadaniach o wspólnym tekście lub wykresie; rzetelność wychodzi wtedy zawyżona.
- Porównywanie grup bez sprawdzenia DIF albo uznanie DIF bez korekty na liczbę testów.
- Brak informacji o wynikach skrajnych i o tym, którą rzetelność raportujesz.
Planując nowy test, zacznij od wpisu o liczebności próby i dobrych pozycjach w IRT. Analizę całej ankiety wiedzy krok po kroku pokazuje wpis ankieta wiedzy – analiza krok po kroku.
Najczęstsze pytania
Jak zrobić analizę modelem Rascha w R?
Wczytaj macierz odpowiedzi 0/1 i dopasuj model funkcją eRm::RM(). Trudności to -coef(), bo eRm podaje łatwości. Miary osób daje person.parameter(), dopasowanie zadań itemfit(), rzetelność separacji SepRel(), a test Andersena i DIF – LRtest() i Waldtest(). Lokalną niezależność sprawdź korelacjami reszt (Q3).
Jakie wartości infit i outfit są dobre?
Wartość oczekiwana to 1. Smith i in. (2008) podają, że większość badań przyjmuje zakres MNSQ 0.7–1.3, ale właściwy zakres zależy od testu. W przykładzie przy prawdziwym modelu outfit mieścił się w przedziale 0.66–1.25, a infit w 0.82–1.07. Statystyki t silnie zależą od liczebności próby, więc czytaj je razem z MNSQ.
Co oznacza istotny test Andersena?
Że trudności zadań różnią się między grupami osób. Przy podziale według mediany wyniku najczęstszą przyczyną są zadania o innej dyskryminacji. W przykładzie test dał LR = 42.30, df = 9, p < .001, a po usunięciu płaskiego zadania z07 przestał być istotny (p = .538). Przy podziale według grupy, np. kierunku studiów, test sprawdza DIF.
Czy usuwać zadania niedopasowane do modelu Rascha?
Nie mechanicznie. Najpierw sprawdź treść, klucz i dystraktory. Zadanie płaskie i niejasne często się usuwa. Parę zadań o wspólnym bodźcu lepiej połączyć w jedną pozycję punktowaną częściowo. Nadmiernie dopasowane zadanie zwykle się zostawia. Każdą decyzję uzasadnij i pokaż wyniki przed zmianą i po niej.
Czym różni się model skali ocen od modelu częściowego kredytu?
Model skali ocen zakłada tę samą strukturę progów kategorii we wszystkich pozycjach. Model częściowego kredytu szacuje progi osobno dla każdej pozycji. Modele są zagnieżdżone, więc porównasz je testem ilorazu wiarygodności; w przykładzie PCM pasował lepiej, LR = 267.12, df = 10, p < .001.
Powiązane hasła
Przeczytaj też
IRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →PoradnikDIF krok po kroku: Mantel–Haenszel, regresja i IRT
Trzy metody wykrywania DIF na jednych danych: klasyfikacja ETS, ΔR² w regresji logistycznej, IRT z kotwicą, DTF i wzór opisu.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →Analizujesz test lub skalę modelem Rascha?
Pomożemy sprawdzić założenia, ocenić dopasowanie zadań i DIF, podjąć uzasadnione decyzje o pozycjach i opisać wyniki tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, E. B. (1973). A goodness of fit test for the Rasch model. Psychometrika, 38(1), 123–140. https://doi.org/10.1007/bf02291180
- Andrich, D. (1978). A rating formulation for ordered response categories. Psychometrika, 43(4), 561–573. https://doi.org/10.1007/bf02293814
- Bond, T. G., & Fox, C. M. (2015). Applying the Rasch model: Fundamental measurement in the human sciences (3rd ed.). Routledge. https://doi.org/10.4324/9781315814698
- Christensen, K. B., Makransky, G., & Horton, M. (2017). Critical values for Yen's Q3: Identification of local dependence in the Rasch model using residual correlations. Applied Psychological Measurement, 41(3), 178–194. https://doi.org/10.1177/0146621616677520 ● Otwarty dostęp: pełny tekst
- Masters, G. N. (1982). A Rasch model for partial credit scoring. Psychometrika, 47(2), 149–174. https://doi.org/10.1007/bf02296272
- Rasch, G. (1980). Probabilistic models for some intelligence and attainment tests (Expanded ed.). University of Chicago Press.
- Smith, A. B., Rush, R., Fallowfield, L. J., Velikova, G., & Sharpe, M. (2008). Rasch fit statistics and sample size considerations for polytomous data. BMC Medical Research Methodology, 8(1), Article 33. https://doi.org/10.1186/1471-2288-8-33 ● Otwarty dostęp
- Wright, B. D., & Masters, G. N. (1982). Rating scale analysis. Mesa Press.
Cytowania BibTeX
@article{andersen1973goodness, author={Andersen, Erling B.}, title={{A goodness of fit test for the Rasch model}}, journal={Psychometrika}, year={1973}, volume={38}, number={1}, pages={123--140}, doi={10.1007/bf02291180}}@article{andrich1978rating, author={Andrich, David}, title={{A rating formulation for ordered response categories}}, journal={Psychometrika}, year={1978}, volume={43}, number={4}, pages={561--573}, doi={10.1007/bf02293814}}@book{bond2015applying, author={Bond, Trevor G. and Fox, Christine M.}, title={{Applying the Rasch model: Fundamental measurement in the human sciences}}, year={2015}, edition={3}, publisher={Routledge}, doi={10.4324/9781315814698}}@article{christensen2017critical, author={Christensen, Karl Bang and Makransky, Guido and Horton, Mike}, title={{Critical values for Yen's Q3: Identification of local dependence in the Rasch model using residual correlations}}, journal={Applied Psychological Measurement}, year={2017}, volume={41}, number={3}, pages={178--194}, doi={10.1177/0146621616677520}}@article{masters1982rasch, author={Masters, Geoff N.}, title={{A Rasch model for partial credit scoring}}, journal={Psychometrika}, year={1982}, volume={47}, number={2}, pages={149--174}, doi={10.1007/bf02296272}}@book{rasch1980probabilistic, author={Rasch, Georg}, title={{Probabilistic models for some intelligence and attainment tests}}, year={1980}, edition={Expanded ed.}, publisher={University of Chicago Press}}@article{smith2008rasch, author={Smith, Adam B. and Rush, Robert and Fallowfield, Lesley J. and Velikova, Galina and Sharpe, Michael}, title={{Rasch fit statistics and sample size considerations for polytomous data}}, journal={BMC Medical Research Methodology}, year={2008}, volume={8}, number={1}, eid={33}, doi={10.1186/1471-2288-8-33}}@book{wright1982rating, author={Wright, Benjamin D. and Masters, Geofferey N.}, title={{Rating scale analysis}}, year={1982}, publisher={Mesa Press}}