Co to jest funkcja informacyjna testu?
Funkcja informacyjna testu (ang. test information function, TIF) to krzywa z teorii reagowania na pozycje testowe (IRT), która pokazuje, jak precyzyjnie test mierzy cechę θ na każdym jej poziomie. Jest sumą funkcji informacyjnych pozycji. Pozycja dychotomiczna daje najwięcej informacji w pobliżu swojej trudności b, a tym więcej, im wyższa jej dyskryminacja a; dla pozycji wielokategorialnych, np. w modelu GRM, informacja rozkłada się na zakres progów.
Informacja, błąd standardowy i rzetelność warunkowa
Najważniejsza zależność to I(θ) = 1/SE(θ)², czyli błąd standardowy oszacowania cechy wynosi SE(θ) = 1/√I(θ). Zamiast jednego standardowego błędu pomiaru dla wszystkich badanych IRT daje błąd zależny od poziomu cechy. Nicewander (2018) pokazał, że warunkowa rzetelność przy ustalonym θ jest prostym przekształceniem informacji: I/(I + 1), co przy θ o wariancji 1 równa się 1/(1 + SE²). Zależność ta dotyczy pozycji dychotomicznych i wielokategorialnych, a także testów adaptacyjnych. Jeden ogólny współczynnik rzetelności uśrednia natomiast precyzję po rozkładzie cechy w grupie, więc zmienia się z populacją.
Przykład
Dla symulowanego testu 10 zadań 0/1 (model 2PL, 1000 osób) informacja w θ = 0 wynosi 3.34, więc SE = 0.55, a rzetelność warunkowa .77. Przy θ = 2 informacja spada do 1.56 (SE = 0.80, rzetelność .61), a przy θ = 3 do 0.59 (SE = 1.30, rzetelność .37). Rzetelność brzegowa całego testu to .73 – liczba, która ukrywa słabą precyzję na krańcach skali.
Do czego się przydaje
- Budowa testu. Pozycje dobiera się tak, by informacja była wysoka tam, gdzie zapadają decyzje, np. wokół punktu odcięcia.
- Testowanie adaptacyjne. W CAT kolejna pozycja to zwykle ta o największej informacji przy bieżącym oszacowaniu θ.
- Skracanie skal. Cook i Wind (2024) pokazują, że wskaźniki precyzji z IRT pomagają oceniać osoby, pozycje oraz skale krótkie i adaptacyjne.
Na rysunku
Rysunek pokazuje test z przykładu (10 zadań, model 2PL) na jednej osi θ: u góry informację, u dołu wynikający z niej błąd standardowy. Jak błąd pomiaru zaniża korelacje i jak wygląda przedział wokół wyniku osoby w klasycznej teorii testów, pokazuje wpis Rzetelność i błąd pomiaru – wizualizacja.
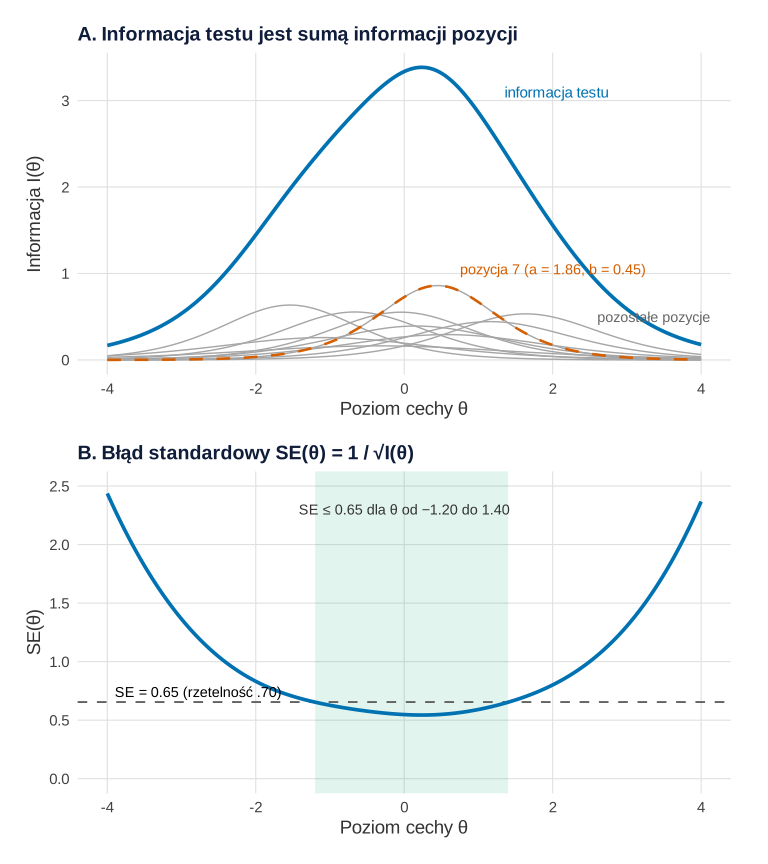
Co widać. Każda pozycja daje mały garb informacji w pobliżu swojej trudności. Pozycja 7 ma najwyższą oszacowaną dyskryminację (a = 1.86), więc jej garb jest najwyższy: 0.86 przy θ = 0.44, czyli tyle, ile wynosi a²/4 w modelu 2PL. Informacja testu to suma garbów; osiąga 3.38 przy θ = 0.24. W panelu B ta sama krzywa odwrócona przez SE = 1/√I ma kształt litery U, z minimum 0.54. Przy SE = 0.65 rzetelność warunkowa wynosi .70. Test spełnia ten poziom tylko dla θ od −1.20 do 1.40, a poza tym zakresem błąd szybko rośnie.
Na co uważać. Krzywe pochodzą z oszacowanych parametrów, więc dziedziczą ich błąd – przy małej próbie kalibracyjnej kształt krzywej może się wyraźnie różnić od prawdziwego. Wykres nie mówi, ile osób ma dany poziom cechy: test może być precyzyjny tam, gdzie prawie nikogo nie ma. Próg .70 jest tu tylko przykładem; w praktyce wybiera się go zależnie od celu pomiaru. Na krańcach skali, gdzie informacji jest mało, oszacowanie θ zależy też silnie od metody (np. EAP ściąga wyniki ku średniej).
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Dane są te same co w przykładzie (set.seed(655)); próg rzetelności .70 wybrano ręcznie jako ilustrację.
Kod R rysunku 1
# Rysunek 1. Informacja pozycji i testu (A) oraz błąd standardowy oszacowania θ (B)
suppressPackageStartupMessages({ library(mirt); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw; test i pozycje różnią się też grubością i rodzajem linii
kol <- c(test = "#0072B2", poz7 = "#D55E00", pasmo = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "none",
        plot.title = element_text(face = "bold"))

# Te same dane i model co w przykładzie: 1000 osób, 10 zadań 0/1, model 2PL
set.seed(655)
a <- c(1.6, 1.2, 1.9, 0.8, 1.4, 1.1, 1.7, 1.0, 1.3, 1.5)
b <- c(-1.5, -1.0, -0.6, -0.3, 0.0, 0.2, 0.5, 0.8, 1.2, 1.6)
dane <- simdata(a = matrix(a), d = matrix(-a * b), N = 1000, itemtype = "dich")
m2pl <- mirt(dane, 1, itemtype = "2PL", verbose = FALSE)

th <- seq(-4, 4, by = 0.04)
Ip <- sapply(1:10, function(j) iteminfo(extract.item(m2pl, j), matrix(th)))   # informacja pozycji
I  <- testinfo(m2pl, matrix(th))                                               # informacja testu = suma
SE <- 1 / sqrt(I)
se_70 <- sqrt(1 / 0.70 - 1)        # SE, przy którym rzetelność warunkowa 1 / (1 + SE²) wynosi .70

# Liczby do opisu: maksimum informacji, zakres θ z rzetelnością warunkową ≥ .70
round(c(theta_max = th[which.max(I)], I_max = max(I), SE_min = min(SE), se_70 = se_70), 2)
round(range(th[SE <= se_70]), 2)
round(max(abs(rowSums(Ip) - I)), 10)                                           # suma pozycji = test
# Pozycja 7 ma najwyższe oszacowane a: szczyt jej informacji leży w b i wynosi a² / 4
par7 <- coef(m2pl, IRTpars = TRUE, simplify = TRUE)$items[7, c("a", "b")]
round(c(par7, theta_szczytu = th[which.max(Ip[, 7])], I_szczyt = max(Ip[, 7]), a2_4 = par7[["a"]]^2 / 4), 2)

dp <- data.frame(theta = rep(th, 10), I = c(Ip), poz = rep(1:10, each = length(th)))
pa <- ggplot() +
  geom_line(data = dp, aes(theta, I, group = poz), colour = "grey65", linewidth = 0.5) +
  geom_line(data = subset(dp, poz == 7), aes(theta, I), colour = kol[["poz7"]],
            linewidth = 0.9, linetype = "dashed") +
  geom_line(data = data.frame(theta = th, I = I), aes(theta, I), colour = kol[["test"]], linewidth = 1.3) +
  annotate("text", x = 1.35, y = 3.1, label = "informacja testu", hjust = 0, colour = kol[["test"]], size = 4) +
  annotate("text", x = 0.75, y = 1.05, label = "pozycja 7 (a = 1.86, b = 0.45)", hjust = 0, colour = kol[["poz7"]], size = 3.8) +
  annotate("text", x = 2.6, y = 0.5, label = "pozostałe pozycje", hjust = 0, colour = "grey40", size = 3.8) +
  labs(title = "A. Informacja testu jest sumą informacji pozycji", x = "Poziom cechy θ", y = "Informacja I(θ)") + motyw

zakres <- range(th[SE <= se_70])
pb <- ggplot(data.frame(theta = th, SE = SE), aes(theta, SE)) +
  annotate("rect", xmin = zakres[1], xmax = zakres[2], ymin = -Inf, ymax = Inf, fill = kol[["pasmo"]], alpha = 0.12) +
  geom_hline(yintercept = se_70, linetype = "dashed", colour = "grey35") +
  geom_line(colour = kol[["test"]], linewidth = 1.3) +
  annotate("text", x = -3.9, y = se_70, label = "SE = 0.65 (rzetelność .70)", hjust = 0, vjust = -0.5, size = 3.8) +
  annotate("text", x = 0, y = 2.3, label = gsub("-", "\u2212", sprintf("SE ≤ 0.65 dla θ od %.2f do %.2f", zakres[1], zakres[2])),
           size = 3.8, colour = "grey20") +
  scale_y_continuous(limits = c(0, 2.5)) +
  labs(title = "B. Błąd standardowy SE(θ) = 1 / √I(θ)", x = "Poziom cechy θ", y = "SE(θ)") + motyw

p1 <- pa / pb
p1   # zapis: ggsave("funkcja-informacyjna-testu-i-blad.svg", p1, width = 8, height = 9)
Wynik w R
theta_max     I_max    SE_min     se_70
     0.24      3.38      0.54      0.65
[1] -1.2  1.4
[1] 0
            a             b theta_szczytu      I_szczyt          a2_4
         1.86          0.45          0.44          0.86          0.86
Jak opisać w pracy
Na co uważać
Informacja zależy od przyjętego modelu i metryki θ, więc wartości z różnych analiz porównuj ostrożnie. Wzór I/(I + 1) zakłada wariancję cechy równą 1. Planując test, sprawdzaj informację w zakresie, który ma znaczenie – wskazówki daje wpis o dobrych pozycjach testowych w IRT.
Funkcja informacyjna testu w R
Kod symuluje odpowiedzi na 10 zadań 0/1, dopasowuje model 2PL i liczy informację testu, błąd standardowy i rzetelność warunkową dla wybranych wartości θ. Liczby w tekście pochodzą z tego kodu.
Informacja, SE(θ) i rzetelność warunkowa
R
library(mirt)
set.seed(655)
n <- 1000
a <- c(1.6, 1.2, 1.9, 0.8, 1.4, 1.1, 1.7, 1.0, 1.3, 1.5)   # 10 pozycji 0/1 (2PL)
b <- c(-1.5, -1.0, -0.6, -0.3, 0.0, 0.2, 0.5, 0.8, 1.2, 1.6)
dane <- simdata(a = matrix(a), d = matrix(-a * b), N = n, itemtype = "dich")
m2pl <- mirt(dane, 1, itemtype = "2PL", verbose = FALSE)
th <- matrix(c(-3, -2, -1, 0, 1, 2, 3))
I  <- testinfo(m2pl, th)                     # informacja testu
tab <- data.frame(theta = th[, 1], I = I, SE = 1 / sqrt(I),
                  rel_warunkowa = I / (I + 1))  # 1 / (1 + SE^2) przy wariancji theta = 1
round(tab, 2)
round(iteminfo(extract.item(m2pl, 3), th), 2) # wklad pozycji 3 (najwyzsze a)
round(marginal_rxx(m2pl), 2)                 # rzetelnosc brzegowa (srednia po rozkladzie theta)
Wynik w R
  theta    I   SE rel_warunkowa
1    -3 0.54 1.36          0.35
2    -2 1.45 0.83          0.59
3    -1 2.54 0.63          0.72
4     0 3.34 0.55          0.77
5     1 2.86 0.59          0.74
6     2 1.56 0.80          0.61
7     3 0.59 1.30          0.37
[1] 0.06 0.24 0.52 0.44 0.16 0.04 0.01
[1] 0.73
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mirt). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak przeliczyć informację testu na błąd standardowy?
SE(θ) = 1/√I(θ). Informacja 4 daje SE = 0.50, a informacja 1 – SE = 1.00. W przykładzie informacja 3.34 przy θ = 0 odpowiada SE = 0.55.
Czym rzetelność warunkowa różni się od alfy Cronbacha?
Alfa to jedna liczba dla całej grupy. Rzetelność warunkowa z IRT zmienia się z poziomem cechy: w przykładzie wynosi .77 przy θ = 0, ale tylko .37 przy θ = 3.
Jak policzyć funkcję informacyjną testu w R?
W pakiecie mirt po dopasowaniu modelu: testinfo(model, Theta) dla całego testu i iteminfo(extract.item(model, j), Theta) dla pozycji j. Wykres daje plot(model, type = "info").
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Teoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikDobre pozycje testowe i liczebność próby w IRT
Kryteria dobrej pozycji, przykłady z badań, planowanie próby symulacją Monte Carlo w R i najważniejsze przeliczenia parametrów IRT.
Czytaj →PoradnikJak skrócić kwestionariusz
Ładunki CFA, informacja IRT i mapa treści przy wyborze pozycji, a potem walidacja na nowej próbie: omega, korekta korelacji z pełną wersją, trafność.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. M., & Wind, S. A. (2024). Item response theory: A modern measurement approach to reliability and precision for counseling researchers. Measurement and Evaluation in Counseling and Development, 57(2), 116–135. https://doi.org/10.1080/07481756.2023.2301284
- Nicewander, W. A. (2018). Conditional reliability coefficients for test scores. Psychological Methods, 23(2), 351–362. https://doi.org/10.1037/met0000132
Cytowania BibTeX
@article{cook2024item, author={Cook, Ryan M. and Wind, Stefanie A.}, title={{Item response theory: A modern measurement approach to reliability and precision for counseling researchers}}, journal={Measurement and Evaluation in Counseling and Development}, year={2024}, volume={57}, number={2}, pages={116--135}, doi={10.1080/07481756.2023.2301284}}@article{nicewander2018conditional, author={Nicewander, W. Alan}, title={{Conditional reliability coefficients for test scores}}, journal={Psychological Methods}, year={2018}, volume={23}, number={2}, pages={351--362}, doi={10.1037/met0000132}}