Co to jest komputerowe testowanie adaptacyjne?
Komputerowe testowanie adaptacyjne (ang. computerized adaptive testing, CAT) to sposób przeprowadzania testu, w którym komputer po każdej odpowiedzi szacuje poziom mierzonej cechy i dobiera kolejną pozycję z banku tak, by była najbardziej informatywna dla tej osoby. Każdy badany dostaje więc inny, zwykle krótszy zestaw pytań, a wyniki pozostają porównywalne, bo wszystkie pozycje skalibrowano wcześniej na wspólnej skali teorii reagowania na pozycje testowe (IRT), np. w modelu Rascha albo modelu dwuparametrycznym.
Jak działa CAT
- Start: wstępne oszacowanie cechy, np. średnia w populacji.
- Wybór pozycji: pozycja o maksymalnej informacji przy bieżącym oszacowaniu, z ograniczeniami treściowymi i kontrolą ekspozycji.
- Aktualizacja: nowe oszacowanie cechy (np. EAP) i jego błąd pomiaru.
- Zakończenie: gdy błąd spadnie poniżej progu albo po maksymalnej liczbie pozycji.
Weiss (1982) opisał, że przy dobrze zaprojektowanym banku test adaptacyjny daje jednakową precyzję na wszystkich poziomach cechy, a w badaniach na żywo wymagał około połowy pozycji testu konwencjonalnego. Weiss i Kingsbury (1984) pokazali zastosowania szkolne, np. adaptacyjny test opanowania materiału, który trafniej klasyfikował uczniów przy mniejszej liczbie pytań.
Przykład
W symulacji w R (bank 200 pozycji, 300 osób) CAT kończył się po osiągnięciu błędu 0.30. Potrzebował średnio 14.7 pozycji, a średni błąd wyniósł 0.295 (RMSE 0.289). Stały test z 20 pozycji o średniej trudności miał średni błąd 0.342. U 40 osób o skrajnym poziomie cechy (|θ| > 1.5) różnica była większa: 0.295 w CAT wobec 0.480 w teście stałym.
Na rysunku
Rysunek śledzi jedną osobę o wysokim poziomie cechy (θ = 1.8) w dwóch wersjach testu z przykładu: adaptacyjnej (bank 200 pozycji, stop przy błędzie 0.30) i stałej (20 pozycji o średniej trudności). Po każdej odpowiedzi oba warianty liczą nowe oszacowanie EAP i jego błąd.
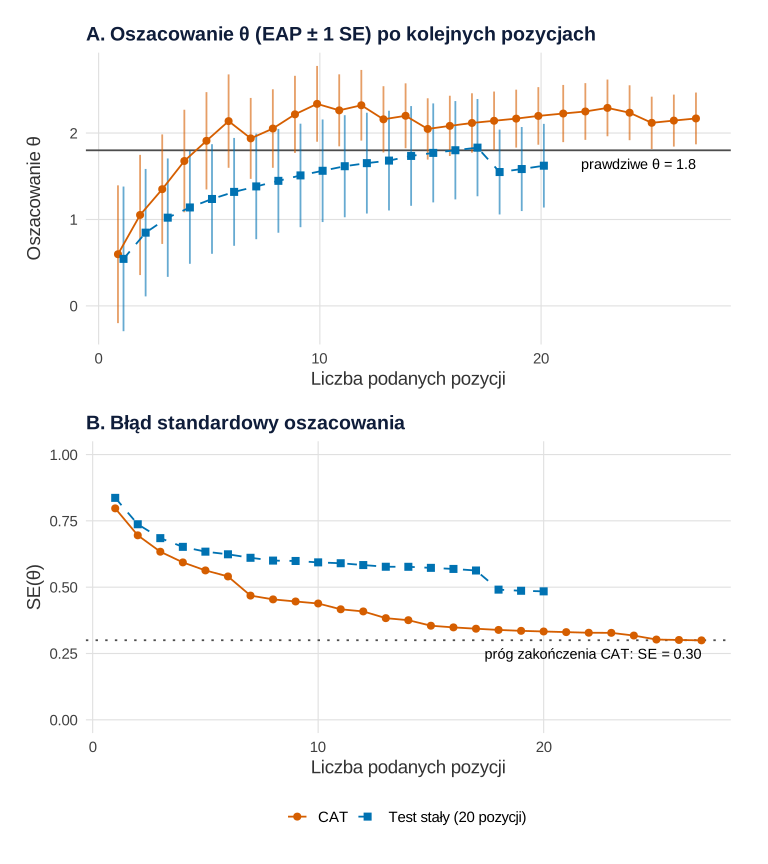
Co widać. CAT szybko „idzie w górę” i podaje coraz trudniejsze pozycje: ich średnia trudność wynosi 1.40, a w teście stałym 0.00. Dlatego błąd maleje szybciej. Już po 7 pozycjach CAT osiąga taki błąd, jaki test stały ma dopiero po 20 (0.48). Po 20 pozycjach błąd CAT wynosi 0.33. Próg 0.30 osoba osiąga po 27 pozycjach, wyraźnie więcej niż średnio w przykładzie (14.7). Bank pozycji ma trudności z rozkładu normalnego wokół 0, więc dla osób z krańca skali brakuje pozycji o dopasowanej trudności.
Na co uważać. To jedna osoba i jeden ciąg losowych odpowiedzi. Końcowe oszacowanie CAT (2.17) leży dalej od prawdy niż jeden błąd standardowy – przy losowych odpowiedziach to normalne i nie świadczy o błędzie procedury. Na tej podstawie nie da się więc ocenić trafności żadnej z metod – do tego służy symulacja wielu osób z przykładu powyżej. Wykres nie pokazuje też ograniczeń stosowanych w praktyce, np. kontroli ekspozycji pozycji, które wydłużają test. Związek błędu z informacją opisuje funkcja informacyjna testu.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Bank pozycji jest ten sam co w przykładzie (set.seed(4681)), a odpowiedzi osoby losowane są dalej z tego samego strumienia. Poziom cechy θ = 1.8 wybrano ręcznie, żeby pokazać osobę z krańca skali; ziarna nie zmieniano.
Kod R rysunku 1
# Rysunek 1. Jedna osoba w teście adaptacyjnym i w teście stałym: oszacowanie θ (A) i jego błąd (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw; warianty testu różnią się też kształtem punktów i rodzajem linii
kol <- c("CAT" = "#D55E00", "Test stały (20 pozycji)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Ten sam bank co w przykładzie: 200 pozycji 2PL (set.seed(4681)); potem odpowiedzi jednej osoby
set.seed(4681)
K <- 200
a <- runif(K, 0.8, 2.0); b <- rnorm(K)
siatka <- seq(-4, 4, by = 0.05); prior <- dnorm(siatka)
P <- function(th, j) plogis(a[j] * (th - b[j]))
eap <- function(j, x) {                          # oszacowanie EAP i jego błąd standardowy
  L <- prior
  for (i in seq_along(j)) L <- L * P(siatka, j[i])^x[i] * (1 - P(siatka, j[i]))^(1 - x[i])
  w <- L / sum(L); m <- sum(w * siatka)
  c(theta = m, se = sqrt(sum(w * (siatka - m)^2)))
}
theta_osoby <- 1.8                               # osoba o wysokim poziomie cechy (wybrana ręcznie)

# CAT: pozycja o maksymalnej informacji przy bieżącym θ, stop przy SE < 0.30 (maks. 40 pozycji)
j <- integer(0); x <- integer(0); est <- c(theta = 0, se = 1); sciezka_cat <- NULL
while (est["se"] > 0.30 && length(j) < 40) {
  p <- P(est["theta"], seq_len(K)); info <- a^2 * p * (1 - p)
  info[j] <- -Inf
  nowa <- which.max(info)
  j <- c(j, nowa); x <- c(x, rbinom(1, 1, P(theta_osoby, nowa)))
  est <- eap(j, x)
  sciezka_cat <- rbind(sciezka_cat, c(n = length(j), est, b = b[nowa]))
}
# Test stały: te same 20 pozycji o średniej trudności dla każdego, w tej samej kolejności
staly <- order(abs(b))[1:20]
xs <- rbinom(20, 1, P(theta_osoby, staly))
sciezka_st <- t(sapply(1:20, function(m) c(n = m, eap(staly[1:m], xs[1:m]), b = b[staly[m]])))

round(sciezka_cat[nrow(sciezka_cat), ], 2)       # CAT: liczba pozycji, θ, SE na końcu
round(sciezka_st[20, ], 2)                       # test stały po 20 pozycjach
round(c(sr_b_CAT = mean(sciezka_cat[, "b"]), sr_b_staly = mean(b[staly])), 2)
round(sciezka_cat[20, c("theta", "se")], 2)     # CAT po 20 pozycjach (tyle, ile ma test stały)
min(sciezka_cat[sciezka_cat[, "se"] <= sciezka_st[20, "se"], "n"])  # po ilu pozycjach CAT osiąga SE testu stałego

d <- rbind(data.frame(sciezka_cat, test = "CAT"), data.frame(sciezka_st, test = "Test stały (20 pozycji)"))
d$test <- factor(d$test, names(kol))
pa <- ggplot(d, aes(n, theta, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = theta_osoby, colour = "grey30") +
  annotate("text", x = max(d$n), y = theta_osoby, label = "prawdziwe θ = 1.8", hjust = 1, vjust = 1.8, size = 3.8) +
  geom_errorbar(aes(ymin = theta - se, ymax = theta + se), width = 0, linetype = "solid",
                position = position_dodge(width = 0.5), alpha = 0.6, show.legend = FALSE) +
  geom_line(position = position_dodge(width = 0.5)) +
  geom_point(size = 2.4, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "A. Oszacowanie θ (EAP ± 1 SE) po kolejnych pozycjach",
       x = "Liczba podanych pozycji", y = "Oszacowanie θ") + motyw
pb <- ggplot(d, aes(n, se, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 0.30, colour = "grey30", linetype = "dotted") +
  annotate("text", x = max(d$n), y = 0.30, label = "próg zakończenia CAT: SE = 0.30", hjust = 1, vjust = 1.8, size = 3.8) +
  geom_line() + geom_point(size = 2.4) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(limits = c(0, 1)) +
  labs(title = "B. Błąd standardowy oszacowania", x = "Liczba podanych pozycji", y = "SE(θ)") + motyw

p1 <- pa / pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("komputerowe-testowanie-adaptacyjne-jedna-osoba.svg", p1, width = 8, height = 9)
Wynik w R
    n theta    se     b
27.00  2.17  0.30  1.14
    n theta    se     b
20.00  1.62  0.48  0.14
  sr_b_CAT sr_b_staly
       1.4        0.0
theta    se
 2.20  0.33
[1] 7
Jak opisać w pracy
Na co uważać
- Bank decyduje o jakości. CAT nie poprawi słabych pozycji; wymaga dużej próby kalibracyjnej, dobrej analizy pozycji (zob. IRT w R z pakietem mirt) i sprawdzenia DIF.
- Jednowymiarowość. Standardowy CAT zakłada jedną cechę; przy wielu wymiarach potrzebny jest model wielowymiarowy.
- Nadużywane pozycje. Bez kontroli ekspozycji te same najlepsze pozycje trafiają do większości osób i szybko się „opatrzą”.
- Rzetelność. Zamiast jednego współczynnika rzetelności podaj błąd pomiaru dla poszczególnych osób lub na różnych poziomach cechy.
Symulacja CAT w R
Kod tworzy bank 200 pozycji w modelu dwuparametrycznym, przeprowadza test adaptacyjny (wybór według maksymalnej informacji, oszacowanie EAP, zakończenie przy błędzie 0.30) i porównuje go ze stałym testem 20 pozycji.
CAT a test stały: długość testu i błąd oszacowania
R
set.seed(4681)
K <- 200                                         # bank 200 pozycji (model 2PL)
a <- runif(K, 0.8, 2.0); b <- rnorm(K)
siatka <- seq(-4, 4, by = 0.05); prior <- dnorm(siatka)
P <- function(th, j) plogis(a[j] * (th - b[j]))
eap <- function(j, x) {                          # oszacowanie EAP i jego błąd standardowy
  L <- prior
  for (i in seq_along(j)) L <- L * P(siatka, j[i])^x[i] * (1 - P(siatka, j[i]))^(1 - x[i])
  w <- L / sum(L); m <- sum(w * siatka)
  c(theta = m, se = sqrt(sum(w * (siatka - m)^2)))
}
cat_test <- function(th, se_stop = 0.30, max_poz = 40) {
  j <- integer(0); x <- integer(0); est <- c(theta = 0, se = 1)
  while (est["se"] > se_stop && length(j) < max_poz) {
    p <- P(est["theta"], seq_len(K)); info <- a^2 * p * (1 - p)
    info[j] <- -Inf                               # bez powtarzania pozycji
    nowa <- which.max(info)                       # pozycja o maksymalnej informacji
    j <- c(j, nowa); x <- c(x, rbinom(1, 1, P(th, nowa)))
    est <- eap(j, x)
  }
  c(est, n_poz = length(j))
}
staly <- order(abs(b))[1:20]                     # test stały: 20 pozycji o średniej trudności
theta <- rnorm(300)
wyn <- t(sapply(theta, function(th) {
  cat_w <- cat_test(th)
  st <- eap(staly, rbinom(20, 1, P(th, staly)))
  c(cat_n = cat_w[["n_poz"]], cat_se = cat_w[["se"]], cat_blad = cat_w[["theta"]] - th,
    stały_se = st[["se"]], stały_blad = st[["theta"]] - th)
}))
round(c(średnio_pozycji_CAT = mean(wyn[, "cat_n"]),
        SE_CAT = mean(wyn[, "cat_se"]), RMSE_CAT = sqrt(mean(wyn[, "cat_blad"]^2)),
        SE_stały_20 = mean(wyn[, "stały_se"]), RMSE_stały_20 = sqrt(mean(wyn[, "stały_blad"]^2))), 3)
skrajni <- abs(theta) > 1.5                       # osoby o skrajnym poziomie cechy
round(c(n_skrajnych = sum(skrajni), SE_CAT = mean(wyn[skrajni, "cat_se"]),
        SE_stały_20 = mean(wyn[skrajni, "stały_se"])), 3)
Wynik w R
średnio_pozycji_CAT              SE_CAT            RMSE_CAT         SE_stały_20
             14.710               0.295               0.289               0.342
      RMSE_stały_20
              0.350
n_skrajnych      SE_CAT SE_stały_20
     40.000       0.295       0.480
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Symulacja nie wymaga dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy wyniki osób, które rozwiązały różne pozycje w CAT, są porównywalne?
Tak, jeśli wszystkie pozycje skalibrowano na wspólnej skali IRT. Wynik to oszacowanie cechy (θ), a nie liczba poprawnych odpowiedzi, więc różne zestawy pytań dają wyniki na tej samej skali, każdy z własnym błędem pomiaru.
Ile pozycji musi mieć bank do testu adaptacyjnego?
Nie ma jednej liczby. Bank powinien być kilkakrotnie większy od typowej długości testu i pokrywać cały zakres cechy, także poziomy skrajne. Zbyt mały bank powoduje nadmierną ekspozycję tych samych pozycji.
Kiedy test adaptacyjny nie ma sensu w pracy dyplomowej?
Gdy nie masz skalibrowanego banku pozycji. Kalibracja wymaga dużej próby i analizy IRT, więc przy jednym badaniu z krótkim kwestionariuszem lepiej użyć stałej, zwalidowanej skali.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Teoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikIRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Weiss, D. J. (1982). Improving measurement quality and efficiency with adaptive testing. Applied Psychological Measurement, 6(4), 473–492. https://doi.org/10.1177/014662168200600408 ● Otwarty dostęp: pełny tekst
- Weiss, D. J., & Kingsbury, G. G. (1984). Application of computerized adaptive testing to educational problems. Journal of Educational Measurement, 21(4), 361–375. https://doi.org/10.1111/j.1745-3984.1984.tb01040.x
Cytowania BibTeX
@article{weiss1982improving, author={Weiss, David J.}, title={{Improving measurement quality and efficiency with adaptive testing}}, journal={Applied Psychological Measurement}, year={1982}, volume={6}, number={4}, pages={473--492}, doi={10.1177/014662168200600408}}@article{weiss1984application, author={Weiss, David J. and Kingsbury, G. Gage}, title={{Application of computerized adaptive testing to educational problems}}, journal={Journal of Educational Measurement}, year={1984}, volume={21}, number={4}, pages={361--375}, doi={10.1111/j.1745-3984.1984.tb01040.x}}