Co to jest model częściowego kredytu?
Model częściowego kredytu (ang. partial credit model, PCM; nazywany też modelem częściowego zaliczenia) to model z rodziny modelu Rascha dla pozycji ocenianych w dwóch lub więcej uporządkowanych kategoriach, np. zadań punktowanych 0–1–2–3. Masters (1982) przedstawił go jako rozszerzenie modelu skali ocen Andricha na pozycje, które mogą mieć różną liczbę i strukturę kategorii. Jak inne modele Rascha, PCM ma separowalne parametry osób i pozycji.
Jak działa PCM
Przejście z kategorii j − 1 do j to osobny „krok” o trudności δj. Szansa wykonania kroku zależy od różnicy θ − δj, tak jak w dychotomicznym modelu Rascha, a wszystkie pozycje mają tę samą dyskryminację. Próg δj to punkt, w którym krzywe dwóch sąsiednich kategorii się przecinają. W modelu odpowiedzi stopniowanej (GRM) progi są granicami kategorii kumulatywnych, a Masters (1982) pokazał, że to inne parametry. Dlatego progi PCM mogą wyjść nieuporządkowane, a progi GRM – nie. Uogólniony model częściowego kredytu (GPCM) dodaje różne nachylenia pozycji; w danych NAEP z matematyki pasował lepiej niż PCM (Muraki, 1992).
Przykład
W symulowanych danych 500 osób odpowiadało na 4 pozycje oceniane od 0 do 3. Pozycja 3 ma uporządkowane progi −1.97, −0.51 i 0.92. Pozycja 4 ma progi 0.58, −0.55 i 1.17: pierwszy krok jest trudniejszy od drugiego, a kategorię 1 wybrało tylko 71 osób. PCM jest zagnieżdżony w GPCM, więc można je porównać testem ilorazu wiarygodności: χ²(3) = 0.57, p = .902, a AIC jest niższe dla PCM (4950.4 wobec 4955.8).
Na rysunku
Rysunek zestawia dwie pozycje z przykładu: pozycję 3 z progami uporządkowanymi (−1.97, −0.51, 0.92) i pozycję 4, w której pierwszy krok jest trudniejszy od drugiego (0.58 i −0.55).
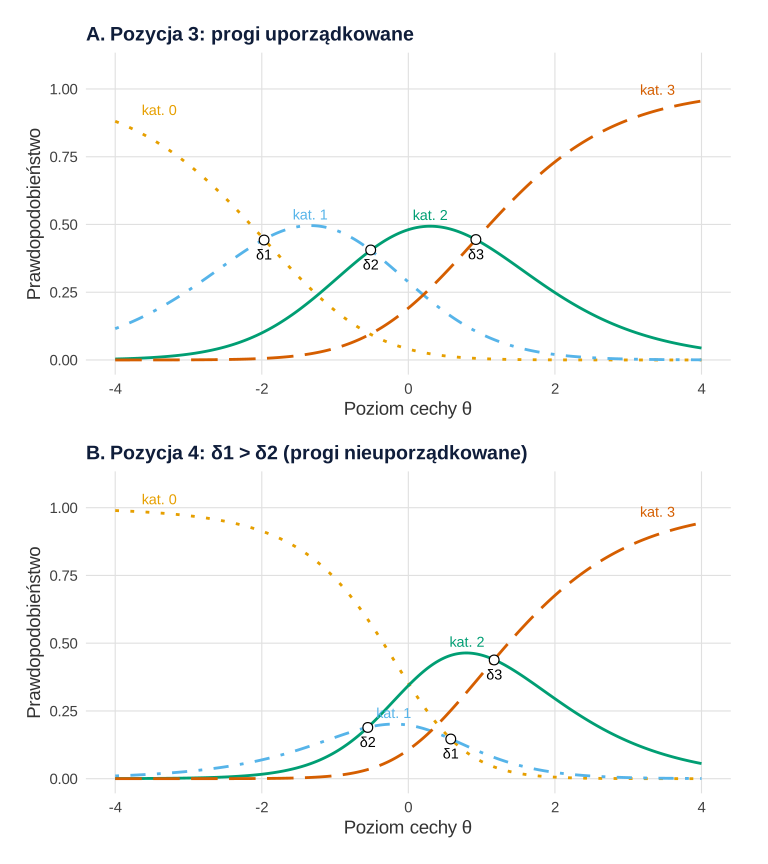
Co widać. Każdy próg δ leży dokładnie tam, gdzie przecinają się krzywe dwóch sąsiednich kategorii – kod sprawdza, że różnica ich wysokości w tym punkcie wynosi 0. W pozycji 3 progi idą od lewej do prawej, więc każda kategoria ma swój odcinek skali θ, na którym jest najczęstszą odpowiedzią. W pozycji 4 kolejność jest odwrócona. Krzywa kategorii 1 sięga najwyżej .20 (przy θ = −0.20) i dla żadnego poziomu cechy nie jest najwyższa. Osoba o rosnącym θ przechodzi z kategorii 0 od razu do 2; ich krzywe przecinają się przy θ ≈ 0.01, w połowie między δ1 i δ2.
Na co uważać. Nieuporządkowane progi nie oznaczają, że osoby wybierają kategorie „w złej kolejności”, ani że model jest źle dopasowany. Tu dane wygenerowano dokładnie z PCM, a kategorię 1 i tak wybrało 71 osób. Taki obraz mówi tyle, że kategoria 1 nigdy nie jest odpowiedzią najbardziej prawdopodobną – warto sprawdzić jej opis i liczebność. Rysunek pokazuje krzywe modelu, nie odsetki w danych. Progi PCM to inne parametry niż progi GRM, gdzie nieuporządkowanie jest niemożliwe z konstrukcji. Gotowe wykresy w R daje też funkcja plot(pcm, type = "trace") z pakietu mirt.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Dane są te same co w przykładzie (set.seed(654)); odwrócone kroki pozycji 4 ustawiono w symulacji ręcznie, żeby pokazać nieuporządkowane progi, a ziarna nie zmieniano.
Kod R rysunku 1
# Rysunek 1. Krzywe kategorii w modelu częściowego kredytu: progi uporządkowane (A) i nieuporządkowane (B)
suppressPackageStartupMessages({ library(mirt); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw; kategorie różnią się też rodzajem linii i etykietą przy krzywej
kol <- c("#E69F00", "#56B4E9", "#009E73", "#D55E00")
lin <- c("dotted", "dotdash", "solid", "longdash")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "none",
        plot.title = element_text(face = "bold"))

# Te same dane i model co w przykładzie: 500 osób, 4 pozycje w skali 0–3
set.seed(654)
kroki <- rbind(c(-1.5, 0.0, 1.5), c(-1.0, 0.2, 1.0),
               c(-2.0, -0.5, 0.8), c(0.5, -0.5, 1.2))   # pozycja 4: progi nieuporządkowane
d <- t(apply(kroki, 1, function(s) c(0, -cumsum(s))))
dane <- simdata(a = matrix(1, 4), d = d, N = 500, itemtype = "gpcm")
pcm <- mirt(dane, 1, itemtype = "Rasch", verbose = FALSE)
delta <- coef(pcm, IRTpars = TRUE, simplify = TRUE)$items[, c("b1", "b2", "b3")]

th <- seq(-4, 4, by = 0.02)
krzywe <- function(j) {
  P <- probtrace(extract.item(pcm, j), Theta = matrix(th))
  data.frame(theta = rep(th, 4), P = c(P), kat = factor(rep(0:3, each = length(th))))
}
k3 <- krzywe(3); k4 <- krzywe(4)

# Liczby do opisu: w progu δ_j krzywe kategorii j−1 i j mają tę samą wysokość
pr <- function(j, t) probtrace(extract.item(pcm, j), Theta = matrix(t))
round(sapply(1:3, function(s) diff(pr(4, delta[4, s])[1, s:(s + 1)])), 6)   # różnice = 0
# Kategoria 1 pozycji 4: najwyższe prawdopodobieństwo i czy jest kiedykolwiek najczęstsza
P4 <- matrix(k4$P, ncol = 4)
round(c(max_P_kat1 = max(P4[, 2]), theta_szczytu = th[which.max(P4[, 2])]), 3)
any(apply(P4, 1, which.max) == 2)                  # czy kategoria 1 jest dla kogoś najczęstsza
round(mean(delta[4, 1:2]), 2)                      # tu przecinają się krzywe kategorii 0 i 2
P3 <- matrix(k3$P, ncol = 4)
round(c(max_P_kat1_poz3 = max(P3[, 2]), max_P_kat2_poz3 = max(P3[, 3])), 3)

rysuj <- function(dk, dl, tytul) {
  sz <- aggregate(P ~ kat, dk, max)
  sz$theta <- sapply(levels(dk$kat), function(k) dk$theta[dk$kat == k][which.max(dk$P[dk$kat == k])])
  sz$theta[1] <- -3.4; sz$theta[4] <- 3.4                         # etykiety skrajnych kategorii przy brzegach
  pp <- data.frame(theta = dl, P = sapply(seq_along(dl), function(s)
    dk$P[dk$kat == s - 1][which.min(abs(th - dl[s]))]), et = paste0("δ", 1:3))
  ggplot(dk, aes(theta, P, colour = kat, linetype = kat)) +
    geom_line(linewidth = 1) +
    geom_point(data = pp, aes(theta, P), inherit.aes = FALSE, shape = 21, size = 3, fill = "white") +
    geom_text(data = pp, aes(theta, P, label = et), inherit.aes = FALSE, vjust = 1.9, size = 3.8) +
    geom_text(data = sz, aes(label = paste("kat.", kat)), vjust = -0.6, size = 3.8) +
    scale_colour_manual(values = kol) + scale_linetype_manual(values = lin) +
    scale_y_continuous(limits = c(0, 1.08), breaks = seq(0, 1, 0.25)) +
    labs(title = tytul, x = "Poziom cechy θ", y = "Prawdopodobieństwo") + motyw
}
pa <- rysuj(k3, delta[3, ], "A. Pozycja 3: progi uporządkowane")
pb <- rysuj(k4, delta[4, ], "B. Pozycja 4: δ1 > δ2 (progi nieuporządkowane)")

p1 <- pa / pb
p1   # zapis: ggsave("model-czesciowego-kredytu-krzywe.svg", p1, width = 8, height = 9)
Wynik w R
P.2 P.3 P.4
  0   0   0
   max_P_kat1 theta_szczytu
        0.201        -0.200
[1] FALSE
[1] 0.01
max_P_kat1_poz3 max_P_kat2_poz3
          0.496           0.494
Jak opisać w pracy
Na co uważać
- Progi nieuporządkowane. Gdy δ1 > δ2, kategoria 1 nie jest najbardziej prawdopodobna dla żadnego θ. Sprawdź jej opis i liczebność; czasem łączy się ją z sąsiednią.
- PCM to nie model skali ocen. Model skali ocen zakłada tę samą strukturę progów we wszystkich pozycjach, PCM szacuje ją osobno dla każdej.
- Wspólna dyskryminacja to założenie. Porównaj PCM z GPCM i sprawdź dopasowanie pozycji, np. w analizie pozycji testu.
Miejsce PCM wśród innych modeli opisuje wpis teoria reagowania na pozycje testowe (IRT), a wariant z oceniającymi – wieloaspektowy model Rascha.
Model PCM w R
Kod symuluje odpowiedzi na cztery pozycje czterokategorialne (w jednej progi są nieuporządkowane), dopasowuje PCM (itemtype = "Rasch") i GPCM, a następnie je porównuje. Liczby w tekście pochodzą z tego kodu.
Progi kroków i porównanie PCM z GPCM
R
library(mirt)
set.seed(654)
n <- 500
kroki <- rbind(c(-1.5, 0.0, 1.5), c(-1.0, 0.2, 1.0),
               c(-2.0, -0.5, 0.8), c(0.5, -0.5, 1.2))   # pozycja 4: progi nieuporzadkowane
d <- t(apply(kroki, 1, function(s) c(0, -cumsum(s))))   # parametryzacja gpcm w mirt
dane <- simdata(a = matrix(1, 4), d = d, N = n, itemtype = "gpcm")
pcm  <- mirt(dane, 1, itemtype = "Rasch", verbose = FALSE)    # PCM: wspolne a = 1
gpcm <- mirt(dane, 1, itemtype = "gpcm",  verbose = FALSE)    # GPCM: rozne a
round(coef(pcm, IRTpars = TRUE, simplify = TRUE)$items, 2)
round(coef(pcm, simplify = TRUE)$cov, 2)                       # wariancja theta
apply(dane, 2, table)                                          # liczebnosci kategorii 0-3
anova(pcm, gpcm)
Wynik w R
       a    b1    b2   b3
Item_1 1 -1.13  0.07 1.71
Item_2 1 -0.91  0.26 0.83
Item_3 1 -1.97 -0.51 0.92
Item_4 1  0.58 -0.55 1.17
     F1
F1 1.08
  Item_1 Item_2 Item_3 Item_4
0     99    113     46    196
1    169    157    140     71
2    168    125    191    142
3     64    105    123     91
          AIC    SABIC       HQ      BIC    logLik    X2 df     p
pcm  4950.396 4963.923 4971.895 5005.185 -2462.198
gpcm 4955.822 4972.470 4982.283 5023.255 -2461.911 0.574  3 0.902
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mirt). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznaczają nieuporządkowane progi w modelu częściowego kredytu?
Że któryś krok jest trudniejszy od następnego, więc pośrednia kategoria nie jest najbardziej prawdopodobna dla żadnego poziomu cechy. Zwykle chodzi o kategorię rzadko wybieraną albo niejasno opisaną.
Czym PCM różni się od uogólnionego modelu częściowego kredytu (GPCM)?
PCM zakłada tę samą dyskryminację wszystkich pozycji, GPCM szacuje ją osobno dla każdej. Modele są zagnieżdżone, więc porównuje się je testem ilorazu wiarygodności i kryteriami AIC lub BIC.
Jak dopasować model częściowego kredytu w R?
W pakiecie mirt dla pozycji politomicznych: mirt(dane, 1, itemtype = "Rasch"). Trudności kroków zwraca coef(model, IRTpars = TRUE, simplify = TRUE), a GPCM daje itemtype = "gpcm".
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Teoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikIRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Masters, G. N. (1982). A Rasch model for partial credit scoring. Psychometrika, 47(2), 149–174. https://doi.org/10.1007/bf02296272
- Muraki, E. (1992). A generalized partial credit model: Application of an EM algorithm. Applied Psychological Measurement, 16(2), 159–176. https://doi.org/10.1177/014662169201600206 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{masters1982rasch, author={Masters, Geoff N.}, title={{A Rasch model for partial credit scoring}}, journal={Psychometrika}, year={1982}, volume={47}, number={2}, pages={149--174}, doi={10.1007/bf02296272}}@article{muraki1992generalized, author={Muraki, Eiji}, title={{A generalized partial credit model: Application of an EM algorithm}}, journal={Applied Psychological Measurement}, year={1992}, volume={16}, number={2}, pages={159--176}, doi={10.1177/014662169201600206}}