Pięć typowych projektów w pracy z pracy socjalnej
Prace dyplomowe z pracy socjalnej mają kilka cech, które odróżniają je od prac z psychologii czy socjologii. Badasz zwykle ludzi związanych z jedną instytucją: pracowników kilku ośrodków pomocy społecznej, klientów jednej placówki albo rodziny objęte konkretnym programem. Próby są małe, osoby są pogrupowane w zespołach, a część danych pochodzi nie z ankiety, lecz z dokumentacji prowadzonej przez instytucję. Do tego pytasz o sprawy drażliwe: ubóstwo, przemoc, uzależnienia, konflikty z przełożonym. Każda z tych cech zmienia wybór analizy. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Wypalenie pracowników | Czy liczba prowadzonych rodzin i superwizja wiążą się z wypaleniem? | wynik skali 0–100, pracownicy z 12 ośrodków | regresja z błędami odpornymi na klastrowanie albo model wielopoziomowy | b z 95% CI, ICC |
| 2. Ankieta klientów | Czy osoby mieszkające samotnie mają mniejsze wsparcie? Czy sposób zwrotu ankiety zmienia ocenę pomocy? | MSPSS (1–7), satysfakcja 1–5 | test Welcha, test Manna–Whitneya, odsetki z CI | g Hedgesa, korelacja rangowo-biseryjna |
| 3. Ewaluacja programu | Czy program wsparcia rodzin obniżył stres rodzicielski? | pomiar przed i po, grupa programu i grupa porównawcza | ANCOVA z pomiarem przed jako kowariantem | różnica skorygowana z 95% CI, d |
| 4. Dane z dokumentacji | Czy w rodzinach z asystentem rzadziej dochodzi do sytuacji kryzysowych? | zliczenia zdarzeń, różny czas objęcia wsparciem | regresja ujemna dwumianowa z offsetem | iloraz częstości (IRR) z 95% CI |
| 5. Mała grupa wsparcia | Czy po udziale w grupie więcej osób szuka pracy? | 14 osób przed i po, wynik tak/nie i wynik skali | dokładny test McNemara (mid-p), test Wilcoxona, test permutacyjny, test Fishera | korelacja rangowo-biseryjna, OR z CI |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnej rzeczywistej instytucji ani populacji. Pełny kod znajdziesz w sekcji Przykład w R. Dane z projektu 3 możesz pobrać jako plik CSV i powtórzyć analizę w dowolnym programie. Jeśli nie wiesz, który test pasuje do Twojej hipotezy, zacznij od kreatora doboru testu, a cały proces od pytania badawczego do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: dostęp do danych, zgody i drażliwe pytania
Dostęp do instytucji to część planu badania. Ankieta wśród pracowników ośrodka albo analiza dokumentacji wymaga zgody kierownika instytucji, a badanie klientów – także świadomej zgody każdej osoby. Zanim zaprojektujesz analizy, ustal z promotorem, czy badanie wymaga opinii komisji etycznej, i przygotuj informację dla uczestników zgodną z zasadami opisanymi w haśle świadoma zgoda i RODO w badaniach. Klient pomocy społecznej jest w relacji zależności od instytucji, więc musi wiedzieć, że odmowa udziału nie wpłynie na przyznaną pomoc. To nie jest formalność: od tego zależy, czy odpowiedzi będą szczere.
Kto podaje ankietę, ten wpływa na odpowiedzi. Jeśli kwestionariusz o satysfakcji z pomocy wręcza klientowi pracownik, który prowadzi jego sprawę, część osób odpowie tak, by nie zaszkodzić relacji. To przykład aprobaty społecznej i efektu ankietera. Projekt 2 pokazuje, jak duża może być ta różnica. Pytania o przemoc, uzależnienia czy zadłużenie zadawaj w ankiecie bez udziału pracownika i tylko wtedy, gdy są potrzebne do hipotez.
Dane z dokumentacji to dane zastane. Liczba interwencji, czas objęcia wsparciem czy powód zakończenia sprawy zostały zapisane w celach administracyjnych, a nie badawczych. Ich jakość zależy od tego, jak różni pracownicy prowadzą dokumentację. Pobieraj tylko zmienne potrzebne do analizy, bez danych osobowych, najlepiej w postaci przygotowanej przez instytucję. Liczb o skali problemów społecznych we wstępie pracy nie podawaj bez źródła: cytuj publikację albo oficjalną statystykę z datą odczytu.
Projekt 1. Wypalenie pracowników socjalnych z kilku ośrodków
Wypalenie zawodowe to jeden z najczęstszych tematów prac z pracy socjalnej. Lloyd, King i Chenoweth (2002) w przeglądzie literatury zauważyli, że wiele wcześniejszych prac porównywało pracowników socjalnych z normami dla populacji ogólnej, a nie z podobnymi zawodami. Wśród czynników ryzyka wskazali charakter pracy, w tym napięcie między wartościami zawodu a wymaganiami instytucji, oraz organizację środowiska pracy. Superwizja i wsparcie zespołu miały w ich przeglądzie pewne oparcie w danych jako czynniki ochronne. Kim i Stoner (2008) w badaniu 346 pracowników socjalnych pokazali, że stres roli wiązał się bezpośrednio z wypaleniem, a wsparcie społeczne i autonomia – z mniejszym zamiarem odejścia z pracy, ale nie bezpośrednio z wypaleniem. To dobre źródła do uzasadnienia hipotez.
Narzędzie: wypalenie związane z pracą z klientem
Do pracy socjalnej szczególnie pasuje Kopenhaski Kwestionariusz Wypalenia (CBI). Kristensen i in. (2005) zbudowali go z trzech skal: wypalenia osobistego, zawodowego i związanego z klientem, i sprawdzili go na pracownikach usług społecznych. W badaniu PUMA, opisanym przez Borritz i in. (2006), wypalenie zawodowe korelowało m.in. z satysfakcją z pracy, wymaganiami ilościowymi i konfliktem ról. Alternatywą jest OLBI z podskalami wyczerpania i dystansowania się od pracy. Obie skale analizuj jako wyniki ciągłe, bo nie mają oficjalnych progów wypalenia.
Pracownicy nie są niezależni: ICC i efekt schematu
Przykład: 180 pracowników z 12 ośrodków (po 15 osób) wypełniło skalę wypalenia związanego z klientem (0–100). Średni wynik wynosił 29.46 (SD = 15.59). Predyktory to liczba prowadzonych środowisk (rodzin), staż pracy i to, czy ośrodek zapewnia regularną superwizję (6 z 12 ośrodków). Pracownicy jednego ośrodka mają wspólnego kierownika, rejon i obciążenie, więc ich wyniki są do siebie podobne. Mierzy to korelacja wewnątrzklasowa (ICC): tu ICC = .18, czyli 18.2% zmienności wypalenia przypadało na różnice między ośrodkami. Przy 15 osobach w ośrodku efekt schematu wynosił 1 + (15 − 1) × 0.182 = 3.55. Przy szacowaniu średniej 180 ankiet daje więc precyzję podobną jak ok. 51 niezależnych osób.
Regresja: trzy sposoby liczenia niepewności
Model regresji z trzema predyktorami wyjaśniał 13.0% wariancji wypalenia (R² = .130). Oszacowania współczynników są w każdym podejściu podobne. Różni się to, jak szeroki jest przedział ufności, a rysunek 1 pokazuje, dlaczego to ważne.
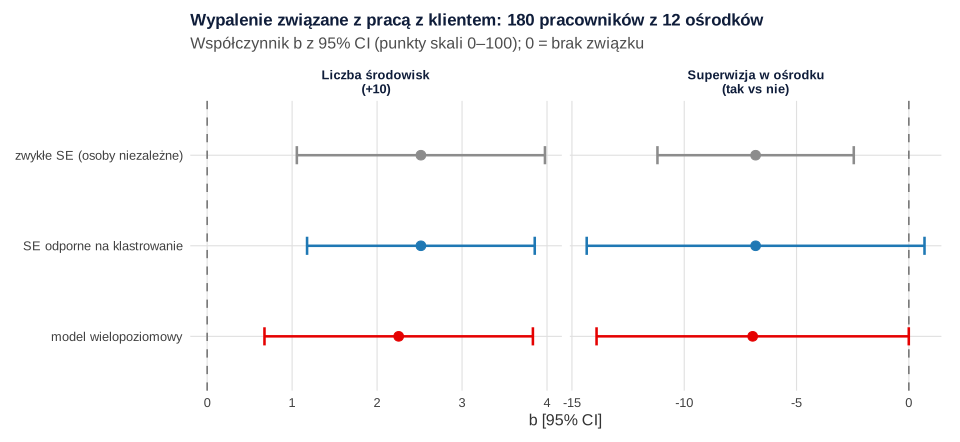
Przy zwykłych błędach standardowych, które zakładają niezależność 180 osób, superwizja wiązała się z wynikiem niższym o 6.82 punktu, 95% CI [−11.19, −2.45], p = .002. Superwizja jest jednak cechą ośrodka, a ośrodków jest tylko 12. Błędy standardowe odporne na klastrowanie uwzględniają to i dają przedział [−14.34, 0.70], p = .071. Model wielopoziomowy z losowym wyrazem wolnym ośrodka dał podobny wynik: b = −6.95, 95% CI [−13.90, 0.00]. Cameron i Miller (2015) opisują, że domyślne błędy standardowe przy danych pogrupowanych mogą znacznie zawyżać precyzję. Zwracają też uwagę na trudności przy małej liczbie klastrów. W przykładzie, przy 12 ośrodkach, wartości p i przedziały dla błędów odpornych liczono z rozkładu t z 11 stopniami swobody.
Inaczej wygląda predyktor mierzony u każdej osoby. Każde 10 dodatkowych środowisk wiązało się z wypaleniem wyższym o 2.52 punktu, a przedział ufności był podobny we wszystkich podejściach (przy błędach odpornych [1.18, 3.86], p = .002). Staż nie miał istotnego związku z wypaleniem, b = 0.19, p = .401. Wniosek praktyczny: jeśli hipoteza dotyczy cechy ośrodka (superwizja, wielkość zespołu, typ gminy), potrzebujesz wielu ośrodków, a nie wielu pracowników w kilku ośrodkach. Model wielopoziomowy krok po kroku opisujemy w poradniku model wielopoziomowy w R.
Projekt 2. Ankieta klientów: wsparcie społeczne i satysfakcja z pomocy
Drugi częsty typ pracy to ankieta wśród klientów: seniorów korzystających z usług opiekuńczych, rodzin, osób w kryzysie bezdomności. Często mierzy się w niej wsparcie społeczne. Wielowymiarowa Skala Spostrzeganego Wsparcia Społecznego (MSPSS) ma 12 pozycji ocenianych od 1 do 7. Zimet i in. (1988) wyodrębnili w niej trzy podskale według źródła wsparcia: rodzinę, przyjaciół i osobę znaczącą.
Porównanie dwóch grup klientów
Przykład: 160 dorosłych klientów ośrodka wypełniło MSPSS. Spójność skali była wysoka (α = .94), średni wynik ogólny wynosił 4.60 (SD = 1.06). Osoby mieszkające samotnie (n = 69) miały niższe wsparcie (M = 4.32, SD = 1.11) niż osoby mieszkające z innymi (n = 91, M = 4.82, SD = 0.98). Grupy różnią się liczebnością i wariancją, więc zamiast klasycznego testu t użyj testu Welcha: t(135.67) = 2.92, p = .004, różnica 95% CI [0.16, 0.83], g Hedgesa = 0.47, 95% CI [0.15, 0.79]. To badanie przekrojowe: nie wiesz, czy samotne mieszkanie obniża wsparcie, czy osoby z mniejszym wsparciem częściej mieszkają same.
Satysfakcja z pomocy: kto zbiera ankiety?
Pytania o satysfakcję z pomocy prawie zawsze dają rozkład przesunięty w stronę najwyższych ocen, czyli efekt sufitu. W przykładzie połowie klientów losowo przydzielono zwrot ankiety do rąk pracownika prowadzącego sprawę, a połowie – do zamkniętej urny. Przy urnie zadowolonych (ocena 4 lub 5) było 75.0% osób, 95% CI [64.5, 83.2], a przy zwrocie do pracownika 90.0%, 95% CI [81.5, 94.8] (przedziały Wilsona). Rozkłady ocen różniły się w teście Manna–Whitneya, W = 2314.5, p = .001, a korelacja rangowo-biseryjna wyniosła .28 na korzyść zwrotu do pracownika, 95% CI [.10, .43]. W tej symulacji zadowolenie było takie samo, a różnicę wywołał wyłącznie sposób zbierania odpowiedzi. Jeśli satysfakcja jest ważnym wynikiem, zbieraj ankiety anonimowo i opisz ten sposób w rozdziale metodologicznym.
Projekt 3. Ewaluacja programu wsparcia rodzin przed i po
Ewaluacja programu to temat bardzo bliski praktyce: warsztaty umiejętności wychowawczych, program aktywizacji, grupa dla osób opuszczających placówkę. Ogólne zasady (model logiczny, kryteria, wskaźniki) opisuje poradnik badanie ewaluacyjne w pracy dyplomowej. Tutaj skupiamy się na jednym problemie, typowym dla pomocy społecznej. Do programu nie trafiają losowe rodziny, tylko te, którym jest najtrudniej.
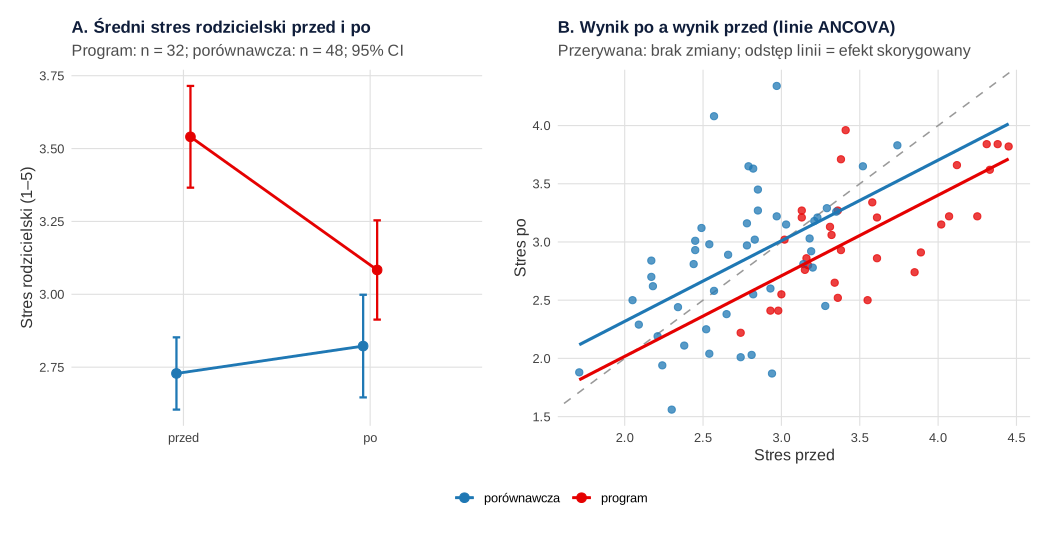
Przykład: 80 rodzin objętych pracą socjalną wypełniło skalę stresu rodzicielskiego (średnia 10 pozycji, 1–5; więcej = większy stres) przed programem i po nim. Do programu częściej kierowano rodziny z wyższym wynikiem w pomiarze przed. Program objął 32 rodziny, które na starcie miały M = 3.54 (SD = 0.48). Grupę porównawczą stanowiło 48 rodzin objętych zwykłą pracą socjalną, które miały na starcie M = 2.73 (SD = 0.43). W symulacji wiemy, że program naprawdę obniżał stres o 0.30 punktu.
Trzy analizy, trzy odpowiedzi
Tylko grupa programu, test t dla prób zależnych. Stres spadł o 0.46 punktu, 95% CI [−0.60, −0.31], t(31) = −6.48, p < .001, dz = −1.14. Wygląda to na bardzo duży efekt. Ten wynik łączy jednak trzy rzeczy: działanie programu, zmianę w czasie i regresję do średniej. Rodziny trafiły do programu w chwili wysokiego wyniku, a część tej „wysokości” była chwilowym wahaniem i błędem pomiaru. W następnym pomiarze wynik spadłby więc nawet bez programu.
Różnica w różnicach (DiD). W grupie porównawczej stres wzrósł o 0.09 punktu (p = .225), bo do niej trafiły rodziny z niskim wynikiem na starcie. Różnica zmian wynosiła −0.55, 95% CI [−0.76, −0.34], t(76.73) = −5.30, p < .001. To jeszcze więcej niż w samej grupie programu, bo regresja do średniej działa tu w obie strony. Metoda różnicy w różnicach zakłada, że bez programu obie grupy zmieniałyby się tak samo. Przy przydziale według wyniku przed to założenie nie jest spełnione.
ANCOVA z pomiarem przed jako kowariantem. Porównuje rodziny o tym samym wyniku wyjściowym. Interakcja pomiar przed × grupa była nieistotna (b = −0.10, p = .664), więc założenie równoległych nachyleń można przyjąć. Po uwzględnieniu wyniku przed rodziny z programu miały stres niższy o 0.30 punktu, 95% CI [−0.58, −0.02], t(77) = −2.12, p = .037. Średnie skorygowane wynosiły 2.75, 95% CI [2.55, 2.94] w grupie programu i 3.05, 95% CI [2.89, 3.20] w grupie porównawczej, a d liczone ze skorygowanej różnicy wyniosło −0.54. Wright (2006) pokazał, że gdy przydział do grup zależy od wyniku wyjściowego, właściwa jest ANCOVA, a test na wynikach zmiany może prowadzić do innego wniosku. To jedna z odsłon paradoksu Lorda.
Ziarno losowania wybrano tak, aby oszacowanie ANCOVA było bliskie prawdziwemu efektowi. Dlatego kod zawiera też 500 powtórzeń tego samego schematu. Średnio sama grupa programu dawała −0.49 (SD = 0.085), DiD −0.55 (SD = 0.112), a ANCOVA −0.29 (SD = 0.140), czyli prawie dokładnie prawdziwe −0.30. Duże SD ANCOVA przypomina, że przy 80 rodzinach pojedyncze badanie może trafić daleko od prawdy w obie strony. Szczegóły ANCOVA, z założeniami i wersją w SPSS, opisuje poradnik ANCOVA w badaniu przed i po. Jeśli liczysz w jamovi, model z kowariantem znajdziesz we wpisie ANOVA w jamovi.
Uwaga: ANCOVA usuwa obciążenie tylko wtedy, gdy o skierowaniu do programu decydował zmierzony wynik przed. Jeśli pracownicy kierowali rodziny także według innych, niezapisanych kryteriów (np. motywacji), żadna z trzech analiz nie da pewnej odpowiedzi. Napisz to wprost w ograniczeniach badania.
Projekt 4. Dane z dokumentacji: zliczenia przy różnym czasie obserwacji
Dokumentacja ośrodka daje zwykle zliczenia: liczbę wizyt, interwencji, odnotowanych sytuacji kryzysowych. Pułapka polega na tym, że rodziny są objęte wsparciem przez różny czas. Rodzina, która jest w dokumentacji 12 miesięcy, ma więcej okazji do zdarzeń niż rodzina obserwowana 3 miesiące. Porównywanie surowych liczb myli więc liczbę zdarzeń z długością obserwacji.
Przykład: 140 rodzin, liczba sytuacji kryzysowych odnotowanych w okresie wsparcia (3–12 miesięcy), asystent rodziny (tak/nie) i liczba dzieci. Średnia liczba zdarzeń wynosiła 1.08, wariancja 1.97, a 44.3% rodzin nie miało żadnego. Rodziny z asystentem były w dokumentacji średnio 8.9 miesiąca, a pozostałe 7.5 miesiąca. W przeliczeniu na 12 miesięcy częstość wynosiła 1.21 zdarzenia w rodzinach z asystentem i 1.94 w pozostałych.
Właściwy model to regresja dla zliczeń z offsetem, czyli logarytmem czasu obserwacji. Współczynnik rozproszenia w modelu Poissona wynosił 1.73, więc wybrano regresję ujemną dwumianową. Po uwzględnieniu czasu obserwacji i liczby dzieci częstość sytuacji kryzysowych w rodzinach z asystentem była niższa, IRR = 0.63, 95% CI [0.41, 0.97], z = −2.11, p = .035. Ten sam model bez offsetu dał IRR = 0.76, p = .210, bo rodziny z asystentem były dłużej obserwowane i „zbierały” więcej zdarzeń. Krok po kroku – z diagnostyką nadmiernego rozproszenia i nadmiaru zer – opisujemy to w poradniku regresja dla zliczeń.
Pamiętaj, że to dane obserwacyjne. Asystenta przydziela się rodzinom według potrzeb, więc różnica może wynikać z cech rodzin, a nie z pracy asystenta. Jeśli dokumentacja zawiera dane o sytuacji rodziny na początku wsparcia, uwzględnij je w modelu. Gdy analizujesz odsetki (np. spraw zakończonych osiągnięciem celu), podawaj je z przedziałem ufności dla proporcji.
Projekt 5. Mała grupa wsparcia: testy dokładne
W pracy socjalnej często badasz całą grupę, która istnieje: 14 uczestników grupy wsparcia, 9 wychowanków placówki, 12 osób w programie aktywizacji. Testy oparte na przybliżeniach dużej próby mogą wtedy dawać zbyt optymistyczne albo zbyt ostrożne wartości p. Agresti (1992) w przeglądzie metod dokładnych dla tabel liczebności pokazał, że rozwój algorytmów i mocy obliczeniowej pozwala liczyć wiele testów dokładnie, bez polegania na przybliżeniach. Co realnie da się wykazać przy kilkunastu osobach, opisujemy w poradniku analiza na małej próbie.
Wynik tak/nie przed i po: dokładny test McNemara i mid-p
Przykład: przed rozpoczęciem grupy 4 z 14 osób aktywnie szukały pracy, a po jej zakończeniu 10 z 14. O wyniku decydują tylko osoby, które zmieniły odpowiedź: 7 zaczęło szukać pracy, a 1 przestało. Dokładny test McNemara (test dwumianowy dla 7 z 8) dał p = .070, wersja mid-p dała p = .039, a test asymptotyczny bez poprawki p = .034. Fagerland, Lydersen i Laake (2013) porównali te warianty w tysiącach scenariuszy. Dokładny test warunkowy nie sprawdził się w żadnym scenariuszu, a test mid-p nie przekraczał nominalnego poziomu istotności i miał moc zbliżoną do testu asymptotycznego. Wersję testu wybierz w planie analizy, a nie po zobaczeniu wyników. Więcej o tym teście piszemy we wpisie test McNemara przed i po.
Wynik skali przed i po: Wilcoxon i test permutacyjny
Poczucie sprawczości (10–40) wzrosło u 12 z 14 osób. Mediana różnic wynosiła 4.5 punktu, estymator Hodgesa–Lehmanna 4.0, 95% CI [2.0, 5.5], test Wilcoxona dla par p = .002. Korelacja rangowo-biseryjna wyniosła .94, 95% CI [.82, .98]. Przy 14 osobach można też policzyć dokładny test permutacyjny: wszystkie 214 = 16 384 możliwe zmiany znaków różnic. Dla średniej różnicy 3.71 punktu dał on p = .0007. Podobne zadania z rozwiązaniami przećwiczysz w zadaniach z testów nieparametrycznych.
Dwie małe grupy: test Fishera
Po zakończeniu programu pracy szukało 10 z 14 uczestników grupy i 4 z 12 osób, które w grupie nie uczestniczyły. Test dokładny Fishera dał p = .113, OR = 4.67, 95% CI [0.74, 36.66]. Przedział ufności jest tak szeroki, że zgadza się zarówno z brakiem efektu, jak i z efektem bardzo dużym. Tak to opisz w pracy: jako wynik niejednoznaczny, a nie jako „dowód, że grupa nie działa”. Kiedy wybrać test Fishera zamiast chi-kwadrat, wyjaśnia wpis chi-kwadrat czy test Fishera. Małą grupę bez grupy porównawczej opisuj ostrożnie: wzrost może wynikać z upływu czasu, sezonu na rynku pracy albo regresji do średniej, tak jak w projekcie 3.
Anonimizacja w małych zespołach
W badaniu pracowników ośrodków anonimowość jest szczególnie krucha. Kierownik zespołu liczącego 15 osób zna płeć, wiek i staż każdego pracownika. Jeśli w tabeli pokażesz wypalenie według ośrodka i stażu, łatwo rozpozna, kto wypełnił ankietę. Sweeney (2002) zaproponowała model k-anonimowości: dane spełniają go, jeśli informacji o żadnej osobie nie da się odróżnić od informacji o co najmniej k − 1 innych osobach. Cechy, które razem mogą zidentyfikować osobę, nazywa się quasi-identyfikatorami.
W symulowanej bazie 180 pracowników 47.2% osób było jedynych w swojej kombinacji czterech cech: ośrodek, płeć, wiek w pięciu przedziałach i staż w czterech przedziałach. Każda osoba należała do kombinacji liczącej mniej niż 5 osób. Po usunięciu ośrodka odsetek osób jedynych spadł do 3.9%, a po zostawieniu tylko płci i stażu w dwóch przedziałach do 0%. Praktyczne zasady: nie zbieraj zmiennych, których nie analizujesz, nie raportuj wyników dla pojedynczych ośrodków, wiek i staż zbieraj w przedziałach. Instytucji przekaż tylko wyniki zbiorcze. Pojęcia porządkuje hasło anonimizacja i pseudonimizacja danych.
Jak opisać analizę statystyczną w pracy z pracy socjalnej
Rozdział o metodach powinien pozwolić innej osobie powtórzyć badanie. W pracy socjalnej opisz dodatkowo, jak uzyskano dostęp do instytucji, kto rozdawał i zbierał ankiety oraz jak pobrano dane z dokumentacji. Od tych decyzji zależy wiarygodność odpowiedzi. Poniżej wzór akapitu dla projektów 1, 3 i 4. Gotowe zdania do pozostałych testów przygotujesz w generatorze opisu wyników APA.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: ewaluacja programu i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą ewaluacji: od statystyk opisowych, przez błędną analizę samej grupy programu i różnicę w różnicach, po ANCOVA ze średnimi skorygowanymi i symulację, która pokazuje, który estymator trafia w prawdziwy efekt. Przepis 2 zawiera pozostałe projekty, a przepis 3 – rysunki. Każdy przepis tworzy własne dane symulowane.
1. Projekt 3: ewaluacja programu – test dla prób zależnych, DiD i ANCOVA
R
# Projekt 3: ewaluacja programu wsparcia rodzin z pomiarem przed i po (dane symulowane).
# 80 rodzin objętych pracą socjalną; do programu (warsztaty umiejętności wychowawczych + konsultacje)
# częściej kierowano rodziny z wyższym wynikiem stresu rodzicielskiego w pomiarze wyjściowym.
# Wynik: średnia 10 pozycji skali stresu rodzicielskiego (1–5, więcej = większy stres).
suppressPackageStartupMessages({ library(emmeans) })
set.seed(41612)
n <- 80
stres_staly <- rnorm(n, 3.1, 0.50)                         # „prawdziwy” poziom stresu rodziny
przed <- round(stres_staly + rnorm(n, 0, 0.35), 2)          # pomiar przed: poziom + błąd pomiaru
p_programu <- plogis(4 * (przed - 3.2))                     # przydział zależy od wyniku przed
grupa <- factor(ifelse(rbinom(n, 1, p_programu) == 1, "program", "porównawcza"), levels = c("porównawcza", "program"))
po <- round(stres_staly - 0.05 - 0.30 * (grupa == "program") + rnorm(n, 0, 0.35), 2)  # prawdziwy efekt: −0.30
ew <- data.frame(id = 1:n, grupa, przed, po, zmiana = round(po - przed, 2))
write.csv(ew, "../statystyka-praca-socjalna-ewaluacja-dane.csv", row.names = FALSE)

# Krok 1. Statystyki opisowe przed i po w grupach
aggregate(cbind(przed, po, zmiana) ~ grupa, ew, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# Krok 2. Częsty błąd: tylko grupa programu, test t dla prób zależnych
tp <- t.test(ew$po[ew$grupa == "program"], ew$przed[ew$grupa == "program"], paired = TRUE)
dz <- mean(ew$zmiana[ew$grupa == "program"]) / sd(ew$zmiana[ew$grupa == "program"])
round(c(roznica = unname(tp$estimate), CI_d = tp$conf.int[1], CI_g = tp$conf.int[2], t = unname(tp$statistic),
        df = unname(tp$parameter), d_z = dz), 2); signif(tp$p.value, 3)
# Ta sama analiza w grupie porównawczej (bez programu)
tk <- t.test(ew$po[ew$grupa == "porównawcza"], ew$przed[ew$grupa == "porównawcza"], paired = TRUE)
round(c(roznica = unname(tk$estimate), CI_d = tk$conf.int[1], CI_g = tk$conf.int[2], t = unname(tk$statistic)), 2); signif(tk$p.value, 3)

# Krok 3. Różnica w różnicach: porównanie zmian między grupami (test Welcha na wynikach zmiany)
dd <- t.test(zmiana ~ grupa, data = ew)
# t.test liczy (porównawcza − program), więc odwracamy znak, żeby DiD = zmiana w programie − zmiana w porównawczej
round(c(DiD = unname(diff(dd$estimate)), CI_d = -dd$conf.int[2], CI_g = -dd$conf.int[1], t = -unname(dd$statistic),
        df = unname(dd$parameter)), 2); signif(dd$p.value, 3)

# Krok 4. ANCOVA: wynik po z pomiarem przed jako kowariantem
m_int <- lm(po ~ przed * grupa, data = ew)                 # jednorodność nachyleń
round(summary(m_int)$coefficients["przed:grupaprogram", ], 3)
m_anc <- lm(po ~ przed + grupa, data = ew)
round(cbind(b = coef(m_anc), confint(m_anc), t = summary(m_anc)$coefficients[, 3]), 3)
signif(summary(m_anc)$coefficients[, 4], 3)
emmeans(m_anc, ~ grupa)                                    # średnie skorygowane o pomiar przed
sd_po <- sqrt(sum(tapply(ew$po, ew$grupa, function(x) (length(x) - 1) * var(x))) / (n - 2))
round(c(d_skorygowane = unname(coef(m_anc)["grupaprogram"]) / sd_po, r_przed_po = cor(ew$przed, ew$po)), 2)

# Krok 5. Prawdziwy efekt w symulacji wynosi −0.30. Który estymator trafia? (500 powtórzeń tego samego schematu)
sym <- t(replicate(500, {
  s <- rnorm(n, 3.1, 0.50); pr <- s + rnorm(n, 0, 0.35)
  g <- rbinom(n, 1, plogis(4 * (pr - 3.2))); p <- s - 0.05 - 0.30 * g + rnorm(n, 0, 0.35)
  c(tylko_program = mean((p - pr)[g == 1]), DiD = mean((p - pr)[g == 1]) - mean((p - pr)[g == 0]),
    ANCOVA = unname(coef(lm(p ~ pr + g))["g"]))
}))
round(rbind(srednia = colMeans(sym), SD = apply(sym, 2, sd)), 3)
Wynik w R
        grupa przed.n przed.M przed.SD  po.n  po.M po.SD zmiana.n zmiana.M zmiana.SD
1 porównawcza   48.00    2.73     0.43 48.00  2.82  0.61    48.00     0.09      0.53
2     program   32.00    3.54     0.48 32.00  3.08  0.47    32.00    -0.46      0.40
roznica    CI_d    CI_g       t      df     d_z
  -0.46   -0.60   -0.31   -6.48   31.00   -1.14
[1] 3.19e-07
roznica    CI_d    CI_g       t
   0.09   -0.06    0.25    1.23
[1] 0.225
  DiD  CI_d  CI_g     t    df
-0.55 -0.76 -0.34 -5.30 76.73
[1] 1.09e-06
  Estimate Std. Error    t value   Pr(>|t|)
    -0.103      0.235     -0.436      0.664
                  b  2.5 % 97.5 %      t
(Intercept)   0.933  0.286  1.581  2.869
przed         0.692  0.460  0.925  5.934
grupaprogram -0.301 -0.584 -0.018 -2.117
 (Intercept)        przed grupaprogram
    5.31e-03     7.98e-08     3.75e-02
 grupa       emmean     SE df lower.CL upper.CL
 porównawcza   3.05 0.0770 77     2.89     3.20
 program       2.75 0.0999 77     2.55     2.94

Confidence level used: 0.95
d_skorygowane    r_przed_po
        -0.54          0.56
        tylko_program    DiD ANCOVA
srednia        -0.490 -0.550 -0.292
SD              0.085  0.112  0.140
2. Projekty 1, 2, 4 i 5 oraz ryzyko identyfikacji
R
# Projekty 1, 2, 4 i 5 oraz kontrola ryzyka identyfikacji (dane symulowane).
suppressPackageStartupMessages({ library(lme4); library(sandwich); library(lmtest); library(psych)
  library(MASS); library(DescTools); library(effectsize) })

## Projekt 1. Wypalenie związane z pracą z klientem: 180 pracowników z 12 ośrodków --------------
# Wynik: skala wypalenia związanego z klientem (0–100, jak w CBI); predyktory: liczba prowadzonych
# środowisk (rodzin), staż pracy, superwizja w ośrodku (cecha ośrodka: 6 z 12 ośrodków ją ma).
set.seed(41614)
k <- 12; m <- 15
osrodek <- factor(rep(sprintf("O%02d", 1:k), each = m))
superwizja <- rep(rep(c("nie", "tak"), each = k / 2)[sample(k)], each = m)
efekt_osr <- rep(rnorm(k, 0, 6), each = m)
srodowiska <- round(pmax(10, rnorm(k * m, 45, 12) + rep(rnorm(k, 0, 8), each = m)))
staz <- round(pmin(35, rgamma(k * m, 2.2, 0.22)))
wypalenie <- 30 + 0.30 * (srodowiska - 45) - 6 * (superwizja == "tak") + 0.15 * staz + efekt_osr + rnorm(k * m, 0, 15)
p1 <- data.frame(osrodek, superwizja = factor(superwizja), srodowiska, staz,
                 wypalenie = round(pmin(100, pmax(0, wypalenie)), 1))
round(c(M = mean(p1$wypalenie), SD = sd(p1$wypalenie)), 2)
# Ile zmienności przypada na ośrodki? ICC z modelu pustego i efekt schematu 1 + (m − 1)·ICC
m0 <- lmer(wypalenie ~ 1 + (1 | osrodek), data = p1)
vc <- as.data.frame(VarCorr(m0))$vcov; icc <- vc[1] / sum(vc)
round(c(ICC = icc, deff = 1 + (m - 1) * icc, n_efektywne = k * m / (1 + (m - 1) * icc)), 3)
# Regresja: zwykłe błędy standardowe, błędy odporne na klastrowanie (ośrodek) i model wielopoziomowy
m1 <- lm(wypalenie ~ I(srodowiska / 10) + superwizja + staz, data = p1)
cf <- function(est, se, df = Inf) { q <- if (is.finite(df)) qt(.975, df) else qnorm(.975)
  round(cbind(b = est, CI_d = est - q * se, CI_g = est + q * se, SE = se), 2) }
zwykle <- coeftest(m1)
odporne <- coeftest(m1, vcov = vcovCL(m1, cluster = ~osrodek), df = k - 1)
cat("Zwykłe SE:\n"); print(cf(zwykle[-1, 1], zwykle[-1, 2], m1$df.residual)); signif(zwykle[-1, 4], 3)
cat("SE odporne na klastrowanie (12 ośrodków, df = 11):\n"); print(cf(odporne[-1, 1], odporne[-1, 2], k - 1)); signif(odporne[-1, 4], 3)
m2 <- lmer(wypalenie ~ I(srodowiska / 10) + superwizja + staz + (1 | osrodek), data = p1)
cat("Model wielopoziomowy (CI Walda):\n"); print(cf(fixef(m2)[-1], sqrt(diag(vcov(m2)))[-1]))
round(summary(m1)$r.squared, 3)

## Projekt 2. Ankieta klientów: wsparcie społeczne (MSPSS) i satysfakcja z pomocy -----------------
# 160 dorosłych klientów ośrodka; MSPSS: 12 pozycji 1–7, wynik = średnia; mieszkanie samotnie (tak/nie);
# satysfakcja z pomocy (1–5); sposób zwrotu ankiety przydzielony losowo: do rąk pracownika socjalnego
# prowadzącego sprawę albo do zamkniętej urny.
set.seed(41602)
n2 <- 160
samotnie <- factor(rbinom(n2, 1, .40), 0:1, c("nie", "tak"))
wsp_lat <- rnorm(n2, 0, 1) - 0.55 * (samotnie == "tak")
poz <- sapply(1:12, function(j) pmin(7, pmax(1, round(4.9 + 1.05 * wsp_lat + rnorm(n2, 0, 0.9)))))
mspss <- rowMeans(poz)
zwrot <- factor(sample(rep(c("pracownik", "urna"), each = n2 / 2)), levels = c("urna", "pracownik"))
sat_lat <- 0.3 * wsp_lat + 0.7 * (zwrot == "pracownik") + rlogis(n2, 0, 0.7)
satysfakcja <- findInterval(sat_lat, c(-2.4, -1.5, -0.6, 0.5)) + 1
round(c(alfa = psych::alpha(poz)$total$raw_alpha, M = mean(mspss), SD = sd(mspss)), 2)
tapply(mspss, samotnie, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
tw <- t.test(mspss ~ samotnie, data = data.frame(mspss, samotnie))
round(c(t = unname(tw$statistic), df = unname(tw$parameter), CI_d = tw$conf.int[1], CI_g = tw$conf.int[2]), 2); signif(tw$p.value, 3)
print(hedges_g(mspss ~ samotnie, data = data.frame(mspss, samotnie), pooled_sd = FALSE), digits = 2)
# Satysfakcja: rozkład, odsetek zadowolonych (4–5) z CI Wilsona w obu sposobach zwrotu
round(100 * prop.table(table(zwrot, satysfakcja), 1), 1)
t(sapply(levels(zwrot), function(g) { x <- sum(satysfakcja[zwrot == g] >= 4); nn <- sum(zwrot == g)
  ci <- 100 * BinomCI(x, nn, method = "wilson")
  round(c(x = x, n = nn, proc = ci[1], CI_d = ci[2], CI_g = ci[3]), 1) }))
mw <- wilcox.test(satysfakcja ~ zwrot, exact = FALSE); mw$statistic; signif(mw$p.value, 3)
print(rank_biserial(satysfakcja ~ zwrot, data = data.frame(satysfakcja, zwrot)), digits = 2)

## Projekt 4. Dane z dokumentacji: sytuacje kryzysowe w rodzinach przy różnym czasie wsparcia ------
# 140 rodzin; liczba odnotowanych sytuacji kryzysowych; czas objęcia wsparciem 3–12 miesięcy (offset);
# asystent rodziny (tak/nie); liczba dzieci.
set.seed(41607)
n4 <- 140
asystent <- factor(rbinom(n4, 1, .45), 0:1, c("nie", "tak"))
miesiace <- ifelse(asystent == "tak", sample(6:12, n4, TRUE), sample(3:12, n4, TRUE))  # rodziny z asystentem dłużej w dokumentacji
dzieci <- 1 + rpois(n4, 1.2)
mu <- miesiace * exp(-2.2 - 0.45 * (asystent == "tak") + 0.18 * dzieci)
kryzysy <- rnbinom(n4, mu = mu, size = 1.6)
p4 <- data.frame(asystent, miesiace, dzieci, kryzysy)
round(c(M = mean(kryzysy), Wariancja = var(kryzysy), Zera_proc = 100 * mean(kryzysy == 0)), 2)
tapply(p4$miesiace, p4$asystent, function(x) round(c(n = length(x), M_miesiecy = mean(x)), 1))
# Surowe częstości na 12 miesięcy w grupach (suma zdarzeń / suma miesięcy × 12)
round(tapply(p4$kryzysy, p4$asystent, sum) / tapply(p4$miesiace, p4$asystent, sum) * 12, 2)
mp <- glm(kryzysy ~ asystent + dzieci + offset(log(miesiace)), family = poisson, data = p4)
round(sum(residuals(mp, type = "pearson")^2) / df.residual(mp), 2)
mnb <- glm.nb(kryzysy ~ asystent + dzieci + offset(log(miesiace)), data = p4)
b <- coef(mnb)[-1]; se <- sqrt(diag(vcov(mnb)))[-1]
round(cbind(IRR = exp(b), CI_d = exp(b - 1.96 * se), CI_g = exp(b + 1.96 * se), z = b / se), 2); signif(2 * pnorm(-abs(b / se)), 3)
# Częsty błąd: model bez offsetu (pomija różny czas obserwacji)
mbez <- glm.nb(kryzysy ~ asystent + dzieci, data = p4)
round(c(IRR_bez_offsetu = unname(exp(coef(mbez)[2])), p = summary(mbez)$coefficients[2, 4]), 3)

## Projekt 5. Mała grupa wsparcia: 14 osób przed i po, porównanie z 12 osobami bez grupy --------
# Wynik binarny: aktywne poszukiwanie pracy (tak/nie); wynik liczbowy: poczucie sprawczości (10–40).
przed_b <- c(1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 1, 0, 0)
po_b    <- c(1, 1, 1, 0, 1, 1, 1, 1, 1, 0, 1, 0, 1, 0)
table(przed = przed_b, po = po_b)
b10 <- sum(przed_b == 1 & po_b == 0); b01 <- sum(przed_b == 0 & po_b == 1)
p_dokl <- binom.test(b01, b01 + b10)$p.value                         # dokładny test McNemara
p_mid <- p_dokl - dbinom(b01, b01 + b10, .5)                          # mid-p (Fagerland i in., 2013)
p_asym <- mcnemar.test(table(przed_b, po_b), correct = FALSE)$p.value # asymptotyczny bez poprawki
round(c(zmiana_na_tak = b01, zmiana_na_nie = b10, p_dokladny = p_dokl, p_mid = p_mid, p_asympt = p_asym), 3)
sprawczosc_przed <- c(18, 22, 15, 25, 20, 17, 21, 24, 16, 19, 23, 26, 14, 20)
sprawczosc_po    <- c(24, 27, 19, 24, 26, 22, 25, 30, 18, 21, 28, 25, 20, 23)
roz <- sprawczosc_po - sprawczosc_przed; roz
wx <- wilcox.test(sprawczosc_po, sprawczosc_przed, paired = TRUE, exact = FALSE, correct = FALSE, conf.int = TRUE)
round(c(Me_roznicy = median(roz), HL = unname(wx$estimate), CI_d = wx$conf.int[1], CI_g = wx$conf.int[2]), 2); signif(wx$p.value, 3)
# Dokładny test permutacyjny (znakowy) dla średniej różnicy: wszystkie 2^14 = 16384 zmiany znaków
znaki <- as.matrix(expand.grid(rep(list(c(-1, 1)), length(roz))))
rozklad <- as.vector(znaki %*% abs(roz)) / length(roz)
round(c(M_roznicy = mean(roz), p_perm = mean(abs(rozklad) >= abs(mean(roz)) - 1e-12)), 4)
print(rank_biserial(sprawczosc_po, sprawczosc_przed, paired = TRUE), digits = 2)
# Po zakończeniu: 10 z 14 osób z grupy vs 4 z 12 osób bez grupy aktywnie szuka pracy (test Fishera)
tab5 <- matrix(c(10, 4, 4, 8), 2, dimnames = list(grupa = c("wsparcia", "bez grupy"), szuka = c("tak", "nie"))); tab5
ft <- fisher.test(tab5); round(c(OR = unname(ft$estimate), CI_d = ft$conf.int[1], CI_g = ft$conf.int[2], p = ft$p.value), 3)
round(min(chisq.test(tab5)$expected), 2)

## Ryzyko identyfikacji w ankiecie pracowników (dane z projektu 1) -------------------------------
set.seed(41606)
q <- data.frame(osrodek = p1$osrodek, plec = sample(c("K", "M"), nrow(p1), TRUE, prob = c(.85, .15)),
                wiek = cut(round(runif(nrow(p1), 24, 64)), c(0, 29, 39, 49, 59, Inf)),
                staz = cut(p1$staz, c(-1, 4, 9, 19, Inf)))
unikat <- function(d) { kk <- ave(rep(1, nrow(d)), do.call(paste, d), FUN = length)
  c(jedyni_proc = 100 * mean(kk == 1), w_grupach_ponizej_5_proc = 100 * mean(kk < 5)) }
q2 <- q[c("plec", "wiek", "staz")]                                    # bez ośrodka
q3 <- data.frame(plec = q$plec, staz = cut(p1$staz, c(-1, 9, Inf)))   # płeć i staż w dwóch przedziałach
round(rbind(z_osrodkiem = unikat(q), bez_osrodka = unikat(q2), plec_i_staz_2_kat = unikat(q3)), 1)
Wynik w R
    M    SD
29.46 15.59
        ICC        deff n_efektywne
      0.182       3.547      50.749
Zwykłe SE:
                     b   CI_d  CI_g   SE
I(srodowiska/10)  2.52   1.06  3.98 0.74
superwizjatak    -6.82 -11.19 -2.45 2.21
staz              0.19  -0.19  0.56 0.19
I(srodowiska/10)    superwizjatak             staz
        0.000833         0.002400         0.326000
SE odporne na klastrowanie (12 ośrodków, df = 11):
                     b   CI_d CI_g   SE
I(srodowiska/10)  2.52   1.18 3.86 0.61
superwizjatak    -6.82 -14.34 0.70 3.42
staz              0.19  -0.28 0.66 0.21
I(srodowiska/10)    superwizjatak             staz
         0.00166          0.07120          0.40100
Model wielopoziomowy (CI Walda):
                     b   CI_d CI_g   SE
I(srodowiska/10)  2.25   0.67 3.83 0.81
superwizjatak    -6.95 -13.90 0.00 3.55
staz              0.22  -0.14 0.58 0.18
[1] 0.13
alfa    M   SD
0.94 4.60 1.06
$nie
    n     M    SD
91.00  4.82  0.98

$tak
    n     M    SD
69.00  4.32  1.11

     t     df   CI_d   CI_g
  2.92 135.67   0.16   0.83
[1] 0.00406
Hedges' g |       95% CI
------------------------
0.47      | [0.15, 0.79]

- Estimated using un-pooled SD.           satysfakcja
zwrot          1    2    3    4    5
  urna       6.2  3.8 15.0 38.8 36.2
  pracownik  0.0  3.8  6.2 30.0 60.0
           x  n proc CI_d CI_g
urna      60 80   75 64.5 83.2
pracownik 72 80   90 81.5 94.8
     W
2314.5
[1] 0.00103
r (rank biserial) |         95% CI
----------------------------------
-0.28             | [-0.43, -0.10]
        M Wariancja Zera_proc
     1.08      1.97     44.29
$nie
         n M_miesiecy
      82.0        7.5

$tak
         n M_miesiecy
      58.0        8.9

 nie  tak
1.94 1.21
[1] 1.73
             IRR CI_d CI_g     z
asystenttak 0.63 0.41 0.97 -2.11
dzieci      1.10 0.92 1.32  1.05
asystenttak      dzieci
     0.0349      0.2920
IRR_bez_offsetu               p
          0.758           0.210
     po
przed 0 1
    0 3 7
    1 1 3
zmiana_na_tak zmiana_na_nie    p_dokladny         p_mid      p_asympt
        7.000         1.000         0.070         0.039         0.034
 [1]  6  5  4 -1  6  5  4  6  2  2  5 -1  6  3
Me_roznicy         HL       CI_d       CI_g
       4.5        4.0        2.0        5.5
[1] 0.00181
M_roznicy    p_perm
   3.7143    0.0007
r (rank biserial) |       95% CI
--------------------------------
0.94              | [0.82, 0.98]
           szuka
grupa       tak nie
  wsparcia   10   4
  bez grupy   4   8
    OR   CI_d   CI_g      p
 4.667  0.735 36.661  0.113
[1] 5.54
                  jedyni_proc w_grupach_ponizej_5_proc
z_osrodkiem              47.2                    100.0
bez_osrodka               3.9                     23.9
plec_i_staz_2_kat         0.0                      0.0
3. Rysunki
R
# Rysunki do wpisu (dane z przepisów 1 i 2; pliki w tym samym folderze).
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          strip.text = element_text(face = "bold", colour = KOLORY[["granat"]]),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output({ for (f in c("b416-1-ewaluacja-programu.R", "b416-2-pozostale-projekty.R")) source(f) }))

# Rysunek 1: ewaluacja – średnie przed i po z 95% CI (A) oraz wynik po względem wyniku przed z liniami ANCOVA (B)
sr <- do.call(rbind, lapply(c("przed", "po"), function(cz) do.call(rbind, lapply(levels(ew$grupa), function(g) {
  x <- ew[ew$grupa == g, cz]; tt <- t.test(x)
  data.frame(pomiar = cz, grupa = g, M = mean(x), CI_d = tt$conf.int[1], CI_g = tt$conf.int[2]) }))))
sr$pomiar <- factor(sr$pomiar, levels = c("przed", "po"))
print(transform(sr, M = round(M, 2), CI_d = round(CI_d, 2), CI_g = round(CI_g, 2)), row.names = FALSE)
kol <- c("porównawcza" = KOLORY[["drugi"]], "program" = KOLORY[["akcent"]])
pd <- position_dodge(width = .15)
rA <- ggplot(sr, aes(pomiar, M, colour = grupa, group = grupa)) +
  geom_line(linewidth = 1, position = pd) + geom_errorbar(aes(ymin = CI_d, ymax = CI_g), width = .08, linewidth = .8, position = pd) +
  geom_point(size = 3, position = pd) + scale_colour_manual(values = kol, name = NULL) +
  labs(title = "A. Średni stres rodzicielski przed i po", subtitle = "Program: n = 32; porównawcza: n = 48; 95% CI",
       x = NULL, y = "Stres rodzicielski (1–5)") + theme_metodolog(12)
siatka <- expand.grid(przed = seq(min(ew$przed), max(ew$przed), length.out = 50), grupa = levels(ew$grupa))
siatka$grupa <- factor(siatka$grupa, levels = levels(ew$grupa))
siatka$po <- predict(m_anc, siatka)
print(round(coef(m_anc), 3))
rB <- ggplot(ew, aes(przed, po, colour = grupa)) + geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = 2) +
  geom_point(size = 2.2, alpha = .75) + geom_line(data = siatka, linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL, guide = "none") +
  labs(title = "B. Wynik po a wynik przed (linie ANCOVA)", subtitle = "Przerywana: brak zmiany; odstęp linii = efekt skorygowany",
       x = "Stres przed", y = "Stres po") + theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.15), guides = "collect") & theme(legend.position = "bottom"),
           "../statystyka-praca-socjalna-ewaluacja-ancova.svg", szer = 11, wys = 5.6)

# Rysunek 2: wypalenie – te same współczynniki z trzema sposobami liczenia niepewności
ci_tab <- function(est, se, q, metoda) data.frame(metoda, zm = c("Liczba środowisk\n(+10)", "Superwizja w ośrodku\n(tak vs nie)"),
  b = est[1:2], CI_d = est[1:2] - q * se[1:2], CI_g = est[1:2] + q * se[1:2])
w <- rbind(ci_tab(zwykle[-1, 1], zwykle[-1, 2], qt(.975, m1$df.residual), "zwykłe SE (osoby niezależne)"),
           ci_tab(odporne[-1, 1], odporne[-1, 2], qt(.975, k - 1), "SE odporne na klastrowanie"),
           ci_tab(fixef(m2)[-1], sqrt(diag(vcov(m2)))[-1], qnorm(.975), "model wielopoziomowy"))
w$metoda <- factor(w$metoda, levels = rev(unique(w$metoda)))
print(transform(w, b = round(b, 2), CI_d = round(CI_d, 2), CI_g = round(CI_g, 2)), row.names = FALSE)
r2 <- ggplot(w, aes(b, metoda, colour = metoda)) + geom_vline(xintercept = 0, colour = "grey45", linetype = 2) +
  geom_errorbar(aes(xmin = CI_d, xmax = CI_g), width = .2, orientation = "y", linewidth = .9) + geom_point(size = 3) +
  facet_wrap(~zm, scales = "free_x") +
  scale_colour_manual(values = c("zwykłe SE (osoby niezależne)" = KOLORY[["dane"]], "SE odporne na klastrowanie" = KOLORY[["drugi"]],
                                 "model wielopoziomowy" = KOLORY[["akcent"]]), guide = "none") +
  labs(title = "Wypalenie związane z pracą z klientem: 180 pracowników z 12 ośrodków",
       subtitle = "Współczynnik b z 95% CI (punkty skali 0–100); 0 = brak związku",
       x = "b [95% CI]", y = NULL) + theme_metodolog(12)
zapisz_svg(r2, "../statystyka-praca-socjalna-wypalenie-klastry.svg", szer = 10, wys = 4.6)
Wynik w R
 pomiar       grupa    M CI_d CI_g
  przed porównawcza 2.73 2.60 2.85
  przed     program 3.54 3.37 3.71
     po porównawcza 2.82 2.65 3.00
     po     program 3.08 2.91 3.25
 (Intercept)        przed grupaprogram
       0.933        0.692       -0.301
Zapisano ../statystyka-praca-socjalna-ewaluacja-ancova.svg: w HTML width="1100" height="560" (26 KB)
                       metoda                                 zm     b   CI_d  CI_g
 zwykłe SE (osoby niezależne)            Liczba środowisk\n(+10)  2.52   1.06  3.98
 zwykłe SE (osoby niezależne) Superwizja w ośrodku\n(tak vs nie) -6.82 -11.19 -2.45
   SE odporne na klastrowanie            Liczba środowisk\n(+10)  2.52   1.18  3.86
   SE odporne na klastrowanie Superwizja w ośrodku\n(tak vs nie) -6.82 -14.34  0.70
         model wielopoziomowy            Liczba środowisk\n(+10)  2.25   0.67  3.83
         model wielopoziomowy Superwizja w ośrodku\n(tak vs nie) -6.95 -13.90  0.00
Zapisano ../statystyka-praca-socjalna-wypalenie-klastry.svg: w HTML width="1000" height="460" (10 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), glm(), t.test(), wilcox.test(), binom.test(), mcnemar.test() i fisher.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- emmeans (wersja 2.0.2): Lenth, R. V. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://CRAN.R-project.org/package=emmeans
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z pracy socjalnej
- Ewaluacja programu na podstawie samej grupy uczestników. Spadek o 0.46 punktu w przykładzie był ponad półtora raza większy od prawdziwego efektu (0.30), bo do programu trafiły rodziny w chwili wysokiego wyniku.
- Różnica w różnicach przy przydziale według wyniku przed. Gdy grupy wybrano według pomiaru wyjściowego, regresja do średniej działa w obu grupach w przeciwne strony i zawyża efekt.
- Pracownicy kilku ośrodków traktowani jak niezależne osoby. Przy ICC = .18 i 15 osobach w ośrodku przedział dla superwizji był zbyt wąski, a p = .002 zamiast .071.
- Hipoteza o cesze ośrodka testowana na kilku ośrodkach. Dwanaście ośrodków to w praktyce dwanaście obserwacji dla zmiennej „superwizja”.
- Zliczenia z dokumentacji bez czasu obserwacji. Bez offsetu efekt asystenta rodziny w przykładzie był nieistotny (IRR = 0.76, p = .210).
- Ankiety o satysfakcji zbierane przez pracownika prowadzącego sprawę i opisywane jako „wysoka ocena pomocy”.
- Test chi-kwadrat lub test t przy kilkunastu osobach bez sprawdzenia, czy przybliżenie jest uprawnione, i bez wielkości efektu z przedziałem ufności.
- Wynik nieistotny w małej grupie opisany jako „program nie działa”, mimo przedziału ufności od 0.74 do 36.66 dla ilorazu szans.
- Wyniki raportowane dla pojedynczych ośrodków lub małych podgrup, które pozwalają rozpoznać pracowników albo klientów.
- Liczby o skali problemów społecznych we wstępie bez źródła albo bez rozróżnienia danych administracyjnych i deklaracji respondentów.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z pracy socjalnej?
Zależy to od danych. Wynik skali (np. wypalenia albo wsparcia społecznego) porównuj testem Welcha lub regresją, wynik programu z pomiarem przed i po – ANCOVA z wynikiem przed jako kowariantem, zliczenia z dokumentacji – regresją ujemną dwumianową z offsetem czasu obserwacji, a wyniki kilkunastoosobowej grupy – testami dokładnymi. Przy każdej analizie podaj wielkość efektu z 95% CI.
Jak ocenić skuteczność programu, do którego trafiły rodziny w najtrudniejszej sytuacji?
Nie opieraj się na samym spadku wyniku u uczestników, bo rodziny skierowane do programu w chwili wysokiego wyniku i tak poprawiłyby się częściowo (regresja do średniej). Zbierz grupę porównawczą, zmierz obie grupy przed i po i porównaj wynik po w ANCOVA z wynikiem przed jako kowariantem. W ograniczeniach opisz, według jakich kryteriów kierowano rodziny do programu.
Czy ankiety pracowników z kilku ośrodków pomocy społecznej można analizować jak jedną próbę?
Tylko w opisie. W testach i regresji uwzględnij, że pracownicy jednego ośrodka są do siebie podobni: policz ICC i użyj błędów standardowych odpornych na klastrowanie albo modelu wielopoziomowego. Jest to szczególnie ważne, gdy hipoteza dotyczy cechy ośrodka, np. superwizji – wtedy o precyzji decyduje liczba ośrodków, a nie pracowników.
Jaki test wybrać, gdy w grupie wsparcia jest tylko kilkanaście osób?
Dla wyniku tak/nie przed i po użyj testu McNemara w wersji dokładnej lub mid-p, dla wyniku skali – testu Wilcoxona dla par albo dokładnego testu permutacyjnego, a przy porównaniu dwóch małych grup – testu Fishera. Wersję testu zapisz w planie analizy przed zebraniem danych i podaj wielkość efektu z przedziałem ufności, bo przy małej próbie wynik nieistotny rzadko oznacza brak efektu.
Jak chronić anonimowość pracowników i klientów w badaniu jednej instytucji?
Nie zbieraj zmiennych, których nie analizujesz, wiek i staż zbieraj w przedziałach, nie raportuj wyników dla pojedynczych ośrodków ani bardzo małych podgrup i przekazuj instytucji tylko wyniki zbiorcze. Przed udostępnieniem danych sprawdź, ile osób jest jedynych w swojej kombinacji cech. Ankiety klientów zbieraj do zamkniętej urny, a nie przez pracownika prowadzącego sprawę.
Powiązane hasła
Przeczytaj też
Jak napisać pracę z pracy socjalnej
Problem społeczny, dostęp do ośrodków, anonimowość w małych zespołach, dane z systemów i ewaluacja programu – z gotowymi akapitami na fikcyjnych przykładach.
Czytaj →PoradnikBadanie ewaluacyjne w pracy dyplomowej
Model logiczny, kryteria i poziomy Kirkpatricka, wskaźniki, schemat przed–po z grupą porównawczą oraz ANCOVA i DiD w R na przykładzie szkolenia.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z pracy socjalnej i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – ankiety pracowników z kilku ośrodków, ewaluacji programu, dokumentacji albo małej grupy – policzyć je z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (1992). A survey of exact inference for contingency tables. Statistical Science, 7(1), 131–153. https://doi.org/10.1214/ss/1177011454 ● Otwarty dostęp
- Borritz, M., Rugulies, R., Bjorner, J. B., Villadsen, E., Mikkelsen, O. A., & Kristensen, T. S. (2006). Burnout among employees in human service work: Design and baseline findings of the PUMA study. Scandinavian Journal of Public Health, 34(1), 49–58. https://doi.org/10.1080/14034940510032275
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Kim, H., & Stoner, M. (2008). Burnout and turnover intention among social workers: Effects of role stress, job autonomy and social support. Administration in Social Work, 32(3), 5–25. https://doi.org/10.1080/03643100801922357 ● Otwarty dostęp
- Kristensen, T. S., Borritz, M., Villadsen, E., & Christensen, K. B. (2005). The Copenhagen Burnout Inventory: A new tool for the assessment of burnout. Work & Stress, 19(3), 192–207. https://doi.org/10.1080/02678370500297720
- Lloyd, C., King, R., & Chenoweth, L. (2002). Social work, stress and burnout: A review. Journal of Mental Health, 11(3), 255–265. https://doi.org/10.1080/09638230020023642
- Sweeney, L. (2002). k-Anonymity: A model for protecting privacy. International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems, 10(05), 557–570. https://doi.org/10.1142/s0218488502001648 ● Otwarty dostęp: pełny tekst
- Wright, D. B. (2006). Comparing groups in a before–after design: When t test and ANCOVA produce different results. British Journal of Educational Psychology, 76(3), 663–675. https://doi.org/10.1348/000709905x52210
- Zimet, G. D., Dahlem, N. W., Zimet, S. G., & Farley, G. K. (1988). The Multidimensional Scale of Perceived Social Support. Journal of Personality Assessment, 52(1), 30–41. https://doi.org/10.1207/s15327752jpa5201_2 ● Otwarty dostęp
Cytowania BibTeX
@article{agresti1992survey, author={Agresti, Alan}, title={{A survey of exact inference for contingency tables}}, journal={Statistical Science}, year={1992}, volume={7}, number={1}, pages={131--153}, doi={10.1214/ss/1177011454}}@article{borritz2006burnout, author={Borritz, Marianne and Rugulies, Reiner and Bjorner, Jakob B. and Villadsen, Ebbe and Mikkelsen, Ole A. and Kristensen, Tage S.}, title={{Burnout among employees in human service work: Design and baseline findings of the PUMA study}}, journal={Scandinavian Journal of Public Health}, year={2006}, volume={34}, number={1}, pages={49--58}, doi={10.1080/14034940510032275}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{kim2008burnout, author={Kim, Hansung and Stoner, Madeleine}, title={{Burnout and turnover intention among social workers: Effects of role stress, job autonomy and social support}}, journal={Administration in Social Work}, year={2008}, volume={32}, number={3}, pages={5--25}, doi={10.1080/03643100801922357}}@article{kristensen2005copenhagen, author={Kristensen, Tage S. and Borritz, Marianne and Villadsen, Ebbe and Christensen, Karl B.}, title={{The Copenhagen Burnout Inventory: A new tool for the assessment of burnout}}, journal={Work \& Stress}, year={2005}, volume={19}, number={3}, pages={192--207}, doi={10.1080/02678370500297720}}@article{lloyd2002social, author={Lloyd, Chris and King, Robert and Chenoweth, Lesley}, title={{Social work, stress and burnout: A review}}, journal={Journal of Mental Health}, year={2002}, volume={11}, number={3}, pages={255--265}, doi={10.1080/09638230020023642}}@article{sweeney2002k, author={Sweeney, Latanya}, title={{k-Anonymity: A model for protecting privacy}}, journal={International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems}, year={2002}, volume={10}, number={05}, pages={557--570}, doi={10.1142/s0218488502001648}}@article{wright2006comparing, author={Wright, Daniel B.}, title={{Comparing groups in a before–after design: When t test and ANCOVA produce different results}}, journal={British Journal of Educational Psychology}, year={2006}, volume={76}, number={3}, pages={663--675}, doi={10.1348/000709905x52210}}@article{zimet1988multidimensional, author={Zimet, Gregory D. and Dahlem, Nancy W. and Zimet, Sara G. and Farley, Gordon K.}, title={{The Multidimensional Scale of Perceived Social Support}}, journal={Journal of Personality Assessment}, year={1988}, volume={52}, number={1}, pages={30--41}, doi={10.1207/s15327752jpa5201_2}}