Jedno badanie, kilka różnych efektów leczenia
W badaniu leku przeciwcukrzycowego część pacjentów po 8 albo 16 tygodniach dostaje leczenie ratunkowe, bo ich HbA1c jest za wysokie. W grupie placebo zdarza się to częściej. Po 24 tygodniach statystyk ma trzy możliwości: analizować wszystkie pomiary, usunąć pomiary po ratunku albo uznać ratunek za porażkę leczenia. Każda z nich daje inną liczbę i każda odpowiada na inne pytanie. Kłopot zaczyna się wtedy, gdy autorzy nie mówią, na które.
Addendum R1 do wytycznej ICH E9, w Unii Europejskiej obowiązujące od 30 lipca 2020 r. (International Council for Harmonisation [ICH], 2020), każe zacząć od pytania, a dopiero potem dobrać metodę. Definicję estymandy, jej pięć atrybutów i prosty przykład z przerwaniem leczenia znajdziesz w haśle słownika. Tu zajmujemy się praktyką: jak wybrać strategię wobec zdarzeń współwystępujących, jakim estymatorem ją oszacować, co się dzieje, gdy estymator nie pasuje do estymandy, i jak zapisać to w protokole.
Potrzeba jest realna. W żadnym z 50 protokołów badań randomizowanych opublikowanych w październiku 2020 r. w Trials i BMJ Open nie opisano wprost estymandy wyniku głównego, a w 74% nie dało się jej nawet odtworzyć (Kahan i in., 2021). W przeglądzie 255 badań z sześciu czołowych czasopism medycznych zdarzenia współwystępujące raportowano w 95% badań, ale sposób postępowania z nimi dało się ustalić tylko w 49% (Cro i in., 2022).
Zdarzenie współwystępujące to nie brak danych
W polskim tłumaczeniu spotkasz też nazwę „zdarzenie śródokresowe” (ang. intercurrent event). Chodzi o zdarzenie po randomizacji, które zmienia interpretację wyniku albo sprawia, że wyniku nie ma: przerwanie leczenia, leczenie ratunkowe, zmiana leku, zgon. Kahan i in. (2024) podkreślają, że braki danych nie są zdarzeniami współwystępującymi. Pacjent, który dostał ratunek, ma zmierzone HbA1c w 24. tygodniu. Pomiar istnieje, tylko nie wiadomo, czy jest „właściwy”. Odpowiedź zależy od estymandy.
To rozróżnienie zmienia projekt badania. Jeśli pytasz o efekt w praktyce, musisz mierzyć wynik także po ratunku i po przerwaniu leczenia. Jeśli pytasz, co by było bez ratunku, pomiary po ratunku do analizy nie trafią, ale nadal przydają się w analizie wrażliwości. Zasada „przerwał leczenie, więc kończy udział w badaniu” niszczy dane potrzebne do strategii polityki leczenia. Tego nie naprawi żadna metoda. Analiza ITT mówi, kogo analizujesz (wszystkich zrandomizowanych), ale nie mówi, który pomiar przyjąć u osoby po ratunku.
Pięć strategii i pytania, na które odpowiadają
Addendum wymienia pięć strategii (Mallinckrodt i in., 2020). Dla każdego rodzaju zdarzenia wybierasz jedną. W jednym badaniu ratunek możesz potraktować strategią polityki leczenia, a zgon – strategią złożoną.
| Strategia | Pytanie (przykład z ratunkiem) | Potrzebne dane | Typowy estymator |
|---|---|---|---|
| Polityka leczenia | Jaka jest różnica HbA1c po 24 tyg. przy przydziale do leku, niezależnie od tego, czy pacjent dostał ratunek? | Pomiary u wszystkich, także po ratunku | ANCOVA na wszystkich zrandomizowanych; przy brakach – imputacja z jawnymi założeniami |
| Hipotetyczna | Jaka byłaby różnica, gdyby leczenie ratunkowe nie było dostępne? | Pomiary przed ratunkiem i zmienne, które o nim decydują | MMRM albo imputacja wielokrotna przy założeniu MAR |
| Złożona | Jaki odsetek osiąga HbA1c < 7% bez potrzeby ratunku? | Wynik i informacja o zdarzeniu | Różnica odsetków; wynik rangowy, test Wilcoxona |
| W trakcie leczenia | Jaki jest efekt do chwili zdarzenia? | Pomiary do zdarzenia, czas zdarzenia | Średnia lub ostatnia wartość przed zdarzeniem; ma sens, gdy czas zdarzenia jest podobny w ramionach |
| Warstwa główna | Jaki jest efekt u osób, które nie potrzebowałyby ratunku w żadnym ramieniu? | Silne założenia lub granice | Metody stratyfikacji głównej |
Strategia hipotetyczna wymaga opisu scenariusza. „Gdyby ratunku nie było” to inne pytanie niż „gdyby pacjent nie przerwał leku mimo działań niepożądanych”. Lipkovich i in. (2020) proponują opisywać takie pytania językiem wyników potencjalnych. Wtedy widać, które porównanie jest przyczynowe i przy jakich założeniach da się je oszacować. W badaniach z leczeniem ratunkowym strategia hipotetyczna ma uzasadnienie: chcesz poznać działanie samego leku, a ratunek jest zabiegiem etycznym, nie częścią badanej terapii. Przy zgonie jest odwrotnie. Pytanie „gdyby nikt nie umarł” rzadko ma sens kliniczny. A jednak w przeglądzie Cro i in. (2022) strategię hipotetyczną wobec zgonu przyjęło 19 z 24 badań, w których część pacjentów zmarła.
Przykład: lek, placebo i leczenie ratunkowe
Symulujemy badanie 2 × 200 pacjentów z HbA1c ok. 8.3% na starcie i pomiarami po 8, 16 i 24 tygodniach. Lek obniża HbA1c o 0.25 punktu procentowego na każde 8 tygodni bardziej niż placebo. Po 8. i 16. tygodniu pacjent z HbA1c powyżej 8.5% dostaje leczenie ratunkowe z prawdopodobieństwem 0.8. Ratunek obniża HbA1c o kolejny punkt procentowy. Decyzja zależy tylko od zmierzonych wartości, więc z punktu widzenia strategii hipotetycznej pomiary po ratunku są brakami MAR.
Prawdziwe wartości estymand policzyliśmy na populacji 2 × 200 000 osób z tego samego modelu. Ratunek dostało tam 38.6% osób z placebo i 24.6% z ramienia leku. Estymanda polityki leczenia wynosi −0.611 punktu procentowego, a hipotetyczna −0.751. Różnią się, bo ratunek częściej poprawia wynik w grupie placebo i zmniejsza różnicę między ramionami (rysunek 1).
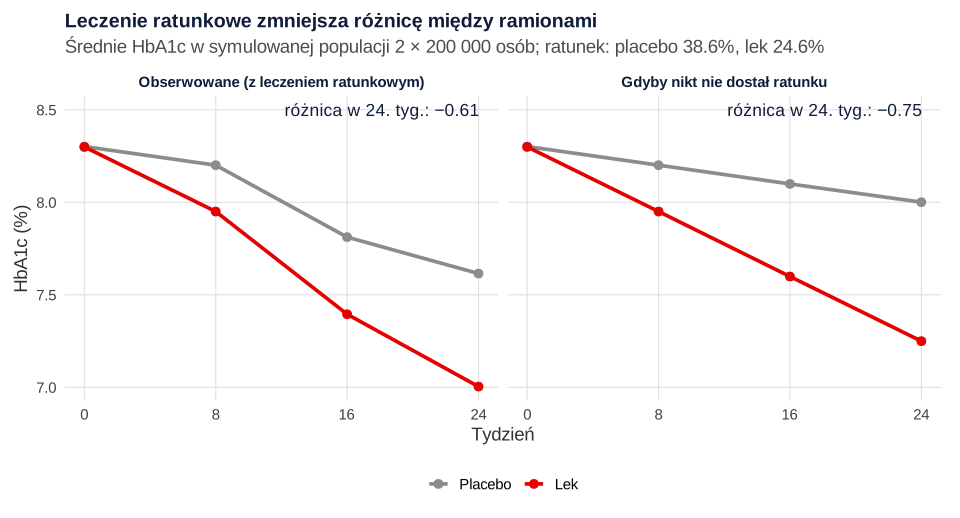
W naszym badaniu ratunek dostało 70 osób z placebo (35%) i 50 z ramienia leku (25%), przeważnie już po 8. tygodniu (54 i 42 osoby). Średnie obserwowane HbA1c w 24. tygodniu wyniosły 7.60% i 7.05%.
Cztery strategie, cztery różne liczby
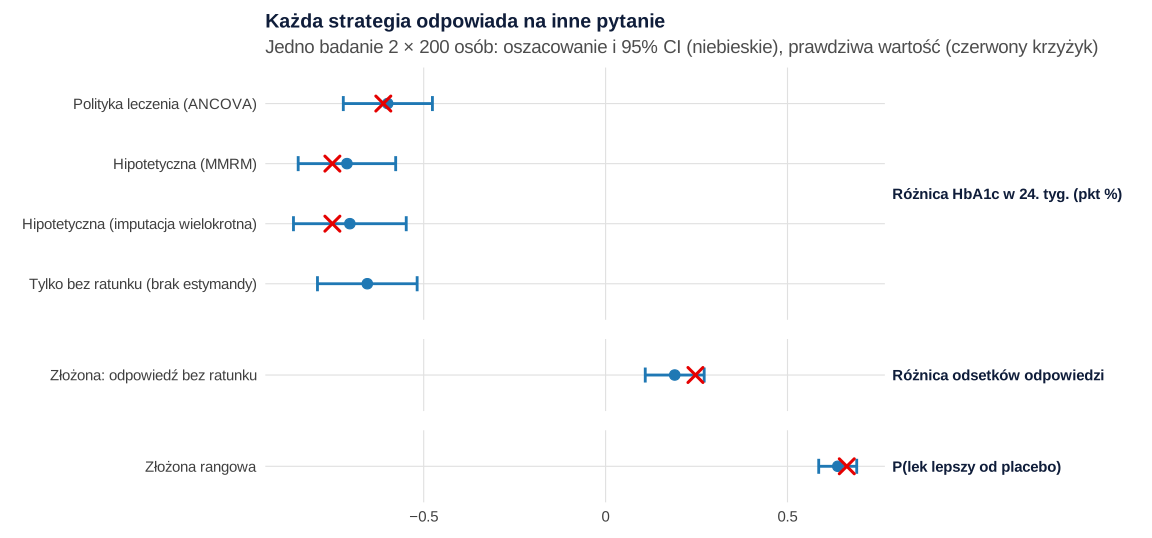
Do każdej strategii dobraliśmy estymator, który odpowiada na jej pytanie. Dodaliśmy też analizę, którą często widać w artykułach: usunięcie pacjentów z ratunkiem.
| Estymanda i estymator | Oszacowanie [95% CI] | Prawdziwa wartość |
|---|---|---|
| Polityka leczenia: ANCOVA, wszystkie pomiary z 24. tyg. | −0.599 [−0.721, −0.476] | −0.611 |
| Hipotetyczna: MMRM bez pomiarów po ratunku | −0.711 [−0.845, −0.577] | −0.751 |
| Hipotetyczna: imputacja wielokrotna (50 zbiorów) + ANCOVA | −0.703 [−0.858, −0.548] | −0.751 |
| Złożona: różnica odsetków HbA1c < 7% bez ratunku (33% wobec 14%) | 0.190 [0.109, 0.271] | 0.247 |
| Złożona rangowa: P(pacjent z lekiem ma lepszy wynik) | 0.638 [0.586, 0.690] | 0.663 |
| Tylko pacjenci bez ratunku (bez estymandy) | −0.655 [−0.792, −0.518] | – |
W strategii hipotetycznej model dla pomiarów powtarzanych (MMRM, nlme::gls z niestrukturalną macierzą kowariancji) wykorzystał 984 z 1200 pomiarów. Pacjent z ratunkiem po 16. tygodniu wnosi pomiary z 8. i 16. tygodnia, a model przewiduje jego wynik „bez ratunku” na tej podstawie. Imputacja wielokrotna, prowadzona osobno w ramionach, dała prawie to samo. Oba estymatory zakładają, że po uwzględnieniu wcześniejszych pomiarów pacjenci z ratunkiem rozwijaliby się jak podobni pacjenci bez ratunku.
W strategii złożonej ratunek jest częścią wyniku. W wersji binarnej pacjent z ratunkiem to brak odpowiedzi (zob. analiza responderów). W wersji rangowej każdy pacjent z ratunkiem ma gorszy wynik niż każdy bez ratunku, a ratunek po 8. tygodniu jest gorszy niż po 16. Wynik to prawdopodobieństwo, że losowy pacjent z ramienia leku ma lepszy wynik niż losowy pacjent z placebo, z testem Manna–Whitneya (p < .001). Dychotomizacja HbA1c traci informację, a ranking zachowuje wartości u osób bez ratunku. Kolejność kategorii trzeba jednak uzasadnić klinicznie. Podobne pułapki ma każdy złożony punkt końcowy.
Co szacuje analiza bez pacjentów z ratunkiem?
Jedno badanie może wyjść szczęśliwie, więc powtórzyliśmy je 500 razy. Estymatory dopasowane do estymand nie miały obciążenia. Polityka leczenia dała średnio −0.610 przy pokryciu 95% przedziału .954, MMRM −0.752 przy pokryciu .944 (błąd Monte Carlo średniej 0.0032), a różnica odsetków odpowiedzi 0.247 przy pokryciu .958. W 99.6% badań oszacowanie polityki leczenia było bliżej zera niż oszacowanie hipotetyczne. To nie błąd żadnej z metod, tylko różnica pytań.
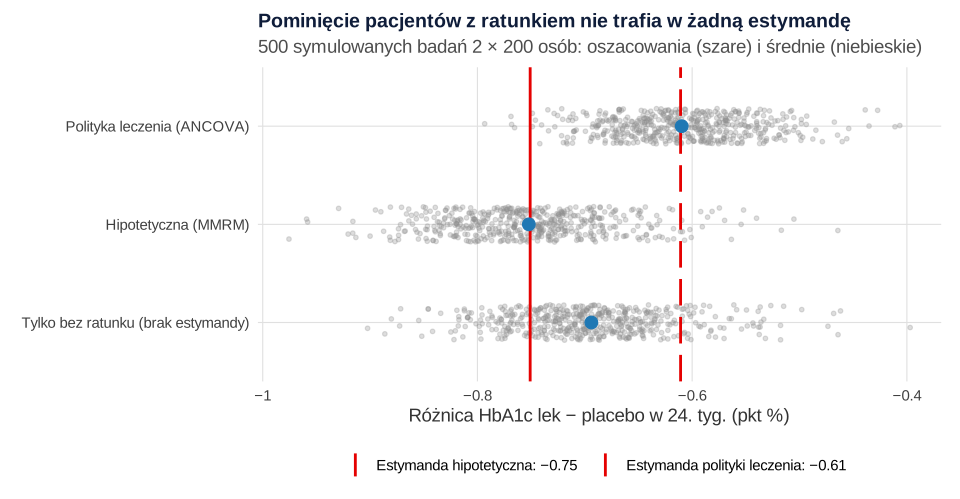
Analiza ograniczona do pacjentów bez ratunku dała średnio −0.694, czyli wynik pośrodku między obiema estymandami. W porównaniu z estymandą hipotetyczną, za którą bywa uważana, jej obciążenie wyniosło 0.057, a pokrycie spadło do .890. Powód jest ten sam co w analizie per protocol: usuwamy pacjentów z wysokim HbA1c, częściej z placebo, więc ramiona przestają być porównywalne. MMRM też nie używa pomiarów po ratunku, ale zachowuje tych pacjentów i ich wcześniejsze wartości.
Jak wybrać strategię
- Kto podejmie decyzję na podstawie wyniku? Lekarz i płatnik pytają zwykle o efekt w praktyce, czyli o politykę leczenia. Badacz mechanizmu albo regulator oceniający samo działanie leku może potrzebować strategii hipotetycznej.
- Czy zdarzenie jest częścią leczenia? Dostępność ratunku w praktyce przemawia za polityką leczenia. Ratunek jako zabieg etyczny tylko w badaniu przemawia za strategią hipotetyczną.
- Czy zdarzenie samo jest wynikiem? Zgon albo przerwanie leczenia z powodu nieskuteczności to informacja o leczeniu. Wtedy dobrym wyborem jest strategia złożona.
- Czy da się zebrać dane? Polityka leczenia wymaga pomiarów po zdarzeniu. Gdy ich zabraknie, imputacja musi zakładać coś o przebiegu po zdarzeniu.
- Jakie założenia przyjmuje estymator? Mallinckrodt i in. (2020) zwracają uwagę, że estymator ma odpowiadać estymandzie, a jego założenia mają być uzasadnione i wiarygodne. Często nie da się ich sprawdzić, dlatego decydują o odporności wyniku.
Nic nie stoi na przeszkodzie, by badanie miało estymandę główną i drugorzędową, np. politykę leczenia dla wyniku głównego i strategię hipotetyczną jako uzupełnienie. Obie trzeba zapisać z góry, a przy kilku testach potwierdzających zaplanować kontrolę błędu (zob. kilka wyników głównych). Clark i in. (2022) pokazują na przykładach, że takie doprecyzowanie pytania zmienia też projekt badania i zbieranie danych.
Jak opisać estymandę w protokole
Opis estymandy umieść w planie analizy statystycznej i w protokole, osobno dla każdego wyniku głównego. Podaj wszystkie pięć atrybutów, estymator z założeniami oraz analizę wrażliwości. Poniższy wzór opisuje estymandę hipotetyczną z przykładu.
W artykule wynik podajesz z nazwą estymandy, np.: „Przy strategii hipotetycznej wobec leczenia ratunkowego różnica HbA1c po 24 tygodniach (lek − placebo) wyniosła −0.71 punktu procentowego, 95% CI [−0.84, −0.58] (MMRM). Przy strategii polityki leczenia różnica wyniosła −0.60, 95% CI [−0.72, −0.48] (ANCOVA)”.
Analiza wrażliwości dla tej samej estymandy
Analiza wrażliwości ma zmieniać założenia, a nie pytanie (Kahan i in., 2024). Porównanie MMRM z analizą per protocol nie jest analizą wrażliwości, bo celuje w inną estymandę. Dla strategii hipotetycznej sprawdź, co się stanie, gdy pacjenci z ratunkiem rozwijaliby się gorzej, niż zakłada MAR. Carpenter i in. (2013) opisali ramy jawnych założeń o danych po odstępstwie od protokołu i pokazali, że przy tych założeniach wnioskowanie da się przeprowadzić imputacją wielokrotną. Z tej rodziny pochodzą metody imputacji względem grupy odniesienia. Prostą alternatywą jest analiza punktu krytycznego: szukasz przesunięcia imputowanych wartości, przy którym wniosek się zmienia. Nie zastępuj braków wartościami z ostatniej wizyty – LOCF nie odpowiada żadnej estymandzie. Więcej o planowaniu takich analiz piszemy we wpisie analiza wrażliwości w artykule.
Podobnie myśli się poza badaniami klinicznymi: w emulacji badania docelowego na danych obserwacyjnych estymanda też poprzedza wybór metody. Jeśli przygotowujesz protokół albo odpowiadasz recenzentowi na pytanie o leczenie ratunkowe, możemy wspólnie dobrać estymandę, estymator i analizę wrażliwości w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z funkcji i obiektów z pierwszego). Pierwszy zapisuje dane badania do pliku estymanda-badanie-ratunkowe.csv (możesz go pobrać tutaj; ratunek_od to numer wizyty, od której pomiar jest po ratunku: 2 = 16. tydzień, 3 = 24. tydzień). Monte Carlo w przepisie 3 liczy się kilka minut. Potrzebne pakiety: nlme i mice.
1. Badanie z leczeniem ratunkowym i prawdziwe wartości estymand
R
# Krok 1. Symulowane badanie z leczeniem ratunkowym i prawdziwe wartości czterech estymand (dane symulowane)
# Cukrzyca typu 2: lek albo placebo przez 24 tygodnie, HbA1c (%) na starcie i w tygodniach 8, 16 i 24.
# Zdarzenie współwystępujące: leczenie ratunkowe, włączane po wizycie 8 albo 16 tyg., gdy HbA1c > 8.5%.
generuj_badanie <- function(n_ramie) {
  n <- 2 * n_ramie
  ramie <- rep(0:1, each = n_ramie)                     # 0 = placebo, 1 = lek
  hba1c_0 <- rnorm(n, 8.3, 0.7)                         # wartość wyjściowa
  b <- rnorm(n, 0, 0.4); s <- rnorm(n, 0, 0.15)         # trwała różnica osoby i jej własne tempo zmian
  # HbA1c bez leczenia ratunkowego (wynik potencjalny): lek obniża o 0.25 pkt % na każde 8 tygodni
  y_bez <- sapply(1:3, function(t) hba1c_0 + 0.6 * b + (-0.10 - 0.25 * ramie + s) * t + rnorm(n, 0, 0.35))
  # Leczenie ratunkowe: decyzja po wizycie 8 albo 16 tyg. na podstawie zmierzonego HbA1c (dane MAR)
  ratunek_od <- rep(NA_integer_, n)                     # od której wizyty pacjent jest „po ratunku”
  for (t in 1:2) {
    kandydat <- is.na(ratunek_od) & y_bez[, t] > 8.5
    ratunek_od[kandydat & runif(n) < 0.8] <- t + 1L
  }
  efekt_ratunku <- sapply(1:3, function(t) ifelse(!is.na(ratunek_od) & t >= ratunek_od, -1.0, 0))
  y <- y_bez + efekt_ratunku                            # to obserwujemy (pomiary trwają po ratunku)
  data.frame(id = seq_len(n), ramie, hba1c_0 = hba1c_0,
             t8 = y[, 1], t16 = y[, 2], t24 = y[, 3], ratunek_od,
             t16_bez_ratunku = y_bez[, 2], t24_bez_ratunku = y_bez[, 3])  # znane tylko w symulacji
}
# Złożony wynik rangowy: każdy pacjent z ratunkiem gorszy od każdego bez ratunku, wcześniejszy ratunek gorszy
wynik_rangowy <- function(d) ifelse(is.na(d$ratunek_od), d$t24, ifelse(d$ratunek_od == 3, 100, 200))
p_przewagi <- function(w, ramie) {                      # P(lek lepszy niż placebo), remisy po połowie
  r <- rank(-w); n1 <- as.numeric(sum(ramie == 1)); n0 <- as.numeric(sum(ramie == 0))
  (sum(r[ramie == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0)
}

# Prawdziwe wartości estymand z bardzo dużego badania (2 × 200 000 osób)
set.seed(3550)
pop <- generuj_badanie(2e5)
roznica <- function(x, ramie) mean(x[ramie == 1]) - mean(x[ramie == 0])
prawda <- c(polityka_leczenia = roznica(pop$t24, pop$ramie),
            hipotetyczna = roznica(pop$t24_bez_ratunku, pop$ramie),
            zlozona_odpowiedz = roznica(pop$t24 < 7 & is.na(pop$ratunek_od), pop$ramie),
            zlozona_rangowa = p_przewagi(wynik_rangowy(pop), pop$ramie))
round(prawda, 3)
cat("Leczenie ratunkowe w populacji (%): placebo", round(100 * mean(!is.na(pop$ratunek_od[pop$ramie == 0])), 1),
    " lek", round(100 * mean(!is.na(pop$ratunek_od[pop$ramie == 1])), 1), "\n")
sr <- function(x) tapply(x, pop$ramie, mean)              # średnie w populacji do rysunku 1
write.csv(data.frame(ramie = rep(0:1, 8), tydzien = rep(rep(c(0, 8, 16, 24), each = 2), 2),
                     wariant = rep(c("obserwowane", "bez_ratunku"), each = 8),
                     hba1c = c(sr(pop$hba1c_0), sr(pop$t8), sr(pop$t16), sr(pop$t24),
                               sr(pop$hba1c_0), sr(pop$t8), sr(pop$t16_bez_ratunku), sr(pop$t24_bez_ratunku))),
          "rysunek1-trajektorie.csv", row.names = FALSE)

# Jedno badanie: 2 × 200 osób
set.seed(3551)
d <- generuj_badanie(200)
d$ratunek <- !is.na(d$ratunek_od)
write.csv(transform(d[, c("id", "ramie", "hba1c_0", "t8", "t16", "t24", "ratunek_od")],
                    hba1c_0 = round(hba1c_0, 2), t8 = round(t8, 2), t16 = round(t16, 2), t24 = round(t24, 2)),
          "estymanda-badanie-ratunkowe.csv", row.names = FALSE)
grupy <- factor(d$ramie, 0:1, c("placebo", "lek"))
cat("Leczenie ratunkowe (n i %):\n")
print(rbind(n = tapply(d$ratunek, grupy, sum), proc = round(100 * tapply(d$ratunek, grupy, mean), 1)))
cat("Wizyta, po której włączono ratunek:\n")
print(table(grupy, wizyta = factor(d$ratunek_od, 2:3, c("8 tyg.", "16 tyg.")), useNA = "no"))
cat("Średnie HbA1c (obserwowane, ze skutkiem ratunku):\n")
print(round(sapply(d[, c("hba1c_0", "t8", "t16", "t24")], tapply, grupy, mean), 2))
Wynik w R
polityka_leczenia      hipotetyczna zlozona_odpowiedz   zlozona_rangowa
           -0.611            -0.751             0.247             0.663
Leczenie ratunkowe w populacji (%): placebo 38.6  lek 24.6
Leczenie ratunkowe (n i %):
     placebo lek
n         70  50
proc      35  25
Wizyta, po której włączono ratunek:
         wizyta
grupy     8 tyg. 16 tyg.
  placebo     54      16
  lek         42       8
Średnie HbA1c (obserwowane, ze skutkiem ratunku):
        hba1c_0   t8  t16  t24
placebo    8.26 8.16 7.79 7.60
lek        8.33 8.00 7.44 7.05
2. Cztery strategie na jednym badaniu
R
# Krok 2. Jedno badanie, cztery strategie wobec leczenia ratunkowego (+ analiza bez estymandy)
# Korzysta z obiektów d, prawda, wynik_rangowy() i p_przewagi() z kroku 1.
suppressPackageStartupMessages({library(nlme); library(mice)})
wiersz <- function(est, se) c(oszacowanie = est, dolna = est - qnorm(.975) * se, gorna = est + qnorm(.975) * se)

# 1. Polityka leczenia: wszyscy zrandomizowani, HbA1c w 24. tyg. niezależnie od ratunku (ANCOVA)
m_pl <- lm(t24 ~ ramie + hba1c_0, data = d)
pl <- wiersz(coef(m_pl)[["ramie"]], sqrt(vcov(m_pl)["ramie", "ramie"]))

# 2a. Hipotetyczna: pomiary po ratunku usunięte, MMRM (gls, macierz niestrukturalna), kontrast w 24. tyg.
d$t16_h <- ifelse(d$ratunek & d$ratunek_od <= 2, NA, d$t16)
d$t24_h <- ifelse(d$ratunek, NA, d$t24)
dl <- data.frame(id = rep(d$id, 3), ramie = rep(d$ramie, 3), hba1c_0 = rep(d$hba1c_0, 3),
                 wizyta = rep(1:3, each = nrow(d)), y = c(d$t8, d$t16_h, d$t24_h))
dl$tydz <- factor(dl$wizyta, levels = c(3, 1, 2), labels = c("t24", "t8", "t16"))  # t24 jako poziom odniesienia
m_mmrm <- gls(y ~ tydz * (ramie + hba1c_0), data = dl, na.action = na.omit, method = "REML",
              correlation = corSymm(form = ~ wizyta | id), weights = varIdent(form = ~ 1 | wizyta))
hip_mmrm <- wiersz(coef(m_mmrm)[["ramie"]], sqrt(vcov(m_mmrm)["ramie", "ramie"]))
cat("Obserwacje w MMRM:", sum(!is.na(dl$y)), "z", nrow(dl), "\n")

# 2b. Hipotetyczna: imputacja wielokrotna (osobno w ramionach, 50 zbiorów) + ANCOVA i reguły Rubina
szer <- d[, c("ramie", "hba1c_0", "t8", "t16_h", "t24_h")]
imp <- lapply(0:1, function(r) mice(szer[szer$ramie == r, -1], m = 50, method = "norm",
                                    printFlag = FALSE, seed = 3552 + r))
dopas <- lapply(1:50, function(k) {
  dk <- rbind(cbind(ramie = 0, complete(imp[[1]], k)), cbind(ramie = 1, complete(imp[[2]], k)))
  m <- lm(t24_h ~ ramie + hba1c_0, data = dk)
  c(b = coef(m)[["ramie"]], v = vcov(m)["ramie", "ramie"])
})
dopas <- do.call(rbind, dopas)
Tcal <- mean(dopas[, "v"]) + (1 + 1 / 50) * var(dopas[, "b"])  # całkowita wariancja (Rubin)
hip_mi <- wiersz(mean(dopas[, "b"]), sqrt(Tcal))

# 3. Złożona (odpowiedź): HbA1c < 7% w 24. tyg. BEZ leczenia ratunkowego; różnica odsetków
odp <- d$t24 < 7 & !d$ratunek
p1 <- mean(odp[d$ramie == 1]); p0 <- mean(odp[d$ramie == 0])
zl_odp <- wiersz(p1 - p0, sqrt(p1 * (1 - p1) / 200 + p0 * (1 - p0) / 200))
cat("Odsetek odpowiedzi: lek", round(p1, 3), " placebo", round(p0, 3), "\n")

# 4. Złożona (rangowa): ratunek po 8. tyg. < ratunek po 16. tyg. < brak ratunku (wtedy niższe HbA1c lepsze)
w <- wynik_rangowy(d)
pp <- p_przewagi(w, d$ramie)
test_r <- wilcox.test(w[d$ramie == 1], w[d$ramie == 0], exact = FALSE)
set.seed(3554)                                         # bootstrap w obrębie ramion, 2000 powtórzeń
pp_boot <- replicate(2000, { i <- c(sample(which(d$ramie == 0), replace = TRUE), sample(which(d$ramie == 1), replace = TRUE))
                             p_przewagi(w[i], d$ramie[i]) })
cat("Złożona rangowa: P(lek lepszy) =", round(pp, 3), " 95% CI (bootstrap percentylowy)",
    round(quantile(pp_boot, c(.025, .975), names = FALSE), 3), " test Wilcoxona p =", signif(test_r$p.value, 3), "\n")

# 5. Bez estymandy: analiza tylko pacjentów bez leczenia ratunkowego
m_bez <- lm(t24 ~ ramie + hba1c_0, data = d, subset = !ratunek)
bez <- wiersz(coef(m_bez)[["ramie"]], sqrt(vcov(m_bez)["ramie", "ramie"]))

wyniki <- rbind(polityka_leczenia = pl, hipotetyczna_MMRM = hip_mmrm, hipotetyczna_MI = hip_mi,
                zlozona_odpowiedz = zl_odp, tylko_bez_ratunku = bez)
wyniki <- cbind(round(wyniki, 3),
                prawda = round(c(prawda[c("polityka_leczenia", "hipotetyczna", "hipotetyczna",
                                          "zlozona_odpowiedz")], NA), 3))   # analiza 5 nie ma estymandy
wyniki
write.csv(rbind(data.frame(analiza = rownames(wyniki), wyniki),   # do rysunku 2 dopisujemy wynik rangowy
                data.frame(analiza = "zlozona_rangowa", oszacowanie = pp, dolna = quantile(pp_boot, .025, names = FALSE),
                           gorna = quantile(pp_boot, .975, names = FALSE), prawda = prawda[["zlozona_rangowa"]])),
          "wyniki-strategii.csv", row.names = FALSE)
Wynik w R
Obserwacje w MMRM: 984 z 1200
Odsetek odpowiedzi: lek 0.33  placebo 0.14
Złożona rangowa: P(lek lepszy) = 0.638  95% CI (bootstrap percentylowy) 0.586 0.69  test Wilcoxona p = 1.45e-06
                  oszacowanie  dolna  gorna prawda
polityka_leczenia      -0.599 -0.721 -0.476 -0.611
hipotetyczna_MMRM      -0.711 -0.845 -0.577 -0.751
hipotetyczna_MI        -0.703 -0.858 -0.548 -0.751
zlozona_odpowiedz       0.190  0.109  0.271  0.247
tylko_bez_ratunku      -0.655 -0.792 -0.518     NA
3. Monte Carlo: który estymator trafia w którą estymandę
R
# Krok 3. Monte Carlo: czy każdy estymator trafia we własną estymandę? (500 badań po 2 × 200 osób)
# Korzysta z generuj_badanie(), wynik_rangowy(), p_przewagi() i prawda z kroku 1 oraz pakietu nlme z kroku 2.
jedno_badanie <- function() {
  d <- generuj_badanie(200); rat <- !is.na(d$ratunek_od)
  b_se <- function(m, nazwa = "ramie") c(coef(m)[[nazwa]], sqrt(vcov(m)[nazwa, nazwa]))
  y16 <- ifelse(rat & d$ratunek_od <= 2, NA, d$t16); y24 <- ifelse(rat, NA, d$t24)
  dl <- data.frame(id = rep(d$id, 3), ramie = rep(d$ramie, 3), hba1c_0 = rep(d$hba1c_0, 3),
                   wizyta = rep(1:3, each = nrow(d)), y = c(d$t8, y16, y24))
  dl$tydz <- factor(dl$wizyta, levels = c(3, 1, 2))
  mm <- gls(y ~ tydz * (ramie + hba1c_0), data = dl, na.action = na.omit,
            correlation = corSymm(form = ~ wizyta | id), weights = varIdent(form = ~ 1 | wizyta))
  odp <- d$t24 < 7 & !rat; p1 <- mean(odp[d$ramie == 1]); p0 <- mean(odp[d$ramie == 0])
  c(b_se(lm(t24 ~ ramie + hba1c_0, data = d)), b_se(mm),
    p1 - p0, sqrt(p1 * (1 - p1) / 200 + p0 * (1 - p0) / 200),
    b_se(lm(t24 ~ ramie + hba1c_0, data = d, subset = !rat)),
    p_przewagi(wynik_rangowy(d), d$ramie))
}
set.seed(3553)
R <- 500
mc <- t(replicate(R, jedno_badanie()))
nazwy <- c("polityka_leczenia", "hipotetyczna_MMRM", "zlozona_odpowiedz", "tylko_bez_ratunku")
cel <- prawda[c("polityka_leczenia", "hipotetyczna", "zlozona_odpowiedz", "hipotetyczna")]
podsum <- t(sapply(1:4, function(j) {
  b <- mc[, 2 * j - 1]; se <- mc[, 2 * j]
  c(cel = cel[[j]], srednia = mean(b), obciazenie = mean(b) - cel[[j]], SD = sd(b), sredni_SE = mean(se),
    pokrycie = mean(abs(b - cel[[j]]) <= qnorm(.975) * se))
}))
rownames(podsum) <- nazwy
cat("Analizę 'tylko_bez_ratunku' porównano z estymandą hipotetyczną, bo tak bywa interpretowana.\n")
round(podsum, 3)
cat("Złożona rangowa: prawda", round(prawda[["zlozona_rangowa"]], 3), " średnia", round(mean(mc[, 9]), 3),
    " SD", round(sd(mc[, 9]), 3), "\n")
cat("Błąd Monte Carlo średniej (MMRM):", round(sd(mc[, 3]) / sqrt(R), 4), "\n")
cat("Odsetek badań, w których polityka leczenia < hipotetyczna co do wartości bezwzględnej:",
    mean(abs(mc[, 1]) < abs(mc[, 3])), "\n")
write.csv(data.frame(analiza = rep(nazwy, each = R), b = c(mc[, c(1, 3, 5, 7)]), se = c(mc[, c(2, 4, 6, 8)])),
          "mc-strategie.csv", row.names = FALSE)
Wynik w R
Analizę 'tylko_bez_ratunku' porównano z estymandą hipotetyczną, bo tak bywa interpretowana.
                     cel srednia obciazenie    SD sredni_SE pokrycie
polityka_leczenia -0.611  -0.610      0.001 0.062     0.063    0.954
hipotetyczna_MMRM -0.751  -0.752     -0.001 0.073     0.072    0.944
zlozona_odpowiedz  0.247   0.247      0.000 0.041     0.042    0.958
tylko_bez_ratunku -0.751  -0.694      0.057 0.072     0.073    0.890
Złożona rangowa: prawda 0.663  średnia 0.664  SD 0.027
Błąd Monte Carlo średniej (MMRM): 0.0032
Odsetek badań, w których polityka leczenia < hipotetyczna co do wartości bezwzględnej: 0.996
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (modele lm() i wilcox.test() z pakietu stats) z pakietami nlme i mice; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Analiza ITT” zamiast estymandy. ITT określa populację, ale nie mówi, co zrobić z pomiarem po ratunku.
- Kończenie obserwacji po przerwaniu leczenia. Bez tych pomiarów strategia polityki leczenia opiera się na nieweryfikowalnej imputacji.
- Usunięcie pacjentów ze zdarzeniem. Wynik nie odpowiada żadnej estymandzie, a w przykładzie przekłamał efekt hipotetyczny.
- Jedna strategia dla wszystkich zdarzeń bez uzasadnienia. Ratunek, przerwanie z powodu działań niepożądanych i zgon zwykle wymagają różnych strategii.
- Analiza wrażliwości z innym pytaniem. Zmieniaj założenia estymatora, nie estymandę.
- Estymanda tylko w statystycznej części protokołu. Strategie zmieniają zbieranie danych, więc ustal je z zespołem klinicznym przed rozpoczęciem badania.
Najczęstsze pytania
Czym jest zdarzenie współwystępujące w badaniu klinicznym?
To zdarzenie po randomizacji, które zmienia interpretację wyniku albo sprawia, że wyniku nie ma: przerwanie leczenia, leczenie ratunkowe, zmiana leku, zgon. Nie jest brakiem danych – pacjent po ratunku zwykle ma pomiar, tylko trzeba z góry ustalić, czy i jak go użyć.
Czy analiza ITT to to samo co strategia polityki leczenia?
Nie do końca. ITT mówi, kogo analizujesz – wszystkich zrandomizowanych w przydzielonych grupach. Strategia polityki leczenia mówi dodatkowo, że wynik po zdarzeniu, np. po leczeniu ratunkowym, wchodzi do analizy taki, jaki jest. Wymaga to zbierania pomiarów także po przerwaniu leczenia.
Jak oszacować estymandę hipotetyczną?
Usuwa się pomiary po zdarzeniu i modeluje, jak przebiegałby wynik bez niego, zwykle modelem dla pomiarów powtarzanych (MMRM) albo imputacją wielokrotną przy założeniu MAR. W przykładzie MMRM dał −0.711, a imputacja −0.703 punktu procentowego przy prawdziwej wartości −0.751. Założenie MAR trzeba sprawdzić analizą wrażliwości.
Dlaczego nie wystarczy usunąć pacjentów z leczeniem ratunkowym?
Bo usuwasz pacjentów o gorszym przebiegu, częściej z placebo, i ramiona przestają być porównywalne. W 500 symulowanych badaniach taka analiza dała średnio −0.694, czyli wynik między estymandą polityki leczenia (−0.611) a hipotetyczną (−0.751), a pokrycie 95% przedziału dla estymandy hipotetycznej spadło do .890.
Co powinien zawierać opis estymandy w protokole?
Pięć atrybutów: populację, porównywane warunki leczenia, punkt końcowy, miarę podsumowującą i strategię dla każdego rodzaju zdarzeń współwystępujących. Do tego estymator z jego założeniami i analizę wrażliwości, która zmienia założenia, ale nie zmienia pytania.
Powiązane hasła
Przeczytaj też
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikEmulacja badania docelowego krok po kroku
Tabela protokołu, punkt zero, klonowanie–cenzurowanie–ważenie i ważone krzywe przeżycia w R – na kohorcie, w której znamy prawdziwy efekt.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Piszesz protokół badania klinicznego i nie wiesz, jak potraktować leczenie ratunkowe?
Pomożemy sformułować estymandę z pięcioma atrybutami, dobrać do niej estymator i analizę wrażliwości oraz przygotować opis, który obronisz przed komisją i recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Carpenter, J. R., Roger, J. H., & Kenward, M. G. (2013). Analysis of longitudinal trials with protocol deviation: A framework for relevant, accessible assumptions, and inference via multiple imputation. Journal of Biopharmaceutical Statistics, 23(6), 1352–1371. https://doi.org/10.1080/10543406.2013.834911
- Clark, T. P., Kahan, B. C., Phillips, A., White, I., & Carpenter, J. R. (2022). Estimands: Bringing clarity and focus to research questions in clinical trials. BMJ Open, 12(1), Article e052953. https://doi.org/10.1136/bmjopen-2021-052953 ● Otwarty dostęp
- Cro, S., Kahan, B. C., Rehal, S., Chis Ster, A., Carpenter, J. R., White, I. R., & Cornelius, V. R. (2022). Evaluating how clear the questions being investigated in randomised trials are: Systematic review of estimands. BMJ, 378, Article e070146. https://doi.org/10.1136/bmj-2022-070146 ● Otwarty dostęp
- International Council for Harmonisation. (2020). ICH E9 (R1) addendum on estimands and sensitivity analysis in clinical trials to the guideline on statistical principles for clinical trials (EMA/CHMP/ICH/436221/2017). European Medicines Agency. https://www.ema.europa.eu/en/ich-e9-statistical-principles-clinical-trials-scientific-guideline ● Otwarty dostęp
- Kahan, B. C., Hindley, J., Edwards, M., Cro, S., & Morris, T. P. (2024). The estimands framework: A primer on the ICH E9(R1) addendum. BMJ, 384, Article e076316. https://doi.org/10.1136/bmj-2023-076316 ● Otwarty dostęp
- Kahan, B. C., Morris, T. P., White, I. R., Carpenter, J., & Cro, S. (2021). Estimands in published protocols of randomised trials: Urgent improvement needed. Trials, 22(1), Article 686. https://doi.org/10.1186/s13063-021-05644-4 ● Otwarty dostęp
- Lipkovich, I., Ratitch, B., & Mallinckrodt, C. H. (2020). Causal inference and estimands in clinical trials. Statistics in Biopharmaceutical Research, 12(1), 54–67. https://doi.org/10.1080/19466315.2019.1697739
- Mallinckrodt, C. H., Bell, J., Liu, G., Ratitch, B., O’Kelly, M., Lipkovich, I., Singh, P., Xu, L., & Molenberghs, G. (2020). Aligning estimators with estimands in clinical trials: Putting the ICH E9(R1) guidelines into practice. Therapeutic Innovation & Regulatory Science, 54(2), 353–364. https://doi.org/10.1007/s43441-019-00063-9
Cytowania BibTeX
@article{carpenter2013analysis, author={Carpenter, James R. and Roger, James H. and Kenward, Michael G.}, title={{Analysis of longitudinal trials with protocol deviation: A framework for relevant, accessible assumptions, and inference via multiple imputation}}, journal={Journal of Biopharmaceutical Statistics}, year={2013}, volume={23}, number={6}, pages={1352--1371}, doi={10.1080/10543406.2013.834911}}@article{clark2022estimands, author={Clark, Timothy Peter and Kahan, Brennan C. and Phillips, Alan and White, Ian and Carpenter, James R.}, title={{Estimands: Bringing clarity and focus to research questions in clinical trials}}, journal={BMJ Open}, year={2022}, volume={12}, number={1}, eid={e052953}, doi={10.1136/bmjopen-2021-052953}}@article{cro2022evaluating, author={Cro, Suzie and Kahan, Brennan C. and Rehal, Sunita and Chis Ster, Anca and Carpenter, James R. and White, Ian R. and Cornelius, Victoria R.}, title={{Evaluating how clear the questions being investigated in randomised trials are: Systematic review of estimands}}, journal={BMJ}, year={2022}, volume={378}, eid={e070146}, doi={10.1136/bmj-2022-070146}}@techreport{ich2020e9r1, author={{International Council for Harmonisation}}, title={{ICH E9 (R1) addendum on estimands and sensitivity analysis in clinical trials to the guideline on statistical principles for clinical trials (EMA/CHMP/ICH/436221/2017)}}, year={2020}, institution={European Medicines Agency}, url={https://www.ema.europa.eu/en/ich-e9-statistical-principles-clinical-trials-scientific-guideline}}@article{kahan2024estimands, author={Kahan, Brennan C. and Hindley, Joanna and Edwards, Mark and Cro, Suzie and Morris, Tim P.}, title={{The estimands framework: A primer on the ICH E9(R1) addendum}}, journal={BMJ}, year={2024}, volume={384}, eid={e076316}, doi={10.1136/bmj-2023-076316}}@article{kahan2021estimands, author={Kahan, Brennan C. and Morris, Tim P. and White, Ian R. and Carpenter, James and Cro, Suzie}, title={{Estimands in published protocols of randomised trials: Urgent improvement needed}}, journal={Trials}, year={2021}, volume={22}, number={1}, eid={686}, doi={10.1186/s13063-021-05644-4}}@article{lipkovich2020causal, author={Lipkovich, Ilya and Ratitch, Bohdana and Mallinckrodt, Craig H.}, title={{Causal inference and estimands in clinical trials}}, journal={Statistics in Biopharmaceutical Research}, year={2020}, volume={12}, number={1}, pages={54--67}, doi={10.1080/19466315.2019.1697739}}@article{mallinckrodt2020aligning, author={Mallinckrodt, C. H. and Bell, J. and Liu, G. and Ratitch, B. and O’Kelly, M. and Lipkovich, I. and Singh, P. and Xu, L. and Molenberghs, G.}, title={{Aligning estimators with estimands in clinical trials: Putting the ICH E9(R1) guidelines into practice}}, journal={Therapeutic Innovation \& Regulatory Science}, year={2020}, volume={54}, number={2}, pages={353--364}, doi={10.1007/s43441-019-00063-9}}