Gdy jeden wynik główny nie wystarcza
Badanie terapii depresji rzadko ma jeden wynik. Interesują nas objawy, ale też funkcjonowanie w pracy i domu, lęk, sen. Każdy z tych wyników ma zwolenników w zespole i w literaturze. Jeśli jednak każdy test wykonasz na poziomie α = .05, a za sukces uznasz istotność któregokolwiek z nich, ryzyko ogłoszenia działania terapii, która nie działa, rośnie z każdym wynikiem. To problem wielokrotnych porównań, tyle że w wersji, w której stawką jest główny wniosek badania.
Dmitrienko i D’Agostino (2013) opisują to jako typowy problem badań klinicznych z kilkoma celami: równoczesna ocena kilku wyników rodzi wielokrotność, a bez jej uwzględnienia wnioski statystyczne tracą wiarygodność. Bender i Lange (2001) dodają, że korekta jest potrzebna w badaniach konfirmacyjnych zawsze wtedy, gdy wyniki wielu testów składają się na jeden końcowy wniosek. Przegląd zwykłych poprawek (Bonferroni, Holm, Hochberg, FDR) znajdziesz we wpisie poprawki na wielokrotne porównania, a rozstrzygnięcie, kiedy poprawka jest w ogóle potrzebna – we wpisie czy muszę stosować poprawkę. Tutaj zajmujemy się czymś innym: jak zaplanować kolejność i hierarchię testów, żeby wyniki ważniejsze miały większą moc, a cała procedura nadal trzymała błąd I rodzaju.
Sześć strategii dla kilku wyników
Najpierw podziel wyniki na pierwszorzędowe i drugorzędowe. Wynik pierwszorzędowy (ang. primary outcome) odpowiada na główne pytanie i na nim opierasz liczebność próby. Wyniki drugorzędowe mają wspierać lub uszczegóławiać wniosek. Podział zapisz w rejestracji badania i w planie analizy statystycznej, zanim zobaczysz dane. Potem wybierz strategię testowania.
| Strategia | Zasada | Kiedy pasuje | Główne ryzyko |
|---|---|---|---|
| Jeden wynik pierwszorzędowy | Cały poziom α na jeden test; reszta to wyniki drugorzędowe, opisywane ostrożnie | Gdy jeden wynik naprawdę oddaje cel badania | Wybór „złego” wyniku; pokusa, by po fakcie awansować inny |
| Bonferroni lub Holm | Wszystkie wyniki w jednej rodzinie, α dzielone po równo | Wyniki równie ważne, bez naturalnej kolejności | Niska moc; hierarchia wyników jest ignorowana |
| Stała kolejność | Testy po kolei na pełnym α, stop przy pierwszym wyniku nieistotnym | Pewna kolejność ważności i mocy | Słaby wynik na początku blokuje wszystkie dalsze |
| Bramka (gatekeeping) | Rodzina drugorzędowa testowana dopiero po sukcesie w rodzinie pierwszorzędowej | Kilka wyników pierwszorzędowych i kilka drugorzędowych | Przy bramce szeregowej jeden nieudany wynik pierwszorzędowy zamyka całą rodzinę drugorzędową |
| Procedura graficzna | Wagi α na hipotezach i reguły przekazywania α po odrzuceniu | Złożona hierarchia, którą trzeba pokazać zespołowi i recenzentom | Trzeba ją zaprojektować i sprawdzić przed badaniem |
| Wynik złożony lub win ratio | Kilka składowych łączy się w jedną zmienną albo w porównanie par według hierarchii | Składowe o podobnej wadze lub o jasno ustalonej kolejności ważności | Efekt napędzany przez składową najmniej ważną |
Osobny przypadek to wyniki współpierwszorzędowe, z których każdy musi być istotny, żeby ogłosić sukces (np. objawy i funkcjonowanie jednocześnie). Wtedy poprawka nie jest potrzebna, bo warunek „wszystkie naraz” sam chroni przed fałszywym alarmem. Płacisz za to mocą: szansa, że istotne okażą się wszystkie wyniki, jest mniejsza niż szansa dla każdego z osobna.
Stała kolejność, bramki i procedura graficzna należą do jednej rodziny. Bretz i in. (2009) pokazują, że testy ze stałą kolejnością, procedury bramkowe i procedury typu fallback to sekwencyjnie odrzucające testy typu Bonferroniego. Opierają się na zasadzie testów domkniętych, więc formalnie wymagają określenia wielu hipotez przecięć, a przez to trudno je wytłumaczyć zespołowi. Autorzy zaproponowali więc zapis w postaci grafu: każda hipoteza to węzeł z wagą, a skierowane krawędzie mówią, gdzie trafia jej α po odrzuceniu. Bonferroni, Holm i stała kolejność to szczególne przypadki takiego grafu, co sprawdza kod niżej.
Przykład: jedno badanie, siedem decyzji
Symulowane badanie randomizowane porównuje terapię internetową z listą oczekujących, po 150 osób w grupie. Po 8 tygodniach mierzymy cztery wyniki, standaryzowane tak, że wyższy wynik oznacza lepszy stan, skorelowane wewnątrz osoby na poziomie .50. H1 (objawy depresji) i H2 (funkcjonowanie) to hipotezy pierwszorzędowe, H3 (lęk) i H4 (sen) – drugorzędowe. W populacji różnice wynoszą d = 0.35, 0.25, 0.30 i 0.20. Ziarno losowania wybraliśmy tak, żeby strategie dały różne decyzje. Jak często tak się dzieje, pokazuje symulacja w następnej sekcji.
| Hipoteza | Różnica (SD) | p | p Bonferroni | p Holm | p max-t | Odrzucają |
|---|---|---|---|---|---|---|
| H1: depresja | 0.33 | .005 | .022 | .016 | .019 | wszystkie strategie |
| H2: funkcjonowanie | 0.23 | .040 | .160 | .080 | .127 | bez korekty, stała kolejność, bramka, graficzna |
| H3: lęk | 0.36 | .002 | .008 | .008 | .007 | wszystkie strategie |
| H4: sen | 0.16 | .160 | .639 | .160 | .431 | żadna |
Bonferroni i Holm odrzucają H1 i H3, ale nie H2. Badanie ogłosiłoby więc efekt na lęk, czyli wynik drugorzędowy, a nie na funkcjonowanie, czyli wynik pierwszorzędowy. Hierarchii, którą zespół ustalił przed badaniem, ta decyzja nie odzwierciedla. Korekta parametryczna max-t z pakietu multcomp (Hothorn i in., 2008) uwzględnia korelację wyników. Jest więc nieco mniej zachowawcza od Bonferroniego (p = .019 zamiast .022 dla H1), ale tu nie zmienia decyzji.
Trzy strategie z hierarchią odrzucają H1, H2 i H3:
- Stała kolejność H1 → H2 → H3 → H4: H1 (p = .005), H2 (.040) i H3 (.002) przechodzą na pełnym α = .05, H4 (.160) zatrzymuje procedurę.
- Bramka szeregowa: Holm w rodzinie {H1, H2} odrzuca obie hipotezy (.005 ≤ .025, potem .040 ≤ .05). Bramka się otwiera i Holm w rodzinie {H3, H4} odrzuca H3.
- Procedura graficzna z rysunku 1 prowadzi do tych samych decyzji. Jej kroki opisuje następna sekcja.
Procedura graficzna krok po kroku
Graf z rysunku 1 to jedna z wielu możliwych konstrukcji, tu dobrana do naszego przykładu. Hipotezy pierwszorzędowe startują z α/2 = .025, drugorzędowe z zerem. Po odrzuceniu hipotezy pierwszorzędowej połowa jej α trafia do drugiej hipotezy pierwszorzędowej, a połowa do „jej” wyniku drugorzędowego. Hipoteza drugorzędowa po odrzuceniu oddaje całe α krzyżowo do drugiej pierwszorzędowej. Dzięki temu efekt na lęk może pomóc w teście funkcjonowania, a α nigdy nie „wycieka” poza graf.
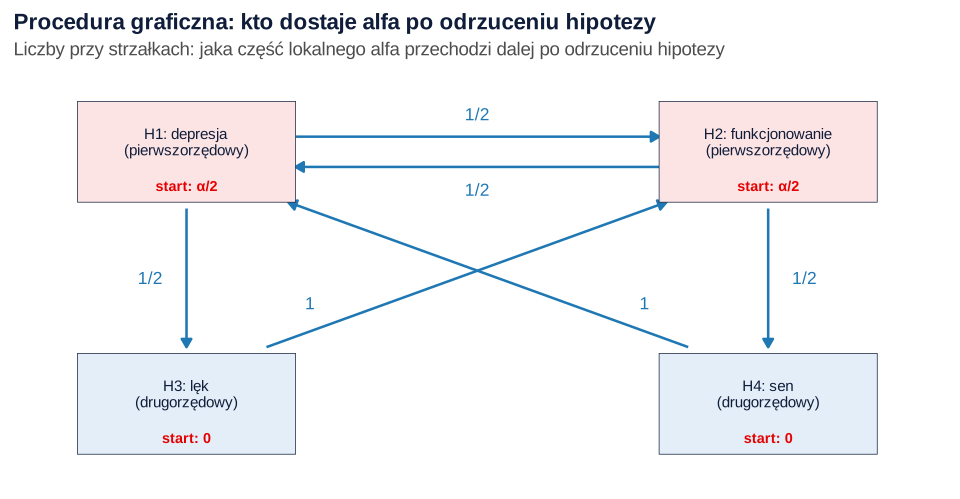
Algorytm jest prosty. Szukasz hipotezy, której p nie przekracza jej lokalnego α. Odrzucasz ją, przekazujesz jej α według krawędzi, przeliczasz krawędzie między pozostałymi hipotezami i powtarzasz krok. W przykładzie:
- H1: p = .0054 ≤ .025, więc odrzucamy H1. Lokalne α rośnie: H2 do .0375, H3 do .0125.
- H3: p = .0020 ≤ .0125, więc odrzucamy H3. Jej α trafia do H2, która ma teraz pełne .05.
- H2: p = .0400 ≤ .05, więc odrzucamy H2. H4 dostaje .025, ale p = .160, więc procedura się kończy.
Kolejność kroków nie zmienia końcowych decyzji. Liczy się to, że graf powstał przed zbieraniem danych. W protokole wystarczy rysunek z wagami i jedno zdanie o algorytmie. To dużo łatwiej sprawdzić niż listę kilkunastu hipotez przecięć (Bretz i in., 2009).
Symulacja: błąd I rodzaju i moc sześciu strategii
Pojedyncze badanie niczego nie dowodzi, więc ten sam schemat powtórzyliśmy 10 000 razy w sześciu scenariuszach (zasady planowania takich symulacji opisuje wpis jak zaplanować badanie symulacyjne). Mierzymy dwie rzeczy. FWER to odsetek badań z co najmniej jednym fałszywym odrzuceniem, czyli błędem I rodzaju w rodzinie. Druga miara to moc dla każdej hipotezy. Błąd Monte Carlo przy odsetku .05 wynosi około 0.002.
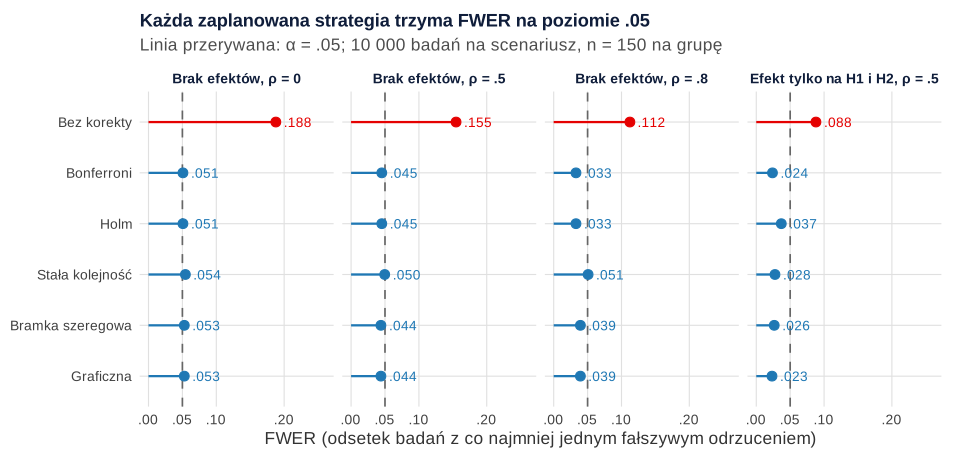
Bez korekty FWER wynosi .188 przy niezależnych wynikach i .155 przy korelacji .50. Przy korelacji .80 spada do .112, bo silnie skorelowane wyniki „mylą się” razem. Wszystkie pozostałe strategie trzymają poziom .05. Bonferroni i Holm stają się jednak zachowawcze przy silnej korelacji (.033 przy ρ = .80), a stała kolejność wykorzystuje α w całości (.050–.054). Gdy terapia działa tylko na H1 i H2, fałszywe odrzucenie H3 lub H4 zdarza się w 8.8% badań bez korekty i w 2.3–3.7% przy pozostałych strategiach.
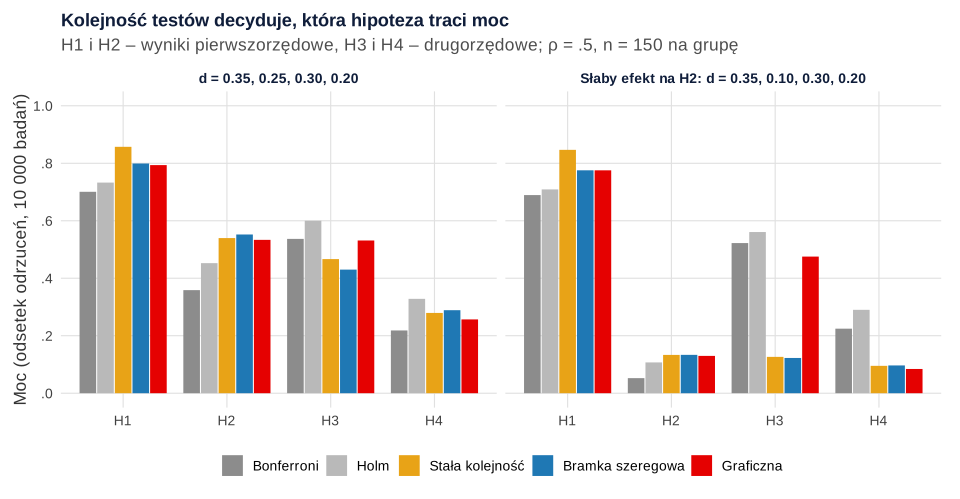
Moc pokazuje, że wybór strategii to wybór, którą hipotezę chronisz:
- Stała kolejność daje najwyższą moc dla H1 (.857 wobec .701 przy Bonferronim i .733 przy Holmie), bo testuje ją na pełnym α. Moc dla H2 rośnie z .359 (Bonferroni) do .540.
- Holm ma najwyższą moc dla wyników drugorzędowych (H3: .600, H4: .328). Wynika to stąd, że traktuje je na równi z pierwszorzędowymi.
- Bramka szeregowa i procedura graficzna dają wysoką moc dla H1 i H2 (.794–.799 i .533–.552). Graf zachowuje przy tym więcej mocy dla H3 (.531 wobec .430).
Najwięcej uczy scenariusz ze słabym efektem na H2 (d = 0.10). W stałej kolejności i bramce szeregowej H2 zwykle nie przechodzi, więc moc dla lęku spada do .126 i .123, choć efekt na lęk jest duży. Procedura graficzna przekazuje α z H1 bezpośrednio do H3 i zachowuje moc .475. Kolejność testów musi więc odzwierciedlać nie tylko ważność wyników, ale też realistyczne oczekiwania co do ich mocy.
Warto też ustalić, jaką moc planujesz. Bretz i in. (2011) omawiają różne miary mocy dla badań z kilkoma celami pierwszorzędowymi i drugorzędowymi. W przykładzie szansa odrzucenia co najmniej jednej fałszywej hipotezy wynosi .822 dla Bonferroniego, Holma, bramki i grafu, a .857 dla stałej kolejności. Szansa odrzucenia wszystkich czterech to tylko .112–.279. Jeśli sukces badania wymaga kilku wyników, licz liczebność dla tej drugiej miary, najlepiej symulacją.
Wynik złożony i win ratio
Zamiast testować kilka wyników, można je połączyć. Złożony punkt końcowy (np. „hospitalizacja lub zgon”) zwiększa liczbę zdarzeń i moc, ale efekt bywa napędzany przez składową najmniej ważną. Freemantle i in. (2003) znaleźli wśród badań ze złożonym wynikiem obejmującym zgon 36% takich, w których istotny był wynik złożony, ale nie śmiertelność. Raportowanie sugerowało przy tym, że wynik dotyczy poszczególnych składowych. Z tego samego powodu ostrożnie traktuj zastępcze punkty końcowe w roli składowych.
Pocock i in. (2012) zaproponowali win ratio, które respektuje hierarchię składowych. Każdą osobę z grupy leczonej porównuje się z osobą z grupy kontrolnej, najpierw na ważniejszej składowej. Dopiero gdy ta nie rozstrzyga, sięga się po następną. Win ratio to liczba „wygranych” podzielona przez liczbę „przegranych”. Gdy dopasowanie par jest niepraktyczne, można porównać wszystkie możliwe pary.
W naszym przykładzie (dane symulowane, po 150 osób) poziom 1 to hospitalizacja psychiatryczna w ciągu 6 miesięcy: 12% w grupie kontrolnej i 6% w grupie terapii. Poziom 2 to zmiana objawów, przy czym wygrana wymaga poprawy większej o co najmniej 3 punkty. Średnia zmiana wyniosła −2.70 i −5.13 punktu. Z 22 500 par terapia wygrała 52.2%, przegrała 27.0%, a 20.8% to remisy. Win ratio = 1.93, 95% CI [1.40, 2.72] (bootstrap percentylowy). Tylko 21.6% wygranych rozstrzygnęła jednak hospitalizacja. Resztę rozstrzygnęła zmiana objawów. Hierarchia nie chroni więc przed tym, że wynik zależy głównie od składowej mniej ważnej, ale częstszej. Dlatego zawsze raportuj, na którym poziomie zapadły rozstrzygnięcia, i podawaj składowe osobno. Bootstrap losuje tu osoby osobno w każdej grupie, bo pary nie są niezależne.
Jak opisać strategię w protokole i w artykule
Strategię opisz w protokole i w planie analizy statystycznej przed odślepieniem danych. Lista CONSORT wymaga wskazania wyniku pierwszorzędowego i drugorzędowych (zob. STROBE, CONSORT i TRIPOD). Każdy wynik powinien mieć też jasno opisany efekt, który szacujesz – tę część rozwija wpis o estymandzie w badaniu klinicznym. Gdy wynik w podgrupach ma być osobnym wnioskiem, i on należy do strategii wielokrotności (zob. analiza podgrup – kiedy jej wierzyć). Podaj hipotezy, ich podział na rodziny, wagi, kolejność lub graf, kontrolowany wskaźnik błędu i sposób liczenia mocy.
W wynikach podawaj nieskorygowane p razem z lokalnym α, przy którym podjęto decyzję, oraz przedziały ufności dla wszystkich wyników. Wyniki spoza strategii opisuj jako eksploracyjne. Nie zaliczaj do niej wyniku, który „wyszedł” po fakcie.
Przykład w R
Trzy przepisy odtwarzają wszystkie liczby z tekstu, tabel i rysunków. Przepis 2 korzysta z funkcji z przepisu 1, więc uruchom je po kolei w jednej sesji R; przepis 3 jest niezależny. Potrzebne pakiety: MASS, multcomp i boot.
1. Jedno badanie: poprawki, max-t, stała kolejność, bramka i graf
R
# Krok 1. Jedno badanie, cztery wyniki, brak korekty i sześć strategii testowania (dane symulowane)
# RCT: terapia internetowa vs lista oczekujących, po 150 osób; cztery wyniki po 8 tygodniach,
# standaryzowane tak, że wyższy wynik = lepszy stan. Korelacja wyników wewnątrz osoby .50.
# Hipotezy: H1 – objawy depresji (pierwszorzędowy), H2 – funkcjonowanie (pierwszorzędowy),
#           H3 – lęk (drugorzędowy, związany z H1), H4 – sen (drugorzędowy, związany z H2).
suppressPackageStartupMessages({ library(MASS); library(multcomp) })

n <- 150; alfa <- .05; rho <- .50
nazwy <- c("H1_depresja", "H2_funkcjonowanie", "H3_lek", "H4_sen")
S <- matrix(rho, 4, 4); diag(S) <- 1
d_pop <- c(0.35, 0.25, 0.30, 0.20)                    # prawdziwe różnice (d) w populacji

set.seed(3562)
kontrola <- mvrnorm(n, mu = rep(0, 4), Sigma = S)
terapia <- mvrnorm(n, mu = d_pop, Sigma = S)
dane <- data.frame(grupa = factor(rep(c("kontrola", "terapia"), each = n)), rbind(kontrola, terapia))
names(dane)[2:5] <- nazwy

# Testy t dla każdego wyniku (dwustronne, równe wariancje jak w modelu liniowym)
wyniki <- t(sapply(nazwy, function(v) {
  tt <- t.test(dane[[v]] ~ dane$grupa, var.equal = TRUE)
  c(roznica = unname(diff(tt$estimate)), t = -unname(tt$statistic), p = tt$p.value)
}))
round(wyniki, 4)
p <- wyniki[, "p"]

# a) Bez korekty, Bonferroni i Holm (wszystkie cztery hipotezy w jednej rodzinie)
p_adj <- cbind(surowe = p, bonferroni = p.adjust(p, "bonferroni"), holm = p.adjust(p, "holm"))
round(p_adj, 4)

# b) Korekta parametryczna max-t (multcomp): uwzględnia korelację wyników
modele <- lapply(nazwy, function(v) lm(reformulate("grupa", v), data = dane))
names(modele) <- nazwy
mm <- glht(do.call(mmm, modele), mlf("grupaterapia = 0"))
p_maxt <- summary(mm)$test$pvalues
round(setNames(as.numeric(p_maxt), nazwy), 4)

# c) Procedura graficzna (Bretz i in., 2009): wagi startowe w i macierz przejść G
graf_test <- function(p, w, G, alfa = .05, slad = FALSE) {
  m <- length(p); odrzuc <- rep(FALSE, m); aktywne <- rep(TRUE, m)
  repeat {
    kand <- which(aktywne & p <= w * alfa)
    if (!length(kand)) break
    j <- kand[which.min(p[kand] / w[kand])]
    if (slad) cat(sprintf("odrzucam %s: %.4f <= %.4f; ", names(p)[j], p[j], w[j] * alfa))
    odrzuc[j] <- TRUE; aktywne[j] <- FALSE
    w_nowe <- w; G_nowe <- G * 0
    for (l in which(aktywne)) {
      w_nowe[l] <- w[l] + w[j] * G[j, l]
      for (k in which(aktywne)) if (k != l) {
        mian <- 1 - G[l, j] * G[j, k]
        G_nowe[l, k] <- if (mian > 0) (G[l, k] + G[l, j] * G[j, k]) / mian else 0
      }
    }
    w <- w_nowe; w[j] <- 0; G <- G_nowe
    if (slad) cat("nowe lokalne alfa:", paste(sprintf("%.4f", w[aktywne] * alfa), collapse = " "), "\n")
  }
  setNames(odrzuc, names(p))
}
# Graf: H1 i H2 startują z alfa/2; po odrzuceniu połowa alfa idzie do drugiego wyniku
# pierwszorzędowego, połowa do „jego” wyniku drugorzędowego; H3 i H4 oddają całość krzyżowo.
w_graf <- c(.5, .5, 0, 0)
G_graf <- rbind(c(0, .5, .5, 0),
                c(.5, 0, 0, .5),
                c(0, 1, 0, 0),
                c(1, 0, 0, 0))
dimnames(G_graf) <- list(nazwy, nazwy)
G_graf
odrz_graf <- graf_test(p, w_graf, G_graf, slad = TRUE)

# d) Stała kolejność H1 -> H2 -> H3 -> H4: każdy test na pełnym alfa, stop przy pierwszym p > alfa
stala_kolejnosc <- function(p, alfa = .05) cumprod(p <= alfa) == 1
# e) Bramka szeregowa: Holm w rodzinie {H1, H2}; {H3, H4} (Holm) tylko gdy odrzucono obie
bramka_szeregowa <- function(p, alfa = .05) {
  pierw <- p.adjust(p[1:2], "holm") <= alfa
  drug <- if (all(pierw)) p.adjust(p[3:4], "holm") <= alfa else c(FALSE, FALSE)
  c(pierw, drug)
}

decyzje <- data.frame(bez_korekty = p <= alfa, bonferroni = p_adj[, 2] <= alfa,
                      holm = p_adj[, 3] <= alfa, max_t = as.numeric(p_maxt) <= alfa,
                      stala_kolejnosc = stala_kolejnosc(p), bramka_szeregowa = bramka_szeregowa(p),
                      graficzna = odrz_graf, row.names = nazwy)
decyzje
colSums(decyzje)

# Sprawdzenie: graf bez krawędzi = Bonferroni, graf pełny o równych wagach = Holm,
# łańcuch o wadze 1 = stała kolejność
c(bonf = all(graf_test(p, rep(.25, 4), matrix(0, 4, 4)) == decyzje$bonferroni),
  holm = all(graf_test(p, rep(.25, 4), (1 - diag(4)) / 3) == decyzje$holm),
  kolejnosc = all(graf_test(p, c(1, 0, 0, 0), rbind(c(0, 1, 0, 0), c(0, 0, 1, 0), c(0, 0, 0, 1), 0)) ==
                  decyzje$stala_kolejnosc))
Wynik w R
                  roznica      t      p
H1_depresja        0.3262 2.8004 0.0054
H2_funkcjonowanie  0.2323 2.0633 0.0400
H3_lek             0.3646 3.1209 0.0020
H4_sen             0.1630 1.4092 0.1598
                  surowe bonferroni   holm
H1_depresja       0.0054     0.0217 0.0163
H2_funkcjonowanie 0.0400     0.1598 0.0799
H3_lek            0.0020     0.0079 0.0079
H4_sen            0.1598     0.6393 0.1598
      H1_depresja H2_funkcjonowanie            H3_lek            H4_sen
           0.0187            0.1267            0.0069            0.4311
                  H1_depresja H2_funkcjonowanie H3_lek H4_sen
H1_depresja               0.0               0.5    0.5    0.0
H2_funkcjonowanie         0.5               0.0    0.0    0.5
H3_lek                    0.0               1.0    0.0    0.0
H4_sen                    1.0               0.0    0.0    0.0
odrzucam H1_depresja: 0.0054 <= 0.0250; nowe lokalne alfa: 0.0375 0.0125 0.0000
odrzucam H3_lek: 0.0020 <= 0.0125; nowe lokalne alfa: 0.0500 0.0000
odrzucam H2_funkcjonowanie: 0.0400 <= 0.0500; nowe lokalne alfa: 0.0250
                  bez_korekty bonferroni  holm max_t stala_kolejnosc
H1_depresja              TRUE       TRUE  TRUE  TRUE            TRUE
H2_funkcjonowanie        TRUE      FALSE FALSE FALSE            TRUE
H3_lek                   TRUE       TRUE  TRUE  TRUE            TRUE
H4_sen                  FALSE      FALSE FALSE FALSE           FALSE
                  bramka_szeregowa graficzna
H1_depresja                   TRUE      TRUE
H2_funkcjonowanie             TRUE      TRUE
H3_lek                        TRUE      TRUE
H4_sen                       FALSE     FALSE
     bez_korekty       bonferroni             holm            max_t
               3                2                2                2
 stala_kolejnosc bramka_szeregowa        graficzna
               3                3                3
     bonf      holm kolejnosc
     TRUE      TRUE      TRUE
2. Symulacja: FWER i moc sześciu strategii
R
# Krok 2. Symulacja: błąd I rodzaju (FWER) i moc sześciu strategii przy skorelowanych wynikach
# Korzysta z funkcji graf_test(), stala_kolejnosc(), bramka_szeregowa() oraz obiektów
# w_graf, G_graf, n i alfa z przepisu 1 (uruchom oba w jednej sesji R).
suppressPackageStartupMessages(library(MASS))

strategie <- function(p, alfa = .05) rbind(
  bez_korekty = p <= alfa,
  bonferroni = p.adjust(p, "bonferroni") <= alfa,
  holm = p.adjust(p, "holm") <= alfa,
  stala_kolejnosc = stala_kolejnosc(p, alfa),
  bramka_szeregowa = bramka_szeregowa(p, alfa),
  graficzna = graf_test(p, w_graf, G_graf, alfa))

symuluj <- function(d, rho, R = 10000, n = 150) {
  S <- matrix(rho, 4, 4); diag(S) <- 1
  prawdziwa_H0 <- d == 0
  wyn <- replicate(R, {
    k <- mvrnorm(n, rep(0, 4), S); t1 <- mvrnorm(n, d, S)
    sp <- sqrt((apply(k, 2, var) + apply(t1, 2, var)) / 2)       # wspólne SD (równe n)
    t_stat <- (colMeans(t1) - colMeans(k)) / (sp * sqrt(2 / n))
    p <- 2 * pt(-abs(t_stat), 2 * n - 2)
    o <- strategie(p)
    c(fwer = apply(o[, prawdziwa_H0, drop = FALSE], 1, any),
      moc_dowolna = apply(o[, !prawdziwa_H0, drop = FALSE], 1, any),
      moc_wszystkie = apply(o[, !prawdziwa_H0, drop = FALSE], 1, all),
      moc_H = o)                                                  # odrzucenia każdej hipotezy
  })
  rowMeans(wyn)
}

scenariusze <- list(
  globalna_H0_rho0  = list(d = c(0, 0, 0, 0), rho = 0),
  globalna_H0_rho05 = list(d = c(0, 0, 0, 0), rho = .5),
  globalna_H0_rho08 = list(d = c(0, 0, 0, 0), rho = .8),
  czesciowa_H0      = list(d = c(.35, .25, 0, 0), rho = .5),
  wszystkie_efekty  = list(d = c(.35, .25, .30, .20), rho = .5),
  slaby_H2          = list(d = c(.35, .10, .30, .20), rho = .5))

set.seed(3563)
sym <- lapply(scenariusze, function(s) symuluj(s$d, s$rho))
nazwy_s <- c("bez_korekty", "bonferroni", "holm", "stala_kolejnosc", "bramka_szeregowa", "graficzna")
tabela <- function(sc, miara) {
  x <- sym[[sc]]
  if (miara == "moc_H") matrix(x[grep("^moc_H", names(x))], 6, dimnames = list(nazwy_s, paste0("H", 1:4)))
  else setNames(x[grep(paste0("^", miara), names(x))], nazwy_s)
}

# a) FWER, gdy żadna terapia nie działa (globalna H0), przy trzech korelacjach wyników
fwer_glob <- sapply(c("globalna_H0_rho0", "globalna_H0_rho05", "globalna_H0_rho08"), tabela, miara = "fwer")
round(fwer_glob, 3)
# b) FWER, gdy działa tylko na wyniki pierwszorzędowe (H3 i H4 prawdziwe)
round(tabela("czesciowa_H0", "fwer"), 3)
# c) Moc dla każdej hipotezy, moc „co najmniej jedna” i „wszystkie”: wszystkie efekty prawdziwe
round(cbind(tabela("wszystkie_efekty", "moc_H"), dowolna = tabela("wszystkie_efekty", "moc_dowolna"),
            wszystkie = tabela("wszystkie_efekty", "moc_wszystkie")), 3)
# d) To samo, gdy efekt na funkcjonowanie (H2) jest słaby (d = 0.10)
round(cbind(tabela("slaby_H2", "moc_H"), dowolna = tabela("slaby_H2", "moc_dowolna")), 3)
round(c(odsetek_05 = sqrt(.05 * .95 / 10000), odsetek_50 = sqrt(.5 * .5 / 10000)), 4)   # błąd Monte Carlo

wyniki_sym <- do.call(rbind, lapply(names(sym), function(sc) {
  data.frame(scenariusz = sc, strategia = nazwy_s, fwer = tabela(sc, "fwer"),
             tabela(sc, "moc_H"), row.names = NULL)
}))
write.csv(wyniki_sym, "symulacja-strategii.csv", row.names = FALSE)
Wynik w R
                 globalna_H0_rho0 globalna_H0_rho05 globalna_H0_rho08
bez_korekty                 0.188             0.155             0.112
bonferroni                  0.051             0.045             0.033
holm                        0.051             0.045             0.033
stala_kolejnosc             0.054             0.050             0.051
bramka_szeregowa            0.053             0.044             0.039
graficzna                   0.053             0.044             0.039
     bez_korekty       bonferroni             holm  stala_kolejnosc
           0.088            0.024            0.037            0.028
bramka_szeregowa        graficzna
           0.026            0.023
                    H1    H2    H3    H4 dowolna wszystkie
bez_korekty      0.857 0.576 0.733 0.406   0.938     0.279
bonferroni       0.701 0.359 0.537 0.218   0.822     0.112
holm             0.733 0.452 0.600 0.328   0.822     0.258
stala_kolejnosc  0.857 0.540 0.467 0.279   0.857     0.279
bramka_szeregowa 0.799 0.552 0.430 0.289   0.822     0.273
graficzna        0.794 0.533 0.531 0.257   0.822     0.243
                    H1    H2    H3    H4 dowolna
bez_korekty      0.847 0.137 0.725 0.405   0.920
bonferroni       0.689 0.052 0.522 0.224   0.788
holm             0.709 0.107 0.561 0.290   0.788
stala_kolejnosc  0.847 0.133 0.126 0.095   0.847
bramka_szeregowa 0.775 0.133 0.123 0.097   0.776
graficzna        0.775 0.130 0.475 0.084   0.776
odsetek_05 odsetek_50
    0.0022     0.0050
3. Win ratio z przedziałem bootstrapowym
R
# Krok 3. Win ratio dla wyniku złożonego z hierarchią ważności (dane symulowane)
# Poziom 1 (ważniejszy): hospitalizacja psychiatryczna w ciągu 6 miesięcy (tak/nie).
# Poziom 2: zmiana objawów depresji w punktach (ujemna = poprawa); wygrana, gdy poprawa
# jest większa o co najmniej 3 punkty (próg ustalony z góry w tym przykładzie).
# Każda osoba z terapii jest porównana z każdą osobą z grupy kontrolnej (pary niedopasowane).
library(boot)

set.seed(3564)
n <- 150
dane_wr <- data.frame(grupa = rep(c("kontrola", "terapia"), each = n),
                      hosp = c(rbinom(n, 1, .10), rbinom(n, 1, .07)),
                      zmiana = round(c(rnorm(n, -3, 5), rnorm(n, -5, 5))))

porownaj <- function(d, prog = 3) {
  t1 <- d[d$grupa == "terapia", ]; k <- d[d$grupa == "kontrola", ]
  h <- outer(t1$hosp, k$hosp, "-")                     # −1: hospitalizacja tylko w kontroli
  z <- outer(t1$zmiana, k$zmiana, "-")                 # ujemna różnica: większa poprawa w terapii
  wygr1 <- h == -1; przegr1 <- h == 1
  wygr2 <- h == 0 & z <= -prog; przegr2 <- h == 0 & z >= prog
  c(wygrane = sum(wygr1) + sum(wygr2), przegrane = sum(przegr1) + sum(przegr2),
    remisy = sum(h == 0 & abs(z) < prog), wygrane_poz1 = sum(wygr1), przegrane_poz1 = sum(przegr1),
    win_ratio = (sum(wygr1) + sum(wygr2)) / (sum(przegr1) + sum(przegr2)))
}

# Składowe osobno
tapply(dane_wr$hosp, dane_wr$grupa, mean)
round(tapply(dane_wr$zmiana, dane_wr$grupa, mean), 2)
wr <- porownaj(dane_wr)
wr[1:5]                                                # liczby par spośród 150 × 150 = 22 500
round(c(win_ratio = wr[["win_ratio"]], odsetek_wygranych = wr[["wygrane"]] / n^2,
        odsetek_przegranych = wr[["przegrane"]] / n^2, odsetek_remisow = wr[["remisy"]] / n^2,
        udzial_poz1_w_wygranych = wr[["wygrane_poz1"]] / wr[["wygrane"]]), 3)

# Przedział ufności z bootstrapu (losowanie osób osobno w każdej grupie)
set.seed(3565)
b <- boot(dane_wr, function(d, i) porownaj(d[i, ])[["win_ratio"]], R = 2000,
          strata = factor(dane_wr$grupa))
round(setNames(c(b$t0, boot.ci(b, type = "perc")$percent[4:5]), c("win_ratio", "CI95_dolna", "CI95_gorna")), 2)
Wynik w R
Attaching package: ‘boot’

The following object is masked from ‘package:survival’:

    aml

kontrola  terapia
    0.12     0.06
kontrola  terapia
   -2.70    -5.13
       wygrane      przegrane         remisy   wygrane_poz1 przegrane_poz1
         11742           6085           4673           2538           1188
              win_ratio       odsetek_wygranych     odsetek_przegranych
                  1.930                   0.522                   0.270
        odsetek_remisow udzial_poz1_w_wygranych
                  0.208                   0.216
 win_ratio CI95_dolna CI95_gorna
      1.93       1.40       2.72
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje t.test() i p.adjust() z pakietu stats; skorelowane dane – mvrnorm() z pakietu MASS; korekta max-t – pakiet multcomp; bootstrap – pakiet boot); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- multcomp (wersja 1.4.30): Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Kilka wyników „pierwszorzędowych” bez strategii. Gdy każdy wynik testujesz na α = .05, a sukcesem jest dowolny z nich, przy czterech wynikach FWER sięga .155–.188.
- Holm tam, gdzie jest hierarchia. Równe traktowanie wyników może dać istotny wynik drugorzędowy przy nieistotnym pierwszorzędowym, jak H3 i H2 w przykładzie.
- Kolejność ustalona tylko według ważności. Słaby wynik na początku sekwencji zabiera moc wszystkim kolejnym. Sprawdź kolejność w symulacji z realistycznymi efektami.
- Zmiana kolejności lub grafu po odślepieniu. Taka zmiana unieważnia kontrolę błędu, tak jak p-hacking.
- Wynik złożony bez składowych. Raportuj każdą składową, a przy win ratio – na którym poziomie zapadły rozstrzygnięcia.
- Interpretacja wyniku po zatrzymaniu sekwencji. Hipotez za punktem zatrzymania nie odrzucono, więc ich p podawaj tylko opisowo.
Najczęstsze pytania
Czy przy dwóch wynikach pierwszorzędowych trzeba stosować poprawkę?
Tak, jeśli sukces badania ogłosisz, gdy istotny będzie którykolwiek z nich. Wtedy rozdziel α (np. po .025) albo użyj procedury, która przekazuje α po odrzuceniu pierwszej hipotezy. Poprawka nie jest potrzebna, gdy oba wyniki muszą być istotne jednocześnie, ale wtedy moc jest mniejsza niż dla każdego z osobna.
Na czym polega testowanie ze stałą kolejnością (fixed sequence)?
Hipotezy testujesz w kolejności ustalonej przed badaniem, każdą na pełnym poziomie α. Gdy któraś okaże się nieistotna, procedura się zatrzymuje i dalszych hipotez nie odrzucasz. W symulacji ten sposób dawał najwyższą moc dla pierwszej hipotezy (.857 wobec .701 przy Bonferronim), ale przy słabym efekcie na drugim miejscu moc dla kolejnych hipotez spadała do .126 i .095.
Czym jest gatekeeping w badaniu klinicznym?
To procedura bramkowa: rodzinę hipotez drugorzędowych testujesz dopiero wtedy, gdy uda się odrzucić hipotezy z rodziny pierwszorzędowej. Bramka szeregowa wymaga odrzucenia wszystkich hipotez pierwszorzędowych, bramka równoległa – przynajmniej jednej. Taką procedurę można zapisać jako graf z wagami α (Bretz i in., 2009).
Jak działa procedura graficzna Bretza?
Każda hipoteza ma początkową część α, a strzałki z wagami mówią, dokąd przechodzi jej α po odrzuceniu. Odrzucasz hipotezę, której p nie przekracza lokalnego α, przekazujesz jej α dalej i powtarzasz krok, dopóki da się coś odrzucić. Procedura kontroluje FWER, a Bonferroni, Holm i stała kolejność są jej szczególnymi przypadkami.
Co to jest win ratio i kiedy go użyć?
Win ratio porównuje pary osób z grupy leczonej i kontrolnej według hierarchii składowych: najpierw najważniejsza, a gdy ta nie rozstrzyga – następna. Wynik to liczba wygranych podzielona przez liczbę przegranych (Pocock i in., 2012). Pasuje do wyniku złożonego, ale zawsze podaj, na którym poziomie zapadły rozstrzygnięcia – w przykładzie hospitalizacja rozstrzygnęła tylko 21.6% wygranych.
Powiązane hasła
Przeczytaj też
Poprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikCzy muszę stosować poprawkę?
Kiedy poprawka na wielokrotne porównania jest potrzebna, a kiedy nie: rodzina testów, tabela tak/nie, przykład w R i wzór uzasadnienia w pracy.
Czytaj →PoradnikEstymanda w badaniu klinicznym (ICH E9)
Leczenie ratunkowe i inne zdarzenia współwystępujące: pięć strategii, MMRM, imputacja i wynik złożony w R oraz opis estymandy w protokole.
Czytaj →Twoje badanie ma kilka wyników głównych i nie wiesz, jak rozdzielić α?
Pomożemy dobrać strategię testowania, sprawdzić jej moc w symulacji i opisać ją w protokole tak, żebyś samodzielnie obronił(a) ją przed komisją etyczną i recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bender, R., & Lange, S. (2001). Adjusting for multiple testing—When and how? Journal of Clinical Epidemiology, 54(4), 343–349. https://doi.org/10.1016/S0895-4356(00)00314-0
- Bretz, F., Maurer, W., & Hommel, G. (2011). Test and power considerations for multiple endpoint analyses using sequentially rejective graphical procedures. Statistics in Medicine, 30(13), 1489–1501. https://doi.org/10.1002/sim.3988
- Bretz, F., Maurer, W., Brannath, W., & Posch, M. (2009). A graphical approach to sequentially rejective multiple test procedures. Statistics in Medicine, 28(4), 586–604. https://doi.org/10.1002/sim.3495
- Dmitrienko, A., & D’Agostino, R. (2013). Traditional multiplicity adjustment methods in clinical trials. Statistics in Medicine, 32(29), 5172–5218. https://doi.org/10.1002/sim.5990
- Freemantle, N., Calvert, M., Wood, J., Eastaugh, J., & Griffin, C. (2003). Composite outcomes in randomized trials: Greater precision but with greater uncertainty? JAMA, 289(19), 2554–2559. https://doi.org/10.1001/jama.289.19.2554
- Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425 ● Otwarty dostęp: pełny tekst
- Pocock, S. J., Ariti, C. A., Collier, T. J., & Wang, D. (2012). The win ratio: A new approach to the analysis of composite endpoints in clinical trials based on clinical priorities. European Heart Journal, 33(2), 176–182. https://doi.org/10.1093/eurheartj/ehr352
Cytowania BibTeX
@article{bender2001adjusting, author={Bender, Ralf and Lange, Stefan}, title={{Adjusting for multiple testing—When and how?}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={4}, pages={343--349}, doi={10.1016/s0895-4356(00)00314-0}}@article{bretz2011test, author={Bretz, Frank and Maurer, Willi and Hommel, Gerhard}, title={{Test and power considerations for multiple endpoint analyses using sequentially rejective graphical procedures}}, journal={Statistics in Medicine}, year={2011}, volume={30}, number={13}, pages={1489--1501}, doi={10.1002/sim.3988}}@article{bretz2009graphical, author={Bretz, Frank and Maurer, Willi and Brannath, Werner and Posch, Martin}, title={{A graphical approach to sequentially rejective multiple test procedures}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={4}, pages={586--604}, doi={10.1002/sim.3495}}@article{dmitrienko2013traditional, author={Dmitrienko, Alex and D'Agostino, Ralph}, title={{Traditional multiplicity adjustment methods in clinical trials}}, journal={Statistics in Medicine}, year={2013}, volume={32}, number={29}, pages={5172--5218}, doi={10.1002/sim.5990}}@article{freemantle2003composite, author={Freemantle, Nick and Calvert, Melanie and Wood, John and Eastaugh, Joanne and Griffin, Carl}, title={{Composite outcomes in randomized trials: Greater precision but with greater uncertainty?}}, journal={JAMA}, year={2003}, volume={289}, number={19}, pages={2554--2559}, doi={10.1001/jama.289.19.2554}}@article{hothorn2008simultaneous, author={Hothorn, Torsten and Bretz, Frank and Westfall, Peter}, title={{Simultaneous inference in general parametric models}}, journal={Biometrical Journal}, year={2008}, volume={50}, number={3}, pages={346--363}, doi={10.1002/bimj.200810425}}@article{pocock2012win, author={Pocock, Stuart J. and Ariti, Cono A. and Collier, Timothy J. and Wang, Duolao}, title={{The win ratio: A new approach to the analysis of composite endpoints in clinical trials based on clinical priorities}}, journal={European Heart Journal}, year={2012}, volume={33}, number={2}, pages={176--182}, doi={10.1093/eurheartj/ehr352}}