Analiza mocy w jamovi: moduł jpower
Analiza mocy a priori odpowiada na pytanie, ile osób trzeba zbadać, żeby test z dużym prawdopodobieństwem wykrył efekt, na którym Ci zależy. Czym jest moc testu i od czego zależy, wyjaśnia hasło w słowniku. Pięć decyzji przed obliczeniem (efekt, α, moc, plan, odpadanie) omawia poradnik dobór liczebności próby. Tutaj pokazujemy tylko, jak tę analizę zrobić w jamovi i jak czytać to, co program zwraca.
W jamovi służy do tego moduł jpower (jpower: Power Analysis for Common Research Designs), autorstwa Richarda D. Moreya i Raviego Selkera. Opisujemy wersję 0.1.3 – tę samą podaje plik opisu modułu w repozytorium i lista biblioteki modułów (Morey i Selker, b.d.; The jamovi project, b.d.). Moduł instalujesz przez Modules → jamovi library i jest dostępny od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.). Pierwsze kroki w programie opisuje wpis jamovi krok po kroku.
Nazwy menu, pól i tabel wzięliśmy z plików definicji analiz (.a.yaml, .r.yaml, .u.yaml) i z kodu modułu w repozytorium. Samego jpower nie uruchamialiśmy. Liczby policzyliśmy w R tymi samymi wzorami (niecentralny rozkład t, pakiet pwr), których moduł używa wewnętrznie. W polskiej wersji interfejsu nazwy mogą brzmieć inaczej. Analiza mocy nie potrzebuje danych, więc tym razem nie ma pliku do pobrania – wystarczy pusty arkusz.
Okno jpower krok po kroku
Po instalacji w menu Analyses pojawia się grupa Power, a w niej podgrupa jpower z trzema analizami: Independent Samples T-Test, Paired Samples T-Test i One Sample T-Test (Morey i Selker, b.d.). Okno testu dla prób niezależnych ma następujące pola:
- Calculate – co liczysz: N per group (liczebność, domyślnie), Power (moc przy danym N i efekcie) albo Effect size (najmniejszy efekt wykrywalny przy danym N i mocy). Pole, które jest liczone, staje się nieaktywne.
- Minimally-interesting effect size (δ) – najmniejszy interesujący efekt, domyślnie 0.5. To standaryzowana różnica średnich, czyli coś w rodzaju d Cohena w populacji.
- Minimum desired power – domyślnie 0.9, a nie 0.8, do którego przyzwyczajają podręczniki. Wartość 1 jest niedozwolona.
- N for group 1 – domyślnie 20; używane, gdy liczysz moc albo efekt.
- Relative size of group 2 to group 1 – stosunek N₂/N₁, domyślnie 1 (grupy równe).
- α (type I error rate) – domyślnie 0.05; okno podpowiada też 0.1, 0.01, 0.005 i 0.001.
- Tails – two-tailed albo one-tailed (consistent), czyli test jednostronny w kierunku zgodnym z hipotezą.
- Plots – Power contour plot i Power curve by effect size (domyślnie włączone), Power curve by N i Power demonstration. Additional Options → Explanatory text – teksty objaśniające, domyślnie włączone.
Okna Paired Samples T-Test i One Sample T-Test mają te same pola, tylko bez stosunku liczebności, a zamiast N for group 1 jest po prostu N (Morey i Selker, b.d.).
Skąd wziąć δ, zanim cokolwiek klikniesz
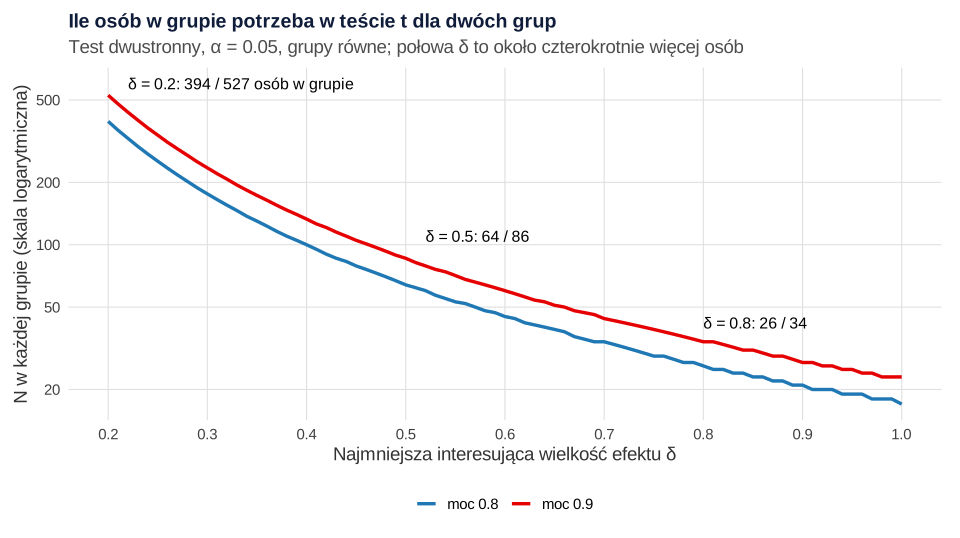
Wynik analizy mocy zależy przede wszystkim od δ. Na rysunku 2 widać, że połowa efektu oznacza mniej więcej czterokrotnie więcej osób. Etykieta pola mówi wprost, czego moduł oczekuje: najmniejszego efektu, który byłby dla Ciebie interesujący, a nie efektu, który „pewnie wyjdzie”. To jest najmniejszy interesujący efekt (SESOI).
- Literatura i metaanalizy – efekt z podobnych badań, najlepiej przeliczony na tę samą miarę. Jak czytać wielkości efektu, opisuje poradnik wielkość efektu – interpretacja.
- Pilotaż – ostrożnie. Efekt oszacowany w małym pilotażu jest niedokładny. Planowanie badania głównego tylko na jego podstawie daje zwykle zbyt małą moc (Albers i Lakens, 2018).
- Konwencja „0.2, 0.5, 0.8” – Cohen (1992) podał umowne wartości małego, średniego i dużego efektu dla sytuacji, w których nic więcej nie wiadomo. To ostateczność, a nie uzasadnienie. Domyślne 0.5 w oknie jpower to tylko wartość startowa.
Lakens (2022) przypomina, że uzasadnienie liczebności to coś więcej niż jedno obliczenie. Warto rozważyć najmniejszy interesujący efekt, efekty oczekiwane i zakres efektów, które badanie wykrywa z wystarczającą mocą (analiza wrażliwości). Wszystkie trzy policzysz w jpower, zmieniając pole Calculate.
Calculate: N per group – tabele wyników
Przykład jest fikcyjny. Planujesz porównanie dwóch grup (np. trening i grupa kontrolna) testem t dla prób niezależnych. Najmniejsza różnica, która miałaby znaczenie praktyczne, to pół odchylenia standardowego. Zostawiasz ustawienia domyślne: δ = 0.5, moc 0.9, α = 0.05, test dwustronny, grupy równe.
Na górze wyników jpower pokazuje krótki wstęp, a pod nim tabelę A Priori Power Analysis. Kolumna liczona stoi na początku. Wartości wpisane przez Ciebie są pod wspólnym nagłówkiem User Defined (Morey i Selker, b.d.).
| N₁ | N₂ | Effect Size | Power | α | ES for design to have 50% power |
|---|---|---|---|---|---|
| 86 | 86 | 0.500 | 0.900 | 0.050 | 0.301 |
Potrzeba 86 osób w każdej grupie, razem 172. Moduł zaokrągla liczebność w górę, więc rzeczywista moc przy 86 osobach to 0.903. Ostatnia kolumna mówi, przy jakim prawdziwym efekcie ten plan ma tylko 50% mocy: δ = 0.301. Mniejsze efekty badanie najpewniej przegapi.
Gdy tekst objaśniający jest włączony, pod tabelą pojawia się zdanie z wynikiem (po angielsku) i tabela Power by Effect Size. Moduł dzieli w niej możliwe prawdziwe efekty na cztery przedziały mocy z opisami słownymi (Morey i Selker, b.d.):
| True effect size | Power to detect | Description |
|---|---|---|
| 0 < δ ≤ 0.301 | ≤50% | Likely miss |
| 0.301 < δ ≤ 0.430 | 50% – 80% | Good chance of missing |
| 0.430 < δ ≤ 0.553 | 80% – 95% | Probably detect |
| δ ≥ 0.553 | ≥95% | Almost surely detect |
Ta tabela jest często ciekawsza niż samo N. Pokazuje, że plan „na 0.5” wykrywa z mocą co najmniej 80% efekty od 0.43 wzwyż, a efekty poniżej 0.30 najpewniej przegapi.
Calculate: Power i Effect size – gdy N jest z góry ustalone
Studenci często nie wybierają liczebności, tylko ją dostają: dwie grupy ćwiczeniowe po 40 osób. Wtedy pytanie „ile osób?” traci sens. Lepiej zapytać: jaką moc ma ten plan i jaki najmniejszy efekt wykrywa?
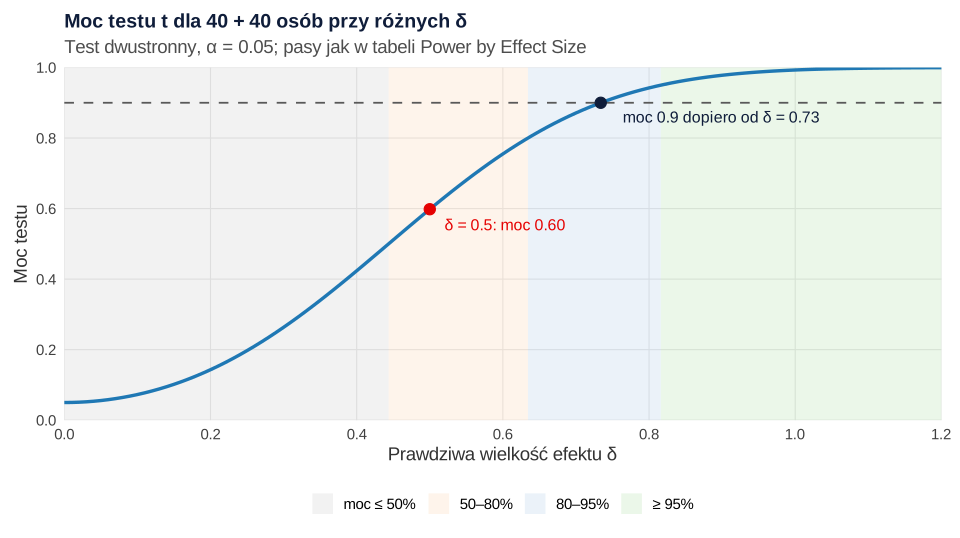
- Calculate → Power, N for group 1 = 40, δ = 0.5: moc wynosi 0.598. Ostatnia kolumna tabeli daje δ = 0.444 dla mocy 50%.
- Calculate → Effect size, N for group 1 = 40, moc 0.9: najmniejszy efekt wykrywalny to δ = 0.734, a przy mocy 0.8 – 0.634. Tabela Power by Effect Size ma progi 0.444, 0.634 i 0.816.
To jest analiza wrażliwości – zakres efektów, które badanie wykryje z wystarczającą mocą (Lakens, 2022). Na rysunku 1 widać, że przy 40 osobach w grupie efekt 0.5 ma mniej więcej takie same szanse na wykrycie jak rzut monetą z lekką przewagą. Podobny wykres daje opcja Power curve by effect size. Jest ona niedostępna, gdy liczysz N, bo wtedy liczebność nie jest jeszcze znana.
Do pracy taki wynik jest uczciwszy niż „moc obserwowana” liczona z własnych wyników po badaniu. Dlaczego ta druga nic nie wnosi, wyjaśnia wpis moc po fakcie – co podać zamiast.
Grupy nierówne i test jednostronny
Relative size of group 2 to group 1. Jeśli grupa kontrolna ma być dwa razy większa, wpisz 2. Przy δ = 0.5 i mocy 0.9 potrzeba wtedy 64 osób w grupie 1 i 128 w grupie 2, razem 192. Grupy równe dawały razem 172. Nierówny podział jest więc mniej oszczędny, ale bywa uzasadniony, np. gdy łatwiej zebrać jedną z grup.
Tails: one-tailed (consistent). Test jednostronny przy tych samych ustawieniach wymaga 70 osób w grupie zamiast 86. Wybierz go tylko wtedy, gdy kierunek hipotezy ustalono przed zebraniem danych i wynik w przeciwną stronę nie miałby znaczenia. Szczegóły: test jednostronny i dwustronny.
Rysunek 2 i tabela w kodzie R pokazują, jak potrzebne N zależy od δ. Przy δ = 0.2 to 394 osoby w grupie dla mocy 0.8 i 527 dla mocy 0.9. Przy δ = 0.8 – odpowiednio 26 i 34.
Paired Samples i One Sample: inne δ
W Paired Samples T-Test jpower liczy moc funkcją pwr.t.test z typem "paired" (Morey i Selker, b.d.). δ oznacza tu średnią różnic podzieloną przez odchylenie standardowe różnic, czyli dz, a N to liczba par. Przy domyślnych ustawieniach (δ = 0.5, moc 0.9) wychodzi 44 pary. Tabela A Priori Power Analysis ma tu kolumny N, Effect Size, Power i α, bez kolumny dla 50% mocy.
Pułapka: efekt z literatury jest zwykle podany w jednostkach odchylenia standardowego pomiaru (d), a nie różnic. Przy równych odchyleniach obu pomiarów dz = d / √(2(1 − r)), gdzie r to korelacja przed–po. Lakens (2013) szczegółowo omawia różnice między miarami efektu dla planów wewnątrz- i międzyosobowych. Dla d = 0.5 i mocy 0.9:
| Korelacja przed–po r | δ do wpisania w jpower (dz) | N par |
|---|---|---|
| .3 | 0.423 | 61 |
| .5 | 0.500 | 44 |
| .7 | 0.645 | 28 |
| .8 | 0.791 | 19 |
Jeśli wpiszesz d = 0.5 jako δ, a pomiary korelują na poziomie .7, przeszacujesz potrzebną próbę (44 zamiast 28 par). Jeśli korelacja jest niska, a przyjmiesz ją wysoką – niedoszacujesz. Korelację weź z wcześniejszych badań tym samym narzędziem i podaj ją w opisie. Przy 30 parach i dz = 0.5 moc wynosi 0.754, a najmniejszy efekt wykrywalny z mocą 0.9 to dz = 0.612. Porównanie planu z parami i planu z dwiema grupami pokazuje zadanie 8 w zbiorze moc testu i liczebność próby – zadania.
One Sample T-Test ma te same pola co analiza dla par, a w kodzie modułu dziedziczy po niej obliczenia (Morey i Selker, b.d.). δ to tu różnica między średnią a wartością odniesienia, podzielona przez SD. Przy δ = 0.5 i mocy 0.9 wynik jest ten sam: 44 osoby.
Wykresy i tekst objaśniający
Według definicji wyników jpower oferuje cztery wykresy (Morey i Selker, b.d.):
- Power Contour – mapa mocy dla kombinacji liczebności grupy 1 (oś pozioma) i hipotetycznego efektu δ (oś pionowa). Czarna linia łączy kombinacje N i δ, które dają wybraną moc, a punkt oznacza Twój plan.
- Power Curve by Effect Size – moc w funkcji δ przy ustalonym N (jak na rysunku 1). Niedostępna przy Calculate: N.
- Power Curve by N – moc w funkcji liczebności przy ustalonym δ. Niedostępna przy Calculate: Effect size.
- Power Demonstration – dwa rozkłady z próby oszacowanego efektu: gdy δ = 0 i gdy δ ma wpisaną wartość, z liniami przerywanymi w miejscu wartości krytycznych. To dobra ilustracja błędów I i II rodzaju na obronę.
Opcja Explanatory text dodaje pod tabelą i każdym wykresem akapit po angielsku. Moduł wstawia do niego Twoje liczby, np. że do wykrycia δ ≥ 0.5 z prawdopodobieństwem większym niż 0.9 potrzeba 86 osób w grupie przy dwustronnym kryterium i α = 0.05. Te teksty dobrze objaśniają wynik. Nie przeklejaj ich jednak do pracy po polsku słowo w słowo – lepiej napisać własne zdanie według wzoru niżej.
Czego jpower nie liczy
- Tylko testy t. README modułu mówi, że w wersji testowej zaimplementowano tylko testy t. Analiza ANOVA jest w kodzie, ale w opisie modułu oznaczona jako ukryta (Morey i Selker, b.d.). Mocy dla ANOVA, χ², regresji i interakcji 2 × 2 nie policzysz – służy do tego kalkulator mocy: ANOVA, χ², regresja albo R. Moc dla interakcji omawia osobny wpis moc testu dla interakcji.
- Klasyczny test t Studenta. Obliczenia zakładają równe wariancje w grupach. Nie ma wariantu dla testu Welcha ani testów nieparametrycznych.
- Bez poprawki na odpadanie. Wynik to liczba osób, które mają trafić do analizy. Zapas na braki doliczasz sam (zadanie 5 w zbiorze zadań).
- Bez planów złożonych. Losowanie całych klas, model mieszany czy pomiary wielokrotne wymagają symulacji – zob. analiza mocy dla modelu mieszanego i hasło o parametrze niecentralności i symulacyjnej analizie mocy.
- Precyzja zamiast mocy. Jeśli celem jest oszacowanie efektu z określoną dokładnością, a nie test, zob. liczebność próby z precyzji (AIPE).
Szerszy wybór testów ma m.in. program G*Power, opisany w haśle analiza mocy a priori (G*Power).
Opis analizy mocy w pracy
W Metodzie podaj test, δ wraz z uzasadnieniem, α, kierunek testu, moc, wynik i program z wersją modułu. Jeśli zakładasz odpadanie, podaj, ile osób rekrutujesz. Wzór do dostosowania:
Gdy liczebność była z góry ustalona, zamiast analizy a priori opisz analizę wrażliwości: „Przy 40 osobach w każdej grupie, α = .05 (test dwustronny) badanie miało moc 0.80 do wykrycia efektów δ ≥ 0.63 i moc 0.90 dla δ ≥ 0.73”. Opis samego wyniku testu t ułatwi generator opisu wyników APA, a test t w jamovi krok po kroku pokazuje wpis test t w jamovi.
Te same liczby w R (pwr i power.t.test)
Pakietu R z modułem jpower nie używamy. Liczby odtwarzamy tymi samymi wzorami. Dla prób niezależnych moduł szuka najmniejszego N, przy którym moc z niecentralnego rozkładu t osiąga zadaną wartość, i zaokrągla je w górę. Dla prób zależnych i jednej próby wywołuje pwr::pwr.t.test (Morey i Selker, b.d.). Kontrolnie podajemy wynik power.t.test z strict = TRUE. Bez tej opcji funkcja przy teście dwustronnym pomija drugi ogon i daje minimalnie inne liczby. Danych ani ziarna losowania nie potrzeba – obliczenia są dokładne.
1. Independent Samples T-Test: N, moc, najmniejszy efekt
R
# B558 – analiza mocy w jamovi (jpower): Independent Samples T-Test policzony w R
# jpower liczy moc z niecentralnego rozkładu t (pakiet pwr i własne funkcje modułu).
# Ustawienia jak domyślne w oknie jpower: Calculate = N per group, δ = 0.5, moc 0.9,
# α = 0.05, test dwustronny, stosunek liczebności N2/N1 = 1. Danych nie potrzeba.
suppressPackageStartupMessages(library(pwr))

# Moc testu t dla dwóch grup z niecentralnego rozkładu t (oba ogony)
moc_t2 <- function(n1, n2, d, alpha = .05, ogony = "two.sided") {
  df <- n1 + n2 - 2
  ncp <- d * sqrt(n1 * n2 / (n1 + n2))
  if (ogony == "two.sided") {
    kr <- qt(1 - alpha / 2, df)
    pt(kr, df, ncp, lower.tail = FALSE) + pt(-kr, df, ncp)
  } else {
    pt(qt(1 - alpha, df), df, ncp, lower.tail = FALSE)
  }
}
# Najmniejsze N1 (N2 = ceiling(ratio * N1)) dające co najmniej zadaną moc
n_dla_mocy <- function(d, moc = .9, alpha = .05, ratio = 1, ogony = "two.sided") {
  n1 <- 2
  while (moc_t2(n1, ceiling(ratio * n1), d, alpha, ogony) < moc) n1 <- n1 + 1
  c(N1 = n1, N2 = ceiling(ratio * n1))
}

# 1. Calculate: N per group (ustawienia domyślne)
n <- n_dla_mocy(d = 0.5, moc = .9)
print(n)
cat(sprintf("moc przy tych N: %.4f\n", moc_t2(n[1], n[2], 0.5)))
# kontrola: pwr::pwr.t.test i stats::power.t.test (strict = TRUE liczy oba ogony)
cat(sprintf("pwr.t.test: n = %.2f; power.t.test: n = %.2f\n",
            pwr.t.test(d = 0.5, power = .9, sig.level = .05)$n,
            power.t.test(delta = 0.5, sd = 1, power = .9, sig.level = .05, strict = TRUE)$n))

# Kolumna "ES for design to have 50% power" i tabela Power by Effect Size
d_dla <- function(moc, n1, n2) pwr.t2n.test(n1 = n1, n2 = n2, power = moc, sig.level = .05)$d
cat(sprintf("delta dla mocy 50%%, 80%%, 95%% przy N = %d + %d: %s\n", n[1], n[2],
            paste(sprintf("%.3f", sapply(c(.5, .8, .95), d_dla, n1 = n[1], n2 = n[2])), collapse = ", ")))

# 2. Calculate: Power – grupy po 40 osób, δ = 0.5
cat(sprintf("moc przy N = 40 + 40 i delta = 0.5: %.3f\n", moc_t2(40, 40, 0.5)))
cat(sprintf("delta dla mocy 50%% przy N = 40 + 40: %.3f\n", d_dla(.5, 40, 40)))

# 3. Calculate: Effect size – grupy po 40 osób, moc 0.9 i 0.8
cat(sprintf("najmniejsze delta przy N = 40 + 40: moc 0.9 -> %.3f; moc 0.8 -> %.3f\n",
            d_dla(.9, 40, 40), d_dla(.8, 40, 40)))
cat(sprintf("delta dla mocy 50%%, 80%%, 95%% przy N = 40 + 40: %s\n",
            paste(sprintf("%.3f", sapply(c(.5, .8, .95), d_dla, n1 = 40, n2 = 40)), collapse = ", ")))

# 4. Grupy nierówne: N2/N1 = 2 oraz test jednostronny
n2 <- n_dla_mocy(d = 0.5, moc = .9, ratio = 2)
cat(sprintf("ratio 2: N1 = %d, N2 = %d, razem %d (przy równych grupach razem %d)\n",
            n2[1], n2[2], sum(n2), sum(n)))
n1s <- n_dla_mocy(d = 0.5, moc = .9, ogony = "greater")
cat(sprintf("test jednostronny: N1 = N2 = %d\n", n1s[1]))

# 5. Inne δ przy mocy 0.9 i 0.8 (N w każdej grupie)
tab <- sapply(c(0.2, 0.3, 0.4, 0.5, 0.6, 0.8), function(d)
  c(delta = d, moc_0.8 = n_dla_mocy(d, .8)[[1]], moc_0.9 = n_dla_mocy(d, .9)[[1]]))
print(t(tab))
Wynik:
N1 N2
86 86
moc przy tych N: 0.9032
pwr.t.test: n = 85.03; power.t.test: n = 85.03
delta dla mocy 50%, 80%, 95% przy N = 86 + 86: 0.301, 0.430, 0.553
moc przy N = 40 + 40 i delta = 0.5: 0.598
delta dla mocy 50% przy N = 40 + 40: 0.444
najmniejsze delta przy N = 40 + 40: moc 0.9 -> 0.734; moc 0.8 -> 0.634
delta dla mocy 50%, 80%, 95% przy N = 40 + 40: 0.444, 0.634, 0.816
ratio 2: N1 = 64, N2 = 128, razem 192 (przy równych grupach razem 172)
test jednostronny: N1 = N2 = 70
     delta moc_0.8 moc_0.9
[1,]   0.2     394     527
[2,]   0.3     176     235
[3,]   0.4     100     133
[4,]   0.5      64      86
[5,]   0.6      45      60
[6,]   0.8      26      34
2. Paired Samples i One Sample T-Test
R
# B558 – analiza mocy w jamovi (jpower): Paired Samples T-Test i One Sample T-Test policzone w R
# jpower liczy te analizy funkcją pwr::pwr.t.test (type = "paired" albo "one.sample").
# δ to tu średnia różnic podzielona przez SD różnic (d_z), a N to liczba par.
suppressPackageStartupMessages(library(pwr))

# 1. Paired Samples T-Test, ustawienia domyślne: δ = 0.5, moc 0.9, α = 0.05, dwustronnie
p <- pwr.t.test(d = 0.5, power = .9, sig.level = .05, type = "paired")
cat(sprintf("pary: n = %.3f -> N = %d\n", p$n, ceiling(p$n)))
o <- pwr.t.test(d = 0.5, power = .9, sig.level = .05, type = "one.sample")
cat(sprintf("jedna próba: n = %.3f -> N = %d\n", o$n, ceiling(o$n)))
cat(sprintf("kontrola power.t.test (paired, strict = TRUE): n = %.3f\n",
            power.t.test(delta = 0.5, sd = 1, power = .9, type = "paired", strict = TRUE)$n))

# 2. Ten sam efekt w jednostkach SD pomiaru (d = 0.5) a d_z przy różnej korelacji przed–po
# Przy równych SD pomiarów: SD różnic = SD * sqrt(2 * (1 - r)), więc d_z = d / sqrt(2 * (1 - r))
r <- c(0.3, 0.5, 0.7, 0.8)
dz <- 0.5 / sqrt(2 * (1 - r))
N <- sapply(dz, function(x) ceiling(pwr.t.test(d = x, power = .9, sig.level = .05, type = "paired")$n))
print(data.frame(r = r, d_z = round(dz, 3), N_par = N), row.names = FALSE)

# 3. Moc i najmniejszy efekt przy 30 parach
cat(sprintf("30 par, d_z = 0.5: moc = %.3f\n", pwr.t.test(n = 30, d = 0.5, sig.level = .05, type = "paired")$power))
cat(sprintf("30 par, moc 0.9: najmniejsze d_z = %.3f; moc 0.5: d_z = %.3f\n",
            pwr.t.test(n = 30, power = .9, sig.level = .05, type = "paired")$d,
            pwr.t.test(n = 30, power = .5, sig.level = .05, type = "paired")$d))
Wynik:
pary: n = 43.995 -> N = 44
jedna próba: n = 43.995 -> N = 44
kontrola power.t.test (paired, strict = TRUE): n = 43.996
   r   d_z N_par
 0.3 0.423    61
 0.5 0.500    44
 0.7 0.645    28
 0.8 0.791    19
30 par, d_z = 0.5: moc = 0.754
30 par, moc 0.9: najmniejsze d_z = 0.612; moc 0.5: d_z = 0.370
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite (kodu rysunków nie pokazujemy). Moduł jpower i jamovi nie były uruchamiane. W pracy podaj wersję jamovi i jpower albo R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- δ = 0.5 „bo tak było w oknie”. To wartość domyślna, a nie uzasadnienie. Wynik jest tak dobry, jak δ, które wpiszesz.
- d z literatury wpisane w Paired Samples. Moduł oczekuje dz. Bez przeliczenia z korelacją przed–po wynik może być daleko od prawdy.
- N per group czytane jako N łącznie. 86 to liczba w każdej grupie.
- Test jednostronny wybrany po to, żeby zmniejszyć próbę. Kierunek musi wynikać z hipotezy ustalonej z góry.
- Brak zapasu na braki danych i rezygnacje. jpower podaje N do analizy, nie do rekrutacji.
- jpower użyty do ANOVA „przez test t”. Moc dla kilku grup liczy się inaczej – użyj kalkulatora mocy.
Liczenie wyników w jamovi zaczniesz od wpisu przygotowanie danych i statystyki opisowe w jamovi. Inny moduł z biblioteki jamovi opisuje wpis metaanaliza w jamovi (MAJOR).
Najczęstsze pytania
Gdzie w jamovi jest analiza mocy?
Daje ją moduł jpower (Morey i Selker, b.d.). Zainstaluj go przez Modules → jamovi library (The jamovi project, b.d.). Po instalacji analizy są w Analyses → Power, w podgrupie jpower: Independent Samples T-Test, Paired Samples T-Test i One Sample T-Test. W polskiej wersji interfejsu nazwy mogą brzmieć inaczej.
Jaką wielkość efektu wpisać w jpower?
Najmniejszy efekt, który byłby dla Ciebie ważny (δ w jednostkach odchylenia standardowego). Wartość domyślna 0.5 to tylko ustawienie startowe okna. Efekt z małego pilotażu bywa zawyżony i prowadzi do zbyt małej próby (Albers i Lakens, 2018). Jak wybrać δ, wyjaśnia poradnik o doborze liczebności próby.
Dlaczego jpower podaje dla prób zależnych tak małe N?
W Paired Samples T-Test δ to średnia różnic podzielona przez SD różnic (dz), a N to liczba par. Przy dodatniej korelacji pomiarów SD różnic jest mniejsze, więc ten sam efekt w jednostkach SD pomiaru daje większe dz. Przy d = 0.5 i r = .7 to dz = 0.645 i 28 par zamiast 44.
Czy w jpower policzę moc dla ANOVA albo korelacji?
Nie. Wersja 0.1.3 ma tylko trzy analizy dla testu t. ANOVA jest w kodzie modułu, ale oznaczona jako ukryta. Moc dla ANOVA, χ², regresji i interakcji policzysz w kalkulatorze mocy na metodolog.pl albo w R.
Czy jpower nadaje się do mocy po fakcie?
Technicznie możesz wpisać N i efekt z własnych wyników, ale taka „moc obserwowana” nic nowego nie mówi – wynika z wartości p. Zamiast niej podaj przedział ufności efektu i analizę wrażliwości: najmniejsze δ, które Twoja próba wykrywa z mocą 0.8 lub 0.9 (opcja Calculate → Effect size).
Powiązane hasła
Przeczytaj też
Dobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikKalkulator mocy: ANOVA, χ², regresja
Moc dla N albo N dla mocy w jednoczynnikowej ANOVA, teście chi-kwadrat, regresji (R² i ΔR²) i interakcji 2 × 2. Wzory, kod R i opis APA.
Czytaj →PoradnikMoc testu i liczebność próby – zadania
Dziesięć zadań: liczebność dla testu t, proporcji i korelacji, moc przy danym n, minimalny efekt, ubytek, efekt schematu, α i moc po fakcie.
Czytaj →PoradnikTest t w jamovi krok po kroku
Trzy testy t w jamovi: które pola zaznaczyć, jak czytać tabele Student, Welch i Mann–Whitney, gdzie jest d Cohena i jak opisać wynik w APA – z danymi do pobrania.
Czytaj →Nie wiesz, ile osób potrzebujesz do badania?
Pomożemy dobrać najmniejszy interesujący efekt, policzyć liczebność dla Twojego planu (także poza testem t) i opisać uzasadnienie liczebności tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Morey, R. D., & Selker, R. (b.d.). jpower: Power analysis for common research designs (moduł jamovi, wersja 0.1.3) – pliki definicji analiz i kod modułu. GitHub. https://github.com/richarddmorey/jpower ● Otwarty dostęp
- The jamovi project. (b.d.). Library modules. https://www.jamovi.org/modules.html ● Otwarty dostęp
Cytowania BibTeX
@article{albers2018when, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@misc{moreyndjpower, author={Morey, Richard D. and Selker, Ravi}, title={{jpower: Power analysis for common research designs (moduł jamovi, wersja 0.1.3) – pliki definicji analiz i kod modułu}}, howpublished={GitHub}, year={b.d.}, url={https://github.com/richarddmorey/jpower}}@misc{jamovindmodules, author={{The jamovi project}}, title={{Library modules}}, howpublished={jamovi}, year={b.d.}, url={https://www.jamovi.org/modules.html}}