Metaanaliza w jamovi: moduł MAJOR
Podstawowe menu jamovi nie ma metaanalizy. Daje ją moduł MAJOR (Meta-Analysis for JAMOVI) autorstwa W. Kyle'a Hamiltona. Instalujesz go przez Modules → jamovi library i jest dostępny od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.). Pierwsze kroki w programie opisuje wpis jamovi krok po kroku.
MAJOR to nakładka na pakiet R metafor (Viechtbauer, 2010). Okno zbiera dane i opcje, a liczy funkcja rma() tego pakietu (Hamilton, b.d.). Dlatego wszystkie liczby w tym wpisie policzyliśmy w R pakietem metafor. Samego modułu nie uruchamialiśmy.
Biblioteka modułów podaje wersję 1.2.4, a publiczne repozytorium modułu zawiera wersję 1.2.0. Nazwy menu, opcji i tabel wzięliśmy z plików definicji i kodu tej wersji (Hamilton, b.d.). W nowszej mogą się nieznacznie różnić. Plików tłumaczeń w repozytorium nie ma, więc podajemy nazwy angielskie.
Ten wpis pokazuje tylko obsługę modułu. Czym jest model efektów losowych, τ² i I², wyjaśniają hasło metaanaliza i poradnik metaanaliza krok po kroku.
Sześć analiz w menu MAJOR
Po instalacji na pasku Analyses pojawia się ikona MAJOR, a w niej podgrupa Meta Analysis. Analizę wybierasz według tego, co podają artykuły (Hamilton, b.d.):
| Pozycja menu | Co wpisujesz (jeden wiersz = jedno badanie) | Domyślna miara |
|---|---|---|
| Mean Differences (n, M, SD) | liczebność, średnia i SD w dwóch grupach | SMD (g Hedgesa) |
| Correlation Coefficients (r, N) | korelacja i liczebność | ZCOR (z Fishera) |
| Effect Sizes and Sampling Variances | gotowy efekt i jego wariancja | – (to, co wpiszesz) |
| Dichotomous Models | liczba zdarzeń i liczebność w dwóch grupach | OR (iloraz szans) |
| Proportions | liczba zdarzeń i liczebność | PR (surowa proporcja) |
| Reliability Generalization | alfa Cronbacha, liczba pozycji, liczebność | ARAW (surowa alfa) |
Uwaga na korelacje. Przy domyślnej mierze ZCOR tabela pokazuje wynik w skali z Fishera, bo kod modułu nie przelicza go z powrotem na r (Hamilton, b.d.). Zanim przepiszesz wynik, przelicz go w konwerterze wielkości efektu. Gdy artykuły podają już g Hedgesa z błędem standardowym, wybierz Effect Sizes and Sampling Variances i wpisz wariancję, czyli SE².
Przykład i pliki do pobrania
Dane są fikcyjne. Dwanaście badań porównywało naukę przez samotestowanie (grupa 1) z ponownym czytaniem materiału (grupa 2). Wynikiem były punkty w teście wiedzy. Badania liczyły od 16 do 57 osób w grupie, łącznie 784 osoby.
Pobierz plik CSV albo plik .sav z etykietami. Kolumny to badanie, n1, m1, sd1, n2, m2 i sd2. W jamovi ustaw badanie jako Nominal, a resztę jako Continuous. Ziarno losowania wybraliśmy spośród 4000 tak, żeby jedno małe badanie (badanie 12) miało nietypowo duży efekt. Na nim pokażemy diagnostykę wpływu.
Okno Mean Differences krok po kroku
- MAJOR → Mean Differences (n, M, SD).
- Przeciągnij
n1,m1,sd1do pól Group One Sample Size, Group One Mean i Group One Standard Deviation, an2,m2,sd2do pól grupy drugiej.badanietrafia do Study Label. Kod liczy różnicę „grupa 1 minus grupa 2”, więc dodatni efekt oznacza tu przewagę samotestowania (Hamilton, b.d.). - Model Options. Model estimator to domyślnie Restricted Maximum-Likelihood (REML). Na liście są też m.in. DerSimonian-Laird, Paule-Mandel, Sidik-Jonkman i Fixed-Effect. Effect size model measures to domyślnie Standardized Mean Difference, czyli g Hedgesa. Knapp and Hartung Adjustment jest domyślnie wyłączona. Moderator type to domyślnie No Moderator.
- Plots. W części Forest Plot zaznacz Prediction interval, bo domyślnie jest wyłączony.
- Publication Bias i Additional Options zostaw na razie bez zmian. Wrócimy do nich niżej.
Estymator wybierz przed analizą i zapisz w protokole. Przegląd metod wskazuje REML i Paule'a–Mandela jako lepsze wybory niż popularny estymator DerSimoniana–Lairda (Veroniki i in., 2016). W przykładzie DL daje τ² = 0.099 i I² = 60.2%, a REML τ² = 0.081 i I² = 55.5%. Efekt łączny zmienia się tylko o 0.004.
Pierwsza wiadomość po uruchomieniu modelu w R to ostrzeżenie metafor: jedna wartość SMD przekracza 2 i być może zamiast SD wpisano błąd standardowy. W badaniu 12 SD w grupie samotestowania wynosi 4.67, a w pozostałych badaniach od 9.50 do 14.86. Czy jamovi pokaże to ostrzeżenie, nie sprawdzaliśmy. Dlatego zanim cokolwiek policzysz, porównaj SD między badaniami.
Tabela Random-Effects Model
| Estimate | se | Z | p | CI Lower Bound | CI Upper Bound | |
|---|---|---|---|---|---|---|
| Intercept | 0.518 | 0.112 | 4.604 | < .001 | 0.297 | 0.738 |
Pod tabelą moduł dopisuje notę Tau² Estimator: Restricted Maximum-Likelihood. Intercept to średni efekt w modelu efektów losowych: g = 0.52, 95% CI [0.30, 0.74]. Kolumna Z to test, czy średni efekt różni się od zera. Drugi wiersz tabeli wypełnia się tylko przy moderatorze. Moderatory i metaregresję opisuje wpis metaregresja i analiza moderatorów.
Tabela Heterogeneity Statistics
| Tau | Tau² | I² | H² | R² | df | Q | p |
|---|---|---|---|---|---|---|---|
| 0.285 | 0.0812 (SE= 0.0637 ) | 55.48% | 2.246 | 11 | 27.642 | .004 |
Tau to odchylenie standardowe prawdziwych efektów między badaniami: τ = 0.28 na skali g. Tau² moduł podaje razem z błędem standardowym w jednej komórce. I² = 55.5% mówi, jaka część zmienności obserwowanych efektów wynika z różnic między badaniami, a nie z błędu losowego. Q(11) = 27.64, p = .004 to test heterogeniczności. R² jest puste, bo dotyczy tylko modelu z moderatorem. Jak czytać te miary i dlaczego I² nie jest miarą „dużej” heterogeniczności, wyjaśnia hasło I² i τ².
Przedział predykcji: wykres lasu i Model Summary
Żadna tabela MAJOR nie ma kolumny z przedziałem predykcji. Znajdziesz go w dwóch miejscach. Tekst Model Summary pod tabelami podaje go zdaniem po angielsku, gdy τ² > 0 (Hamilton, b.d.). Wykres lasu dorysowuje go po zaznaczeniu Prediction interval. Tak policzony 95% przedział predykcji wynosi [−0.08, 1.12].
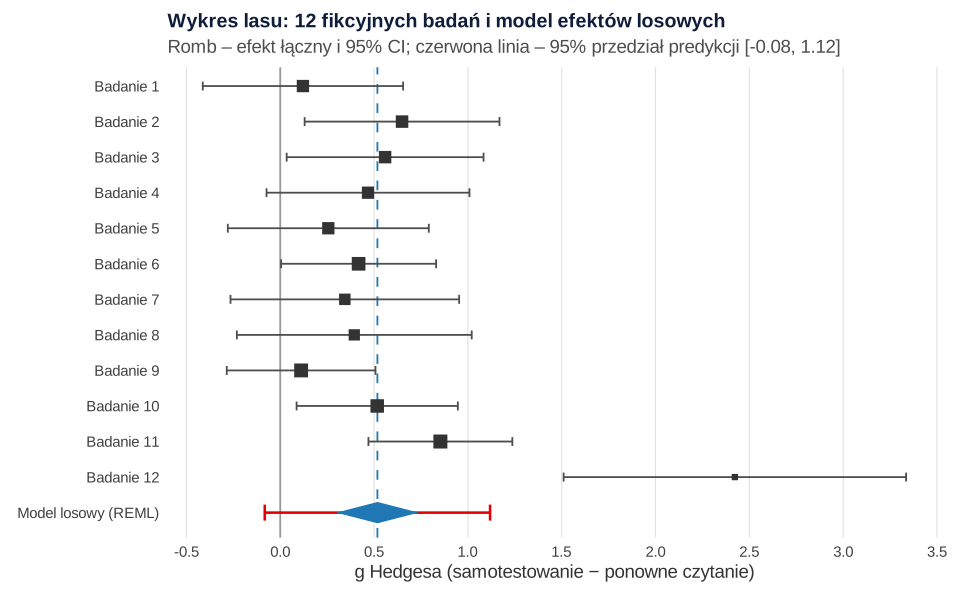
Średni efekt jest wyraźnie dodatni, ale w nowym, podobnym badaniu prawdziwy efekt może leżeć od lekko ujemnego do bardzo dużego. To zdanie warto mieć w Dyskusji. Metafor liczy ten przedział domyślnie z rozkładu normalnego. Riley i in. (2011) proponują rozkład t z k − 2 stopniami swobody. Wtedy przedział jest szerszy: [−0.17, 1.20]. W jamovi tej wersji nie wybierzesz. Policzysz ją w R albo w kalkulatorze metaanalizy. W pracy napisz, której wersji użyłeś.
Inne opcje wykresu to Model fitting weights (wagi w procentach), X-Axis Title i Study order. Kolejność domyślnie ustala Fitted values. Jak czytać wykres lasu, opisuje osobne hasło.
Knapp and Hartung Adjustment
Po zaznaczeniu tej opcji kod przełącza test z z na t z k − 1 stopniami swobody (Hamilton, b.d.). Przedział ufności jest wtedy zwykle szerszy. W przykładzie: se = 0.137, t(11) = 3.77, p = .003, 95% CI [0.22, 0.82]. Przedział predykcji to wtedy [−0.18, 1.21]. Nota pod tabelą zmienia się na Knapp and Hartung (2003) adjustment used.
Uwaga: nagłówek kolumny pozostaje Z, bo jest stały w definicji tabeli. Przy poprawce to jednak statystyka t i tak ją opisz. W symulacjach 2–20 badań metoda Hartunga–Knappa–Sidika–Jonkmana dawała bardziej adekwatny odsetek błędów I rodzaju niż standardowa metoda DerSimoniana–Lairda (IntHout i in., 2014). Przy kilkunastu badaniach warto więc ją włączyć, a decyzję zapisać przed analizą.
Publication Bias Assessment i wykres lejkowy
Tabela Publication Bias Assessment w definicji wyników nie zależy od żadnej opcji, więc pojawia się od razu. Ma kolumny Test Name, value i p (Hamilton, b.d.).
| Test Name | value | p |
|---|---|---|
| Fail-Safe N | 209 | < .001 |
| Begg and Mazumdar Rank Correlation | 0.061 | .841 |
| Egger's Regression | 2.341 | .019 |
| Trim and Fill Number of Studies | 0 |
Nota pod tabelą mówi, że fail-safe N policzono metodą Rosenthala. Inne warianty (Orwin, Rosenberg) wybierzesz w sekcji Publication Bias. W kolumnie value są różne statystyki. Dla Begga i Mazumdara to tau Kendalla, dla testu Eggera statystyka z, a dla trim-and-fill liczba „dopisanych” badań.
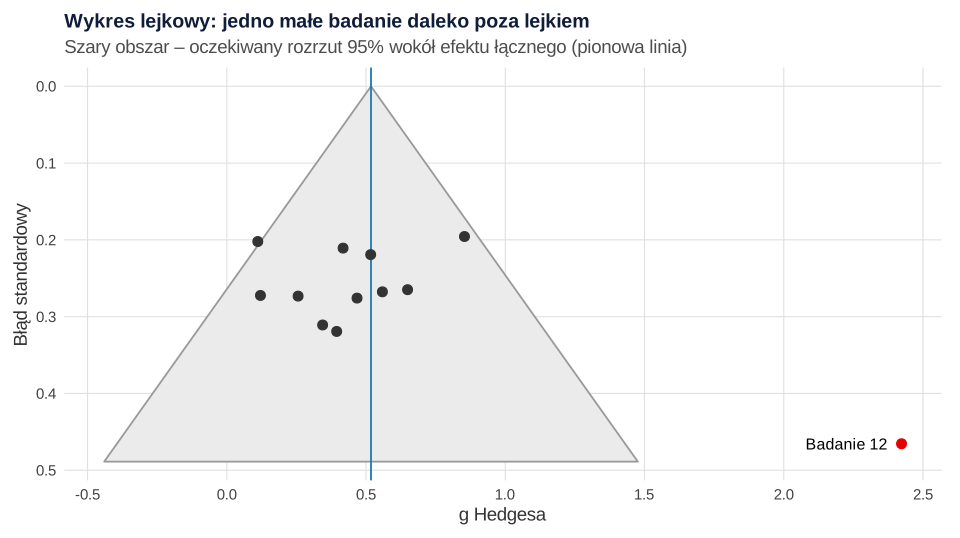
Tabela wygląda sprzecznie. Test Eggera wskazuje asymetrię (z = 2.34, p = .019), test Begga i Mazumdara nie, trim-and-fill nie dopisuje żadnego badania, a fail-safe N jest ogromne. Wykres lejkowy wyjaśnia, skąd to się bierze. Całą asymetrię tworzy jedno małe badanie z bardzo dużym efektem. Bez badania 12 test Eggera daje z = −0.62, p = .532. Asymetria lejka ma wiele przyczyn poza błędem publikacji, więc nie należy ich utożsamiać (Sterne i in., 2011). Przy 12 badaniach testy mają też małą moc.
Fail-safe N = 209 nie znaczy, że wynik jest odporny na błąd publikacji. Metoda Rosenthala liczy, ile badań z zerowym efektem trzeba by dopisać, żeby łączny wynik przestał być istotny. Dotyczy więc istotności, a nie wielkości efektu. Dlaczego nie warto jej raportować, pokazuje wpis błąd publikacji w metaanalizie – metody. Ten sam wpis omawia p-curve, p-uniform i modele selekcji, które MAJOR ma w sekcji Publication Bias (Hamilton, b.d.).
Diagnostyka wpływu: Show Plot of Influence Diagnostics
W Additional Options zaznacz Show Plot of Influence Diagnostics. Moduł wywołuje wtedy funkcję influence() z metafor i rysuje grupę Outlier and Influential Case Diagnostics (Hamilton, b.d.). To diagnostyka znana z regresji liniowej przeniesiona na modele metaanalizy (Viechtbauer i Cheung, 2010). Wykresy w module to:
- Externally Standardized Residual – jak daleko efekt badania leży od modelu dopasowanego bez niego;
- DFFITS Values i Cook's Distances – jak bardzo zmienia się wynik po usunięciu badania;
- Covariance Ratios – wartość poniżej 1 znaczy, że usunięcie badania zwiększa precyzję oszacowania;
- Leave-one-out Tau Estimates i Leave-one-out (residual) Heterogeneity Test Statistics – τ² i Q po usunięciu badania;
- Hat Values, Weights i Q-Q Plot.
Metafor oznacza jako wpływowe tylko badanie 12. Ma resztę standaryzowaną 4.08 i odległość Cooka 0.475. Pozostałe badania mają odległość Cooka najwyżej 0.166. Bez badania 12 τ² spada z 0.081 do 0.012, a Q z 27.64 do 10.01.
Co z tym zrobić? Najpierw sprawdź dane: czy SD nie jest w rzeczywistości błędem standardowym i czy wyniki przepisano z właściwej tabeli. Jeśli dane są poprawne, nie usuwaj badania po cichu. Podaj wynik główny i analizę wrażliwości bez badania 12. Bez niego efekt wynosi g = 0.44, 95% CI [0.28, 0.60], I² = 16.7%, a przedział predykcji [0.17, 0.71]. W Dyskusji zastanów się, czym badanie różni się od reszty. Zasady postępowania z obserwacjami odstającymi omawia wpis czy można usunąć obserwacje odstające.
Czego MAJOR nie zrobi
- Jeden efekt z badania. Model wielopoziomowy (
rma.mv) jest na liście planów w opisie repozytorium, ale nie ma go w menu. Gdy badanie daje kilka efektów, przejdź do R (zob. metaanaliza wielopoziomowa). - Jeden moderator naraz. W polu Moderator jest jedna zmienna, a w opisie repozytorium „więcej niż jeden moderator” też figuruje jako plan.
- Brak metaanalizy sieciowej. Porównanie wielu interwencji naraz opisuje wpis metaanaliza sieciowa krok po kroku.
- Brak przedziału predykcji Rileya i brak przeliczenia z Fishera na r w analizie korelacji (zob. wyżej).
Liczebność potrzebną do pojedynczego badania policzysz w jamovi modułem opisanym we wpisie analiza mocy w jamovi.
Zapis wyników w stylu APA
W Metodzie podaj program i moduł z wersją, miarę efektu, estymator τ², metodę przedziału ufności i sposób oceny błędu publikacji. Wzór do dostosowania:
Jeśli włączyłeś poprawkę Knappa–Hartunga, zamień z na t(11) = 3.77, p = .003 i przedział na [0.22, 0.82]. Zdania do innych analiz przygotuje generator opisu wyników APA.
Te same liczby w R (metafor)
MAJOR liczy funkcją metafor::rma() z miarą SMD, estymatorem REML i testem z, a tabelę błędu publikacji – funkcjami fsn(), ranktest(), regtest() i trimfill() (Hamilton, b.d.). Te same wywołania są poniżej. Przepis 1 tworzy pliki do pobrania, przepis 2 liczy wszystkie tabele. Uruchom je po kolei w jednym folderze.
1. Dane i pliki CSV oraz .sav
R
# B559 – metaanaliza w jamovi (MAJOR): dane do pobrania
# Dane fikcyjne: 12 badań porównujących naukę przez samotestowanie (grupa 1)
# z ponownym czytaniem materiału (grupa 2); wynik – punkty w teście wiedzy.
# set.seed(30) – ziarno wybrane spośród 4000 tak, żeby przykład miał umiarkowaną
# heterogeniczność i jedno małe badanie wpływowe (badanie 12 ma celowo bardzo duży efekt).
suppressPackageStartupMessages(library(haven))
set.seed(30)
k <- 12
n <- sample(18:60, k, replace = TRUE)              # osoby w każdej grupie
delta <- rnorm(k, 0.45, 0.22)                     # prawdziwe efekty badań
delta[12] <- 1.6; n[12] <- 16                     # małe badanie z bardzo dużym efektem
wiersz <- function(i) {
  x1 <- rnorm(n[i], 60 + 12 * delta[i], 12)       # samotestowanie
  x2 <- rnorm(n[i], 60, 12)                       # ponowne czytanie
  c(n[i], round(mean(x1), 2), round(sd(x1), 2), n[i], round(mean(x2), 2), round(sd(x2), 2))
}
d <- data.frame(t(sapply(1:k, wiersz)))
names(d) <- c("n1", "m1", "sd1", "n2", "m2", "sd2")
d <- data.frame(badanie = paste("Badanie", 1:k), d)

write.csv(d, "metaanaliza-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
sav <- d
etyk <- c(badanie = "Etykieta badania", n1 = "Liczebność – samotestowanie", m1 = "Średnia – samotestowanie",
          sd1 = "SD – samotestowanie", n2 = "Liczebność – ponowne czytanie", m2 = "Średnia – ponowne czytanie",
          sd2 = "SD – ponowne czytanie")
for (v in names(etyk)) sav[[v]] <- labelled(sav[[v]], label = etyk[[v]])
write_sav(sav, "metaanaliza-w-jamovi-dane.sav")

print(d, row.names = FALSE)
cat(sprintf("Łącznie osób: %d; liczebność grupy: %d–%d\n", sum(d$n1 + d$n2), min(d$n1), max(d$n1)))
Wynik:
    badanie n1    m1   sd1 n2    m2   sd2
  Badanie 1 27 61.16 14.86 27 59.70  7.89
  Badanie 2 30 67.27 13.09 30 58.69 13.00
  Badanie 3 29 66.18 12.78 29 58.14 15.48
  Badanie 4 27 66.23 12.34 27 60.56 11.54
  Badanie 5 27 60.89 13.26 27 57.56 12.35
  Badanie 6 46 67.51  9.92 46 62.77 12.45
  Badanie 7 21 65.43 13.61 21 60.56 14.15
  Badanie 8 20 64.49 10.81 20 58.82 16.73
  Badanie 9 49 60.84 10.03 49 59.56 12.65
 Badanie 10 43 67.18 10.65 43 61.08 12.66
 Badanie 11 57 67.83  9.50 57 57.85 13.40
 Badanie 12 16 79.91  4.67 16 56.11 12.71
Łącznie osób: 784; liczebność grupy: 16–57
2. Tabele MAJOR: model, heterogeniczność, błąd publikacji i wpływ
R
# B559 – liczby do tabel modułu MAJOR (Mean Differences (n, M, SD)) policzone w pakiecie metafor
# MAJOR wywołuje metafor::rma z miarą SMD (domyślna), estymatorem REML (domyślny) i testem z;
# po zaznaczeniu Knapp and Hartung Adjustment – test = "knha".
suppressPackageStartupMessages(library(metafor))
fp <- function(p) if (p < .001) "< .001" else paste("=", sub("^0\\.", ".", formatC(p, format = "f", digits = 3)))
d <- read.csv("metaanaliza-w-jamovi-dane.csv")
# ostrzeżenia pakietu wypisujemy w wyniku zamiast w konsoli
pokaz <- function(w) { cat("Ostrzeżenie metafor:", conditionMessage(w), "\n"); invokeRestart("muffleWarning") }
res <- withCallingHandlers(
  rma(n1i = n1, n2i = n2, m1i = m1, m2i = m2, sd1i = sd1, sd2i = sd2,
      measure = "SMD", method = "REML", test = "z", data = d, slab = badanie),
  warning = pokaz)

# Efekty poszczególnych badań (g Hedgesa) i ich wariancje
es <- suppressWarnings(escalc(measure = "SMD", n1i = n1, n2i = n2, m1i = m1, m2i = m2,
                              sd1i = sd1, sd2i = sd2, data = d, slab = badanie))
print(data.frame(badanie = d$badanie, g = round(es$yi, 3), v = round(es$vi, 4),
                 waga_proc = round(weights(res), 1)), row.names = FALSE)

# Tabela Random-Effects Model (k = 12)
cat(sprintf("Random-Effects Model (k = %d): Estimate = %.3f; se = %.3f; Z = %.3f; p %s; CI [%.3f, %.3f]\n",
            res$k, coef(res), res$se, res$zval, fp(res$pval), res$ci.lb, res$ci.ub))

# Tabela Heterogeneity Statistics (zaokrąglenia jak w kodzie modułu)
cat(sprintf("Heterogeneity: Tau = %.4f; Tau2 = %.4f (SE= %.4f ); I2 = %.2f%%; H2 = %.4f; df = %d; Q = %.3f; p %s\n",
            sqrt(res$tau2), res$tau2, res$se.tau2, res$I2, res$H2, res$k - 1, res$QE, fp(res$QEp)))

# Przedział predykcji: domyślnie w metafor (jak w Model Summary i na wykresie lasu) i wariant Rileya
p_def <- predict(res)
p_ril <- predict(res, predtype = "Riley")
cat(sprintf("95%% PI (metafor, z): [%.3f, %.3f]; 95%% PI (Riley, t z k - 2 df): [%.3f, %.3f]\n",
            p_def$pi.lb, p_def$pi.ub, p_ril$pi.lb, p_ril$pi.ub))

# Tabela Publication Bias Assessment
fs <- fsn(res$yi, res$vi, type = "Rosenthal")          # MAJOR: fsn(yi =, vi =) w starszej wersji metafor
rk <- ranktest(res)
eg <- regtest(res)
tf <- trimfill(res)
cat(sprintf("Fail-Safe N = %d (p %s)\nBegg and Mazumdar Rank Correlation: tau = %.3f; p %s\nEgger's Regression: z = %.3f; p %s\nTrim and Fill Number of Studies = %d\n",
            fs$fsnum, fp(fs$pval), rk$tau, fp(rk$pval), eg$zval, fp(eg$pval), tf$k0))

# Knapp and Hartung Adjustment (test = "knha")
kh <- update(res, test = "knha")
p_kh <- predict(kh)
cat(sprintf("Knapp-Hartung: Estimate = %.3f; se = %.3f; t(%d) = %.3f; p %s; CI [%.3f, %.3f]; PI [%.3f, %.3f]\n",
            coef(kh), kh$se, kh$k - 1, kh$zval, fp(kh$pval), kh$ci.lb, kh$ci.ub, p_kh$pi.lb, p_kh$pi.ub))

# Inny estymator tau2 dla porównania: DerSimonian-Laird
dl <- update(res, method = "DL")
cat(sprintf("DL: Estimate = %.3f; Tau2 = %.4f; I2 = %.2f%%\n", coef(dl), dl$tau2, dl$I2))

# Outlier and Influential Case Diagnostics (to samo co wykresy w MAJOR)
inf <- influence(res)
print(round(as.data.frame(inf$inf)[, c("rstudent", "dffits", "cook.d", "cov.r", "tau2.del", "QE.del", "hat", "weight")], 3))
cat("Badania oznaczone jako wpływowe:", d$badanie[inf$is.infl], "\n")

# Model bez badania 12 (analiza wrażliwości – zapisz ją w pracy obok wyniku głównego)
bez12 <- update(res, subset = -12)
p_bez12 <- predict(bez12)
cat(sprintf("Bez badania 12 (k = %d): Estimate = %.3f; CI [%.3f, %.3f]; Tau2 = %.4f; I2 = %.2f%%; Q = %.3f; p_Q %s; PI [%.3f, %.3f]\n",
            bez12$k, coef(bez12), bez12$ci.lb, bez12$ci.ub, bez12$tau2, bez12$I2, bez12$QE, fp(bez12$QEp),
            p_bez12$pi.lb, p_bez12$pi.ub))
eg12 <- regtest(bez12)
cat(sprintf("Egger bez badania 12: z = %.3f; p %s\n", eg12$zval, fp(eg12$pval)))
Wynik:
Ostrzeżenie metafor: One or more SMD values are unusually large (i.e., abs(yi) > 2).
Maybe SEs were used in place of SDs to compute them?
    badanie     g      v waga_proc
  Badanie 1 0.121 0.0742       8.1
  Badanie 2 0.649 0.0702       8.4
  Badanie 3 0.559 0.0717       8.3
  Badanie 4 0.468 0.0761       8.0
  Badanie 5 0.256 0.0747       8.1
  Badanie 6 0.418 0.0444      10.1
  Badanie 7 0.344 0.0966       7.1
  Badanie 8 0.395 0.1019       6.9
  Badanie 9 0.111 0.0409      10.4
 Badanie 10 0.517 0.0481       9.8
 Badanie 11 0.853 0.0383      10.6
 Badanie 12 2.423 0.2167       4.2
Random-Effects Model (k = 12): Estimate = 0.518; se = 0.112; Z = 4.604; p < .001; CI [0.297, 0.738]
Heterogeneity: Tau = 0.2849; Tau2 = 0.0812 (SE= 0.0637 ); I2 = 55.48%; H2 = 2.2460; df = 11; Q = 27.642; p = .004
95% PI (metafor, z): [-0.083, 1.118]; 95% PI (Riley, t z k - 2 df): [-0.165, 1.200]
Fail-Safe N = 209 (p < .001)
Begg and Mazumdar Rank Correlation: tau = 0.061; p = .841
Egger's Regression: z = 2.341; p = .019
Trim and Fill Number of Studies = 0
Knapp-Hartung: Estimate = 0.518; se = 0.137; t(11) = 3.770; p = .003; CI [0.216, 0.820]; PI [-0.178, 1.214]
DL: Estimate = 0.522; Tau2 = 0.0986; I2 = 60.21%
           rstudent dffits cook.d cov.r tau2.del QE.del   hat weight
Badanie 1    -1.041 -0.318  0.104 1.117    0.085 25.638 0.081  8.140
Badanie 2     0.310  0.044  0.002 1.289    0.108 27.263 0.084  8.356
Badanie 3     0.083 -0.032  0.001 1.322    0.112 27.576 0.083  8.276
Badanie 4    -0.137 -0.099  0.012 1.321    0.112 27.634 0.080  8.042
Badanie 5    -0.662 -0.239  0.064 1.242    0.102 26.836 0.081  8.115
Badanie 6    -0.284 -0.155  0.031 1.381    0.117 27.499 0.101 10.070
Badanie 7    -0.414 -0.166  0.031 1.263    0.106 27.401 0.071  7.113
Badanie 8    -0.293 -0.133  0.020 1.269    0.107 27.543 0.069  6.907
Badanie 9    -1.307 -0.416  0.150 0.996    0.065 23.552 0.104 10.362
Badanie 10   -0.024 -0.072  0.007 1.383    0.118 27.628 0.098  9.786
Badanie 11    1.122  0.439  0.166 0.995    0.065 23.685 0.106 10.588
Badanie 12    4.084  0.786  0.475 0.530    0.012 10.011 0.042  4.246
Badania oznaczone jako wpływowe: Badanie 12
Bez badania 12 (k = 11): Estimate = 0.440; CI [0.280, 0.601]; Tau2 = 0.0122; I2 = 16.69%; Q = 10.011; p_Q = .439; PI [0.171, 0.710]
Egger bez badania 12: z = -0.624; p = .532
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite (kodu rysunków nie pokazujemy). Moduł MAJOR i jamovi nie były uruchamiane, a MAJOR korzysta z własnej kopii pakietu metafor, więc w ostatnich miejscach po przecinku wyniki mogą się nieznacznie różnić. W pracy podaj wersję jamovi i MAJOR albo R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Wpisanie SE zamiast SD. Efekt rośnie wtedy kilkukrotnie. Porównaj SD między badaniami, zanim uruchomisz analizę.
- Odwrócone grupy w części badań. Kierunek „grupa 1 minus grupa 2” musi znaczyć to samo w każdym wierszu.
- Raport bez przedziału predykcji. Domyślnie wykres go nie pokazuje, a przy I² = 55% to najważniejsza informacja dla praktyki.
- Kolumna Z opisana jako z mimo poprawki Knappa–Hartunga. Przy poprawce to t z k − 1 stopniami swobody.
- Fail-safe N jako dowód braku błędu publikacji. W przykładzie wynosi 209, choć lejek jest wyraźnie asymetryczny.
- Usunięcie wpływowego badania bez raportu. Pokaż oba wyniki.
Pełny przebieg metaanalizy w R, od wyszukiwania po raport PRISMA 2020, pokazuje poradnik metaanalizy krok po kroku. Hasło jamovi zbiera pozostałe wpisy o programie.
Najczęstsze pytania
Jak zainstalować moduł MAJOR do metaanalizy w jamovi?
Przez Modules → jamovi library. Moduł jest dostępny od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.). Biblioteka podaje wersję 1.2.4, a publiczne repozytorium zawiera wersję 1.2.0 (Hamilton, b.d.). Analizy są w menu MAJOR → Meta Analysis. Nazwy są po angielsku, bo w repozytorium nie ma plików tłumaczeń.
Którą analizę MAJOR wybrać, gdy artykuły podają g Hedgesa z błędem standardowym?
Effect Sizes and Sampling Variances. Wpisujesz efekt i jego wariancję, czyli SE do kwadratu, a nie samo SE (Hamilton, b.d.). Gdy masz średnie i SD obu grup, wybierz Mean Differences (n, M, SD). Moduł policzy wtedy g Hedgesa sam.
Gdzie w MAJOR jest przedział predykcji?
Nie ma go w żadnej tabeli. Podaje go tekst Model Summary pod tabelami, gdy τ² > 0, oraz wykres lasu po zaznaczeniu Prediction interval (Hamilton, b.d.). W przykładzie to [−0.08, 1.12]. Wersji z rozkładem t i k − 2 stopniami swobody, którą proponują Riley i in. (2011), moduł nie liczy. Daje ona [−0.17, 1.20].
Czy włączyć Knapp and Hartung Adjustment w MAJOR?
Przy kilkunastu badaniach zwykle tak. W symulacjach ta metoda dawała bardziej adekwatny odsetek błędów I rodzaju niż metoda DerSimoniana–Lairda (IntHout i in., 2014). Pamiętaj, że kolumna Z zachowuje wtedy nazwę, ale zawiera statystykę t z k − 1 stopniami swobody. W przykładzie t(11) = 3.77, p = .003.
Test Eggera w MAJOR jest istotny – czy to błąd publikacji?
Niekoniecznie. Asymetria lejka ma wiele możliwych przyczyn (Sterne i in., 2011). W przykładzie tworzy ją jedno małe badanie z nietypowo dużym efektem. Bez niego test Eggera daje p = .532. Sprawdź diagnostykę wpływu (Show Plot of Influence Diagnostics) i podaj analizę wrażliwości.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikKalkulator metaanalizy z wykresem lasu
Model stały i losowy (REML, DL, Knapp–Hartung), Q, I², H², przedział predykcji i wykres lasu SVG z efektów i SE albo przedziałów ufności.
Czytaj →PoradnikBłąd publikacji w metaanalizie – metody
Lejek i test Eggera, trim-and-fill, PET-PEESE, model selekcji, p-curve i fail-safe N porównane na jednej symulacji w R, z wzorem opisu.
Czytaj →PoradnikMetaregresja i analiza moderatorów
Moderatory ciągłe i kategoryczne w metafor, Knapp–Hartung, QM i QE, pseudo-R², test permutacyjny, wykres bąbelkowy i opis APA.
Czytaj →Robisz metaanalizę w jamovi i nie wiesz, jak opisać wyniki?
Sprawdzimy Twój plik .omv, dane z badań, wybór miary i estymatora, heterogeniczność, błąd publikacji i badania wpływowe i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hamilton, W. K. (b.d.). MAJOR: Meta-Analysis for JAMOVI – kod źródłowy i pliki definicji modułu jamovi (wersja 1.2.0). GitHub – kylehamilton/MAJOR. https://github.com/kylehamilton/MAJOR ● Otwarty dostęp
- IntHout, J., Ioannidis, J. P. A., & Borm, G. F. (2014). The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method. BMC Medical Research Methodology, 14(1), Article 25. https://doi.org/10.1186/1471-2288-14-25 ● Otwarty dostęp
- Riley, R. D., Higgins, J. P. T., & Deeks, J. J. (2011). Interpretation of random effects meta-analyses. BMJ, 342, Article d549. https://doi.org/10.1136/bmj.d549
- Sterne, J. A. C., Sutton, A. J., Ioannidis, J. P. A., Terrin, N., Jones, D. R., Lau, J., Carpenter, J., Rücker, G., Harbord, R. M., Schmid, C. H., Tetzlaff, J., Deeks, J. J., Peters, J., Macaskill, P., Schwarzer, G., Duval, S., Altman, D. G., Moher, D., & Higgins, J. P. T. (2011). Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ, 343, Article d4002. https://doi.org/10.1136/bmj.d4002 ● Otwarty dostęp
- The jamovi project. (b.d.). Library modules. https://www.jamovi.org/modules.html ● Otwarty dostęp
- Veroniki, A. A., Jackson, D., Viechtbauer, W., Bender, R., Bowden, J., Knapp, G., Kuss, O., Higgins, J. P. T., Langan, D., & Salanti, G. (2016). Methods to estimate the between-study variance and its uncertainty in meta-analysis. Research Synthesis Methods, 7(1), 55–79. https://doi.org/10.1002/jrsm.1164 ● Otwarty dostęp
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
- Viechtbauer, W., & Cheung, M. W.-L. (2010). Outlier and influence diagnostics for meta-analysis. Research Synthesis Methods, 1(2), 112–125. https://doi.org/10.1002/jrsm.11
Cytowania BibTeX
@misc{hamiltonndmajor, author={Hamilton, W. Kyle}, title={{MAJOR: Meta-Analysis for JAMOVI – kod źródłowy i pliki definicji modułu jamovi (wersja 1.2.0)}}, howpublished={GitHub – kylehamilton/MAJOR}, year={b.d.}, url={https://github.com/kylehamilton/MAJOR}}@article{inthout2014hartung, author={IntHout, Joanna and Ioannidis, John P. A. and Borm, George F.}, title={{The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={25}, doi={10.1186/1471-2288-14-25}}@article{riley2011interpretation, author={Riley, Richard D. and Higgins, Julian P. T. and Deeks, Jonathan J.}, title={{Interpretation of random effects meta-analyses}}, journal={BMJ}, year={2011}, volume={342}, eid={d549}, doi={10.1136/bmj.d549}}@article{sterne2011recommendations, author={Sterne, Jonathan A. C. and Sutton, Alex J. and Ioannidis, John P. A. and Terrin, Norma and Jones, David R. and Lau, Joseph and Carpenter, James and Rücker, Gerta and Harbord, Roger M. and Schmid, Christopher H. and Tetzlaff, Jennifer and Deeks, Jonathan J. and Peters, Jaime and Macaskill, Petra and Schwarzer, Guido and Duval, Sue and Altman, Douglas G. and Moher, David and Higgins, Julian P. T.}, title={{Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials}}, journal={BMJ}, year={2011}, volume={343}, eid={d4002}, doi={10.1136/bmj.d4002}}@misc{jamovindmodules, author={{The jamovi project}}, title={{Library modules}}, howpublished={jamovi}, year={b.d.}, url={https://www.jamovi.org/modules.html}}@article{veroniki2016methods, author={Veroniki, Areti Angeliki and Jackson, Dan and Viechtbauer, Wolfgang and Bender, Ralf and Bowden, Jack and Knapp, Guido and Kuss, Oliver and Higgins, Julian P. T. and Langan, Dean and Salanti, Georgia}, title={{Methods to estimate the between-study variance and its uncertainty in meta-analysis}}, journal={Research Synthesis Methods}, year={2016}, volume={7}, number={1}, pages={55--79}, doi={10.1002/jrsm.1164}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}@article{viechtbauer2010outlier, author={Viechtbauer, Wolfgang and Cheung, Mike W.-L.}, title={{Outlier and influence diagnostics for meta-analysis}}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={112--125}, doi={10.1002/jrsm.11}}