Co to jest test Q Dixona?
Test Q Dixona (ang. Dixon’s Q test) sprawdza, czy jedna skrajna wartość w małej próbie z rozkładu normalnego odbiega od pozostałych bardziej, niż można by oczekiwać przypadkiem. Dean i Dixon (1951) opisali go jako prostą metodę dla małej liczby obserwacji i stał się popularny w chemii analitycznej, gdzie powtarza się zwykle kilka pomiarów. Ogólne pojęcie opisuje hasło obserwacja odstająca.
Jak go liczyć
Po uporządkowaniu wartości statystyka to iloraz luki do rozstępu: dla największej wartości Q = (x(n) − x(n−1)) / (x(n) − x(1)), a dla najmniejszej (x(2) − x(1)) / (x(n) − x(1)). Q porównuje się z wartością krytyczną dla danego n. Rorabacher (1991) podał wartości krytyczne Q i pokrewnych ilorazów dla poziomu ufności 95%; tam je odczytaj.
Przykład w R
Sześć symulowanych pomiarów to 94.2, 95.5, 100.6, 101.9, 103.0 i 115.0. Luka wynosi 12.0, a rozstęp 20.8, więc Q = 0.577. Nie podajemy p, bo wynik trzeba porównać z tabelą wartości krytycznych dla n = 6 w źródle. Gdy dodamy dwie podobne skrajne wartości (114 i 115), Q spada do 0.048: druga wartość „maskuje” pierwszą.
Na rysunku
Panel A to dane z przykładu, panel B – rozkład Q, gdy hipoteza zerowa jest prawdziwa: 100 000 prób po 6 i po 8 wartości z jednego rozkładu normalnego. Wartość krytyczna to po prostu kwantyl takiego rozkładu.
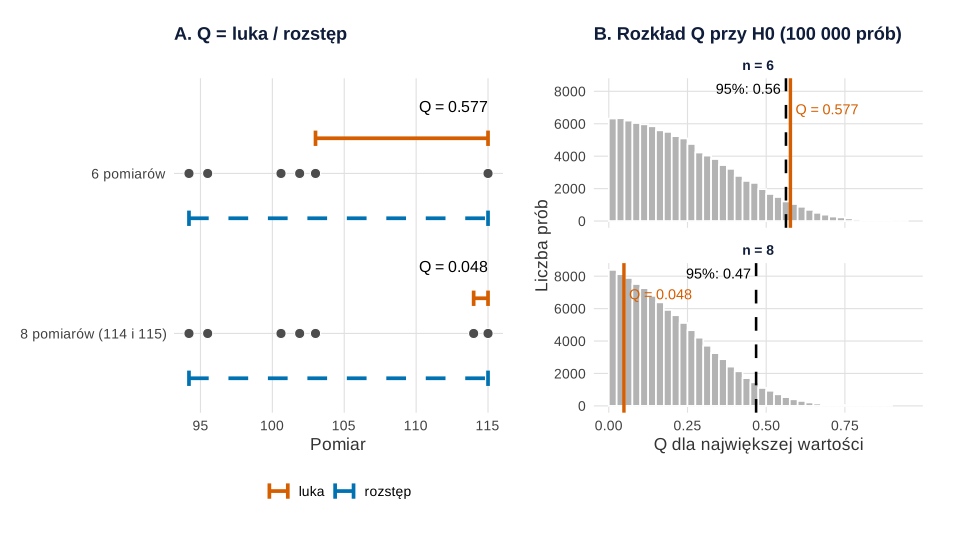
set.seed(4887) i set.seed(4888)).Co widać. Przy sześciu pomiarach luka zajmuje ponad połowę rozstępu (Q = 0.577). W symulacji 95% prób z H0 ma Q największej wartości poniżej 0.563, a wartość co najmniej 0.577 zdarza się w 4.4% prób (błąd Monte Carlo 0.06 pp). Gdy dochodzi druga skrajna wartość, luka między 114 a 115 jest mała, Q = 0.048 i leży w środku rozkładu dla n = 8 (p = .84) – to maskowanie.
Na co uważać. Ten sam wynik bywa „istotny” albo nie zależnie od wariantu testu. Jeśli z góry nie wiadomo, który koniec próby sprawdzamy, bierze się większą z dwóch luk; wtedy 95. percentyl dla n = 6 wynosi 0.626, a Q = 0.577 przekracza go w 8.7% prób. Sprawdź więc, którego wariantu dotyczy tabela. Rozkład w panelu B zakłada normalność: w danych skośnych duże Q zdarza się częściej bez żadnego błędu. Wykres nie mówi też, czy wartość jest błędem pomiaru – o tym decyduje źródło danych, nie test.
Podpis do pracy:
Kod odtwarza rysunek i liczby. Dane są te same co w przykładzie (ziarno 4887), symulacja ma własne ziarno 4888; ziaren nie dobierano, a skrypt liczy się kilka sekund. Rysunek na stronie powstał z obiektu p1 z motywem serwisu; różni się tylko krojem czcionki i siatką.
Kod R rysunku 1
# Rysunek 1. Luka i rozstęp w danych z przykładu (A) oraz rozkład Q przy H0 z symulacji (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(luka = "#D55E00", rozstep = "#0072B2")                     # Okabe–Ito

q_dixona <- function(x) { x <- sort(x); n <- length(x); (x[n] - x[n - 1]) / (x[n] - x[1]) }
set.seed(4887)                                                       # te same dane co w przykładzie hasła
x <- round(rnorm(5, mean = 100, sd = 5), 1)
x1 <- c(x, 115); x2 <- c(x, 114, 115)
round(c(Q_n6 = q_dixona(x1), Q_n8 = q_dixona(x2)), 3)

# rozkład Q przy H0 (wszystkie wartości z jednego rozkładu normalnego), 100 000 prób dla n = 6 i n = 8
set.seed(4888)
B <- 100000
sym_Q <- function(n) {
  m <- t(apply(matrix(rnorm(B * n), ncol = n), 1, sort))
  rozstep <- m[, n] - m[, 1]
  data.frame(gora = (m[, n] - m[, n - 1]) / rozstep,                 # Q dla największej wartości
             obie = pmax(m[, n] - m[, n - 1], m[, 2] - m[, 1]) / rozstep)   # Q dla bardziej odległej z dwóch skrajnych
}
q6 <- sym_Q(6); q8 <- sym_Q(8)
kwantyle <- rbind(n6_najwieksza = quantile(q6$gora, c(.90, .95, .99)), n6_dowolna_skrajna = quantile(q6$obie, c(.90, .95, .99)),
                  n8_najwieksza = quantile(q8$gora, c(.90, .95, .99)), n8_dowolna_skrajna = quantile(q8$obie, c(.90, .95, .99)))
round(kwantyle, 3)
p <- c(n6_najwieksza = mean(q6$gora >= q_dixona(x1)), n6_dowolna_skrajna = mean(q6$obie >= q_dixona(x1)),  # w x1 dolna luka jest mniejsza
       n8_najwieksza = mean(q8$gora >= q_dixona(x2)))
round(rbind(p_symulacja = p, blad_MC = sqrt(p * (1 - p) / B)), 4)

# A: wartości na osi z luką i rozstępem (wiersz 2 = 6 pomiarów, wiersz 1 = 8 pomiarów)
proby <- list("8 pomiarów (114 i 115)" = x2, "6 pomiarów" = x1)
punkty <- do.call(rbind, lapply(1:2, function(w) data.frame(wiersz = w, x = proby[[w]])))
odc <- do.call(rbind, lapply(1:2, function(w) { s <- sort(proby[[w]]); n <- length(s)
  data.frame(wiersz = w, od = c(s[1], s[n - 1]), do = s[n], co = c("rozstęp", "luka"), y = w + c(-0.28, 0.22),
             Q = (s[n] - s[n - 1]) / (s[n] - s[1])) }))
pA <- ggplot(punkty, aes(x, wiersz)) +
  geom_segment(data = odc, aes(x = od, xend = do, y = y, yend = y, colour = co, linetype = co), linewidth = 1.3,
               arrow = arrow(ends = "both", length = unit(0.08, "inches"), angle = 90)) +
  geom_point(size = 3.2, shape = 21, fill = "grey30", colour = "white", stroke = 0.6) +
  geom_text(data = subset(odc, co == "luka"), aes(x = do, y = wiersz + 0.42, label = sprintf("Q = %.3f", Q)),
            hjust = 1, size = 4.2) +
  scale_colour_manual(values = c(luka = kol[["luka"]], "rozstęp" = kol[["rozstep"]]), name = NULL) +
  scale_linetype_manual(values = c(luka = "solid", "rozstęp" = "dashed"), name = NULL) +
  scale_y_continuous(breaks = 1:2, labels = names(proby), limits = c(0.6, 2.5)) +
  labs(title = "A. Q = luka / rozstęp", x = "Pomiar", y = NULL) +
  motyw

# B: rozkład Q największej wartości przy H0 z kwantylem 95% i wartościami z przykładu
dB <- rbind(data.frame(n = "n = 6", Q = q6$gora), data.frame(n = "n = 8", Q = q8$gora))
linie <- data.frame(n = c("n = 6", "n = 8"), kw95 = c(kwantyle["n6_najwieksza", 2], kwantyle["n8_najwieksza", 2]),
                    obs = c(q_dixona(x1), q_dixona(x2)))
pB <- ggplot(dB, aes(Q)) +
  geom_histogram(binwidth = 0.025, boundary = 0, fill = "grey70", colour = "white") +
  geom_vline(data = linie, aes(xintercept = kw95), linetype = "dashed", linewidth = 0.9) +
  geom_vline(data = linie, aes(xintercept = obs), colour = kol[["luka"]], linewidth = 1.2) +
  geom_text(data = linie, aes(x = kw95, y = Inf, label = sprintf("95%%: %.2f", kw95)), vjust = 1.5, hjust = 1.08, size = 3.8) +
  geom_text(data = linie, aes(x = obs, y = Inf, label = sprintf("Q = %.3f", obs)), colour = kol[["luka"]],
            vjust = 3.5, hjust = -0.08, size = 3.8) +
  facet_wrap(~ n, ncol = 1) +
  labs(title = "B. Rozkład Q przy H0 (100 000 prób)", x = "Q dla największej wartości", y = "Liczba prób") +
  motyw
p1 <- pA + pB + plot_layout(widths = c(1, 1))
p1   # zapis: ggsave("test-q-dixona-luka-i-rozklad.svg", p1, width = 10, height = 5.6)
Wynik w R
 Q_n6  Q_n8
0.577 0.048
                     90%   95%   99%
n6_najwieksza      0.484 0.563 0.695
n6_dowolna_skrajna 0.563 0.626 0.743
n8_najwieksza      0.399 0.468 0.592
n8_dowolna_skrajna 0.467 0.526 0.635
            n6_najwieksza n6_dowolna_skrajna n8_najwieksza
p_symulacja        0.0438             0.0873        0.8414
blad_MC            0.0006             0.0009        0.0012
Dixon a Grubbs
Test Grubbsa opiera się na średniej i odchyleniu standardowym, test Dixona tylko na uporządkowanych wartościach, więc łatwo go policzyć ręcznie. Oba zakładają normalność i jedną podejrzaną obserwację.
Jak opisać w pracy
Na co uważać
- Wynik testu nie jest powodem usunięcia. Leys i in. (2019) odróżniają wartości błędne od interesujących i losowych, radzą zapisać regułę w prerejestracji i podawać wyniki z obserwacjami odstającymi i bez nich. Szerzej pisze o tym wpis czy można usunąć obserwacje odstające.
- Powtarzanie testu. Każde kolejne usunięcie zmienia poziom błędu i zmniejsza rozstęp.
- Alternatywy odporne. Przy rozkładach skośnych lepsze jest kryterium oparte na MAD.
Statystyka Q Dixona w R
Kod liczy statystykę Q dla największej wartości w małej próbie i pokazuje efekt maskowania przy dwóch podobnych skrajnych wartościach. Wartości krytycznej i p nie liczymy – odczytaj je z tabeli w źródle (Rorabacher, 1991).
Statystyka Q i maskowanie
R
q_dixona <- function(x) {                # Q dla największej wartości
  x <- sort(x); n <- length(x)
  (x[n] - x[n - 1]) / (x[n] - x[1])
}
set.seed(4887)
x <- round(rnorm(5, mean = 100, sd = 5), 1)  # 5 pomiarów, np. czas w ms
x1 <- c(x, 115)                          # jedna podejrzana wartość
sort(x1)
round(q_dixona(x1), 3)
x2 <- c(x, 114, 115)                     # dwie podobne skrajne wartości
round(q_dixona(x2), 3)                   # maskowanie: Q spada
Wynik w R
[1]  94.2  95.5 100.6 101.9 103.0 115.0
[1] 0.577
[1] 0.048
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład – bez dodatkowych pakietów). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dla jakich prób stosuje się test Q Dixona?
Przede wszystkim dla bardzo małych prób, np. kilku powtórzonych pomiarów tej samej wielkości, gdy podejrzana jest jedna wartość, a pozostałe pochodzą z rozkładu normalnego. Wartość krytyczną dla danego n odczytaj z tabeli w źródle, np. u Rorabachera (1991).
Czym test Q Dixona różni się od testu Grubbsa?
Q Dixona korzysta tylko z uporządkowanych wartości: luki i rozstępu. Test Grubbsa mierzy odległość od średniej w jednostkach odchylenia standardowego. Oba zakładają normalność i jedną podejrzaną obserwację, a przy dwóch skrajnych wartościach oba mogą ulec maskowaniu.
Czy po istotnym teście Dixona można usunąć obserwację?
Nie automatycznie. Usuń ją, jeśli potwierdzisz błąd pomiaru lub zapisu albo jeśli tak przewiduje reguła zapisana przed analizą. W pozostałych przypadkach podaj wyniki z tą obserwacją i bez niej (Leys i in., 2019).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Czy można usunąć obserwacje odstające?
Kiedy usunięcie wyniku jest uzasadnione, a kiedy staje się manipulacją: tabela decyzji, analiza wrażliwości w R i gotowy opis do pracy.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dean, R. B., & Dixon, W. J. (1951). Simplified statistics for small numbers of observations. Analytical Chemistry, 23(4), 636–638. https://doi.org/10.1021/ac60052a025
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Rorabacher, D. B. (1991). Statistical treatment for rejection of deviant values: Critical values of Dixon’s “Q” parameter and related subrange ratios at the 95% confidence level. Analytical Chemistry, 63(2), 139–146. https://doi.org/10.1021/ac00002a010
Cytowania BibTeX
@article{dean1951simplified, author={Dean, R. B. and Dixon, W. J.}, title={{Simplified statistics for small numbers of observations}}, journal={Analytical Chemistry}, year={1951}, volume={23}, number={4}, pages={636--638}, doi={10.1021/ac60052a025}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{rorabacher1991statistical, author={Rorabacher, David B.}, title={{Statistical treatment for rejection of deviant values: Critical values of Dixon’s “Q” parameter and related subrange ratios at the 95\% confidence level}}, journal={Analytical Chemistry}, year={1991}, volume={63}, number={2}, pages={139--146}, doi={10.1021/ac00002a010}}