Co sprawdza test Breslowa–Daya?
Test Breslowa–Daya sprawdza, czy iloraz szans jest taki sam we wszystkich warstwach, np. grupach wieku, ośrodkach lub szkołach. Hipoteza zerowa mówi, że OR w warstwach są jednorodne. Test uzupełnia test Cochrana–Mantela–Haenszela: CMH pyta o wspólny OR, a Breslow–Day o to, czy wspólny OR w ogóle ma sens.
W każdej warstwie porównuje się obserwowaną liczebność jednej komórki z liczebnością oczekiwaną przy wspólnym OR Mantela–Haenszela. Kwadraty różnic odniesione do wariancji sumuje się po warstwach. Przy K warstwach statystyka ma w dużych próbach rozkład χ² z K − 1 stopniami swobody. Tarone (1985) wyprowadził wersję testu opartą na estymatorze Mantela–Haenszela, dlatego programy podają też wynik „z poprawką Tarone’a”.
Przykład w R
W trzech grupach wieku OR związku ekspozycji z wynikiem wynosi 1, 2 i 5. Wspólny OR Mantela–Haenszela to 2.0 (CMH: p = .005), ale test Breslowa–Daya daje χ²(2) = 6.82, p = .033, a z poprawką Tarone’a praktycznie to samo (p = .033). Jeden OR = 2 ukrywa tu brak związku u młodszych i silny związek u najstarszych.
Jak interpretować wynik
- Wynik nieistotny – można raportować wspólny OR, ale nie dowodzi to jednorodności. Reis, Hirji i Afifi (1999) pokazali w symulacjach, że testy jednorodności OR mają małą moc przy małych warstwach, nawet przy wyraźnej niejednorodności.
- Wynik istotny – zmienna warstwująca może być modyfikatorem efektu. Podaj OR osobno w warstwach; to odpowiednik interakcji w regresji logistycznej.
- Małe liczebności – test jest asymptotyczny; w tych samych symulacjach przy małych i rzadkich danych lepiej wypadały testy dokładne.
Pojedyncze tabele 2×2 policzysz w kalkulatorze tabeli 2×2.
Na rysunku
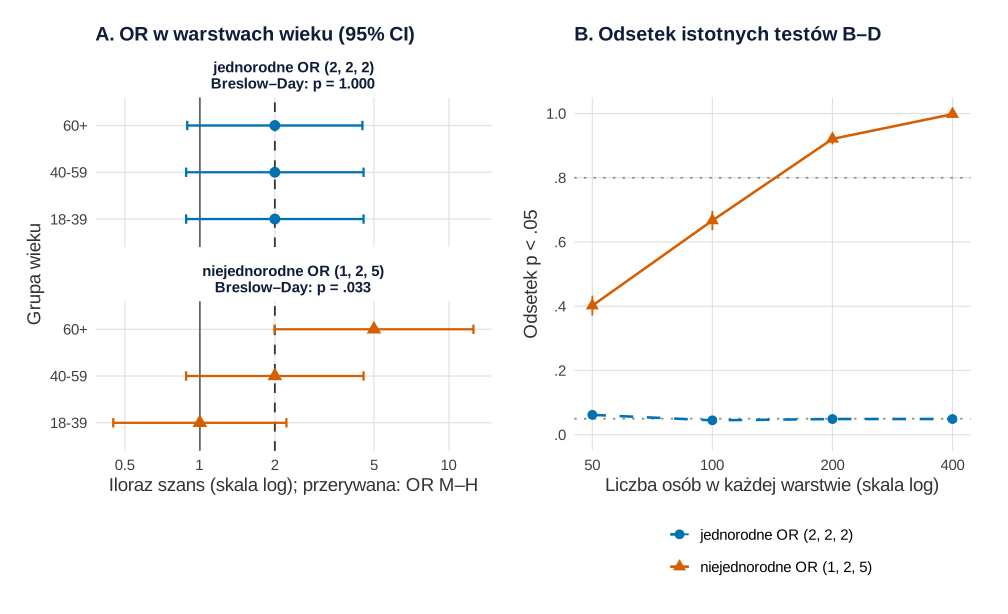
set.seed(561)).Co widać. W obu zestawach z panelu A wspólny OR Mantela–Haenszela wynosi 2, a każda warstwa ma 100 osób. Dolny zestaw to tabele z przykładu: OR 1, 2 i 5, test Breslowa–Daya p = .033. W górnym zestawie każda warstwa ma OR dokładnie 2, więc χ² = 0 i p = 1.000. Sam ORMH tych dwóch sytuacji nie odróżnia; robi to dopiero test jednorodności i wykres OR z warstw. Panel B pokazuje, jak często test wykrywa niejednorodność 1, 2, 5 w zależności od liczebności. Przy 50 osobach w warstwie był istotny w 40% symulowanych badań, przy 100 – w 67%, przy 200 – w 92%. Gdy OR są jednorodne, odsetek istotnych wyników pozostaje blisko .05 (od .045 do .062; błąd Monte Carlo ok. .007–.008).
Na co uważać. Przedziały ufności w panelu A są szerokie i nakładają się nawet przy p = .033, więc nakładanie się przedziałów nie zastępuje testu. Symulacja dotyczy jednego układu: połowa osób w warstwie eksponowana, u nieeksponowanych prawdopodobieństwo wyniku 0.5 (wybrane ręcznie), trzy warstwy o równej liczebności. Tabele z przykładu mają inne rozkłady brzegowe, a przy wielu małych warstwach moc testów jednorodności jest mała (Reis i in., 1999). Nieistotny wynik przy 50 osobach w warstwie oznacza więc zwykle za mało danych, a nie jednorodność. Zobacz też hasło wykres lasu i wpis paradoks Simpsona – wizualizacja.
Podpis do pracy:
Losuje tylko część dla panelu B; ziarno ustalono raz (set.seed(561), numer hasła). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. OR w warstwach jednorodne i niejednorodne; moc testu Breslowa–Daya a liczebność warstw
library(ggplot2)
library(patchwork)
library(DescTools)

# Paleta Okabe–Ito i prosty motyw
kol <- c("jednorodne OR (2, 2, 2)" = "#0072B2", "niejednorodne OR (1, 2, 5)" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
warstwy3 <- function(...) array(c(...), dim = c(2, 2, 3),
                                dimnames = list(ekspozycja = c("tak", "nie"), wynik = c("tak", "nie"),
                                                wiek = c("18-39", "40-59", "60+")))

# A: dwa zestawy trzech tabel 2 x 2 po 100 osób – niejednorodny z przykładu i jednorodny (OR = 2 wszędzie)
zestawy <- list("niejednorodne OR (1, 2, 5)" = warstwy3(30, 20, 30, 20,  40, 20, 20, 20,  50, 10, 20, 20),
                "jednorodne OR (2, 2, 2)"    = warstwy3(20, 20, 20, 40,  40, 20, 20, 20,  32, 16, 26, 26))
las <- do.call(rbind, lapply(names(zestawy), function(z) {
  tab <- zestawy[[z]]
  w <- t(apply(tab, 3, function(t) {
    lor <- log(t[1, 1] * t[2, 2] / (t[1, 2] * t[2, 1])); se <- sqrt(sum(1 / t))
    exp(c(OR = lor, dolna = lor - 1.96 * se, gorna = lor + 1.96 * se))
  }))
  bd <- BreslowDayTest(tab)
  data.frame(zestaw = z, wiek = rownames(w), w, OR_MH = unname(mantelhaen.test(tab)$estimate),
             chi2_BD = unname(bd$statistic), p_BD = bd$p.value)
}))
print(cbind(las[, 1:2], round(las[, -(1:2)], 3)), row.names = FALSE)
las$zestaw <- factor(las$zestaw, levels = names(kol))
las$panel <- factor(sprintf("%s\nBreslow–Day: p = %s", las$zestaw, sub("^0", "", sprintf("%.3f", las$p_BD))))
las$panel <- factor(las$panel, levels = unique(las$panel[order(las$zestaw)]))

pA <- ggplot(las, aes(OR, wiek, colour = zestaw, shape = zestaw)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_vline(aes(xintercept = OR_MH), linetype = "dashed", colour = "grey20") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.8, orientation = "y") +
  geom_point(size = 3.4) +
  facet_wrap(~ panel, ncol = 1) +
  scale_x_log10(breaks = c(0.5, 1, 2, 5, 10), labels = c("0.5", "1", "2", "5", "10")) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  labs(title = "A. OR w warstwach wieku (95% CI)", x = "Iloraz szans (skala log); przerywana: OR M–H",
       y = "Grupa wieku") +
  motyw

# B: moc testu przy prawdziwych OR 1, 2, 5 i rozmiar przy OR 2, 2, 2 – symulacja, 1000 replikacji na punkt.
# W każdej warstwie połowa osób eksponowana; P(wynik) u nieeksponowanych = 0.5 (wybrane ręcznie).
set.seed(561)
symuluj <- function(or, n) {
  p1 <- or / (1 + or); tab <- array(0, dim = c(2, 2, 3))
  for (k in 1:3) {
    a <- rbinom(1, n / 2, p1[k]); c0 <- rbinom(1, n / 2, 0.5)
    tab[, , k] <- matrix(c(a, c0, n / 2 - a, n / 2 - c0), 2)
  }
  BreslowDayTest(tab)$p.value < 0.05
}
siatka <- expand.grid(n = c(50, 100, 200, 400), zestaw = names(kol), stringsAsFactors = FALSE)
siatka$odrzucenia <- mapply(function(n, z) {
  or <- if (grepl("niejednorodne", z)) c(1, 2, 5) else c(2, 2, 2)
  mean(replicate(1000, symuluj(or, n)))
}, siatka$n, siatka$zestaw)
siatka$blad_MC <- sqrt(siatka$odrzucenia * (1 - siatka$odrzucenia) / 1000)
print(transform(siatka, odrzucenia = round(odrzucenia, 3), blad_MC = round(blad_MC, 3)), row.names = FALSE)
siatka$zestaw <- factor(siatka$zestaw, levels = names(kol))

pB <- ggplot(siatka, aes(n, odrzucenia, colour = zestaw, shape = zestaw, linetype = zestaw)) +
  geom_hline(yintercept = c(0.05, 0.80), colour = "grey55", linetype = "dotted") +
  geom_errorbar(aes(ymin = odrzucenia - 2 * blad_MC, ymax = odrzucenia + 2 * blad_MC), width = 0,
                linetype = "solid") +
  geom_line(linewidth = 0.9) + geom_point(size = 3) +
  scale_x_log10(breaks = c(50, 100, 200, 400)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) sub("^0", "", sprintf("%.1f", x))) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "B. Odsetek istotnych testów B–D", x = "Liczba osób w każdej warstwie (skala log)",
       y = "Odsetek p < .05") +
  motyw

p <- pA + pB + plot_layout(widths = c(1, 1))
p
Wynik w R
                     zestaw  wiek OR dolna  gorna OR_MH chi2_BD  p_BD
 niejednorodne OR (1, 2, 5) 18-39  1 0.449  2.226     2   6.825 0.033
 niejednorodne OR (1, 2, 5) 40-59  2 0.881  4.541     2   6.825 0.033
 niejednorodne OR (1, 2, 5)   60+  5 1.994 12.538     2   6.825 0.033
    jednorodne OR (2, 2, 2) 18-39  2 0.881  4.541     2   0.000 1.000
    jednorodne OR (2, 2, 2) 40-59  2 0.881  4.541     2   0.000 1.000
    jednorodne OR (2, 2, 2)   60+  2 0.890  4.495     2   0.000 1.000
   n                     zestaw odrzucenia blad_MC
  50    jednorodne OR (2, 2, 2)      0.062   0.008
 100    jednorodne OR (2, 2, 2)      0.045   0.007
 200    jednorodne OR (2, 2, 2)      0.049   0.007
 400    jednorodne OR (2, 2, 2)      0.049   0.007
  50 niejednorodne OR (1, 2, 5)      0.402   0.016
 100 niejednorodne OR (1, 2, 5)      0.667   0.015
 200 niejednorodne OR (1, 2, 5)      0.921   0.009
 400 niejednorodne OR (1, 2, 5)      0.998   0.001
Jak opisać w pracy
Podaj statystykę χ², liczbę stopni swobody, wartość p i OR z każdej warstwy, a nie tylko wspólny OR.
Test Breslowa–Daya w R
Kod liczy OR w trzech warstwach, wspólny OR i test CMH funkcją bazową mantelhaen.test() oraz test Breslowa–Daya funkcją BreslowDayTest() z pakietu DescTools – bez poprawki i z poprawką Tarone’a.
Jednorodność OR w trzech grupach wieku
R
# Test Breslowa–Daya: czy OR są takie same we wszystkich warstwach?
library(DescTools)
tab <- array(c(30, 20, 30, 20,     # warstwa 1: OR = 1.0
               40, 20, 20, 20,     # warstwa 2: OR = 2.0
               50, 10, 20, 20),    # warstwa 3: OR = 5.0
             dim = c(2, 2, 3),
             dimnames = list(ekspozycja = c("tak", "nie"),
                             wynik = c("tak", "nie"),
                             wiek = c("18-39", "40-59", "60+")))
or_w <- apply(tab, 3, function(t) t[1, 1] * t[2, 2] / (t[1, 2] * t[2, 1]))
round(or_w, 2)                                    # OR w warstwach
mh <- mantelhaen.test(tab)
round(c(OR_MH = unname(mh$estimate), p_CMH = mh$p.value), 3)
BreslowDayTest(tab)                               # jednorodność OR
BreslowDayTest(tab, correct = TRUE)               # z poprawką Tarone'a
Wynik w R
18-39 40-59   60+
    1     2     5
OR_MH p_CMH
2.000 0.005

	Breslow-Day test on Homogeneity of Odds Ratios

data:  tab
X-squared = 6.8249, df = 2, p-value = 0.03296


	Breslow-Day Test on Homogeneity of Odds Ratios (with Tarone correction)

data:  tab
X-squared = 6.8176, df = 2, p-value = 0.03308
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools 0.99.60. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Breslowa–Daya różni się od testu CMH?
Test CMH sprawdza, czy wspólny iloraz szans różni się od 1. Test Breslowa–Daya sprawdza wcześniejsze pytanie: czy ilorazy szans w warstwach są na tyle podobne, że jeden wspólny OR dobrze je opisuje. W przykładzie CMH był istotny (p = .005), ale OR w warstwach wynosiły 1, 2 i 5.
Czy nieistotny test Breslowa–Daya dowodzi jednorodności OR?
Nie. Przy małych warstwach testy jednorodności mają małą moc, nawet gdy OR wyraźnie się różnią (Reis i in., 1999). Zawsze pokaż OR z poszczególnych warstw i oceń, czy różnice są ważne merytorycznie.
Co to jest poprawka Tarone’a w teście Breslowa–Daya?
To modyfikacja statystyki wynikająca z tego, że w teście używa się estymatora Mantela–Haenszela zamiast estymatora największej wiarygodności. Zwykle zmienia wynik nieznacznie – w przykładzie χ² spadło z 6.825 do 6.818. Wiele programów podaje obie wersje.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Reis, I. M., Hirji, K. F., & Afifi, A. A. (1999). Exact and asymptotic tests for homogeneity in several 2×2 tables. Statistics in Medicine, 18(8), 893–906. https://doi.org/10.1002/(sici)1097-0258(19990430)18:8<893::aid-sim84>3.0.co;2-5
- Tarone, R. E. (1985). On heterogeneity tests based on efficient scores. Biometrika, 72(1), 91–95. https://doi.org/10.1093/biomet/72.1.91
Cytowania BibTeX
@article{reis1999exact, author={Reis, Isildinha M. and Hirji, Karim F. and Afifi, Abdelmonem A.}, title={{Exact and asymptotic tests for homogeneity in several 2×2 tables}}, journal={Statistics in Medicine}, year={1999}, volume={18}, number={8}, pages={893--906}, doi={10.1002/(sici)1097-0258(19990430)18:8<893::aid-sim84>3.0.co;2-5}}@article{tarone1985heterogeneity, author={Tarone, Robert E.}, title={{On heterogeneity tests based on efficient scores}}, journal={Biometrika}, year={1985}, volume={72}, number={1}, pages={91--95}, doi={10.1093/biomet/72.1.91}}