Kim był William G. Cochran?
William Gemmell Cochran (1909–1980) był szkockim statystykiem, który większość kariery spędził w Stanach Zjednoczonych, autor klasycznych podręczników planowania doświadczeń i metody reprezentacyjnej. Urodził się 15 lipca 1909 r. w Rutherglen koło Glasgow w skromnej rodzinie; studia opłaciły mu wygrane stypendia. W 1931 r. ukończył w Glasgow matematykę i fizykę (M.A.) i wyjechał do St John’s College w Cambridge, gdzie słuchał wykładu Johna Wisharta (Hansen i Mosteller, 1987).
W 1934 r. przeszedł do stacji doświadczalnej Rothamsted, w 1939 r. – do Iowa State College w Ames, w latach 1943–1944 pracował dla wojska w grupie badań statystycznych w Princeton, w 1946 r. przeszedł do North Carolina State College, w 1949 r. objął katedrę biostatystyki Johns Hopkins University, a w latach 1957–1976 pracował na Harvardzie. Zmarł 29 marca 1980 r. w Orleans w stanie Massachusetts (Hansen i Mosteller, 1987; Yates, 1982).
Najważniejsze pomysły
- Twierdzenie Cochrana (1934). Jeszcze w Cambridge udowodnił, kiedy części, na które rozkłada się suma kwadratów niezależnych zmiennych normalnych, mają rozkłady chi-kwadrat i są od siebie niezależne. Na tym wyniku opiera się podział zmienności w analizie wariancji (Hansen i Mosteller, 1987; Yates, 1982).
- Planowanie doświadczeń. W Rothamsted razem z Frankiem Yatesem rozwijał pomysły Fishera – układy czynnikowe, kraty, serie doświadczeń. Z Gertrude Cox napisał podręcznik „Experimental Designs” (Cochran i Cox, 1950).
- Dane liczebnościowe. Zaproponował test Q do porównywania odsetków w próbach zależnych (Cochran, 1950), a w pracy o wzmacnianiu testów chi-kwadrat (Cochran, 1954) wyprowadził w dodatku metodę łączenia kilku tabel 2 × 2, nazywaną dziś metodą Mantela–Haenszela (Hansen i Mosteller, 1987) – stąd test Cochrana–Mantela–Haenszela.
- Metoda reprezentacyjna. W 1936 r. przeanalizował eksperyment, w którym żaden z 12 obserwatorów nie zdołał wybrać „na oko” próby reprezentatywnej, i pokazał przewagę losowania; w 1942 r. zbadał estymator regresyjny, który wykorzystuje znaną dla całej populacji zmienną pomocniczą. „Sampling Techniques” (1953; wyd. 3 – 1977) stał się najpopularniejszym podręcznikiem badań reprezentacyjnych (Hansen i Mosteller, 1987).
Ciekawostka
Doktor, który nie zrobił doktoratu. Na początku 1934 r. Frank Yates, nowy kierownik działu statystyki w Rothamsted, wywalczył etat asystenta i zaproponował go Cochranowi pod warunkiem, że przyjdzie od razu. Uniwersytet wymagał zamieszkania na miejscu, więc przyjęcie posady oznaczało porzucenie doktoratu; Yates pisał później z humorem, że był to dowód rozsądku Cochrana, a może i jego własnej siły perswazji (Yates, 1982). Cochran nigdy nie uzyskał doktoratu w zwykłym trybie – dostał tylko doktoraty honorowe w Glasgow (1970) i Johns Hopkins (1975) (Hansen i Mosteller, 1987).
Brak dyplomu wrócił przy wyjeździe do USA. Według Yatesa (1982) Cochran przyjął w 1938 r. ofertę z Ames, w ostatniej chwili wycofał się z powodów patriotycznych przed spodziewaną wojną i wyjechał latem 1939 r., gdy ofertę ponowiono; brak doktoratu u obu panów budził w Ames konsternację. Hansen i Mosteller (1987) opisują to łagodniej: wahał się, ale uznał, że musi dotrzymać słowa.
Przykład na historycznych danych
Pakiet boot zawiera zbiór bigcity z podręcznika Cochrana (1977): ludność 49 miast USA w 1920 i 1930 r. (w tysiącach), wylosowanych z 196 największych miast z 1920 r.; zbiór city to pierwsze 10 z nich. Traktujemy 49 miast jak populację i szacujemy średnią ludność z 1930 r. z próby 10 miast, znając dane z 1920 r. dla wszystkich. Prawdziwa średnia wynosi 127.8 tys., a korelacja ludności w obu latach r = .982.
Porównujemy trzy estymatory: zwykłą średnią z próby, estymator ilorazowy (iloraz ludności 1930/1920 z próby razy znana średnia z 1920 r.) i estymator regresyjny. Dla 10 miast ze zbioru city dają 97.3, 156.8 i 138.3 tys. W 10 000 losowych prób po 10 miast (ziarno 1909) odchylenie standardowe oszacowań wyniosło 34.90 tys. dla średniej z próby, 8.00 dla estymatora ilorazowego i 9.43 dla regresyjnego; obciążenie – odpowiednio 0.11, 0.80 i −2.80 tys. Przybliżone wzory na błąd standardowy dały 34.73, 7.03 i 6.61, czyli przy dziesięciu miastach zaniżają błąd, zwłaszcza estymatora regresyjnego. Cochran wykazał, że wzór dla estymatora regresyjnego jest poprawny asymptotycznie, w dużych próbach (Hansen i Mosteller, 1987).
Estymatorem ilorazowym szacował w 1802 r. ludność Francji z urodzeń Laplace; Cochran opisał to w artykule z 1978 r. (Hansen i Mosteller, 1987).
Na rysunku
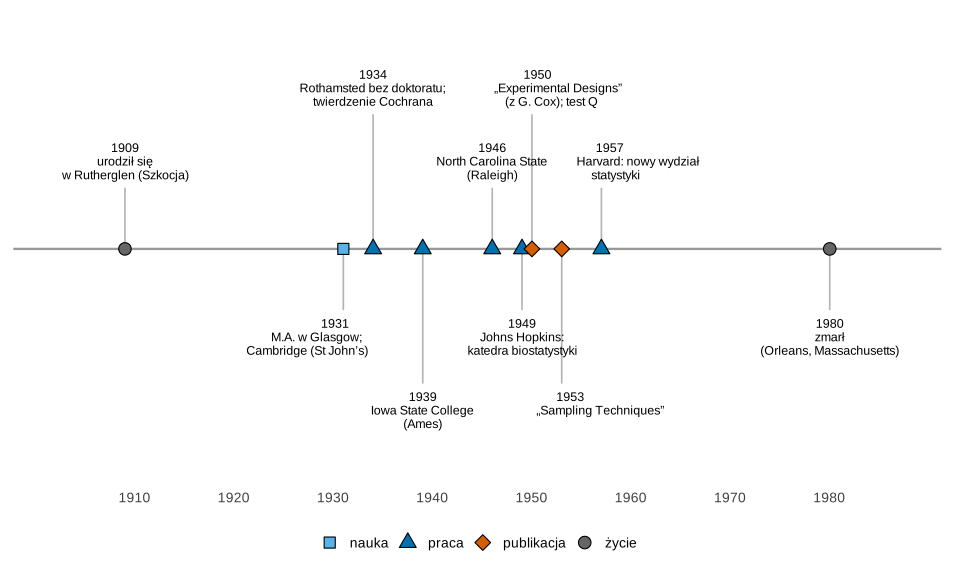
Co widać. Oba podręczniki powstały z wykładów, które Cochran zaczął w Ames w 1939 r. (Hansen i Mosteller, 1987), a ukazały się dopiero po dekadzie.
Na co uważać. Źródła różnią się w szczegółach: Hansen i Mosteller (1987) datują pracę w Princeton na lata 1943–1944, Yates (1982) – na 1944 r.
Podpis do pracy:
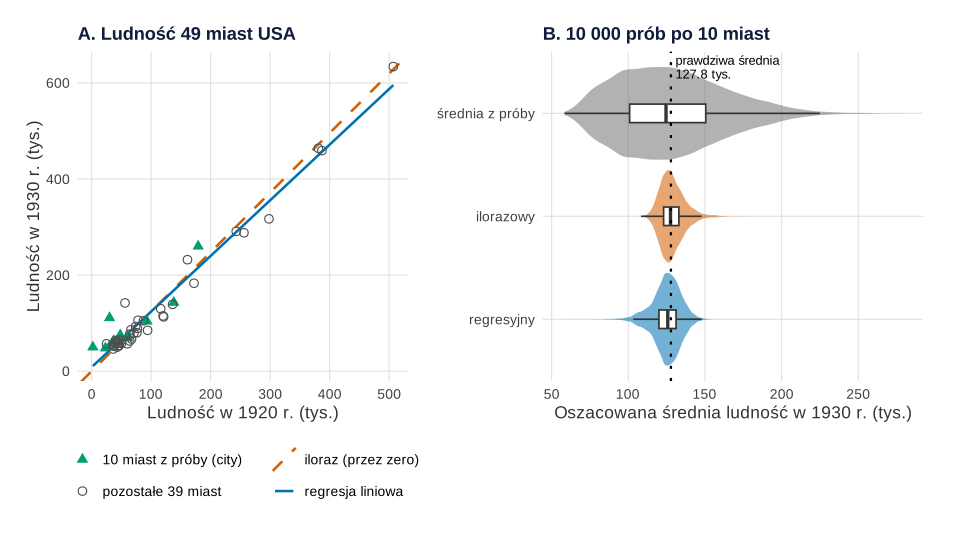
Co widać. Na panelu A ludność z 1930 r. jest prawie proporcjonalna do ludności z 1920 r. Na panelu B oba estymatory korzystające z tej informacji dają rozkład kilka razy węższy niż zwykła średnia z próby.
Na co uważać. Oba estymatory są w małych próbach lekko obciążone, a zysk wymaga silnego związku zmiennej badanej z pomocniczą. Symulacja dotyczy tylko tej populacji i prób po 10 miast.
Podpis do pracy:
Gdzie spotkasz Cochrana w swojej pracy
- Gdy te same osoby odpowiadają „tak/nie” w kilku warunkach, liczysz test Q Cochrana; gdy związek w tabeli 2 × 2 sprawdzasz osobno w warstwach (np. w kilku szkołach), sięgasz po test CMH.
- Ostrzeżenia przed testem chi-kwadrat przy małych liczebnościach w komórkach mają źródło m.in. w regułach, które Cochran podał w pracach z 1952 i 1954 r. (Hansen i Mosteller, 1987).
- Planując ankietę, korzystasz z logiki „Sampling Techniques”: błąd oszacowania zależy od liczebności próby, wielkości populacji i zmienności cechy, a próba losowa chroni przed obciążeniem, którego nie usunie żaden wzór (zob. liczebność próby w ankiecie). Losowanie warstwowe i alokację pokazuje hasło o Jerzym Neymanie.
- Planując badanie obserwacyjne, zadaj pytanie, które Cochran przypominał za Haroldem Dornem: jak wyglądałoby to badanie jako kontrolowany eksperyment (Hansen i Mosteller, 1987)?
Spory, mity i trudne strony
- Czyja jest metoda Mantela–Haenszela? Cochran wyprowadził ją w dodatku pracy z 1954 r.; dziś nosi ona nazwiska Mantela i Haenszela, a test – nazwiska wszystkich trzech. Sam powtarzał, że badacze zasługują na więcej uznania za wyniki publikowane przez innych, a na mniej za własne, bo pomysły długo krążą, zanim ktoś je spisze (Hansen i Mosteller, 1987).
- Palenie i statystyka. W 1964 r. Cochran był członkiem komitetu, który przygotował raport Surgeon Generala „Smoking and Health” (Yates, 1982) – według Hansena i Mostellera (1987) jedynym statystykiem w tym komitecie i zarazem palaczem. Wcześniej z Johnem Tukeyem i Frederickiem Mostellerem ocenił metodologię raportów Kinseya (Yates, 1982).
Estymator ilorazowy Cochrana w R
Kod wczytuje zbiór bigcity z pakietu boot, porównuje trzy oszacowania średniej ludności z 1930 r. dla próby city, powtarza losowanie 10 000 razy (ziarno 1909), zestawia wynik z przybliżonymi wzorami na błąd standardowy i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. Trzy estymatory średniej: rysunek 2
Kod R rysunku 2
# William G. Cochran: estymator ilorazowy i regresyjny na danych z „Sampling Techniques” (Cochran, 1977; boot::bigcity)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(prosta = "grey45", ilorazowy = "#D55E00", regresyjny = "#0072B2", proba = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(bigcity, package = "boot")      # 49 miast USA: u – ludność w 1920 r., x – w 1930 r. (w tysiącach)
miasta <- bigcity
N <- nrow(miasta); n <- 10           # populacja 49 miast, próba 10 miast bez zwracania
sr_1920 <- mean(miasta$u)            # znana dla wszystkich miast (zmienna pomocnicza)
prawda  <- mean(miasta$x)            # to chcemy oszacować: średnia ludność w 1930 r.
round(c(N = N, srednia_1920 = sr_1920, srednia_1930 = prawda, r = cor(miasta$u, miasta$x)), 3)

# Trzy oszacowania średniej z 1930 r. na podstawie próby i
oszacuj <- function(i) {
  u <- miasta$u[i]; x <- miasta$x[i]
  b <- unname(coef(lm(x ~ u))[2])
  c(prosta     = mean(x),                          # średnia z próby (bez informacji pomocniczej)
    ilorazowy  = mean(x) / mean(u) * sr_1920,      # iloraz 1930/1920 z próby × znana średnia z 1920 r.
    regresyjny = mean(x) + b * (sr_1920 - mean(u)))  # estymator regresyjny (Cochran, 1942)
}
round(oszacuj(1:10), 1)              # pierwsze 10 miast – próba z pakietu boot (zbiór city)

# 10 000 losowych prób po 10 miast: obciążenie, rozrzut i średni błąd kwadratowy oszacowań
set.seed(1909)
sym <- t(replicate(10000, oszacuj(sample(N, n))))
wyniki <- data.frame(srednia = colMeans(sym), obciazenie = colMeans(sym) - prawda,
                     SD = apply(sym, 2, sd), RMSE = sqrt(colMeans((sym - prawda)^2)))
round(wyniki, 2)

# Przybliżone błędy standardowe ze wzorów z podręcznika Cochrana (z poprawką na skończoną populację)
f <- n / N; R <- prawda / sr_1920; rho <- cor(miasta$u, miasta$x)
round(c(prosta     = sqrt((1 - f) / n * var(miasta$x)),
        ilorazowy  = sqrt((1 - f) / n * sum((miasta$x - R * miasta$u)^2) / (N - 1)),
        regresyjny = sqrt((1 - f) / n * var(miasta$x) * (1 - rho^2))), 2)

# Rysunek 2A: 49 miast, prosta ilorazu (przez zero) i prosta regresji
miasta$w_probie <- factor(seq_len(N) <= 10, levels = c(TRUE, FALSE), labels = c("10 miast z próby (city)", "pozostałe 39 miast"))
pA <- ggplot(miasta, aes(u, x)) +
  geom_abline(aes(intercept = 0, slope = R, linetype = "iloraz (przez zero)"), colour = oi[["ilorazowy"]], linewidth = 0.9) +
  geom_smooth(aes(linetype = "regresja liniowa"), method = "lm", formula = y ~ x, se = FALSE,
              colour = oi[["regresyjny"]], linewidth = 0.9) +
  geom_point(aes(shape = w_probie, colour = w_probie), size = 2.6) +
  scale_shape_manual(values = c(17, 1), name = NULL) +
  scale_colour_manual(values = c(oi[["proba"]], "grey30"), name = NULL) +
  scale_linetype_manual(values = c("iloraz (przez zero)" = "dashed", "regresja liniowa" = "solid"), name = NULL) +
  labs(title = "A. Ludność 49 miast USA", x = "Ludność w 1920 r. (tys.)", y = "Ludność w 1930 r. (tys.)") +
  guides(shape = guide_legend(nrow = 2), colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  motyw
# Rysunek 2B: rozkład 10 000 oszacowań każdym estymatorem
dl <- data.frame(estymator = factor(rep(colnames(sym), each = nrow(sym)), levels = c("regresyjny", "ilorazowy", "prosta")),
                 oszacowanie = as.vector(sym))
pB <- ggplot(dl, aes(oszacowanie, estymator, fill = estymator)) +
  geom_violin(scale = "width", colour = NA, alpha = 0.55) +
  geom_boxplot(width = 0.18, outlier.shape = NA, fill = "white") +
  geom_vline(xintercept = prawda, linetype = "dotted", linewidth = 0.8) +
  annotate("text", x = prawda + 3, y = 3.45, label = sprintf("prawdziwa średnia\n%.1f tys.", prawda), hjust = 0, size = 3.4, lineheight = 0.9) +
  scale_fill_manual(values = c(prosta = oi[["prosta"]], ilorazowy = oi[["ilorazowy"]], regresyjny = oi[["regresyjny"]])) +
  scale_y_discrete(labels = c(prosta = "średnia z próby", ilorazowy = "ilorazowy", regresyjny = "regresyjny")) +
  labs(title = "B. 10 000 prób po 10 miast", x = "Oszacowana średnia ludność w 1930 r. (tys.)", y = NULL) +
  guides(fill = "none") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
           N srednia_1920 srednia_1930            r
      49.000      103.143      127.796        0.982
    prosta  ilorazowy regresyjny
      97.3      156.8      138.3
           srednia obciazenie    SD  RMSE
prosta       127.9       0.11 34.90 34.90
ilorazowy    128.6       0.80  8.00  8.04
regresyjny   125.0      -2.80  9.43  9.84
    prosta  ilorazowy regresyjny
     34.73       7.03       6.61
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: William G. Cochran, 1909–1980 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1909, 1931, 1934, 1939, 1946, 1949, 1950, 1953, 1957, 1980),
  opis = c("urodził się\nw Rutherglen (Szkocja)", "M.A. w Glasgow;\nCambridge (St John’s)",
           "Rothamsted bez doktoratu;\ntwierdzenie Cochrana", "Iowa State College\n(Ames)",
           "North Carolina State\n(Raleigh)", "Johns Hopkins:\nkatedra biostatystyki",
           "„Experimental Designs”\n(z G. Cox); test Q", "„Sampling Techniques”",
           "Harvard: nowy wydział\nstatystyki", "zmarł\n(Orleans, Massachusetts)"),
  rodzaj = c("życie", "nauka", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "praca", "życie"))
# Gęste lata 1931–1957: etykiety na przemian nad (1) i pod (−1) osią, na dwóch wysokościach
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, -1)
zdarzenia$poziom     <- c(0.5, 0.5, 1.1, 1.1, 0.5, 0.5, 1.1, 1.1, 0.5, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.8, 0.5, 0.5, 0.5, 0.5, 0.3, 0.2, 0.2, 0.5)
ksztalty <- c("życie" = 21, "nauka" = 22, "praca" = 24, "publikacja" = 23)
kolory <- c("życie" = "grey40", "nauka" = "#56B4E9", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1902, 1987), breaks = seq(1910, 1980, by = 10)) +
  scale_y_continuous(limits = c(-1.75, 1.75)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja – funkcja lm() z pakietu stats; dane – pakiet boot; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był William G. Cochran?
Szkockim statystykiem (1909–1980) urodzonym w Rutherglen. Po studiach w Glasgow i Cambridge pracował w stacji doświadczalnej Rothamsted (1934–1939), a potem w USA: w Iowa State, North Carolina State, Johns Hopkins i od 1957 r. na Harvardzie (Hansen i Mosteller, 1987).
Dlaczego Cochran nie miał doktoratu?
W 1934 r. Frank Yates zaproponował mu etat w Rothamsted pod warunkiem natychmiastowego przyjścia, a doktorat w Cambridge wymagał zamieszkania przy uczelni, więc Cochran go porzucił (Yates, 1982). Zwykłego doktoratu nigdy nie uzyskał – dostał tylko doktoraty honorowe w Glasgow (1970) i Johns Hopkins (1975).
Co to jest twierdzenie Cochrana?
Wynik z 1934 r. o rozkładzie form kwadratowych: jeśli sumę kwadratów niezależnych zmiennych normalnych rozłożyć na części o rzędach sumujących się do liczby zmiennych, to części mają rozkłady chi-kwadrat i są niezależne. Uzasadnia podział zmienności w analizie wariancji (Hansen i Mosteller, 1987).
Czym jest estymator ilorazowy z podręcznika Cochrana?
Oszacowaniem średniej, które mnoży iloraz dwóch cech z próby przez znaną średnią cechy pomocniczej w populacji. W przykładzie z 49 miastami USA zmniejszył odchylenie standardowe oszacowań średniej ludności z 34.90 tys. (zwykła średnia z 10 miast) do 8.00 tys.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikSchematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cochran, W. G. (1950). The comparison of percentages in matched samples. Biometrika, 37(3–4), 256–266. https://doi.org/10.1093/biomet/37.3-4.256
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). Wiley.
- Cochran, W. G., & Cox, G. M. (1950). Experimental designs. Wiley.
- Hansen, M., & Mosteller, F. (1987). William Gemmell Cochran 1909–1980. In Biographical memoirs (Vol. 56) (pp. 60–89). National Academy Press. https://www.nasonline.org/wp-content/uploads/2024/06/cochran-william-g.pdf
- Yates, F. (1982). Obituary: William Gemmell Cochran, 1909–1980. Journal of the Royal Statistical Society. Series A (General), 145(4), 521–523. https://repository.rothamsted.ac.uk/id/eprint/23994/ ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cochran1950comparison, author={Cochran, William G.}, title={{The comparison of percentages in matched samples}}, journal={Biometrika}, year={1950}, volume={37}, number={3–4}, pages={256--266}, doi={10.1093/biomet/37.3-4.256}}@article{cochran1954some, author={Cochran, William G.}, title={{Some methods for strengthening the common χ² tests}}, journal={Biometrics}, year={1954}, volume={10}, number={4}, pages={417--451}, doi={10.2307/3001616}}@book{cochran1977sampling, author={Cochran, William G.}, title={{Sampling techniques}}, year={1977}, edition={3}, publisher={Wiley}, url={https://lccn.loc.gov/77000728}}@book{cochran1950experimental, author={Cochran, William G. and Cox, Gertrude M.}, title={{Experimental designs}}, year={1950}, publisher={Wiley}}@incollection{hansen1987william, author={Hansen, Morris and Mosteller, Frederick}, title={{William Gemmell Cochran 1909–1980}}, booktitle={Biographical memoirs (Vol. 56)}, year={1987}, pages={60--89}, publisher={National Academy Press}, url={https://www.nasonline.org/wp-content/uploads/2024/06/cochran-william-g.pdf}}@article{yates1982obituary, author={Yates, Frank}, title={{Obituary: William Gemmell Cochran, 1909–1980}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1982}, volume={145}, number={4}, pages={521--523}, url={https://repository.rothamsted.ac.uk/id/eprint/23994/}}