Kim był John W. Tukey?
John Wilder Tukey (1915–2000) był amerykańskim statystykiem i matematykiem, który nauczył statystyków patrzeć na dane, zanim zaczną je testować. Urodził się 16 czerwca 1915 r. w New Bedford w stanie Massachusetts. Na Brown University ukończył studia licencjackie i magisterskie z chemii (1936 i 1937), a w 1939 r. obronił w Princeton doktorat z matematyki (Fernholz i Morgenthaler, 2000). Z wykształcenia był więc chemikiem, a z doktoratu – topologiem (McCullagh, 2003).
W czasie II wojny światowej pracował w Princeton przy projektach dotyczących kierowania ogniem. Od 1945 r. łączył dwie posady: profesora w Princeton (profesorem zwyczajnym został w wieku 35 lat) i badacza w Bell Telephone Laboratories. Od 1956 r. kierował w Princeton grupą Statistical Research Group, a gdy w 1965 r. powstał tam wydział statystyki, został jego pierwszym kierownikiem (do 1970 r.). Na emeryturę przeszedł w 1985 r. z obu instytucji. Doradzał prezydentom USA od Eisenhowera do Nixona, a w 1973 r. otrzymał National Medal of Science (Fernholz i Morgenthaler, 2000; McCullagh, 2003). Zmarł 26 lipca 2000 r.
Najważniejsze pomysły
- Eksploracyjna analiza danych (EDA). Książka Exploratory Data Analysis (Tukey, 1977) zaczyna się od wykresu łodygowo-liściowego, potem omawia podsumowanie pięcioma liczbami z „zawiasami” (ang. hinges), wykres pudełkowy (ang. box-and-whisker plot), „płoty” i wartości leżące poza nimi oraz proste przekształcenia danych (logarytmy, pierwiastki), także dla zliczeń. McCullagh (2003) zauważa, że Tukey promował EDA, gdy nie była ona jeszcze akademicko szanowana.
- Porównania wielokrotne. W 1949 r. zaproponował procedurę dzielenia średnich z ANOVA na grupy, gdy test F mówi tylko, że nie wszystkie średnie są równe (Tukey, 1949). Jego nazwisko nosi dziś test HSD – popularny test post hoc.
- Metody odporne. Prowadził – jak pisze McCullagh (2003) – krucjatę na rzecz metod odpornych na obserwacje odstające. Rozwinął też jackknife jako ogólną metodę szacowania wariancji.
- Analiza sygnałów. Spopularyzował analizę spektralną szeregów czasowych i współtworzył algorytm szybkiej transformaty Fouriera (FFT).
- Słowa. W Bell Labs ukuł słowa „bit” (od binary digit) i „software” (McCullagh, 2003).
Przykład na historycznych danych
Zbiór InsectSprays z pakietu datasets to liczby owadów na 72 poletkach doświadczalnych, po 12 na każdy z sześciu środków owadobójczych (A–F). Według pliku pomocy dane pochodzą z artykułu G. Bealla w Biometrice z 1942 r. o przekształcaniu danych z doświadczeń entomologicznych. To dobry materiał na EDA: małe liczby całkowite, kilka grup, nierówne rozrzuty.
Pięć liczb Tukeya (fivenum()) pokazuje dwie rodziny środków. Po A, B i F mediana wynosi 14–16.5 owada, a rozstęp między zawiasami 6–11; po C, D i E mediana to 1.5–5, a rozstęp 1.5–2.5. Rozrzut rośnie razem z poziomem – typowe dla zliczeń. Płoty 1.5 × długość pudełka wskazują dwie wartości poza nimi: 7 owadów po środku C i 12 po środku D. Dlatego ANOVA liczymy na pierwiastku z liczby owadów: F(5, 66) = 44.8, p < .001. Test HSD Tukeya wskazuje różnicę w 10 z 15 par: każdy środek z grupy A, B, F różni się od każdego z grupy C, D, E, a w obrębie tych grup tylko C i D (różnica 0.92 na skali pierwiastka, p = .008). Nie twierdzimy, że Tukey analizował te dane – to nasza analiza w jego stylu.
Na rysunku
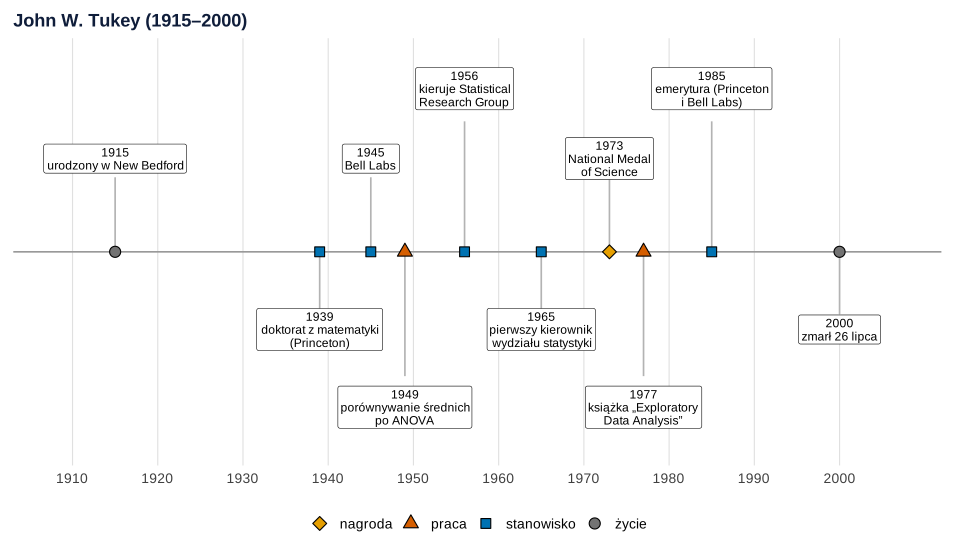
Co widać. Kariera Tukeya biegła dwoma torami naraz: uniwersytet w Princeton i laboratoria Bell od 1945 r. aż do wspólnej emerytury w 1985 r. Najbardziej znane studentom prace – porównania średnich i EDA – dzieli prawie 30 lat.
Na co uważać. To wybór dziesięciu zdarzeń, a nie pełny życiorys: pomija pracę wojenną, doradztwo rządowe i dziesiątki artykułów. Rok przy pomyśle to rok publikacji, nie powstania idei.
Podpis do pracy:
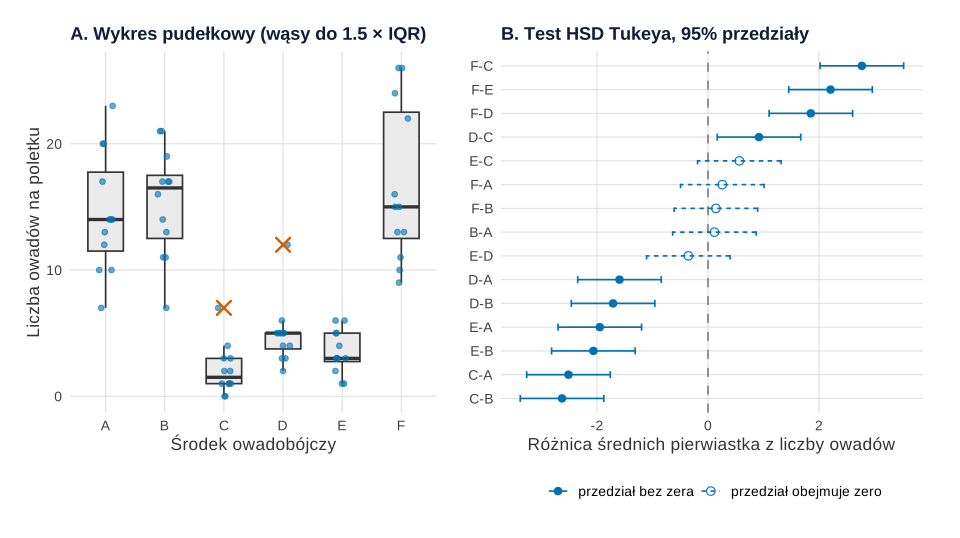
datasets::InsectSprays (Beall, 1942, według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork; rozrzut punktów w poziomie losowy (seed = 808).Co widać. Na panelu A pudełka pokazują to, co Tukey uważał za pierwszy krok analizy: położenie, rozrzut i wartości nietypowe w każdej grupie. Krzyżyk oznacza wartość poza płotem 1.5 × IQR (liczonym z zawiasów, jak w boxplot()). Na panelu B przedziały HSD dzielą środki na dwie rodziny; w obrębie każdej różni się tylko para D–C.
Na co uważać. Wartość poza płotem to sygnał „przyjrzyj się”, a nie wyrok „usuń”. Przy 12 obserwacjach w grupie jedno nietypowe poletko łatwo przesuwa zawias. HSD na pierwiastku porównuje średnie pierwiastków, a nie średnie liczby owadów – napisz to w opisie.
Podpis do pracy:
Gdzie spotkasz Tukeya w swojej pracy
- Statystyki opisowe. Mediana, kwartyle i rozstęp ćwiartkowy w tabeli i wykres pudełkowy obok – to schemat z rozdziału 2 książki z 1977 r.
- Wartości odstające. Reguła 1.5 × IQR, którą programy stosują domyślnie, pochodzi z „płotów” Tukeya. Co z takimi wynikami zrobić, opisuje wpis Wartości odstające: jak je wykryć.
- Post hoc po ANOVA. Test HSD w SPSS, jamovi i R (
TukeyHSD()). - Testy nieparametryczne. Test Siegela–Tukeya porównuje rozrzut w dwóch grupach.
Spory, mity i trudne strony
„Tukey wymyślił wykres pudełkowy”. Upowszechnił go książką z 1977 r. i to jego wersja z płotami 1.5 × IQR stała się standardem. Kto pierwszy narysował podobny wykres, w naszych źródłach nie rozstrzygamy.
„1.5 × IQR to granica błędu”. Płot to umowny próg do oglądania danych, a nie test statystyczny. W dużej próbie nawet z rozkładu normalnego część wartości wypadnie poza płoty.
„Zawiasy to kwartyle”. Prawie, ale nie zawsze: fivenum() liczy zawiasy Tukeya, a quantile() domyślnie nieco inne kwartyle. W małych próbach różnica jest widoczna – po środku A zawiasy wynoszą 11 i 18.5, a kwartyle 11.5 i 17.75. Funkcja boxplot() rysuje pudełka z zawiasów, a ggplot2 – z kwartyli, więc ten sam zbiór może dać dwa nieco różne pudełka.
„Test HSD pochodzi z pracy z 1949 roku”. Artykuł z 1949 r. opisuje procedurę dzielenia średnich na grupy rozróżnialne, a nie test HSD w dzisiejszej postaci – nie cytuj go jako źródła HSD bez sprawdzenia.
Tukey w R
Kod rysuje oś czasu, liczy pięć liczb Tukeya, wykres łodygowo-liściowy, wartości poza płotami, ANOVA na pierwiastku z liczby owadów i test HSD. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu, EDA i test HSD na danych InsectSprays
Kod R rysunków 1 i 2
# John W. Tukey: oś czasu, wykres pudełkowy z płotami 1.5 × IQR i test HSD na danych InsectSprays
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Fernholz i Morgenthaler 2000 oraz McCullagh 2003)
zdarzenia <- data.frame(
  rok = c(1915, 1939, 1945, 1949, 1956, 1965, 1973, 1977, 1985, 2000),
  opis = c("urodzony w New Bedford", "doktorat z matematyki\n(Princeton)", "Bell Labs", "porównywanie średnich\npo ANOVA",
           "kieruje Statistical\nResearch Group", "pierwszy kierownik\nwydziału statystyki", "National Medal\nof Science",
           "książka „Exploratory\nData Analysis”", "emerytura (Princeton\ni Bell Labs)", "zmarł 26 lipca"),
  rodzaj = c("życie", "stanowisko", "stanowisko", "praca", "stanowisko", "stanowisko", "nagroda", "praca", "stanowisko", "życie"))
zdarzenia$y <- c(1.2, -1, 1.2, -2, 2.1, -1, 1.2, -2, 2.1, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "stanowisko" = 22, "praca" = 24, "nagroda" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "stanowisko" = oi[["niebieski"]], "praca" = oi[["cynober"]],
                               "nagroda" = oi[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1910, 2000, 10), limits = c(1908, 2007)) + scale_y_continuous(limits = c(-2.5, 2.5)) +
  labs(title = "John W. Tukey (1915–2000)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: liczba owadów na poletkach po sześciu środkach owadobójczych (Beall 1942)
data(InsectSprays, package = "datasets")
# Pięć liczb Tukeya (minimum, zawias dolny, mediana, zawias górny, maksimum) dla każdego środka
t(sapply(split(InsectSprays$count, InsectSprays$spray), fivenum))
# Zawiasy Tukeya a kwartyle z quantile() (z kwartyli ggplot2 rysuje pudełka) – środek A
a <- InsectSprays$count[InsectSprays$spray == "A"]
rbind(zawiasy = fivenum(a)[c(2, 4)], kwartyle = quantile(a, c(0.25, 0.75)))
# Wykres łodygowo-liściowy wszystkich 72 zliczeń
stem(InsectSprays$count)
# Wartości poza płotami 1.5 × długość pudełka (jak w boxplot())
odstajace <- do.call(rbind, lapply(split(InsectSprays, InsectSprays$spray), function(d) {
  poza <- boxplot.stats(d$count, coef = 1.5)$out
  if (length(poza)) data.frame(spray = d$spray[1], count = poza)
}))
odstajace
# Zliczenia: rozrzut rośnie ze średnią, więc ANOVA i HSD na pierwiastku z liczby owadów
model <- aov(sqrt(count) ~ spray, data = InsectSprays)
summary(model)
hsd <- TukeyHSD(model, conf.level = 0.95)$spray
hsd <- data.frame(para = rownames(hsd), round(hsd, 3))
hsd$istotna <- ifelse(hsd$p.adj < .05, "przedział bez zera", "przedział obejmuje zero")
hsd[order(hsd$diff), ]
table(hsd$istotna)

p_box <- ggplot(InsectSprays, aes(spray, count)) +
  geom_boxplot(coef = 1.5, outlier.shape = NA, fill = "grey92", width = 0.6) +
  geom_point(position = position_jitter(width = 0.12, height = 0, seed = 808), colour = oi[["niebieski"]], alpha = 0.6, size = 1.6) +
  geom_point(data = odstajace, shape = 4, size = 4, stroke = 1.3, colour = oi[["cynober"]]) +
  labs(title = "A. Wykres pudełkowy (wąsy do 1.5 × IQR)", x = "Środek owadobójczy", y = "Liczba owadów na poletku") + motyw
p_hsd <- ggplot(hsd, aes(diff, reorder(para, diff), shape = istotna, linetype = istotna)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey50") +
  geom_errorbar(aes(xmin = lwr, xmax = upr), width = 0.3, orientation = "y", colour = oi[["niebieski"]]) +
  geom_point(size = 2.6, colour = oi[["niebieski"]]) +
  scale_shape_manual(values = c("przedział bez zera" = 16, "przedział obejmuje zero" = 1), name = NULL) +
  scale_linetype_manual(values = c("przedział bez zera" = "solid", "przedział obejmuje zero" = "22"), name = NULL) +
  labs(title = "B. Test HSD Tukeya, 95% przedziały", x = "Różnica średnich pierwiastka z liczby owadów", y = NULL) +
  motyw + theme(legend.position = "bottom")
p_metoda <- p_box + p_hsd + plot_layout(widths = c(1, 1.15))
p_os
p_metoda
Wynik w R
  [,1] [,2] [,3] [,4] [,5]
A    7 11.0 14.0 18.5   23
B    7 12.0 16.5 18.0   21
C    0  1.0  1.5  3.0    7
D    2  3.5  5.0  5.0   12
E    1  2.5  3.0  5.0    6
F    9 12.0 15.0 23.0   26
          25%   75%
zawiasy  11.0 18.50
kwartyle 11.5 17.75

  The decimal point is 1 digit(s) to the right of the |

  0 | 001111112222333333334444
  0 | 55555556667779
  1 | 0001112233334444
  1 | 556677779
  2 | 0011234
  2 | 66

  spray count
C     C     7
D     D    12
            Df Sum Sq Mean Sq F value Pr(>F)
spray        5  88.44  17.688    44.8 <2e-16 ***
Residuals   66  26.06   0.395
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
    para   diff    lwr    upr p.adj                 istotna
C-B  C-B -2.632 -3.385 -1.879 0.000      przedział bez zera
C-A  C-A -2.516 -3.269 -1.763 0.000      przedział bez zera
E-B  E-B -2.067 -2.820 -1.314 0.000      przedział bez zera
E-A  E-A -1.951 -2.704 -1.198 0.000      przedział bez zera
D-B  D-B -1.712 -2.465 -0.959 0.000      przedział bez zera
D-A  D-A -1.596 -2.349 -0.843 0.000      przedział bez zera
E-D  E-D -0.355 -1.108  0.398 0.737 przedział obejmuje zero
B-A  B-A  0.116 -0.637  0.869 0.998 przedział obejmuje zero
F-B  F-B  0.142 -0.611  0.895 0.994 przedział obejmuje zero
F-A  F-A  0.258 -0.495  1.011 0.914 przedział obejmuje zero
E-C  E-C  0.565 -0.188  1.318 0.251 przedział obejmuje zero
D-C  D-C  0.919  0.167  1.672 0.008      przedział bez zera
F-D  F-D  1.854  1.101  2.607 0.000      przedział bez zera
F-E  F-E  2.209  1.456  2.962 0.000      przedział bez zera
F-C  F-C  2.774  2.021  3.527 0.000      przedział bez zera

     przedział bez zera przedział obejmuje zero
                     10                       5
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pięć liczb, wykres łodygowo-liściowy, ANOVA i HSD – funkcje bazowe fivenum(), stem(), boxplot.stats(), aov(), TukeyHSD(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był John Tukey?
Amerykańskim statystykiem i matematykiem (1915–2000). Z wykształcenia chemik, doktorat zrobił z matematyki w Princeton (1939). Przez 40 lat pracował jednocześnie na Uniwersytecie Princeton i w Bell Laboratories, był pierwszym kierownikiem wydziału statystyki w Princeton i doradcą kilku prezydentów USA.
Co wymyślił John Tukey?
Najbardziej znane są eksploracyjna analiza danych (książka z 1977 r.) z wykresem łodygowo-liściowym, wykresem pudełkowym i regułą 1.5 × IQR, test HSD do porównań wielokrotnych, rozwój metody jackknife i metod odpornych, współudział w algorytmie FFT oraz słowa „bit” i „software”.
Dlaczego test HSD nazywa się testem Tukeya?
Bo pochodzi z prac Tukeya o porównaniach wielokrotnych po ANOVA. HSD to skrót od honestly significant difference – najmniejsza różnica średnich, którą uznaje się za istotną przy kontroli błędu dla wszystkich par naraz.
Czy Tukey wymyślił wykres pudełkowy?
Upowszechnił go: w książce Exploratory Data Analysis (1977) opisał wykres „box-and-whisker” z zawiasami, płotami i wartościami poza nimi, i ta wersja stała się standardem w programach statystycznych. Pytanie, kto pierwszy narysował podobny wykres, wykracza poza źródła tego hasła.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fernholz, L. T., & Morgenthaler, S. (2000). A conversation with John W. Tukey and Elizabeth Tukey. Statistical Science, 15(1), 79–94. https://doi.org/10.1214/ss/1009212675 ● Otwarty dostęp: pełny tekst
- McCullagh, P. (2003). John Wilder Tukey. 16 June 1915 – 26 July 2000. Biographical Memoirs of Fellows of the Royal Society, 49, 537–555. https://doi.org/10.1098/rsbm.2003.0032
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Cytowania BibTeX
@article{fernholz2000conversation, author={Fernholz, Luisa T. and Morgenthaler, Stephan}, title={{A conversation with John W. Tukey and Elizabeth Tukey}}, journal={Statistical Science}, year={2000}, volume={15}, number={1}, pages={79--94}, doi={10.1214/ss/1009212675}}@article{mccullagh2003tukey, author={McCullagh, Peter}, title={{John Wilder Tukey. 16 June 1915 – 26 July 2000}}, journal={Biographical Memoirs of Fellows of the Royal Society}, year={2003}, volume={49}, pages={537--555}, doi={10.1098/rsbm.2003.0032}}@article{tukey1949comparing, author={Tukey, John W.}, title={{Comparing individual means in the analysis of variance}}, journal={Biometrics}, year={1949}, volume={5}, number={2}, pages={99--114}, doi={10.2307/3001913}}@book{tukey1977exploratory, author={Tukey, John W.}, title={{Exploratory data analysis}}, year={1977}, publisher={Addison-Wesley}}