Co to jest test Siegela–Tukeya?
Test Siegela–Tukeya (ang. Siegel–Tukey test) to nieparametryczny test dla dwóch niezależnych prób, który sprawdza, czy pochodzą one z populacji o różnej zmienności (rozrzucie). Siegel i Tukey (1960) zaproponowali go jako alternatywę dla testu F dla dwóch wariancji, który jest bardzo wrażliwy na odstępstwa od normalności. Test nie wymaga normalności i można go stosować do danych porządkowych.
Jak działa
Obie próby łączy się i porządkuje, a rangi nadaje się naprzemiennie od obu końców: najmniejsza wartość dostaje 1, dwie największe – 2 i 3, dwie kolejne najmniejsze – 4 i 5 itd. Wartości skrajne mają więc małe rangi, a środkowe – duże. Na tak nadanych rangach liczy się zwykłą statystykę sumy rang, jak w teście Manna–Whitneya, dzięki czemu można korzystać z tych samych tablic. Grupa o mniejszej sumie rang ma więcej wyników na krańcach, czyli większy rozrzut. Autorzy podali tablice dla liczebności do 20 w każdej grupie oraz przybliżenie dla dużych prób z poprawką na remisy (Siegel i Tukey, 1960).
Przykład w R
Dwie wersje zadania (po 20 osób, dane symulowane) mają podobne mediany czasu (59.70 i 59.35 s), ale różne SD (3.1 i 11.3 s). Suma rang Siegela–Tukeya w wersji A wynosi 518, a w wersji B – 302; p = .004. Pokrewny test Ansariego–Bradleya daje niemal ten sam wynik (p = .004).
Na rysunku
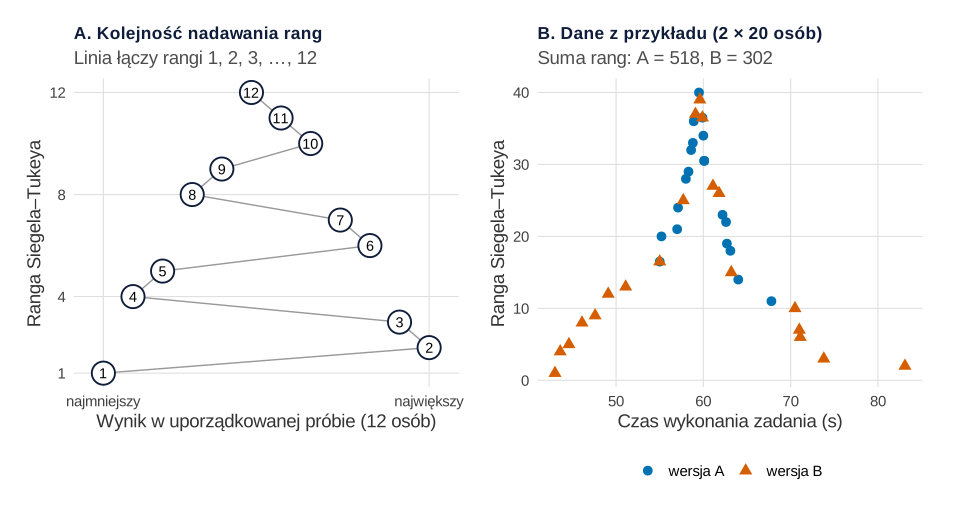
set.seed(560)).Co widać. Panel A pokazuje schemat dla 12 uporządkowanych wyników. Linia łączy rangi w kolejności nadawania: 1 dostaje najmniejszy wynik, 2 i 3 – dwa największe, 4 i 5 – dwa kolejne od dołu. Linia skacze więc między krańcami i zbliża się do środka, gdzie leżą rangi 11 i 12. Panel B to dane z przykładu. Trójkąty wersji B zajmują oba krańce i dostają małe rangi, a koła wersji A skupiają się w środku, gdzie rangi są duże. Dlatego suma rang wersji A (518) jest wyraźnie większa niż wersji B (302), a test daje p = .004.
Na co uważać. Obie grupy mają tu prawie tę samą medianę, więc środek próby łącznej jest wspólny. Gdyby jedna grupa była przesunięta, jej wyniki trafiłyby na jeden kraniec i dostały małe rangi także bez różnicy rozrzutu; przy różnych medianach odejmij je przed testem. Rysunek nie pokazuje też, że rangi nie są idealnie symetryczne (najmniejszy wynik dostaje 1, największy 2), czego nie ma w rangach testu Ansariego–Bradleya. Ziarno i dane są te same co w przykładzie; liczbę 12 wyników w panelu A wybrano ręcznie dla czytelności.
Podpis do pracy:
Kod nadaje rangi tą samą funkcją co przykład i używa tych samych danych (ziarno 560). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Jak test Siegela–Tukeya nadaje rangi (A, 12 uporządkowanych wyników)
# i te rangi w danych z przykładu wyżej (B)
library(ggplot2)
library(patchwork)

kol <- c("wersja A" = "#0072B2", "wersja B" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# rangi Siegela–Tukeya: 1 = najmniejsza, 2 i 3 = dwie największe, 4 i 5 = dwie kolejne najmniejsze...
rangi_st <- function(n) {
  r <- integer(n); lo <- 1; hi <- n; k <- 1; strona <- "dol"; ile <- 1
  while (lo <= hi) {
    for (j in seq_len(ile)) {
      if (lo > hi) break
      if (strona == "dol") { r[lo] <- k; lo <- lo + 1 } else { r[hi] <- k; hi <- hi - 1 }
      k <- k + 1
    }
    strona <- if (strona == "dol") "gora" else "dol"; ile <- 2
  }
  r
}
schemat <- data.frame(pozycja = 1:12, ranga = rangi_st(12))
schemat$ranga                                      # rangi kolejnych wyników od najmniejszego

set.seed(560)                                      # te same dane co w przykładzie wyżej
a <- round(rnorm(20, mean = 60, sd = 5), 1)        # czas zadania (s), wersja A
b <- round(rnorm(20, mean = 60, sd = 11), 1)       # wersja B: to samo położenie, większy rozrzut
d <- data.frame(czas = c(a, b), wersja = rep(c("wersja A", "wersja B"), each = 20))
porz <- order(d$czas); d$ranga <- NA; d$ranga[porz] <- rangi_st(nrow(d))
d$ranga <- ave(d$ranga, d$czas, FUN = mean)        # remisy: średnia rang
(s <- tapply(d$ranga, d$wersja, sum))

pA <- ggplot(schemat[order(schemat$ranga), ], aes(pozycja, ranga)) +
  geom_path(colour = "grey60", linewidth = 0.5) +
  geom_point(size = 7.5, colour = "#0f1d3a", fill = "white", shape = 21, stroke = 1) +
  geom_text(aes(label = ranga), size = 3.8) +
  scale_x_continuous(breaks = c(1, 12), labels = c("najmniejszy", "największy"), expand = expansion(add = 1)) +
  scale_y_continuous(breaks = c(1, 4, 8, 12)) +
  labs(title = "A. Kolejność nadawania rang", subtitle = "Linia łączy rangi 1, 2, 3, …, 12", x = "Wynik w uporządkowanej próbie (12 osób)",
       y = "Ranga Siegela–Tukeya") +
  motyw
pB <- ggplot(d, aes(czas, ranga)) +
  geom_point(aes(colour = wersja, shape = wersja), size = 3) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c("wersja A" = 16, "wersja B" = 17), name = NULL) +
  labs(title = "B. Dane z przykładu (2 × 20 osób)",
       subtitle = sprintf("Suma rang: A = %g, B = %g", s[[1]], s[[2]]),
       x = "Czas wykonania zadania (s)", y = "Ranga Siegela–Tukeya") +
  motyw
p1 <- pA | pB
p1
Wynik w R
 [1]  1  4  5  8  9 12 11 10  7  6  3  2
wersja A wersja B
     518      302
Jak opisać w pracy
Na co uważać
- Równe mediany. Test wykrywa różnicę rozrzutu tylko wtedy, gdy grupy mają wspólne położenie. Moses (1963) pokazał, że bez takiego założenia żaden test rangowy nie jest zadowalającym testem rozproszenia. Gdy mediany się różnią, odejmij je przed testem (w DescTools:
adjust.median = TRUE). - Nie myl z testem położenia. Ten sam rachunek na zwykłych rangach to test Manna–Whitneya, a jego miarą przesunięcia jest estymator Hodgesa–Lehmanna.
- Więcej niż dwie grupy. Użyj testu Flignera–Killeena albo testu Levene’a z medianą.
Test Siegela–Tukeya w R
Kod nadaje rangi Siegela–Tukeya ręcznie, liczy na nich test sumy rang wilcox.test(), a potem sprawdza wynik funkcją SiegelTukeyTest() z pakietu DescTools i porównuje go z ansari.test().
Dwie próby o różnym rozrzucie
R
# Test Siegela–Tukeya: rangi nadawane naprzemiennie od obu końców, potem test Wilcoxona
set.seed(560)
a <- round(rnorm(20, mean = 60, sd = 5), 1)    # czas zadania (s), wersja A
b <- round(rnorm(20, mean = 60, sd = 11), 1)   # wersja B: to samo położenie, większy rozrzut
# rangi Siegela–Tukeya: 1 = najmniejsza, 2 i 3 = dwie największe, 4 i 5 = dwie kolejne najmniejsze...
rangi_st <- function(n) {
  r <- integer(n); lo <- 1; hi <- n; k <- 1; strona <- "dol"; ile <- 1
  while (lo <= hi) {
    for (j in seq_len(ile)) {
      if (lo > hi) break
      if (strona == "dol") { r[lo] <- k; lo <- lo + 1 } else { r[hi] <- k; hi <- hi - 1 }
      k <- k + 1
    }
    strona <- if (strona == "dol") "gora" else "dol"; ile <- 2
  }
  r
}
x <- c(a, b); g <- rep(c("A", "B"), each = 20)
porz <- order(x); r <- numeric(length(x)); r[porz] <- rangi_st(length(x))
r <- ave(r, x, FUN = mean)                     # remisy: średnia rang
round(c(sd_A = sd(a), sd_B = sd(b), suma_rang_A = sum(r[g == "A"]),
        suma_rang_B = sum(r[g == "B"])), 2)
round(wilcox.test(r[g == "A"], r[g == "B"], exact = FALSE)$p.value, 4)
library(DescTools)
SiegelTukeyTest(a, b, exact = FALSE)           # to samo funkcją z DescTools
round(ansari.test(a, b, exact = FALSE)$p.value, 4)   # pokrewny test Ansariego–Bradleya
Wynik w R
       sd_A        sd_B suma_rang_A suma_rang_B
        3.1        11.3       518.0       302.0
[1] 0.004

	Siegel-Tukey-test for equal variability

data:  a and b
ST = 518, p-value = 0.003961
alternative hypothesis: true ratio of scales is not equal to 1

[1] 0.0041
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test() i ansari.test() z pakietu stats oraz SiegelTukeyTest() z pakietu DescTools 0.99.60). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy test Siegela–Tukeya sprawdza równość wariancji?
Sprawdza różnicę rozrzutu (skali) bez założenia normalności, a nie wariancje w sensie parametrycznym. Działa dobrze, gdy grupy mają podobne położenie.
Jak policzyć test Siegela–Tukeya w R?
Funkcją SiegelTukeyTest(x, y) z pakietu DescTools albo ręcznie: nadaj rangi od obu końców i użyj wilcox.test() na tych rangach. Gdy mediany się różnią, ustaw adjust.median = TRUE.
Czym test Siegela–Tukeya różni się od testu Ansariego–Bradleya?
Oba nadają małe rangi wartościom skrajnym i zwykle dają bardzo podobne wyniki. Siegel–Tukey nadaje rangi naprzemiennie parami od końców, więc można użyć tablic testu sumy rang; Ansari–Bradley nadaje te same rangi obu krańcom.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Moses, L. E. (1963). Rank tests of dispersion. The Annals of Mathematical Statistics, 34(3), 973–983. https://doi.org/10.1214/aoms/1177704020 ● Otwarty dostęp
- Siegel, S., & Tukey, J. W. (1960). A nonparametric sum of ranks procedure for relative spread in unpaired samples. Journal of the American Statistical Association, 55(291), 429–445. https://doi.org/10.1080/01621459.1960.10482073
Cytowania BibTeX
@article{moses1963rank, author={Moses, Lincoln E.}, title={{Rank tests of dispersion}}, journal={The Annals of Mathematical Statistics}, year={1963}, volume={34}, number={3}, pages={973--983}, doi={10.1214/aoms/1177704020}}@article{siegel1960nonparametric, author={Siegel, Sidney and Tukey, John W.}, title={{A nonparametric sum of ranks procedure for relative spread in unpaired samples}}, journal={Journal of the American Statistical Association}, year={1960}, volume={55}, number={291}, pages={429--445}, doi={10.1080/01621459.1960.10482073}}