Co to jest test Flignera–Killeena?
Test Flignera–Killeena (ang. Fligner–Killeen test) to nieparametryczny test równości wariancji w dwóch lub więcej niezależnych grupach. Hipoteza zerowa mówi, że rozproszenie we wszystkich grupach jest takie samo, czyli spełnione jest założenie homogeniczności wariancji. Fligner i Killeen (1976) zaproponowali statystyki dla dwóch prób – odpowiedniki m.in. testu Ansariego–Bradleya – o tej samej efektywności asymptotycznej, ale większej mocy w małych próbach.
Jak działa
W wersji używanej dziś (z medianą) od każdego wyniku odejmuje się medianę jego grupy, a wartości bezwzględne tych odchyleń zamienia na rangi w całej próbie. Rangi przekształca się na wyniki normalne (kwantyle rozkładu normalnego), a statystyka porównuje ich średnie w grupach. Przy hipotezie zerowej ma w przybliżeniu rozkład chi-kwadrat z k − 1 stopniami swobody. Conover, Johnson i Johnson (1981) porównali w symulacjach wiele testów jednorodności wariancji i tylko kilka okazało się zarazem odpornych i mocnych. Dokumentacja funkcji fligner.test() w R wskazuje, że wersja z medianą należała do najbardziej odpornych na nienormalność.
Przykład w R
Trzy grupy po 30 osób wylosowano z tego samego prawoskośnego rozkładu lognormalnego, więc wariancje są równe. Test Bartletta: K²(2) = 4.82, p = .090; test Flignera–Killeena: χ²(2) = 2.15, p = .341. W 2000 powtórzeniach test Bartletta odrzucał prawdziwą hipotezę zerową w 43.5% prób, a test Flignera–Killeena w 6.1%.
Na rysunku
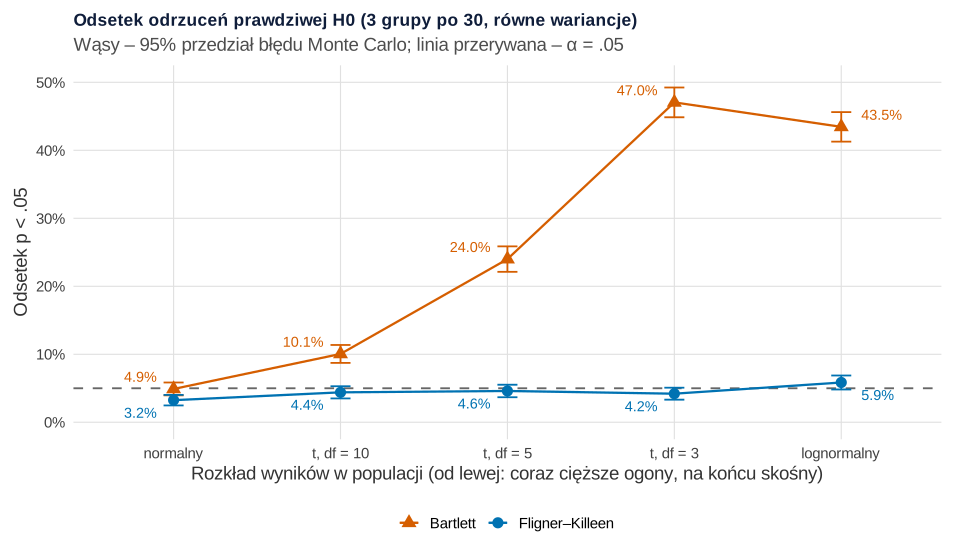
set.seed(5071), 2000 powtórzeń na rozkład).Co widać. Symulacja rozszerza przykład na pięć rozkładów. W każdym trzy grupy po 30 osób pochodzą z tego samego rozkładu, więc każde p < .05 to fałszywy alarm. Przy rozkładzie normalnym test Bartletta trzyma poziom (4.9%), ale gdy ogony grubieją, odsetek rośnie: 10.1% przy rozkładzie t z 10 stopniami swobody, 24.0% przy 5 i 47.0% przy 3. Przy rozkładzie lognormalnym z przykładu wynosi 43.5%. Test Flignera–Killeena pozostaje w przedziale 3.2–5.9%. Błąd Monte Carlo każdego odsetka wynosi najwyżej 1.1 pp (wąsy to 95% przedział tego błędu). Odsetek dla testu Flignera–Killeena przy rozkładzie lognormalnym (5.9%) różni się nieco od 6.1% z przykładu, bo to inne losowania.
Na co uważać. Rysunek pokazuje tylko błąd I rodzaju, a nie moc. Przy danych normalnych test Flignera–Killeena jest lekko zachowawczy (3.2%), a test Bartletta wykrywa wtedy prawdziwe różnice wariancji częściej. Wynik dotyczy trzech równych grup po 30 osób; przy małych i nierównych grupach odsetki mogą być inne. Rozkłady, liczebności i liczbę powtórzeń wybrano ręcznie; ziarna nie zmieniano. Podobne porównanie z testem Levene’a pokazuje hasło test Bartletta.
Podpis do pracy:
Kod używa funkcji bartlett.test() i fligner.test() z pakietu stats. Symulacja ma ziarno 5071, inne niż w przykładzie. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rzeczywisty odsetek fałszywych alarmów (α = .05) testu Bartletta i Flignera–Killeena,
# gdy wariancje są równe, a rozkład ma coraz cięższe ogony albo jest skośny
library(ggplot2)

kol <- c(Bartlett = "#D55E00", "Fligner–Killeen" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(5071)                                   # ziarno ustalone raz, niezależne od przykładu wyżej
R <- 2000                                        # powtórzeń w każdym scenariuszu
g <- factor(rep(c("A", "B", "C"), each = 30))    # trzy grupy po 30 osób, ten sam rozkład (H0 prawdziwa)
rozklady <- list(
  "normalny" = function(n) rnorm(n),
  "t, df = 10" = function(n) rt(n, df = 10),
  "t, df = 5" = function(n) rt(n, df = 5),
  "t, df = 3" = function(n) rt(n, df = 3),
  "lognormalny" = function(n) rlnorm(n, meanlog = 3, sdlog = 0.6))
wyniki <- do.call(rbind, lapply(names(rozklady), function(nazwa) {
  p <- replicate(R, {
    y <- rozklady[[nazwa]](90)
    c(Bartlett = bartlett.test(y, g)$p.value, "Fligner–Killeen" = fligner.test(y, g)$p.value)
  })
  alfa <- rowMeans(p < .05)
  data.frame(rozklad = nazwa, test = names(alfa), alfa = alfa,
             blad_mc = sqrt(alfa * (1 - alfa) / R), row.names = NULL)
}))
wyniki$rozklad <- factor(wyniki$rozklad, levels = names(rozklady))
wyniki$proc <- sprintf("%.1f%%", 100 * wyniki$alfa)            # etykiety na rysunku
wyniki$blad_mc_pp <- sprintf("%.1f", 100 * wyniki$blad_mc)      # błąd Monte Carlo w punktach proc.
print(wyniki[, c("rozklad", "test", "proc", "blad_mc_pp")], row.names = FALSE)

p1 <- ggplot(wyniki, aes(rozklad, alfa, colour = test, shape = test, group = test)) +
  geom_hline(yintercept = .05, linetype = "dashed", colour = "grey40") +
  geom_line(linewidth = 0.8) +
  geom_errorbar(aes(ymin = alfa - 1.96 * blad_mc, ymax = alfa + 1.96 * blad_mc), width = 0.12) +
  geom_point(size = 3.5) +
  geom_text(aes(x = as.numeric(rozklad) + ifelse(rozklad == "lognormalny", 0.12, -0.1), label = proc,
                hjust = ifelse(rozklad == "lognormalny", 0, 1), vjust = ifelse(test == "Bartlett", -0.7, 1.7)),
            size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(Bartlett = 17, "Fligner–Killeen" = 16), name = NULL) +
  scale_y_continuous(limits = c(0, 0.5), breaks = seq(0, 0.5, 0.1), labels = function(x) paste0(100 * x, "%")) +
  labs(title = "Odsetek odrzuceń prawdziwej H0 (3 grupy po 30, równe wariancje)",
       subtitle = "Wąsy – 95% przedział błędu Monte Carlo; linia przerywana – α = .05",
       x = "Rozkład wyników w populacji (od lewej: coraz cięższe ogony, na końcu skośny)",
       y = "Odsetek p < .05") +
  motyw
p1
Wynik w R
     rozklad            test  proc blad_mc_pp
    normalny        Bartlett  4.9%        0.5
    normalny Fligner–Killeen  3.2%        0.4
  t, df = 10        Bartlett 10.1%        0.7
  t, df = 10 Fligner–Killeen  4.4%        0.5
   t, df = 5        Bartlett 24.0%        1.0
   t, df = 5 Fligner–Killeen  4.6%        0.5
   t, df = 3        Bartlett 47.0%        1.1
   t, df = 3 Fligner–Killeen  4.2%        0.4
 lognormalny        Bartlett 43.5%        1.1
 lognormalny Fligner–Killeen  5.9%        0.5
Jak opisać w pracy
Na co uważać
- Nie jako test wstępny. Nieistotny wynik nie dowodzi równych wariancji. Średnie porównuj od razu ANOVA Welcha.
- Podaj wariant. Napisz, że test liczono z medianą; przy innym centrowaniu wynik się zmienia.
- Alternatywy. Podobną odporność daje test Levene’a z medianą (Browna–Forsythe’a). Wybierz jeden test przed analizą.
- Różne mediany nie przeszkadzają. Centrowanie medianą każdej grupy usuwa różnice położenia, czego nie robi podstawowa wersja testu Ansariego–Bradleya.
Test Flignera–Killeena w R
Kod porównuje test Bartletta z testem Flignera–Killeena (funkcje bartlett.test() i fligner.test() z pakietu stats) na danych prawoskośnych o równych wariancjach, a potem w 2000 symulacjach liczy odsetek fałszywych alarmów.
Bartlett a Fligner–Killeen przy skośnych danych
R
set.seed(507)
# trzy grupy z tego samego rozkładu prawoskośnego (wariancje równe)
g <- factor(rep(c("A", "B", "C"), each = 30))
y <- rlnorm(90, meanlog = 3, sdlog = 0.6)
bartlett.test(y ~ g)
fligner.test(y ~ g)
# odsetek fałszywych alarmów w 2000 symulacjach (alfa = .05)
p <- replicate(2000, {
  yy <- rlnorm(90, meanlog = 3, sdlog = 0.6)
  c(Bartlett = bartlett.test(yy ~ g)$p.value,
    Fligner  = fligner.test(yy ~ g)$p.value)
})
rowMeans(p < .05)
Wynik w R
	Bartlett test of homogeneity of variances

data:  y by g
Bartlett's K-squared = 4.8186, df = 2, p-value = 0.08988


	Fligner-Killeen test of homogeneity of variances

data:  y by g
Fligner-Killeen:med chi-squared = 2.1522, df = 2, p-value = 0.3409

Bartlett  Fligner
   0.435    0.061
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bartlett.test() i fligner.test() z pakietu stats). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy wybrać test Flignera–Killeena zamiast testu Bartletta?
Gdy rozkłady w grupach są skośne, grubo-ogonowe albo mają obserwacje odstające. Test Bartletta myli wtedy kształt rozkładu z różnicą wariancji; w przykładzie z danymi lognormalnymi dawał fałszywy alarm w 43.5% prób.
Czy test Flignera–Killeena wymaga równych liczebności grup?
Nie. Funkcja fligner.test() w R przyjmuje grupy o różnych liczebnościach, bo każdą grupę centruje jej własną medianą, a rangi liczy w całej połączonej próbie.
Jak zapisać wynik testu Flignera–Killeena w stylu APA?
Podaj statystykę chi-kwadrat z liczbą stopni swobody i p, np. χ²(2) = 2.15, p = .341, oraz zaznacz, że użyto wersji z centrowaniem medianą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Conover, W. J., Johnson, M. E., & Johnson, M. M. (1981). A comparative study of tests for homogeneity of variances, with applications to the outer continental shelf bidding data. Technometrics, 23(4), 351–361. https://doi.org/10.1080/00401706.1981.10487680
- Fligner, M. A., & Killeen, T. J. (1976). Distribution-free two-sample tests for scale. Journal of the American Statistical Association, 71(353), 210–213. https://doi.org/10.1080/01621459.1976.10481517
Cytowania BibTeX
@article{conover1981comparative, author={Conover, W. J. and Johnson, Mark E. and Johnson, Myrle M.}, title={{A comparative study of tests for homogeneity of variances, with applications to the outer continental shelf bidding data}}, journal={Technometrics}, year={1981}, volume={23}, number={4}, pages={351--361}, doi={10.1080/00401706.1981.10487680}}@article{fligner1976distribution, author={Fligner, Michael A. and Killeen, Timothy J.}, title={{Distribution-free two-sample tests for scale}}, journal={Journal of the American Statistical Association}, year={1976}, volume={71}, number={353}, pages={210--213}, doi={10.1080/01621459.1976.10481517}}