Co to jest test Ansariego–Bradleya?
Test Ansariego–Bradleya (ang. Ansari–Bradley test) to nieparametryczny test dla dwóch niezależnych prób, który sprawdza, czy rozkłady różnią się rozproszeniem (skalą), a nie położeniem. Hipoteza zerowa mówi, że obie próby pochodzą z tego samego rozkładu, a alternatywa – że jeden rozkład jest „rozciągniętą” wersją drugiego. Test zaproponowali Ansari i Bradley (1960).
Jak działa
Obie próby łączy się i porządkuje, a rangi nadaje od obu końców ku środkowi: najmniejsza i największa wartość dostają 1, kolejne 2 itd. Statystyką jest suma takich rang w jednej próbie. Mała suma oznacza, że wyniki tej grupy leżą częściej na krańcach, czyli są bardziej rozproszone. Autorzy podali tablice dokładnych wartości krytycznych dla łącznej liczebności do 20 i przybliżenie normalne. Przy rozkładzie normalnym test ma efektywność asymptotyczną 6/π² (około 0.61) względem testu F dla dwóch wariancji.
Przykład w R
Dwie wersje zadania (po 20 osób, dane symulowane) mają podobne mediany czasu (62.13 i 66.23 s), ale różne SD (4.96 i 11.46). Test Ansariego–Bradleya: AB = 262, p = .004. Gdy drugą grupę spowolniono o 15 s, p wzrosło do .078, a po odjęciu median grup wyniosło .047.
Na rysunku
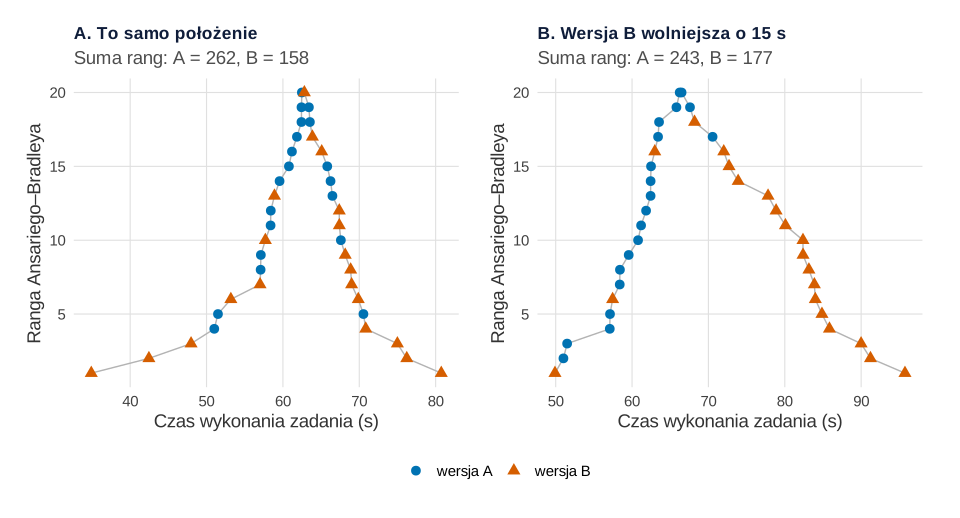
set.seed(506)).Co widać. Rangi nadawane od obu końców układają się w odwróconą literę V: najkrótszy i najdłuższy czas dostają rangę 1, a obserwacje ze środka połączonej próby – rangę 20. W panelu A trójkąty wersji B zajmują oba zbocza, a koła wersji A skupiają się przy szczycie. Suma rang wersji A wynosi 262, a wersji B 158. Mała suma oznacza wyniki częściej na krańcach, czyli większy rozrzut (p = .004, jak w przykładzie). Panel B pokazuje te same dane po spowolnieniu wersji B o 15 s. Teraz lewe zbocze należy głównie do wersji A, a prawe do wersji B, więc niskie rangi dzielą się między obie grupy. Sumy zbliżają się do siebie (243 i 177), a p rośnie do .078, choć odchylenia standardowe grup się nie zmieniły.
Na co uważać. Różnica położenia potrafi ukryć różnicę rozrzutu, dlatego przy różnych medianach porównuj odchylenia od median (p = .047 w przykładzie). Wykres pokazuje tylko, jak daleko od wspólnego środka próby łącznej leżą obserwacje każdej grupy. Ta sama suma rang może powstać przy rozkładach o różnym kształcie, a rysunek nie mówi nic o mocy testu przy innych liczebnościach. Dane i przesunięcie o 15 s są te same co w przykładzie; ziarna nie zmieniano.
Podpis do pracy:
Kod używa tych samych danych co przykład (ziarno 506), liczy rangi Ansariego–Bradleya wprost (ranga od bliższego końca) i sprawdza p funkcją ansari.test(). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rangi Ansariego–Bradleya w tych samych danych co w przykładzie wyżej:
# A – to samo położenie grup, B – grupa B przesunięta o 15 s
library(ggplot2)
library(patchwork)

kol <- c("wersja A" = "#0072B2", "wersja B" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(506)                                    # te same dane co w przykładzie wyżej
standard <- rnorm(20, mean = 60, sd = 5)         # wersja A
nowa     <- rnorm(20, mean = 60, sd = 11)        # wersja B: to samo położenie, większy rozrzut

# ranga Ansariego–Bradleya: zwykła ranga liczona od bliższego końca (1 = najmniejsza i największa)
rangi_ab <- function(x) { r <- rank(x); pmin(r, length(x) - r + 1) }
dane_ab <- function(a, b) {
  d <- data.frame(czas = c(a, b), wersja = rep(c("wersja A", "wersja B"), c(length(a), length(b))))
  d$ranga <- rangi_ab(d$czas)
  d
}
d1 <- dane_ab(standard, nowa)
d2 <- dane_ab(standard, nowa + 15)               # wersja B wolniejsza o 15 s
sumy <- rbind(to_samo_polozenie = tapply(d1$ranga, d1$wersja, sum),
              B_przesunieta     = tapply(d2$ranga, d2$wersja, sum))
sumy
c(p_to_samo = ansari.test(standard, nowa)$p.value,
  p_przesuniecie = ansari.test(standard, nowa + 15)$p.value)

panel <- function(d, tytul) {
  s <- tapply(d$ranga, d$wersja, sum)
  ggplot(d, aes(czas, ranga)) +
    geom_line(data = d[order(d$czas), ], colour = "grey70", linewidth = 0.5) +
    geom_point(aes(colour = wersja, shape = wersja), size = 3) +
    scale_colour_manual(values = kol, name = NULL) +
    scale_shape_manual(values = c("wersja A" = 16, "wersja B" = 17), name = NULL) +
    labs(title = tytul, subtitle = sprintf("Suma rang: A = %g, B = %g", s[[1]], s[[2]]),
         x = "Czas wykonania zadania (s)", y = "Ranga Ansariego–Bradleya") +
    motyw
}
p1 <- (panel(d1, "A. To samo położenie") | panel(d2, "B. Wersja B wolniejsza o 15 s")) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1
Wynik w R
                  wersja A wersja B
to_samo_polozenie      262      158
B_przesunieta          243      177
     p_to_samo p_przesuniecie
   0.004427944    0.078278669
Jak opisać w pracy
Na co uważać
- Równe mediany. Test zakłada wspólne (albo znane) położenie. Moses (1963) pokazał, że bez takiego założenia żaden test rangowy nie jest zadowalającym testem rozproszenia. Gdy mediany się różnią, porównuj odchylenia od median, jak w przykładzie.
- Nie myl z testem Manna–Whitneya. Test U wykrywa przesunięcie położenia, a test Ansariego–Bradleya – różnicę rozrzutu.
- Tylko dwie grupy. Przy trzech i więcej grupach użyj testu Flignera–Killeena albo testu Levene’a z medianą.
- Remisy. W R dokładne p jest liczone tylko bez wartości wiązanych i przy mniej niż 50 obserwacjach w każdej próbie; w przeciwnym razie – przybliżenie normalne.
Test Ansariego–Bradleya w R
Kod porównuje rozproszenie czasu wykonania zadania w dwóch wersjach funkcją ansari.test() z pakietu stats, a potem sprawdza, co się dzieje, gdy grupy różnią się także położeniem.
Dwie próby o różnym rozrzucie
R
set.seed(506)
standard <- rnorm(20, mean = 60, sd = 5)    # czas zadania (s), wersja A
nowa     <- rnorm(20, mean = 60, sd = 11)   # wersja B: to samo położenie, większy rozrzut
round(c(med_A = median(standard), med_B = median(nowa),
        sd_A = sd(standard), sd_B = sd(nowa)), 2)
ansari.test(standard, nowa)
# wersja B dodatkowo wolniejsza o 15 s (inne położenie, ten sam rozrzut co wyżej)
wolna <- nowa + 15
ansari.test(standard, wolna)$p.value                    # bez wyrównania median
ansari.test(standard - median(standard),
            wolna - median(wolna))$p.value             # odchylenia od median
Wynik w R
med_A med_B  sd_A  sd_B
62.13 66.23  4.96 11.46

	Ansari-Bradley test

data:  standard and nowa
AB = 262, p-value = 0.004428
alternative hypothesis: true ratio of scales is not equal to 1

[1] 0.07827867
[1] 0.04726778
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja ansari.test() z pakietu stats). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy test Ansariego–Bradleya porównuje wariancje?
Porównuje rozproszenie, czyli parametr skali, a nie samą wariancję. Przy rozkładach różniących się tylko skalą wniosek o większym rozrzucie jest równoznaczny z wnioskiem o większej wariancji.
Co zrobić, gdy grupy mają różne mediany?
Odejmij od wyników medianę każdej grupy i przeprowadź test na odchyleniach. Ansari i Bradley zaproponowali taką modyfikację, choć nie zbadali jej własności, więc wynik traktuj ostrożnie.
Czym test Ansariego–Bradleya różni się od testu Siegela–Tukeya?
Oba są rangowymi testami rozproszenia dla dwóch prób i nadają niskie rangi wartościom skrajnym. Różnią się sposobem przydzielania rang; Ansari i Bradley omawiają test Siegela–Tukeya jako podobny.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ansari, A. R., & Bradley, R. A. (1960). Rank-sum tests for dispersions. The Annals of Mathematical Statistics, 31(4), 1174–1189. https://doi.org/10.1214/aoms/1177705688 ● Otwarty dostęp
- Moses, L. E. (1963). Rank tests of dispersion. The Annals of Mathematical Statistics, 34(3), 973–983. https://doi.org/10.1214/aoms/1177704020 ● Otwarty dostęp
Cytowania BibTeX
@article{ansari1960rank, author={Ansari, A. R. and Bradley, R. A.}, title={{Rank-sum tests for dispersions}}, journal={The Annals of Mathematical Statistics}, year={1960}, volume={31}, number={4}, pages={1174--1189}, doi={10.1214/aoms/1177705688}}@article{moses1963rank, author={Moses, Lincoln E.}, title={{Rank tests of dispersion}}, journal={The Annals of Mathematical Statistics}, year={1963}, volume={34}, number={3}, pages={973--983}, doi={10.1214/aoms/1177704020}}