Co to jest test Fmax Hartleya?
Test Fmax Hartleya (ang. Hartley’s Fmax test, maximum F-ratio) to szybki test równości wariancji w kilku grupach o równych liczebnościach. Statystyką jest iloraz największej i najmniejszej wariancji z próby. Hartley (1950) zaproponował go jako skrót obliczeniowy przy sprawdzaniu homogeniczności wariancji przed ANOVA.
Jak liczyć
Fmax = s²max / s²min
Wynik zawsze wynosi co najmniej 1. Porównuje się go z wartością krytyczną z tablic Hartleya, która zależy od liczby grup k i stopni swobody n − 1 w każdej grupie. To nie jest zwykły rozkład F: wybieramy najbardziej skrajną parę spośród wielu, więc wartości krytyczne rosną wraz z k. Statystyka korzysta tylko z dwóch grup, a pozostałe ignoruje.
Przykład w R
Cztery grupy po 12 osób (dane symulowane, SD w populacji 6, 7, 8 i 12) dały wariancje 52.26, 26.03, 47.23 i 72.23, czyli Fmax = 72.23 / 26.03 = 2.77 przy k = 4 i df = 11. Najmniejszą wariancję miała grupa B, choć w populacji najmniejszy rozrzut miała A – tak duża jest zmienność wariancji w małych próbach. Funkcje R nie podają wartości p dla Fmax (potrzebne są tablice Hartleya); przybliżoną wartość z symulacji pokazujemy niżej, w sekcji Na rysunku. Dla porównania test Bartletta dał p = .444, a test Flignera–Killeena χ²(3) = 5.07, p = .166.
Na rysunku
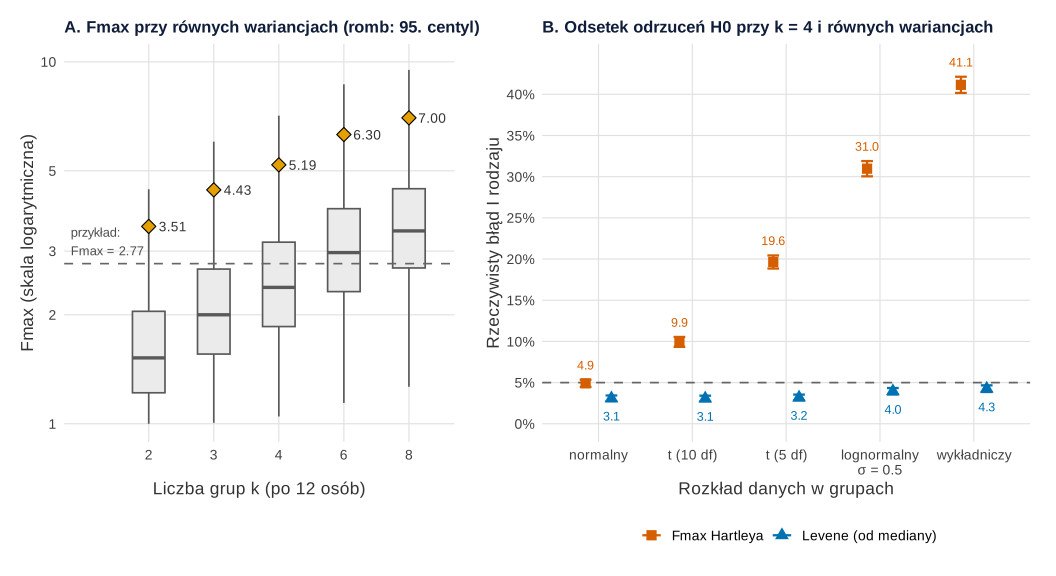
set.seed(5081) i set.seed(5082), 20 000 i 10 000 powtórzeń).Co widać. Panel A pokazuje, dlaczego Fmax wymaga własnych tablic. Przy równych wariancjach w populacji iloraz największej i najmniejszej wariancji z próby rośnie z liczbą grup, bo im więcej grup, tym bardziej skrajna para. 95. centyl, czyli przybliżona wartość krytyczna dla α = .05 i 12 osób w grupie, wynosi 3.51 przy dwóch grupach, 5.19 przy czterech i 7.00 przy ośmiu. Przy dwóch grupach dokładna wartość z rozkładu F (dwustronnie) to 3.47; różnica wynika z błędu Monte Carlo. Dla przykładu z czterema grupami Fmax ≥ 2.77 wypadło w 35.8% badań, czyli p ≈ .36. Panel B stosuje wartość krytyczną 5.19 w nowej symulacji. Przy rozkładzie normalnym test trzyma poziom (4.9%), ale już przy umiarkowanie grubych ogonach (t z 10 df) odrzuca prawdziwą hipotezę dwa razy częściej, a przy rozkładzie wykładniczym w 41% badań. Test Levene’a od mediany daje 3.1–4.3%. Błąd Monte Carlo każdego odsetka wynosi najwyżej 0.5 pp (odcinki to ±2 błędy).
Na co uważać. Rysunek dotyczy tylko równych liczebności (12 osób w grupie) i tylko błędu I rodzaju; nie pokazuje mocy. Liczby grup i rozkłady wybrano ręcznie, by objąć zakres od normalności do silnej skośności; ziaren nie zmieniano. Test od mediany jest przy tak małych grupach lekko zachowawczy. Podobny obraz dla testu Bartletta przy grubych ogonach pokazuje hasło test Bartletta jednorodności wariancji.
Podpis do pracy:
Kod liczy Fmax i test Levene’a od mediany ze wzorów (szybciej niż funkcje w pętli) i na jednym zbiorze sprawdza zgodność z car::leveneTest() (ziarno 508). Symulacje mają ziarna 5081 (panel A) i 5082 (panel B). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozkład Fmax Hartleya pod H0 a liczba grup i błąd I rodzaju przy danych nienormalnych
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("Fmax Hartleya" = "#D55E00", "Levene (od mediany)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

n <- 12                                                   # 12 osób w grupie, jak w przykładzie (df = 11)
fmax <- function(Y) { w <- apply(Y, 2, var); max(w) / min(w) }   # Y: macierz n × k, kolumny = grupy
p_levene_med <- function(Y) {                             # test Levene’a od mediany jako ANOVA na |y − mediana|
  Z <- abs(sweep(Y, 2, apply(Y, 2, median))); k <- ncol(Z); m <- colMeans(Z)
  F <- n * sum((m - mean(Z))^2) / (k - 1) / (sum(sweep(Z, 2, m)^2) / (k * n - k))
  pf(F, k - 1, k * n - k, lower.tail = FALSE)
}
# kontrola zgodności z car::leveneTest() na jednym zbiorze
set.seed(508)
Y0 <- matrix(rnorm(4 * n), n, 4)
round(c(wzor = p_levene_med(Y0), car = car::leveneTest(c(Y0), factor(rep(1:4, each = n)))[1, 3]), 6)

# A. Rozkład Fmax pod H0 (rozkład normalny, równe wariancje) dla k = 2–8 grup, 20 000 badań na k
set.seed(5081)
R_A <- 20000
ks <- c(2, 3, 4, 6, 8)
symA <- do.call(rbind, lapply(ks, function(k)
  data.frame(k = k, Fmax = replicate(R_A, fmax(matrix(rnorm(n * k), n, k))))))
kryt <- aggregate(Fmax ~ k, symA, function(x) quantile(x, 0.95))
names(kryt)[2] <- "kryt_95"
kryt$F_dwustronne <- ifelse(kryt$k == 2, qf(0.975, n - 1, n - 1), NA)   # przy k = 2 Fmax to dwustronny test F
print(transform(kryt, kryt_95 = round(kryt_95, 2), F_dwustronne = round(F_dwustronne, 2)), row.names = FALSE)
# przybliżone p dla Fmax = 2.77 z przykładu (k = 4): odsetek symulowanych Fmax ≥ 2.77
round(mean(symA$Fmax[symA$k == 4] >= 2.77), 3)
symA$kf <- factor(symA$k)

# B. Błąd I rodzaju przy k = 4 i równych wariancjach dla różnych rozkładów, 10 000 badań na rozkład
kryt4 <- kryt$kryt_95[kryt$k == 4]
rozklady <- list("normalny" = function(m) rnorm(m), "t (10 df)" = function(m) rt(m, 10),
                 "t (5 df)" = function(m) rt(m, 5), "lognormalny σ = 0.5" = function(m) rlnorm(m, 0, 0.5),
                 "wykładniczy" = function(m) rexp(m))
set.seed(5082)
R_B <- 10000
symB <- do.call(rbind, lapply(names(rozklady), function(r) {
  w <- replicate(R_B, { Y <- matrix(rozklady[[r]](4 * n), n, 4); c(fmax(Y) >= kryt4, p_levene_med(Y) < .05) })
  odrz <- rowMeans(w)
  data.frame(rozklad = r, test = names(kol), odsetek = odrz, blad_MC = sqrt(odrz * (1 - odrz) / R_B))
}))
symB$rozklad <- factor(symB$rozklad, levels = names(rozklady))
symB$test <- factor(symB$test, levels = names(kol))
print(transform(symB, odsetek = round(odsetek, 4), blad_MC = round(blad_MC, 4)), row.names = FALSE)

pA <- ggplot(symA, aes(kf, Fmax)) +
  geom_boxplot(width = 0.5, outlier.shape = NA, fill = "grey92", colour = "grey35") +
  geom_point(aes(y = kryt_95), data = transform(kryt, kf = factor(k)), shape = 23, size = 3.6,
             fill = "#E69F00", colour = "black") +
  geom_text(aes(y = kryt_95, label = sprintf("%.2f", kryt_95)), data = transform(kryt, kf = factor(k)),
            nudge_x = 0.36, size = 3.6, colour = "grey20") +
  geom_hline(yintercept = 2.77, linetype = "dashed", colour = "grey40") +
  annotate("text", x = -0.2, y = 2.77, label = "przykład:\nFmax = 2.77", hjust = 0, vjust = -0.3, size = 3.4, colour = "grey30") +
  scale_x_discrete(expand = expansion(add = c(1.3, 0.7))) +
  scale_y_log10(breaks = c(1, 2, 3, 5, 10)) + coord_cartesian(ylim = c(1, 10)) +
  labs(title = "A. Fmax przy równych wariancjach (romb: 95. centyl)", x = "Liczba grup k (po 12 osób)",
       y = "Fmax (skala logarytmiczna)") +
  motyw
dz <- position_dodge(width = 0.55)
pB <- ggplot(symB, aes(rozklad, odsetek, colour = test, shape = test)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(ymin = odsetek - 2 * blad_MC, ymax = odsetek + 2 * blad_MC), width = 0.25, linewidth = 0.8, position = dz) +
  geom_point(size = 3.2, position = dz) +
  geom_text(aes(y = ifelse(test == "Fmax Hartleya", odsetek + 2 * blad_MC + 0.018, odsetek - 2 * blad_MC - 0.018), label = sprintf("%.1f", 100 * odsetek)), position = dz,
            size = 3.3, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(15, 17), name = NULL) +
  scale_x_discrete(labels = function(x) sub(" σ", "\nσ", x)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, NA), breaks = seq(0, 0.4, 0.05)) +
  labs(title = "B. Odsetek odrzuceń H0 przy k = 4 i równych wariancjach", x = "Rozkład danych w grupach",
       y = "Rzeczywisty błąd I rodzaju") +
  motyw
pA + pB + plot_layout(widths = c(1, 1.25))
Wynik w R
    wzor      car
0.165796 0.165796
 k kryt_95 F_dwustronne
 2    3.51         3.47
 3    4.43           NA
 4    5.19           NA
 6    6.30           NA
 8    7.00           NA
[1] 0.358
             rozklad                test odsetek blad_MC
            normalny       Fmax Hartleya  0.0491  0.0022
            normalny Levene (od mediany)  0.0309  0.0017
           t (10 df)       Fmax Hartleya  0.0994  0.0030
           t (10 df) Levene (od mediany)  0.0307  0.0017
            t (5 df)       Fmax Hartleya  0.1964  0.0040
            t (5 df) Levene (od mediany)  0.0319  0.0018
 lognormalny σ = 0.5       Fmax Hartleya  0.3097  0.0046
 lognormalny σ = 0.5 Levene (od mediany)  0.0395  0.0019
         wykładniczy       Fmax Hartleya  0.4115  0.0049
         wykładniczy Levene (od mediany)  0.0426  0.0020
Jak opisać w pracy
Na co uważać
- Normalność. Test zakłada rozkład normalny w grupach. Gastwirth i in. (2009) przypominają, że wiele testów równości wariancji zakłada normalność i nie jest odpornych na jej brak, a w porównaniu Conovera i in. (1981) odporne i mocne było tylko kilka testów. Przy danych skośnych wybierz test Levene’a z medianą.
- Równe liczebności. Tablice dotyczą grup o tej samej liczebności.
- Fmax jako opis. Sam iloraz wariancji dobrze opisuje skalę problemu, ale o teście średnich nie decyduj na podstawie testu wstępnego – stosuj od razu ANOVA Welcha.
Fmax Hartleya w R
Kod liczy wariancje w czterech grupach i statystykę Fmax ręcznie, a dla porównania podaje p z testów Bartletta i Flignera–Killeena (pakiet stats). Wartości krytycznych Fmax kod nie liczy.
Iloraz największej i najmniejszej wariancji
R
set.seed(508)
g <- factor(rep(c("A", "B", "C", "D"), each = 12))
y <- rnorm(48, mean = 50, sd = rep(c(6, 7, 8, 12), each = 12))
w <- tapply(y, g, var)
round(w, 2)
Fmax <- max(w) / min(w)
round(Fmax, 2)                       # statystyka Hartleya: k = 4, df = n - 1 = 11
round(bartlett.test(y ~ g)$p.value, 3)
fk <- fligner.test(y ~ g)
round(c(chi2 = unname(fk$statistic), df = unname(fk$parameter), p = fk$p.value), 3)
Wynik w R
    A     B     C     D
52.26 26.03 47.23 72.23
[1] 2.77
[1] 0.444
 chi2    df     p
5.074 3.000 0.166
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje var(), bartlett.test() i fligner.test() z pakietu stats). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork (zgodność testu Levene’a sprawdzono pakietem car), a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
Najczęstsze pytania
Czy Fmax można porównać z rozkładem F?
Nie. Iloraz dotyczy najbardziej skrajnej pary spośród k grup, więc ma inny rozkład niż zwykłe F dla dwóch wariancji. Tylko przy dwóch grupach Fmax jest równoważny dwustronnemu testowi F.
Co zrobić, gdy liczebności grup są różne?
Tablice Hartleya dotyczą równych liczebności. Przy różnych n użyj testu Levene’a z medianą lub testu Flignera–Killeena, a Fmax podaj najwyżej jako opis rozrzutu wariancji.
Dlaczego Fmax rzadko pojawia się w programach statystycznych?
Bo jest skrótem z czasów liczenia ręcznego: korzysta tylko z dwóch wariancji i wymaga normalności. Programy oferują zwykle odporniejsze testy, np. Levene’a, Browna–Forsythe’a czy Flignera–Killeena.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Conover, W. J., Johnson, M. E., & Johnson, M. M. (1981). A comparative study of tests for homogeneity of variances, with applications to the outer continental shelf bidding data. Technometrics, 23(4), 351–361. https://doi.org/10.1080/00401706.1981.10487680
- Gastwirth, J. L., Gel, Y. R., & Miao, W. (2009). The impact of Levene’s test of equality of variances on statistical theory and practice. Statistical Science, 24(3), 343–360. https://doi.org/10.1214/09-sts301 ● Otwarty dostęp
- Hartley, H. O. (1950). The maximum F-ratio as a short-cut test for heterogeneity of variance. Biometrika, 37(3–4), 308–312. https://doi.org/10.1093/biomet/37.3-4.308
Cytowania BibTeX
@article{conover1981comparative, author={Conover, W. J. and Johnson, Mark E. and Johnson, Myrle M.}, title={{A comparative study of tests for homogeneity of variances, with applications to the outer continental shelf bidding data}}, journal={Technometrics}, year={1981}, volume={23}, number={4}, pages={351--361}, doi={10.1080/00401706.1981.10487680}}@article{gastwirth2009impact, author={Gastwirth, Joseph L. and Gel, Yulia R. and Miao, Weiwen}, title={{The impact of Levene’s test of equality of variances on statistical theory and practice}}, journal={Statistical Science}, year={2009}, volume={24}, number={3}, pages={343--360}, doi={10.1214/09-sts301}}@article{hartley1950maximum, author={Hartley, H. O.}, title={{The maximum F-ratio as a short-cut test for heterogeneity of variance}}, journal={Biometrika}, year={1950}, volume={37}, number={3–4}, pages={308--312}, doi={10.1093/biomet/37.3-4.308}}