Kim był Frank Yates?
Frank Yates (1902–1994) urodził się 12 maja 1902 r. jako jedyny syn Percy’ego i Edith Yatesów z Didsbury pod Manchesterem; ojciec był wspólnikiem w rodzinnej firmie nasienniczej. Od 1916 r. uczył się w Clifton College, a jako stypendysta St John’s College w Cambridge ukończył w 1924 r. matematykę z wyróżnieniem (first class honours) (Finney, 1995).
Po krótkiej pracy nauczyciela w Malvern College wyjechał w 1927 r. na Złote Wybrzeże (dziś Ghana) jako matematyk służby geodezyjnej. Tam nauczył się metody najmniejszych kwadratów Gaussa, która później okazała się kluczem do jego prac nad planami doświadczeń. Od 31 sierpnia 1931 r. był asystentem statystyka w stacji doświadczalnej Rothamsted u Ronalda Fishera, a gdy w 1933 r. Fisher przeszedł na University College London, Yates objął po nim dział statystyki i kierował nim do emerytury w 1968 r. W latach 1958–1968 był też zastępcą dyrektora stacji. Członkiem Royal Society został w 1948 r., w 1960 r. otrzymał złoty Medal Guya, a w latach 1967–1968 był prezesem Royal Statistical Society. Po emeryturze przez około 10 lat pracował w Imperial College. Zmarł 17 czerwca 1994 r. (Finney, 1995).
Najważniejsze pomysły
- Doświadczenia czynnikowe. Jego monografia z 1937 r., w Rothamsted nazywana „TC35” (Yates, 1937), przez lata była podstawowym źródłem o nietrywialnych planach czynnikowych. Rozwinął Fisherowskie pomieszanie (confounding) efektów z blokami, a z kratowych planów niekompletnych bloków skorzystali hodowcy roślin (Finney, 1995). Zob. schemat czynnikowy 2 × 2 i interakcja trójczynnikowa.
- Algorytm Yatesa. Prosty sposób obliczania wszystkich efektów planu 2n przez powtarzane sumy i różnice par. Zapytany przez Davida Coxa, jak wpadł na tak pomysłowy sposób, odpowiedział, że to przecież oczywiste (Finney, 1995).
- Poprawka na ciągłość (1934). W pracy o tabelach z małymi liczebnościami zaproponował poprawkę Yatesa do testu chi-kwadrat dla tabel 2 × 2 (Yates, 1934).
- Tablice i braki danych. Z Fisherem wydał tablice statystyczne dla biologii, rolnictwa i medycyny (do 6. wydania w 1963 r.). Opracował też iteracyjne szacowanie plonów z poletek, które przepadły, tak by dało się użyć zwykłej analizy wariancji (Finney, 1995).
- Badania próbkowe. Książka Sampling Methods for Censuses and Surveys (1949), przygotowana jako podręcznik dla podkomisji ONZ do spisów powszechnych, utrwaliła m.in. termin frame – po polsku operat losowania (Finney, 1995).
Ciekawostka
W 1954 r. Yates zdobył dla Rothamsted komputer elektroniczny Elliott 401. Maszyna miała lampy i pamięć na bębnie magnetycznym, przyszła z jedną stroną instrukcji i prawie bez oprogramowania; dane wczytywał domowej roboty czytnik taśmy, a wyniki drukowała zwykła maszyna do pisania. Yates potrafił godzinami układać kod na bębnie, wpatrzony w ekran lampy oscyloskopowej. Wkrótce jego dział analizował na komputerze ponad 4000 doświadczeń rocznie, a programy od początku miały kontrolę poprawności danych. W latach 1960–1961 Yates był prezesem British Computer Society (Finney, 1995).
Przykład: algorytm Yatesa na danych npk
Zbiór npk z pakietu datasets to według pliku pomocy klasyczne doświadczenie czynnikowe N, P, K (azot, fosfor, potas) z groszkiem na 6 blokach; każdy blok dostał połowę planu 2 × 2 × 2, w której pomieszano interakcję N:P:K z blokami. Każda z 8 kombinacji wystąpiła 3 razy. Zysk z bloków na tych danych pokazuje hasło Gertrude M. Cox; tu liczymy efekty ręcznie.
Sumy plonów z 3 poletek ustawiamy w porządku standardowym: (1), n, p, np, k, nk, pk, npk. Algorytm Yatesa trzy razy (bo 23) zastępuje kolumnę sumami kolejnych par (górna połowa) i ich różnicami (dolna połowa). Ostatnia kolumna to kontrasty: od 1317.0 (suma wszystkich plonów) przez 67.4 dla N do 29.8 dla N:P:K. Kontrast podzielony przez 12 daje efekt, a jego kwadrat podzielony przez 24 – sumę kwadratów. Azot zwiększa plon średnio o 5.617 funta z poletka, potas zmniejsza o 3.983.
Sumy kwadratów z algorytmu (np. 189.28 dla N i 95.20 dla K) są identyczne z tabelą aov(). Różnica: aov() nie pokazuje N:P:K, bo ten efekt (suma kwadratów 37.00) jest pomieszany z blokami i zawiera się w ich sumie kwadratów 343.3. Z resztowego średniego kwadratu 15.441 (12 df) błąd standardowy efektu wynosi 1.604; 95% przedział dla N to [2.12, 9.11], a dla K [−7.48, −0.49].
Na rysunku
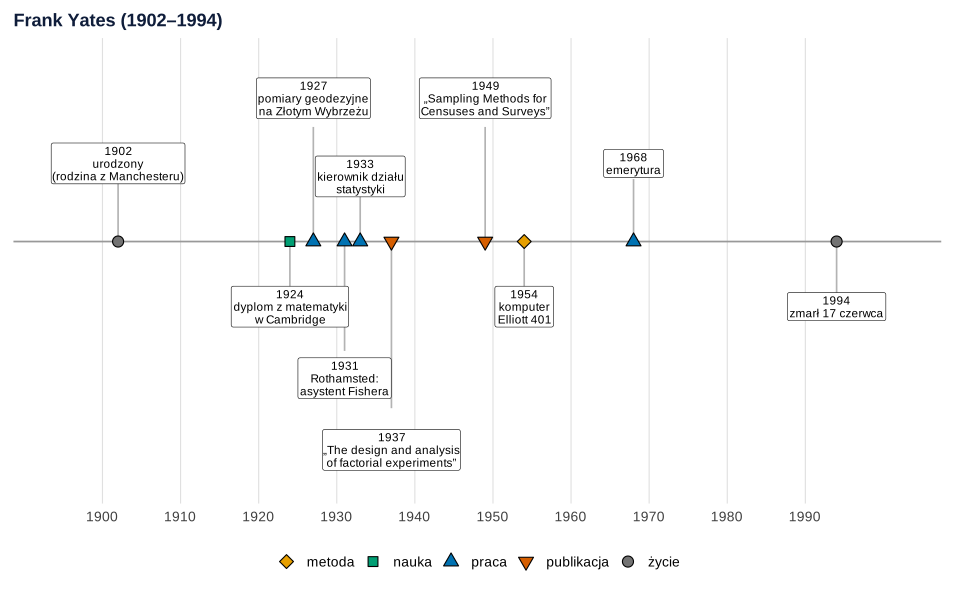
Co widać. Najważniejsze prace o planach doświadczeń powstały w ciągu sześciu lat od przyjścia do Rothamsted, a komputer pojawił się w połowie kariery.
Na co uważać. Oś zawiera tylko daty z jednego, wyczerpującego wspomnienia biograficznego. Rok pierwszego wydania tablic Fishera i Yatesa pominęliśmy, bo nie potwierdziliśmy go w drugim źródle.
Podpis do pracy:
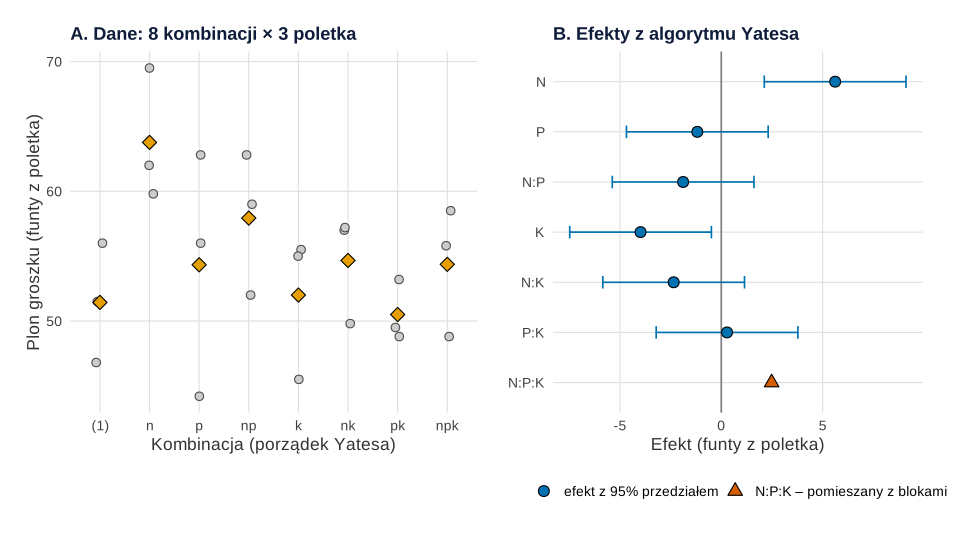
datasets::npk. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork.Co widać. Na panelu A różnice między kombinacjami giną w rozrzucie poletek; algorytm Yatesa porządkuje je w siedem efektów. Wyraźne są tylko efekty azotu (dodatni) i potasu (ujemny).
Na co uważać. Efekt N:P:K da się policzyć, ale nie da się go ocenić: każdy blok dostał połowę planu, więc różnica między połówkami jest zarazem różnicą między blokami. To cena, którą Yates świadomie płacił za mniejsze bloki. Przedziały nie są korygowane na porównania wielokrotne.
Podpis do pracy:
Gdzie spotkasz Yatesa w swojej pracy
- Tabela 2 × 2. Programy przy teście chi-kwadrat dla tabeli 2 × 2 często podają wynik „z poprawką na ciągłość” – to poprawka Yatesa; porównanie z testem dokładnym znajdziesz we wpisie chi-kwadrat czy test Fishera.
- Eksperymenty czynnikowe. Gdy planujesz kilka czynników naraz, korzystasz z jego pomysłów – zob. frakcyjny schemat czynnikowy i wpis eksperyment czynnikowy i frakcyjny. Finney (1995) pisze, że pomysł frakcyjnej replikacji, przypisywany jemu, rzucił w rozmowie Yates.
- Raportowanie. Pierwsze użycie gwiazdek do oznaczania poziomu istotności pochodzi z TC35 (Finney, 1995), ale sam Yates uważał, że ważniejsza od istotności różnicy jest jej wielkość – zob. wartość p.
Spory, mity i trudne strony
- Poprawka na ciągłość. Nie została powszechnie uznana za ulepszenie; Yates bronił jej jeszcze w wieku 82 lat w osobnej pracy (Finney, 1995). Alternatywą przy małych liczebnościach jest test dokładny Fishera.
- Silne poglądy. Finney (1995) opisuje go jako dogmatycznego: nie widział pożytku z funkcji mocy i nie znosił mechanicznego szukania istotności. Nelder i Lane (1995) w artykule jego pamięci ocenili w świetle idei Yatesa spór o komputerową analizę doświadczeń czynnikowych i skrytykowali m.in. pomijanie zasady marginalności.
- Wojna. W czasie II wojny światowej zebrał wyniki około 5000 doświadczeń nawozowych w syntezę, którą Finney nazywa prawdziwą metaanalizą, a z Solly’m Zuckermanem analizował skutki bombardowań (Finney, 1995). Z jego zespołu wyszli później profesorowie uczelni – jako pierwszy William G. Cochran.
Yates w R
Kod rysuje oś czasu, a potem liczy efekty doświadczenia npk algorytmem Yatesa: sumy 8 kombinacji w porządku standardowym, trzy kroki sum i różnic par, efekty i sumy kwadratów. Następnie porównuje je z tabelą aov(), pokazuje pomieszanie N:P:K z blokami i liczy 95% przedziały efektów. Niczego nie losuje. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i algorytm Yatesa dla planu 2 × 2 × 2
Kod R rysunków 1 i 2 i obliczeń
# Frank Yates: oś czasu i algorytm Yatesa dla doświadczenia czynnikowego 2 × 2 × 2 (dane npk)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Finneya 1995)
zdarzenia <- data.frame(
  rok = c(1902, 1924, 1927, 1931, 1933, 1937, 1949, 1954, 1968, 1994),
  opis = c("urodzony\n(rodzina z Manchesteru)", "dyplom z matematyki\nw Cambridge", "pomiary geodezyjne\nna Złotym Wybrzeżu",
           "Rothamsted:\nasystent Fishera", "kierownik działu\nstatystyki", "„The design and analysis\nof factorial experiments”",
           "„Sampling Methods for\nCensuses and Surveys”", "komputer\nElliott 401", "emerytura", "zmarł 17 czerwca"),
  rodzaj = c("życie", "nauka", "praca", "praca", "praca", "publikacja", "publikacja", "metoda", "praca", "życie"))
zdarzenia$y <- c(1.2, -1, 2.2, -2.1, 1, -3.2, 2.2, -1, 1.2, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "nauka" = 22, "praca" = 24, "metoda" = 23, "publikacja" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "nauka" = oi[["zielony"]], "praca" = oi[["niebieski"]],
                               "metoda" = oi[["pomaranczowy"]], "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1900, 1990, 10), limits = c(1894, 2002)) + scale_y_continuous(limits = c(-3.7, 2.8)) +
  labs(title = "Frank Yates (1902–1994)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: doświadczenie N, P, K z groszkiem – 6 bloków po 4 poletka, każda z 8 kombinacji 3 razy (datasets::npk)
data(npk, package = "datasets")
npk$kombinacja <- paste0(ifelse(npk$N == "1", "n", ""), ifelse(npk$P == "1", "p", ""), ifelse(npk$K == "1", "k", ""))
npk$kombinacja[npk$kombinacja == ""] <- "(1)"
porzadek <- c("(1)", "n", "p", "np", "k", "nk", "pk", "npk")      # porządek standardowy Yatesa
sumy <- tapply(npk$yield, npk$kombinacja, sum)[porzadek]            # sumy z 3 powtórzeń
r <- 3
table(npk$kombinacja)[porzadek]

# 3. Algorytm Yatesa: trzy razy (bo 2^3) – górna połowa = sumy kolejnych par, dolna = różnice kolejnych par
krok <- function(x) c(x[c(1, 3, 5, 7)] + x[c(2, 4, 6, 8)], x[c(2, 4, 6, 8)] - x[c(1, 3, 5, 7)])
k1 <- krok(sumy); k2 <- krok(k1); k3 <- krok(k2)
yates <- data.frame(kombinacja = porzadek, suma = sumy, krok1 = k1, krok2 = k2, kontrast = k3,
                    efekt = k3 / (4 * r), SS = k3^2 / (8 * r))
yates$efekt[1] <- k3[1] / (8 * r)                                   # pierwszy wiersz: średnia ogólna
yates$nazwa <- c("średnia", "N", "P", "N:P", "K", "N:K", "P:K", "N:P:K")
yates[, -1] |> transform(efekt = round(efekt, 3), SS = round(SS, 2))

# 4. To samo w aov(): N:P:K znika, bo jest pomieszane z blokami (każdy blok dostał połowę planu)
model <- aov(yield ~ block + N * P * K, data = npk)
summary(model)
alias(model)$Complete
# Suma kwadratów bloków = N:P:K + różnice między blokami w obrębie połówek planu
c(SS_bloki = sum((tapply(npk$yield, npk$block, mean) - mean(npk$yield))^2) * 4, SS_NPK_Yates = yates$SS[8]) |> round(2)

# 5. Efekty z 95% przedziałami (błąd z analizy z blokami: SE = √(MSE · (1/12 + 1/12)))
mse <- deviance(model) / df.residual(model)
se_efektu <- sqrt(mse * (1 / 12 + 1 / 12))
efekty <- yates[-1, c("nazwa", "efekt")]
efekty$dolna <- efekty$efekt - qt(0.975, df.residual(model)) * se_efektu
efekty$gorna <- efekty$efekt + qt(0.975, df.residual(model)) * se_efektu
efekty$pomieszany <- efekty$nazwa == "N:P:K"
efekty[efekty$pomieszany, c("dolna", "gorna")] <- NA                  # brak oceny błędu: efekt pomieszany z blokami
round(c(MSE = mse, df = df.residual(model), SE = se_efektu), 3)
transform(efekty, efekt = round(efekt, 2), dolna = round(dolna, 2), gorna = round(gorna, 2))

# Rysunek 2A: plony 24 poletek w 8 kombinacjach (porządek standardowy) ze średnimi
npk$kombinacja <- factor(npk$kombinacja, levels = porzadek)
srednie <- data.frame(kombinacja = factor(porzadek, levels = porzadek), m = as.numeric(sumy / r))
pA <- ggplot(npk, aes(kombinacja, yield)) +
  geom_point(shape = 21, size = 2.6, fill = "grey80", colour = "grey30", position = position_jitter(width = 0.08, height = 0, seed = 1937)) +
  geom_point(data = srednie, aes(y = m), shape = 23, size = 3.6, fill = oi[["pomaranczowy"]]) +
  labs(title = "A. Dane: 8 kombinacji × 3 poletka", x = "Kombinacja (porządek Yatesa)", y = "Plon groszku (funty z poletka)") +
  motyw
# Rysunek 2B: efekty z algorytmu Yatesa z 95% przedziałami
efekty$nazwa <- factor(efekty$nazwa, levels = rev(efekty$nazwa))
pB <- ggplot(efekty, aes(efekt, nazwa)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = oi[["niebieski"]], na.rm = TRUE) +
  geom_point(aes(shape = pomieszany, fill = pomieszany), size = 3.4) +
  scale_shape_manual(values = c("FALSE" = 21, "TRUE" = 24), labels = c("efekt z 95% przedziałem", "N:P:K – pomieszany z blokami"), name = NULL) +
  scale_fill_manual(values = c("FALSE" = oi[["niebieski"]], "TRUE" = oi[["cynober"]]), labels = c("efekt z 95% przedziałem", "N:P:K – pomieszany z blokami"), name = NULL) +
  labs(title = "B. Efekty z algorytmu Yatesa", x = "Efekt (funty z poletka)", y = NULL) +
  motyw + theme(legend.position = "bottom")
p_metoda <- pA + pB + plot_layout(widths = c(1.1, 1))
p_os
p_metoda
Wynik w R
(1)   n   p  np   k  nk  pk npk
  3   3   3   3   3   3   3   3
     suma krok1 krok2 kontrast  efekt       SS   nazwa
(1) 154.3 345.6 682.4   1317.0 54.875 72270.38 średnia
n   191.3 336.8 634.6     67.4  5.617   189.28       N
p   163.0 320.0  47.8    -14.2 -1.183     8.40       P
np  173.8 314.6  19.6    -22.6 -1.883    21.28     N:P
k   156.0  37.0  -8.8    -47.8 -3.983    95.20       K
nk  164.0  10.8  -5.4    -28.2 -2.350    33.14     N:K
pk  151.5   8.0 -26.2      3.4  0.283     0.48     P:K
npk 163.1  11.6   3.6     29.8  2.483    37.00   N:P:K
            Df Sum Sq Mean Sq F value  Pr(>F)
block        5  343.3   68.66   4.447 0.01594 *
N            1  189.3  189.28  12.259 0.00437 **
P            1    8.4    8.40   0.544 0.47490
K            1   95.2   95.20   6.166 0.02880 *
N:P          1   21.3   21.28   1.378 0.26317
N:K          1   33.1   33.14   2.146 0.16865
P:K          1    0.5    0.48   0.031 0.86275
Residuals   12  185.3   15.44
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
         (Intercept) block2 block3 block4 block5 block6 N1   P1   K1   N1:P1
N1:P1:K1    0         1/4    1/4    1/4      0      0   -1/4 -1/4 -1/4  1/2
         N1:K1 P1:K1
N1:P1:K1  1/2   1/2
    SS_bloki SS_NPK_Yates
       343.3         37.0
   MSE     df     SE
15.441 12.000  1.604
    nazwa efekt dolna gorna pomieszany
n       N  5.62  2.12  9.11      FALSE
p       P -1.18 -4.68  2.31      FALSE
np    N:P -1.88 -5.38  1.61      FALSE
k       K -3.98 -7.48 -0.49      FALSE
nk    N:K -2.35 -5.85  1.15      FALSE
pk    P:K  0.28 -3.21  3.78      FALSE
npk N:P:K  2.48    NA    NA       TRUE
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – pakiet datasets; analiza wariancji – funkcja aov() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Frank Yates?
Brytyjskim statystykiem (1902–1994). Po studiach matematycznych w Cambridge i pracy geodety na Złotym Wybrzeżu trafił w 1931 r. do Rothamsted jako asystent Fishera, a od 1933 do 1968 r. kierował tamtejszym działem statystyki. Projektował doświadczenia czynnikowe, pisał o badaniach próbkowych i wcześnie wprowadził komputery do analiz.
Na czym polega algorytm Yatesa?
To ręczny sposób liczenia wszystkich efektów planu 2^n. Sumy wyników ustawia się w porządku standardowym i n razy zastępuje kolumnę sumami kolejnych par (górna połowa) i różnicami (dolna połowa). Ostatnia kolumna to kontrasty: po podzieleniu dają efekty główne i interakcje, a ich kwadraty – sumy kwadratów do ANOVA.
Skąd nazwa „poprawka Yatesa”?
Od nazwiska autora: Yates zaproponował ją w 1934 r. w pracy o tabelach kontyngencji z małymi liczebnościami. Poprawka na ciągłość zmniejsza wartość chi-kwadrat dla tabeli 2 × 2. Nie wszyscy uznali ją za ulepszenie; Yates bronił jej jeszcze w wieku 82 lat.
Co to jest pomieszanie efektów z blokami?
Sposób na mniejsze bloki w doświadczeniu czynnikowym: każdy blok dostaje tylko część kombinacji, a jedna mało ważna interakcja (np. N:P:K) zostaje pomieszana z różnicami między blokami. Tracimy możliwość jej oceny, zyskujemy precyzję pozostałych efektów. Yates systematycznie rozwinął ten pomysł Fishera.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Eksperyment czynnikowy i frakcyjny
Pięć składników interwencji w 16 warunkach: plan 2^(5−1), aliasy w FrF2, kodowanie −1/+1, liczebność na efekt i pułapka rozdzielczości III.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Finney, D. J. (1995). Frank Yates, 12 May 1902 – 17 June 1994. Biographical Memoirs of Fellows of the Royal Society, 41(41), 554–573. https://doi.org/10.1098/rsbm.1995.0033 ● Otwarty dostęp: pełny tekst
- Nelder, J. A., & Lane, P. W. (1995). The computer analysis of factorial experiments: In memoriam—Frank Yates. The American Statistician, 49(4), 382–385. https://doi.org/10.1080/00031305.1995.10476189
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604 ● Otwarty dostęp: pełny tekst
- Yates, F. (1937). The design and analysis of factorial experiments (Technical Communication No. 35). Imperial Bureau of Soil Science.
Cytowania BibTeX
@article{finney1995frank, author={Finney, David John}, title={{Frank Yates, 12 May 1902 – 17 June 1994}}, journal={Biographical Memoirs of Fellows of the Royal Society}, year={1995}, volume={41}, number={41}, pages={554--573}, doi={10.1098/rsbm.1995.0033}}@article{nelder1995computer, author={Nelder, John A. and Lane, Peter W.}, title={{The computer analysis of factorial experiments: In memoriam—Frank Yates}}, journal={The American Statistician}, year={1995}, volume={49}, number={4}, pages={382--385}, doi={10.1080/00031305.1995.10476189}}@article{yates1934contingency, author={Yates, F.}, title={{Contingency tables involving small numbers and the χ² test}}, journal={Supplement to the Journal of the Royal Statistical Society}, year={1934}, volume={1}, number={2}, pages={217--235}, doi={10.2307/2983604}}@book{yates1937design, author={Yates, Frank}, title={{The design and analysis of factorial experiments (Technical Communication No. 35)}}, year={1937}, publisher={Imperial Bureau of Soil Science}, url={https://openlibrary.org/books/OL45387804M}}