Co to jest metoda ADF?
Metoda asymptotycznie wolna od rozkładu (ang. asymptotically distribution-free, ADF) to metoda estymacji modeli SEM i CFA, która nie wymaga wielowymiarowej normalności zmiennych obserwowalnych. Zaproponował ją Browne (1984). Wyprowadził dla niej test dopasowania i błędy standardowe, które są poprawne przy dowolnym rozkładzie – ale asymptotycznie, czyli dopiero w bardzo dużych próbach. Ta jedna cecha decyduje o praktycznej przydatności metody.
„Asymptotycznie” znaczy tu: w granicy, gdy liczebność próby rośnie do nieskończoności. Własności obiecane przez teorię – nieobciążony test χ² i trafne błędy standardowe – nie mówią nic o tym, jak metoda zachowuje się przy 200 czy 400 osobach. To trzeba sprawdzać w symulacjach, i właśnie one pokazały słabość ADF.
W programach ADF występuje pod różnymi nazwami. W lavaan i LISREL to WLS (ważone najmniejsze kwadraty z pełną macierzą wag) zastosowane do zmiennych ciągłych, w EQS – AGLS, w AMOS – ADF. Nie należy jej mylić z WLSMV. WLSMV jest przeznaczony dla danych porządkowych, używa tylko przekątnej macierzy wag i skorygowanej statystyki testu, więc zachowuje się zupełnie inaczej.
Jak działa ADF – funkcja rozbieżności i macierz wag
Wszystkie estymatory SEM minimalizują rozbieżność między macierzą kowariancji z próby a macierzą odtworzoną przez model. ADF zapisuje obie macierze jako wektory niepowtarzających się elementów i waży ich różnice:
Tu s to wektor wariancji i kowariancji z próby, σ(θ) – ten sam wektor odtworzony z parametrów modelu θ, a W – macierz asymptotycznych kowariancji elementów s, szacowana z momentów czwartego rzędu danych. Właśnie W „przenosi” do estymacji informację o skośności i kurtozie. Dzięki temu ADF nie musi zakładać rozkładu normalnego. Statystyka testu to N × FADF (w części programów (N − 1) × FADF), porównywana z rozkładem χ² o tylu stopniach swobody co w zwykłej statystyce CMIN.
Cena jest wysoka. Przy p zmiennych wektor s ma p* = p(p + 1)/2 elementów, a macierz wag – p*(p* + 1)/2 niepowtarzających się elementów. Dla 12 wskaźników to 78 momentów i 3081 elementów macierzy wag, które trzeba oszacować z danych, zanim w ogóle zacznie się szacować model. Przy 300 osobach macierz wag jest więc oszacowana bardzo nieprecyzyjnie, a jej odwrotność – jeszcze gorzej.
Przykład: jeden zbiór danych i symulacja
Model CFA ma trzy skorelowane czynniki: objawy somatyczne, lękowe i depresyjne, po cztery wskaźniki częstości objawów w ostatnim miesiącu (dane symulowane). Rozkłady są silnie prawoskośne, jak zwykle przy objawach w próbie nieklinicznej: skośność wskaźników w próbie wynosiła od 1.17 do 2.75, a kurtoza nadwyżkowa – od 1.21 do 12.42. Model jest poprawny, bo dokładnie tak wygenerowano dane.
W próbie N = 300 trzy metody dały:
| Metoda | χ²(51) | p | Standaryzowany ładunek S1 | SE ładunku S2 |
|---|---|---|---|---|
| ML (zakłada normalność) | 63.23 | .117 | .776 | 0.074 |
| ML + korekta Satorry–Bentlera (MLM) | 48.35 | .579 | .776 | 0.090 |
| ADF (WLS) | 51.99 | .435 | .815 | 0.074 |
Warto zwrócić uwagę na ostatnią kolumnę. Przy tak silnej kurtozie błąd standardowy ładunku powinien być większy niż w zwykłym ML – i rzeczywiście skorygowany błąd MLM wynosi 0.090. ADF dał tymczasem 0.074, czyli tyle samo co ML ignorujące nienormalność. Standaryzowany ładunek S1 był w ADF wyższy (.815 wobec .776). Oszacowania ADF w umiarkowanej próbie różnią się więc od ML nie tylko testem dopasowania.
Poza tym w tym jednym zbiorze ADF nie wygląda źle. Pojedyncza próba niewiele jednak mówi o metodzie, dlatego powtórzyliśmy analizę 250 razy dla każdej z pięciu liczebności. Rysunek 1 pokazuje, jak często test χ² odrzucał poprawny model przy α = .05. Dobra metoda powinna to robić w około 5% prób.
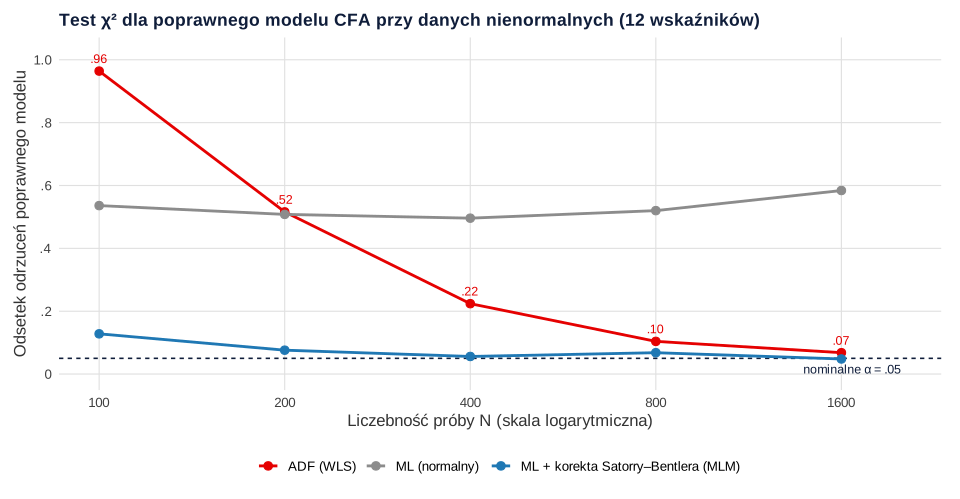
Wynik powtarza klasyczne ustalenia. Przy N = 100 ADF odrzucał poprawny model w 96% prób, przy N = 400 – w 22%, a do poziomu bliskiego 5% zbliżył się dopiero przy 1600 osobach (6.8%). Zwykłe ML, które ignoruje kurtozę, odrzucało poprawny model w około połowie prób przy każdej liczebności. Najlepiej wypadło ML ze skalowaną statystyką Satorry–Bentlera: 12.8% przy N = 100, 7.6% przy N = 200 i od 4.8% do 6.8% w większych próbach. Hu i in. (1992) opisali test ADF jako działający „spektakularnie źle” we wszystkich warunkach poza największymi próbami. Curran i in. (1996) stwierdzili, że ADF jest obciążony we wszystkich próbach poza największymi, a skalowana statystyka Satorry–Bentlera – nie.
Kiedy (nie) stosować ADF
- Ciągłe wskaźniki, nienormalne, umiarkowana próba – zamiast ADF użyj ML z odpornymi błędami standardowymi i skalowanym testem (MLM, MLR) albo bootstrapu w SEM.
- Pozycje porządkowe (np. skala Likerta 1–5) – zamiast ADF na surowych wynikach użyj korelacji polichorycznych z WLSMV. Flora i Curran (2004) pokazali, że pełny WLS działał poprawnie tylko w największej próbie, a odporny WLS – we wszystkich warunkach.
- Bardzo duża próba (tysiące osób) i niewiele wskaźników – ADF jest dopuszczalny. Nawet wtedy porównaj wynik z MLR.
- Model źle określony – Olsson i in. (2000) stwierdzili, że WLS w żadnych warunkach nie był lepszy od ML i GLS. Przy modelach błędnych dawał niestabilne oszacowania i zbyt optymistyczne dopasowanie.
Pamiętaj, że „wolna od rozkładu” nie znaczy „wolna od założeń”. ADF nadal wymaga poprawnej specyfikacji modelu, niezależnych obserwacji, kompletnych danych (albo odpowiedniego postępowania z brakami) i macierzy wag, którą da się odwrócić.
Jak opisać wybór estymatora w pracy
Napisz, jak oceniono rozkład zmiennych (skośność, kurtoza, ewentualnie wielowymiarowa kurtoza Mardii) i dlaczego wybrano daną metodę. Jeśli recenzent albo promotor proponuje ADF przy próbie kilkusetosobowej, możesz odpowiedzieć zdaniem opartym na literaturze. Przykład opisu:
ADF w R (lavaan)
Kod liczy rozmiar macierzy wag dla 12 wskaźników, generuje nienormalne dane z modelu trójczynnikowego, porównuje ML, MLM i ADF (w lavaan: estimator = "WLS") w jednej próbie, a potem powtarza test dopasowania poprawnego modelu w 250 replikacjach dla pięciu liczebności. Liczby w tekście, w tabeli i na rysunku 1 pochodzą z tego kodu. Symulacja trwa kilka minut.
ML, MLM i ADF przy danych nienormalnych
R
# R120 – metoda ADF (w lavaan: estimator = "WLS" dla zmiennych ciągłych)
# Dane symulowane: model trójczynnikowy, 12 wskaźników o silnie nienormalnym rozkładzie
# (skośność 2, kurtoza 7), np. częstość objawów somatycznych, lękowych i depresyjnych w ostatnim miesiącu.
suppressPackageStartupMessages(library(lavaan))
populacja <- '
  som =~ 0.75*S1 + 0.70*S2 + 0.70*S3 + 0.65*S4
  lek =~ 0.75*L1 + 0.70*L2 + 0.70*L3 + 0.65*L4
  dep =~ 0.75*D1 + 0.70*D2 + 0.70*D3 + 0.65*D4
  som ~~ 0.40*lek
  som ~~ 0.35*dep
  lek ~~ 0.50*dep
'
model <- '
  som =~ S1 + S2 + S3 + S4
  lek =~ L1 + L2 + L3 + L4
  dep =~ D1 + D2 + D3 + D4
'
generuj <- function(n) simulateData(populacja, sample.nobs = n, standardized = TRUE,
                                    skewness = 2, kurtosis = 7)

# Ile elementów musi oszacować ADF? p* = p(p + 1)/2 momentów, macierz wag p* × p*
p <- 12; p_gw <- p * (p + 1) / 2
c(p_gwiazdka = p_gw, elementy_macierzy_wag = p_gw * (p_gw + 1) / 2)

# 1. Jeden zbiór danych (N = 300): ML, ML z korektą Satorry–Bentlera (MLM) i ADF (WLS)
set.seed(120)
d <- generuj(300)
ks <- apply(d, 2, function(x) c(skosnosc = mean((x - mean(x))^3) / sd(x)^3,
                                kurtoza = mean((x - mean(x))^4) / sd(x)^4 - 3))
round(apply(ks, 1, range), 2)   # najmniejsza i największa wartość wśród 12 wskaźników
wyniki <- lapply(c(ML = "ML", MLM = "MLM", ADF = "WLS"), function(e) cfa(model, data = d, estimator = e))
round(t(sapply(wyniki, function(f) {
  fm <- fitMeasures(f, c("chisq", "df", "pvalue", "chisq.scaled", "pvalue.scaled"))
  if (is.na(fm["chisq.scaled"])) fm[c("chisq.scaled", "pvalue.scaled")] <- fm[c("chisq", "pvalue")]
  c(chi2 = unname(fm["chisq.scaled"]), df = unname(fm["df"]), p = unname(fm["pvalue.scaled"]))
})), 3)
# ładunek S1 (standaryzowany) i błąd standardowy ładunku niestandaryzowanego S2
round(t(sapply(wyniki, function(f) {
  pe <- parameterEstimates(f, standardized = TRUE)
  c(lambda_S1_std = pe$std.all[pe$lhs == "som" & pe$rhs == "S1"],
    b_S2 = pe$est[pe$lhs == "som" & pe$rhs == "S2"], SE_S2 = pe$se[pe$lhs == "som" & pe$rhs == "S2"])
})), 3)

# 2. Symulacja: jak często test chi-kwadrat odrzuca POPRAWNY model (α = .05)?
set.seed(1201)
N <- c(100, 200, 400, 800, 1600); R <- 250
sym <- do.call(rbind, lapply(N, function(n) {
  do.call(rbind, lapply(seq_len(R), function(r) {
    dd <- generuj(n)
    sapply(c(ML = "ML", MLM = "MLM", ADF = "WLS"), function(e) {
      f <- tryCatch(suppressWarnings(cfa(model, data = dd, estimator = e)), error = function(err) NULL)
      if (is.null(f) || !lavInspect(f, "converged")) return(NA)
      fm <- fitMeasures(f, c("pvalue", "pvalue.scaled"))
      unname(if (e == "MLM") fm["pvalue.scaled"] else fm["pvalue"])
    }) -> pv
    data.frame(n = n, estymator = names(pv), p = pv)
  }))
}))
odrzucenia <- aggregate(p ~ n + estymator, data = sym, FUN = function(x) mean(x < .05), na.action = na.omit)
names(odrzucenia)[3] <- "odsetek_odrzucen"
odrzucenia$odsetek_odrzucen <- round(odrzucenia$odsetek_odrzucen, 3)
odrzucenia[order(odrzucenia$estymator, odrzucenia$n), ]
# liczba replikacji bez zbieżności
aggregate(p ~ n + estymator, data = transform(sym, p = is.na(p)), FUN = sum)
saveRDS(odrzucenia, "adf-symulacja.rds")
Wynik w R
           p_gwiazdka elementy_macierzy_wag
                   78                  3081
     skosnosc kurtoza
[1,]     1.17    1.21
[2,]     2.75   12.42
      chi2 df     p
ML  63.230 51 0.117
MLM 48.354 51 0.579
ADF 51.989 51 0.435
    lambda_S1_std  b_S2 SE_S2
ML          0.776 0.832 0.074
MLM         0.776 0.832 0.090
ADF         0.815 0.823 0.074
      n estymator odsetek_odrzucen
1   100       ADF            0.964
2   200       ADF            0.516
3   400       ADF            0.224
4   800       ADF            0.104
5  1600       ADF            0.068
6   100        ML            0.536
7   200        ML            0.508
8   400        ML            0.496
9   800        ML            0.520
10 1600        ML            0.584
11  100       MLM            0.128
12  200       MLM            0.076
13  400       MLM            0.056
14  800       MLM            0.068
15 1600       MLM            0.048
      n estymator p
1   100       ADF 3
2   200       ADF 0
3   400       ADF 0
4   800       ADF 0
5  1600       ADF 0
6   100        ML 0
7   200        ML 0
8   400        ML 0
9   800        ML 0
10 1600        ML 0
11  100       MLM 0
12  200       MLM 0
13  400       MLM 0
14  800       MLM 0
15 1600       MLM 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- ADF „bo dane nie są normalne” przy 200–500 osobach. To zwykle zamiana jednego problemu (nienormalności) na większy: zawyżone χ² i niestabilne oszacowania.
- Utożsamianie ADF z WLSMV. Obie metody należą do rodziny ważonych najmniejszych kwadratów, ale działają na innych danych i inaczej szacują wagi.
- ADF na pozycjach Likerta traktowanych jako ciągłe. Dla danych porządkowych właściwsze są korelacje polichoryczne i WLSMV.
- Brak informacji o rozkładzie. Uzasadnienie wyboru estymatora wymaga podania skośności i kurtozy (zob. jak sprawdzić normalność rozkładu).
- Porównywanie indeksów dopasowania z różnych estymatorów według tych samych progów. Progi z badań symulacyjnych dotyczą zwykle ML.
Wybór estymatora jako jeden z etapów całej analizy omawia przewodnik CB-SEM. Porównanie ML i metody GLS przy błędnym modelu znajdziesz w haśle metoda uogólnionych najmniejszych kwadratów (GLS), a podstawy ML – w haśle metoda największej wiarygodności.
Najczęstsze pytania
Jak duża próba jest potrzebna do metody ADF?
Zależy to od liczby wskaźników, bo macierz wag rośnie bardzo szybko: dla 12 wskaźników ma 3081 niepowtarzających się elementów. W symulacji z tego hasła test ADF zbliżył się do nominalnych 5% odrzuceń poprawnego modelu dopiero przy 1600 osobach. Przy kilkuset osobach wyniki ADF są zwykle zbyt optymistyczne albo zbyt surowe.
Czym różni się ADF od WLSMV?
ADF (pełny WLS) stosuje się do zmiennych ciągłych i odwraca całą macierz wag. WLSMV służy do danych porządkowych, opiera się na korelacjach polichorycznych, używa tylko przekątnej macierzy wag i skorygowanej statystyki χ². Dlatego WLSMV działa stabilnie w znacznie mniejszych próbach.
Co wybrać zamiast ADF przy danych nienormalnych?
Dla zmiennych ciągłych zwykle ML z odpornymi błędami standardowymi i skalowanym testem (MLM, MLR) albo bootstrap. Dla pozycji Likerta z małą liczbą kategorii – WLSMV na korelacjach polichorycznych. W symulacji z tego hasła ML z korektą Satorry–Bentlera odrzucało poprawny model w 5–8% prób już od N = 200.
Jak ustawić estymator ADF w lavaan i AMOS?
W lavaan dla zmiennych ciągłych wpisz estimator = "WLS" w funkcji cfa() albo sem(). W AMOS metodę ADF wybiera się w ustawieniach estymacji (Asymptotically distribution-free); program wymaga wtedy kompletnych danych surowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Browne, M. W. (1984). Asymptotically distribution-free methods for the analysis of covariance structures. British Journal of Mathematical and Statistical Psychology, 37(1), 62–83. https://doi.org/10.1111/j.2044-8317.1984.tb00789.x
- Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16–29. https://doi.org/10.1037/1082-989x.1.1.16
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Hu, L., Bentler, P. M., & Kano, Y. (1992). Can test statistics in covariance structure analysis be trusted? Psychological Bulletin, 112(2), 351–362. https://doi.org/10.1037/0033-2909.112.2.351
- Olsson, U. H., Foss, T., Troye, S. V., & Howell, R. D. (2000). The performance of ML, GLS, and WLS estimation in structural equation modeling under conditions of misspecification and nonnormality. Structural Equation Modeling: A Multidisciplinary Journal, 7(4), 557–595. https://doi.org/10.1207/s15328007sem0704_3
Cytowania BibTeX
@article{browne1984asymptotically, author={Browne, M. W.}, title={{Asymptotically distribution-free methods for the analysis of covariance structures}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1984}, volume={37}, number={1}, pages={62--83}, doi={10.1111/j.2044-8317.1984.tb00789.x}}@article{curran1996robustness, author={Curran, Patrick J. and West, Stephen G. and Finch, John F.}, title={{The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={16--29}, doi={10.1037/1082-989x.1.1.16}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{hu1992can, author={Hu, Li-tze and Bentler, P. M. and Kano, Yutaka}, title={{Can test statistics in covariance structure analysis be trusted?}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={2}, pages={351--362}, doi={10.1037/0033-2909.112.2.351}}@article{olsson2000performance, author={Olsson, Ulf Henning and Foss, Tron and Troye, Sigurd V. and Howell, Roy D.}, title={{The performance of ML, GLS, and WLS estimation in structural equation modeling under conditions of misspecification and nonnormality}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2000}, volume={7}, number={4}, pages={557--595}, doi={10.1207/s15328007sem0704_3}}