Co to jest Q² Stone’a-Geissera?
Q² Stone’a-Geissera to miara trafności predykcyjnej modelu (np. regresji liniowej albo modelu SEM): mówi, o ile błędy prognozy wartości, których model nie widział podczas estymacji, są mniejsze od błędów naiwnej prognozy średnią. W PLS-SEM nazywa się ją też trafnością predykcyjną (ang. predictive relevance) i liczy dla konstruktów endogenicznych.
- SSE – suma kwadratów błędów prognozy dla obserwacji pominiętych przy estymacji;
- SSO – suma kwadratów odchyleń obserwacji od średniej, czyli błąd prognozy, w której każdemu przypisujemy średnią.
Q² = 1 oznacza prognozę bezbłędną, Q² = 0 – prognozę nie lepszą od średniej, a Q² < 0 – prognozę gorszą od samej średniej. Wzór przypomina R², ale różnica jest zasadnicza: R² liczy błędy dla tych samych osób, na których model oszacowano, a Q² – dla osób (lub punktów danych) pominiętych.
Nazwa pochodzi od dwóch statystyków, którzy w 1974 roku niezależnie rozwinęli ideę ponownego użycia próby do oceny prognoz. Stone (1974) zastosował uogólnione kryterium walidacji krzyżowej do wyboru i oceny prognoz, m.in. w regresji liniowej i analizie wariancji. Geisser (1974) wyprowadził estymatory w modelu efektów losowych metodą predykcyjnego ponownego użycia próby (ang. predictive sample reuse).
Trzy odmiany Q²
| Odmiana | Co się pomija | Gdzie spotkasz |
|---|---|---|
| Q² z walidacji „zostaw jedną osobę” (PRESS) | Po kolei każdą osobę | Regresja, chemometria, ogólna statystyka |
| Q² z blindfoldingu | Co D-ty punkt danych wskaźników konstruktu endogenicznego (D – odległość pominięcia) | Klasyczny PLS-SEM (np. SmartPLS) |
| Q²predict | Całe osoby w kolejnych foldach walidacji krzyżowej | PLSpredict |
Wszystkie trzy mają tę samą logikę 1 − SSE/SSO, ale różnią się tym, co znaczy „dane niewidziane”. W blindfoldingu pominięte punkty danych są uzupełniane i model szacuje się dalej na tych samych osobach, więc nie jest to prognoza dla nowych osób. Shmueli i in. (2019) zauważają, że ocena modeli PLS-SEM opierała się dotąd na miarach mocy wyjaśniającej, i proponują PLSpredict z próbą wydzieloną jako ocenę prognozy poza próbą. Henseler i in. (2016) zalecają z kolei, by przy celach predykcyjnych ocenę modelu oprzeć na blindfoldingu i wynikach na próbach testowych. W blindfoldingu rozróżnia się też dwa sposoby prognozy pominiętych punktów: z wyników konstruktów poprzedzających (redundancja) albo z wyniku samego konstruktu (komunalność). W praktyce: blindfolding Q² traktuj jako miarę trafności predykcyjnej w próbie, a Q²predict – jako właściwy test prognozy.
Przykład: R² rośnie, Q² spada
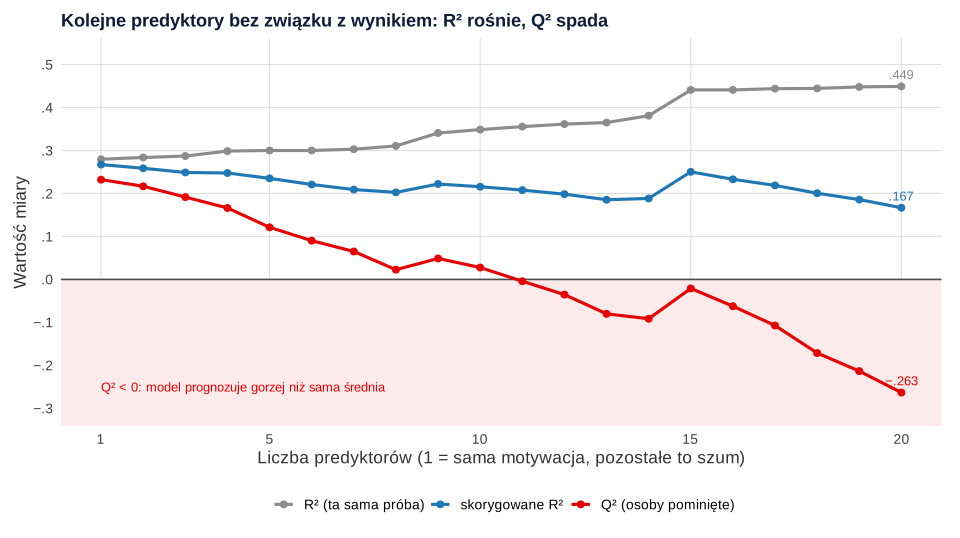
Najlepiej widać sens Q² na przykładzie nadmiernego dopasowania. W danych symulowanych 60 studentów ma wynik egzaminu ze statystyki (0–100) i poziom motywacji (1–7). Motywacja naprawdę przewiduje wynik. Do modelu (regresja wieloraka) dokładamy kolejno 19 zmiennych, które w populacji nie mają z wynikiem żadnego związku.
Krok 1 – model z samą motywacją. R² = .280. Q² obliczamy, pomijając po kolei każdą osobę, szacując model na pozostałych 59 i prognozując wynik pominiętej: Q² = .232. Q² jest niższe od R², bo prognoza dla nowych osób zawsze jest trudniejsza niż opis osób znanych. Ręczna pętla daje ten sam wynik co skrót z wartości wpływu (hatvalues).
Krok 2 – dokładanie szumu.
| Liczba predyktorów | R² | Skorygowane R² | Q² |
|---|---|---|---|
| 1 (motywacja) | .280 | .267 | .232 |
| 5 | .300 | .235 | .121 |
| 10 | .349 | .216 | .028 |
| 15 | .441 | .250 | −.021 |
| 20 | .449 | .167 | −.263 |
R² rośnie z każdą zmienną, choć dodawane zmienne to czysty szum. Skorygowane R² karze za liczbę predyktorów, ale niekonsekwentnie – przy 15 predyktorach znów rośnie. Q² spada: przy 20 predyktorach wynosi −.263, czyli model prognozuje wyniki nowych osób gorzej niż przypisanie każdemu średniej.
Krok 3 – logika blindfoldingu. W kodzie pokazano też wariant z odległością pominięcia D = 7: w każdej z siedmiu rund pomija się co siódmą obserwację wyniku, szacuje model na pozostałych i prognozuje pominięte. Dla modelu z motywacją daje to Q² = .213 – wartość zbliżoną do wersji „zostaw jedną osobę”. W PLS-SEM blindfolding działa podobnie, ale pomija punkty danych wielu wskaźników jednocześnie, a nie całe osoby.
Jak interpretować Q²
- Q² > 0 – model ma trafność predykcyjną dla danego konstruktu lub wskaźnika; to warunek minimalny.
- Q² bliskie R² – model dobrze uogólnia się na nowe obserwacje. Duża różnica między R² a Q² sygnalizuje nadmierne dopasowanie.
- Q² ≤ 0 – model nie prognozuje lepiej niż średnia; przy złożonym modelu i małej próbie to częsty wynik.
W literaturze PLS-SEM spotyka się dodatkowe progi „małej”, „średniej” i „dużej” trafności predykcyjnej, ale – podobnie jak w przypadku R² – zależą one od dziedziny i trudności prognozowanego zjawiska. Porównuj Q² modeli konkurencyjnych na tych samych danych, a nie z uniwersalnym progiem. Przy konstruktach refleksyjnych pamiętaj, że Q² ocenia prognozę, a zgodność oszacowań parametrów zapewnia dopiero korekta PLSc. Gdy celem badania jest prognoza, uzupełnij Q² procedurą PLSpredict z benchmarkiem regresji liniowej.
Precyzja samego Q². Q² też jest oszacowaniem z próby. W małych próbach jego wartość zależy od tego, które obserwacje trafiły do której części danych – dlatego przy walidacji z foldami powtarza się losowy podział wiele razy i uśrednia wynik. Wersja „zostaw jedną osobę” nie ma tego problemu (podział jest jeden), ale przy bardzo małych N bywa niestabilna, bo każda prognoza opiera się na niemal tej samej próbie. Jeśli różnica Q² dwóch modeli wynosi kilka setnych, nie traktuj jej jako rozstrzygającej bez dodatkowej walidacji, np. na niezależnej próbie.
Jak opisać Q² w pracy (APA)
Napisz, którą odmianę Q² policzono (blindfolding z jaką odległością pominięcia, walidacja krzyżowa z iloma foldami) i podaj wartość dla każdego konstruktu endogenicznego obok R². Wzór dla przykładu:
Pełną ocenę modelu strukturalnego w PLS-SEM, z R², Q² i PLSpredict, opisuje wpis PLS-SEM krok po kroku, wybór między podejściami – PLS-SEM czy CB-SEM, a implementację w R – PLS-SEM w R: seminr i cSEM.
Q² w R krok po kroku
Kod tworzy dane z przykładu, liczy Q² skrótem i ręczną pętlą „zostaw jedną osobę”, porównuje R², skorygowane R² i Q² przy rosnącej liczbie predyktorów oraz pokazuje wariant z odległością pominięcia D = 7. Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
Q² = 1 − PRESS/SSO w regresji liniowej
R
# Dane symulowane: 60 studentów; wynik egzaminu ze statystyki (0–100) zależy od motywacji (skala 1–7);
# do modelu dokładamy kolejno 19 zmiennych, które w populacji nie mają z wynikiem żadnego związku
set.seed(133)
n <- 60
motywacja <- round(pmin(pmax(rnorm(n, 4.5, 1.2), 1), 7), 1)
wynik <- round(pmin(pmax(30 + 7 * motywacja + rnorm(n, sd = 11), 0), 100))
szum <- matrix(rnorm(n * 19), n, 19, dimnames = list(NULL, paste0("z", 1:19)))
dane <- data.frame(wynik, motywacja, szum)

# Q² = 1 − PRESS / SSO: PRESS to suma kwadratów błędów prognozy dla osób POMINIĘTYCH przy estymacji,
# SSO – suma kwadratów odchyleń od średniej (błąd naiwnej prognozy średnią)
q2_loo <- function(model) {
  e_loo <- residuals(model) / (1 - hatvalues(model))   # błąd prognozy, gdy osoba i jest pominięta (skrót dla regresji)
  1 - sum(e_loo^2) / sum((model$model[[1]] - mean(model$model[[1]]))^2)
}
m1 <- lm(wynik ~ motywacja, data = dane)
# Sprawdzenie skrótu: ręczna walidacja „zostaw jedną osobę” dla modelu z motywacją
e_reczne <- sapply(1:n, function(i) dane$wynik[i] - predict(lm(wynik ~ motywacja, data = dane[-i, ]), dane[i, ]))
round(c(R2 = summary(m1)$r.squared, Q2_skrot = q2_loo(m1),
        Q2_recznie = 1 - sum(e_reczne^2) / sum((dane$wynik - mean(dane$wynik))^2)), 3)

# Coraz więcej predyktorów: R² rośnie zawsze, Q² zaczyna spadać
wyn <- t(sapply(0:19, function(k) {
  f <- if (k == 0) wynik ~ motywacja else as.formula(paste("wynik ~ motywacja +", paste0("z", 1:k, collapse = " + ")))
  m <- lm(f, data = dane)
  c(predyktory = k + 1, R2 = summary(m)$r.squared, R2_skor = summary(m)$adj.r.squared, Q2 = q2_loo(m))
}))
round(wyn[c(1, 5, 10, 15, 20), ], 3)

# Q² w wersji blindfolding (PLS-SEM) liczy się według tej samej logiki: 1 − SSE/SSO,
# z tą różnicą, że pomija się co D-ty punkt danych wskaźników konstruktu endogenicznego.
# Mini-przykład z odległością pominięcia D = 7: w każdej z 7 rund pomijamy co 7. obserwację wyniku egzaminu
# (przy jednym wskaźniku pominięcie punktu danych oznacza pominięcie osoby), szacujemy model na reszcie i prognozujemy pominięte
D <- 7; e_bf <- numeric(n)
for (runda in 1:D) {
  pomin <- seq(runda, n, by = D)
  m <- lm(wynik ~ motywacja, data = dane[-pomin, ])
  e_bf[pomin] <- dane$wynik[pomin] - predict(m, dane[pomin, ])
}
round(c(Q2_D7 = 1 - sum(e_bf^2) / sum((dane$wynik - mean(dane$wynik))^2)), 3)
Wynik w R
        R2   Q2_skrot Q2_recznie
     0.280      0.232      0.232
     predyktory    R2 R2_skor     Q2
[1,]          1 0.280   0.267  0.232
[2,]          5 0.300   0.235  0.121
[3,]         10 0.349   0.216  0.028
[4,]         15 0.441   0.250 -0.021
[5,]         20 0.449   0.167 -0.263
Q2_D7
0.213
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Utożsamianie Q² z R². R² opisuje dopasowanie do znanych danych; Q² – prognozę dla pominiętych.
- Traktowanie Q² z blindfoldingu jako prognozy dla nowych osób. Blindfolding pomija punkty danych, a nie całe osoby; do prognozy poza próbą służy Q²predict.
- Brak informacji o odmianie i ustawieniach (odległość pominięcia D, liczba foldów) – bez nich wyniku nie da się powtórzyć.
- Dobieranie predyktorów pod R² i pomijanie Q²; w przykładzie model z najwyższym R² prognozował najgorzej.
- Porównywanie Q² z uniwersalnymi progami zamiast z modelami konkurencyjnymi na tych samych danych.
Najczęstsze pytania
Co oznacza ujemne Q²?
Ujemne Q² oznacza, że model prognozuje wartości pominięte gorzej niż przypisanie każdemu średniej. Zdarza się to przy modelach przeładowanych predyktorami, małych próbach albo słabych związkach. W przykładzie na tej stronie model z 20 predyktorami miał R² = .449, ale Q² = −.263.
Czym Q² różni się od R²?
R² liczy błędy dla tych samych osób, na których oszacowano model, więc rośnie z każdym predyktorem. Q² liczy błędy dla danych pominiętych przy estymacji, więc spada, gdy model dopasowuje się do przypadkowych cech próby. Q² jest zwykle niższe od R²; duża różnica sygnalizuje nadmierne dopasowanie.
Jak policzyć Q² w PLS-SEM?
Klasycznie procedurą blindfolding: co D-ty punkt danych wskaźników konstruktu endogenicznego jest pomijany, prognozowany z modelu oszacowanego na pozostałych danych i porównywany z wartością rzeczywistą. Do oceny prognozy dla nowych osób użyj Q²predict z procedury PLSpredict.
Skąd nazwa Q² Stone’a-Geissera?
Od nazwisk Mervyna Stone’a i Seymoura Geissera, którzy w 1974 roku niezależnie opisali ocenę prognoz przez ponowne użycie próby: walidację krzyżową (Stone) i predykcyjne ponowne użycie próby (Geisser). Do PLS-SEM miarę przeniesiono jako ocenę trafności predykcyjnej konstruktów endogenicznych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Geisser, S. (1974). A predictive approach to the random effect model. Biometrika, 61(1), 101–107. https://doi.org/10.1093/biomet/61.1.101 ● Otwarty dostęp: pełny tekst
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: Updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
- Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. https://doi.org/10.1111/j.2517-6161.1974.tb00994.x
Cytowania BibTeX
@article{geisser1974predictive, author={Geisser, Seymour}, title={{A predictive approach to the random effect model}}, journal={Biometrika}, year={1974}, volume={61}, number={1}, pages={101--107}, doi={10.1093/biomet/61.1.101}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: Updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}@article{stone1974cross, author={Stone, M.}, title={{Cross-validatory choice and assessment of statistical predictions}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1974}, volume={36}, number={2}, pages={111--133}, doi={10.1111/j.2517-6161.1974.tb00994.x}}