level: 1, level: 2, cluster =). Ustal, czy konstrukt jest konfiguralny (agregat cechy osoby – testuj równe ładunki na obu poziomach), czy wspólny (cecha grupy oceniana przez jej członków). Rzetelność podaj dla poziomu, którego dotyczą wnioski.Dlaczego zwykła CFA na danych zagnieżdżonych to błąd
Kwestionariusz wypełnili uczniowie ze stu szkół, a recenzent pyta, czy struktura czynnikowa skali „trzyma się” na poziomie szkół. Zwykła konfirmacyjna analiza czynnikowa nie odpowie na to pytanie. Liczy model na jednej macierzy kowariancji wszystkich uczniów, jakby każda osoba była niezależną obserwacją. Tymczasem uczniowie tej samej szkoły są do siebie podobni, a związki między pozycjami mogą wyglądać inaczej wewnątrz szkół niż między nimi.
Pominięcie zagnieżdżenia ma dwa skutki. Pierwszy jest techniczny: zaniżone błędy standardowe i zawyżony chi-kwadrat. W symulacji Juliana (2001) przy minimalnych ICC wyniki prawie się nie zmieniały, ale wraz ze wzrostem ICC obciążeniu ulegały statystyka chi-kwadrat, parametry i ich błędy standardowe. Drugi skutek jest merytoryczny. Ładunki i korelacje czynników z modelu jednopoziomowego to mieszanina dwóch różnych struktur, więc nie wiesz, czy opisują uczniów, czy szkoły. To ten sam problem co w błędzie ekologicznym, tylko w modelu pomiarowym.
Nie zawsze trzeba od razu przechodzić do modelu dwupoziomowego. Stapleton, Yang i Hancock (2016) zauważają, że gdy konstrukt jest z założenia cechą osoby, a pytanie dotyczy osób, wystarczyć może analiza jednopoziomowa z korektą na zależność obserwacji. Stapleton, McNeish i Yang (2016) wiążą tę decyzję z pytaniami badawczymi i ze strukturą pomiaru konstruktów na poziomie grup. Wielopoziomowa CFA (ang. multilevel confirmatory factor analysis, MCFA) jest potrzebna, gdy chcesz opisać pomiar na obu poziomach. Ogólną logikę modeli dla danych zagnieżdżonych opisuje hasło model wielopoziomowy, a regresję wielopoziomową krok po kroku pokazujemy we wpisie model wielopoziomowy w R. Ten tekst dotyczy modelu pomiarowego.
Przykład: zaangażowanie i wsparcie nauczycieli w 100 szkołach
W badaniu (dane symulowane, set.seed(1733)) wzięło udział 2020 uczniów klas 7–8 ze 100 szkół. Szkoły liczyły od 12 do 28 badanych, średnio 20.2. Uczniowie odpowiadali na skali 1–7 na dwie czteropozycyjne skale:
- ZAN – zaangażowanie w naukę (pozycje z1–z4) to cecha ucznia, np. „Staram się, nawet gdy zadanie jest trudne”. Średnia szkoły to przeciętne zaangażowanie jej uczniów.
- KLI – wsparcie nauczycieli w szkole (k1–k4) to ocena szkoły, np. „Nauczyciele w mojej szkole pomagają, gdy czegoś nie rozumiem”. Uczniowie są tu raczej „sędziami” tej samej szkoły.
Dane w formacie długim (jeden wiersz to jeden uczeń, kolumna szkola z kodem szkoły) możesz pobrać jako plik CSV. Średnie pozycji wynosiły od 4.23 do 4.27 w ZAN i od 4.63 do 4.66 w KLI.
Krok 1. Rozkład kowariancji i ICC pozycji
MCFA opiera się na prostym rozkładzie. Wynik ucznia w pozycji to suma średniej jego szkoły i odchylenia od tej średniej. Te dwie części są nieskorelowane, więc macierz kowariancji całkowitej rozpada się na dwie macierze:
ΣW opisuje kowariancje wewnątrz szkół, a ΣB – kowariancje średnich szkół. Muthén (1994) pokazał, jak dopasować do obu macierzy osobne modele czynnikowe w zwykłym oprogramowaniu SEM. Na każdym poziomie może więc obowiązywać inna struktura.
Zacznij od ICC każdej pozycji, czyli części wariancji przypadającej na różnice między szkołami. Najprościej odczytać je z dwupoziomowego modelu nasyconego w lavaan (lavInspect(fit, "icc")).
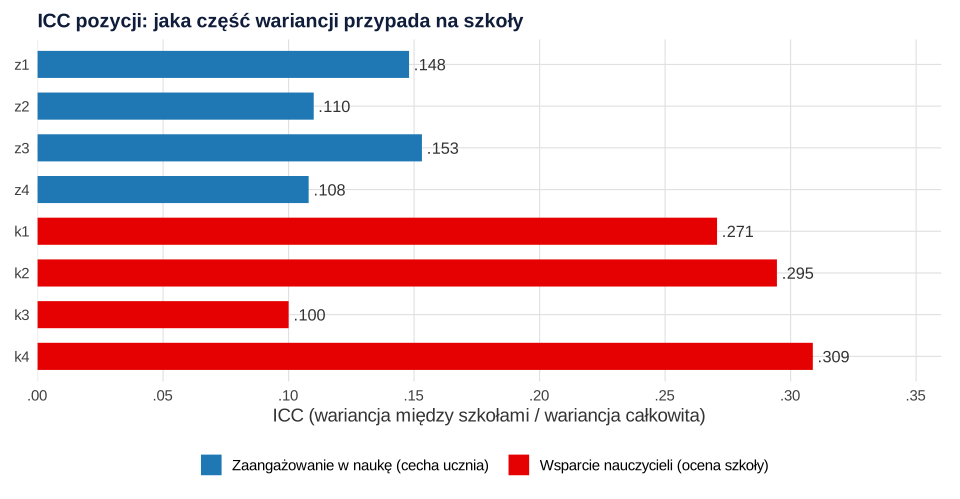
ICC pozycji zaangażowania wynoszą od .108 do .153, a pozycji wsparcia od .271 do .309, z wyjątkiem k3 (.100). Przy średnio 20.2 uczniach w szkole efekt schematu waha się od 2.92 do 6.93. Już takie wartości oznaczają, że zwykłe błędy standardowe będą zbyt małe. Niski ICC pozycji k3 to pierwsza wskazówka, że ta pozycja słabo różnicuje szkoły.
Rozkład kowariancji widać też w korelacjach. Korelacje pozycji ZAN z pozycjami KLI wynoszą w całej próbie od .19 do .26. Policzone wewnątrz szkół (na odchyleniach od średnich szkół) mają wartości od .14 do .19, a na średnich szkół od .36 do .46. Jedna liczba z próby całkowitej ukrywa więc dwie różne zależności.
Krok 2. Co pokazuje jednopoziomowa CFA
Dla porównania dopasuj najpierw zwykły dwuczynnikowy model CFA. Dopasowanie jest bez zarzutu: χ²(19) = 16.31, p = .637, CFI = 1.000, RMSEA = .000, SRMR = .010. Dobre dopasowanie nie chroni przed błędem zagnieżdżenia. Model nie wie, że dane mają dwa poziomy, i nie ma czego „źle dopasować”.
Ten sam model z estymatorem MLR i argumentem cluster = "szkola" daje błędy standardowe odporne na zagnieżdżenie. Dla ładunków pozycji KLI są one do 1.53 raza większe niż zwykłe, a dla ZAN do 1.15 raza. Korelacja czynników wynosi r = .37, a jej SE rośnie z 0.023 do 0.026. To rozwiązanie, które Stapleton, Yang i Hancock (2016) dopuszczają dla konstruktów indywidualnych. Korekta naprawia jednak tylko niepewność. Korelacja .37 nadal jest mieszaniną związku wewnątrz szkół i między nimi, które w modelu dwupoziomowym okażą się bardzo różne.
Krok 3. Dwupoziomowa CFA w lavaan
W pakiecie lavaan (Rosseel, 2012), w zainstalowanej wersji 0.7-2, model dwupoziomowy zapisujesz w jednym tekście z blokami level: 1 i level: 2, a funkcji sem() lub cfa() przekazujesz cluster = "szkola". Estymacja odbywa się metodą największej wiarygodności. Bez zmian zostaje składnia, którą znasz z wpisu CB-SEM w R. Model M1 ma tę samą strukturę dwóch czynników na obu poziomach, a ładunki są szacowane osobno na każdym poziomie.
Dopasowanie M1: χ²(38) = 30.42, p = .804, CFI = 1.000, RMSEA = .000. lavaan podaje też SRMR osobno dla poziomów: .011 wewnątrz szkół i .026 między szkołami. Patrz na oba. Globalne indeksy zależą głównie od poziomu 1, bo tam jest większość informacji, więc źle dopasowany poziom szkół może się w nich „schować” (zob. SRMR).
Korelacja czynników wynosi teraz .300 wewnątrz szkół i .578 między szkołami. Uczeń bardziej zaangażowany od kolegów nieco lepiej ocenia wsparcie nauczycieli. Szkoły, w których uczniowie są przeciętnie bardziej zaangażowani, są zaś znacznie lepiej oceniane. Model jednopoziomowy uśrednił te dwa związki do .37.
Konstrukt konfiguralny czy wspólny
Zanim zinterpretujesz czynnik na poziomie szkół, ustal, czym on jest. Stapleton, Yang i Hancock (2016) rozróżniają konstrukty indywidualne i grupowe, a wśród grupowych dwa typy:
| Typ konstruktu | Co mierzy pozycja | Przykład | Czynnik na poziomie szkół |
|---|---|---|---|
| Indywidualny | cechę osoby; zależność w danych bywa pozorna | cecha ucznia, gdy pytasz tylko o uczniów | niepotrzebny; wystarczy korekta SE |
| Konfiguralny | cechę osoby, której agregat opisuje grupę | ZAN: przeciętne zaangażowanie uczniów szkoły | ten sam czynnik zagregowany; zwykle równe ładunki |
| Wspólny (shared) | cechę grupy ocenianą przez jej członków | KLI: wsparcie nauczycieli w szkole | właściwy konstrukt; poziom uczniów to różnice w percepcji |
Jak i in. (2021) podają podobne przykłady konstruktów mierzonych na poziomie grup: ocena jakości nauczania przez uczniów i ocena klimatu organizacji przez pracowników. W konstrukcie wspólnym liczy się czynnik szkół, a czynnik uczniów opisuje, czym różnią się ich spostrzeżenia tej samej szkoły. Dlatego ICC pozycji takiej skali powinien być wyraźny, a pozycja z niskim ICC, jak k3, słabo nadaje się do opisu szkół.
Krok 4. Równe ładunki na obu poziomach
Jeśli czynnik szkół jest zagregowaną wersją czynnika uczniów, jego ładunki powinny być takie same na obu poziomach. Jak (2019) pokazała w symulacji, że pominięcie takich ograniczeń, gdy są prawdziwe, prowadzi do modelu z nadmiarem parametrów, większej liczby problemów z estymacją i mniejszej mocy. Równość ładunków między poziomami to forma izomorfizmu psychometrycznego, którego typy i testy opisują Tay i in. (2014). Uwaga na nazwy: „konfiguralny” w typologii konstruktów to co innego niż konfiguralny model inwariancji, czyli ta sama struktura bez ograniczeń (nasz M1). Procedurę inwariancji między grupami opisujemy we wpisie inwariancja pomiaru krok po kroku. Tu porównujesz poziomy, a nie grupy.
Ograniczenie równości wprowadzasz etykietami: ta sama etykieta, np. a2*z2, w bloku level: 1 i level: 2. Porównaj modele testem różnicy chi-kwadrat:
| Model | χ² (df) | CFI | RMSEA | BIC | Porównanie |
|---|---|---|---|---|---|
| M1: ta sama struktura, ładunki swobodne | 30.42 (38) | 1.000 | .000 | 48239.2 | – |
| M2: równe ładunki ZAN | 31.97 (41) | 1.000 | .000 | 48217.9 | Δχ²(3) = 1.55, p = .670 wobec M1 |
| M3: równe ładunki ZAN i KLI | 117.19 (44) | .989 | .029 | 48280.3 | Δχ²(3) = 85.22, p < .001 wobec M2 |
Dla zaangażowania ograniczenie nie pogarsza dopasowania, a BIC maleje, więc przyjmujesz M2. Dla wsparcia nauczycieli równość ładunków wyraźnie się nie sprawdza. Rysunek 2 pokazuje, dlaczego: pozycja k3 ma wewnątrz szkół ładunek 0.978, 95% CI [0.915, 1.040], a między szkołami tylko 0.490 [0.400, 0.580]. Uczniowie różnicują nią swoje spostrzeżenia, ale słabo odróżnia ona szkoły. Dla konstruktu wspólnego to nie jest wada modelu. Taki wynik mówi Ci jednak, która pozycja nie mierzy cechy szkoły.
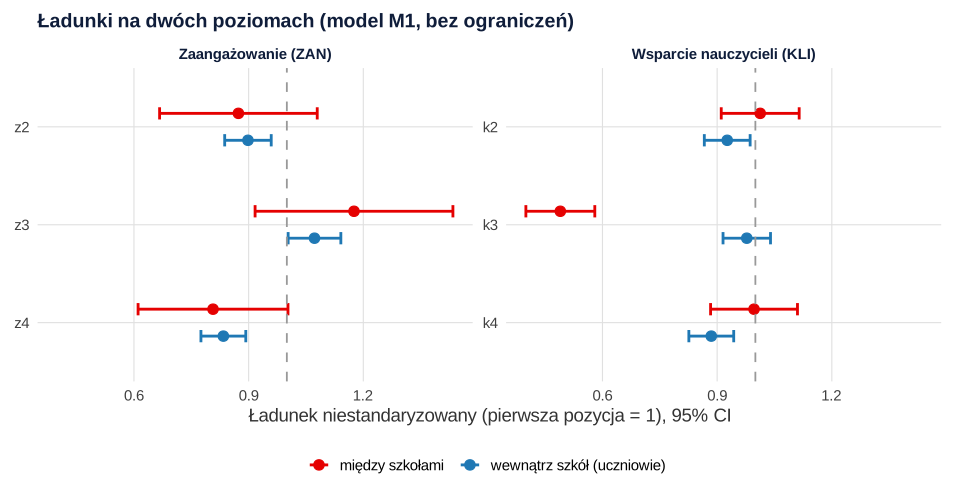
Równe ładunki dają wspólną skalę obu czynników ZAN, więc ich wariancje można porównać. W M2 wariancja zaangażowania wynosi 0.951 wewnątrz szkół i 0.204 między szkołami. ICC czynnika wynosi więc 0.204 / (0.204 + 0.951) = .177. Jest wyższy niż ICC pojedynczych pozycji, bo nie zawiera błędu pomiaru.
Ładunki standaryzowane na poziomie szkół są wysokie (.84–.98), bo wariancje reszt pozycji między szkołami są bliskie zeru (od 0.023 do 0.086). To typowe dla konstruktów zagregowanych. Jak i in. (2021) pokazali, że to, czy wariancje reszt na poziomie grup są w populacji i w modelu zerowe, wpływa na zbieżność estymacji. Przy ujemnych wariancjach reszt sprawdź, czy ustalenie ich na 0 ma uzasadnienie.
Krok 5. Rzetelność na obu poziomach
Jedna wartość omegi dla całej próby nie wystarczy. Geldhof i in. (2014) pokazali, że oszacowanie jednopoziomowe nie odpowiada rzetelności skali, jeśli nie jest ona taka sama na obu poziomach. Zaproponowali omegę i alfę liczone osobno dla każdego poziomu. Lai (2021) zwrócił uwagę, że ich wskaźnik dla poziomu grup opisuje hipotetyczny kompozyt latentny i może silnie zawyżać rzetelność obserwowanych średnich szkół. Zdefiniował więc wskaźniki dla wyników, które naprawdę liczysz, zależnie od typu konstruktu. Wszystkie te warianty liczy funkcja compRelSEM() z pakietu semTools. Szersze omówienie znajdziesz w haśle rzetelność wielopoziomowa.
| Wynik | Współczynnik | ZAN | KLI |
|---|---|---|---|
| wynik ucznia w skali (obie części wariancji) | ω2L | .845 | – |
| wynik ucznia wycentrowany w szkole | ωW | .829 | .836 |
| średnia szkoły | ωB | .727 | .880 |
Dla zaangażowania, czyli konstruktu konfiguralnego, raportujesz ω2L = .845, a jeśli analizujesz średnie szkół, także ωB = .727. Dla wsparcia nauczycieli, czyli konstruktu wspólnego, kluczowe jest ωB = .880, bo celem pomiaru jest szkoła. ωB zależy od liczby uczniów w szkole (tu średnia harmoniczna 18.94): przy mniejszych grupach średnie są mniej rzetelne. Geldhof i in. (2014) ostrzegają też, że małe grupy mogą zawyżać oszacowania rzetelności na poziomie grup.
Jak opisać wielopoziomową CFA
W opisie podaj liczbę osób i grup, zakres liczebności grup, ICC pozycji, typ każdego konstruktu i uzasadnienie modelu na poziomie grup. Dodaj też porównanie modeli z ograniczeniami między poziomami, dopasowanie z SRMR dla obu poziomów i rzetelność dla właściwego poziomu. Nazwij wskaźniki rzetelności (np. „ωB według Laia”), bo różne wzory dają różne liczby.
Jeśli przygotowujesz walidację skali na danych z wielu szkół, oddziałów albo firm i chcesz sprawdzić model na obu poziomach przed recenzją, możemy przejść przez analizę razem w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik mcfa-szkoly-dane.csv (możesz go pobrać tutaj), liczy ICC i jednopoziomową CFA. Drugi dopasowuje modele dwupoziomowe i liczy rzetelność. Potrzebujesz pakietów lavaan, semTools i MASS.
1. Dane, ICC pozycji i jednopoziomowa CFA
R
# Dane symulowane: 100 szkół, uczniowie klas 7–8; dwie skale po 4 pozycje (odpowiedzi 1–7)
# ZAN – zaangażowanie w naukę (cecha ucznia, konstrukt konfiguralny): z1–z4
# KLI – wsparcie nauczycieli w szkole (ocena szkoły przez uczniów, konstrukt wspólny): k1–k4
suppressPackageStartupMessages(library(lavaan))
set.seed(1733)
J <- 100
n_j <- sample(12:28, J, replace = TRUE)
szkola <- rep(seq_len(J), n_j)
N <- length(szkola)

# Poziom szkół: średnie czynników (zaangażowanie szkoły i wsparcie nauczycieli, korelacja .50)
Fb <- MASS::mvrnorm(J, c(0, 0), matrix(c(0.18, 0.5 * sqrt(0.18 * 0.60), 0.5 * sqrt(0.18 * 0.60), 0.60), 2))
# Poziom uczniów: odchylenia od średniej szkoły (korelacja .30)
Fw <- MASS::mvrnorm(N, c(0, 0), matrix(c(1, 0.3, 0.3, 1), 2))

lam_z <- c(1, 0.9, 1.1, 0.8)          # te same ładunki na obu poziomach (izomorfizm)
lam_kw <- c(1, 0.9, 1.0, 0.9)         # wsparcie: ładunki wewnątrz szkół (różnice w percepcji)
lam_kb <- c(1, 1.0, 0.45, 1.1)        # wsparcie: ładunki między szkołami (inne niż wewnątrz)
pozycja <- function(srednia, l_w, l_b, fw, fb, sd_w, sd_b) {
  y <- srednia + l_b * fb[szkola] + rnorm(J, 0, sd_b)[szkola] + l_w * fw + rnorm(N, 0, sd_w)
  pmin(pmax(round(y), 1), 7)
}
dane <- data.frame(szkola = szkola)
for (i in 1:4) dane[[paste0("z", i)]] <- pozycja(4.3, lam_z[i], lam_z[i], Fw[, 1], Fb[, 1], 0.8, 0.20)
for (i in 1:4) dane[[paste0("k", i)]] <- pozycja(4.6, lam_kw[i], lam_kb[i], Fw[, 2], Fb[, 2], 0.8, 0.20)
write.csv(dane, "mcfa-szkoly-dane.csv", row.names = FALSE)

pozycje <- c(paste0("z", 1:4), paste0("k", 1:4))
c(uczniowie = N, szkoly = J, min_n = min(n_j), max_n = max(n_j), srednio = round(mean(n_j), 2))
round(sapply(dane[pozycje], function(x) c(M = mean(x), SD = sd(x))), 2)

# Rozkład kowariancji na część wewnątrz szkół (pooled within) i między szkołami
srednie <- aggregate(dane[pozycje], list(szkola = dane$szkola), mean)
odchylenia <- dane[pozycje] - srednie[match(dane$szkola, srednie$szkola), pozycje]
S_PW <- crossprod(as.matrix(odchylenia)) / (N - J)
round(cor(dane[pozycje])[1:4, 5:8], 2)            # korelacje całkowite ZAN × KLI
round(cov2cor(S_PW)[1:4, 5:8], 2)                 # korelacje wewnątrz szkół
round(cor(srednie[pozycje])[1:4, 5:8], 2)          # korelacje średnich szkół

# ICC pozycji z dwupoziomowego modelu nasyconego (lavaan)
nasycony <- paste(c("level: 1", paste(combn(pozycje, 2, paste, collapse = " ~~ ")), "level: 2",
                    paste(combn(pozycje, 2, paste, collapse = " ~~ "))), collapse = "\n")
fit_nas <- sem(nasycony, data = dane, cluster = "szkola")
icc <- lavInspect(fit_nas, "icc")
round(icc, 3)
deff <- 1 + (mean(n_j) - 1) * icc
round(deff, 2)

# Jednopoziomowa CFA: zwykła (ML) i z błędami odpornymi na zagnieżdżenie (MLR + cluster)
model_1p <- "
  ZAN =~ z1 + z2 + z3 + z4
  KLI =~ k1 + k2 + k3 + k4
"
fit_ml  <- cfa(model_1p, data = dane, std.lv = TRUE)
fit_mlr <- cfa(model_1p, data = dane, std.lv = TRUE, estimator = "MLR", cluster = "szkola")
round(fitMeasures(fit_ml, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
round(fitMeasures(fit_mlr, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "rmsea.robust", "srmr")), 3)
l_ml <- subset(parameterEstimates(fit_ml), op == "=~")
l_mlr <- subset(parameterEstimates(fit_mlr), op == "=~")
data.frame(pozycja = l_ml$rhs, ladunek = round(l_ml$est, 3), SE_ML = round(l_ml$se, 3),
           SE_klastry = round(l_mlr$se, 3), iloraz = round(l_mlr$se / l_ml$se, 2))
# Korelacja czynników w modelu jednopoziomowym: oszacowanie i oba błędy standardowe
r_ml <- subset(parameterEstimates(fit_ml), lhs == "ZAN" & op == "~~" & rhs == "KLI")
r_mlr <- subset(parameterEstimates(fit_mlr), lhs == "ZAN" & op == "~~" & rhs == "KLI")
round(c(r = r_ml$est, SE_ML = r_ml$se, SE_klastry = r_mlr$se), 3)
Wynik w R
uczniowie    szkoly     min_n     max_n   srednio
   2020.0     100.0      12.0      28.0      20.2
     z1   z2   z3   z4   k1   k2   k3   k4
M  4.23 4.26 4.27 4.24 4.63 4.63 4.63 4.66
SD 1.40 1.29 1.47 1.24 1.49 1.45 1.34 1.43
     k1   k2   k3   k4
z1 0.21 0.21 0.19 0.24
z2 0.22 0.21 0.21 0.24
z3 0.25 0.24 0.22 0.26
z4 0.23 0.22 0.20 0.23
     k1   k2   k3   k4
z1 0.15 0.16 0.15 0.18
z2 0.16 0.14 0.17 0.17
z3 0.18 0.16 0.18 0.19
z4 0.17 0.17 0.17 0.18
     k1   k2   k3   k4
z1 0.38 0.36 0.37 0.39
z2 0.45 0.45 0.36 0.46
z3 0.45 0.45 0.39 0.43
z4 0.43 0.44 0.39 0.40
   z1    z2    z3    z4    k1    k2    k3    k4
0.148 0.110 0.153 0.108 0.271 0.295 0.100 0.309
  z1   z2   z3   z4   k1   k2   k3   k4
3.84 3.11 3.94 3.07 6.20 6.66 2.92 6.93
 chisq     df pvalue    cfi  rmsea   srmr
16.307 19.000  0.637  1.000  0.000  0.010
 chisq.scaled            df pvalue.scaled    cfi.robust  rmsea.robust
       13.820        19.000         0.794         1.000         0.000
         srmr
        0.009
  pozycja ladunek SE_ML SE_klastry iloraz
1      z1   1.080 0.028      0.029   1.02
2      z2   0.963 0.026      0.028   1.08
3      z3   1.180 0.029      0.030   1.02
4      z4   0.892 0.026      0.030   1.15
5      k1   1.238 0.028      0.035   1.23
6      k2   1.188 0.028      0.037   1.33
7      k3   0.976 0.027      0.027   0.98
8      k4   1.136 0.028      0.043   1.53
         r      SE_ML SE_klastry
     0.370      0.023      0.026
2. Dwupoziomowa CFA, równe ładunki i rzetelność
R
# Dwupoziomowa CFA w lavaan: ten sam zbiór (obiekt dane z przepisu 1)
# M1: ta sama struktura na obu poziomach, ładunki szacowane swobodnie
m1 <- "
level: 1
  ZAN =~ z1 + z2 + z3 + z4
  KLI =~ k1 + k2 + k3 + k4
level: 2
  ZAN =~ z1 + z2 + z3 + z4
  KLI =~ k1 + k2 + k3 + k4
"
# M2: równe ładunki zaangażowania na obu poziomach (izomorfizm ZAN)
m2 <- "
level: 1
  ZAN =~ z1 + a2*z2 + a3*z3 + a4*z4
  KLI =~ k1 + k2 + k3 + k4
level: 2
  ZAN =~ z1 + a2*z2 + a3*z3 + a4*z4
  KLI =~ k1 + k2 + k3 + k4
"
# M3: równe ładunki obu czynników na obu poziomach
m3 <- "
level: 1
  ZAN =~ z1 + a2*z2 + a3*z3 + a4*z4
  KLI =~ k1 + b2*k2 + b3*k3 + b4*k4
level: 2
  ZAN =~ z1 + a2*z2 + a3*z3 + a4*z4
  KLI =~ k1 + b2*k2 + b3*k3 + b4*k4
"
fit1 <- sem(m1, data = dane, cluster = "szkola")
fit2 <- sem(m2, data = dane, cluster = "szkola")
fit3 <- sem(m3, data = dane, cluster = "szkola")
miary <- c("chisq", "df", "pvalue", "cfi", "rmsea", "aic", "bic")
round(sapply(list(M1 = fit1, M2 = fit2, M3 = fit3), fitMeasures, fit.measures = miary), 3)
round(fitMeasures(fit1, c("srmr_within", "srmr_between")), 3)   # SRMR osobno dla poziomów (tylko M1)
# Ładunki niestandaryzowane w M1 (bez ograniczeń) z 95% CI – porównanie poziomów
l1 <- subset(parameterEstimates(fit1), op == "=~" & !rhs %in% c("z1", "k1"))
data.frame(poziom = l1$level, pozycja = l1$rhs, ladunek = round(l1$est, 3),
           dolny = round(l1$ci.lower, 3), gorny = round(l1$ci.upper, 3))
anova(fit1, fit2)
anova(fit2, fit3)

# Ładunki standaryzowane w modelu M2 na obu poziomach
pe <- parameterEstimates(fit2, standardized = TRUE)
ld <- subset(pe, op == "=~")
data.frame(czynnik = ld$lhs[ld$level == 1], pozycja = ld$rhs[ld$level == 1],
           nst_uczniowie = round(ld$est[ld$level == 1], 3), nst_szkoly = round(ld$est[ld$level == 2], 3),
           st_uczniowie = round(ld$std.all[ld$level == 1], 3), st_szkoly = round(ld$std.all[ld$level == 2], 3))

# Wariancje czynników, ICC czynnika ZAN (sensowne przy równych ładunkach) i korelacje czynników
war <- subset(pe, op == "~~" & lhs == rhs & lhs %in% c("ZAN", "KLI"))
data.frame(czynnik = war$lhs, poziom = war$level, wariancja = round(war$est, 3), SE = round(war$se, 3))
psi_w <- war$est[war$lhs == "ZAN" & war$level == 1]; psi_b <- war$est[war$lhs == "ZAN" & war$level == 2]
round(c(ICC_czynnika_ZAN = psi_b / (psi_b + psi_w)), 3)
kor <- subset(pe, op == "~~" & lhs == "ZAN" & rhs == "KLI")
data.frame(poziom = kor$level, r = round(kor$std.all, 3), p = format.pval(kor$pvalue, eps = .001))
# Wariancje reszt pozycji na poziomie szkół
res_b <- subset(pe, op == "~~" & lhs == rhs & level == 2 & lhs %in% pozycje)
data.frame(pozycja = res_b$lhs, wariancja = round(res_b$est, 3), SE = round(res_b$se, 3))

# Rzetelność na obu poziomach (semTools::compRelSEM, wzory Laia 2021):
# ZAN jako konstrukt konfiguralny, KLI jako konstrukt wspólny (shared)
suppressPackageStartupMessages(library(semTools))
# omega 2L: wynik ucznia w ZAN (wariancja prawdziwa z obu poziomów)
# omega B: średnie szkół (dla KLI jako konstruktu wspólnego i dla ZAN)
rel_2L <- compRelSEM(fit2, simplify = TRUE)
rel_B  <- compRelSEM(fit2, shared = c("ZAN", "KLI"), simplify = TRUE)
# omega W: wynik wycentrowany w szkołach (unikalne nazwy kompozytów na poziomie 1)
W_w <- "
level: 1
  ZANw <~ z1 + z2 + z3 + z4
  KLIw <~ k1 + k2 + k3 + k4
level: 2
  ZANb <~ z1 + z2 + z3 + z4
  KLIb <~ k1 + k2 + k3 + k4
"
rel_W <- compRelSEM(fit2, W = W_w, simplify = TRUE)
round(c(omega_2L_ZAN = rel_2L[["ZAN"]], omega_W_ZAN = rel_W[["ZANw"]], omega_B_ZAN = rel_B[["ZAN"]],
        omega_W_KLI = rel_W[["KLIw"]], omega_B_KLI = rel_B[["KLI"]]), 3)
# Harmoniczna średnia liczebności szkół (wchodzi do omega B)
round(1 / mean(1 / n_j), 2)
Wynik w R
Warning: lavaan->lav_object_fit_by_level():
   level-specific fit measures are not available: the model contains
   (equality) constraints involving parameters from different levels.
Warning: lavaan->lav_object_fit_by_level():
   level-specific fit measures are not available: the model contains
   (equality) constraints involving parameters from different levels.
              M1        M2        M3
chisq     30.421    31.974   117.192
df        38.000    41.000    44.000
pvalue     0.804     0.843     0.000
cfi        1.000     1.000     0.989
rmsea      0.000     0.000     0.029
aic    48003.545 47999.098 48078.317
bic    48239.201 48217.922 48280.308
 srmr_within srmr_between
       0.011        0.026
   poziom pozycja ladunek dolny gorny
1       1      z2   0.898 0.837 0.959
2       1      z3   1.072 1.003 1.141
3       1      z4   0.834 0.775 0.893
4       1      k2   0.926 0.866 0.986
5       1      k3   0.978 0.915 1.040
6       1      k4   0.885 0.826 0.943
7       2      z2   0.873 0.667 1.079
8       2      z3   1.176 0.917 1.434
9       2      z4   0.807 0.611 1.003
10      2      k2   1.013 0.911 1.115
11      2      k3   0.490 0.400 0.580
12      2      k4   0.996 0.883 1.110

Chi-Squared Difference Test

     Df   AIC   BIC  Chisq Chisq diff RMSEA Df diff Pr(>Chisq)
fit1 38 48004 48239 30.421
fit2 41 47999 48218 31.974     1.5531     0       3     0.6701

Chi-Squared Difference Test

     Df   AIC   BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit2 41 47999 48218  31.974
fit3 44 48078 48280 117.192     85.219 0.11648       3  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  czynnik pozycja nst_uczniowie nst_szkoly st_uczniowie st_szkoly
1     ZAN      z1         1.000      1.000        0.755     0.839
2     ZAN      z2         0.895      0.895        0.720     0.923
3     ZAN      z3         1.082      1.082        0.782     0.896
4     ZAN      z4         0.831      0.831        0.695     0.903
5     KLI      k1         1.000      1.000        0.771     0.977
6     KLI      k2         0.926      1.013        0.743     0.981
7     KLI      k3         0.977      0.490        0.753     0.875
8     KLI      k4         0.885      0.997        0.725     0.941
  czynnik poziom wariancja    SE
1     ZAN      1     0.951 0.052
2     KLI      1     0.963 0.052
3     ZAN      2     0.204 0.040
4     KLI      2     0.581 0.098
ICC_czynnika_ZAN
           0.177
  poziom     r       p
1      1 0.300 < 0.001
2      2 0.578 < 0.001
  pozycja wariancja    SE
1      z1     0.086 0.021
2      z2     0.029 0.013
3      z3     0.059 0.018
4      z4     0.032 0.012
5      k1     0.027 0.014
6      k2     0.023 0.015
7      k3     0.043 0.014
8      k4     0.075 0.020
omega_2L_ZAN  omega_W_ZAN  omega_B_ZAN  omega_W_KLI  omega_B_KLI
       0.845        0.829        0.727        0.836        0.880
[1] 18.94
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Jednopoziomowa CFA na danych z wielu grup bez komentarza. Dobre dopasowanie niczego tu nie dowodzi. Podaj ICC i uzasadnij wybór modelu.
- Interpretacja czynnika szkół bez ustalenia typu konstruktu. Zagregowane zaangażowanie to co innego niż wspólna ocena szkoły.
- Brak testu równości ładunków między poziomami przy konstrukcie konfiguralnym. Bez niego porównanie wariancji czynników i ICC czynnika nie ma sensu.
- Patrzenie tylko na globalne CFI i RMSEA. Sprawdź SRMR dla poziomu grup.
- Jedna alfa lub omega dla całej próby albo omega poziomu grup z wzoru dla kompozytu latentnego podana jako rzetelność średnich szkół.
- Za mało grup. Model poziomu 2 szacujesz na 100 średnich, a nie na 2020 uczniach. Przy kilkudziesięciu grupach upraszczaj model szkół. Ogólne wskazówki znajdziesz w przewodnikach po modelowaniu SEM i po psychometrii.
Najczęstsze pytania
Kiedy potrzebna jest wielopoziomowa analiza czynnikowa?
Gdy osoby są zagnieżdżone w grupach (uczniowie w szkołach, pacjenci na oddziałach), pozycje mają wyraźne ICC i chcesz opisać pomiar także na poziomie grup albo używać średnich grup. Jeśli konstrukt jest cechą osoby, a wnioski dotyczą tylko osób, Stapleton, Yang i Hancock (2016) wskazują, że wtedy często wystarczy jednopoziomowa CFA z błędami standardowymi odpornymi na zagnieżdżenie.
Jak zrobić dwupoziomową CFA w lavaan?
Zapisz model w blokach level: 1 i level: 2, każdy z własnymi definicjami czynników, i dodaj w funkcji sem() lub cfa() argument cluster = z nazwą zmiennej grupującej. ICC pozycji odczytasz przez lavInspect(fit, "icc"), a dopasowanie poziomów z miar srmr_within i srmr_between.
Czy ładunki czynnikowe muszą być równe na obu poziomach?
Powinny być równe, gdy czynnik grupy jest zagregowaną wersją czynnika osób, czyli przy konstrukcie konfiguralnym (Jak, 2019). Sprawdź to testem różnicy chi-kwadrat między modelem z ładunkami swobodnymi a modelem z tymi samymi etykietami ładunków na obu poziomach. Przy konstrukcie wspólnym, np. ocenie szkoły przez uczniów, równość nie jest wymagana.
Czym różni się konstrukt wspólny od konfiguralnego?
Konstrukt konfiguralny to cecha osób, której średnia opisuje grupę, np. przeciętne zaangażowanie uczniów szkoły. Konstrukt wspólny (shared) to cecha samej grupy oceniana przez jej członków, np. wsparcie nauczycieli w szkole. Od tego zależy model na poziomie grup i wybór współczynnika rzetelności (Lai, 2021).
Jak policzyć rzetelność skali na poziomie szkół lub oddziałów?
Użyj współczynników dla obserwowanych średnich grup, np. ωB Laia (2021) z funkcji semTools::compRelSEM() z argumentem shared =. Omega poziomu grup liczona jak dla kompozytu latentnego może zawyżać rzetelność średnich. Rzetelność średnich rośnie z liczbą osób w grupie.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikMediacja wielopoziomowa (1-1-1 i 2-1-1) w R
Efekty pośrednie wewnątrz i między grupami, centrowanie, przedział Monte Carlo, lme4 i dwupoziomowy SEM w lavaan na przykładzie oddziałów szpitalnych.
Czytaj →Walidujesz skalę na danych z wielu szkół, oddziałów lub firm?
Pomożemy dobrać model na poziomie grup, sprawdzić równość ładunków, policzyć rzetelność na obu poziomach i wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Geldhof, G. J., Preacher, K. J., & Zyphur, M. J. (2014). Reliability estimation in a multilevel confirmatory factor analysis framework. Psychological Methods, 19(1), 72–91. https://doi.org/10.1037/a0032138
- Jak, S. (2019). Cross-level invariance in multilevel factor models. Structural Equation Modeling: A Multidisciplinary Journal, 26(4), 607–622. https://doi.org/10.1080/10705511.2018.1534205 ● Otwarty dostęp
- Jak, S., Jorgensen, T. D., & Rosseel, Y. (2021). Evaluating cluster-level factor models with lavaan and Mplus. Psych, 3(2), 134–152. https://doi.org/10.3390/psych3020012 ● Otwarty dostęp
- Julian, M. W. (2001). The consequences of ignoring multilevel data structures in nonhierarchical covariance modeling. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 325–352. https://doi.org/10.1207/s15328007sem0803_1
- Lai, M. H. C. (2021). Composite reliability of multilevel data: It’s about observed scores and construct meanings. Psychological Methods, 26(1), 90–102. https://doi.org/10.1037/met0000287
- Muthén, B. O. (1994). Multilevel covariance structure analysis. Sociological Methods & Research, 22(3), 376–398. https://doi.org/10.1177/0049124194022003006
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Stapleton, L. M., McNeish, D. M., & Yang, J. S. (2016). Multilevel and single-level models for measured and latent variables when data are clustered. Educational Psychologist, 51(3–4), 317–330. https://doi.org/10.1080/00461520.2016.1207178
- Stapleton, L. M., Yang, J. S., & Hancock, G. R. (2016). Construct meaning in multilevel settings. Journal of Educational and Behavioral Statistics, 41(5), 481–520. https://doi.org/10.3102/1076998616646200
- Tay, L., Woo, S. E., & Vermunt, J. K. (2014). A conceptual and methodological framework for psychometric isomorphism: Validation of multilevel construct measures. Organizational Research Methods, 17(1), 77–106. https://doi.org/10.1177/1094428113517008
Cytowania BibTeX
@article{geldhof2014reliability, author={Geldhof, G. John and Preacher, Kristopher J. and Zyphur, Michael J.}, title={{Reliability estimation in a multilevel confirmatory factor analysis framework}}, journal={Psychological Methods}, year={2014}, volume={19}, number={1}, pages={72--91}, doi={10.1037/a0032138}}@article{jak2019cross, author={Jak, Suzanne}, title={{Cross-level invariance in multilevel factor models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2019}, volume={26}, number={4}, pages={607--622}, doi={10.1080/10705511.2018.1534205}}@article{jak2021evaluating, author={Jak, Suzanne and Jorgensen, Terrence D. and Rosseel, Yves}, title={{Evaluating cluster-level factor models with lavaan and Mplus}}, journal={Psych}, year={2021}, volume={3}, number={2}, pages={134--152}, doi={10.3390/psych3020012}}@article{julian2001consequences, author={Julian, Marc W.}, title={{The consequences of ignoring multilevel data structures in nonhierarchical covariance modeling}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={325--352}, doi={10.1207/s15328007sem0803_1}}@article{lai2021composite, author={Lai, Mark H. C.}, title={{Composite reliability of multilevel data: It’s about observed scores and construct meanings}}, journal={Psychological Methods}, year={2021}, volume={26}, number={1}, pages={90--102}, doi={10.1037/met0000287}}@article{muthen1994multilevel, author={Muthén, Bengt O.}, title={{Multilevel covariance structure analysis}}, journal={Sociological Methods \& Research}, year={1994}, volume={22}, number={3}, pages={376--398}, doi={10.1177/0049124194022003006}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{stapleton2016multilevel, author={Stapleton, Laura M. and McNeish, Daniel M. and Yang, Ji Seung}, title={{Multilevel and single-level models for measured and latent variables when data are clustered}}, journal={Educational Psychologist}, year={2016}, volume={51}, number={3–4}, pages={317--330}, doi={10.1080/00461520.2016.1207178}}@article{stapleton2016construct, author={Stapleton, Laura M. and Yang, Ji Seung and Hancock, Gregory R.}, title={{Construct meaning in multilevel settings}}, journal={Journal of Educational and Behavioral Statistics}, year={2016}, volume={41}, number={5}, pages={481--520}, doi={10.3102/1076998616646200}}@article{tay2014conceptual, author={Tay, Louis and Woo, Sang Eun and Vermunt, Jeroen K.}, title={{A conceptual and methodological framework for psychometric isomorphism: Validation of multilevel construct measures}}, journal={Organizational Research Methods}, year={2014}, volume={17}, number={1}, pages={77--106}, doi={10.1177/1094428113517008}}