Co to jest NFI?
NFI (ang. normed fit index, normowany indeks dopasowania) to przyrostowy indeks dopasowania modeli SEM i CFA, zaproponowany przez Bentlera i Boneta (1980). Odpowiada na pytanie: o jaką część zmniejszyło się niedopasowanie, gdy zamiast modelu bazowego (niezależności) zastosowano model badacza? Autorzy wyszli od obserwacji, że test χ² w dużych próbach odrzuca niemal każdy model, a w małych nie odróżnia modeli konkurencyjnych. Zaproponowali więc dodatkowy punkt odniesienia – model zerowy – i dwa indeksy: normowany (NFI) i nienormowany (NNFI, dziś znany jako TLI).
NFI przyjmuje wartości od 0 do 1; im bliżej 1, tym większa poprawa względem modelu bazowego. Jest historycznie pierwszym z rodziny indeksów przyrostowych, do której należą też CFI, TLI i ich wersje „oszczędnościowe” – PNFI i PCFI.
Wzór i interpretacja
χ²B to statystyka modelu bazowego, w którym wszystkie zmienne obserwowalne są nieskorelowane (szacuje się tylko ich wariancje). χ²M to statystyka modelu badacza (zob. CMIN). NFI = .95 oznacza, że model usuwa 95% niedopasowania modelu bazowego.
We wzorze nie ma stopni swobody ani liczebności próby. Z tego wynikają dwie główne wady NFI:
- Nie karze za złożoność. Każdy dodatkowy parametr obniża χ²M, więc podnosi NFI – nawet jeśli parametr nie ma sensu. Tę wadę naprawia PNFI, który mnoży NFI przez stosunek stopni swobody. Mulaik i in. (1989) opisali ogólną korektę indeksów przez współczynnik oszczędności.
- Zaniża dopasowanie w małych próbach. Nawet dla modelu idealnie poprawnego oczekiwana wartość χ²M to nie 0, lecz liczba stopni swobody modelu. Wobec tego NFI ≈ 1 − dfM/χ²B. Ponieważ χ²B rośnie razem z N, w małej próbie NFI poprawnego modelu jest wyraźnie niższy niż 1. Bentler (1990) zaproponował CFI właśnie po to, by uniknąć niedoszacowania dopasowania, typowego dla NFI w małych próbach.
Przykład: NFI policzony ręcznie
Trzysta osób (dane symulowane) wypełniło 8-pozycyjną skalę przekonań o własnej skuteczności w nauce. Cztery pozycje dotyczą planowania (P1–P4), a cztery – wytrwałości (W1–W4). Model dwuczynnikowy jest poprawny, bo dokładnie z takiego wygenerowano dane.
- Model bazowy: χ²B(28) = 728.50.
- Model dwuczynnikowy: χ²M(19) = 18.98.
- NFI = (728.50 − 18.98) / 728.50 = .974.
Model jest poprawny, a χ²M jest niemal równe stopniom swobody. Mimo to NFI wynosi .974, podczas gdy CFI i TLI osiągają 1.000, a RMSEA .000. Wartość .974 to niemal dokładnie 1 − 19/728.50. Niedoszacowanie wynika więc wprost ze wzoru. Dla porównania model jednoczynnikowy, który łączy oba wymiary, dał χ²(20) = 183.09 i NFI = .749 (CFI = .767, RMSEA = .165). Oba indeksy wyraźnie go więc odrzucają.
Żeby zobaczyć, jak silnie NFI zależy od liczebności, poprawny model oszacowano w 300 próbach dla każdej z sześciu liczebności (rysunek 1).
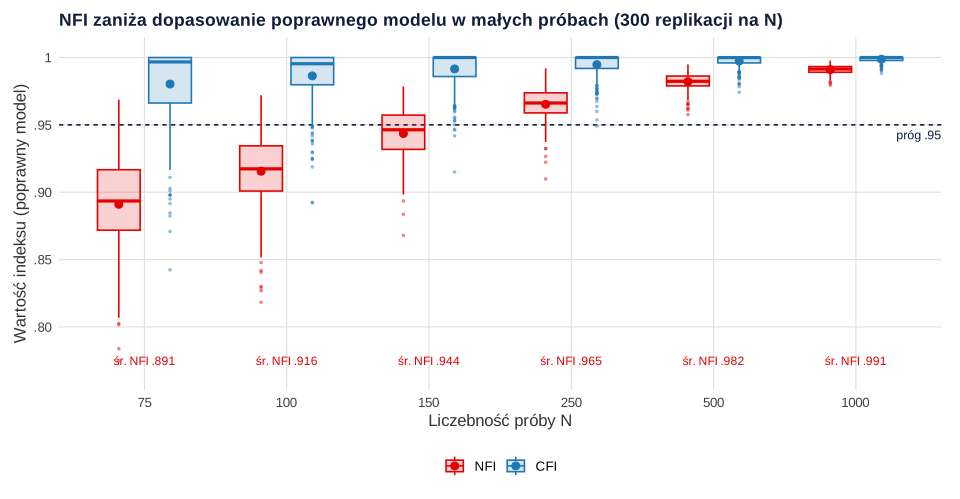
| N | Średni NFI | NFI < .95 | Średni CFI | CFI < .95 |
|---|---|---|---|---|
| 75 | .891 | 97.7% | .980 | 14.7% |
| 100 | .916 | 92.0% | .986 | 6.7% |
| 150 | .944 | 58.3% | .992 | 1.3% |
| 250 | .965 | 11.0% | .995 | 0.3% |
| 500 | .982 | 0.0% | .997 | 0.0% |
| 1000 | .991 | 0.0% | .999 | 0.0% |
Przy 100 osobach NFI poprawnego modelu spadał poniżej .95 w 92% prób. Badacz stosujący ten próg odrzuciłby więc model prawdziwy niemal zawsze. CFI w tych samych próbach był poniżej .95 w 6.7% przypadków. Dopiero od kilkuset osób oba indeksy zaczynają mówić to samo.
NFI na tle innych indeksów przyrostowych
Wszystkie indeksy przyrostowe porównują model badacza z tym samym modelem bazowym. Różnią się tym, co biorą pod uwagę oprócz samego χ²:
| Indeks | Wzór (w skrócie) | Co uwzględnia |
|---|---|---|
| NFI | (χ²B − χ²M) / χ²B | tylko poprawę χ² |
| TLI (NNFI) | (χ²B/dfB − χ²M/dfM) / (χ²B/dfB − 1) | χ² na stopień swobody – karze za złożoność |
| CFI | 1 − max(χ²M − dfM, 0) / max(χ²B − dfB, χ²M − dfM, 0) | niecentralność – usuwa obciążenie małej próby |
| PNFI | (dfM/dfB) × NFI | oszczędność modelu |
| PCFI | (dfM/dfB) × CFI | oszczędność modelu |
Wynik każdego z tych indeksów zależy od modelu bazowego. Gdy zmienne słabo ze sobą korelują, χ²B jest małe i nawet dobry model uzyska niskie wartości. Gdy korelacje są silne, wysokie wartości osiąga łatwo nawet przeciętny model. Dlatego indeksy przyrostowe uzupełniaj miarami bezwzględnymi, takimi jak RMSEA i SRMR. Wybór zestawu miar w praktyce omawia poradnik analiza czynnikowa EFA i CFA.
Czy podawać NFI?
NFI jest nadal wypisywany przez AMOS, lavaan i inne programy, a recenzenci czasem o niego proszą. Rozsądne zasady są takie:
- Jako główny indeks przyrostowy podawaj CFI (i ewentualnie TLI), razem z RMSEA, SRMR i χ². Hu i Bentler (1999) zalecają łączne raportowanie co najmniej dwóch typów indeksów.
- Jeśli podajesz NFI, w próbie poniżej ok. 250 osób nie interpretuj go według progu .95. Napisz wprost, że indeks ten zaniża dopasowanie w małych próbach.
- NFI dobrze nadaje się do porównania modeli zagnieżdżonych na tych samych danych. Przy identycznym χ²B różnica NFI odzwierciedla różnicę χ² między modelami.
- Do porównań uwzględniających złożoność modelu użyj PNFI albo PCFI, a do porównań modeli niezagnieżdżonych – kryteriów informacyjnych (zob. AIC i BIC w SEM).
Jak opisać NFI w pracy (APA)
NFI podawaj w tym samym zdaniu co pozostałe indeksy, bez zera przed kropką. Wszystkie wartości zbierz w tabeli według wzoru tabeli dopasowania modelu CFA w APA.
NFI w R (lavaan)
Kod dopasowuje poprawny model dwuczynnikowy, liczy NFI z definicji i porównuje go z wartością podaną przez lavaan, szacuje gorszy model jednoczynnikowy, a następnie sprawdza w symulacji, jak NFI i CFI poprawnego modelu zależą od liczebności próby. Liczby w tekście, w tabelach i na rysunku 1 pochodzą z tego kodu (symulacja trwa ok. minuty).
NFI z definicji i w symulacji
R
# R125 – NFI (normed fit index Bentlera i Boneta) w CFA: obliczenie i zależność od liczebności próby
# Dane symulowane: skala przekonań o własnej skuteczności w nauce, 8 pozycji, dwa czynniki
# (planowanie P1–P4, wytrwałość W1–W4).
suppressPackageStartupMessages(library(lavaan))
populacja <- '
  plan =~ 0.75*P1 + 0.70*P2 + 0.65*P3 + 0.60*P4
  wytr =~ 0.75*W1 + 0.70*W2 + 0.65*W3 + 0.60*W4
  plan ~~ 0.50*wytr
'
model <- '
  plan =~ P1 + P2 + P3 + P4
  wytr =~ W1 + W2 + W3 + W4
'
set.seed(125)
dane <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)
fit <- cfa(model, data = dane)

# 1. NFI z definicji: (χ² modelu bazowego − χ² modelu) / χ² modelu bazowego
fm <- fitMeasures(fit, c("chisq", "df", "pvalue", "baseline.chisq", "baseline.df", "nfi", "cfi", "tli", "rmsea", "srmr"))
round(fm, 3)
round(unname((fm["baseline.chisq"] - fm["chisq"]) / fm["baseline.chisq"]), 3)

# 2. Ten sam model, ale gorszy: jeden czynnik zamiast dwóch
fit1 <- cfa('ogolny =~ P1 + P2 + P3 + P4 + W1 + W2 + W3 + W4', data = dane)
round(fitMeasures(fit1, c("chisq", "df", "nfi", "cfi", "tli", "rmsea")), 3)

# 3. Symulacja: poprawny model, różna liczebność próby (po 300 replikacji)
set.seed(1251)
N <- c(75, 100, 150, 250, 500, 1000)
sym <- do.call(rbind, lapply(N, function(n) {
  t(replicate(300, {
    d <- simulateData(populacja, sample.nobs = n, standardized = TRUE)
    f <- suppressWarnings(cfa(model, data = d))
    c(n = n, fitMeasures(f, c("nfi", "cfi")))
  }))
}))
sym <- as.data.frame(sym)
podsum <- aggregate(cbind(nfi, cfi) ~ n, data = sym, FUN = mean)
podsum$nfi_ponizej_95 <- aggregate(nfi ~ n, data = sym, FUN = function(x) mean(x < .95))$nfi
podsum$cfi_ponizej_95 <- aggregate(cfi ~ n, data = sym, FUN = function(x) mean(x < .95))$cfi
round(podsum, 3)
saveRDS(sym, "nfi-symulacja.rds")
Wynik w R
         chisq             df         pvalue baseline.chisq    baseline.df
        18.978         19.000          0.458        728.498         28.000
           nfi            cfi            tli          rmsea           srmr
         0.974          1.000          1.000          0.000          0.027
[1] 0.974
  chisq      df     nfi     cfi     tli   rmsea
183.088  20.000   0.749   0.767   0.674   0.165
     n   nfi   cfi nfi_ponizej_95 cfi_ponizej_95
1   75 0.891 0.980          0.977          0.147
2  100 0.916 0.986          0.920          0.067
3  150 0.944 0.992          0.583          0.013
4  250 0.965 0.995          0.110          0.003
5  500 0.982 0.997          0.000          0.000
6 1000 0.991 0.999          0.000          0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Odrzucanie modelu z powodu NFI < .95 w małej próbie. Przy N = 100 poprawny model nie spełniał tego progu w 92% prób.
- Podawanie samego NFI zamiast zestawu indeksów różnego typu.
- Traktowanie wzrostu NFI po dodaniu parametrów jako dowodu lepszego modelu. NFI nigdy nie spada, gdy model się komplikuje.
- Brak informacji, z którego programu i estymatora pochodzi NFI. Przy estymatorach odpornych programy mogą podawać wersje skalowane indeksów, więc zaznacz, którą wartość raportujesz.
- Porównywanie NFI między badaniami o różnych liczebnościach albo z różnymi modelami bazowymi, np. przy innej liczbie zmiennych.
Pełną ścieżkę oceny dopasowania, od χ² po diagnostykę lokalną, omawia przewodnik CB-SEM. Gdy indeksy globalne wyglądają dobrze, sprawdź jeszcze macierz reszt standaryzowanych.
Najczęstsze pytania
Jaka wartość NFI oznacza dobre dopasowanie?
Tradycyjnie przyjmuje się .90, a później .95, ale próg ten ma sens dopiero w dużych próbach. NFI zaniża dopasowanie przy małym N: w symulacji z tego hasła poprawny model miał średni NFI .916 przy 100 osobach i .965 przy 250. Ocenę opieraj na CFI, RMSEA, SRMR i resztach.
Dlaczego NFI jest niższy niż CFI dla tego samego modelu?
CFI odejmuje od χ² liczbę stopni swobody, czyli wartość oczekiwaną dla poprawnego modelu. NFI tego nie robi, więc nawet idealny model ma w skończonej próbie NFI wyraźnie poniżej 1. W przykładzie z tego hasła poprawny model miał CFI = 1.000 i NFI = .974.
Czym NFI różni się od TLI i PNFI?
TLI (dawniej NNFI) porównuje χ² w przeliczeniu na stopień swobody, więc uwzględnia złożoność i nie jest ograniczony do przedziału 0–1. PNFI to NFI pomnożony przez stosunek stopni swobody modelu i modelu bazowego, co obniża ocenę modeli z wieloma parametrami.
Jak policzyć NFI ręcznie?
Weź χ² modelu bazowego (w lavaan baseline.chisq) i χ² swojego modelu, a następnie podziel ich różnicę przez χ² modelu bazowego. Na przykład (728.50 − 18.98) / 728.50 = .974.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Mulaik, S. A., James, L. R., Van Alstine, J., Bennett, N., Lind, S., & Stilwell, C. D. (1989). Evaluation of goodness-of-fit indices for structural equation models. Psychological Bulletin, 105(3), 430–445. https://doi.org/10.1037/0033-2909.105.3.430
Cytowania BibTeX
@article{bentler1990comparative, author={Bentler, P. M.}, title={{Comparative fit indexes in structural models}}, journal={Psychological Bulletin}, year={1990}, volume={107}, number={2}, pages={238--246}, doi={10.1037/0033-2909.107.2.238}}@article{bentler1980significance, author={Bentler, P. M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{mulaik1989evaluation, author={Mulaik, Stanley A. and James, Larry R. and Van Alstine, Judith and Bennett, Nathan and Lind, Sherri and Stilwell, C. Dean}, title={{Evaluation of goodness-of-fit indices for structural equation models}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={430--445}, doi={10.1037/0033-2909.105.3.430}}