gfi to nowy estymator z przedziałem ufności, a klasyczny to gfi_lisrel.Co to jest GFI?
GFI (ang. goodness of fit index, wskaźnik dobroci dopasowania) to wskaźnik dopasowania modelu SEM, który mówi, jaką część kowariancji z próby odtwarza model. Wprowadzili go Jöreskog i Sörbom w programie LISREL. Działa podobnie jak R² w regresji. Maydeu-Olivares i in. (2024) opisują go jako odsetek wariancji sumy kwadratów kowariancji wyjaśniony przez model. Przyjmuje wartości od 0 do 1, a 1 oznacza, że macierz modelowa jest identyczna z macierzą z próby.
GFI jest wskaźnikiem bezwzględnym. Ocenia model sam w sobie, bez porównania z modelem niezależności, w odróżnieniu od CFI, TLI i NFI. Ma dwie odmiany: AGFI, czyli GFI skorygowany o liczbę stopni swobody, i PGFI, czyli GFI pomnożony przez współczynnik oszczędności. Przez lata pojawiał się w tabelach dopasowania z progiem .90 albo .95. Dziś raportuje się go rzadziej, z powodów opisanych niżej.
Wzór GFI i AGFI
Dla estymacji metodą największej wiarygodności GFI porównuje macierz kowariancji z próby S z macierzą odtworzoną przez model Σ̂:
Tutaj tr to ślad macierzy (suma elementów na przekątnej), I to macierz jednostkowa, p to liczba zmiennych obserwowalnych, a df to stopnie swobody modelu. Gdy model odtwarza dane idealnie, Σ̂−1S = I, licznik ułamka wynosi 0, a GFI = 1. AGFI „karze” modele z wieloma parametrami, bo przy małej liczbie stopni swobody mnożnik p(p + 1)/(2df) jest duży. Mulaik i in. (1989) uznali jednak tę korektę za nieudaną i zaproponowali inną: mnożenie wskaźnika przez współczynnik oszczędności, z którego powstał PGFI.
Główna wada: GFI zależy od liczebności próby
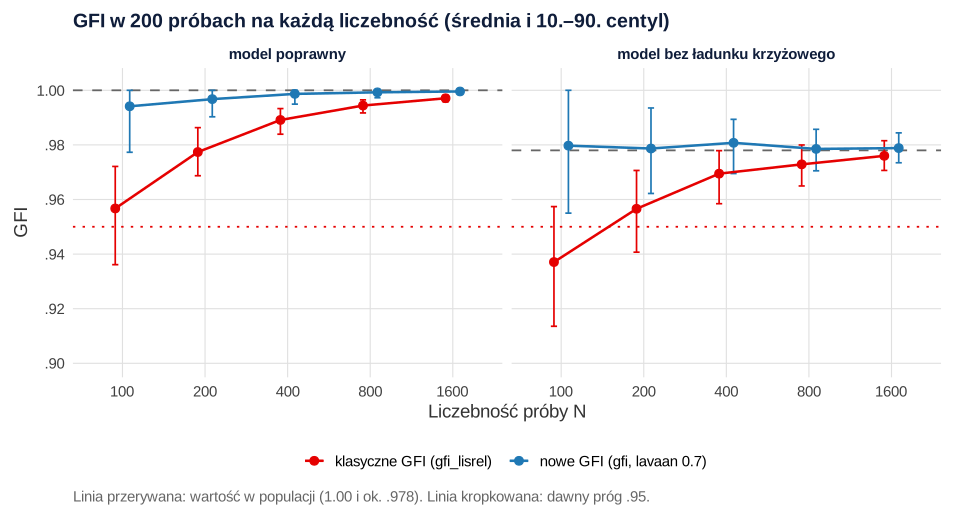
Klasyczny GFI z próby jest obciążony w dół, a obciążenie maleje wraz ze wzrostem N. Ten sam, poprawny model dostaje w małej próbie gorszy GFI niż w dużej. Wyniki symulacji z rysunku 1 (200 prób na każdą liczebność, dane symulowane):
- Dla modelu poprawnego średni klasyczny GFI wynosił .957 przy N = 100, .977 przy N = 200 i .997 przy N = 1600. Przy N = 100 aż 28% prób miało GFI poniżej .95, choć model był dokładnie prawdziwy.
- Dla modelu z pominiętym ładunkiem krzyżowym (wartość w populacji ok. .978) klasyczny GFI rósł od .937 przy N = 100 do .976 przy N = 1600.
Nie jest to jedyny problem. MacCallum i Hong (1997) pokazali, że analiza mocy oparta na GFI daje wyniki sprzeczne z intuicją. Dla GFI i AGFI trudno też ustalić spójne wartości graniczne, dlatego autorzy zalecają RMSEA. Według Fana i in. (1999) metoda estymacji silnie wpływa na niemal wszystkie wskaźniki dopasowania, a różne wskaźniki dają nieporównywalne informacje o modelach źle określonych. W symulacji Hu i Bentlera (1998) GFI nie znalazł się wśród wskaźników, które autorzy rekomendują. Zalecili SRMR uzupełniony np. o CFI, TLI albo RMSEA.
Nowe GFI: odsetek wyjaśnionej wariancji z przedziałem ufności
Maydeu-Olivares i in. (2024) proponują przywrócić GFI, ale w innej roli. Ich zdaniem GFI nie powinien rozstrzygać, czy model jest „dobrze” czy „źle” dopasowany. Ma raczej pokazywać, jak użyteczny jest model, podobnie jak R² w regresji. Autorzy podają estymator GFI poprawiony na obciążenie, także dla danych nienormalnych, razem z przedziałem ufności. W symulacji estymator ten był dokładny nawet przy dużych modelach.
Uwaga praktyczna: w lavaan od wersji 0.7 wynik gfi w fitMeasures() to już nowe GFI z 90% przedziałem ufności (gfi.ci.lower, gfi.ci.upper). Klasyczny wskaźnik z LISREL-a ma nazwę gfi_lisrel, a AGFI – agfi_lisrel. W przykładzie niżej różnica jest wyraźna: .986 i .968 dla tego samego modelu. Zawsze napisz, którą wersję raportujesz. Inne programy (AMOS, starsze wersje lavaan) podają wersję klasyczną.
Przykład: dwuczynnikowy model wypalenia studenckiego
Model CFA zakłada dwa skorelowane czynniki: wyczerpanie (4 pozycje) i cynizm (4 pozycje), N = 250 (dane symulowane). W populacji jedna pozycja cynizmu ładuje też słabo na wyczerpaniu, a model ten ładunek pomija. Dla porównania oszacowano model jednoczynnikowy.
| Model | χ²(df) | GFI klasyczny | AGFI | GFI nowe [90% CI] | CFI | RMSEA | SRMR |
|---|---|---|---|---|---|---|---|
| Dwa czynniki | 34.51 (19), p = .016 | .968 | .939 | .986 [.967, .998] | .981 | .057 | .042 |
| Jeden czynnik | 203.10 (20), p < .001 | .772 | .590 | .784 [.750, .818] | .778 | .191 | .111 |
Klasyczny GFI policzony ręcznie ze wzoru (macierze S i Σ̂ z lavaan) wynosi dokładnie .968, a AGFI – .939, tak jak w programie. Jak to interpretować?
- Model dwuczynnikowy odtwarza ok. 97–99% „wariancji kowariancji”, zależnie od wersji GFI. Model jednoczynnikowy – tylko ok. 78%.
- Mimo wysokiego GFI test χ² jest istotny, a RMSEA = .057 sugeruje niewielki błąd specyfikacji. To właśnie pominięty ładunek krzyżowy. Sam GFI tego nie ujawnia. Miejsca niedopasowania pokażą indeksy modyfikacji i reszty standaryzowane.
- AGFI jest wyraźnie niższy od GFI, bo model ma tylko 19 stopni swobody przy 36 elementach macierzy.
Jak raportować GFI (APA)
Jeśli promotor albo czasopismo wymaga GFI, podaj go jako uzupełnienie χ², CFI, RMSEA z przedziałem ufności i SRMR, z informacją o wersji. Wzór (w tabeli wskaźników pomoże tabela dopasowania modelu CFA w APA):
Przegląd wszystkich wskaźników i kolejność kroków oceny modelu znajdziesz w poradniku CB-SEM krok po kroku, a ich znaczenie w CFA – we wpisie analiza czynnikowa EFA i CFA.
Przykład w R
Kod tworzy dane z przykładu, szacuje modele dwu- i jednoczynnikowy, liczy GFI i AGFI ręcznie ze wzoru i porównuje je z lavaan. Na końcu przeprowadza symulację z rysunku 1 (5 liczebności × 200 prób; trwa ok. 1–2 minut).
GFI, AGFI i nowe GFI w lavaan
R
# GFI i AGFI w lavaan: obliczenie ze wzoru i zależność od wielkości próby
library(lavaan)

# Model populacyjny: dwa skorelowane czynniki wypalenia studenckiego (wyczerpanie, cynizm),
# po 4 pozycje; jedna pozycja (c1) ma w populacji także mały ładunek krzyżowy na wyczerpaniu
pop <- '
  wyczerpanie =~ 0.75*e1 + 0.70*e2 + 0.65*e3 + 0.70*e4 + 0.30*c1
  cynizm      =~ 0.60*c1 + 0.70*c2 + 0.75*c3 + 0.65*c4
  wyczerpanie ~~ 0.45*cynizm
'
model2 <- '
  wyczerpanie =~ e1 + e2 + e3 + e4
  cynizm      =~ c1 + c2 + c3 + c4
'
model1 <- ' wypalenie =~ e1 + e2 + e3 + e4 + c1 + c2 + c3 + c4 '

# 1. Jedna próba: N = 250 (dane symulowane)
set.seed(109)
dane <- simulateData(pop, sample.nobs = 250, standardized = TRUE)
f2 <- cfa(model2, data = dane)
f1 <- cfa(model1, data = dane)
# W lavaan 0.7: gfi_lisrel i agfi_lisrel = klasyczne GFI i AGFI; gfi = nowe GFI (Maydeu-Olivares i in., 2024) z 90% CI
miary <- c("chisq", "df", "pvalue", "gfi_lisrel", "agfi_lisrel", "gfi", "gfi.ci.lower", "gfi.ci.upper", "cfi", "rmsea", "srmr")
round(rbind(dwa_czynniki = fitMeasures(f2, miary), jeden_czynnik = fitMeasures(f1, miary)), 3)

# 2. GFI i AGFI ze wzoru (estymacja ML): S – macierz z próby, Sigma – macierz modelowa
S     <- lavInspect(f2, "sampstat")$cov
Sigma <- lavInspect(f2, "implied")$cov
A <- solve(Sigma) %*% S
gfi  <- 1 - sum(diag((A - diag(8)) %*% (A - diag(8)))) / sum(diag(A %*% A))
p <- 8; df <- fitMeasures(f2, "df")
agfi <- 1 - (p * (p + 1) / (2 * df)) * (1 - gfi)
round(c(GFI_wzor = gfi, AGFI_wzor = unname(agfi)), 3)

# 3. Symulacja: 200 prób dla każdej liczebności, model poprawny (pop) i z pominiętym ładunkiem krzyżowym
model_pelny <- '
  wyczerpanie =~ e1 + e2 + e3 + e4 + c1
  cynizm      =~ c1 + c2 + c3 + c4
'
set.seed(1090)
siatka <- expand.grid(N = c(100, 200, 400, 800, 1600), rep = 1:200)
wyn <- t(sapply(seq_len(nrow(siatka)), function(i) {
  d <- simulateData(pop, sample.nobs = siatka$N[i], standardized = TRUE)
  a <- fitMeasures(cfa(model_pelny, data = d), c("gfi_lisrel", "gfi", "rmsea"))
  b <- fitMeasures(cfa(model2, data = d), c("gfi_lisrel", "gfi", "rmsea"))
  c(siatka$N[i], a, b)
}))
colnames(wyn) <- c("N", "gfiL_poprawny", "gfiN_poprawny", "rmsea_poprawny", "gfiL_bez_ladunku", "gfiN_bez_ladunku", "rmsea_bez_ladunku")
sym <- aggregate(. ~ N, data = as.data.frame(wyn), FUN = mean)
print(round(sym, 3), row.names = FALSE)
# odsetek prób z klasycznym GFI < .95 dla modelu poprawnego
print(round(tapply(wyn[, "gfiL_poprawny"] < .95, wyn[, "N"], mean), 3))
# przybliżenie wartości populacyjnych: model bez ładunku krzyżowego w jednej bardzo dużej próbie (N = 200 000)
set.seed(1091)
fp <- cfa(model2, data = simulateData(pop, sample.nobs = 2e5, standardized = TRUE))
round(fitMeasures(fp, c("gfi_lisrel", "gfi", "rmsea", "cfi")), 3)
saveRDS(as.data.frame(wyn), "gfi-symulacja.rds")
Wynik w R
                chisq df pvalue gfi_lisrel agfi_lisrel   gfi gfi.ci.lower
dwa_czynniki   34.507 19  0.016      0.968       0.939 0.986        0.967
jeden_czynnik 203.101 20  0.000      0.772       0.590 0.784        0.750
              gfi.ci.upper   cfi rmsea  srmr
dwa_czynniki         0.998 0.981 0.057 0.042
jeden_czynnik        0.818 0.778 0.191 0.111
 GFI_wzor AGFI_wzor
    0.968     0.939
    N gfiL_poprawny gfiN_poprawny rmsea_poprawny gfiL_bez_ladunku
  100         0.957         0.994          0.025            0.937
  200         0.977         0.997          0.019            0.957
  400         0.989         0.999          0.010            0.969
  800         0.994         0.999          0.008            0.973
 1600         0.997         1.000          0.006            0.976
 gfiN_bez_ladunku rmsea_bez_ladunku
            0.980             0.059
            0.979             0.063
            0.981             0.061
            0.979             0.065
            0.979             0.065
 100  200  400  800 1600
0.28 0.00 0.00 0.00 0.00
gfi_lisrel        gfi      rmsea        cfi
     0.978      0.978      0.066      0.968
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- GFI ≥ .90 jako dowód dobrego modelu. W przykładzie GFI = .968 współistnieje z istotnym χ² i pominiętym ładunkiem. Dla GFI trudno ustalić spójne wartości graniczne (MacCallum i Hong, 1997).
- Porównywanie GFI z badań o różnej liczebności. Klasyczny GFI rośnie z N, więc model w próbie 120 osób dostaje gorszą wartość niż ten sam model w próbie 1000 osób.
- Brak informacji o wersji. „GFI = .986” z lavaan 0.7 i „GFI = .968” z AMOS mogą dotyczyć tego samego modelu. Podaj nazwę wskaźnika (
gficzygfi_lisrel) i program. - Raportowanie samego GFI i AGFI. Zawsze dodaj χ², CFI, RMSEA i SRMR. To zestaw, którego oczekują recenzenci.
- Traktowanie wysokiego GFI jako dowodu trafności teorii. GFI mówi, ile kowariancji odtwarza model. Nie mówi, czy model jest jedynym ani najlepszym wyjaśnieniem danych. Modele alternatywne porównuj np. testem różnicy χ² albo kryteriami AIC i BIC.
Najczęstsze pytania
Jaka wartość GFI oznacza dobre dopasowanie modelu?
Tradycyjnie przyjmowano progi .90 albo .95, ale nie mają one mocnych podstaw. Klasyczny GFI zależy od liczebności próby: w symulacji na tej stronie poprawny model przy N = 100 miał GFI poniżej .95 w 28% prób. Traktuj GFI jako opis odsetka odtworzonych kowariancji, a o dopasowaniu wnioskuj z χ², CFI, RMSEA i SRMR.
Czym różni się GFI od AGFI?
AGFI to GFI skorygowany o liczbę stopni swobody: AGFI = 1 − [p(p + 1)/(2df)] × (1 − GFI). Modele z wieloma parametrami (mało df) dostają niższy AGFI. W przykładzie na tej stronie GFI = .968, a AGFI = .939.
Dlaczego lavaan podaje inne GFI niż AMOS?
Od wersji 0.7 lavaan pod nazwą gfi podaje nowy estymator GFI poprawiony na obciążenie, z 90% przedziałem ufności. Klasyczny GFI, ten sam co w AMOS i LISREL, ma w lavaan nazwę gfi_lisrel, a AGFI – agfi_lisrel. W pracy napisz, którą wersję raportujesz.
Czy GFI trzeba raportować w pracy magisterskiej?
Nie jest obowiązkowy – standardem są χ² z df i p, CFI, TLI, RMSEA z 90% CI i SRMR. GFI dodaj, jeśli wymaga go promotor albo czasopismo, z informacją o wersji i bez traktowania progu .90 jako rozstrzygającego.
Czy wysokie GFI oznacza, że model jest poprawny?
Nie. GFI może być wysoki mimo pominiętych parametrów. W przykładzie na tej stronie GFI = .968 współistnieje z istotnym testem χ² i pominiętym ładunkiem krzyżowym. Błędy specyfikacji lepiej wskazują indeksy modyfikacji i reszty standaryzowane.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fan, X., Thompson, B., & Wang, L. (1999). Effects of sample size, estimation methods, and model specification on structural equation modeling fit indexes. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 56–83. https://doi.org/10.1080/10705519909540119
- Hu, L.-t., & Bentler, P. M. (1998). Fit indices in covariance structure modeling: Sensitivity to underparameterized model misspecification. Psychological Methods, 3(4), 424–453. https://doi.org/10.1037/1082-989x.3.4.424
- MacCallum, R. C., & Hong, S. (1997). Power analysis in covariance structure modeling using GFI and AGFI. Multivariate Behavioral Research, 32(2), 193–210. https://doi.org/10.1207/s15327906mbr3202_5
- Maydeu-Olivares, A., Ximénez, C., & Revuelta, J. (2024). Percentage of variance accounted for in structural equation models: The rediscovery of the goodness of fit index. Psychological Methods. https://doi.org/10.1037/met0000680 ● Otwarty dostęp
- Mulaik, S. A., James, L. R., Van Alstine, J., Bennett, N., Lind, S., & Stilwell, C. D. (1989). Evaluation of goodness-of-fit indices for structural equation models. Psychological Bulletin, 105(3), 430–445. https://doi.org/10.1037/0033-2909.105.3.430
Cytowania BibTeX
@article{fan1999effects, author={Fan, Xitao and Thompson, Bruce and Wang, Lin}, title={{Effects of sample size, estimation methods, and model specification on structural equation modeling fit indexes}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={56--83}, doi={10.1080/10705519909540119}}@article{hu1998fit, author={Hu, Li-tze and Bentler, Peter M.}, title={{Fit indices in covariance structure modeling: Sensitivity to underparameterized model misspecification}}, journal={Psychological Methods}, year={1998}, volume={3}, number={4}, pages={424--453}, doi={10.1037/1082-989x.3.4.424}}@article{maccallum1997power, author={MacCallum, Robert C. and Hong, Sehee}, title={{Power analysis in covariance structure modeling using GFI and AGFI}}, journal={Multivariate Behavioral Research}, year={1997}, volume={32}, number={2}, pages={193--210}, doi={10.1207/s15327906mbr3202_5}}@article{maydeu2024percentage, author={Maydeu-Olivares, Alberto and Ximénez, Carmen and Revuelta, Javier}, title={{Percentage of variance accounted for in structural equation models: The rediscovery of the goodness of fit index}}, journal={Psychological Methods}, year={2024}, doi={10.1037/met0000680}}@article{mulaik1989evaluation, author={Mulaik, Stanley A. and James, Larry R. and Van Alstine, Judith and Bennett, Nathan and Lind, Sherri and Stilwell, C. Dean}, title={{Evaluation of goodness-of-fit indices for structural equation models}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={430--445}, doi={10.1037/0033-2909.105.3.430}}