Co to jest PNFI?
PNFI (ang. parsimony normed fit index, normowany wskaźnik dopasowania skorygowany o oszczędność) to NFI pomnożony przez stosunek stopni swobody ocenianego modelu do stopni swobody modelu niezależności (bazowego). Łączy więc dwie informacje: o ile model poprawia dopasowanie w porównaniu z modelem, w którym zmienne w ogóle nie są skorelowane, i jak wiele stopni swobody zużył, żeby to osiągnąć.
PNFI należy do rodziny indeksów oszczędności. Jego bliskim krewnym jest PGFI, ale różnią się punktem odniesienia: PGFI koryguje bezwzględny GFI, dzieląc df przez liczbę wszystkich wariancji i kowariancji, a PNFI koryguje przyrostowy NFI, dzieląc df przez stopnie swobody modelu niezależności. Ta sama logika z CFI daje PCFI.
Wzór: NFI, model bazowy i współczynnik oszczędności
- χ²B, dfB – statystyka i stopnie swobody modelu niezależności, w którym szacuje się tylko wariancje p zmiennych. Ma on dfB = p(p − 1)/2 – tyle, ile jest korelacji między zmiennymi.
- χ²M, dfM – to samo dla ocenianego modelu.
- dfM / dfB – współczynnik oszczędności (w AMOS raportowany jako PRATIO): jaka część stopni swobody modelu bazowego pozostała po oszacowaniu parametrów.
Model niezależności jako punkt odniesienia zaproponowali Bentler i Bonett (1980). Wyszli od obserwacji, że sam test χ² nie wystarcza: w dużych próbach odrzuca niemal każdy model, a w małych nie odróżnia modeli konkurencyjnych. NFI mówi, jaki odsetek niedopasowania modelu niezależności „usunął” oceniany model. Mulaik i in. (1989) dodali do tego obserwację, że indeksy takie jak NFI nagradzają każdy dodatkowy parametr, i zaproponowali korektę przez współczynnik oszczędności.
Przykład: ile wymiarów mają wymagania w pracy?
Dwanaście pozycji kwestionariusza wymagań w pracy (skala 1–5) wypełniło 360 pracowników (dane symulowane). Według teorii pozycje tworzą cztery czynniki po trzy pozycje: obciążenie ilościowe, presję czasu, konflikt ról i niejasność ról. Model niezależności ma χ²B = 1107.54 przy dfB = 12 × 11/2 = 66.
| Model | Parametry | χ²(df) | NFI | df/66 | PNFI | RMSEA |
|---|---|---|---|---|---|---|
| 1 czynnik | 24 | 488.85 (54) | .559 | .818 | .457 | .150 |
| 2 czynniki | 25 | 317.82 (53) | .713 | .803 | .573 | .118 |
| 4 czynniki (teoria) | 30 | 45.96 (48) | .958 | .727 | .697 | .000 |
| 4 czynniki + 2 parametry z MI | 32 | 35.92 (46) | .968 | .697 | .674 | .000 |
| 4 czynniki + 8 parametrów z MI | 38 | 15.57 (40) | .986 | .606 | .598 | .000 |
Obliczenie dla modelu teoretycznego: NFI = (1107.54 − 45.96) / 1107.54 = .958; współczynnik oszczędności 48/66 = .727; PNFI = .958 × .727 = .697. Wynik ręczny zgadza się z lavaan.
Po modelu czterech czynników do modelu dokładano kolejno parametry o najwyższych indeksach modyfikacji: jeden ładunek krzyżowy i siedem kowariancji reszt. Rysunek 1 pokazuje, co dzieje się z oboma wskaźnikami.
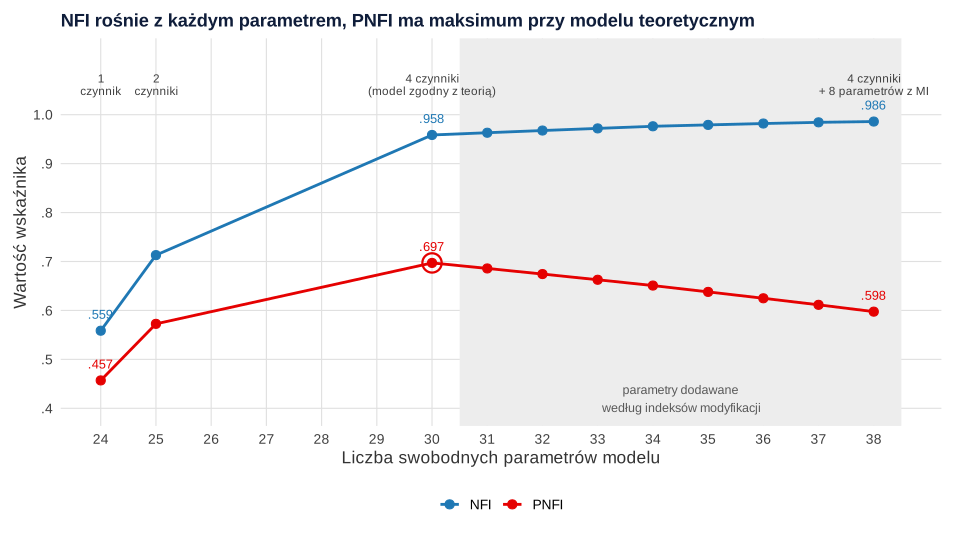
- NFI rośnie monotonicznie – z każdym parametrem, także z takim, który opisuje tylko przypadkowe kowariancje w tej próbie.
- PNFI ma maksimum przy modelu teoretycznym (.697). Przejście od dwóch do czterech czynników poprawiło NFI na tyle, że zrekompensowało utratę 5 stopni swobody; kolejne parametry już nie.
- Test różnicy χ² tego nie wychwyci. Model z ośmioma dodatkowymi parametrami „istotnie” lepiej pasuje niż model teoretyczny, Δχ²(8) = 30.39, p < .001. Ale parametry wybrano właśnie dlatego, że najbardziej obniżały χ² w tej próbie, więc ten test jest obciążony i nie mówi nic o replikowalności modyfikacji.
Jak interpretować PNFI
PNFI nie ma uzasadnionego progu. Jego sufit wynosi dfM/dfB, czyli zależy od liczby zmiennych i struktury modelu – nawet idealny model z wieloma parametrami nie osiągnie wysokiego PNFI. Wskaźnik czytaj więc porównawczo: dla modeli opartych na tych samych zmiennych wyższy PNFI wskazuje lepszy kompromis między dopasowaniem a prostotą.
Wynik zależy też od NFI, a ten ma znane słabości. Ponieważ model niezależności jest tym gorszy, im silniej skorelowane są zmienne, ten sam model ocenia się lepiej w danych o wysokich korelacjach. NFI jest też wrażliwy na liczebność próby – Marsh i in. (1988) badali zależność indeksów dopasowania od wielkości próby w CFA. Dlatego w ocenie samego dopasowania lepiej sprawdzają się CFI i TLI – dla nich Hu i Bentler (1999) zaproponowali orientacyjne wartości bliskie .95 w połączeniu z SRMR lub RMSEA – a PNFI pozostaw do porównań.
| Wskaźnik | Punkt odniesienia | Kara za parametry | Do czego |
|---|---|---|---|
| NFI | Model niezależności | Brak | Ocena poprawy względem modelu niezależności |
| PNFI | Model niezależności | × dfM/dfB | Porównanie modeli tych samych zmiennych |
| PGFI | Model bez parametrów | × dfM/[p(p + 1)/2] | Porównanie modeli; sam GFI zależny od N |
Jak używać PNFI przy wyborze modelu – kolejność kroków:
- Zdefiniuj modele konkurencyjne przed analizą (np. 1, 2 i 4 czynniki) – na podstawie teorii, nie indeksów modyfikacji.
- Odrzuć modele źle dopasowane według χ², CFI, RMSEA i SRMR. W przykładzie odpadają modele jedno- i dwuczynnikowy.
- Spośród pozostałych porównaj PNFI, a dla modeli niezagnieżdżonych także AIC i BIC. Duża przewaga PNFI prostszego modelu przemawia za nim nawet przy nieco gorszym NFI.
- Każdą modyfikację po fakcie zgłoś jako eksploracyjną i, jeśli to możliwe, sprawdź na niezależnej próbie.
Jak opisać PNFI w pracy (APA)
PNFI podaj w tabeli porównania modeli razem z χ², CFI, RMSEA i SRMR, a w tekście uzasadnij wybór modelu teorią i wskaźnikami oszczędności.
Całą procedurę oceny modelu pomiarowego, w tym zasady modyfikacji, omawiają wpisy analiza czynnikowa EFA i CFA oraz CB-SEM krok po kroku.
PNFI w R (lavaan)
Kod tworzy dane z przykładu, szacuje modele z jednym, dwoma i czterema czynnikami, dokłada kolejno 8 parametrów według indeksów modyfikacji, odczytuje NFI i PNFI, przelicza PNFI ręcznie i wykonuje test różnicy χ². Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
NFI, PNFI i sekwencja modyfikacji modelu
R
# Dane symulowane: 360 pracowników, 12 pozycji kwestionariusza wymagań w pracy (1–5), 4 czynniki po 3 pozycje:
# obciążenie ilościowe (ob), presja czasu (pc), konflikt ról (kr), niejasność ról (nr)
suppressPackageStartupMessages(library(lavaan))
set.seed(131)
n <- 360
R <- matrix(.35, 4, 4); R[1, 2] <- R[2, 1] <- .60; R[3, 4] <- R[4, 3] <- .50; diag(R) <- 1
F <- MASS::mvrnorm(n, rep(0, 4), R)
poz <- function(f, l) round(pmin(pmax(3 + 0.9 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 5))
lam <- c(.80, .72, .65)
dane <- data.frame(do.call(cbind, lapply(1:4, function(k) sapply(lam, function(l) poz(F[, k], l)))))
names(dane) <- paste0(rep(c("ob", "pc", "kr", "nr"), each = 3), 1:3)

m1 <- 'WYM =~ ob1 + ob2 + ob3 + pc1 + pc2 + pc3 + kr1 + kr2 + kr3 + nr1 + nr2 + nr3'
m2 <- 'ILO =~ ob1 + ob2 + ob3 + pc1 + pc2 + pc3
       ROL =~ kr1 + kr2 + kr3 + nr1 + nr2 + nr3'
m4 <- 'OB =~ ob1 + ob2 + ob3
       PC =~ pc1 + pc2 + pc3
       KR =~ kr1 + kr2 + kr3
       NR =~ nr1 + nr2 + nr3'
fity <- list(jeden = cfa(m1, data = dane), dwa = cfa(m2, data = dane), cztery = cfa(m4, data = dane))

# Model „podrasowany”: do modelu czterech czynników dodajemy kolejno 8 parametrów o największych indeksach modyfikacji
fit <- fity$cztery; model <- m4; dodane <- character(0)
for (k in 1:8) {
  mi <- modindices(fit, sort. = TRUE, op = c("~~", "=~"))
  nowy <- paste(mi$lhs[1], mi$op[1], mi$rhs[1]); dodane <- c(dodane, nowy)
  model <- paste(model, nowy, sep = "\n"); fit <- cfa(model, data = dane)
  fity[[paste0("cztery_plus", k)]] <- fit
}
dodane
miary <- c("chisq", "df", "pvalue", "npar", "baseline.chisq", "baseline.df", "nfi", "pnfi", "cfi", "rmsea")
tab <- t(sapply(fity, fitMeasures, fit.measures = miary))
round(tab[c("jeden", "dwa", "cztery", "cztery_plus2", "cztery_plus8"), ], 3)

# PNFI „ręcznie”: NFI × (df modelu / df modelu niezależności); df bazowe = p(p − 1)/2 = 66
p <- 12
round(cbind(df = tab[, "df"], df_bazowe = p * (p - 1) / 2, NFI = tab[, "nfi"],
            PNFI_recznie = tab[, "nfi"] * tab[, "df"] / (p * (p - 1) / 2))[c("jeden", "dwa", "cztery", "cztery_plus8"), ], 3)
# Czy 8 dodatkowych parametrów poprawia dopasowanie istotnie?
lavTestLRT(fity$cztery, fity$cztery_plus8)
Wynik w R
[1] "NR =~ pc3"  "kr3 ~~ nr2" "pc2 ~~ kr2" "pc3 ~~ kr1" "ob1 ~~ nr2"
[6] "ob3 ~~ kr1" "ob2 ~~ pc2" "ob2 ~~ kr2"
               chisq df pvalue npar baseline.chisq baseline.df   nfi  pnfi
jeden        488.853 54  0.000   24       1107.538          66 0.559 0.457
dwa          317.818 53  0.000   25       1107.538          66 0.713 0.573
cztery        45.964 48  0.557   30       1107.538          66 0.958 0.697
cztery_plus2  35.920 46  0.857   32       1107.538          66 0.968 0.674
cztery_plus8  15.573 40  1.000   38       1107.538          66 0.986 0.598
               cfi rmsea
jeden        0.582 0.150
dwa          0.746 0.118
cztery       1.000 0.000
cztery_plus2 1.000 0.000
cztery_plus8 1.000 0.000
             df df_bazowe   NFI PNFI_recznie
jeden        54        66 0.559        0.457
dwa          53        66 0.713        0.573
cztery       48        66 0.958        0.697
cztery_plus8 40        66 0.986        0.598

Chi-Squared Difference Test

                  Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
fity$cztery_plus8 40 10605 10753 15.573
fity$cztery       48 10620 10736 45.964     30.391 0.088173       8  0.0001803

fity$cztery_plus8
fity$cztery       ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Ocena dopasowania na podstawie samego PNFI lub porównywanie go z progiem .90 czy .95, właściwym dla innych indeksów.
- Porównywanie PNFI modeli z różnymi zestawami zmiennych. Zmienia się model niezależności i dfB, więc wartości nie są porównywalne.
- Uznanie wzrostu NFI po modyfikacji za dowód lepszego modelu. NFI rośnie zawsze; sprawdź, co dzieje się z PNFI i czy modyfikacja ma uzasadnienie w treści pozycji.
- Wiara w test różnicy χ² po przeszukaniu indeksów modyfikacji. Parametry wybrane według danych dają „istotną” poprawę z definicji.
- Mylenie PNFI z PGFI. Mają inne mianowniki współczynnika oszczędności i inne indeksy wyjściowe – nie zastępuj jednego drugim w tabeli.
Najczęstsze pytania
Jak obliczyć PNFI?
Najpierw policz NFI = (χ²B − χ²M) / χ²B, gdzie B to model niezależności. Potem pomnóż NFI przez dfM/dfB. Przy 12 zmiennych dfB = 66, więc model z df = 48 i NFI = .958 ma PNFI = .958 × 48/66 = .697.
Jaka wartość PNFI jest dobra?
Nie ma uzasadnionej wartości granicznej, bo najwyższy możliwy PNFI zależy od liczby zmiennych i stopni swobody modelu. PNFI interpretuj porównawczo: spośród modeli opartych na tych samych zmiennych i podobnie dobrze dopasowanych wybierz ten, który ma wyraźnie wyższy PNFI.
Czym jest model niezależności w SEM?
To model bazowy, w którym wszystkie zmienne jawne są nieskorelowane – szacuje się tylko ich wariancje. Bentler i Bonett (1980) zaproponowali go jako punkt odniesienia dla przyrostowych indeksów dopasowania, takich jak NFI, CFI i TLI.
Dlaczego NFI rośnie, a PNFI spada po modyfikacji modelu?
Każdy nowy parametr zmniejsza χ² modelu, więc NFI może tylko wzrosnąć. Jednocześnie ubywa stopni swobody, przez co maleje współczynnik oszczędności dfM/dfB. Gdy poprawa dopasowania jest niewielka, przeważa kara i PNFI spada – sygnał, że modyfikacja była zbędna.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikCB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Marsh, H. W., Balla, J. R., & McDonald, R. P. (1988). Goodness-of-fit indexes in confirmatory factor analysis: The effect of sample size. Psychological Bulletin, 103(3), 391–410. https://doi.org/10.1037/0033-2909.103.3.391
- Mulaik, S. A., James, L. R., Van Alstine, J., Bennett, N., Lind, S., & Stilwell, C. D. (1989). Evaluation of goodness-of-fit indices for structural equation models. Psychological Bulletin, 105(3), 430–445. https://doi.org/10.1037/0033-2909.105.3.430
Cytowania BibTeX
@article{bentler1980significance, author={Bentler, Peter M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{marsh1988goodness, author={Marsh, Herbert W. and Balla, John R. and McDonald, Roderick P.}, title={{Goodness-of-fit indexes in confirmatory factor analysis: The effect of sample size}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={391--410}, doi={10.1037/0033-2909.103.3.391}}@article{mulaik1989evaluation, author={Mulaik, Stanley A. and James, Larry R. and Van Alstine, Judith and Bennett, Nathan and Lind, Sherri and Stilwell, C. Dean}, title={{Evaluation of goodness-of-fit indices for structural equation models}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={430--445}, doi={10.1037/0033-2909.105.3.430}}