Co to jest PGFI?
PGFI (ang. parsimony goodness-of-fit index, wskaźnik dobroci dopasowania skorygowany o oszczędność) to GFI pomnożony przez współczynnik oszczędności – stosunek stopni swobody modelu do liczby informacji w danych. Ma odpowiedzieć na pytanie, którego sam GFI nie zadaje: czy dobre dopasowanie nie zostało „kupione” dodatkowymi parametrami?
Każdy wolny parametr – ładunek krzyżowy, kowariancja reszt, dodatkowa ścieżka – poprawia GFI albo go nie zmienia, ale nigdy nie pogarsza. Model, w którym uwolniono wszystko, odtwarza dane idealnie, lecz niczego nie testuje. Mulaik i in. (1989) zwrócili uwagę, że popularne indeksy dopasowania nie uwzględniają oszczędności modelu, a więc jego falsyfikowalności, i opisali korektę indeksów przez współczynnik oszczędności. PGFI to ta korekta zastosowana do GFI; analogiczny zabieg dla NFI daje PNFI, a dla CFI – PCFI.
Wzór PGFI
- GFI – klasyczny wskaźnik dobroci dopasowania Jöreskoga i Sörboma: odsetek wariancji i kowariancji w danych, który odtwarza model.
- dfM – stopnie swobody ocenianego modelu.
- p(p + 1)/2 – liczba niepowtarzalnych wariancji i kowariancji p zmiennych jawnych. To liczba stopni swobody „modelu zerowego”, w którym nie szacuje się żadnego parametru.
Współczynnik oszczędności mówi, jaka część informacji w danych pozostaje do testowania po oszacowaniu parametrów. Model nasycony ma df = 0, więc PGFI = 0 niezależnie od GFI. To odróżnia PGFI od AGFI: AGFI też koryguje GFI o df, ale robi to inaczej i może być wysoki nawet przy złożonym modelu – Mulaik i in. (1989) odrzucili AGFI jako miarę oszczędności.
Uwaga dla użytkowników R. W lavaan 0.7-2 nazwa gfi oznacza inną, nowszą odmianę wskaźnika; klasyczny GFI, z którego liczony jest PGFI, ma nazwę gfi_lisrel. Porównując wyniki z AMOS czy LISREL, używaj tej drugiej.
Przykład: trzy modele tej samej skali dobrostanu
Dziewięć pozycji krótkiej skali dobrostanu (1–6) wypełniło 280 osób (dane symulowane). Teoria zakłada trzy skorelowane wymiary: dobrostan emocjonalny, psychologiczny i społeczny, każdy mierzony trzema pozycjami. Dziewięć pozycji daje 9 × 10/2 = 45 wariancji i kowariancji. Porównujemy trzy modele:
| Model | χ²(df) | GFI | df/45 | PGFI | CFI | RMSEA |
|---|---|---|---|---|---|---|
| 1 czynnik | 147.51 (27) | .880 | .600 | .528 | .797 | .126 |
| 3 czynniki (teoria) | 19.40 (24) | .985 | .533 | .525 | 1.000 | .000 |
| 3 czynniki + 6 kowariancji reszt | 11.23 (18) | .991 | .400 | .396 | 1.000 | .000 |
Obliczenie krok po kroku dla modelu teoretycznego: GFI = .985, współczynnik oszczędności 24/45 = .533, więc PGFI = .985 × .533 = .525. Ręczny wynik zgadza się z lavaan.
Co widać w tabeli:
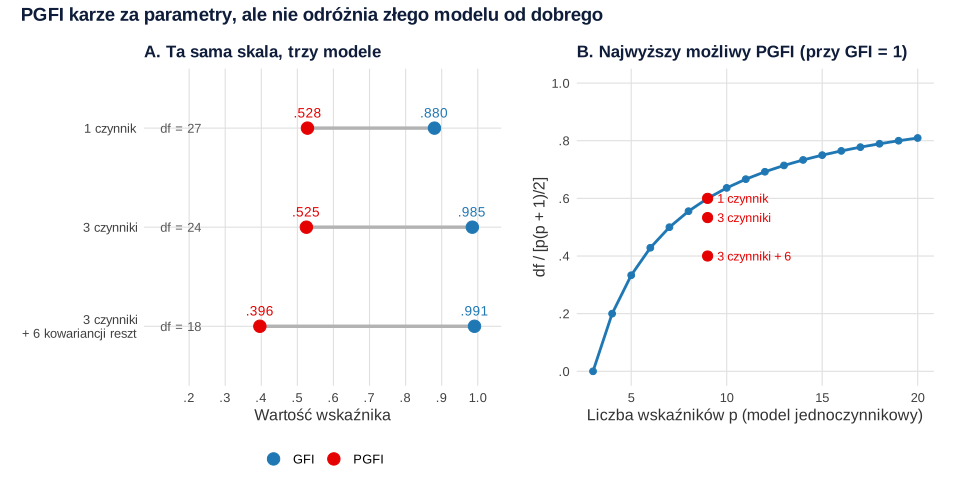
- PGFI ukarał model „dopieszczony”. Sześć kowariancji reszt podniosło GFI z .985 do .991, ale zużyło 6 stopni swobody, więc PGFI spadł z .525 do .396. Test różnicy χ² potwierdza, że te parametry były zbędne: Δχ²(6) = 8.17, p = .226.
- PGFI nie odróżnił złego modelu od dobrego. Model jednoczynnikowy, odrzucany przez wszystkie inne wskaźniki (CFI = .797, RMSEA = .126), ma PGFI = .528 – praktycznie tyle samo co model teoretyczny. Ma po prostu więcej stopni swobody, a premia za oszczędność wyrównała gorsze dopasowanie.
To najważniejsza lekcja tego hasła: PGFI służy do porównywania modeli o podobnej jakości dopasowania, a nie do oceny, czy model pasuje. Najpierw sprawdź dopasowanie bezwzględne i przyrostowe (RMSEA, SRMR, CFI), dopiero potem pytaj o oszczędność.
Dlaczego PGFI nie ma progu
Panel B rysunku pokazuje, że nawet idealnie dopasowany model nie może przekroczyć swojego współczynnika oszczędności. Dla modelu jednoczynnikowego z 4 pozycjami ten sufit wynosi .200, z 9 pozycjami – .600, z 20 pozycjami – .810. PGFI = .45 może więc oznaczać doskonały model krótkiej skali albo przeciętny model długiej. W podręcznikach i pracach spotyka się orientacyjną wartość .50, ale – jak widać – zależy ona od wielkości modelu, a nie tylko od jego jakości.
Dochodzi do tego zależność samego GFI od warunków badania. Anderson i Gerbing (1984) w symulacji Monte Carlo stwierdzili praktycznie istotny wpływ liczebności próby, liczby wskaźników na czynnik i liczby czynników na GFI i AGFI; zależność indeksów dopasowania od wielkości próby badali też Marsh i in. (1988). Hu i Bentler (1998) w zaleceniach dotyczących wyboru indeksów (SRMR uzupełniony m.in. przez CFI, TLI lub RMSEA) nie uwzględnili GFI. Dlatego PGFI raportuj najwyżej jako uzupełnienie przy porównaniu modeli – obok AIC i BIC (AIC i BIC w SEM) i testu różnicy χ².
Kiedy PGFI się przydaje
PGFI ma sens w jednej sytuacji: gdy masz kilka modeli dla tych samych zmiennych jawnych, wszystkie dobrze dopasowane, i chcesz pokazać, że prostszy z nich nie traci wiele na dopasowaniu. Wtedy mianownik jest wspólny, a różnice PGFI wynikają wyłącznie z liczby parametrów i różnic w GFI. Typowe zastosowania:
- Model wyjściowy a model z modyfikacjami – jak w przykładzie: spadek PGFI po dodaniu parametrów sygnalizuje, że poprawa GFI była kosmetyczna.
- Modele niezagnieżdżone, np. dwa różne przypisania pozycji do czynników, których nie da się porównać testem różnicy χ². PGFI można wtedy podać obok AIC i BIC.
- Model z czynnikiem wyższego rzędu a model ze skorelowanymi czynnikami (zob. konstrukt wyższego rzędu) – przy trzech czynnikach pierwszego rzędu oba modele mają tyle samo stopni swobody, przy czterech i więcej model hierarchiczny jest oszczędniejszy.
Jeśli wszystkie porównywane modele mają podobny PGFI, a różnią się wyraźnie innymi wskaźnikami, decyzję opieraj na tych innych wskaźnikach i na teorii.
Jak opisać PGFI w pracy (APA)
PGFI podaj w tabeli porównania modeli, nigdy jako jedyny wskaźnik. W tekście wyjaśnij, co wynika z różnic.
Szersze omówienie oceny dopasowania i decyzji o modyfikacjach znajdziesz w poradniku CB-SEM krok po kroku, a przykład pełnej CFA w R – we wpisie CB-SEM w R: lavaan.
PGFI w R (lavaan)
Kod tworzy dane z przykładu, szacuje trzy modele, odczytuje klasyczny GFI, AGFI i PGFI, przelicza PGFI ręcznie i testuje, czy dodatkowe kowariancje reszt poprawiają dopasowanie. Liczby w tabeli i tekście pochodzą z tego kodu.
GFI, współczynnik oszczędności i PGFI dla trzech modeli
R
# Dane symulowane: 280 osób, 9 pozycji krótkiej skali dobrostanu (1–6): dobrostan emocjonalny (e1–e3),
# psychologiczny (p1–p3) i społeczny (s1–s3); czynniki skorelowane .50–.60
suppressPackageStartupMessages(library(lavaan))
set.seed(128)
n <- 280
R <- matrix(c(1, .60, .50, .60, 1, .55, .50, .55, 1), 3)
F <- MASS::mvrnorm(n, rep(0, 3), R)
poz <- function(f, l) round(pmin(pmax(3.8 + 1.0 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 6))
dane <- data.frame(e1 = poz(F[, 1], .80), e2 = poz(F[, 1], .75), e3 = poz(F[, 1], .70),
                   p1 = poz(F[, 2], .75), p2 = poz(F[, 2], .70), p3 = poz(F[, 2], .65),
                   s1 = poz(F[, 3], .75), s2 = poz(F[, 3], .70), s3 = poz(F[, 3], .60))

m_1 <- cfa('DOB =~ e1 + e2 + e3 + p1 + p2 + p3 + s1 + s2 + s3', data = dane)
m_3 <- cfa('EMO =~ e1 + e2 + e3
            PSY =~ p1 + p2 + p3
            SPO =~ s1 + s2 + s3', data = dane)
# Model „dopieszczony”: model trójczynnikowy + 6 kowariancji reszt dodanych tylko dlatego, że poprawiają GFI
m_3plus <- cfa('EMO =~ e1 + e2 + e3
                PSY =~ p1 + p2 + p3
                SPO =~ s1 + s2 + s3
                e1 ~~ p1; e2 ~~ s2; p2 ~~ s1; e3 ~~ s3; p3 ~~ s2; e1 ~~ s1', data = dane)
# Uwaga: w lavaan 0.7 klasyczny GFI Jöreskoga i Sörboma to "gfi_lisrel" (to on wchodzi do PGFI);
# "gfi" w tej wersji pakietu to inna, nowsza odmiana wskaźnika
miary <- c("chisq", "df", "pvalue", "npar", "gfi_lisrel", "agfi_lisrel", "pgfi", "cfi", "rmsea")
tab <- round(rbind(jednoczynnikowy = fitMeasures(m_1, miary), trojczynnikowy = fitMeasures(m_3, miary),
                   trojczynnikowy_plus6 = fitMeasures(m_3plus, miary)), 3)
tab

# PGFI „ręcznie”: GFI pomnożony przez współczynnik oszczędności df / [p(p + 1)/2]
p <- 9; momenty <- p * (p + 1) / 2
wsp_osz <- tab[, "df"] / momenty
round(cbind(df = tab[, "df"], wsp_oszczednosci = wsp_osz, GFI = tab[, "gfi_lisrel"], PGFI_recznie = tab[, "gfi_lisrel"] * wsp_osz), 3)

# Test różnicy chi-kwadrat: czy 6 dodatkowych kowariancji reszt istotnie poprawia dopasowanie?
lavTestLRT(m_3, m_3plus)
Wynik w R
                       chisq df pvalue npar gfi_lisrel agfi_lisrel  pgfi   cfi
jednoczynnikowy      147.509 27  0.000   18      0.880       0.800 0.528 0.797
trojczynnikowy        19.400 24  0.730   21      0.985       0.971 0.525 1.000
trojczynnikowy_plus6  11.231 18  0.884   27      0.991       0.978 0.396 1.000
                     rmsea
jednoczynnikowy      0.126
trojczynnikowy       0.000
trojczynnikowy_plus6 0.000
                     df wsp_oszczednosci   GFI PGFI_recznie
jednoczynnikowy      27            0.600 0.880        0.528
trojczynnikowy       24            0.533 0.985        0.525
trojczynnikowy_plus6 18            0.400 0.991        0.396

Chi-Squared Difference Test

        Df    AIC    BIC Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
m_3plus 18 6776.1 6874.2 11.23
m_3     24 6772.2 6848.6 19.40     8.1694 0.035935       6      0.226
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Ocenianie dopasowania na podstawie samego PGFI. W przykładzie zły model jednoczynnikowy miał PGFI wyższy niż model zgodny z teorią.
- Porównywanie PGFI modeli z różną liczbą zmiennych jawnych. Mianownik p(p + 1)/2 się zmienia, więc wartości nie są porównywalne.
- Stosowanie „progu .50” jak kryterium zaliczenia. Sufit PGFI zależy od wielkości modelu (rysunek 1B).
- Mylenie PGFI z AGFI. Oba korygują GFI o stopnie swobody, ale tylko PGFI spada do zera przy modelu nasyconym.
- Odczytanie
gfizamiastgfi_lisrelw lavaan 0.7 i porównywanie go z GFI z AMOS. - Dodawanie parametrów według indeksów modyfikacji tylko dlatego, że GFI rośnie. PGFI właśnie ten zabieg wychwytuje.
Najczęstsze pytania
Jak obliczyć PGFI ręcznie?
Pomnóż GFI przez df modelu podzielone przez p(p + 1)/2, gdzie p to liczba zmiennych jawnych. Dla 9 pozycji jest 45 wariancji i kowariancji; model z df = 24 i GFI = .985 ma PGFI = .985 × 24/45 = .525.
Czy PGFI powyżej .50 oznacza dobry model?
Nie. Najwyższy możliwy PGFI zależy od liczby zmiennych i stopni swobody – dla krótkiej skali jest niższy niż .50 nawet przy idealnym dopasowaniu, a dla długiej źle dopasowany model łatwo przekracza .50. Oceniaj dopasowanie innymi indeksami, a PGFI traktuj jako pomoc przy porównaniu modeli.
Czym różni się PGFI od AGFI?
Oba korygują GFI o liczbę parametrów, ale inaczej. AGFI może pozostać wysoki dla złożonego modelu, a PGFI spada do zera dla modelu nasyconego, bo mnoży GFI przez udział stopni swobody. Mulaik i in. (1989) odrzucili AGFI jako miarę oszczędności.
Dlaczego lavaan pokazuje inny GFI niż AMOS?
W lavaan 0.7-2 nazwa gfi oznacza nowszą odmianę wskaźnika. Klasyczny GFI Jöreskoga i Sörboma, z którego liczony jest PGFI, ma w tej wersji nazwę gfi_lisrel – tę wartość porównuj z AMOS i LISREL.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1984). The effect of sampling error on convergence, improper solutions, and goodness-of-fit indices for maximum likelihood confirmatory factor analysis. Psychometrika, 49(2), 155–173. https://doi.org/10.1007/bf02294170
- Hu, L., & Bentler, P. M. (1998). Fit indices in covariance structure modeling: Sensitivity to underparameterized model misspecification. Psychological Methods, 3(4), 424–453. https://doi.org/10.1037/1082-989x.3.4.424
- Marsh, H. W., Balla, J. R., & McDonald, R. P. (1988). Goodness-of-fit indexes in confirmatory factor analysis: The effect of sample size. Psychological Bulletin, 103(3), 391–410. https://doi.org/10.1037/0033-2909.103.3.391
- Mulaik, S. A., James, L. R., Van Alstine, J., Bennett, N., Lind, S., & Stilwell, C. D. (1989). Evaluation of goodness-of-fit indices for structural equation models. Psychological Bulletin, 105(3), 430–445. https://doi.org/10.1037/0033-2909.105.3.430
Cytowania BibTeX
@article{anderson1984effect, author={Anderson, James C. and Gerbing, David W.}, title={{The effect of sampling error on convergence, improper solutions, and goodness-of-fit indices for maximum likelihood confirmatory factor analysis}}, journal={Psychometrika}, year={1984}, volume={49}, number={2}, pages={155--173}, doi={10.1007/bf02294170}}@article{hu1998fit, author={Hu, Li-tze and Bentler, Peter M.}, title={{Fit indices in covariance structure modeling: Sensitivity to underparameterized model misspecification}}, journal={Psychological Methods}, year={1998}, volume={3}, number={4}, pages={424--453}, doi={10.1037/1082-989x.3.4.424}}@article{marsh1988goodness, author={Marsh, Herbert W. and Balla, John R. and McDonald, Roderick P.}, title={{Goodness-of-fit indexes in confirmatory factor analysis: The effect of sample size}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={391--410}, doi={10.1037/0033-2909.103.3.391}}@article{mulaik1989evaluation, author={Mulaik, Stanley A. and James, Larry R. and Van Alstine, Judith and Bennett, Nathan and Lind, Sherri and Stilwell, C. Dean}, title={{Evaluation of goodness-of-fit indices for structural equation models}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={430--445}, doi={10.1037/0033-2909.105.3.430}}