Co to jest FMIN?
FMIN (ang. minimum of the fit function) to najmniejsza wartość funkcji rozbieżności, jaką osiąga estymacja modelu SEM. Funkcja rozbieżności (ang. discrepancy function, fit function) mierzy, jak bardzo macierz kowariancji odtworzona przez model, Σ(θ), różni się od macierzy kowariancji z próby, S. Estymacja polega na znalezieniu parametrów θ, przy których ta różnica jest najmniejsza. FMIN to wartość funkcji w tym punkcie.
Nazwa FMIN występuje w programie AMOS, w tabeli „Minimization History” i w zestawieniu miar dopasowania obok F0 i RMSEA. Inne programy podają tę samą wielkość pod nazwą fmin (lavaan) albo tylko pośrednio, przez statystykę chi-kwadrat. FMIN rzadko trafia do raportów, ale jest „cegiełką”, z której zbudowane są CMIN, RMSEA i wiele indeksów dopasowania.
Funkcja rozbieżności ML i inne funkcje
Przy estymacji metodą największej wiarygodności funkcja rozbieżności ma postać:
gdzie |·| to wyznacznik macierzy, tr – ślad (suma elementów przekątnej), a p – liczba zmiennych obserwowanych. Gdy Σ(θ) = S, ślad wynosi p, logarytmy się znoszą i F = 0. Każda rozbieżność daje wartość dodatnią. Tę funkcję minimalizuje konfirmacyjna analiza czynnikowa opisana przez Jöreskoga (1969).
Inne metody estymacji minimalizują inne funkcje:
- GLS (uogólnione najmniejsze kwadraty): F = ½ tr[(S − Σ)S−1]²;
- ULS (nieważone najmniejsze kwadraty): F = ½ tr[(S − Σ)²], zob. metoda najmniejszych kwadratów;
- ADF/WLS – funkcja ważona macierzą asymptotycznych kowariancji wariancji i kowariancji. Browne (1984) wyprowadził ją jako asymptotycznie niezależną od rozkładu (zob. ADF).
Każda funkcja mierzy rozbieżność w innej „walucie”, więc wartości FMIN z różnych metod estymacji nie są porównywalne.
Od FMIN do chi-kwadrat i RMSEA
FMIN zależy tylko od rozbieżności, a nie od liczebności próby. Aby zrobić z niej test, mnoży się ją przez liczebność:
Nawet poprawny model ma w próbie FMIN większe od zera, bo S zawiera błąd losowy. Oczekiwana wartość tego „szumu” to df/(N − 1). Po jej odjęciu otrzymuje się oszacowanie rozbieżności populacyjnej F0, a z niej RMSEA:
Rozróżnienie między rozbieżnością w próbie a rozbieżnością modelu w populacji (błąd aproksymacji) opisali Browne i Cudeck (1992). Zaproponowali też miary z przedziałami ufności, które uwzględniają liczbę parametrów, oraz test „bliskiego” zamiast dokładnego dopasowania.
Przykład: FMIN policzone ręcznie
Dwustu pięćdziesięciu studentów (dane symulowane) wypełniło 5-pozycyjną skalę akademickiego poczucia skuteczności (1–7). Model jednoczynnikowy ma 10 parametrów i df = 15 − 10 = 5. Po oszacowaniu w pakiecie lavaan (Rosseel, 2012) odczytano macierze S i Σ(θ̂) i podstawiono je do wzoru:
- FML = 0.07134; lavaan w kolumnie
fminpokazuje 0.03567, czyli dokładnie połowę – to konwencja tego pakietu, z której χ² = 2N ×fmin; - χ² = N × FML = 250 × 0.07134 = 17.84, p = .003;
- w konwencji AMOS (S z dzielnikiem N − 1): FMIN = 0.0713, CMIN = 249 × FMIN = 17.76;
- F0 = 0.0713 − 5/249 = 0.0513, a RMSEA = √(0.0513/5) = .101 – identycznie jak w wydruku.
RMSEA = .101 przy CFI = .971 i SRMR = .038 to typowy obraz modelu z małą liczbą stopni swobody i pominiętą kowariancją błędów (tu: pozycje sa4 i sa5). Ta sama FMIN jest dzielona przez zaledwie 5 df.
Rysunek 1 pokazuje, czym jest FMIN geometrycznie. Ładunek pozycji sa1 ustalano na kolejnych wartościach, a pozostałe parametry szacowano od nowa. Wartość funkcji rozbieżności tworzy krzywą z minimum dokładnie w punkcie oszacowania ML.
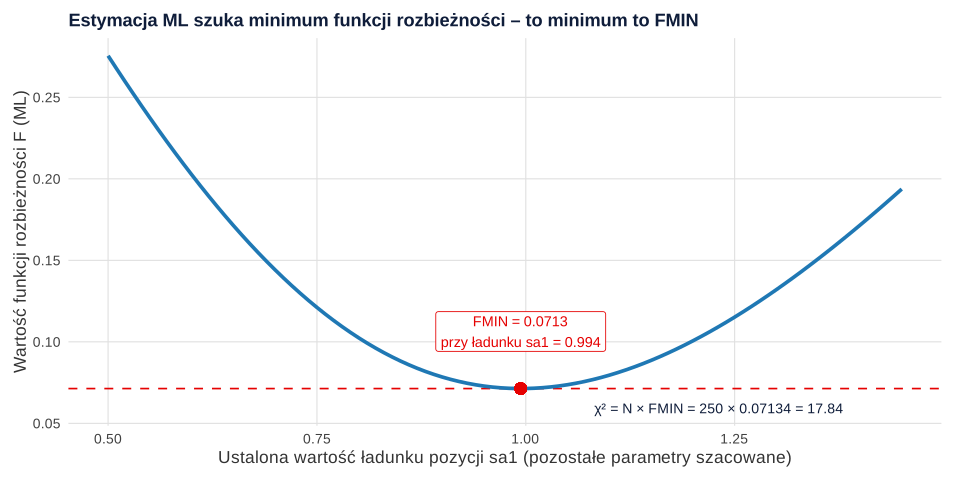
Przy ładunku 0.55 funkcja wynosi 0.2374, a przy 1.35 – 0.1509. Minimum 0.0713 pada przy ładunku 0.994, czyli w oszacowaniu ML. Krzywa pokazuje też, skąd biorą się testy różnicy chi-kwadrat: ustalenie parametru na wartości innej niż optymalna podnosi minimum, a różnica minimów pomnożona przez N to statystyka testu. Ta sama funkcja w trzech metodach estymacji dała w lavaan fmin 0.03567 (ML), 0.03175 (GLS) i 0.03236 (ULS). Liczby są podobne, ale – jak wspomniano – nieporównywalne.
Minimalizacja w praktyce: zbieżność i problemy
Program nie zna minimum z góry. Zaczyna od wartości startowych i w kolejnych iteracjach zmienia parametry tak, by wartość funkcji malała. AMOS pokazuje ten proces w tabeli „Minimization History”, a lavaan zapisuje liczbę iteracji w wyniku. Gdy kolejne kroki przestają zmniejszać funkcję, estymacja się kończy, a ostatnia wartość to FMIN. Kilka sytuacji wymaga uwagi:
- Brak zbieżności. Funkcja nie osiąga minimum w dozwolonej liczbie iteracji. Przyczyną bywa zła specyfikacja, za mała próba albo słabo zidentyfikowany model. Wyników takiego modelu nie interpretuj.
- Rozwiązanie niedopuszczalne. Minimum leży w punkcie z ujemną wariancją błędu albo korelacją większą od 1 (przypadek Heywooda). FMIN jest wtedy poprawnie policzone, ale model wymaga przemyślenia.
- Model niezidentyfikowany. Funkcja ma „płaskie dno”: wiele zestawów parametrów daje to samo minimum, więc wartości parametrów są dowolne.
Profil z rysunku 1 to prosty sposób na zobaczenie tego kształtu: wyraźne, pojedyncze minimum oznacza dobrze określony parametr.
Czy i jak raportować FMIN?
W pracach z psychologii FMIN zwykle nie jest raportowane, bo zawiera tę samą informację co χ² (CMIN). Raportuj χ² z df i p, RMSEA z 90% CI, CFI i SRMR, a w opisie metody podaj funkcję rozbieżności (estymator) i program. FMIN warto wspomnieć wtedy, gdy wyjaśniasz w metodologii, jak powstają miary dopasowania, albo gdy wydruki dwóch programów różnią się χ² (konwencje N i N − 1).
FMIN w R (lavaan)
Kod tworzy dane z przykładu, odczytuje z lavaan macierz z próby i macierz odtworzoną przez model, liczy funkcję rozbieżności ML ręcznie, odtwarza χ², FMIN i CMIN w konwencji AMOS, F0 i RMSEA, porównuje fmin dla ML, GLS i ULS oraz liczy profil funkcji rozbieżności dla jednego ładunku. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Funkcja rozbieżności, FMIN, F0 i RMSEA
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 250 studentów, 5-pozycyjna skala akademickiego poczucia skuteczności (odpowiedzi 1–7).
# W populacji pozycje sa4 i sa5 mają skorelowane błędy, więc model jednoczynnikowy nie pasuje idealnie.
set.seed(107)
pop <- '
  skutecznosc =~ 0.78*sa1 + 0.74*sa2 + 0.70*sa3 + 0.62*sa4 + 0.60*sa5
  sa4 ~~ 0.10*sa5
'
z <- simulateData(pop, sample.nobs = 250, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4.5 + 1.3 * x), 1), 7)))
model <- 'skutecznosc =~ sa1 + sa2 + sa3 + sa4 + sa5'
fit <- cfa(model, data = dane, std.lv = TRUE)
N <- nobs(fit); p <- 5; df <- fitMeasures(fit, "df")

# 1. Funkcja rozbieżności ML policzona ręcznie: F = ln|Σ| − ln|S| + tr(SΣ⁻¹) − p
S     <- lavInspect(fit, "sampstat")$cov          # macierz z próby (dzielnik N)
Sigma <- lavInspect(fit, "implied")$cov           # macierz odtworzona przez model
F_ml <- log(det(Sigma)) - log(det(S)) + sum(diag(S %*% solve(Sigma))) - p
round(c(F_ML = F_ml, fmin_lavaan = unname(fitMeasures(fit, "fmin")), relacja = unname(F_ml / fitMeasures(fit, "fmin"))), 5)

# 2. Od minimum funkcji do statystyki chi-kwadrat
round(c(N_razy_F = N * F_ml, chisq_lavaan = unname(fitMeasures(fit, "chisq")), df = unname(df)), 3)
round(fitMeasures(fit, c("pvalue", "cfi", "srmr")), 3)
# Konwencja AMOS: S z dzielnikiem N − 1, a CMIN = (N − 1) × FMIN
S1 <- cov(dane)
fit_w <- cfa(model, sample.cov = S1, sample.nobs = N, likelihood = "wishart", std.lv = TRUE)
Sig1 <- lavInspect(fit_w, "implied")$cov
FMIN_amos <- log(det(Sig1)) - log(det(S1)) + sum(diag(S1 %*% solve(Sig1))) - p
round(c(FMIN_amos = FMIN_amos, CMIN = (N - 1) * FMIN_amos, chisq_wishart = unname(fitMeasures(fit_w, "chisq"))), 4)

# 3. F0 (rozbieżność populacyjna) i RMSEA wyprowadzone z FMIN
F0 <- max(FMIN_amos - df / (N - 1), 0)
round(c(F0 = F0, RMSEA = unname(sqrt(F0 / df)), rmsea_lavaan_wishart = unname(fitMeasures(fit_w, "rmsea"))), 4)

# 4. Inne funkcje rozbieżności: GLS i ULS (minimum zależy od funkcji, więc FMIN nie są porównywalne)
fmins <- sapply(c("ML", "GLS", "ULS"), function(e) fitMeasures(cfa(model, data = dane, std.lv = TRUE, estimator = e), "fmin"))
round(fmins, 5)

# 5. Profil funkcji rozbieżności: ładunek sa1 ustalony na kolejnych wartościach, pozostałe parametry szacowane
lam <- seq(0.55, 1.35, by = 0.05)
prof <- sapply(lam, function(l) {
  m <- sprintf('skutecznosc =~ %.2f*sa1 + sa2 + sa3 + sa4 + sa5', l)
  2 * unname(fitMeasures(cfa(m, data = dane, std.lv = TRUE), "fmin"))
})
round(data.frame(ladunek_sa1 = lam, F_ML = prof)[c(1, 5, 9, 13, 17), ], 4)
round(coef(fit)["skutecznosc=~sa1"], 3)
Wynik w R
       F_ML fmin_lavaan     relacja
    0.07134     0.03567     2.00000
    N_razy_F chisq_lavaan           df
      17.836       17.836        5.000
pvalue    cfi   srmr
 0.003  0.971  0.038
    FMIN_amos          CMIN chisq_wishart
       0.0713       17.7643       17.7643
                  F0                RMSEA rmsea_lavaan_wishart
              0.0513               0.1013               0.1013
 ML.fmin GLS.fmin ULS.fmin
 0.03567  0.03175  0.03236
   ladunek_sa1   F_ML
1         0.55 0.2374
5         0.75 0.1211
9         0.95 0.0729
13        1.15 0.0886
17        1.35 0.1509
skutecznosc=~sa1
           0.994
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie FMIN między estymatorami (ML, GLS, ULS, WLSMV) albo między modelami dopasowanymi do różnych danych.
- Mylenie konwencji programów: lavaan podaje
fminjako połowę FML, a AMOS liczy FMIN z macierzy S z dzielnikiem N − 1. Ręczne przeliczenia dają wtedy wynik różny od wydruku. - Utożsamianie FMIN z F0. FMIN dotyczy próby i jest dodatnie nawet dla poprawnego modelu, F0 to oszacowanie rozbieżności w populacji.
- Interpretowanie małego FMIN jako dobrego dopasowania bez względu na df – ta sama wartość przy 5 i przy 50 stopniach swobody oznacza zupełnie inne dopasowanie.
Rozwinięcie tematu znajdziesz w hasłach CMIN i AIC i BIC oraz w poradnikach CB-SEM krok po kroku i CB-SEM w R.
Najczęstsze pytania
Co oznacza FMIN w wynikach AMOS?
FMIN to wartość funkcji rozbieżności w punkcie, w którym estymacja zakończyła minimalizację – im mniejsza, tym bliżej siebie są macierz z próby i macierz modelu. Sama w sobie rzadko jest interpretowana; AMOS używa jej do obliczenia CMIN = (N − 1) × FMIN, F0 i RMSEA.
Jak z FMIN obliczyć RMSEA?
Najpierw odejmij od FMIN oczekiwany wpływ błędu losowego: F0 = max(FMIN − df/(N − 1), 0). Potem RMSEA = √(F0/df). W przykładzie z hasła: F0 = 0.0713 − 5/249 = 0.0513, a RMSEA = √(0.0513/5) = .101.
Dlaczego fmin w lavaan jest dwa razy mniejsze niż w AMOS?
lavaan podaje w kolumnie fmin połowę funkcji rozbieżności ML, a statystykę testu liczy jako 2N × fmin. AMOS podaje pełną wartość funkcji i mnoży ją przez N − 1. Obie konwencje dają praktycznie tę samą statystykę χ².
Czy FMIN trzeba podawać w pracy dyplomowej?
Zwykle nie – χ² z df i p zawiera tę samą informację i jest standardem raportowania. Wystarczy podać estymator (czyli to, jaką funkcję rozbieżności minimalizowano), χ², RMSEA z 90% CI, CFI i SRMR.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM): od teorii do raportu
SEM bez skrótów myślowych: model pomiarowy i strukturalny, CB-SEM a PLS-SEM, dopasowanie, założenia oraz raportowanie wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Browne, M. W. (1984). Asymptotically distribution-free methods for the analysis of covariance structures. British Journal of Mathematical and Statistical Psychology, 37(1), 62–83. https://doi.org/10.1111/j.2044-8317.1984.tb00789.x
- Browne, M. W., & Cudeck, R. (1992). Alternative ways of assessing model fit. Sociological Methods & Research, 21(2), 230–258. https://doi.org/10.1177/0049124192021002005
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{browne1984asymptotically, author={Browne, M. W.}, title={{Asymptotically distribution-free methods for the analysis of covariance structures}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1984}, volume={37}, number={1}, pages={62--83}, doi={10.1111/j.2044-8317.1984.tb00789.x}}@article{browne1992alternative, author={Browne, Michael W. and Cudeck, Robert}, title={{Alternative ways of assessing model fit}}, journal={Sociological Methods \& Research}, year={1992}, volume={21}, number={2}, pages={230--258}, doi={10.1177/0049124192021002005}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}