Kim był Herman Wold?
Herman Ole Andreas Wold (1908–1992) był szwedzkim statystykiem i ekonometrykiem, przez prawie trzy dekady profesorem statystyki w Uppsali (American Academy of Arts and Sciences, b.d.; Uppsala universitet, b.d.). Jego nazwisko nosi twierdzenie z teorii szeregów czasowych – rozkład Wolda – a pod koniec kariery stworzył rodzinę metod częściowych najmniejszych kwadratów (PLS), dziś obecną od chemii analitycznej po badania marketingowe.
Rozprawę o szeregach czasowych ukończył w Sztokholmie w 1938 r. W przedmowie dziękuje Haraldowi Cramérowi jako swojemu nauczycielowi – za wykłady, w tym kurs analizy szeregów czasowych z 1933 r., i za szczegółową lekturę pierwszej wersji tekstu; wśród kolegów, z którymi dyskutował, wymienia m.in. Williama Fellera (Wold, 1938). W latach 1942–1970 kierował katedrą statystyki w Uppsali; jego następcą został w 1971 r. Karl G. Jöreskog (Uppsala universitet, b.d.). W 1978 r. American Academy of Arts and Sciences wybrała go na członka honorowego.
Najważniejsze pomysły
- Rozkład Wolda (1938). Rozprawa A Study in the Analysis of Stationary Time Series łączyła empiryczne metody George’a Udny’ego Yule’a i Jewgienija Słuckiego ze ścisłą teorią procesów losowych Chinczyna i Kołmogorowa. Jej twierdzenie 7 mówi, że każdy stacjonarny proces dyskretny o skończonej wariancji można rozłożyć na dwie nieskorelowane części: deterministyczną („osobliwą”) i średnią ruchomą z nieskorelowanych zaburzeń (Wold, 1938). To teoretyczny fundament modeli ARIMA: stacjonarny szereg da się przybliżać średnią ruchomą lub autoregresją.
- Tablice losowych odchyleń normalnych (1948). Zestaw 25 000 liczb z rozkładu normalnego do eksperymentów symulacyjnych (Wold, 1948) – szerzej w ciekawostce.
- „Miękkie modelowanie” i PLS. W latach 70. Wold rozwinął modele ścieżkowe ze zmiennymi ukrytymi szacowanymi iteracyjnie metodą częściowych najmniejszych kwadratów (algorytm NIPALS). Przeznaczył je do sytuacji, w których zjawisko jest złożone, wiedzy teoretycznej mało, a rozkładów nie znamy: zmienne ukryte szacuje się jako ważone sumy wskaźników, a model ocenia walidacją krzyżową (Wold, 1980). Z Jöreskogiem redagował materiały konferencji w Cartigny pod Genewą (1979), na której porównywano PLS z metodą największej wiarygodności.
- Regresja PLS. Ta sama idea – składowe budowane tak, by jak najlepiej przewidywały y – trafiła do chemii; Wold (1980) wymienia zastosowania chemiczne S. Wolda i współpracowników. Dziś to regresja PLS, podstawowe narzędzie kalibracji widm.
Ciekawostka
Zanim komputery zaczęły losować liczby, trzeba je było drukować. W 1948 r. w serii „Tracts for Computers” redagowanej przez Egona Pearsona ukazały się tablice Wolda: 25 000 losowych odchyleń z rozkładu normalnego, uzyskanych przez przekształcenie liczb losowych Kendalla i Babingtona Smitha. Pierwsze podejście się nie udało. Gdy tablice Kendalla i Smitha czytano wierszami, wariancja całego zestawu wyszła o 2–4% za duża, więc w Uppsali zaczęto pracę od nowa, czytając je kolumnami. Dwa rękopiśmienne zestawy liczyli niezależnie współpracownicy instytutu i porównywali je ze sobą (Wold, 1948).
Gotowe liczby przeszły testy zgodności z rozkładem normalnym (z jednym wyjątkiem tuż przy granicy, w pierwszym bloku 5000 liczb); najbardziej skrajne z 25 000 wartości to −4.14 i +3.91. Wold sam wyjaśniał we wstępie, po co komu taki zbiór: by sprawdzać rozkłady statystyk doświadczalnie, metodą, którą wprowadził William S. Gosset („Student”). Dziś robi to jedno wywołanie rnorm().
Przykład na danych z pakietu R
Zbiór gasoline z pakietu pls to – według pliku pomocy – widma w bliskiej podczerwieni (NIR) 60 próbek benzyny, mierzone od 900 do 1700 nm co 2 nm, czyli 401 zmiennych, oraz liczby oktanowe tych próbek; źródłem jest Kalivas (1997). Zmiennych jest prawie siedem razy więcej niż obserwacji, więc zwykła MNK nie działa: lm() zwraca 342 współczynniki jako brakujące, a sąsiednie długości fali są niemal idealnie współliniowe.
Algorytm NIPALS dla jednej zmiennej zależnej mieści się w kilkunastu wierszach R: wagi to kierunek największej kowariancji widm z liczbą oktanową, składowa to ważona suma widm, a po każdym kroku z danych odejmuje się to, co już wyjaśniono. Z czterema składowymi prognozy z ręcznej wersji różnią się od plsr() o mniej niż 10−13, a R² dopasowania wynosi .980.
Ile składowych wziąć? Walidacja krzyżowa z pominięciem jednej próbki daje błąd prognozy RMSEP = 1.543 bez predyktorów, 1.328 z jedną składową PLS, 0.381 z dwiema i 0.241 z czterema; minimum 0.219 przy siedmiu. Regresja na składowych głównych (PCR) potrzebuje czterech składowych, by zejść do 0.250 – przy dwóch ma błąd 1.474. Pierwsza składowa PCR wyjaśnia 72.6% wariancji widm, ale tylko 19% wariancji liczby oktanowej; pierwsza składowa PLS – 71.0% wariancji widm i 32% wariancji liczby oktanowej.
Na rysunku
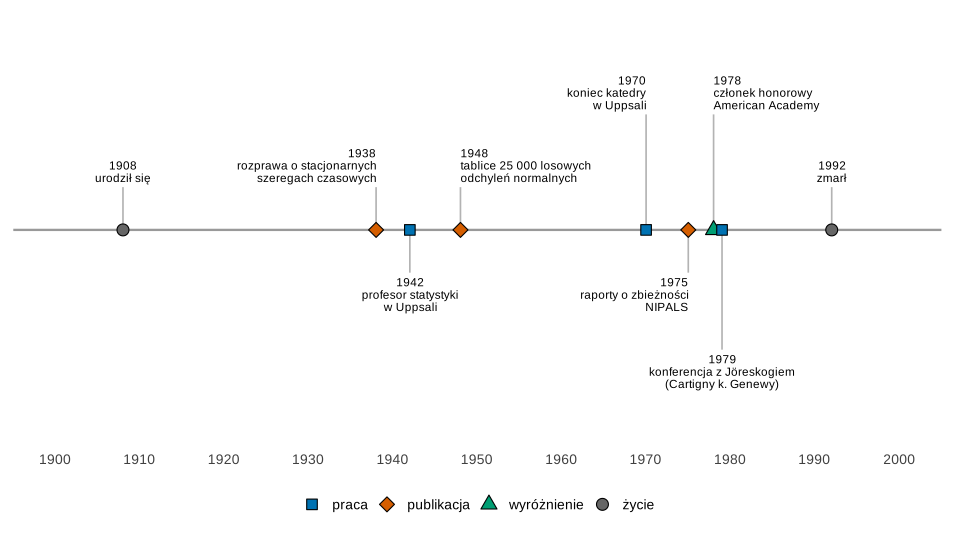
Co widać. Dwie kariery w jednej: teoria szeregów czasowych w latach 30.–40. i PLS w latach 70., gdy Wold zbliżał się do emerytury.
Na co uważać. Cytowane źródła nie podają dokładnych dat urodzenia i śmierci ani miejsca urodzenia, więc ich nie podajemy. Lata 1975 i 1979 pochodzą z dat raportów i konferencji wymienionych w bibliografii pracy z 1980 r.
Podpis do pracy:
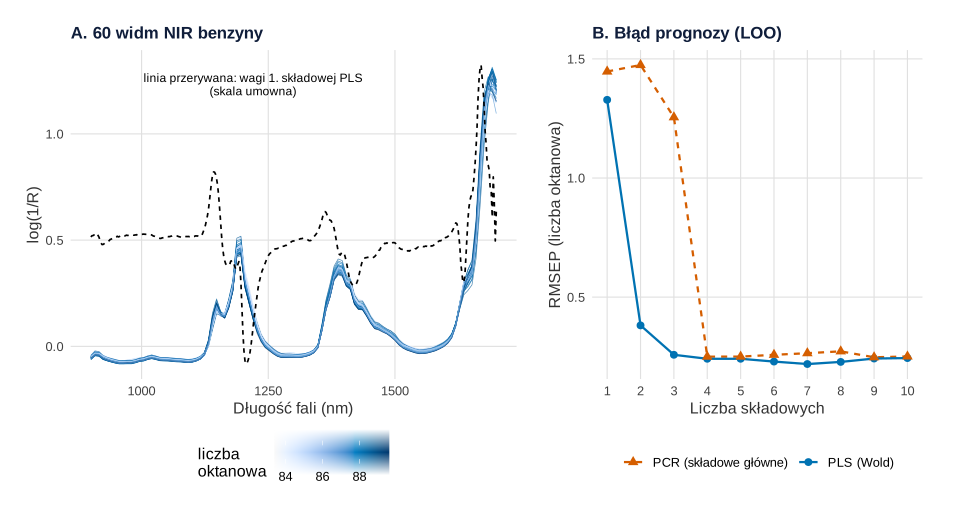
pls::gasoline. Obliczenia i rysunek: R, pakiety pls, ggplot2, patchwork i colorspace.Co widać. W panelu A widma prawie się pokrywają – informacja o liczbie oktanowej siedzi w drobnych różnicach, a wagi PLS wskazują pasma, w których te różnice są najbardziej związane z y. W panelu B PLS osiąga niski błąd już przy dwóch składowych, bo buduje je z myślą o y; PCR szuka kierunków największej wariancji widm, które nie muszą przewidywać liczby oktanowej.
Na co uważać. Przy czterech i więcej składowych obie metody dają podobny błąd, a różnice między 4 a 10 składowymi są małe – wybieraj najprostszy model blisko minimum, żeby uniknąć przeuczenia. Kolor linii w panelu A jest tylko ozdobnikiem, nie nośnikiem wyniku.
Podpis do pracy:
Gdzie spotkasz Wolda w swojej pracy
- Szeregi czasowe. Gdy dopasowujesz model ARMA albo ARIMA, korzystasz z tego, że stacjonarny szereg ma reprezentację średniej ruchomej – to rozkład Wolda.
- Dużo predyktorów, mało obserwacji. Widma, dane genetyczne, wskaźniki z kwestionariuszy – tam, gdzie MNK zawodzi, regresja PLS jest alternatywą dla PCR i regresji grzbietowej i LASSO.
- PLS-SEM. Modele ścieżkowe Wolda to przodek PLS-SEM, popularnego w zarządzaniu i marketingu. Zanim po nie sięgniesz, przeczytaj porównanie PLS-SEM czy CB-SEM? i hasło o PLSc.
Spory, mity i trudne strony
- Czy PLS jest „zgodny”? Wold (1980) pisał, że metoda największej wiarygodności dąży do optymalnej dokładności, a PLS do zgodności („consistency at large”), i że w regularnych warunkach oba podejścia dają podobne oszacowania. Rönkkö i Evermann (2013) pokazali na prostych przykładach, że wiele rozpowszechnionych przekonań o zaletach PLS nie wytrzymuje sprawdzenia. Odpowiedzią części zwolenników są poprawki takie jak PLSc.
- „Ojciec PLS” i chemometria. PLS ma dwie linie rozwoju: ekonometryczno-społeczną (modele ścieżkowe) i chemiczną (regresja PLS). Wold (1980) wymienia obie; nie przypisujemy tu nikomu pierwszeństwa w regresji PLS ponad to, co mówią źródła.
Regresja PLS algorytmem NIPALS w R
Kod wczytuje dane gasoline, pokazuje, dlaczego MNK zawodzi, liczy regresję PLS ręcznie algorytmem NIPALS, porównuje wynik z plsr(), wybiera liczbę składowych walidacją krzyżową (PLS vs PCR) i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje (walidacja leave-one-out jest deterministyczna).
1. NIPALS ręcznie i walidacja krzyżowa: rysunek 2
Kod R rysunku 2
# Herman Wold: regresja PLS algorytmem NIPALS ręcznie vs pakiet pls (dane pls::gasoline)
suppressPackageStartupMessages({library(pls); library(ggplot2); library(patchwork); library(colorspace)})
kol <- c(pls = "#0072B2", pcr = "#D55E00")                          # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(gasoline, package = "pls")
# octane – liczba oktanowa 60 próbek benzyny; NIR – widma w bliskiej podczerwieni, 401 długości fali (900–1700 nm co 2 nm)
X <- unclass(gasoline$NIR); y <- gasoline$octane
c(probki = nrow(X), dlugosci_fali = ncol(X))
round(c(min = min(y), srednia = mean(y), max = max(y), sd = sd(y)), 2)
# Zwykła MNK nie ma sensu: 401 predyktorów, 60 obserwacji
c(rzad_macierzy_X = qr(cbind(1, X))$rank, kolumny = ncol(X) + 1,
  wspolczynniki_NA_w_lm = sum(is.na(coef(lm(y ~ X)))))

# 1. NIPALS dla jednej zmiennej zależnej (PLS1) ręcznie
nipals_pls1 <- function(X, y, a) {
  Xs <- scale(X, scale = FALSE); ys <- y - mean(y)
  W <- P <- matrix(0, ncol(X), a); T <- matrix(0, nrow(X), a); q <- numeric(a)
  for (k in 1:a) {
    w <- crossprod(Xs, ys); w <- w / sqrt(sum(w^2))    # wagi: kierunek największej kowariancji z y
    t <- Xs %*% w                                       # wyniki (składowa ukryta)
    p <- crossprod(Xs, t) / sum(t^2)                    # ładunki X
    q[k] <- sum(ys * t) / sum(t^2)                      # współczynnik regresji y na t
    Xs <- Xs - t %*% t(p); ys <- ys - q[k] * t          # deflacja: odejmujemy to, co już wyjaśnione
    W[, k] <- w; P[, k] <- p; T[, k] <- t
  }
  B <- W %*% solve(crossprod(P, W)) %*% q               # współczynniki dla oryginalnych zmiennych
  list(B = B, b0 = mean(y) - sum(colMeans(X) * B), W = W, T = T)
}
a <- 4
recznie <- nipals_pls1(X, y, a)
pakiet <- plsr(octane ~ NIR, ncomp = a, data = gasoline, method = "oscorespls")
yhat_r <- recznie$b0 + X %*% recznie$B
yhat_p <- predict(pakiet, ncomp = a)[, 1, 1]
signif(c(max_roznica_prognoz = max(abs(yhat_r - yhat_p)),
         max_roznica_wspolczynnikow = max(abs(recznie$B - coef(pakiet, ncomp = a)[, 1, 1]))), 2)
round(c(R2_dopasowania = 1 - sum((y - yhat_r)^2) / sum((y - mean(y))^2)), 4)
# składowe są nieskorelowane
round(cor(recznie$T)[1:3, 1:3], 6)

# 2. Ile składowych? Walidacja krzyżowa leave-one-out: PLS vs regresja na składowych głównych (PCR)
m_pls <- plsr(octane ~ NIR, ncomp = 10, data = gasoline, validation = "LOO")
m_pcr <- pcr(octane ~ NIR, ncomp = 10, data = gasoline, validation = "LOO")
cv <- data.frame(skladowe = 1:10,
                 PLS = RMSEP(m_pls, estimate = "CV", intercept = FALSE)$val[1, 1, ],
                 PCR = RMSEP(m_pcr, estimate = "CV", intercept = FALSE)$val[1, 1, ], row.names = NULL)
round(cv, 3)
c(RMSEP_bez_predyktorow = round(RMSEP(m_pls, estimate = "CV")$val[1, 1, 1], 3))
round(rbind(PLS = explvar(m_pls)[1:4], PCR = explvar(m_pcr)[1:4]), 1)   # % wariancji X na składową
round(c(R2_PLS_y_1skl = R2(m_pls, estimate = "train")$val[1, 1, 2],
        R2_PCR_y_1skl = R2(m_pcr, estimate = "train")$val[1, 1, 2]), 3)

# Rysunek: A – widma NIR i wagi pierwszej składowej PLS; B – błąd prognozy w walidacji krzyżowej
fala <- seq(900, 1700, by = 2)
co4 <- seq(1, ncol(X), by = 4)                      # do rysunku co 8 nm (mniejszy plik)
widma <- data.frame(fala = rep(fala[co4], each = nrow(X)), wartosc = as.vector(X[, co4]),
                    probka = rep(seq_len(nrow(X)), length(co4)), oktany = rep(y, length(co4)))
wagi <- data.frame(fala = fala, w1 = recznie$W[, 1])
skala <- diff(range(X)) / diff(range(wagi$w1))
pA <- ggplot(widma, aes(fala, wartosc, group = probka)) +
  geom_line(aes(colour = oktany), linewidth = 0.25, alpha = 0.7) +
  geom_line(data = wagi, aes(fala, min(X) + (w1 - min(w1)) * skala, group = 1), inherit.aes = FALSE,
            colour = "black", linewidth = 0.6, linetype = "22") +
  annotate("text", x = 1220, y = max(X) * 0.97, label = "linia przerywana: wagi 1. składowej PLS\n(skala umowna)",
           size = 3.2, hjust = 0.5, vjust = 1, lineheight = 0.9) +
  scale_colour_continuous_sequential(palette = "Blues 3", name = "liczba\noktanowa") +
  labs(title = "A. 60 widm NIR benzyny", x = "Długość fali (nm)", y = "log(1/R)") +
  motyw + theme(legend.position = "right")
cv_dl <- rbind(data.frame(skladowe = cv$skladowe, RMSEP = cv$PLS, metoda = "PLS (Wold)"),
               data.frame(skladowe = cv$skladowe, RMSEP = cv$PCR, metoda = "PCR (składowe główne)"))
pB <- ggplot(cv_dl, aes(skladowe, RMSEP, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.4) +
  scale_x_continuous(breaks = 1:10) +
  scale_colour_manual(values = c(`PLS (Wold)` = kol[["pls"]], `PCR (składowe główne)` = kol[["pcr"]]), name = NULL) +
  scale_shape_manual(values = c(`PLS (Wold)` = 16, `PCR (składowe główne)` = 17), name = NULL) +
  scale_linetype_manual(values = c(`PLS (Wold)` = "solid", `PCR (składowe główne)` = "22"), name = NULL) +
  labs(title = "B. Błąd prognozy (LOO)", x = "Liczba składowych", y = "RMSEP (liczba oktanowa)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.35, 1))
p2
Wynik w R
       probki dlugosci_fali
           60           401
    min srednia     max      sd
  83.40   87.18   89.60    1.53
      rzad_macierzy_X               kolumny wspolczynniki_NA_w_lm
                   60                   402                   342
       max_roznica_prognoz max_roznica_wspolczynnikow
                   5.7e-14                    2.9e-15
R2_dopasowania
        0.9801
     [,1] [,2] [,3]
[1,]    1    0    0
[2,]    0    1    0
[3,]    0    0    1
   skladowe   PLS   PCR
1         1 1.328 1.447
2         2 0.381 1.474
3         3 0.258 1.255
4         4 0.241 0.250
5         5 0.241 0.250
6         6 0.229 0.258
7         7 0.219 0.265
8         8 0.228 0.272
9         9 0.242 0.247
10       10 0.244 0.251
RMSEP_bez_predyktorow
                1.543
    Comp 1 Comp 2 Comp 3 Comp 4
PLS   71.0    7.6    7.6    9.3
PCR   72.6   11.3    7.0    4.6
R2_PLS_y_1skl R2_PCR_y_1skl
        0.319         0.190
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Herman Wold (1908–1992) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1908, 1938, 1942, 1948, 1970, 1975, 1978, 1979, 1992),
  opis = c("urodził się", "rozprawa o stacjonarnych\nszeregach czasowych", "profesor statystyki\nw Uppsali",
           "tablice 25 000 losowych\nodchyleń normalnych", "koniec katedry\nw Uppsali",
           "raporty o zbieżności\nNIPALS", "członek honorowy\nAmerican Academy", "konferencja z Jöreskogiem\n(Cartigny k. Genewy)",
           "zmarł"),
  rodzaj = c("życie", "publikacja", "praca", "publikacja", "praca", "publikacja", "wyróżnienie", "praca", "życie"),
  poziom = c(0.5, 0.5, -0.5, 0.5, 1.35, -0.5, 1.35, -1.4, 0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 1, 0.5, 0, 1, 1, 0, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1900, 2000), breaks = seq(1900, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.3, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (regresja PLS, PCR i walidacja krzyżowa – funkcje plsr(), pcr() i RMSEP() z pakietu pls; dane – pakiet pls; rysunki – pakiety ggplot2, patchwork i colorspace). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pls (wersja 2.9-0): Liland, K. H., Mevik, B.-H., & Wehrens, R. (2026). pls: Partial least squares and principal component regression (R package version 2.9-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pls
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
Najczęstsze pytania
Kim był Herman Wold?
Szwedzkim statystykiem i ekonometrykiem (1908–1992). Rozprawę o stacjonarnych szeregach czasowych ukończył w 1938 r. w Sztokholmie (nauczycielem był Harald Cramér), w latach 1942–1970 był profesorem statystyki w Uppsali (jego następcą został Karl Jöreskog), a w latach 70. stworzył metody częściowych najmniejszych kwadratów (PLS).
Co mówi rozkład Wolda?
Że każdy stacjonarny proces dyskretny o skończonej wariancji można zapisać jako sumę dwóch nieskorelowanych części: deterministycznej i średniej ruchomej (nieskończonego rzędu) z nieskorelowanych zaburzeń. Dlatego stacjonarne szeregi da się przybliżać modelami MA, AR i ARMA.
Czym różni się regresja PLS od regresji na składowych głównych?
Obie zastępują wiele skorelowanych predyktorów kilkoma składowymi. PCR buduje składowe tylko z X (największa wariancja), PLS – z myślą o y (największa kowariancja z y). W danych gasoline PLS z dwiema składowymi ma błąd prognozy 0.381, a PCR z dwiema – 1.474; przy czterech obie dają około 0.24–0.25.
Co to jest NIPALS?
Iteracyjny algorytm Wolda (nonlinear iterative partial least squares), który wyznacza składowe po kolei: liczy wagi, składową i ładunki, a potem odejmuje z danych to, co już wyjaśnione. W wersji dla jednej zmiennej zależnej to kilkanaście wierszy kodu; wynik pokrywa się z funkcją plsr() z pakietu pls.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Academy of Arts and Sciences. (b.d.). Herman Ole Andraeas Wold. Pobrano 20 listopada 2026 z https://www.amacad.org/person/herman-ole-andraeas-wold ● Otwarty dostęp
- Rönkkö, M., & Evermann, J. (2013). A critical examination of common beliefs about partial least squares path modeling. Organizational Research Methods, 16(3), 425–448. https://doi.org/10.1177/1094428112474693
- Uppsala universitet, Statistiska institutionen. (b.d.). Professorslängd. Pobrano 20 listopada 2026 z https://www.uu.se/institution/statistiska/forskning/professorslangd ● Otwarty dostęp
- Wold, H. (1938). A study in the analysis of stationary time series. Almqvist & Wiksell. https://archive.org/details/in.ernet.dli.2015.262214 ● Otwarty dostęp
- Wold, H. (1948). Random normal deviates: 25,000 items compiled from Tract No. XXIV (M. G. Kendall and B. Babington Smith’s tables of random sampling numbers) (Tracts for Computers No. 25). Cambridge University Press. https://archive.org/details/RandomNormalDeviates ● Otwarty dostęp
- Wold, H. (1980). Model construction and evaluation when theoretical knowledge is scarce. In J. Kmenta & J. B. Ramsey, Evaluation of econometric models (pp. 47–74). Academic Press. https://doi.org/10.1016/b978-0-12-416550-2.50007-8 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@misc{amacadwold, author={{American Academy of Arts and Sciences}}, title={{Herman Ole Andraeas Wold}}, url={https://www.amacad.org/person/herman-ole-andraeas-wold}}@article{ronkko2013critical, author={Rönkkö, Mikko and Evermann, Joerg}, title={{A critical examination of common beliefs about partial least squares path modeling}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={3}, pages={425--448}, doi={10.1177/1094428112474693}}@misc{uuprofessorslangd, author={{Uppsala universitet, Statistiska institutionen}}, title={{Professorslängd}}, url={https://www.uu.se/institution/statistiska/forskning/professorslangd}}@book{wold1938study, author={Wold, Herman}, title={{A study in the analysis of stationary time series}}, year={1938}, publisher={Almqvist \& Wiksell}, url={https://archive.org/details/in.ernet.dli.2015.262214}}@book{wold1948random, author={Wold, Herman}, title={{Random normal deviates: 25,000 items compiled from Tract No. XXIV (M. G. Kendall and B. Babington Smith’s tables of random sampling numbers) (Tracts for Computers No. 25)}}, year={1948}, publisher={Cambridge University Press}, url={https://archive.org/details/RandomNormalDeviates}}@incollection{wold1980model, author={Wold, Herman}, title={{Model construction and evaluation when theoretical knowledge is scarce}}, booktitle={Evaluation of econometric models}, year={1980}, pages={47--74}, publisher={Academic Press}, doi={10.1016/b978-0-12-416550-2.50007-8}}