Co to jest regresja PLS?
Regresja PLS (ang. partial least squares regression, PLSR, też projection to latent structures) przewiduje jedną lub kilka zmiennych zależnych z wielu silnie skorelowanych predyktorów. Zamiast wszystkich predyktorów używa kilku składowych – ich kombinacji liniowych. Abdi (2010) opisuje ją jako połączenie cech analizy głównych składowych i regresji wielorakiej: z predyktorów wyodrębnia się ortogonalne zmienne ukryte o największej mocy predykcyjnej. Stosuje się ją, gdy predyktorów jest dużo, a obserwacji mało (chemometria, spektroskopia, neuroobrazowanie), i przy silnej współliniowości.
Jak działa PLS i czym różni się od PCR
W regresji na głównych składowych (PCR) składowe maksymalizują wariancję samych predyktorów, a dopiero potem wchodzą do regresji. W PLS każda składowa jest kierunkiem o największej kowariancji z y; po jej wyodrębnieniu predyktory i y oczyszcza się z jej wpływu i szuka następnej (algorytm NIPALS). Liczbę składowych dobiera się walidacją krzyżową. Frank i Friedman (1993) przeanalizowali PLS i PCR ze statystycznego punktu widzenia i porównali je z MNK, doborem zmiennych i regresją grzbietową.
Przykład
W danych symulowanych (60 obserwacji do uczenia, 10 predyktorów, z czego 9 mierzy ten sam czynnik) błąd predykcji RMSE na 1000 nowych obserwacjach wyniósł 1.223 dla MNK. PLS z jedną składową dał 1.148 (PCR: 1.191), z dwiema 0.998 (PCR: 0.999), a z trzema znów gorzej: 1.125. Za dużo składowych oznacza powrót do przeuczenia.
Na rysunku
Przykład pokazał, że PLS lepiej przewiduje. Rysunek pokazuje drugą stronę: stabilność współczynników. Z 60 obserwacji uczących z przykładu (set.seed(642)) wylosowano 500 prób bootstrapowych (ponownie set.seed(642)). W każdej policzono współczynniki MNK i PLS z dwiema składowymi na predyktorach standaryzowanych. Krzyżyki to wartości populacyjne, wyliczone z modelu, z którego generowano dane.
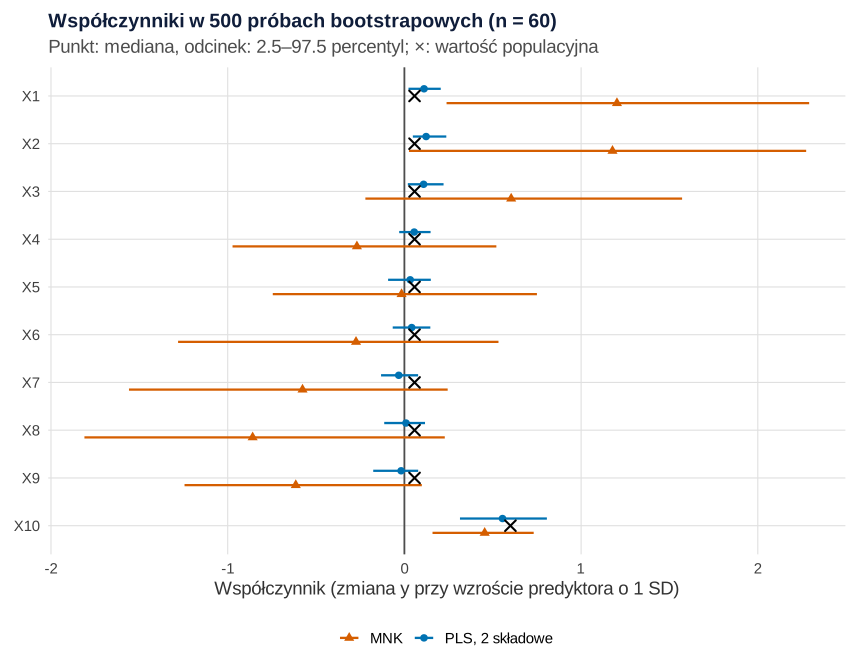
Co widać. Predyktory X1–X9 mierzą ten sam czynnik, więc w populacji każdy ma ten sam mały współczynnik (0.057). MNK w tej próbie przypisuje X1 i X2 po około 1.2, a X8 −0.92. Średnie odchylenie standardowe bootstrapowe tych współczynników wynosi 0.463, a 55.2% oszacowań ma znak ujemny. PLS dzieli wpływ czynnika między wszystkie dziewięć zmiennych. Jego współczynniki mają SD 0.056, czyli ośmiokrotnie mniejsze, i leżą blisko wartości populacyjnych. Dla niezależnego predyktora X10 obie metody dają podobny obraz (SD 0.146 i 0.125).
Na co uważać. Bootstrap pokazuje zmienność wokół tej jednej próby, a nie wokół populacji. Wąskie przedziały PLS nie są przedziałami ufności z klasycznym pokryciem, bo współczynniki PLS są obciążone (kurczone), a ich wielkość zależy od liczby składowych. Tutaj obciążenie jest małe, bo prawdziwe współczynniki X1–X9 są równe, a taki układ PLS odtwarza dobrze. Gdyby jedna zmienna z grupy działała silniej od pozostałych, PLS rozmyłby ten efekt na całą grupę. Odcinki MNK są szerokie, ale nie błędne. Uczciwie mówią, że dane nie rozróżniają zmiennych z jednej grupy. Ten typ wykresu opisuje hasło wykres współczynników, a sam bootstrap – wpis bootstrap w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z opisu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu. Dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Stabilność współczynników MNK i PLS (2 składowe) przy silnej współliniowości: 500 prób bootstrapowych
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw; metodę rozróżnia też kształt punktu
kol <- c("MNK" = "#D55E00", "PLS, 2 składowe" = "#0072B2")
ksz <- c("MNK" = 17, "PLS, 2 składowe" = 16)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Dane jak w przykładzie: 60 obserwacji, X1–X9 mierzą wspólny czynnik z, X10 jest od nich niezależny
set.seed(642)
n <- 60; p <- 10
z <- rnorm(n + 1000)
X <- sapply(1:p, function(j) z + rnorm(n + 1000, sd = 0.3))
X[, 10] <- rnorm(n + 1000)
y <- 0.5 * z + 0.6 * X[, 10] + rnorm(n + 1000)
Xu <- X[1:n, ]; yu <- y[1:n]                         # próba ucząca (pierwsze 60 obserwacji)
colnames(Xu) <- paste0("X", 1:p)

# Wartości populacyjne: współczynniki regresji y na X przy 1 SD predyktora (z macierzy kowariancji modelu)
S <- matrix(1, p, p); diag(S) <- 1 + 0.3^2; S[10, ] <- S[, 10] <- 0; S[10, 10] <- 1
c_xy <- c(rep(0.5, 9), 0.6)                          # cov(X_j, y)
b_pop <- solve(S, c_xy) * sqrt(diag(S))

wsp <- function(Xb, yb) {                            # współczynniki przy 1 SD predyktora w danej próbie
  Xs <- scale(Xb)
  pls_m <- pls::plsr(yb ~ Xs, ncomp = 2, scale = FALSE)
  w <- rbind(MNK = coef(lm(yb ~ Xs))[-1], PLS = drop(coef(pls_m, ncomp = 2)))
  colnames(w) <- colnames(Xb); w
}
set.seed(642)                                        # bootstrap: 500 prób z próby uczącej
B <- 500
boot <- replicate(B, { i <- sample(n, replace = TRUE); wsp(Xu[i, ], yu[i]) })   # tablica 2 × 10 × B

podsum <- do.call(rbind, lapply(1:2, function(m) data.frame(
  metoda = names(kol)[m], predyktor = factor(colnames(Xu), levels = rev(colnames(Xu))),
  srodek = apply(boot[m, , ], 1, median),
  dolna = apply(boot[m, , ], 1, quantile, 0.025), gorna = apply(boot[m, , ], 1, quantile, 0.975))))
round(rbind(populacja = b_pop, wsp(Xu, yu)), 3)      # wartości populacyjne i oszacowania z próby
round(rbind(
  SD_bootstrap_X1_X9 = c(MNK = mean(apply(boot[1, 1:9, ], 1, sd)), PLS = mean(apply(boot[2, 1:9, ], 1, sd))),
  odsetek_ujemnych_X1_X9 = c(MNK = mean(boot[1, 1:9, ] < 0), PLS = mean(boot[2, 1:9, ] < 0)),
  SD_bootstrap_X10 = c(MNK = sd(boot[1, 10, ]), PLS = sd(boot[2, 10, ]))), 3)

pop <- data.frame(predyktor = factor(colnames(Xu), levels = rev(colnames(Xu))), b = b_pop)
p1 <- ggplot(podsum, aes(srodek, predyktor, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.6), size = 0.45, linewidth = 0.8) +
  geom_point(data = pop, aes(b, predyktor), inherit.aes = FALSE, shape = 4, size = 3, stroke = 1.1, colour = "black") +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = ksz, name = NULL) +
  labs(title = "Współczynniki w 500 próbach bootstrapowych (n = 60)",
       subtitle = "Punkt: mediana, odcinek: 2.5–97.5 percentyl; ×: wartość populacyjna",
       x = "Współczynnik (zmiana y przy wzroście predyktora o 1 SD)", y = NULL) +
  motyw
p1
Wynik w R
             X1    X2    X3     X4    X5     X6     X7     X8     X9   X10
populacja 0.057 0.057 0.057  0.057 0.057  0.057  0.057  0.057  0.057 0.600
MNK       1.219 1.234 0.589 -0.286 0.003 -0.299 -0.566 -0.921 -0.566 0.464
PLS       0.107 0.123 0.102  0.055 0.032  0.044 -0.028  0.004 -0.012 0.553
                         MNK   PLS
SD_bootstrap_X1_X9     0.463 0.056
odsetek_ujemnych_X1_X9 0.552 0.260
SD_bootstrap_X10       0.146 0.125
Jak opisać w pracy
Na co uważać
- PLS to metoda predykcyjna: współczynniki są obciążone i nie mają klasycznych wartości p.
- Predyktory standaryzuj, bo składowe zależą od skali zmiennych.
- Nie myl regresji PLS z modelowaniem ścieżek PLS-SEM, które szacuje relacje między konstruktami (zob. PLS-SEM krok po kroku).
- Gdy współliniowość dotyczy kilku zmiennych, prostsze rozwiązania opisuje wpis Wysoki VIF – co zrobić. W R regresję PLS oferuje pakiet pls (Mevik i Wehrens, 2007).
Regresja PLS w R
Kod liczy regresję PLS algorytmem NIPALS ręcznie, a PCR przez prcomp() i lm(), porównuje błąd predykcji obu metod oraz MNK na danych testowych, a na koniec sprawdza wynik funkcją pls::plsr().
PLS (NIPALS) a PCR i MNK przy współliniowości
R
# Regresja PLS (PLS1, algorytm NIPALS) ręcznie i porównanie z PCR i MNK (dane symulowane)
set.seed(642)
n <- 60; p <- 10
z <- rnorm(n + 1000)                                   # wspólny czynnik -> silna współliniowość
X <- sapply(1:p, function(j) z + rnorm(n + 1000, sd = 0.3))
X[, 10] <- rnorm(n + 1000)                             # predyktor niezwiązany z czynnikiem, ale z y
y <- 0.5 * z + 0.6 * X[, 10] + rnorm(n + 1000)
tr <- 1:n; te <- (n + 1):(n + 1000)                    # 60 do uczenia, 1000 do testu
mx <- colMeans(X[tr, ]); sx <- apply(X[tr, ], 2, sd); my <- mean(y[tr])
Xs <- scale(X, mx, sx)
pls1 <- function(X, y, A) {                           # NIPALS dla jednej zmiennej zależnej
  W <- P <- matrix(0, ncol(X), A); q <- numeric(A); E <- X; f <- y
  for (a in 1:A) {
    w <- crossprod(E, f); w <- w / sqrt(sum(w^2))      # wagi: kierunek maks. kowariancji z y
    t <- E %*% w                                       # składowa (score)
    P[, a] <- crossprod(E, t) / sum(t^2); q[a] <- sum(f * t) / sum(t^2)
    E <- E - t %*% t(P[, a]); f <- f - q[a] * t; W[, a] <- w
  }
  W %*% solve(crossprod(P, W)) %*% q                   # współczynniki na skali standaryzowanej
}
rmse <- function(pred) sqrt(mean((y[te] - pred)^2))
wyn <- sapply(1:3, function(A) {
  b_pls <- pls1(Xs[tr, ], y[tr] - my, A)
  pc <- prcomp(Xs[tr, ], center = FALSE)
  T_tr <- pc$x[, 1:A, drop = FALSE]; g <- coef(lm(y[tr] - my ~ T_tr - 1))
  b_pcr <- pc$rotation[, 1:A, drop = FALSE] %*% g
  c(PLS = rmse(my + Xs[te, ] %*% b_pls), PCR = rmse(my + Xs[te, ] %*% b_pcr))
})
colnames(wyn) <- paste0("A=", 1:3)
round(wyn, 3)
ols <- lm(y[tr] ~ X[tr, ])
round(c(MNK_10_predyktorow = rmse(cbind(1, X[te, ]) %*% coef(ols))), 3)
# Pakiet pls: te same modele na danych uczących; RMSE na próbie testowej i walidacja krzyżowa
d_tr <- data.frame(y = y[tr], X = I(X[tr, ])); d_te <- data.frame(y = y[te], X = I(X[te, ]))
m <- pls::plsr(y ~ X, ncomp = 5, scale = TRUE, data = d_tr, validation = "CV")
round(rbind(test_plsr = pls::RMSEP(m, newdata = d_te, intercept = FALSE)$val[1, 1, 1:3],
            CV_plsr = pls::RMSEP(m, intercept = FALSE)$val["CV", 1, 1:3]), 3)
Wynik w R
      A=1   A=2   A=3
PLS 1.148 0.998 1.125
PCR 1.191 0.999 0.999
MNK_10_predyktorow
             1.223
          1 comps 2 comps 3 comps
test_plsr   1.148   0.998   1.125
CV_plsr     1.147   1.057   1.095
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet pls 2.9-0). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pls (wersja 2.9-0): Liland, K. H., Mevik, B.-H., & Wehrens, R. (2026). pls: Partial least squares and principal component regression (R package version 2.9-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pls
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym regresja PLS różni się od regresji na głównych składowych (PCR)?
PCR buduje składowe tylko z predyktorów, maksymalizując ich wariancję, więc może pominąć kierunek ważny dla y. PLS wybiera składowe o największej kowariancji z y, dlatego zwykle potrzebuje mniej składowych do podobnej trafności predykcji.
Czy regresja PLS to to samo co PLS-SEM?
Nie. Regresja PLS przewiduje zmienną zależną z wielu predyktorów. PLS-SEM to modelowanie ścieżek między konstruktami mierzonymi wskaźnikami. Obie metody korzystają z podobnej idei cząstkowych najmniejszych kwadratów, ale służą innym celom.
Ile składowych wybrać w regresji PLS?
Tyle, ile minimalizuje błąd predykcji w walidacji krzyżowej lub na próbie testowej. Dodawanie składowych zawsze poprawia dopasowanie do danych uczących, ale po pewnym punkcie pogarsza predykcję.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wysoki VIF – co zrobić ze współliniowością?
Kiedy wysoki VIF jest problemem, a kiedy nie, dlaczego nie usuwać predyktorów tylko z jego powodu i jak opisać współliniowość w pracy – z przykładem w R.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Abdi, H. (2010). Partial least squares regression and projection on latent structure regression (PLS Regression). WIREs Computational Statistics, 2(1), 97–106. https://doi.org/10.1002/wics.51
- Frank, I. E., & Friedman, J. H. (1993). A statistical view of some chemometrics regression tools. Technometrics, 35(2), 109–135. https://doi.org/10.1080/00401706.1993.10485033
- Mevik, B.-H., & Wehrens, R. (2007). The pls package: Principal component and partial least squares regression in R. Journal of Statistical Software, 18(2). https://doi.org/10.18637/jss.v018.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{abdi2010partial, author={Abdi, Hervé}, title={{Partial least squares regression and projection on latent structure regression (PLS Regression)}}, journal={WIREs Computational Statistics}, year={2010}, volume={2}, number={1}, pages={97--106}, doi={10.1002/wics.51}}@article{frank1993statistical, author={Frank, Ildiko E. and Friedman, Jerome H.}, title={{A statistical view of some chemometrics regression tools}}, journal={Technometrics}, year={1993}, volume={35}, number={2}, pages={109--135}, doi={10.1080/00401706.1993.10485033}}@article{mevik2007pls, author={Mevik, Bjørn-Helge and Wehrens, Ron}, title={{The pls package: Principal component and partial least squares regression in R}}, journal={Journal of Statistical Software}, year={2007}, volume={18}, number={2}, doi={10.18637/jss.v018.i02}}