Kim był Clive W. J. Granger?
Clive William John Granger (1934–2009) był brytyjskim ekonometrykiem, który nauczył ekonomistów ostrożności wobec danych zmieniających się w czasie. Urodził się 4 września 1934 r. w Swansea, a dorastał w Cambridge i pod Nottingham. Na Uniwersytecie w Nottingham studiował matematykę (dyplom 1955). Doktorat (1959) napisał pod kierunkiem probabilisty Harry’ego Pitta na temat, który okazał się proroczy: testowanie niestacjonarności szeregów czasowych (Hendry i Teräsvirta, 2013).
W Nottingham był wykładowcą statystyki od 1956 r., a profesorem od 1965 r. Rok akademicki 1959/60 spędził w Princeton, gdzie John Tukey uczył go analizy spektralnej. W 1974 r. przeniósł się na University of California w San Diego (UCSD) i pracował tam do emerytury w 2003 r. – w tym samym roku otrzymał wraz z Robertem Engle’em Nagrodę Banku Szwecji im. Alfreda Nobla w dziedzinie ekonomii za metody analizy szeregów o wspólnych trendach. W 2005 r. został nobilitowany. Zmarł 27 maja 2009 r. w San Diego (Hendry i Teräsvirta, 2013).
Najważniejsze pomysły
- Analiza spektralna w ekonomii (1964). Z kursu Tukeya powstała książka napisana z Michio Hatanaką o widmach szeregów ekonomicznych (zob. periodogram i analiza spektralna).
- Przyczynowość (1969). W „Econometrice” Granger (1969) zaproponował testowalną definicję: x jest przyczyną y, jeśli przeszłe wartości x poprawiają prognozę y ponad to, co daje sama przeszłość y. To przyczynowość w sensie Grangera, dziś standardowy element modeli VAR.
- Regresja pozorna (1974). Z Paulem Newboldem pokazał w symulacjach, że regresja jednego błądzenia losowego na drugie, zupełnie niezależne, bardzo często daje „istotny” współczynnik (Granger i Newbold, 1974). To powrót do „bezsensownych korelacji” George’a Udny’ego Yule’a z 1926 r. (zob. korelacja pozorna).
- Kointegracja (1987). Szeregi niestacjonarne mogą mieć wspólny trend – wtedy pewna ich kombinacja liniowa jest stacjonarna. Engle i Granger (1987) podali definicję, twierdzenie o reprezentacji (łączące kointegrację z modelem korekty błędu) i testy.
- Prognozowanie. Z Johnem Batesem pokazał, że łączenie prognoz z kilku modeli często poprawia trafność.
Ciekawostka
Kointegracja narodziła się ze sporu. Według Hendry’ego i Teräsvirty (2013), którzy powołują się na autobiografię noblowską Grangera, David Hendry twierdził, że różnica dwóch niestacjonarnych szeregów bywa stacjonarna – jak „wielkie proporcje” ekonomii, np. konsumpcja do dochodu. Granger, przekonany po pracy z Newboldem, że regresje na poziomach niestacjonarnych szeregów są podejrzane, postanowił udowodnić, że Hendry się myli. Skończyło się odwrotnie: wyszło mu twierdzenie, które dziś nazywa się twierdzeniem Grangera o reprezentacji. Autorzy wspomnienia (jednym z nich jest sam Hendry) dodają z przekąsem, że Grangera trudno było do czegokolwiek przekonać – i może dobrze, bo dzięki temu odkrył kointegrację.
Ten sam tekst przytacza historię ze szkoły podstawowej: nauczyciel powiedział matce Grangera, że chłopiec nigdy nie odniesie sukcesu. Granger skomentował to po latach jako przykład trudności prognoz długoterminowych na niewystarczających danych.
Przykład na danych z pakietu R
Zbiór ChickEgg z pakietu lmtest to – według pliku pomocy – roczne dane z USA z lat 1930–1983: liczba kur na 1 grudnia (bez brojlerów) i produkcja jaj w milionach tuzinów. Plik pomocy zastrzega, że nieco różnią się od analizowanych przez Thurmana i Fishera (1988) w żartobliwym artykule o tym, co było pierwsze.
Test Grangera rzędu 3 porównuje dwie regresje: y na trzech własnych opóźnieniach oraz y na tych opóźnieniach i trzech opóźnieniach x. Po utracie trzech pierwszych lat zostaje 51 obserwacji. Czy przeszłe liczby kur poprawiają prognozę produkcji jaj? Nie: F(3, 44) = 0.59, p = .62. Czy przeszła produkcja jaj poprawia prognozę liczby kur? Tak: F(3, 44) = 5.41, p = .003. Wynik policzony ręcznie z sum kwadratów reszt jest identyczny z grangertest().
Wynik zależy jednak od rzędu opóźnień i od postaci danych. Na poziomach przy jednym opóźnieniu kierunek „jaja → kury” nie jest istotny (p = .28), przy 2–6 opóźnieniach jest (p od .0006 do .0064). Na pierwszych różnicach – czyli po usunięciu trendów – p wynosi od .0023 do .044. W kierunku „kury → jaja” żaden z 12 testów nie daje p poniżej .42.
Na rysunku
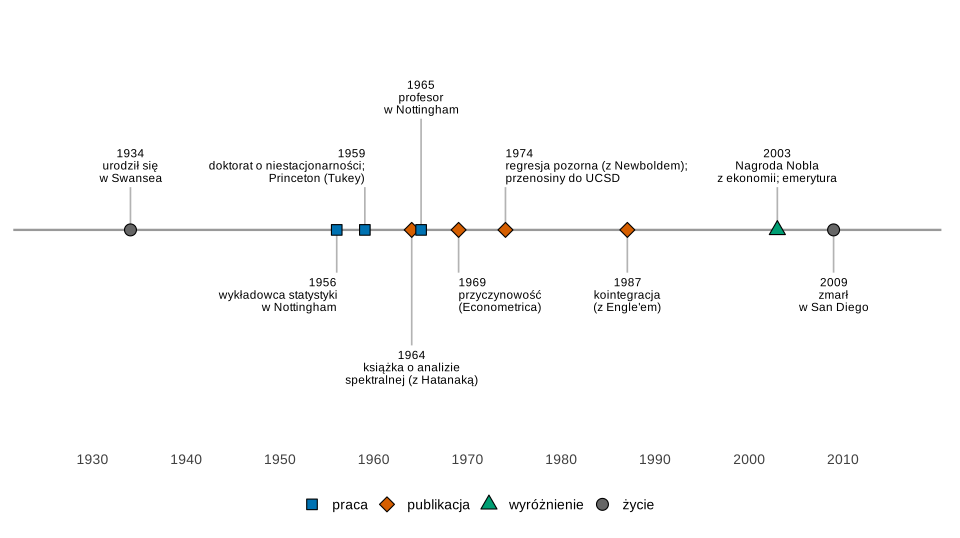
Co widać. Od przyczynowości (1969) do kointegracji (1987) minęło prawie dwadzieścia lat, a do Nobla – kolejne szesnaście.
Na co uważać. Rok przenosin do San Diego (1974) podajemy za wspomnieniem w Biographical Memoirs; w innych tekstach bywa 1973.
Podpis do pracy:
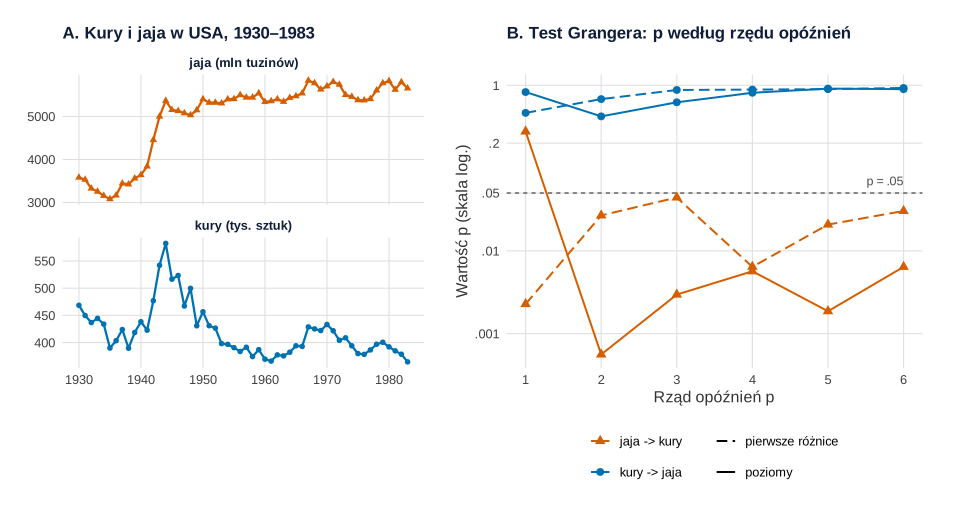
lmtest::ChickEgg. Obliczenia i rysunek: R, pakiety lmtest, ggplot2 i patchwork.Co widać. W panelu A oba szeregi mają wyraźne zmiany poziomu – skok produkcji jaj w czasie wojny i szczyt liczby kur w połowie lat 40. W panelu B wyniki układają się w dwie wyraźne grupy: przeszłość jaj pomaga prognozować liczbę kur (pomarańczowe punkty pod linią .05), przeszłość kur nie pomaga prognozować jaj.
Na co uważać. Test na poziomach zakłada stacjonarność, a oba szeregi błądzą – dlatego obok wyników na poziomach pokazujemy pierwsze różnice. Dwanaście testów na tych danych to porównania wielokrotne. I najważniejsze: „jaja → kury” znaczy tylko, że jaja poprawiają prognozę kur, nie że wiemy, co było pierwsze.
Podpis do pracy:
Gdzie spotkasz Grangera w swojej pracy
Zawsze, gdy analizujesz szeregi czasowe – w ekonomii, psychologii (dane dzienniczkowe) czy zarządzaniu. Na co zwracać uwagę:
- zanim policzysz regresję na dwóch trendujących szeregach, sprawdź stacjonarność (np. testem Dickeya–Fullera) i autokorelację reszt – wysokie R² przy silnie skorelowanych resztach to sygnał regresji pozornej;
- jeśli szeregi są niestacjonarne, ale mają wspólny trend, nie różnicuj ich bezrefleksyjnie – sprawdź kointegrację; praktyczne wskazówki są we wpisie Szeregi czasowe i ARIMA w praktyce;
- przy teście Grangera podawaj rząd opóźnień i sprawdź wrażliwość wyniku na jego zmianę (rysunek 2);
- w badaniach rynku spotkasz jego nazwisko w zupełnie innym miejscu: w latach 60. z André Gaborem prowadził eksperymenty cenowe w supermarketach – od nich pochodzi metoda opisana we wpisie Badanie ceny: van Westendorp i Gabor–Granger.
Spory, mity i trudne strony
- Czy to jest przyczynowość? Definicja Grangera zdobyła popularność dzięki łatwości użycia, ale od początku budziła spór, czy jest ogólną definicją przyczynowości, czy tylko jej szczególnym przypadkiem. Wynik może się odwrócić po dodaniu do analizy kolejnej zmiennej, więc wnioski przyczynowe nie są odporne (Hendry i Teräsvirta, 2013). Bezpieczniej mówić o „poprawie prognozy”; szerzej w haśle korelacja a przyczynowość.
- W próbie czy poza nią? Według tego samego źródła Granger był rozczarowany, że jego test stosuje się głównie w próbie, a on myślał o prawdziwym sprawdzianie prognoz poza próbą.
- Kto pierwszy? Granger nie odkrył „bezsensownych korelacji” – opisał je Yule w 1926 r., a Jewgienij Słucki w 1927 r. formalnie przeanalizował procesy średniej ruchomej (Hendry i Teräsvirta, 2013). Wkładem Grangera i Newbolda było pokazanie skali problemu w ekonometrii i nowa nazwa: regresja pozorna.
Test Grangera w R
Kod wczytuje dane ChickEgg, liczy test Grangera rzędu 3 ręcznie (dwie regresje i statystyka F), porównuje wynik z grangertest(), sprawdza rzędy 1–6 na poziomach i pierwszych różnicach i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Test Grangera ręcznie i w lmtest: rysunek 2
Kod R rysunku 2
# Clive Granger: test przyczynowości w sensie Grangera ręcznie i w lmtest (dane lmtest::ChickEgg)
suppressPackageStartupMessages({library(lmtest); library(ggplot2); library(patchwork)})
kol <- c(kury = "#0072B2", jaja = "#D55E00")                       # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(ChickEgg, package = "lmtest")
# chicken – liczba kur w USA 1 grudnia (bez brojlerów); egg – produkcja jaj w USA (mln tuzinów); lata 1930–1983
dane <- data.frame(rok = as.numeric(time(ChickEgg)),
                   kury = as.numeric(ChickEgg[, "chicken"]) / 1000,  # w tysiącach sztuk
                   jaja = as.numeric(ChickEgg[, "egg"]))
c(lata = range(dane$rok), n = nrow(dane))
round(sapply(dane[, -1], function(x) c(min = min(x), srednia = mean(x), max = max(x))), 1)

# 1. Test Grangera ręcznie: czy przeszłe x poprawiają prognozę y ponad przeszłe y?
opozn <- function(x, k) c(rep(NA, k), head(x, -k))
test_grangera <- function(y, x, p) {
  d <- data.frame(y = y)
  for (k in 1:p) { d[[paste0("y_", k)]] <- opozn(y, k); d[[paste0("x_", k)]] <- opozn(x, k) }
  d <- na.omit(d)
  m0 <- lm(reformulate(paste0("y_", 1:p), "y"), data = d)              # tylko przeszłość y
  m1 <- lm(reformulate(c(paste0("y_", 1:p), paste0("x_", 1:p)), "y"), data = d)
  rss0 <- sum(resid(m0)^2); rss1 <- sum(resid(m1)^2); df2 <- df.residual(m1)
  F <- ((rss0 - rss1) / p) / (rss1 / df2)
  c(n = nrow(d), RSS_bez_x = rss0, RSS_z_x = rss1, F = F, df1 = p, df2 = df2,
    p = pf(F, p, df2, lower.tail = FALSE))
}
reczny <- rbind(`kury -> jaja` = test_grangera(dane$jaja, dane$kury, 3),
                `jaja -> kury` = test_grangera(dane$kury, dane$jaja, 3))
round(reczny, 4)

# 2. To samo w lmtest::grangertest (rząd 3)
g1 <- grangertest(egg ~ chicken, order = 3, data = ChickEgg)
g2 <- grangertest(chicken ~ egg, order = 3, data = ChickEgg)
round(c(F_kury_jaja = g1$F[2], p_kury_jaja = g1$`Pr(>F)`[2],
        F_jaja_kury = g2$F[2], p_jaja_kury = g2$`Pr(>F)`[2]), 4)

# 3. Wrażliwość: rzędy 1–6, poziomy i pierwsze różnice
przyrosty <- diff(ChickEgg)
siatka <- expand.grid(rzad = 1:6, kierunek = c("kury -> jaja", "jaja -> kury"),
                      dane = c("poziomy", "pierwsze różnice"), stringsAsFactors = FALSE)
siatka$p <- mapply(function(r, k, s) {
  szereg <- if (s == "poziomy") ChickEgg else przyrosty
  wzor <- if (k == "kury -> jaja") egg ~ chicken else chicken ~ egg
  grangertest(wzor, order = r, data = szereg)$`Pr(>F)`[2]
}, siatka$rzad, siatka$kierunek, siatka$dane)
tabela <- reshape(siatka, idvar = c("kierunek", "dane"), timevar = "rzad", direction = "wide")
names(tabela) <- sub("p\\.", "rząd ", names(tabela))
tabela[, -(1:2)] <- round(tabela[, -(1:2)], 4)
print(tabela, row.names = FALSE)
c(istotne_p_05 = sum(siatka$p < .05), z = nrow(siatka))

# Rysunek: A – oba szeregi; B – wartości p testu Grangera według rzędu opóźnień
dl <- rbind(data.frame(rok = dane$rok, wartosc = dane$kury, szereg = "kury (tys. sztuk)"),
            data.frame(rok = dane$rok, wartosc = dane$jaja, szereg = "jaja (mln tuzinów)"))
pA <- ggplot(dl, aes(rok, wartosc, colour = szereg, shape = szereg)) +
  geom_line(linewidth = 0.8) + geom_point(size = 1.6) +
  facet_wrap(~ szereg, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = c(`kury (tys. sztuk)` = kol[["kury"]], `jaja (mln tuzinów)` = kol[["jaja"]]), guide = "none") +
  scale_shape_manual(values = c(`kury (tys. sztuk)` = 16, `jaja (mln tuzinów)` = 17), guide = "none") +
  labs(title = "A. Kury i jaja w USA, 1930–1983", x = NULL, y = NULL) +
  motyw
pB <- ggplot(siatka, aes(rzad, p, colour = kierunek, shape = kierunek, linetype = dane)) +
  geom_hline(yintercept = .05, colour = "grey40", linetype = "22") +
  annotate("text", x = 6, y = .062, label = "p = .05", hjust = 1, vjust = 0, size = 3.3, colour = "grey30") +
  geom_line(linewidth = 0.7) + geom_point(size = 2.4) +
  scale_y_log10(breaks = c(.0001, .001, .01, .05, .2, 1), labels = c(".0001", ".001", ".01", ".05", ".2", "1")) +
  scale_x_continuous(breaks = 1:6) +
  scale_colour_manual(values = c(`kury -> jaja` = kol[["kury"]], `jaja -> kury` = kol[["jaja"]]), name = NULL) +
  scale_shape_manual(values = c(`kury -> jaja` = 16, `jaja -> kury` = 17), name = NULL) +
  scale_linetype_manual(values = c(poziomy = "solid", `pierwsze różnice` = "42"), name = NULL) +
  labs(title = "B. Test Grangera: p według rzędu opóźnień", x = "Rząd opóźnień p", y = "Wartość p (skala log.)") +
  motyw + guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
lata1 lata2     n
 1930  1983    54
         kury   jaja
min     364.6 3081.0
srednia 419.5 4986.5
max     582.2 5836.0
              n  RSS_bez_x    RSS_z_x      F df1 df2      p
kury -> jaja 51 1162806.13 1117720.19 0.5916   3  44 0.6238
jaja -> kury 51   28825.09   21062.94 5.4050   3  44 0.0030
F_kury_jaja p_kury_jaja F_jaja_kury p_jaja_kury
     0.5916      0.6238      5.4050      0.0030
     kierunek             dane rząd 1 rząd 2 rząd 3 rząd 4 rząd 5 rząd 6
 kury -> jaja          poziomy 0.8292 0.4215 0.6238 0.8125 0.9131 0.8984
 jaja -> kury          poziomy 0.2772 0.0006 0.0030 0.0057 0.0019 0.0064
 kury -> jaja pierwsze różnice 0.4646 0.6816 0.8788 0.8881 0.8989 0.9295
 jaja -> kury pierwsze różnice 0.0023 0.0268 0.0441 0.0064 0.0208 0.0303
istotne_p_05            z
          11           24
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Clive W. J. Granger (1934–2009) – lata według Hendry'ego i Teräsvirty (2013) i dat publikacji
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1934, 1956, 1959, 1964, 1965, 1969, 1974, 1987, 2003, 2009),
  opis = c("urodził się\nw Swansea", "wykładowca statystyki\nw Nottingham", "doktorat o niestacjonarności;\nPrinceton (Tukey)",
           "książka o analizie\nspektralnej (z Hatanaką)", "profesor\nw Nottingham", "przyczynowość\n(Econometrica)",
           "regresja pozorna (z Newboldem);\nprzenosiny do UCSD", "kointegracja\n(z Engle'em)",
           "Nagroda Nobla\nz ekonomii; emerytura", "zmarł\nw San Diego"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "praca", "publikacja", "publikacja", "publikacja", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 0.5, -1.35, 1.3, -0.5, 0.5, -0.5, 0.5, -0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 1, 1, 0.5, 0.5, 0, 0, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1926, 2016), breaks = seq(1930, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.3, 2.3)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Grangera – funkcja grangertest() z pakietu lmtest, regresje – lm() z pakietu stats; dane – pakiet lmtest; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- zoo (wersja 1.8.15): Zeileis, A., & Grothendieck, G. (2005). zoo: S3 infrastructure for regular and irregular time series. Journal of Statistical Software, 14(6), 1–27. https://doi.org/10.18637/jss.v014.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Clive Granger?
Brytyjskim ekonometrykiem (1934–2009). Studiował matematykę w Nottingham, tam obronił doktorat o niestacjonarności szeregów (1959) i został profesorem (1965). Od 1974 r. do emerytury w 2003 r. pracował na University of California w San Diego. W 2003 r. otrzymał z Robertem Engle’em Nagrodę Nobla z ekonomii za metody analizy szeregów o wspólnych trendach (kointegracja).
Co to znaczy, że x jest przyczyną y w sensie Grangera?
Że przeszłe wartości x poprawiają prognozę y ponad to, co daje sama przeszłość y. Test porównuje regresję y na jej opóźnieniach z regresją, do której dodano opóźnienia x (test F). To przyczynowość predykcyjna – wynik może się zmienić po dodaniu innych zmiennych i nie dowodzi mechanizmu przyczynowego.
Czym jest regresja pozorna?
To regresja, w której dwa niezależne, ale niestacjonarne szeregi (np. dwa błądzenia losowe) dają „istotny” współczynnik i wysokie R². Granger i Newbold (1974) pokazali w symulacjach, jak często to się zdarza; sygnałem ostrzegawczym jest silna autokorelacja reszt.
Co było pierwsze: jajko czy kura – według testu Grangera?
W danych ChickEgg z pakietu lmtest, czyli w danych z USA z lat 1930–1983, przeszła produkcja jaj poprawia prognozę liczby kur (rząd 3: F(3, 44) = 5.41, p = .003), a odwrotnie nie (p = .62). To jednak tylko wniosek o prognozowaniu, wrażliwy na wybór liczby opóźnień – żartobliwa ilustracja, nie rozstrzygnięcie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikBadanie ceny: van Westendorp i Gabor–Granger
Abonament serwisu rowerowego: krzywe van Westendorpa z bootstrapem, popyt i przychód Gabora–Grangera, zakotwiczenie i deklaracje a zakupy – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Engle, R. F., & Granger, C. W. J. (1987). Co-integration and error correction: Representation, estimation, and testing. Econometrica, 55(2), 251. https://doi.org/10.2307/1913236 ● Otwarty dostęp: pełny tekst
- Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424–438. https://doi.org/10.2307/1912791
- Granger, C. W. J., & Newbold, P. (1974). Spurious regressions in econometrics. Journal of Econometrics, 2(2), 111–120. https://doi.org/10.1016/0304-4076(74)90034-7
- Hendry, D. F., & Teräsvirta, T. (2013). Clive William John Granger 1934–2009. Biographical Memoirs of Fellows of the British Academy, 12, 453–469. https://www.thebritishacademy.ac.uk/documents/1476/17_Granger.pdf ● Otwarty dostęp
- Thurman, W. N., & Fisher, M. E. (1988). Chickens, eggs, and causality, or which came first? American Journal of Agricultural Economics, 70(2), 237–238. https://doi.org/10.2307/1242062
Cytowania BibTeX
@article{engle1987cointegration, author={Engle, Robert F. and Granger, C. W. J.}, title={{Co-integration and error correction: Representation, estimation, and testing}}, journal={Econometrica}, year={1987}, volume={55}, number={2}, pages={251}, doi={10.2307/1913236}}@article{granger1969investigating, author={Granger, C. W. J.}, title={{Investigating causal relations by econometric models and cross-spectral methods}}, journal={Econometrica}, year={1969}, volume={37}, number={3}, pages={424--438}, doi={10.2307/1912791}}@article{granger1974spurious, author={Granger, C. W. J. and Newbold, Paul}, title={{Spurious regressions in econometrics}}, journal={Journal of Econometrics}, year={1974}, volume={2}, number={2}, pages={111--120}, doi={10.1016/0304-4076(74)90034-7}}@article{hendry2013clive, author={Hendry, David F. and Teräsvirta, Timo}, title={{Clive William John Granger 1934–2009}}, journal={Biographical Memoirs of Fellows of the British Academy}, year={2013}, volume={12}, pages={453--469}, publisher={The British Academy}, url={https://www.thebritishacademy.ac.uk/documents/1476/17_Granger.pdf}}@article{thurman1988chickens, author={Thurman, Walter N. and Fisher, Mark E.}, title={{Chickens, eggs, and causality, or which came first?}}, journal={American Journal of Agricultural Economics}, year={1988}, volume={70}, number={2}, pages={237--238}, doi={10.2307/1242062}}