Co to jest model VAR?
Model VAR (ang. vector autoregression, wektorowa autoregresja) opisuje kilka szeregów czasowych jednocześnie. Każda zmienna jest regresowana na własnych opóźnionych wartościach i na opóźnieniach wszystkich pozostałych zmiennych. Wszystkie zmienne traktuje się jako endogeniczne. Sims (1980) przekonywał, że ograniczenia identyfikujące duże modele makroekonomiczne są trudne do obrony, i zaproponował analizę w stylu, który się bez nich obywa. VAR jest wielowymiarowym odpowiednikiem modelu AR z rodziny ARIMA.
Jak działa
W modelu VAR(p) z k zmiennymi każde z k równań ma k·p współczynników przy opóźnieniach i wyraz wolny, więc liczba parametrów szybko rośnie. Rząd p wybiera się kryteriami informacyjnymi (AIC, HQ, SC/BIC). Szeregi powinny być stacjonarne; model jest stabilny, gdy moduły pierwiastków wielomianu charakterystycznego są mniejsze od 1. Z dopasowanego modelu wyprowadza się test przyczynowości w sensie Grangera, funkcje odpowiedzi impulsowej (jak szok w jednej zmiennej rozchodzi się w czasie) i dekompozycję wariancji błędu prognozy. Pfaff (2008) opisał implementację tych narzędzi w pakiecie vars.
Przykład
Zasymulowaliśmy 200 dni pomiaru nastroju i aktywności: wczorajszy nastrój wpływał na dzisiejszą aktywność, ale nie odwrotnie. Wszystkie cztery kryteria wskazały p = 1. Oszacowane równanie: aktywnośćt = 0.440·nastrójt−1 + 0.255·aktywnośćt−1; współczynnik aktywności w równaniu nastroju wyniósł −0.042 (p = .498). Moduły pierwiastków to 0.38, więc model jest stabilny. Test Grangera: nastrój → aktywność F(1, 392) = 51.22, p < .001; aktywność → nastrój F(1, 392) = 0.46, p = .497. Test portmanteau reszt: χ²(36) = 20.84, p = .980. Po pięciu dniach 24.6% wariancji błędu prognozy aktywności przypadało na szoki nastroju.
Na rysunku
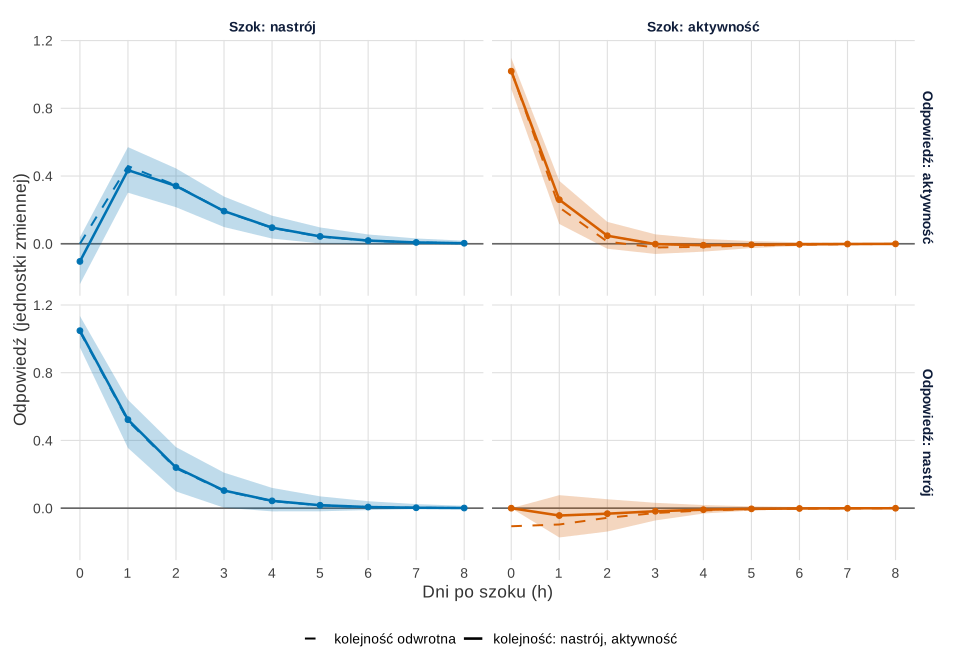
set.seed(6780), bootstrap set.seed(6781)).Co widać. Ten sam model co w przykładzie. Każdy panel pokazuje, o ile zmienia się jedna zmienna w kolejnych dniach po szoku drugiej (o jedno odchylenie standardowe reszt). Szok nastroju podnosi aktywność następnego dnia o 0.435 (95% pasmo: 0.301–0.571), a efekt wygasa – po czterech dniach wynosi 0.095 (0.031–0.166). Odpowiedź nastroju na szok aktywności jest bliska zera (dzień 1: −0.043, pasmo od −0.173 do 0.077), co zgadza się z testem Grangera. Pasma pochodzą z bootstrapu (1000 powtórzeń).
Na co uważać. Odpowiedzi w dniu 0 zależą od kolejności zmiennych w dekompozycji Choleskiego. Przy kolejności „nastrój, aktywność” szok aktywności nie może zmienić nastroju w tym samym dniu, a szok nastroju zmienia aktywność o −0.104; przy kolejności odwrotnej jest na odwrót (−0.107 dla nastroju, 0 dla aktywności). Ta wartość wynika tylko z korelacji reszt (−0.102) – w symulowanym procesie nie ma żadnego efektu jednoczesnego. Od dnia 1 krzywe dla odwrotnej kolejności mieszczą się w pasmach (np. 0.459 wobec 0.435 dla aktywności), bo korelacja reszt jest słaba; przy silnej różnice byłyby większe. Pasma są punktowe: nie mówią, jak niepewny jest kształt całej krzywej. Horyzont 8 dni, 1000 powtórzeń i poziom 95% ustaliliśmy ręcznie.
Podpis do pracy:
Ziarno set.seed(6780) to ziarno danych z przykładu, a set.seed(6781) – osobne ziarno bootstrapu; żadnego nie zmieniano. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Funkcje odpowiedzi impulsowej VAR(1) nastrój–aktywność z 95% pasmami bootstrapowymi (200 dni, dane symulowane)
suppressPackageStartupMessages({library(vars); library(ggplot2)})
kol <- c(nastroj = "#0072B2", aktywnosc = "#D55E00")    # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(6780)                                          # dane jak w przykładzie hasła
n <- 200
A <- matrix(c(0.5, 0.0,
              0.3, 0.4), 2, byrow = TRUE)
y <- matrix(0, n, 2, dimnames = list(NULL, c("nastroj", "aktywnosc")))
for (t in 2:n) y[t, ] <- A %*% y[t - 1, ] + rnorm(2)
m  <- VAR(y, p = 1, type = "const")
m2 <- VAR(y[, c("aktywnosc", "nastroj")], p = 1, type = "const")   # odwrotna kolejność zmiennych
set.seed(6781)                                          # bootstrap pasm (1000 powtórzeń)
ir  <- irf(m, n.ahead = 8, ortho = TRUE, boot = TRUE, runs = 1000, ci = 0.95)
ir2 <- irf(m2, n.ahead = 8, ortho = TRUE, boot = FALSE)
naz <- c(nastroj = "nastrój", aktywnosc = "aktywność")
d <- do.call(rbind, lapply(names(naz), function(imp) do.call(rbind, lapply(names(naz), function(odp)
  data.frame(h = 0:8, imp = paste("Szok:", naz[[imp]]), odp = paste("Odpowiedź:", naz[[odp]]),
             irf = ir$irf[[imp]][, odp], lo = ir$Lower[[imp]][, odp], hi = ir$Upper[[imp]][, odp],
             odwr = ir2$irf[[imp]][, odp], kolor = imp)))))
d$imp <- factor(d$imp, c("Szok: nastrój", "Szok: aktywność"))            # kolejność paneli
d$odp <- factor(d$odp, c("Odpowiedź: aktywność", "Odpowiedź: nastrój"))
round(cor(residuals(m))[1, 2], 3)                       # korelacja reszt: od niej zależy wpływ kolejności
with(subset(d, imp == "Szok: nastrój" & odp == "Odpowiedź: aktywność"),
     round(cbind(h, irf, lo, hi, odwr), 3)[1:5, ])
with(subset(d, imp == "Szok: aktywność" & odp == "Odpowiedź: nastrój"),
     round(cbind(h, irf, lo, hi, odwr), 3)[1:3, ])
p1 <- ggplot(d, aes(h)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = lo, ymax = hi, fill = kolor), alpha = 0.25, show.legend = FALSE) +
  geom_line(aes(y = irf, colour = kolor, linetype = "kolejność: nastrój, aktywność"), linewidth = 0.9) +
  geom_point(aes(y = irf, colour = kolor), size = 1.6, show.legend = FALSE) +
  geom_line(aes(y = odwr, colour = kolor, linetype = "kolejność odwrotna"), linewidth = 0.7) +
  facet_grid(odp ~ imp) +
  scale_colour_manual(values = kol, guide = "none") + scale_fill_manual(values = kol) +
  scale_linetype_manual(values = c("kolejność: nastrój, aktywność" = "solid", "kolejność odwrotna" = "dashed")) +
  scale_x_continuous(breaks = 0:8) +
  labs(x = "Dni po szoku (h)", y = "Odpowiedź (jednostki zmiennej)", linetype = NULL) + motyw
p1
Wynik w R (rysunek 1)
[1] -0.102
     h    irf     lo    hi  odwr
[1,] 0 -0.104 -0.238 0.038 0.000
[2,] 1  0.435  0.301 0.571 0.459
[3,] 2  0.341  0.216 0.445 0.344
[4,] 3  0.193  0.099 0.279 0.192
[5,] 4  0.095  0.031 0.166 0.094
     h    irf     lo    hi   odwr
[1,] 0  0.000  0.000 0.000 -0.107
[2,] 1 -0.043 -0.173 0.077 -0.096
[3,] 2 -0.032 -0.138 0.053 -0.057
Jak opisać w pracy
Na co uważać
- Kolejność zmiennych. Ortogonalne odpowiedzi impulsowe (dekompozycja Choleskiego) zależą od kolejności zmiennych; uzasadnij ją albo pokaż obie wersje.
- Szeregi niestacjonarne. Gdy szeregi są skointegrowane, VAR na samych różnicach pomija relację równowagi – rozważ model korekty błędem (kointegracja).
- Za dużo parametrów. Przy krótkich szeregach ogranicz liczbę zmiennych i opóźnień.
- Reszty. Sprawdź autokorelację reszt; jej obecność sugeruje zbyt małe p.
Model VAR w R
Kod symuluje dwa powiązane szeregi, wybiera liczbę opóźnień, dopasowuje VAR(1) funkcją vars::VAR(), sprawdza stabilność i reszty, testuje przyczynowość w sensie Grangera i liczy odpowiedź impulsową oraz dekompozycję wariancji. Liczby w tekście pochodzą z tego kodu.
VAR(1) dla nastroju i aktywności
R
suppressPackageStartupMessages(library(vars))
set.seed(6780)
n <- 200                                           # 200 dni pomiaru
A <- matrix(c(0.5, 0.0,                            # nastrój_t  = 0.5·nastrój_{t-1} + 0.0·aktywność_{t-1}
              0.3, 0.4), 2, byrow = TRUE)          # aktywność_t = 0.3·nastrój_{t-1} + 0.4·aktywność_{t-1}
y <- matrix(0, n, 2, dimnames = list(NULL, c("nastroj", "aktywnosc")))
for (t in 2:n) y[t, ] <- A %*% y[t - 1, ] + rnorm(2)
VARselect(y, lag.max = 6, type = "const")$selection   # wybór liczby opóźnień
m <- VAR(y, p = 1, type = "const")
round(t(sapply(coef(m), function(k) k[, "Estimate"])), 3)  # macierz współczynników
round(sapply(coef(m), function(k) k[, "Pr(>|t|)"]), 4)
roots(m)                                           # stabilność: moduły < 1
c1 <- causality(m, cause = "nastroj")$Granger
c2 <- causality(m, cause = "aktywnosc")$Granger
round(rbind(nastroj_do_aktywnosc = c(c1$statistic, c1$parameter, p = c1$p.value),
            aktywnosc_do_nastroj = c(c2$statistic, c2$parameter, p = c2$p.value)), 4)
serial.test(m, lags.pt = 10)$serial                # test portmanteau reszt
ir <- irf(m, impulse = "nastroj", response = "aktywnosc", n.ahead = 4, boot = FALSE)
round(ir$irf$nastroj, 3)                           # odpowiedź impulsowa (ortogonalna)
round(fevd(m, n.ahead = 5)$aktywnosc[5, ], 3)      # dekompozycja wariancji błędu prognozy
Wynik w R
AIC(n)  HQ(n)  SC(n) FPE(n)
     1      1      1      1
          nastroj.l1 aktywnosc.l1  const
nastroj        0.494       -0.042 -0.011
aktywnosc      0.440        0.255 -0.121
             nastroj aktywnosc
nastroj.l1    0.0000    0.0000
aktywnosc.l1  0.4975    0.0000
const         0.8862    0.1015
[1] 0.3807539 0.3807539
                      F-Test df1 df2      p
nastroj_do_aktywnosc 51.2212   1 392 0.0000
aktywnosc_do_nastroj  0.4619   1 392 0.4971

	Portmanteau Test (asymptotic)

data:  Residuals of VAR object m
Chi-squared = 20.841, df = 36, p-value = 0.9795

     aktywnosc
[1,]    -0.104
[2,]     0.435
[3,]     0.341
[4,]     0.193
[5,]     0.095
  nastroj aktywnosc
    0.246     0.754
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet vars 1.6.1). Rysunek 1 wykonano w pakiecie ggplot2 4.0.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- vars (wersja 1.6.1): Pfaff, B. (2008). VAR, SVAR and SVEC models: Implementation within R package vars. Journal of Statistical Software, 27(4). https://doi.org/10.18637/jss.v027.i04
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym model VAR różni się od zwykłego modelu autoregresyjnego?
Model AR opisuje jeden szereg jego własną przeszłością. VAR robi to dla kilku szeregów jednocześnie i w każdym równaniu dodaje opóźnienia pozostałych zmiennych, dzięki czemu widać, czy i jak zmienne wpływają na siebie w czasie.
Jak wybrać liczbę opóźnień w modelu VAR?
Dopasuj modele z 1, 2, … opóźnieniami i porównaj kryteria informacyjne (AIC, HQ, SC/BIC, FPE), np. funkcją vars::VARselect. Następnie sprawdź, czy reszty wybranego modelu nie są autoskorelowane; jeśli są, zwiększ liczbę opóźnień.
Czy odpowiedź impulsowa w modelu VAR pokazuje efekt przyczynowy?
Nie wprost. Ortogonalne odpowiedzi impulsowe zależą od przyjętej kolejności zmiennych, a model nie wyklucza wspólnych przyczyn spoza układu. Interpretacja przyczynowa wymaga dodatkowych założeń identyfikujących, jak w strukturalnym VAR (SVAR).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Pfaff, B. (2008). VAR, SVAR and SVEC models: Implementation within R package vars. Journal of Statistical Software, 27(4). https://doi.org/10.18637/jss.v027.i04 ● Otwarty dostęp
- Sims, C. A. (1980). Macroeconomics and reality. Econometrica, 48(1), 1–48. https://doi.org/10.2307/1912017
Cytowania BibTeX
@article{pfaff2008var, author={Pfaff, Bernhard}, title={{VAR, SVAR and SVEC models: Implementation within R package vars}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={4}, doi={10.18637/jss.v027.i04}}@article{sims1980macroeconomics, author={Sims, Christopher A.}, title={{Macroeconomics and reality}}, journal={Econometrica}, year={1980}, volume={48}, number={1}, pages={1--48}, doi={10.2307/1912017}}