Kim jest Karl G. Jöreskog?
Karl Gustav Jöreskog (ur. 1935) to szwedzki statystyk, twórca konfirmacyjnej analizy czynnikowej i – razem z Dagiem Sörbomem – programu LISREL. W latach 1955–1957 studiował matematykę i fizykę w Uppsali, a w 1963 r. obronił tam doktorat ze statystyki o estymacji w analizie czynnikowej; temat zaproponował mu Herman Wold. W latach 1964–1971 był statystykiem w Educational Testing Service (ETS) i profesorem wizytującym w Princeton. W 1971 r. wrócił do Uppsali jako profesor statystyki, a w latach 1984–2000 był tam profesorem badawczym wielowymiarowej analizy statystycznej (Modern Modeling Methods Conference, 2015).
W latach 1977–1978 przewodniczył Psychometric Society. Jest członkiem Szwedzkiej Królewskiej Akademii Nauk, fellow American Statistical Association i honorowym fellow Royal Statistical Society; ma doktoraty honorowe uczelni w Padwie, Bergen i Jenie (Modern Modeling Methods Conference, 2015). W 2000 r. otrzymał Nagrodę Sellsa Society of Multivariate Experimental Psychology (Society of Multivariate Experimental Psychology, b.d.).
Najważniejsze pomysły
- Największa wiarygodność w analizie czynnikowej (1967). Jöreskog (1967) podał metodę obliczania rozwiązania metodą największej wiarygodności, która radzi sobie z maksimum na brzegu przestrzeni parametrów – z zerowymi wariancjami swoistymi (przypadki Heywooda). Pokazał, że takie rozwiązania zdarzają się częściej, niż się sądzono.
- Konfirmacyjna analiza czynnikowa (1969). W „Psychometrice” opisał procedurę, w której dowolne parametry modelu czynnikowego ustala się z góry (np. ładunek równy zeru), a resztę szacuje metodą największej wiarygodności. Hipotezę sprawdza wielkopróbkowy test ilorazu wiarygodności χ², a z macierzy kowariancji estymatorów dostaje się przybliżone przedziały ufności (Jöreskog, 1969). To podstawa dzisiejszej CFA.
- Analiza struktur kowariancji (1970). W „Biometrice” uogólnił ten pomysł: średnie i macierz kowariancji mają dowolną postać parametryczną, a każdy parametr może być ustalony, wolny albo równy innemu (Jöreskog, 1970). Ta rama obejmuje m.in. modele ścieżkowe w duchu Sewalla Wrighta i modele równań strukturalnych.
- LISREL. Prace z ETS stały się podstawą modelu LISREL, przedstawionego po raz pierwszy w listopadzie 1970 r. na konferencji o modelach równań strukturalnych w Madison (Wisconsin); program o tej nazwie rozwijał z Sörbomem (Modern Modeling Methods Conference, 2015).
Ciekawostka
Gdy w 2001 r. „Biometrika” świętowała stulecie, wydano tom z dziesięcioma wybranymi szczególnie przełomowymi artykułami z jej pierwszych stu lat. Wśród nich znalazła się praca Jöreskoga z 1970 r. o analizie struktur kowariancji (Titterington i Cox, 2001).
W 2014 r. Uniwersytet w Uppsali nadał mu tytuł jubileuszowego doktora – w 50. rocznicę doktoratu. Rok później, na konferencji Modern Modeling Methods w Connecticut, wygłosił wykład zatytułowany 50 Years of SEM in 50 Minutes?? – pół wieku modelowania równań strukturalnych w niecałą godzinę (Modern Modeling Methods Conference, 2015).
Przykład na danych z pakietu R
Zbiór HolzingerSwineford1939 z pakietu lavaan to – według pliku pomocy – wyniki testów zdolności uczniów klas 7 i 8 z dwóch szkół (Pasteur i Grant-White) z badania Holzingera i Swineford z 1939 r. Z 26 testów pakiet zawiera 9 najczęściej używanych w literaturze – plik pomocy podaje, że tego podzbioru i 145 uczniów ze szkoły Grant-White użył właśnie Jöreskog (1969). Testy x1–x3 mierzą zdolności wzrokowo-przestrzenne, x4–x6 werbalne, x7–x9 szybkość. Nie powtarzamy tu analizy Jöreskoga; sprawdzamy trzy hipotezy, ustalając, które ładunki są zerami.
- M1 – jeden czynnik ogólny: χ²(27) = 182.41, CFI = .669, RMSEA = .199, SRMR = .144;
- M2 – czynnik werbalny i „niewerbalny” (wzrokowe + szybkość): χ²(26) = 86.71, CFI = .871, RMSEA = .127;
- M3 – trzy skorelowane czynniki: χ²(24) = 51.54, p = .001, CFI = .941, RMSEA = .089, SRMR = .072.
Modele są zagnieżdżone, więc porównuje je różnica χ²: M1 → M2: Δχ²(1) = 95.70, M2 → M3: Δχ²(2) = 35.17, oba p < .001; najniższe AIC ma M3 (3511.8). Funkcję dopasowania ML policzyliśmy też ręcznie: F = 0.3555, a 145 × F = 51.54 – dokładnie χ² z lavaan. Czynniki w M3 korelują od .34 (werbalny–szybkość) do .54 (wzrokowy–werbalny). Mimo wyraźnej poprawy test χ² nadal odrzuca M3 – o tym, czy to „mały” czy „duży” brak dopasowania, mówią dopiero miary w rodzaju RMSEA (zob. James H. Steiger).
Na rysunku
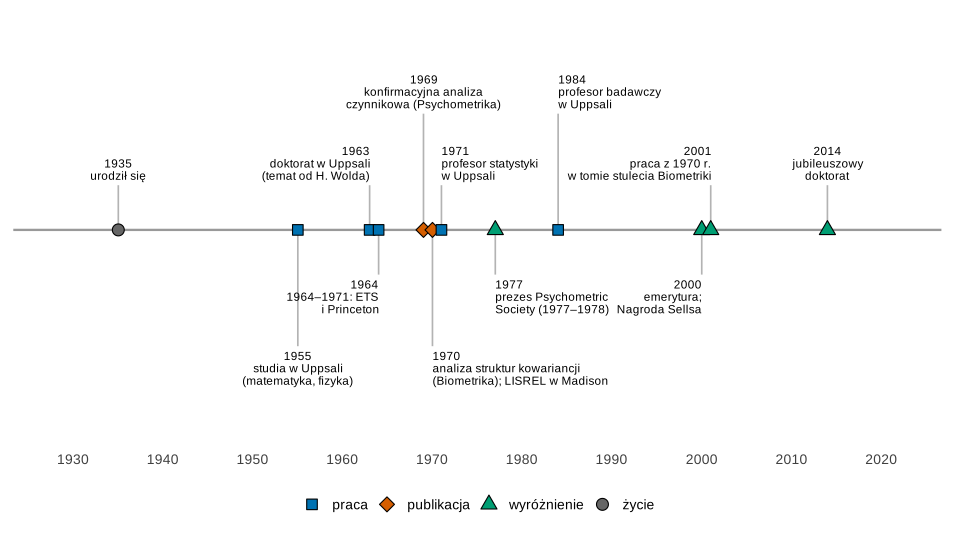
Co widać. Najważniejsze prace – o największej wiarygodności, CFA i strukturach kowariancji – powstały w ciągu siedmiu lat w ETS; potem długa kariera w Uppsali.
Na co uważać. Na osi są tylko zdarzenia zawodowe z cytowanych źródeł. Lat kolejnych wersji programu LISREL źródła nie podają, więc ich nie zaznaczamy.
Podpis do pracy:
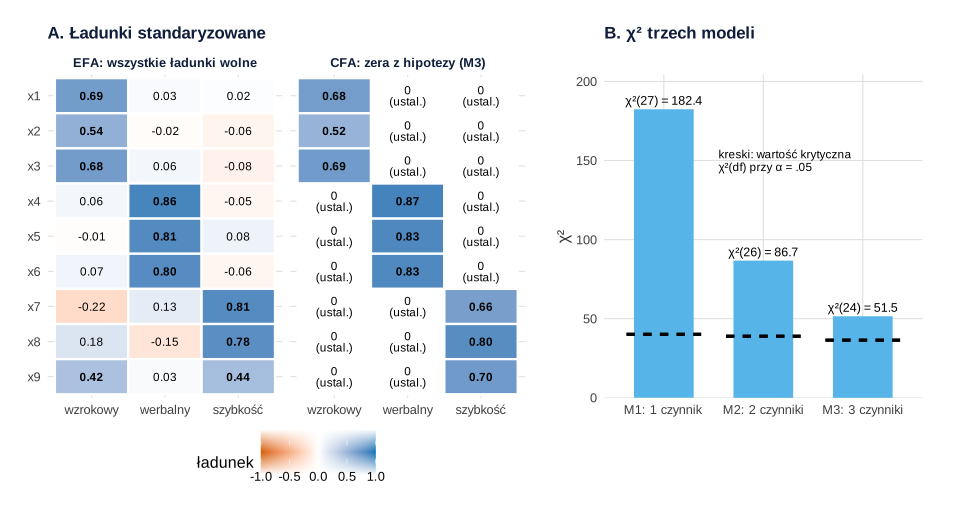
lavaan::HolzingerSwineford1939, szkoła Grant-White, N = 145. Obliczenia: R, pakiety lavaan i stats; rysunek: ggplot2 i patchwork (bez losowania).Co widać. Panel A pokazuje sedno pomysłu z 1969 r.: w EFA każdy test może ładować każdy czynnik, a w CFA badacz z góry wpisuje zera tam, gdzie hipoteza ich wymaga. Struktury są podobne, ale EFA zdradza, gdzie hipoteza jest za ciasna: test x9 ładuje prawie po równo czynnik wzrokowy i szybkość (ładunek krzyżowy .42). Panel B: każdy kolejny czynnik zmniejsza χ², ale żaden model nie schodzi poniżej wartości krytycznej.
Na co uważać. Po zobaczeniu takiego ładunku krzyżowego łatwo „uwolnić” go w CFA i ogłosić lepsze dopasowanie – ale to już modyfikacja na podstawie danych, a nie test hipotezy postawionej z góry (zob. indeksy modyfikacji).
Podpis do pracy:
Gdzie spotkasz Jöreskoga w swojej pracy
- W każdej CFA i każdym modelu SEM. Estymacja ML, test χ² modelu i błędy standardowe parametrów to wprost elementy z prac z lat 1967–1970; w R używasz ich przez lavaan – zob. CB-SEM w R (lavaan) i Analiza czynnikowa EFA i CFA.
- Przy rzetelności skali. Modele testów kongenerycznych, tau-równoważnych i równoległych szacuje się w tej samej ramie CFA – zob. model tau-ekwiwalentny a kongeneryczny.
- Przy porównywaniu modeli. Modele zagnieżdżone porównuj różnicą χ², niezagnieżdżone – kryteriami informacyjnymi; zanim zaczniesz, sprawdź identyfikację modelu.
Spory, mity i trudne strony
- „CFA potwierdza model”. Test χ² może model co najwyżej odrzucić; brak odrzucenia nie dowodzi, że model jest prawdziwy. Przy dużych próbach odrzuca nawet drobne niedopasowania, przy małych – przepuszcza poważne.
- Porównanie M1 i M2. Model jednoczynnikowy to dwuczynnikowy z korelacją czynników równą 1 – wartość na brzegu przestrzeni parametrów, więc zwykły rozkład χ² różnicy jest tu tylko przybliżeniem.
- Rozwiązania niewłaściwe. Ujemne lub zerowe wariancje swoiste (przypadki Heywooda) nie są rzadkością – Jöreskog (1967) pokazał, że zdarzają się częściej, niż sądzono. Raportuj je zamiast ukrywać.
- LISREL – program czy model? Nazwa oznacza zarówno model ogólny, jak i program; dziś te same modele szacuje się w wielu programach, także bezpłatnych.
Konfirmacyjna analiza czynnikowa Jöreskoga w R
Kod wczytuje dane Holzingera i Swineford, wybiera szkołę Grant-White, dopasowuje trzy modele CFA, liczy funkcję dopasowania ML ręcznie, porównuje modele testem ilorazu wiarygodności, zestawia ładunki EFA i CFA i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Trzy modele CFA, ręczne χ² i EFA: rysunek 2
Kod R rysunku 2
# Karl G. Jöreskog: konfirmacyjna analiza czynnikowa (ML) na danych Holzingera i Swineford – szkoła Grant-White
suppressPackageStartupMessages({library(lavaan); library(ggplot2); library(patchwork)})
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(HolzingerSwineford1939, package = "lavaan")
# 9 testów zdolności uczniów klas 7–8; jak u Jöreskoga (1969) bierzemy tylko szkołę Grant-White
gw <- subset(HolzingerSwineford1939, school == "Grant-White")
x <- gw[, paste0("x", 1:9)]
c(N = nrow(x), braki = sum(is.na(x)))
round(cor(x), 2)

# 1. Trzy hipotezy o strukturze: które ładunki są wolne, a które ustalone na zero
m1 <- 'g =~ x1 + x2 + x3 + x4 + x5 + x6 + x7 + x8 + x9'
m2 <- 'niewerbalny =~ x1 + x2 + x3 + x7 + x8 + x9
       werbalny    =~ x4 + x5 + x6'
m3 <- 'wzrokowy  =~ x1 + x2 + x3
       werbalny  =~ x4 + x5 + x6
       szybkosc  =~ x7 + x8 + x9'
dop <- lapply(list(M1 = m1, M2 = m2, M3 = m3), function(m) cfa(m, data = x, std.lv = TRUE))
round(t(sapply(dop, fitMeasures, c("npar", "chisq", "df", "pvalue", "cfi", "rmsea", "srmr", "aic"))), 3)

# 2. Funkcja dopasowania ML ręcznie dla M3: F = ln|Sigma| + tr(S Sigma^-1) - ln|S| - p, chi2 = N * F
S <- lavInspect(dop$M3, "sampstat")$cov; Sigma <- fitted(dop$M3)$cov; p <- ncol(S)
F_ML <- log(det(Sigma)) + sum(diag(S %*% solve(Sigma))) - log(det(S)) - p
round(c(F_ML = F_ML, chi2_recznie = nrow(x) * F_ML, chi2_lavaan = unname(fitMeasures(dop$M3, "chisq")),
        df = p * (p + 1) / 2 - unname(fitMeasures(dop$M3, "npar"))), 4)

# 3. Modele zagnieżdżone: test ilorazu wiarygodności (różnica chi-kwadrat)
lavTestLRT(dop$M1, dop$M2, dop$M3)
# korelacje czynników w M3
round(lavInspect(dop$M3, "std")$psi, 3)

# 4. Eksploracyjnie (wszystkie ładunki wolne, rotacja promax) vs konfirmacyjnie (zera z hipotezy)
efa <- factanal(x, factors = 3, rotation = "promax")
L_efa <- unclass(efa$loadings)
L_efa <- L_efa[, apply(abs(L_efa[c("x1", "x4", "x7"), ]), 1, which.max)]   # kolejność: wzrokowy, werbalny, szybkość
colnames(L_efa) <- c("wzrokowy", "werbalny", "szybkosc")
L_cfa <- lavInspect(dop$M3, "std")$lambda
L_obie <- cbind(L_efa, L_cfa)
colnames(L_obie) <- paste(rep(c("EFA", "CFA"), each = 3), colnames(L_efa), sep = "_")
round(L_obie, 2)
c(max_ladunek_krzyzowy_EFA = max(abs(L_efa[L_cfa == 0])))

# Rysunek: A – ładunki EFA i CFA; B – chi-kwadrat trzech modeli na tle wartości krytycznej
dl <- function(L, metoda) data.frame(test = rep(rownames(L), ncol(L)), czynnik = rep(colnames(L), each = nrow(L)),
                                     ladunek = as.vector(L), metoda = metoda)
lad <- rbind(dl(L_efa, "EFA: wszystkie ładunki wolne"), dl(L_cfa, "CFA: zera z hipotezy (M3)"))
lad$metoda <- factor(lad$metoda, levels = c("EFA: wszystkie ładunki wolne", "CFA: zera z hipotezy (M3)"))
lad$test <- factor(lad$test, levels = paste0("x", 9:1))
lad$czynnik <- factor(lad$czynnik, levels = c("wzrokowy", "werbalny", "szybkosc"), labels = c("wzrokowy", "werbalny", "szybkość"))
lad$ustalony <- lad$metoda == "CFA: zera z hipotezy (M3)" & lad$ladunek == 0
pA <- ggplot(lad, aes(czynnik, test, fill = ladunek)) +
  geom_tile(colour = "white", linewidth = 0.8) +
  geom_text(aes(label = ifelse(ustalony, "0\n(ustal.)", sprintf("%.2f", ladunek)),
                fontface = ifelse(abs(ladunek) >= 0.3, "bold", "plain")), size = 3.1, lineheight = 0.8) +
  facet_wrap(~ metoda) +
  scale_fill_gradient2(low = "#D55E00", mid = "white", high = "#0072B2", midpoint = 0, limits = c(-1, 1), name = "ładunek") +
  labs(title = "A. Ładunki standaryzowane", x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank())
dopas <- data.frame(model = factor(c("M1: 1 czynnik", "M2: 2 czynniki", "M3: 3 czynniki"),
                                   levels = c("M1: 1 czynnik", "M2: 2 czynniki", "M3: 3 czynniki")),
                    chi2 = sapply(dop, fitMeasures, "chisq"), df = sapply(dop, fitMeasures, "df"))
dopas$krytyczna <- qchisq(0.95, dopas$df)
pB <- ggplot(dopas, aes(model)) +
  geom_col(aes(y = chi2), fill = "#56B4E9", width = 0.6) +
  geom_errorbar(aes(ymin = krytyczna, ymax = krytyczna), width = 0.75, linewidth = 1.1, linetype = "22") +
  geom_text(aes(y = chi2, label = sprintf("χ²(%d) = %.1f", df, chi2)), vjust = -0.5, size = 3.3) +
  annotate("text", x = 1.55, y = 150, label = "kreski: wartość krytyczna\nχ²(df) przy α = .05",
           hjust = 0, vjust = 0.5, size = 3.1, lineheight = 0.9) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "B. χ² trzech modeli", x = NULL, y = "χ²") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.5, 1))
p2
Wynik w R
    N braki
  145     0
     x1   x2   x3   x4   x5   x6   x7   x8   x9
x1 1.00 0.33 0.45 0.34 0.31 0.32 0.10 0.31 0.49
x2 0.33 1.00 0.42 0.23 0.16 0.19 0.07 0.17 0.25
x3 0.45 0.42 1.00 0.33 0.29 0.35 0.07 0.24 0.37
x4 0.34 0.23 0.33 1.00 0.72 0.71 0.21 0.10 0.31
x5 0.31 0.16 0.29 0.72 1.00 0.69 0.25 0.20 0.36
x6 0.32 0.19 0.35 0.71 0.69 1.00 0.18 0.12 0.27
x7 0.10 0.07 0.07 0.21 0.25 0.18 1.00 0.59 0.42
x8 0.31 0.17 0.24 0.10 0.20 0.12 0.59 1.00 0.53
x9 0.49 0.25 0.37 0.31 0.36 0.27 0.42 0.53 1.00
   npar   chisq df pvalue   cfi rmsea  srmr      aic
M1   18 182.414 27  0.000 0.669 0.199 0.144 3636.650
M2   19  86.712 26  0.000 0.871 0.127 0.091 3542.947
M3   21  51.542 24  0.001 0.941 0.089 0.072 3511.778
        F_ML chi2_recznie  chi2_lavaan           df
      0.3555      51.5422      51.5422      24.0000

Chi-Squared Difference Test

       Df    AIC    BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
dop$M3 24 3511.8 3574.3  51.542
dop$M2 26 3542.9 3599.5  86.712     35.169 0.33820       2  2.307e-08 ***
dop$M1 27 3636.6 3690.2 182.414     95.702 0.80816       1  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
         wzrkwy wrblny szybks
wzrokowy  1.000
werbalny  0.541  1.000
szybkosc  0.523  0.336  1.000
   EFA_wzrokowy EFA_werbalny EFA_szybkosc CFA_wzrokowy CFA_werbalny
x1         0.69         0.03         0.02         0.68         0.00
x2         0.54        -0.02        -0.06         0.52         0.00
x3         0.68         0.06        -0.08         0.69         0.00
x4         0.06         0.86        -0.05         0.00         0.87
x5        -0.01         0.81         0.08         0.00         0.83
x6         0.07         0.80        -0.06         0.00         0.83
x7        -0.22         0.13         0.81         0.00         0.00
x8         0.18        -0.15         0.78         0.00         0.00
x9         0.42         0.03         0.44         0.00         0.00
   CFA_szybkosc
x1         0.00
x2         0.00
x3         0.00
x4         0.00
x5         0.00
x6         0.00
x7         0.66
x8         0.80
x9         0.70
max_ladunek_krzyzowy_EFA
               0.4200796
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Karl G. Jöreskog (ur. 1935) – lata według cytowanych źródeł (biogram M3 2015, SMEP, daty publikacji)
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1935, 1955, 1963, 1964, 1969, 1970, 1971, 1977, 1984, 2000, 2001, 2014),
  opis = c("urodził się", "studia w Uppsali\n(matematyka, fizyka)", "doktorat w Uppsali\n(temat od H. Wolda)",
           "1964–1971: ETS\ni Princeton", "konfirmacyjna analiza\nczynnikowa (Psychometrika)",
           "analiza struktur kowariancji\n(Biometrika); LISREL w Madison", "profesor statystyki\nw Uppsali",
           "prezes Psychometric\nSociety (1977–1978)", "profesor badawczy\nw Uppsali",
           "emerytura;\nNagroda Sellsa", "praca z 1970 r.\nw tomie stulecia Biometriki", "jubileuszowy\ndoktorat"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "publikacja", "praca", "wyróżnienie", "praca",
             "wyróżnienie", "wyróżnienie", "wyróżnienie"),
  poziom = c(0.5, -1.3, 0.5, -0.5, 1.3, -1.3, 0.5, -0.5, 1.3, -0.5, 0.5, 0.5),       # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 1, 1, 0.5, 0, 0, 0, 0, 1, 1, 0.5))                         # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1928, 2022), breaks = seq(1930, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele CFA, test różnicy χ² i dane – pakiet lavaan; eksploracyjna analiza czynnikowa – factanal() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Karl G. Jöreskog?
Szwedzkim statystykiem (ur. 1935). Doktoryzował się w Uppsali w 1963 r. na temat zaproponowany przez Hermana Wolda, w latach 1964–1971 pracował w Educational Testing Service i wykładał w Princeton, a potem był profesorem statystyki w Uppsali (do emerytury w 2000 r.). Jest twórcą konfirmacyjnej analizy czynnikowej i współautorem programu LISREL.
Czym konfirmacyjna analiza czynnikowa Jöreskoga różni się od eksploracyjnej?
W eksploracyjnej każdy test może ładować każdy czynnik, a strukturę porządkuje rotacja. W konfirmacyjnej badacz z góry ustala część parametrów – zwykle ładunki równe zeru – a pozostałe szacuje metodą największej wiarygodności i testem χ² sprawdza, czy taka hipoteza zgadza się z danymi.
Co oznacza nazwa LISREL?
To skrót od linear structural relations – ogólnego modelu liniowych relacji strukturalnych między zmiennymi latentnymi i obserwowanymi oraz programu do jego szacowania, który Jöreskog rozwijał z Dagiem Sörbomem. Model przedstawiono po raz pierwszy w listopadzie 1970 r. na konferencji w Madison.
Jakie dane analizował Jöreskog w pracy z 1969 r.?
Według pliku pomocy pakietu lavaan – dziewięć testów zdolności z badania Holzingera i Swineford (1939), tylko 145 uczniów ze szkoły Grant-White. Na tych danych model trzech skorelowanych czynników daje χ²(24) = 51.54, CFI = .941 i RMSEA = .089 – wyraźnie lepiej niż model jedno- i dwuczynnikowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jöreskog, K. G. (1967). Some contributions to maximum likelihood factor analysis. Psychometrika, 32(4), 443–482. https://doi.org/10.1007/bf02289658
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- Jöreskog, K. G. (1970). A general method for analysis of covariance structures. Biometrika, 57(2), 239–251. https://doi.org/10.1093/biomet/57.2.239
- Modern Modeling Methods Conference. (2015). Karl Jöreskog [biogram prelegenta]. Neag School of Education, University of Connecticut. https://modeling.uconn.edu/?p=108 ● Otwarty dostęp
- Society of Multivariate Experimental Psychology. (b.d.). Sells Award for Distinguished Multivariate Research. Pobrano 20 listopada 2026 z https://smep.org/?p=222 ● Otwarty dostęp
- Titterington, D. M., & Cox, D. R. (Eds.). (2001). Biometrika: One hundred years. Oxford University Press. https://doi.org/10.1093/oso/9780198509936.001.0001
Cytowania BibTeX
@article{joreskog1967some, author={Jöreskog, Karl G.}, title={{Some contributions to maximum likelihood factor analysis}}, journal={Psychometrika}, year={1967}, volume={32}, number={4}, pages={443--482}, doi={10.1007/bf02289658}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{joreskog1970general, author={Jöreskog, Karl G.}, title={{A general method for analysis of covariance structures}}, journal={Biometrika}, year={1970}, volume={57}, number={2}, pages={239--251}, doi={10.1093/biomet/57.2.239}}@misc{m3joreskog2015, author={{Modern Modeling Methods Conference}}, title={{Karl Jöreskog [biogram prelegenta]}}, year={2015}, publisher={Neag School of Education, University of Connecticut}, url={https://modeling.uconn.edu/?p=108}}@misc{smepsellsaward, author={{Society of Multivariate Experimental Psychology}}, title={{Sells Award for Distinguished Multivariate Research}}, url={https://smep.org/?p=222}}@book{titterington2001biometrika, author={Titterington, D. M. and Cox, D. R.}, title={{Biometrika: One hundred years}}, year={2001}, publisher={Oxford University Press}, doi={10.1093/oso/9780198509936.001.0001}}