Kim jest James H. Steiger?
James H. Steiger to amerykański psychometra, dziś profesor emerytowany psychologii i rozwoju człowieka w Vanderbilt University. Doktorat uzyskał w 1976 r. w Purdue University. Przez wiele lat pracował w University of British Columbia w Vancouver – z tą afiliacją ukazały się zarówno jego przegląd testów dla korelacji z 1980 r., jak i polemika o RMSEA z 2000 r. (Steiger, 1980, 2000). Za wkład w wielowymiarowe metody statystyczne dostał Nagrodę Killama tej uczelni, a także nagrodę im. Samuela J. Messicka Wydziału 5 Amerykańskiego Towarzystwa Psychologicznego i nagrodę im. Raymonda B. Cattella Society of Multivariate Experimental Psychology (Vanderbilt University, b.d.). W 2015 r. to samo towarzystwo przyznało mu Nagrodę Sellsa za wybitne badania wielowymiarowe (wcześniej m.in. Karl Jöreskog; Society of Multivariate Experimental Psychology, b.d.).
Jego obszar to wielowymiarowe metody korelacyjne: analiza czynnikowa i modelowanie równań strukturalnych, porównywanie korelacji, analiza mocy i precyzji, przedziały ufności i testy „bliskiego” dopasowania, a także oprogramowanie statystyczne (Vanderbilt University, b.d.).
Najważniejsze pomysły
- Porównywanie korelacji z tej samej próby (1980). W „Psychological Bulletin” Steiger (1980) przejrzał testy do porównywania elementów jednej macierzy korelacji – np. czy dwa predyktory korelują z kryterium równie silnie – wskazał statystyki, których należy unikać, i przedstawił metody bezpieczne przy średnich i dużych próbach. Stąd nazwa testu Steigera.
- RMSEA (1980). Z J. C. Lindem zaproponował pierwiastek ze średniego kwadratu błędu aproksymacji – RMSEA. Indeks mierzy, jak źle model pasowałby w populacji w przeliczeniu na stopień swobody, zamiast pytać, czy pasuje idealnie; spopularyzowali go Browne i Cudeck (Chen i in., 2008).
- Przedziały zamiast progów (1990). W „Multivariate Behavioral Research” Steiger (1990) przeniósł ocenę i modyfikację modeli strukturalnych na grunt estymacji przedziałowej. Dziś RMSEA podaje się zwykle z 90-procentowym przedziałem ufności, który programy liczą z niecentralnego rozkładu chi-kwadrat.
- Poza testem F. To samo podejście – przedziały ufności dla wielkości efektu i testy bliskiego dopasowania zamiast samego p – przeniósł na analizę wariancji w artykule Beyond the F test (2004) (Vanderbilt University, b.d.).
Ciekawostka
Jeden z najczęściej raportowanych indeksów dopasowania nie zadebiutował w czasopiśmie. Praca, na którą powołują się autorzy przy RMSEA – Steiger i Lind (1980) – to w bibliografiach referat wygłoszony w maju 1980 r. na dorocznym spotkaniu Psychometric Society w Iowa City, zatytułowany „Statistically based tests for the number of common factors”, czyli dotyczący liczby czynników w analizie czynnikowej. Szeroko znany stał się indeks dopiero wtedy, gdy spopularyzowali go Browne i Cudeck (Chen i in., 2008).
Dwie prace z 1980 r. dały więc jego nazwisko dwóm różnym narzędziom: testowi dla korelacji zależnych i indeksowi z niemal każdej tabeli wyników CFA.
Przykład na danych z pakietu R
Zbiór cattell z pakietu psych to – według pliku pomocy – macierz korelacji 12 testów zdolności u 277 uczniów klas 7 i 8: osiem testów Thurstone’a (werbalne, przestrzenne, rozumowania i liczbowe, po dwa) i cztery testy IPAT „wolne od kultury”. Pochodzą z pracy Raymonda Cattella z 1963 r. o inteligencji płynnej i skrystalizowanej; korelacje są zaokrąglone do dwóch miejsc.
Test Steigera ręcznie. Pytanie: czy test matryc IPAT koreluje silniej z drugim testem IPAT (serie; r = .45) niż z testem werbalnym (r = .33)? Seria i test werbalny korelują ze sobą (r = .29). Po transformacji Fishera z i uwzględnieniu zależności (szacowana korelacja między dwoma z wynosi .216) statystyka Steigera to Z = 1.88, p = .061. Test Williamsa z funkcji r.test() daje praktycznie to samo: t(274) = 1.88, p = .061. Gdyby potraktować obie korelacje jak niezależne, wyszłoby Z = 1.66, p = .097.
RMSEA i jego przedział. Na tej samej macierzy dopasowaliśmy trzy modele CFA: M1 – jeden czynnik ogólny, M2 – dwa czynniki (testy Thurstone’a i testy IPAT), M3 – pięć skorelowanych czynników (cztery zdolności Thurstone’a i IPAT). RMSEA i 90% przedział policzyliśmy ręcznie, szukając parametru niecentralności, przy którym zaobserwowane χ² wypada w 5. i 95. centylu, i porównaliśmy z lavaan (różnica poniżej 0.00000001).
- M1: χ²(54) = 839.27, RMSEA = .229 [.216; .243], CFI = .503;
- M2: χ²(53) = 757.83, RMSEA = .219 [.205; .233], CFI = .554;
- M3: χ²(44) = 48.61, p = .293, RMSEA = .019 [.000; .046], CFI = .997, SRMR = .026; test bliskiego dopasowania (H0: RMSEA ≤ .05) p = .975.
Na rysunku
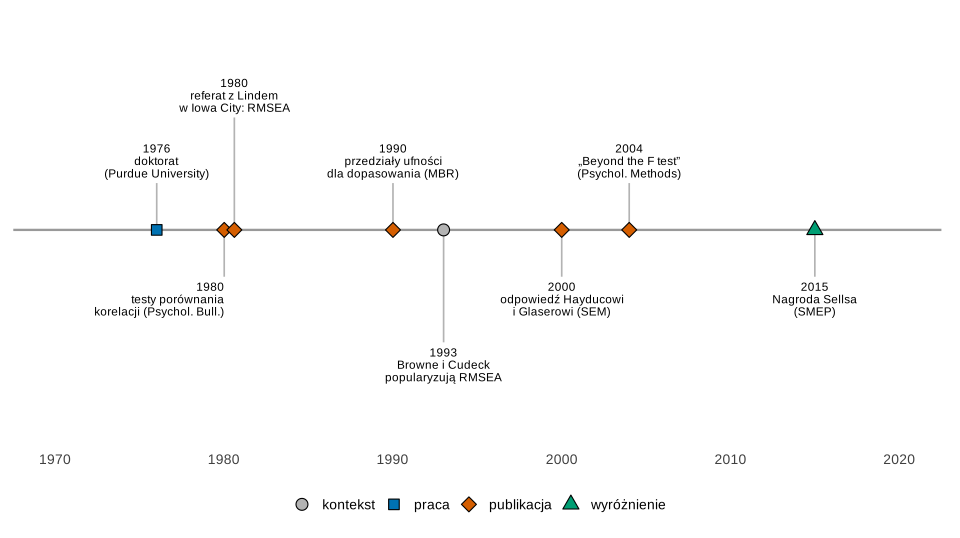
Co widać. Dwa pomysły z 1980 r. i dekadę później – przedziały ufności.
Na co uważać. Na osi są tylko daty potwierdzone w cytowanych źródłach; lat pracy w Vancouver i przejścia do Vanderbilt źródła nie podają, a rok 1993 dotyczy pracy Browne’a i Cudecka, nie Steigera.
Podpis do pracy:
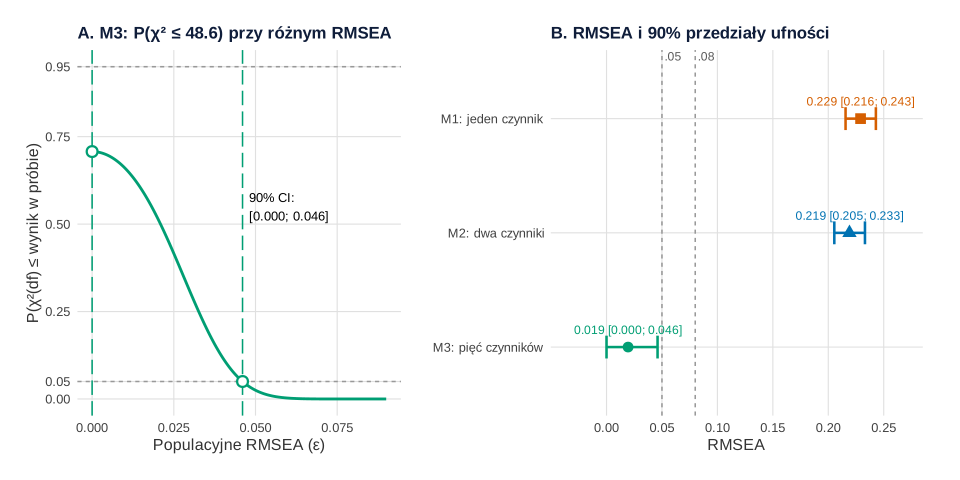
psych::cattell, N = 277. Obliczenia: R, pakiet lavaan; rysunek: pakiety ggplot2 i patchwork (bez losowania).Co widać. Panel A pokazuje mechanizm z pracy Steigera (1990): przesuwamy populacyjne RMSEA i sprawdzamy, jak prawdopodobny byłby wynik χ² z próby. Dla M3 nawet przy idealnym dopasowaniu (RMSEA = 0) wynosi tylko około .71 (= 1 − .29, czyli 1 minus p testu χ²), więc dolną granicą jest zero. Panel B: podział „Thurstone kontra IPAT” (M2) prawie nic nie poprawia; dopiero pięć czynników daje przedział w całości poniżej .05.
Na co uważać. Linie .05 i .08 to umowne punkty odniesienia, a nie granice „dobrego” modelu – ich autorzy sami nazywali je subiektywnymi, a w symulacjach stałe progi źle się sprawdzają (Chen i in., 2008).
Podpis do pracy:
Gdzie spotkasz Steigera w swojej pracy
- W każdej tabeli dopasowania SEM i CFA. Raportuj RMSEA z 90% przedziałem ufności obok χ², CFI i SRMR.
- Przy porównywaniu korelacji. Gdy dwie korelacje pochodzą od tych samych osób (np. dwa predyktory i jedno kryterium), użyj testu dla korelacji zależnych, nie testu dla grup niezależnych – zob. Jak porównać dwie korelacje?
- Przy planowaniu próby. Myślenie o niecentralności, które stoi za przedziałem RMSEA, wraca w analizie mocy przez parametr niecentralności.
Spory, mity i trudne strony
- Progi .05 i .08. Wartości te zaproponowali Browne i Cudeck, a zarówno oni, jak i Steiger, ostrzegali, że są subiektywne. Chen i in. (2008) nie znaleźli empirycznego uzasadnienia dla żadnego uniwersalnego progu – także dla granic przedziału.
- Spór z Haydukiem i Glaserem. Według Steigera (2000) Hayduk i Glaser zarzucili estymatorowi RMSEA, że wartość docelowa .05 nie jest stała, a obcinanie ujemnych oszacowań do zera wyrzuca część informacji. Steiger (2000) odpowiedział, że pierwszy zarzut wynika z błędnego założenia, przed którym sam wcześniej ostrzegał, a drugi – z własności dobrego estymatora, bez praktycznych skutków.
- „Istotna i nieistotna” to nie różnica. Częsty błąd przy korelacjach: to, że jedna korelacja jest istotna, a druga nie, nie znaczy, że różnią się między sobą – trzeba to sprawdzić jednym testem.
Test Steigera i przedział RMSEA w R
Kod wczytuje macierz korelacji cattell, liczy test Steigera dla dwóch korelacji ze wspólną zmienną ręcznie i funkcją r.test(), dopasowuje trzy modele CFA, wyznacza RMSEA i 90% przedział z niecentralnego rozkładu χ² i porównuje je z lavaan, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Test Steigera i RMSEA ręcznie: rysunek 2
Kod R rysunku 2
# James H. Steiger: test korelacji zależnych i przedział ufności RMSEA liczone ręcznie (psych::cattell)
suppressPackageStartupMessages({library(lavaan); library(ggplot2); library(patchwork)})
kol <- c(M1 = "#D55E00", M2 = "#0072B2", M3 = "#009E73", tlo = "grey60")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(cattell, package = "psych")
# macierz korelacji 12 testów zdolności: 8 testów Thurstone'a i 4 testy „wolne od kultury” IPAT; 277 uczniów klas 7–8
R <- cattell; N <- 277
round(R[c("IPATMatr", "IPATSer", "Verbal"), c("IPATMatr", "IPATSer", "Verbal")], 3)

# 1. Test Steigera (1980) dla dwóch korelacji ze wspólną zmienną:
#    czy test matryc IPAT koreluje silniej z drugim testem IPAT (serie) niż z testem werbalnym?
r_jk <- R["IPATMatr", "IPATSer"]; r_jh <- R["IPATMatr", "Verbal"]; r_kh <- R["IPATSer", "Verbal"]
z_jk <- atanh(r_jk); z_jh <- atanh(r_jh)                  # transformacja Fishera z
r_sr <- (r_jk + r_jh) / 2                                  # uśredniona korelacja przy H0: rho_jk = rho_jh
psi <- r_kh * (1 - 2 * r_sr^2) - 0.5 * r_sr^2 * (1 - 2 * r_sr^2 - r_kh^2)
s_sr <- psi / (1 - r_sr^2)^2                               # korelacja między z_jk i z_jh
Z <- (z_jk - z_jh) * sqrt(N - 3) / sqrt(2 - 2 * s_sr)
round(c(r_jk = r_jk, r_jh = r_jh, r_kh = r_kh, roznica = r_jk - r_jh, s_sr = s_sr,
        Z = Z, p = 2 * pnorm(-abs(Z))), 4)
# dla porównania: test Williamsa z pakietu psych (ta sama trójka korelacji)
w <- psych::r.test(N, r12 = r_jk, r13 = r_jh, r23 = r_kh)
round(c(t_Williams = w$t, df = N - 3, p = w$p), 4)
# błąd, przed którym przestrzegał Steiger: test dla grup niezależnych pomija zależność korelacji
Z_niezal <- (z_jk - z_jh) / sqrt(2 / (N - 3))
round(c(Z_jak_dla_niezaleznych = Z_niezal, p = 2 * pnorm(-abs(Z_niezal))), 4)

# 2. Trzy modele CFA na tej samej macierzy (estymacja ML, lavaan)
m1 <- 'g =~ Verbal + Verbal2 + Space1 + Space2 + Reason1 + Reason2 + Number1 + Number2 +
            IPATSer + IPATCLAS + IPATMatr + IPATTOP'
m2 <- 'Thurstone =~ Verbal + Verbal2 + Space1 + Space2 + Reason1 + Reason2 + Number1 + Number2
       IPAT =~ IPATSer + IPATCLAS + IPATMatr + IPATTOP'
m3 <- 'werbalny =~ Verbal + Verbal2;  przestrzenny =~ Space1 + Space2
       rozumowanie =~ Reason1 + Reason2;  liczbowy =~ Number1 + Number2
       IPAT =~ IPATSer + IPATCLAS + IPATMatr + IPATTOP'
modele <- list(M1 = m1, M2 = m2, M3 = m3)
dop <- lapply(modele, function(m) cfa(m, sample.cov = R, sample.nobs = N, std.lv = TRUE))

# 3. RMSEA ręcznie: estymator punktowy i 90% przedział z niecentralnego rozkładu chi-kwadrat
rmsea_recznie <- function(chi2, df, N, poziom = 0.90) {   # lavaan liczy chi2 = N * F_ML, więc w mianowniku N
  a <- (1 - poziom) / 2
  lambda_dla <- function(cel) {                            # parametr niecentralności, przy którym P(X <= chi2) = cel
    if (pchisq(chi2, df, ncp = 0) < cel) return(0)
    uniroot(function(l) pchisq(chi2, df, ncp = l) - cel, c(0, 10 * chi2 + 100), tol = 1e-10)$root
  }
  c(chi2 = chi2, df = df,
    RMSEA = sqrt(max(chi2 - df, 0) / (df * N)),
    dolna = sqrt(lambda_dla(1 - a) / (df * N)),
    gorna = sqrt(lambda_dla(a) / (df * N)))
}
wyniki <- t(sapply(dop, function(f) {
  m <- fitMeasures(f, c("chisq", "df", "pvalue", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "rmsea.pvalue", "cfi", "srmr"))
  c(rmsea_recznie(m[["chisq"]], m[["df"]], N),
    p_chi2 = m[["pvalue"]], lavaan_RMSEA = m[["rmsea"]], lavaan_dolna = m[["rmsea.ci.lower"]], lavaan_gorna = m[["rmsea.ci.upper"]],
    p_bliskie = m[["rmsea.pvalue"]], CFI = m[["cfi"]], SRMR = m[["srmr"]])
}))
round(wyniki, 4)
# różnice ręcznie vs lavaan
c(max_roznica = max(abs(wyniki[, c("RMSEA", "dolna", "gorna")] - wyniki[, c("lavaan_RMSEA", "lavaan_dolna", "lavaan_gorna")])))
# test bliskiego dopasowania (H0: RMSEA <= .05) ręcznie dla M3
lambda05 <- 0.05^2 * wyniki["M3", "df"] * N
round(c(p_bliskie_recznie = pchisq(wyniki["M3", "chi2"], wyniki["M3", "df"], ncp = lambda05, lower.tail = FALSE)), 4)

# Rysunek: A – jak powstają granice przedziału dla M3; B – RMSEA i 90% przedziały trzech modeli
chi2_3 <- wyniki["M3", "chi2"]; df_3 <- wyniki["M3", "df"]
siatka <- data.frame(eps = seq(0, 0.09, by = 0.0005))
siatka$P <- pchisq(chi2_3, df_3, ncp = siatka$eps^2 * df_3 * N)
pA <- ggplot(siatka, aes(eps, P)) +
  geom_hline(yintercept = c(0.05, 0.95), linetype = "22", colour = kol[["tlo"]]) +
  geom_line(linewidth = 1, colour = kol[["M3"]]) +
  geom_vline(xintercept = wyniki["M3", c("dolna", "gorna")], colour = kol[["M3"]], linetype = "longdash") +
  geom_point(data = data.frame(eps = wyniki["M3", c("dolna", "gorna")],
                               P = pchisq(chi2_3, df_3, ncp = wyniki["M3", c("dolna", "gorna")]^2 * df_3 * N)), size = 3, shape = 21,
             fill = "white", colour = kol[["M3"]], stroke = 1.2) +
  annotate("text", x = wyniki["M3", "gorna"] + 0.002, y = 0.55, hjust = 0, size = 3.4,
           label = sprintf("90%% CI:\n[%.3f; %.3f]", wyniki["M3", "dolna"], wyniki["M3", "gorna"])) +
  scale_y_continuous(breaks = c(0, 0.05, 0.25, 0.5, 0.75, 0.95, 1)) +
  labs(title = sprintf("A. M3: P(χ² ≤ %.1f) przy różnym RMSEA", chi2_3),
       x = "Populacyjne RMSEA (ε)", y = "P(χ²(df) ≤ wynik w próbie)") +
  motyw
przedzialy <- data.frame(model = factor(c("M1: jeden czynnik", "M2: dwa czynniki", "M3: pięć czynników"),
                                        levels = rev(c("M1: jeden czynnik", "M2: dwa czynniki", "M3: pięć czynników"))),
                         klucz = rownames(wyniki), RMSEA = wyniki[, "RMSEA"], dolna = wyniki[, "dolna"], gorna = wyniki[, "gorna"])
pB <- ggplot(przedzialy, aes(RMSEA, model, colour = klucz, shape = klucz)) +
  geom_vline(xintercept = c(0.05, 0.08), linetype = "22", colour = kol[["tlo"]]) +
  annotate("text", x = c(0.05, 0.08), y = Inf, vjust = 1.2, hjust = -0.15, label = c(".05", ".08"), size = 3.2, colour = "grey35") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.4) +
  geom_text(aes(label = sprintf("%.3f [%.3f; %.3f]", RMSEA, dolna, gorna)), vjust = -1.5, size = 3.2, show.legend = FALSE) +
  scale_colour_manual(values = kol[c("M1", "M2", "M3")], guide = "none") +
  scale_shape_manual(values = c(M1 = 15, M2 = 17, M3 = 16), guide = "none") +
  scale_x_continuous(limits = c(-0.035, 0.27), breaks = seq(0, 0.25, by = 0.05)) +
  labs(title = "B. RMSEA i 90% przedziały ufności", x = "RMSEA", y = NULL) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
         IPATMatr IPATSer Verbal
IPATMatr     1.00    0.45   0.33
IPATSer      0.45    1.00   0.29
Verbal       0.33    0.29   1.00
   r_jk    r_jh    r_kh roznica    s_sr       Z       p
 0.4500  0.3300  0.2900  0.1200  0.2160  1.8754  0.0607
t_Williams         df          p
    1.8831   274.0000     0.0607
Z_jak_dla_niezaleznych                      p
                1.6606                 0.0968
       chi2 df  RMSEA  dolna  gorna p_chi2 lavaan_RMSEA lavaan_dolna
M1 839.2682 54 0.2291 0.2156 0.2429 0.0000       0.2291       0.2156
M2 757.8293 53 0.2191 0.2054 0.2331 0.0000       0.2191       0.2054
M3  48.6086 44 0.0194 0.0000 0.0460 0.2927       0.0194       0.0000
   lavaan_gorna p_bliskie    CFI   SRMR
M1       0.2429     0.000 0.5033 0.1211
M2       0.2331     0.000 0.5542 0.1343
M3       0.0460     0.975 0.9971 0.0264
 max_roznica
4.451241e-09
p_bliskie_recznie
            0.975
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: James H. Steiger – lata według cytowanych źródeł (strona Vanderbilt, SMEP, Chen i in. 2008, daty publikacji)
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1976, 1980, 1980.6, 1990, 1993, 2000, 2004, 2015),
  opis = c("doktorat\n(Purdue University)", "testy porównania\nkorelacji (Psychol. Bull.)",
           "referat z Lindem\nw Iowa City: RMSEA", "przedziały ufności\ndla dopasowania (MBR)",
           "Browne i Cudeck\npopularyzują RMSEA", "odpowiedź Hayducowi\ni Glaserowi (SEM)",
           "„Beyond the F test”\n(Psychol. Methods)", "Nagroda Sellsa\n(SMEP)"),
  rodzaj = c("praca", "publikacja", "publikacja", "publikacja", "kontekst", "publikacja", "publikacja", "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.2, 0.5, -1.2, -0.5, 0.5, -0.5),      # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 1, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(floor(zdarzenia$rok), "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24, "kontekst" = 21)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73", "kontekst" = "grey70")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1970, 2020), breaks = seq(1970, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele CFA i miary dopasowania – pakiet lavaan; test Williamsa – funkcja r.test() z pakietu psych, z którego pochodzą też dane; niecentralny rozkład χ² i uniroot() – pakiet stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest James H. Steiger?
Amerykańskim psychometrą, profesorem emerytowanym psychologii i rozwoju człowieka w Vanderbilt University; doktorat uzyskał w Purdue University w 1976 r., wcześniej długo pracował w University of British Columbia. Zajmuje się analizą czynnikową, modelowaniem równań strukturalnych, porównywaniem korelacji oraz przedziałami ufności i testami bliskiego dopasowania. W 2015 r. dostał Nagrodę Sellsa SMEP.
Kto wymyślił RMSEA i skąd te progi .05 i .08?
RMSEA zaproponowali James H. Steiger i J. C. Lind w referacie na spotkaniu Psychometric Society w Iowa City w 1980 r.; spopularyzowali go Browne i Cudeck. To oni podali orientacyjne wartości około .05 (bliskie dopasowanie) i .08 (rozsądny błąd aproksymacji), zaznaczając, że są subiektywne – nie są to granice wyznaczone empirycznie.
Jak policzyć przedział ufności RMSEA?
Z niecentralnego rozkładu chi-kwadrat: szuka się parametru niecentralności, przy którym zaobserwowane χ² wypada w 95. i w 5. centylu, i przelicza go na RMSEA. Jeśli nawet przy idealnym dopasowaniu χ² nie jest tak duże, dolna granica wynosi 0 – tak było w przykładzie dla modelu pięcioczynnikowego: RMSEA = .019 [.000; .046].
Czym test Steigera różni się od zwykłego porównania dwóch korelacji?
Uwzględnia, że obie korelacje policzono na tych samych osobach, więc są ze sobą skorelowane – potrzebna jest do tego trzecia korelacja, między porównywanymi zmiennymi. W przykładzie na danych Cattella test Steigera dał Z = 1.88, p = .061, a test dla korelacji niezależnych – Z = 1.66, p = .097.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chen, F., Curran, P. J., Bollen, K. A., Kirby, J., & Paxton, P. (2008). An empirical evaluation of the use of fixed cutoff points in RMSEA test statistic in structural equation models. Sociological Methods & Research, 36(4), 462–494. https://doi.org/10.1177/0049124108314720 ● Otwarty dostęp: pełny tekst
- Society of Multivariate Experimental Psychology. (b.d.). Sells Award for Distinguished Multivariate Research. Pobrano 20 listopada 2026 z https://smep.org/?p=222 ● Otwarty dostęp
- Steiger, J. H. (1980). Tests for comparing elements of a correlation matrix. Psychological Bulletin, 87(2), 245–251. https://doi.org/10.1037/0033-2909.87.2.245
- Steiger, J. H. (1990). Structural model evaluation and modification: An interval estimation approach. Multivariate Behavioral Research, 25(2), 173–180. https://doi.org/10.1207/s15327906mbr2502_4
- Steiger, J. H. (2000). Point estimation, hypothesis testing, and interval estimation using the RMSEA: Some comments and a reply to Hayduk and Glaser. Structural Equation Modeling: A Multidisciplinary Journal, 7(2), 149–162. https://doi.org/10.1207/s15328007sem0702_1
- Vanderbilt University, Department of Psychology and Human Development. (b.d.). James Steiger. Pobrano 20 listopada 2026 z https://www.vanderbilt.edu/psychological_sciences/bio/james-steiger ● Otwarty dostęp
Cytowania BibTeX
@article{chen2008empirical, author={Chen, Feinian and Curran, Patrick J. and Bollen, Kenneth A. and Kirby, James and Paxton, Pamela}, title={{An empirical evaluation of the use of fixed cutoff points in RMSEA test statistic in structural equation models}}, journal={Sociological Methods \& Research}, year={2008}, volume={36}, number={4}, pages={462--494}, doi={10.1177/0049124108314720}}@misc{smepsellsaward, author={{Society of Multivariate Experimental Psychology}}, title={{Sells Award for Distinguished Multivariate Research}}, url={https://smep.org/?p=222}}@article{steiger1980tests, author={Steiger, James H.}, title={{Tests for comparing elements of a correlation matrix}}, journal={Psychological Bulletin}, year={1980}, volume={87}, number={2}, pages={245--251}, doi={10.1037/0033-2909.87.2.245}}@article{steiger1990structural, author={Steiger, James H.}, title={{Structural model evaluation and modification: An interval estimation approach}}, journal={Multivariate Behavioral Research}, year={1990}, volume={25}, number={2}, pages={173--180}, doi={10.1207/s15327906mbr2502_4}}@article{steiger2000point, author={Steiger, James H.}, title={{Point estimation, hypothesis testing, and interval estimation using the RMSEA: Some comments and a reply to Hayduk and Glaser}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2000}, volume={7}, number={2}, pages={149--162}, doi={10.1207/s15328007sem0702_1}}@misc{vanderbiltsteiger, author={{Vanderbilt University, Department of Psychology and Human Development}}, title={{James Steiger}}, url={https://www.vanderbilt.edu/psychological_sciences/bio/james-steiger}}