Dla kogo jest ten wpis i skąd pochodzą nazwy
Ten wpis jest dla osób, które dostały wyniki ze Statistiki albo liczą w niej same na licencji uczelni. Statistica pokazuje wyniki w arkuszach (spreadsheets) z innymi skrótami, innymi ustawieniami domyślnymi i własnym sposobem wyróżniania kolorem niż SPSS czy jamovi. Przejdziemy przez test t dla prób niezależnych i zależnych, ANOVA z testem post hoc, korelację, chi-kwadrat i regresję: co znaczy każda kolumna i jak zrobić z niej zdanie w stylu APA.
Ścieżki menu, nazwy okien i nagłówki kolumn sprawdziliśmy w oficjalnej dokumentacji producenta, Spotfire Statistica 14.2.0 (Cloud Software Group, b.d.-a–g). Starsze wydania nosiły nazwę TIBCO Statistica, a dokumentacja wersji 14.0.0 ma w tych miejscach tę samą treść. Nazwy podajemy po angielsku; w polskiej wersji językowej mogą brzmieć inaczej. Do okien prowadzi wstążka (karta Statistics, grupa Base) albo menu klasyczne (Statistics → Basic Statistics/Tables). Logikę wspólną dla wszystkich programów omawia wpis jak czytać wyniki z SPSS, a darmowe programy porównuje wpis bezpłatne programy do statystyki.
Sześć zasad czytania arkusza wyników Statistiki
- Najpierw nagłówek arkusza. Statistica wypisuje tam np. „Marked correlations are significant at p < .05000” i „N=50 (Casewise deletion of missing data)”, a w regresji także R², F i p modelu (Cloud Software Group, b.d.-a, b.d.-b). Sprawdź N i sposób usuwania braków.
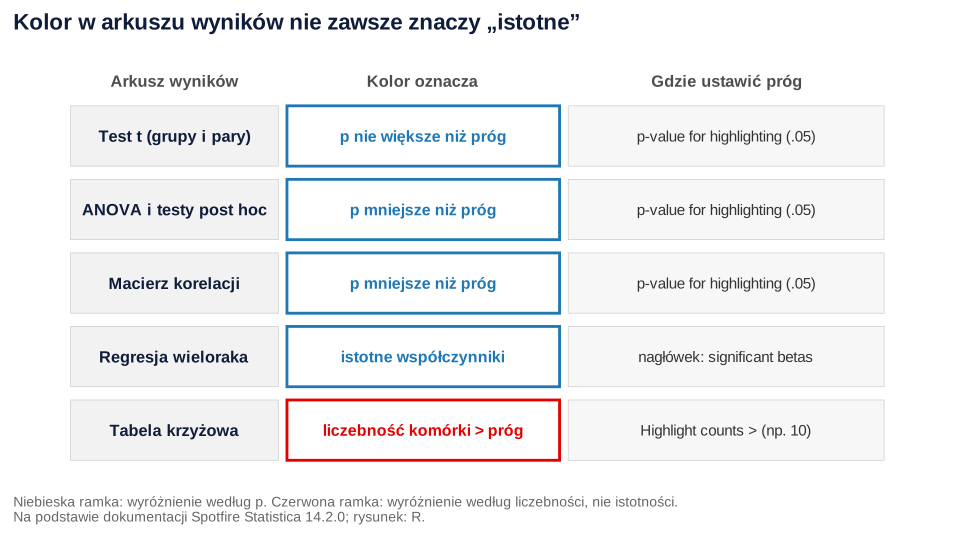
- Kolor to tylko podświetlenie, a nie wynik. W testach, ANOVA i korelacjach na czerwono są wyróżnione wartości z p poniżej progu z pola p-value for highlighting (domyślnie .05). W tabeli krzyżowej kolor oznacza coś innego (rysunek 1).
- Jeden arkusz bywa wieloma testami. Przy 20 zmiennych zależnych naraz kilka czerwonych wierszy może wyjść przypadkiem (zob. problem wielokrotnych porównań).
- Zapis liczb to format programu, a nie APA. Arkusze pokazują wiele cyfr, raz z zerem przed kropką (0.008703), raz bez (.13098). Zaokrąglij je; przy p, r i β pomiń zero przed kropką.
- „p<.00000” i „0.000000” to nie zero. Napisz p < .001 – jak przy „Sig. = .000” w SPSS.
- Sprawdź ustawienia domyślne. Np. test t bez zaznaczenia opcji liczy wariancję łączoną, a nie test Welcha (Cloud Software Group, b.d.-g).
Przykład i plik do pobrania
Wszystkie liczby pochodzą z jednego fikcyjnego zbioru (dane symulowane w R). 120 osób studiujących (72 studiujące stacjonarnie i 48 niestacjonarnie) rozwiązało test wiedzy (0–40 punktów). Losowo przydzielono je po 40 do grupy kontrolnej, warsztatu relaksacji i warsztatu uważności. Zmierzono stres przed warsztatem i po nim (1–5), sen (godziny), wsparcie (1–5), samopoczucie (10–50) i preferowaną formę konsultacji (1 = online, 2 = stacjonarnie, 3 = bez preferencji). Pobierz plik CSV. Statistica otwiera pliki tekstowe przez File → Open, a na liście typów plików są też m.in. arkusze Excela i pliki SPSS Portable (Cloud Software Group, b.d.-a).
Jak powstały tabele. Statistiki nie uruchamialiśmy. Liczby policzyliśmy w R tymi samymi metodami, a układ kolumn i liczbę cyfr odtworzyliśmy według przykładów z dokumentacji producenta. Tam, gdzie dokumentacja nie pokazuje pełnego układu (test dla par, tabela krzyżowa), podajemy zwykłą tabelę.
Test t dla prób niezależnych
Gdzie: Statistics → Basic Statistics → w oknie Basic Statistics and Tables pozycja t-test, independent, by groups. Przycisk Variables: zmienna grupująca tryb i zmienna zależna wynik. W polach Code for Group 1 i Code for Group 2 wpisz kody grup (1 i 2). Wariant by groups wymaga układu z kolumną grupy. Gdy każda grupa jest w osobnej kolumnie, służy do tego t-test, independent, by variables (Cloud Software Group, b.d.-a).
Przed Summary otwórz kartę Options. Domyślnie Statistica liczy wariancję łączoną obu grup, czyli klasyczny test Studenta. Pole Test w/ separate variance estimates dodaje do arkusza test z oddzielnymi wariancjami i przybliżonymi stopniami swobody, czyli test Welcha. Tu zaznacz też Levene's test i CI for estimates (95% przedział ufności różnicy średnich) (Cloud Software Group, b.d.-g). Delacre i in. (2017) zalecają test Welcha jako domyślny, bo przy równych wariancjach traci niewiele, a przy nierównych chroni przed fałszywymi wynikami.
| Variable | Mean stacjonarne | Mean niestacjonarne | t-value | df | p | Valid N stacjonarne | Valid N niestacjonarne |
|---|---|---|---|---|---|---|---|
| wynik | 25.972222 | 21.604167 | 3.67486 | 118 | 0.000359 | 72 | 48 |
Dwie pierwsze kolumny to średnie grup, piąta to p, a Valid N to liczebności grup (Cloud Software Group, b.d.-a). Ten wiersz byłby czerwony, bo p < .05. Ale t = 3.67 z df = 118 to test Studenta. Po przewinięciu arkusza w prawo znajdziesz kolejne kolumny, m.in. test F równości wariancji (Cloud Software Group, b.d.-a). Odchylenia standardowe grup wynoszą 4.85 i 8.16, czyli mniejsza grupa ma dużo większy rozrzut. Test Levene’a wykrywa tę różnicę, F(1, 118) = 10.10, p = .002 (zob. test Levene’a).
Z opcją separate variance estimates w arkuszu pojawi się test Welcha: t(69.23) = 3.34, p = .001. Różnica średnich wynosi 4.37 punktu, 95% CI [1.76, 6.98]. Tu wniosek się nie zmienia, ale bywa inaczej (przykład we wpisie test t w SPSS krok po kroku). Nie wybieraj testu po wyniku Levene’a, tylko zapowiedz test Welcha w planie analiz.
Wielkość efektu. Opcje tego okna opisane w dokumentacji nie obejmują d Cohena, więc policz je ze średnich i SD albo w innym programie (Lakens, 2013). Tu d liczone bez wspólnego SD wynosi 0.65, 95% CI [0.25, 1.05].
Test t dla prób zależnych
Gdzie: Basic Statistics → t-test, dependent samples. Przycisk Variables otwiera dwie listy, a każda zmienna z pierwszej listy jest porównywana z każdą z drugiej. Wybierz stres_przed w pierwszej liście i stres_po w drugiej. Na karcie Advanced są dwa układy wyników. Matrix of t-tests daje trzy arkusze (p, różnice średnich i wartości t), a Detailed results – jeden arkusz ze średnimi, odchyleniami, Valid N i wynikiem testu. Do pracy wybierz Detailed results i zaznacz CI for estimates, żeby dostać przedział ufności różnicy (Cloud Software Group, b.d.-f).
Dokumentacja nie pokazuje pełnych nagłówków arkusza Detailed results, dlatego wynik podajemy w zwykłej tabeli.
| Pomiar | M | SD | Różnica M [95% CI] | t(119) | p | dz |
|---|---|---|---|---|---|---|
| przed | 3.26 | 0.76 | 0.20 [0.09, 0.31] | 3.70 | < .001 | 0.34 |
| po | 3.06 | 0.67 |
Dwie pułapki: przy dwóch długich listach Statistica liczy test dla każdej kombinacji zmiennych, także bez sensu (np. stres przed a sen), więc wybieraj tylko planowane pary. Sprawdź też Valid N: przy usuwaniu braków obserwacjami (Casewise) osoba z brakiem w którejkolwiek wybranej zmiennej wypada ze wszystkich testów. dz to średnia różnica podzielona przez SD różnic.
ANOVA jednoczynnikowa i testy post hoc
Gdzie: Basic Statistics → Breakdown and one-way ANOVA → okno Statistics by Groups (Breakdown), karta Individual tables. Przycisk Variables: stres_po jako zmienna zależna, grupa jako grupująca. Przycisk Codes for grouping variables wybiera kody grup (wszystkie). Po OK otworzy się okno Statistics by Groups - Results. Na karcie ANOVA & tests przycisk Analysis of Variance daje arkusz ANOVA. Na tej samej karcie są też pole Perform Welch's F-Test i Levene test (Cloud Software Group, b.d.-d).
| Variable | SS Effect | df Effect | MS Effect | SS Error | df Error | MS Error | F | p |
|---|---|---|---|---|---|---|---|---|
| stres_po | 4.4835 | 2 | 2.24175 | 48.4045 | 117 | 0.413714 | 5.41860 | 0.005616 |
W pracy zapiszesz F(2, 117) = 5.42, p = .006, ze stopniami swobody z kolumn df Effect i df Error. η² policzysz z arkusza: SS Effect / (SS Effect + SS Error) = 4.4835 / 52.888 = .08. Test Levene’a nie wskazuje różnicy wariancji, F(2, 117) = 1.96, p = .146. Gdy SD grup wyraźnie się różnią, podaj ANOVA Welcha, tu F(2, 76.43) = 4.36, p = .016. Uwaga: przy dwóch zmiennych grupujących ta procedura traktuje każdą kombinację kategorii jako jedną grupę, więc nie jest to ANOVA dwuczynnikowa z interakcją. Pełne tabele dla planów czynnikowych liczą moduły GLM i ANOVA/MANOVA (Cloud Software Group, b.d.-d).
Post hoc: karta Post-hoc → Variables → wybór testu. Pierwszy przycisk to LSD test or planned comparison. Dokumentacja podaje wprost, że ten test daje najmniejszą ochronę przed wzrostem liczby fałszywych alarmów przy wielu porównaniach. Do porównań wszystkich par użyj raczej Tukey honest significant difference (HSD), a przy nierównych grupach – Tukey HSD for unequal N (Spjotvoll & Stoline). Więcej testów, w tym test Dunnetta, ma moduł GLM (Cloud Software Group, b.d.-e). Wynikiem jest macierz wartości p dla par grup (zob. test Tukeya HSD).
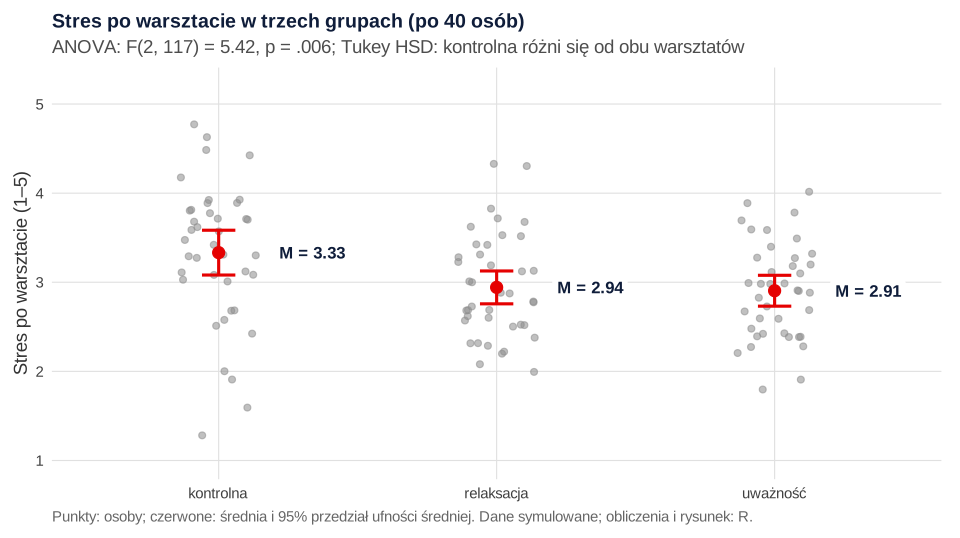
| grupa | {1} M=3.3325 | {2} M=2.9425 | {3} M=2.9050 |
|---|---|---|---|
| kontrolna {1} | 0.020888 | 0.009968 | |
| relaksacja {2} | 0.020888 | 0.963230 | |
| uważność {3} | 0.009968 | 0.963230 |
Macierz jest symetryczna, a nad kolumnami są średnie grup. Grupa kontrolna różni się od obu warsztatów, a warsztaty nie różnią się od siebie (rysunek 2). Macierz zawiera tylko p; różnice z przedziałami ufności policz osobno, tu −0.39, 95% CI [−0.73, −0.05], i −0.43, 95% CI [−0.77, −0.09]. Podobny wykres średnich z przedziałami ufności daje w Statistice przycisk Interaction plots z polem Plot confidence intervals for the mean (Cloud Software Group, b.d.-d).
Macierz korelacji
Gdzie: Basic Statistics → Correlation matrices → okno Product-Moment and Partial Correlations. One variable list daje kwadratową macierz, a Two lists (rect. matrix) – prostokątną, np. predyktory × wynik. Na karcie Options zmień domyślne Display simple matrix (highlight p's), czyli same r z kolorem, na Display r, p-values, and N's. Wtedy każda komórka zawiera też p, a przy usuwaniu braków parami – także N (Cloud Software Group, b.d.-a).
| Variable | samopoczucie |
|---|---|
| sen | .3354 |
| p=.000 | |
| wsparcie | .5136 |
| p=.000 | |
| stres_przed | −.5750 |
| p=.000 |
Wszystkie trzy korelacje są istotne i zostałyby wyróżnione; „p=.000” zapisz jako p < .001. W nawiasie przy r podaj stopnie swobody, N − 2 = 118. Przy usuwaniu braków parami każda komórka ma własne N, więc stopnie swobody bywają różne w jednej tabeli. Predyktory korelują ze sobą słabo: sen z wsparciem r = .11 (p = .235), sen ze stresem r = .08 (p = .368), wsparcie ze stresem r = −.24 (p = .010). Do pracy zwykle wystarczy tabela korelacji w APA.
Tabela krzyżowa i test chi-kwadrat
Gdzie: Basic Statistics → Tables and banners → okno Crosstabulation Tables → Specify tables (select variables): tryb w pierwszej liście, konsultacje w drugiej → OK. W oknie Crosstabulation Tables Results na karcie Options zaznacz Pearson & M-L Chi-square, Expected frequencies, Percentages of row counts i Phi (2x2 tables) & Cramér's V & C. Na karcie Advanced kliknij Detailed two-way tables. Statistica wyświetli tabelę krzyżową i osobny arkusz ze statystykami (Cloud Software Group, b.d.-c).
| Tryb | online | stacjonarnie | bez preferencji | Razem |
|---|---|---|---|---|
| stacjonarne | 19 (26.4%) | 35 (48.6%) | 18 (25.0%) | 72 |
| niestacjonarne | 27 (56.3%) | 12 (25.0%) | 9 (18.8%) | 48 |
| Statistic | Chi-square | df | p |
|---|---|---|---|
| Pearson Chi-square | 11.29857 | df=2 | p=.00352 |
| M-L Chi-square | 11.37815 | df=2 | p=.00338 |
Przepisz wiersz Pearson Chi-square. M-L Chi-square to test ilorazu wiarygodności; nie wybieraj wiersza z mniejszym p. Najmniejsza liczebność oczekiwana wynosi 10.8, więc założenie jest spełnione. Gdy nie jest, przeczytaj wpis chi-kwadrat czy test Fishera. V Craméra wynosi .31. Kierunek związku opisz z procentów w wierszach: osoby studiujące niestacjonarnie częściej wybierały konsultacje online.
Pułapka z kolorem. Na tej samej karcie Options jest pole Highlight counts > z progiem. W przykładzie z dokumentacji jest zaznaczone z wartością 10, a nagłówek tabeli mówi „Marked cells have counts > 10” (Cloud Software Group, b.d.-c). Czerwone komórki tabeli krzyżowej oznaczają więc tylko liczebność większą niż 10, a nie istotną różnicę. O istotności mówi wyłącznie arkusz statystyk.
Regresja wieloraka
Gdzie: Statistics → Multiple Regression → Variables: samopoczucie jako zależna, sen, wsparcie, stres_przed jako niezależne → OK. W oknie Multiple Regression Results u góry jest podsumowanie modelu, a przycisk Summary: Regression results otwiera arkusz współczynników (Cloud Software Group, b.d.-b). W oknie startowym sprawdź sposób usuwania braków: opcja Mean substitution zastępuje braki średnią, co zaniża rozrzut i zwykle nie jest dobrym wyborem (zob. braki danych w ankiecie).
| b* | Std.Err. of b* | b | Std.Err. of b | t(116) | p-value | |
|---|---|---|---|---|---|---|
| Intercept | 18.67959 | 4.46328 | 4.18517 | 0.000056 | ||
| sen | 0.339746 | 0.059836 | 2.54025 | 0.44739 | 5.67793 | 0.000000 |
| wsparcie | 0.354215 | 0.061351 | 4.10534 | 0.71106 | 5.77353 | 0.000000 |
| stres_przed | −0.519882 | 0.061195 | −5.64174 | 0.66409 | −8.49549 | 0.000000 |
Nagłówek opisuje cały model: R to korelacja wielokrotna, R² = .59 to odsetek wyjaśnionej wariancji, a Adjusted R² = .58 to jego wersja skorygowana o liczbę predyktorów. F(3,116) z „p<.00000” zapisz jako F(3, 116) = 56.76, p < .001. Std.Error of estimate to typowy błąd przewidywania w punktach skali.
Kolumny: b to surowy współczynnik (o ile punktów zmienia się samopoczucie przy wzroście predyktora o jednostkę), a b* to współczynnik standaryzowany, czyli β (Cloud Software Group, b.d.-b). Kolumna t(116) ma stopnie swobody w nagłówku, a 0.000000 w p-value to p < .001. Przycisk Partial correlations na karcie Advanced daje arkusz z kolumną Tolerance. Tu wynosi ona .976, .928 i .933, czyli VIF = 1/Tolerance to od 1.02 do 1.08, bez problemu współliniowości. Tabelę do pracy zbudujesz według wzoru tabeli regresji w APA.
Jak opisać Statisticę w pracy
W części o metodzie podaj nazwę programu, numer wersji, której faktycznie użyto, i nazwy procedur. Przykład: „Analizy wykonano w programie Statistica [wersja]. Średnie w dwóch grupach porównano testem t Welcha, w trzech grupach – jednoczynnikową analizą wariancji z testem Tukeya HSD; przyjęto α = .05.” Jeśli wyniki liczyła inna osoba, poproś ją o wersję programu i ustawienia. Wzór pozycji w bibliografii dobierz według ogólnych zasad cytowania oprogramowania z wpisu jak cytować kwestionariusz, SPSS i R. W przeczytanej dokumentacji producent nie podaje gotowego wzoru.
Gotowe zdania do innych testów przygotuje generator opisu wyników APA, a jeśli nie wiesz, czy test pasuje do pytania, sprawdź kreator doboru testu.
Te same liczby w R
Kod tworzy fikcyjny zbiór, zapisuje plik CSV do pobrania i liczy wszystkie liczby z tabel tego wpisu. Parametry symulacji (różnice średnich, rozrzut, związki zmiennych) ustawiono ręcznie, by przykład zawierał typowe sytuacje: nierówne wariancje w teście t, istotną ANOVA z jedną nieistotną parą i bardzo małe p w regresji. Test Levene’a liczymy jako ANOVA na odchyleniach bezwzględnych od średnich grup, tak jak opisuje go dokumentacja Statistiki (Cloud Software Group, b.d.-g). Kodu rysunków nie pokazujemy.
Dane, testy, ANOVA, korelacje, chi-kwadrat i regresja
R
# B529 – liczby do arkuszy wyników w układzie Statistiki (dane symulowane, fikcyjne)
# 120 osób studiujących: tryb studiów, test wiedzy (0–40), warsztat (3 grupy po 40),
# stres przed i po warsztacie (1–5), sen (godziny), wsparcie (1–5), samopoczucie (10–50),
# preferowana forma konsultacji. Metody: test t z wariancją łączoną i Welcha, test Levene'a
# (ANOVA na odchyleniach bezwzględnych od średnich grup), test t dla par, ANOVA i Tukey HSD,
# korelacje Pearsona, chi-kwadrat Pearsona i M-L, regresja liniowa z b* (beta).
suppressPackageStartupMessages(library(effectsize))
set.seed(529)
n <- 120
ogr <- function(x, a, b) pmin(pmax(x, a), b)
tryb <- sample(rep(1:2, c(72, 48)))
wynik <- round(ogr(rnorm(n, c(26, 23.5)[tryb], c(5, 8.5)[tryb]), 0, 40))
grupa <- sample(rep(1:3, each = 40))
stres_przed <- round(ogr(rnorm(n, 3.2, 0.7), 1, 5), 1)
stres_po <- round(ogr(0.6 * stres_przed + 1.3 - c(0, 0.25, 0.45)[grupa] + rnorm(n, 0, 0.5), 1, 5), 1)
sen <- round(ogr(rnorm(n, 6.9, 1), 4, 10), 1)
wsparcie <- round(ogr(rnorm(n, 3.6, 0.7), 1, 5), 1)
samopoczucie <- round(ogr(32 + 2.5 * (sen - 6.9) + 4 * (wsparcie - 3.6) - 5 * (stres_przed - 3.2) +
                          rnorm(n, 0, 6), 10, 50))
pr <- rbind(c(.30, .45, .25), c(.55, .20, .25))
konsultacje <- sapply(tryb, function(g) sample(1:3, 1, prob = pr[g, ]))
dane <- data.frame(id = 1:n, tryb, wynik, grupa, stres_przed, stres_po, sen, wsparcie,
                   samopoczucie, konsultacje)
write.csv(dane, "statistica-wyniki-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
f <- function(x, d = 6) formatC(x, format = "f", digits = d)
bz <- function(x, d) sub("^(-?)0\\.", "\\1.", f(x, d))   # bez zera przed kropką (p, r, R2)

cat("1. TEST t DLA PRÓB NIEZALEŻNYCH: wynik testu wiedzy, tryb 1 vs 2\n")
x1 <- wynik[tryb == 1]; x2 <- wynik[tryb == 2]
st <- t.test(x1, x2, var.equal = TRUE); we <- t.test(x1, x2)
print(data.frame(Mean1 = f(mean(x1)), Mean2 = f(mean(x2)), t = f(st$statistic, 5),
                 df = st$parameter, p = f(st$p.value), N1 = length(x1), N2 = length(x2)), row.names = FALSE)
cat("SD:", f(sd(x1), 3), f(sd(x2), 3), "\n")
cat("Welch: t =", f(we$statistic, 3), " df =", f(we$parameter, 2), " p =", bz(we$p.value, 4),
    " różnica =", f(-diff(we$estimate), 2), " 95% CI [", f(we$conf.int[1], 2), ",", f(we$conf.int[2], 2), "]\n")
odch <- abs(wynik - ave(wynik, tryb))
lev <- anova(lm(odch ~ factor(tryb)))
cat("Levene (od średnich): F(", lev$Df[1], ",", lev$Df[2], ") =", f(lev$`F value`[1], 2),
    " p =", bz(lev$`Pr(>F)`[1], 4), "\n")
print(cohens_d(x1, x2, pooled_sd = FALSE), digits = 2)
cat("\n")

cat("\n2. TEST t DLA PRÓB ZALEŻNYCH: stres przed i po warsztacie\n")
roz <- stres_przed - stres_po
tp <- t.test(stres_przed, stres_po, paired = TRUE)
cat("M przed =", f(mean(stres_przed), 3), " SD =", f(sd(stres_przed), 3),
    "| M po =", f(mean(stres_po), 3), " SD =", f(sd(stres_po), 3), "| N =", n, "\n")
cat("różnica =", f(mean(roz), 3), " SD różnic =", f(sd(roz), 3), " t =", f(tp$statistic, 3),
    " df =", tp$parameter, " p =", bz(tp$p.value, 6),
    " 95% CI [", f(tp$conf.int[1], 4), ",", f(tp$conf.int[2], 4), "]  d_z =", f(mean(roz) / sd(roz), 2), "\n")

cat("\n3. ANOVA JEDNOCZYNNIKOWA: stres po warsztacie a grupa (1 kontrolna, 2 relaksacja, 3 uważność)\n")
print(round(sapply(split(stres_po, grupa), function(x) c(M = mean(x), SD = sd(x), N = length(x))), 4))
a <- anova(lm(stres_po ~ factor(grupa)))
print(data.frame(SS_Effect = f(a$`Sum Sq`[1], 4), df_Effect = a$Df[1], MS_Effect = f(a$`Mean Sq`[1], 5),
                 SS_Error = f(a$`Sum Sq`[2], 4), df_Error = a$Df[2], MS_Error = f(a$`Mean Sq`[2], 6),
                 F = f(a$`F value`[1], 5), p = f(a$`Pr(>F)`[1])), row.names = FALSE)
cat("eta^2 = SS Effect / (SS Effect + SS Error) =", bz(a$`Sum Sq`[1] / sum(a$`Sum Sq`), 4), "\n")
ow <- oneway.test(stres_po ~ factor(grupa))
cat("Welch F(", f(ow$parameter[1], 0), ",", f(ow$parameter[2], 2), ") =", f(ow$statistic, 2),
    " p =", bz(ow$p.value, 4), "\n")
odg <- abs(stres_po - ave(stres_po, grupa))
lg <- anova(lm(odg ~ factor(grupa)))
cat("Levene (od średnich): F(", lg$Df[1], ",", lg$Df[2], ") =", f(lg$`F value`[1], 2),
    " p =", bz(lg$`Pr(>F)`[1], 3), "\n")
th <- TukeyHSD(aov(stres_po ~ factor(grupa)))$`factor(grupa)`
print(round(th, 6))

cat("\n4. KORELACJE PEARSONA (N = 120, bez braków)\n")
zm <- dane[, c("sen", "wsparcie", "stres_przed", "samopoczucie")]
r <- cor(zm)
p <- outer(1:4, 1:4, Vectorize(function(i, j) if (i == j) NA else cor.test(zm[, i], zm[, j])$p.value))
dimnames(p) <- dimnames(r)
print(round(r, 4)); print(round(p, 3))

cat("\n5. TABELA KRZYŻOWA I CHI-KWADRAT: tryb x preferowana forma konsultacji\n")
tab <- table(tryb, konsultacje)
print(addmargins(tab))
print(round(100 * prop.table(tab, 1), 2))
ch <- chisq.test(tab, correct = FALSE)
print(round(ch$expected, 2))
g2 <- 2 * sum(tab * log(tab / ch$expected))
cat("Pearson Chi-square =", f(ch$statistic, 5), " df =", ch$parameter, " p =", bz(ch$p.value, 5), "\n")
cat("M-L Chi-square =", f(g2, 5), " df =", ch$parameter, " p =", bz(pchisq(g2, ch$parameter, lower.tail = FALSE), 5), "\n")
cat("V Craméra =", bz(sqrt(ch$statistic / (sum(tab) * (min(dim(tab)) - 1))), 3), "\n")

cat("\n6. REGRESJA LINIOWA: samopoczucie ~ sen + wsparcie + stres_przed\n")
m <- lm(samopoczucie ~ sen + wsparcie + stres_przed, data = dane)
s <- summary(m); fs <- s$fstatistic
cat("R =", bz(sqrt(s$r.squared), 8), " R2 =", bz(s$r.squared, 8), " Adjusted R2 =", bz(s$adj.r.squared, 8), "\n")
cat("F(", fs[2], ",", fs[3], ") =", f(fs[1], 3), " p =", format.pval(pf(fs[1], fs[2], fs[3], lower.tail = FALSE), digits = 3),
    " Std.Error of estimate =", f(s$sigma, 4), "\n")
co <- coef(s)
sx <- c(NA, sapply(dane[, c("sen", "wsparcie", "stres_przed")], sd)); sy <- sd(dane$samopoczucie)
print(data.frame(b_gw = f(co[, 1] * sx / sy), SE_b_gw = f(co[, 2] * sx / sy), b = f(co[, 1], 5),
                 SE_b = f(co[, 2], 5), t = f(co[, 3], 5), p = f(co[, 4])))
tol <- sapply(c("sen", "wsparcie", "stres_przed"), function(v)
  1 - summary(lm(reformulate(setdiff(c("sen", "wsparcie", "stres_przed"), v), v), data = dane))$r.squared)
print(round(rbind(Tolerance = tol, VIF = 1 / tol), 3))
Wynik
1. TEST t DLA PRÓB NIEZALEŻNYCH: wynik testu wiedzy, tryb 1 vs 2
     Mean1     Mean2       t  df        p N1 N2
 25.972222 21.604167 3.67486 118 0.000359 72 48
SD: 4.853 8.160
Welch: t = 3.336  df = 69.23  p = .0014  różnica = 4.37  95% CI [ 1.76 , 6.98 ]
Levene (od średnich): F( 1 , 118 ) = 10.10  p = .0019
Cohen's d |       95% CI
------------------------
0.65      | [0.25, 1.05]

- Estimated using un-pooled SD.

2. TEST t DLA PRÓB ZALEŻNYCH: stres przed i po warsztacie
M przed = 3.264  SD = 0.761 | M po = 3.060  SD = 0.667 | N = 120
różnica = 0.204  SD różnic = 0.605  t = 3.700  df = 119  p = .000328  95% CI [ 0.0949 , 0.3134 ]  d_z = 0.34

3. ANOVA JEDNOCZYNNIKOWA: stres po warsztacie a grupa (1 kontrolna, 2 relaksacja, 3 uważność)
         1       2       3
M   3.3325  2.9425  2.9050
SD  0.7852  0.5760  0.5411
N  40.0000 40.0000 40.0000
 SS_Effect df_Effect MS_Effect SS_Error df_Error MS_Error       F        p
    4.4835         2   2.24175  48.4045      117 0.413714 5.41860 0.005616
eta^2 = SS Effect / (SS Effect + SS Error) = .0848
Welch F( 2 , 76.43 ) = 4.36  p = .0161
Levene (od średnich): F( 2 , 117 ) = 1.96  p = .146
       diff       lwr       upr    p adj
2-1 -0.3900 -0.731428 -0.048572 0.020888
3-1 -0.4275 -0.768928 -0.086072 0.009968
3-2 -0.0375 -0.378928  0.303928 0.963230

4. KORELACJE PEARSONA (N = 120, bez braków)
                sen wsparcie stres_przed samopoczucie
sen          1.0000   0.1092      0.0828       0.3354
wsparcie     0.1092   1.0000     -0.2352       0.5136
stres_przed  0.0828  -0.2352      1.0000      -0.5750
samopoczucie 0.3354   0.5136     -0.5750       1.0000
               sen wsparcie stres_przed samopoczucie
sen             NA    0.235       0.368            0
wsparcie     0.235       NA       0.010            0
stres_przed  0.368    0.010          NA            0
samopoczucie 0.000    0.000       0.000           NA

5. TABELA KRZYŻOWA I CHI-KWADRAT: tryb x preferowana forma konsultacji
     konsultacje
tryb    1   2   3 Sum
  1    19  35  18  72
  2    27  12   9  48
  Sum  46  47  27 120
    konsultacje
tryb     1     2     3
   1 26.39 48.61 25.00
   2 56.25 25.00 18.75
    konsultacje
tryb    1    2    3
   1 27.6 28.2 16.2
   2 18.4 18.8 10.8
Pearson Chi-square = 11.29857  df = 2  p = .00352
M-L Chi-square = 11.37815  df = 2  p = .00338
V Craméra = .307

6. REGRESJA LINIOWA: samopoczucie ~ sen + wsparcie + stres_przed
R = .77123436  R2 = .59480243  Adjusted R2 = .58432319
F( 3 , 116 ) = 56.760  p = <2e-16  Std.Error of estimate = 5.3229
                 b_gw  SE_b_gw        b    SE_b        t        p
(Intercept)        NA       NA 18.67959 4.46328  4.18517 0.000056
sen          0.339746 0.059836  2.54025 0.44739  5.67793 0.000000
wsparcie     0.354215 0.061351  4.10534 0.71106  5.77353 0.000000
stres_przed -0.519882 0.061195 -5.64174 0.66409 -8.49549 0.000000
            sen wsparcie stres_przed
Tolerance 0.976    0.928       0.933
VIF       1.025    1.078       1.072
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem effectsize; rysunki przygotowano w pakietach ggplot2 i svglite. Statistiki nie uruchamialiśmy. W pracy podaj wersję programu, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe pułapki i lista kontrolna
- Czerwone komórki tabeli krzyżowej uznane za istotne.
- Test Studenta jako jedyny wynik, bo nie zaznaczono Test w/ separate variance estimates.
- Zera z arkusza („0.000000”, „p<.00000”) przepisane do tekstu.
- Kilkadziesiąt testów w jednym arkuszu i opis tylko czerwonych wierszy.
- Test LSD do porównań wszystkich par, bo jest pierwszy na liście.
- b opisane jako β albo odwrotnie.
- Braki zastąpione średnią bez opisu w pracy.
Przed oddaniem rozdziału sprawdź: (1) N w nagłówku każdego arkusza i sposób usuwania braków; (2) czy test t to Welch, jeśli tak zaplanowałeś; (3) czy każde p ma format APA; (4) czy przy każdym teście jest wielkość efektu; (5) czy test post hoc jest nazwany; (6) czy w tabeli krzyżowej opisałeś procenty, a nie kolory; (7) czy w Metodzie jest wersja programu. Spójność liczb między tekstem a tabelami pomaga sprawdzić wpis jak opisać wyniki w stylu APA. Jeśli chcesz, żeby ktoś sprawdził Twoje wyniki ze Statistiki, zajrzyj na stronę analizy statystyczne dla studentów.
Najczęstsze pytania
Co oznacza czerwony kolor w wynikach Statistiki?
W testach t, ANOVA, testach post hoc i macierzach korelacji kolor wyróżnia wyniki z p poniżej progu ustawionego w polu p-value for highlighting (domyślnie .05). W tabeli krzyżowej kolor oznacza tylko liczebność komórki większą niż próg z pola Highlight counts – nie mówi nic o istotności. O wyniku testu chi-kwadrat mówi osobny arkusz statystyk.
Jak zapisać w pracy p = 0.0000 albo p<.00000 ze Statistiki?
Jako p < .001. Wartość p nie jest równa zeru – program pokazuje tylko kilka miejsc po kropce. Pozostałe wartości p zaokrąglij do dwóch lub trzech miejsc i zapisz bez zera przed kropką, np. p = .006.
Czy Statistica liczy test t Welcha?
Tak, ale nie domyślnie. W oknie t-test, independent, by groups na karcie Options zaznacz Test w/ separate variance estimates – do arkusza zostanie dodany test z oddzielnymi wariancjami i przybliżonymi stopniami swobody. Bez tej opcji arkusz pokazuje klasyczny test Studenta z wariancją łączoną.
Gdzie w Statistice jest wielkość efektu?
Okna testu t i jednoczynnikowej ANOVA w module Basic Statistics nie mają w opisanych opcjach d Cohena ani η². η² policzysz z arkusza ANOVA jako SS Effect / (SS Effect + SS Error), d – ze średnich i odchyleń grup. V Craméra daje opcja Phi (2x2 tables) & Cramér's V & C w tabelach krzyżowych, a β w regresji to kolumna b*.
Czym różni się b od b* w regresji w Statistice?
b to surowy współczynnik regresji w jednostkach zmiennych, a b* to współczynnik standaryzowany, czyli β. Obie wartości mają własne błędy standardowe w kolumnach Std.Err. of b i Std.Err. of b*. W tabeli APA podaj b z SE i β, a test t i p są wspólne dla obu.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikANOVA w SPSS krok po kroku
One-Way ANOVA w SPSS od przygotowania pliku po opis APA: opcje Welch i Brown-Forsythe, Tukey a Games–Howell, η² ręcznie i składnia ONEWAY – z plikiem .sav do pobrania.
Czytaj →PoradnikKorelacja i regresja w SPSS
Bivariate i Linear Regression krok po kroku: które opcje zaznaczyć, jak czytać Model Summary, Coefficients i Collinearity Diagnostics, wykresy reszt i zapis APA.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →Masz arkusze wyników ze Statistiki i nie wiesz, co przepisać?
Sprawdzimy wybór testów, ustawienia i liczby w Twoich arkuszach oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cloud Software Group. (b.d.-a). Example 1: Descriptive Statistics, t-Tests, and Correlations. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-1-descriptive-statistics-t-tests-and-correlations.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-b). Example 1: Standard Regression Analysis. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-1-standard-regression-analysis.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-c). Example 10: Chi-Square Test for Independence. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-10-chi-square-test-for-independence.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-d). Example 2: Breakdown and One-Way ANOVA. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-2-breakdown-and-one-way-anova.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-e). Statistics by Groups Results - Post-Hoc tab. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/statistics-by-groups-results-post-hoc-tab.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-f). T-Test for Dependent Samples - Advanced tab. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/user-guide/t-test-for-dependent-samples-advanced-tab.htm ● Otwarty dostęp
- Cloud Software Group. (b.d.-g). T-Test for Independent Samples by Groups - Options Tab. Spotfire Statistica 14.2.0 User's Guide. https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/t-test-for-independent-samples-by-groups-options-tab.htm ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
Cytowania BibTeX
@misc{statistica142ex1, author={{Cloud Software Group}}, title={{Example 1: Descriptive Statistics, t-Tests, and Correlations}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-a}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-1-descriptive-statistics-t-tests-and-correlations.htm}}@misc{statistica142ex1reg, author={{Cloud Software Group}}, title={{Example 1: Standard Regression Analysis}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-b}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-1-standard-regression-analysis.htm}}@misc{statistica142ex10, author={{Cloud Software Group}}, title={{Example 10: Chi-Square Test for Independence}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-c}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-10-chi-square-test-for-independence.htm}}@misc{statistica142ex2, author={{Cloud Software Group}}, title={{Example 2: Breakdown and One-Way ANOVA}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-d}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/example-2-breakdown-and-one-way-anova.htm}}@misc{statistica142posthoc, author={{Cloud Software Group}}, title={{Statistics by Groups Results - Post-Hoc tab}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-e}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/statistics-by-groups-results-post-hoc-tab.htm}}@misc{statistica142ttestdep, author={{Cloud Software Group}}, title={{T-Test for Dependent Samples - Advanced tab}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-f}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/user-guide/t-test-for-dependent-samples-advanced-tab.htm}}@misc{statistica142ttestopt, author={{Cloud Software Group}}, title={{T-Test for Independent Samples by Groups - Options Tab}}, howpublished={Spotfire Statistica 14.2.0 User's Guide}, year={b.d.-g}, publisher={Cloud Software Group}, url={https://docs.tibco.com/pub/stat/14.2.0/doc/html/UserGuide/_shared/t-test-for-independent-samples-by-groups-options-tab.htm}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}