Jedna tabela, pięć akapitów
Promotor z psychologii poprawia brak d Cohena, a promotorka z pielęgniarstwa pyta, gdzie są liczebności. Student dochodzi do wniosku, że każda dziedzina liczy coś innego. Zwykle tak nie jest: liczby pozostają te same, a zmienia się ich kolejność i to, co czytelnik ma zobaczyć najpierw.
Pokazujemy to na jednej fikcyjnej tabeli. Ten sam wynik opisujemy pięcioma pełnymi akapitami, a przy każdym wyjaśniamy, co jest typowe i z czego to wynika. Cały rozdział wyników znajdziesz we wpisie wyniki badań własnych – przykładowy rozdział, zdania dla poszczególnych testów w poradniku o zapisie APA, a różnice całych prac w tekście jedna praca, trzy kierunki. Tu chodzi wyłącznie o to, jak ubrać wynik w słowa. W serii są też wstęp w pięciu dziedzinach, pytania i hipotezy oraz dyskusja.
Zastrzeżenie. Opisane niżej różnice to częste zwyczaje, a nie reguły. W wielu pracach wygląda to inaczej, a wymagania uczelni, promotora i czasopisma mają pierwszeństwo. Tam, gdzie nie podajemy źródła, opisujemy własną obserwację.
Wspólny punkt wyjścia: fikcyjne badanie
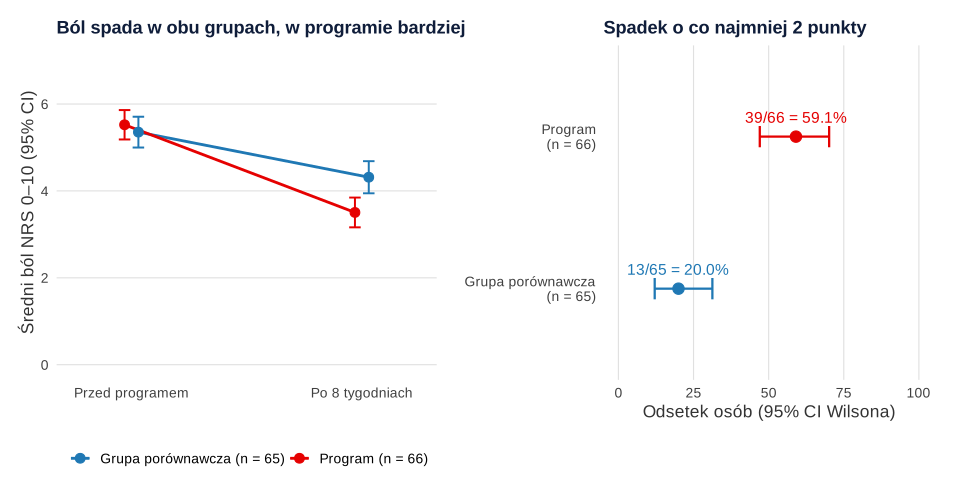
Pracownicy biurowi zgłosili się do ośmiotygodniowego programu przerw ruchowych i edukacji o ergonomii. Część weszła od razu do programu (74 osoby), pozostali trafili na listę oczekujących i posłużyli jako grupa porównawcza (72 osoby). Przydział nie był losowy. Wynik główny to średni ból szyi i pleców z siedmiodniowego dzienniczka (NRS 0–10), mierzony przed programem i po nim. Zmienna binarna to poprawa: spadek bólu o co najmniej 2 punkty. Ten próg jest w przykładzie umowny i fikcyjny. Pomiar końcowy wypełniło 131 ze 146 osób, a o tym, jak traktować pozostałe, piszemy w haśle utrata uczestników.
| Zmienna | Program | Grupa porównawcza | Porównanie (95% CI) |
|---|---|---|---|
| Zapisani, n | 74 | 72 | – |
| Z pomiarem końcowym, n (%) | 66 (89.2) | 65 (90.3) | – |
| Wiek, M (SD) | 38.02 (9.43) | 37.20 (9.60) | – |
| Kobiety, n (%) | 38 (57.6) | 33 (50.8) | – |
| Ból przed, M (SD) | 5.52 (1.38) | 5.35 (1.43) | SMD = 0.12 |
| Ból po, M (SD) | 3.50 (1.39) | 4.32 (1.49) | – |
| Zmiana, M [95% CI] | −2.02 [−2.30, −1.73] | −1.04 [−1.33, −0.75] | – |
| Ból po, średnia skorygowana | 3.45 | 4.37 | b = −0.93 [−1.30, −0.55], p < .001; d = −0.64 [−0.90, −0.38] |
| Poprawa, n (%) [95% CI] | 39 (59.1) [47.0, 70.1] | 13 (20.0) [12.1, 31.3] | różnica 39.1 p.p. [22.6, 52.7]; RR = 2.95 [1.75, 5.00] |
Uwaga do tabeli. Główna analiza to regresja bólu po programie na grupę i ból przed programem, czyli ANCOVA w badaniu przed i po: F(1, 128) = 23.79, cząstkowe η² = .157, a cały model R² = .482. Różnica średnich skorygowanych wygląda jak 0.92, a model daje 0.93, bo liczby zaokrąglono osobno – taki drobiazg warto objaśnić, zanim ktoś go zauważy (kontrola spójności liczb). Przedział dla d to przedział dla b podzielony przez zbiorcze SD wyniku po programie; bootstrap dał [−0.93, −0.38]. Różnicę odsetków opisano przedziałem Newcombe’a (1998).
Psychologia: statystyka, a przy niej efekt
Co tu jest typowe (przykład fikcyjny). Akapit często układa się w sekwencję: po co analiza, jaki test, statystyka z df i dokładnym p, kierunek, efekt z przedziałem. Standardy JARS-Quant dla badań ilościowych w psychologii (Appelbaum i in., 2018) wyznaczają te elementy, a szczegóły opisujemy we wpisie o wytycznych APA. Standaryzowana miara ułatwia porównanie między badaniami (Lakens, 2013), ale nie zastępuje różnicy w punktach. Znak minus przy d oznacza tu mniejszy ból. Etykietę „umiarkowany” dodaj tylko wtedy, gdy umiesz ją uzasadnić (interpretacja wielkości efektu). Pełny obraz pracy z tej dziedziny daje praca z psychologii.
Pielęgniarstwo: liczebności, odsetki i tabela
Co tu jest typowe (przykład fikcyjny). Na początku często pojawia się opis próby i pytanie, ile osób naprawdę stoi za każdą liczbą, a odsetek idzie razem z licznikiem i mianownikiem. Główna treść zwykle mieści się w tabeli, a tekst wskazuje to, co najważniejsze (tabela 1). Czytelnik z praktyki łatwiej odczyta „39 z 66” niż współczynnik modelu. Lista CONSORT dotyczy badań randomizowanych, ale jej punkt 17 dobrze porządkuje rozdział: wynik w każdej grupie, oszacowanie efektu z precyzją, a przy wyniku binarnym miara bezwzględna i względna (Moher i in., 2010). Bez randomizacji warto zajrzeć do TREND (Des Jarlais i in., 2004). Porównanie odsetków opisujemy szerzej we wpisie jak porównać odsetki w dwóch grupach, a kontekst dziedziny w tekście praca z pielęgniarstwa. Wyniki nie są podstawą do zaleceń dla pacjentów.
Fizjoterapia: zmiana a próg znaczenia
Co tu jest typowe (przykład fikcyjny). Istotność często schodzi na drugi plan, a główne pytanie brzmi: czy ta zmiana coś znaczy dla osoby? Stąd zmiana w punktach skali, odsetek osób powyżej progu i zastrzeżenie o regresji do średniej. Próg ustala się z góry i podaje jego źródło. Wartość 2 punkty pojawia się w konsensusie dla NRS w bólu krzyża, ale jako wartość dla pojedynczego pacjenta i punkt wyjścia (Ostelo i in., 2008). Nie przenoś jej automatycznie na inne dolegliwości: tu jest umowna. Różnicy 0.93 punktu nie zestawiaj z MCID. Podział na „poprawa tak/nie” ma też koszt, bo traci informację i moc (Snapinn i Jiang, 2007; dychotomizacja zmiennych ciągłych), więc wynik ciągły zostaje główny. Rachunek progów pokazuje wpis o RCI, MDC i MCID, a ich miejsce w całej pracy – praca z fizjoterapii.
Pedagogika: odpowiedzi według problemów szczegółowych
Problem szczegółowy 2: Czy po ośmiu tygodniach poziom bólu różnił się między uczestnikami programu a grupą porównawczą? Po ośmiu tygodniach średni poziom bólu wynosił 3.50 (SD = 1.39) wśród uczestników programu i 4.32 (SD = 1.49) w grupie porównawczej. Po uwzględnieniu poziomu wyjściowego uczestnicy programu uzyskali wynik niższy o 0.93 punktu (95% CI [0.55, 1.30]; p < .001).
Problem szczegółowy 3: Jaka część osób badanych zmniejszyła ból o co najmniej 2 punkty? Taką poprawę odnotowano u 39 z 66 uczestników programu (59.1%) i u 13 z 65 osób z grupy porównawczej (20.0%), a różnica wyniosła 39.1 punktu procentowego (95% CI [22.6, 52.7]).
Odpowiadając na problem główny, po zakończeniu programu jego uczestnicy deklarowali mniejsze dolegliwości niż osoby z grupy porównawczej. Ze względu na brak losowego przydziału nie można ustalić, w jakim stopniu różnica ta jest rezultatem programu.
Co tu jest typowe (przykład fikcyjny). W polskich pracach pedagogicznych często spotyka się układ problem główny – problemy szczegółowe – hipotezy, opisywany w podręcznikach metodologii (np. Pilch i Bauman, 2010). Wyniki układa się wtedy według problemów, a pojedynczy podrozdział kończy się odpowiedzią wyrażoną słowami. Liczby są te same co gdzie indziej, tylko rozdzielone. Pilnuj, by każdy problem miał własną odpowiedź i by żaden wynik nie pojawił się bez pytania. Taki układ dobrze widać w tekście praca z pedagogiki. Numeracja i nazwy zależą od katedry, więc wzór warto uzgodnić z promotorem.
Zarządzanie: model i skala dla organizacji
Co tu jest typowe (przykład fikcyjny). W zarządzaniu i ekonomii wynik często przedstawia się jako model z hipotezą H1, a osobno interpretuje jego skalę dla organizacji. Aguinis i in. (2010) zalecają, by obok p podawać wielkość efektu i jego praktyczne znaczenie. Współczynnik b jest tu czytelniejszy niż β, bo program ma wartości 0 i 1, a β zależy od proporcji grup. Założenie 4 godzin jest fikcyjne i w prawdziwej pracy wymaga źródła, na przykład harmonogramu. Rachunek pozostaje szacunkiem na podstawie tego samego przedziału. Układ całej pracy opisujemy w tekście praca z zarządzania i ekonomii.
Porównanie pięciu wersji
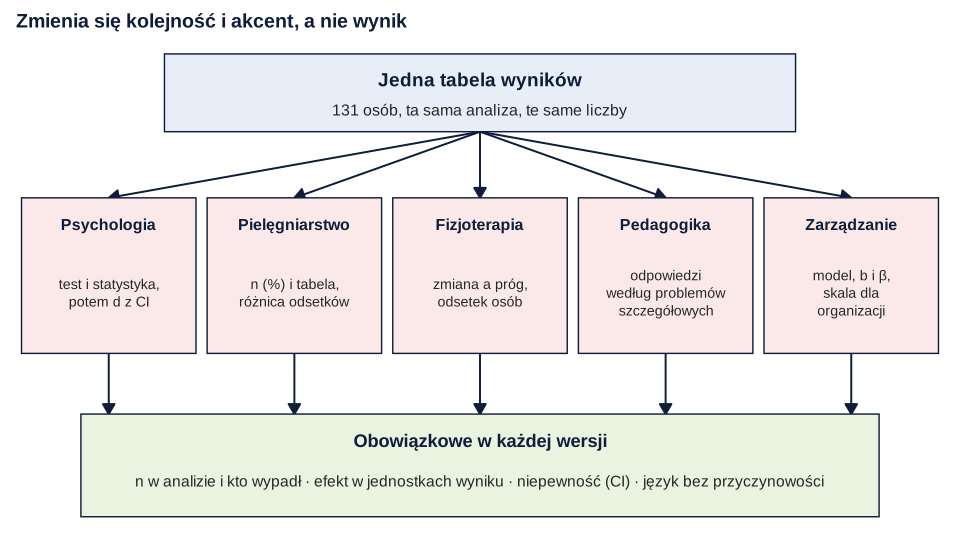
| Dziedzina (często) | Od czego się zaczyna | Główna liczba | Czego pilnować |
|---|---|---|---|
| Psychologia | Cel analizy i test | F, p, d z CI | Etykiety efektu, zapis APA |
| Pielęgniarstwo | Opis próby, tabela | n (%), różnica odsetków | Odsetki bez mianownika, zalecenia na wyrost |
| Fizjoterapia | Zmiana w punktach skali | Odsetek osób powyżej progu | Próg dla osoby a różnica średnich, naturalny przebieg |
| Pedagogika | Problem szczegółowy 1 | Odpowiedź na każdy problem | Wynik bez problemu, problem bez wyniku |
| Zarządzanie | Hipoteza H1 i model | b (β) i skala dla organizacji | Założenia kosztowe, przenoszenie na całą firmę |
Co obowiązuje wszędzie, a co jest zwyczajem
| Element | Status | W przykładzie |
|---|---|---|
| n w analizie i liczba osób, które wypadły | Wszędzie | 146 zapisanych, 131 w analizie |
| Efekt w jednostkach wyniku | Wszędzie | −0.93 punktu; 39.1 p.p. |
| Niepewność | Wszędzie | 95% CI (jak go raportować) |
| Nazwa analizy i wynik dokładny, gdy testujesz | Wszędzie | ANCOVA, p < .001 |
| Język zgodny ze schematem | Wszędzie | Bez przydziału losowego: „różnica”, „wiąże się” |
| Miara standaryzowana | Zwyczaj, mocny w psychologii | d = −0.64 |
| β obok b | Zwyczaj, częsty w zarządzaniu | β = −.31 |
| Układ według problemów lub hipotez | Zwyczaj dziedziny i katedry | Problemy 1–3, H1 |
| Próg znaczenia dla osoby | Tam, gdzie ma uzasadnienie | Umowne 2 punkty |
| Przeliczenie na skalę organizacji | Zwyczaj, zawsze z założeniami | Około 10 godzin |
Jeśli promotor z innej dziedziny prosi o coś dodatkowego, zwykle wystarczy dopisać element z drugiej części tabeli. Pierwszej części nie pomijaj w żadnej wersji. Praktyczny test: zasłoń akapit i sprawdź, czy z samego tekstu da się odtworzyć liczbę osób, kierunek, wielkość i niepewność.
Jak bywa napisane, co jest nie tak, jak poprawić
| Jak bywa napisane | Co jest nie tak | Poprawione |
|---|---|---|
| „Program okazał się skuteczny (p < .001).” | Nielosowy przydział, brak wielkości i kierunku | „Po uwzględnieniu bólu wyjściowego ból w grupie programu był niższy o 0.93 punktu, 95% CI [0.55, 1.30]. Przydział nie był losowy.” |
| „Grupa programu osiągnęła MCID, bo ból spadł średnio o 2.02.” | Próg dotyczy osoby; zmiana w jednej grupie pomija grupę porównawczą | „Próg 2 punktów osiągnęło 39 z 66 uczestników (59.1%) i 13 z 65 osób z grupy porównawczej (20.0%).” |
| „Efekt był duży.” | Etykieta bez liczby i bez kontekstu | „d = −0.64, 95% CI [−0.90, −0.38], co odpowiada różnicy 0.93 punktu na skali 0–10.” |
| „59% osób odczuło poprawę.” | Brak mianownika i porównania; poprawa dotyczy też grupy porównawczej | „Poprawę odnotowano u 39 z 66 uczestników programu (59.1%) oraz 13 z 65 osób z grupy porównawczej (20.0%).” |
| „Firma zaoszczędzi 390 godzin.” | Wynik o bólu zamieniono w oszczędność, której nie zmierzono | „Na 100 objętych programem pracowników przypadałoby około 39 osób więcej z poprawą (95% CI: 23–53). Oszczędności czasu nie badano.” |
Najczęstsze błędy
- Różne wyniki w różnych miejscach: inny model w tabeli, inny w tekście.
- Sam p bez efektu w jednostkach wyniku albo d bez różnicy w punktach.
- Opis samej zmiany w grupie programu, z pominięciem grupy porównawczej i jej zmiany.
- Słownictwo przyczynowe przy nielosowym przydziale, także „dzięki programowi”.
- Odsetki bez licznika i mianownika, zwłaszcza w małych grupach.
- Próg MCID przyłożony do różnicy średnich albo wzięty z innej populacji bez uzasadnienia.
- Pomijanie osób bez pomiaru końcowego w opisie próby.
- Przeliczenia na koszty bez podanych założeń.
- Dopisywanie etykiet („duży”, „wysoce istotny”) zamiast liczb.
Skąd te liczby: kod w R
Jeden skrypt tworzy symulowane dane i liczy wszystko, co pojawia się w tabeli 1 i pięciu akapitach. Dane zapisuje w pliku CSV w folderze nadrzędnym (../). Plik możesz pobrać: program-przerwy-ruchowe-dane.csv (146 osób: grupa, wiek, kobieta, ból przed i po; puste pola to brak pomiaru końcowego). Rysunki powstały w osobnym skrypcie na tych samych danych. W prawdziwej pracy dodaj jeszcze sprawdzenie założeń modelu.
Symulacja, tabela wspólna, model i odsetki
R
# B475 – jeden fikcyjny wynik do opisania w pięciu dziedzinach (dane symulowane, tylko base R)
set.seed(4750)

# 1. Symulacja: 8-tygodniowy program przerw ruchowych i edukacji, lista oczekujących jako grupa porównawcza
n_zapis <- c(program = 74, porownawcza = 72)
dane <- data.frame(id = seq_len(sum(n_zapis)),
                   grupa = rep(names(n_zapis), n_zapis),
                   wiek = round(rnorm(sum(n_zapis), 38, 9)),
                   kobieta = rbinom(sum(n_zapis), 1, .60))
ogranicz <- function(x) round(pmin(pmax(x, 0), 10), 1)      # średnia z 7-dniowego dzienniczka NRS 0–10
dane$bol_przed <- ogranicz(rnorm(nrow(dane), 5.4, 1.5))
dane$bol_po <- ogranicz(1.2 + .62 * dane$bol_przed - 1.05 * (dane$grupa == "program") +
                          rnorm(nrow(dane), 0, 1.25))
wypadl <- c(sample(which(dane$grupa == "program"), 8), sample(which(dane$grupa == "porownawcza"), 7))
dane$bol_po[wypadl] <- NA
write.csv(dane, "../program-przerwy-ruchowe-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 2. Próba analityczna i zmienne pochodne
d <- subset(dane, !is.na(bol_po))
d$program <- as.integer(d$grupa == "program")
d$zmiana <- d$bol_po - d$bol_przed
d$poprawa <- as.integer(d$zmiana <= -2)                     # umowny, fikcyjny próg: spadek o co najmniej 2 pkt
cat("Zapisani:", n_zapis, " Wypadli:", table(dane$grupa[wypadl])[c("program", "porownawcza")],
    " Analiza:", table(d$grupa)[c("program", "porownawcza")],
    sprintf(" Pomiar końcowy: %d/%d = %.1f%%\n", nrow(d), nrow(dane), 100 * nrow(d) / nrow(dane)))
cat(sprintf("Pomiar końcowy w grupach: program %.1f%%, porównawcza %.1f%%\n\n",
            100 * sum(d$grupa == "program") / n_zapis[["program"]],
            100 * sum(d$grupa == "porownawcza") / n_zapis[["porownawcza"]]))

# 3. Tabela wspólna
ms <- function(x) sprintf("%.2f (%.2f)", mean(x), sd(x))
wil <- function(x, n) suppressWarnings(prop.test(x, n, correct = FALSE))$conf.int
for (g in c("program", "porownawcza")) {
  z <- d[d$grupa == g, ]; n <- nrow(z); x <- sum(z$poprawa); w <- 100 * wil(x, n)
  ch <- t.test(z$zmiana)$conf.int
  cat(sprintf("%-12s n = %d | wiek %s | kobiety %d (%.1f%%)\n", g, n, ms(z$wiek), sum(z$kobieta), 100 * mean(z$kobieta)))
  cat(sprintf("  ból przed %s | ból po %s | zmiana %s, 95%% CI [%.2f, %.2f]\n",
              ms(z$bol_przed), ms(z$bol_po), ms(z$zmiana), ch[1], ch[2]))
  cat(sprintf("  poprawa %d/%d = %.1f%%, 95%% CI Wilsona [%.1f, %.1f]\n", x, n, 100 * x / n, w[1], w[2]))
}
A <- d$bol_przed[d$program == 1]; B <- d$bol_przed[d$program == 0]
cat(sprintf("Różnica wyjściowa SMD: %.2f\n\n", (mean(A) - mean(B)) / sqrt((var(A) + var(B)) / 2)))

# 4. Model wspólny: ból po ~ grupa + ból przed (ANCOVA jako regresja)
m <- lm(bol_po ~ program + bol_przed, data = d)
s <- summary(m); ci <- confint(m); wsp <- coef(s)
tt <- wsp["program", "t value"]; df_r <- m$df.residual
cat(sprintf("Model: F(%d, %d) = %.2f, p = %.2g, R2 = %.3f, n = %d\n", s$fstatistic[2], s$fstatistic[3], s$fstatistic[1],
            pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE), s$r.squared, nobs(m)))
for (v in c("program", "bol_przed"))
  cat(sprintf("%-10s b = %.2f, SE = %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, p = %.2g\n",
              v, wsp[v, 1], wsp[v, 2], ci[v, 1], ci[v, 2], df_r, wsp[v, 3], wsp[v, 4]))
ms_b <- lm(scale(bol_po) ~ scale(program) + scale(bol_przed), data = d)
cat(sprintf("Beta: program = %.2f, ból przed = %.2f\n", coef(ms_b)[2], coef(ms_b)[3]))
cat(sprintf("Grupa: F(1, %d) = %.2f, cząstkowe eta2 = %.3f\n", df_r, tt^2, tt^2 / (tt^2 + df_r)))
sr <- tapply(d$bol_po, d$program, mean); nowe <- data.frame(program = 0:1, bol_przed = mean(d$bol_przed))
pr <- predict(m, nowe)
cat(sprintf("Średnie skorygowane po: porównawcza %.2f, program %.2f (surowe %.2f i %.2f)\n", pr[1], pr[2], sr["0"], sr["1"]))

# 5. d: skorygowana różnica / zbiorcze SD wyniku po
n1 <- sum(d$program); n0 <- sum(1 - d$program)
sd_p <- sqrt(((n1 - 1) * var(d$bol_po[d$program == 1]) + (n0 - 1) * var(d$bol_po[d$program == 0])) / (n1 + n0 - 2))
dd <- function(x) {
  f <- lm(bol_po ~ program + bol_przed, data = x); a <- x$program == 1
  s2 <- ((sum(a) - 1) * var(x$bol_po[a]) + (sum(!a) - 1) * var(x$bol_po[!a])) / (nrow(x) - 2)
  coef(f)[["program"]] / sqrt(s2)
}
boot <- replicate(4000, dd(d[c(sample(which(d$program == 1), replace = TRUE),
                               sample(which(d$program == 0), replace = TRUE)), ]))
d_est <- coef(m)[["program"]] / sd_p
cat(sprintf("SD zbiorcze po = %.2f; d = %.2f, 95%% CI z przekształcenia [%.2f, %.2f]; bootstrap [%.2f, %.2f]\n\n",
            sd_p, d_est, ci["program", 1] / sd_p, ci["program", 2] / sd_p, quantile(boot, .025), quantile(boot, .975)))

# 6. Poprawa tak/nie: różnica odsetków (Newcombe), chi-kwadrat, iloraz ryzyk
x <- c(sum(d$poprawa[d$program == 1]), sum(d$poprawa[d$program == 0])); n <- c(n1, n0); p <- x / n
w1 <- wil(x[1], n[1]); w2 <- wil(x[2], n[2]); roz <- p[1] - p[2]
lo <- roz - sqrt((p[1] - w1[1])^2 + (w2[2] - p[2])^2); hi <- roz + sqrt((w1[2] - p[1])^2 + (p[2] - w2[1])^2)
chi <- suppressWarnings(chisq.test(matrix(c(x, n - x), 2), correct = FALSE))
rr <- p[1] / p[2]; se <- sqrt(1 / x[1] - 1 / n[1] + 1 / x[2] - 1 / n[2])
cat(sprintf("Różnica odsetków: %.1f pp., 95%% CI Newcombe'a [%.1f, %.1f]\n", 100 * roz, 100 * lo, 100 * hi))
cat(sprintf("Chi-kwadrat(1, N = %d) = %.2f, p = %.2g; fi = %.2f\n", sum(n), chi$statistic, chi$p.value, sqrt(chi$statistic / sum(n))))
cat(sprintf("RR = %.2f, 95%% CI [%.2f, %.2f]\n", rr, exp(log(rr) - 1.96 * se), exp(log(rr) + 1.96 * se)))

# 7. Skala w jednostkach organizacji (założenia fikcyjne): 4 godziny programu na osobę
g <- 4
cat(sprintf("Na 100 pracowników dodatkowo z poprawą: %.0f (CI %.0f–%.0f)\n", 100 * roz, 100 * lo, 100 * hi))
cat(sprintf("Godziny pracy na 100 osób: %d; na jedną dodatkową osobę z poprawą: %.1f h (zakres z CI %.1f–%.1f h)\n",
            100 * g, g / roz, g / hi, g / lo))
Wynik w R
Zapisani: 74 72  Wypadli: 8 7  Analiza: 66 65  Pomiar końcowy: 131/146 = 89.7%
Pomiar końcowy w grupach: program 89.2%, porównawcza 90.3%

program      n = 66 | wiek 38.02 (9.43) | kobiety 38 (57.6%)
  ból przed 5.52 (1.38) | ból po 3.50 (1.39) | zmiana -2.02 (1.16), 95% CI [-2.30, -1.73]
  poprawa 39/66 = 59.1%, 95% CI Wilsona [47.0, 70.1]
porownawcza  n = 65 | wiek 37.20 (9.60) | kobiety 33 (50.8%)
  ból przed 5.35 (1.43) | ból po 4.32 (1.49) | zmiana -1.04 (1.18), 95% CI [-1.33, -0.75]
  poprawa 13/65 = 20.0%, 95% CI Wilsona [12.1, 31.3]
Różnica wyjściowa SMD: 0.12

Model: F(2, 128) = 59.44, p = 5.5e-19, R2 = 0.482, n = 131
program    b = -0.93, SE = 0.19, 95% CI [-1.30, -0.55], t(128) = -4.88, p = 3.1e-06
bol_przed  b = 0.68, SE = 0.07, 95% CI [0.55, 0.82], t(128) = 10.03, p = 8e-18
Beta: program = -0.31, ból przed = 0.64
Grupa: F(1, 128) = 23.79, cząstkowe eta2 = 0.157
Średnie skorygowane po: porównawcza 4.37, program 3.45 (surowe 4.32 i 3.50)
SD zbiorcze po = 1.44; d = -0.64, 95% CI z przekształcenia [-0.90, -0.38]; bootstrap [-0.93, -0.38]

Różnica odsetków: 39.1 pp., 95% CI Newcombe'a [22.6, 52.7]
Chi-kwadrat(1, N = 131) = 20.90, p = 4.8e-06; fi = 0.40
RR = 2.95, 95% CI [1.75, 5.00]
Na 100 pracowników dodatkowo z poprawą: 39 (CI 23–53)
Godziny pracy na 100 osób: 400; na jedną dodatkową osobę z poprawą: 10.2 h (zakres z CI 7.6–17.7 h)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Lista kontrolna przed wysłaniem rozdziału promotorowi
- Czy wszystkie wersje tego samego wyniku (tabela, tekst, abstrakt) pokazują te same liczby?
- Czy podano liczbę osób w analizie i powód ich ubytku?
- Czy efekt ma jednostki i przedział ufności?
- Czy kolejność akapitu odpowiada zwyczajom Twojej dziedziny i oczekiwaniom promotora?
- Czy próg znaczenia podano z góry i ze źródłem, a przyłożono go do osoby, nie do średniej?
- Czy odsetki mają licznik i mianownik?
- Czy język odpowiada schematowi, zwłaszcza bez losowego przydziału?
- Czy każde przeliczenie na koszty i czas ma jawne założenia?
Dopiero po tym przechodź do tego, co z wyników wynika: podsumowanie wyników zbiera je w jedno miejsce, a dyskusja je interpretuje. Wszystkie liczby i badania we wpisie są fikcyjne.
Najczęstsze pytania
Czy w pracy z pielęgniarstwa trzeba podawać d Cohena?
Zwykle nie jest to warunek, a wymagania ustala promotor. Czytelniejsze są często różnica w punktach i odsetki z mianownikiem. Jeśli promotor prosi o miarę standaryzowaną, dopisz ją obok, a nie zamiast różnicy w jednostkach skali.
Czy mogę w jednej pracy użyć zapisu APA i układu według problemów szczegółowych?
Tak. Układ według problemów dotyczy kolejności podrozdziałów, a zapis APA sposobu podawania liczb. Te dwie rzeczy się nie wykluczają. Przed pisaniem warto pokazać promotorowi jeden gotowy akapit, żeby uzgodnić oba elementy.
Czy średnia zmiana równa progowi MCID oznacza, że grupa osiągnęła poprawę?
Nie można tego tak napisać, jeśli próg dotyczy pojedynczej osoby. Średnia 2.02 punktu w grupie nie mówi, ilu osobom się poprawiło. W przykładzie próg osiągnęło 39 z 66 osób, a różnicę między grupami podano osobno.
Skąd wziąć liczby do przeliczenia wyniku na godziny lub koszty w pracy z zarządzania?
Z dokumentów, które da się wskazać: harmonogramu, stawki lub ewidencji czasu. Założenia wypisz w tekście, a szacunek pokaż z przedziałem. W przykładzie 4 godziny na osobę są fikcyjne, a zmierzono ból, a nie oszczędność czasu.
Czy ten sam wynik może mieć różne p w różnych opisach?
Nie, jeśli to ta sama analiza. Różnice pojawiają się, gdy w tekście podajesz jeden model, a w tabeli inny, na przykład ANCOVA i osobny test na wyniku zmiany. Wybierz analizę główną przed pisaniem, a pozostałe oznacz jako uzupełniające.
Powiązane hasła
Przeczytaj też
Jak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikJak napisać pracę z fizjoterapii
Opis interwencji według TIDieR, mapa ICF, rzetelność pomiaru, MDC i MCID, brak grupy kontrolnej i dyskusja – na fikcyjnym programie ćwiczeń w bólu lędźwiowym, z gotowymi akapitami.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikJeden wynik, pięć dyskusji
Ta sama korelacja i niepotwierdzona hipoteza jako dyskusja z psychologii, pielęgniarstwa, fizjoterapii, pedagogiki i zarządzania: gotowe akapity i komentarze.
Czytaj →PoradnikWstęp w pięciu dziedzinach
Aktywność fizyczna osób starszych w pięciu pełnych wstępach: początek, luka, cel, liczby i komentarz, co typowe dla każdej dziedziny.
Czytaj →PoradnikJedna praca, trzy kierunki
Ten sam temat jako praca z psychologii, pielęgniarstwa i fizjoterapii: fikcyjne fragmenty wszystkich rozdziałów i mapa różnic.
Czytaj →Piszesz rozdział wyników i nie wiesz, jak ująć liczby?
Pomożemy dobrać analizę do hipotez lub problemów badawczych, policzymy efekty i przedziały w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Werner, S., Lanza Abbott, J., Angert, C., Park, J. H., & Kohlhausen, D. (2010). Customer-centric science: Reporting significant research results with rigor, relevance, and practical impact in mind. Organizational Research Methods, 13(3), 515–539. https://doi.org/10.1177/1094428109333339
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Des Jarlais, D. C., Lyles, C., Crepaz, N., & TREND Group. (2004). Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement. American Journal of Public Health, 94(3), 361–366. https://doi.org/10.2105/ajph.94.3.361 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, Article c869. https://doi.org/10.1136/bmj.c869 ● Otwarty dostęp
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Ostelo, R. W. J. G., Deyo, R. A., Stratford, P., Waddell, G., Croft, P., Von Korff, M., Bouter, L. M., & de Vet, H. C. (2008). Interpreting change scores for pain and functional status in low back pain: Towards international consensus regarding minimal important change. Spine, 33(1), 90–94. https://doi.org/10.1097/brs.0b013e31815e3a10 ● Otwarty dostęp: pełny tekst
- Pilch, T., & Bauman, T. (2010). Zasady badań pedagogicznych: Strategie ilościowe i jakościowe (Wyd. 3 popr. i rozsz.). Wydawnictwo Akademickie „Żak”.
- Snapinn, S. M., & Jiang, Q. (2007). Responder analyses and the assessment of a clinically relevant treatment effect. Trials, 8(1), Article 31. https://doi.org/10.1186/1745-6215-8-31 ● Otwarty dostęp
Cytowania BibTeX
@article{aguinis2010customer, author={Aguinis, Herman and Werner, Steve and Lanza Abbott, J{\'e}Anna and Angert, Cory and Park, Joon Hyung and Kohlhausen, Donna}, title={{Customer-centric science: Reporting significant research results with rigor, relevance, and practical impact in mind}}, journal={Organizational Research Methods}, year={2010}, volume={13}, number={3}, pages={515--539}, doi={10.1177/1094428109333339}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{desjarlais2004improving, author={Des Jarlais, Don C. and Lyles, Cynthia and Crepaz, Nicole and {TREND Group}}, title={{Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement}}, journal={American Journal of Public Health}, year={2004}, volume={94}, number={3}, pages={361--366}, doi={10.2105/ajph.94.3.361}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{moher2010consort, author={Moher, David and Hopewell, Sally and Schulz, Kenneth F. and Montori, Victor and Gøtzsche, Peter C. and Devereaux, P. J. and Elbourne, Diana and Egger, Matthias and Altman, Douglas G.}, title={{CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials}}, journal={BMJ}, year={2010}, volume={340}, eid={c869}, doi={10.1136/bmj.c869}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{ostelo2008interpreting, author={Ostelo, Raymond W. J. G. and Deyo, Rick A. and Stratford, P. and Waddell, Gordon and Croft, Peter and Von Korff, Michael and Bouter, Lex M. and de Vet, Henrica C.}, title={{Interpreting change scores for pain and functional status in low back pain: Towards international consensus regarding minimal important change}}, journal={Spine}, year={2008}, volume={33}, number={1}, pages={90--94}, doi={10.1097/brs.0b013e31815e3a10}}@book{pilch2010zasady, author={Pilch, Tadeusz and Bauman, Teresa}, title={{Zasady badań pedagogicznych: Strategie ilościowe i jakościowe}}, year={2010}, edition={Wyd. 3 popr. i rozsz.}, publisher={Wydawnictwo Akademickie „Żak”}}@article{snapinn2007responder, author={Snapinn, Steven M. and Jiang, Qi}, title={{Responder analyses and the assessment of a clinically relevant treatment effect}}, journal={Trials}, year={2007}, volume={8}, number={1}, eid={31}, doi={10.1186/1745-6215-8-31}}