Ten sam wynik, pięć różnych rozdziałów
Dyskusja to część pracy, w której kierunek studiów widać najbardziej. Wyniki można policzyć tak samo, ale na pytanie „co to znaczy?” psycholog, pielęgniarka, fizjoterapeuta, pedagog i menedżer odpowiedzą inaczej. Ten wpis nie powtarza ogólnego układu rozdziału z poradnika jak napisać dyskusję wyników ani przeglądu całej pracy z wpisu jedna praca, trzy kierunki. Bierze jeden wynik i pisze z niego pięć dyskusji, z komentarzem, co w każdej jest typowe i dlaczego.
Opisujemy konwencje spotykane w wielu pracach, a nie reguły. Wymagania uczelni i promotora mają pierwszeństwo. Wpis należy do serii: wstęp w pięciu dziedzinach, pytania czy hipotezy i ten sam wynik opisany na pięć sposobów.
Wspólny punkt wyjścia: dwa fikcyjne wyniki
Program obejmuje 10 spotkań, a badanie 148 osób. Obecność pochodzi z list (odsetek spotkań, na których uczestnik był). Wsparcie otoczenia oceniono ankietą pod koniec programu, więc oba pomiary mają różne źródła, ale kolejność zdarzeń pozostaje niejasna. Kontekst zmienia się pięć razy: poradnictwo psychologiczne, edukacja pacjentów, rehabilitacja, zajęcia szkolne i szkolenia firmowe. Liczby pozostają te same.
| Hipoteza | Wynik | Co oznacza w jednostkach programu |
|---|---|---|
| H1: większe wsparcie wiąże się z regularniejszym udziałem | r = .31, 95% CI [.16, .45], t(146) = 3.94, p < .001, r² = .096 | Różnica 1 SD we wsparciu odpowiada około 5.9 punktu procentowego, czyli 0.6 spotkania na 10 (przybliżone 95% CI [0.3, 0.9]) |
| H2: osoby z doświadczeniem w podobnym programie (n = 62) uczestniczą regularniej niż nowe (n = 86) | 71.9% (SD = 18.3) a 67.6% (SD = 19.7); różnica 4.3 punktu, 95% CI [−1.9, 10.5], t(136.9) = 1.37, p = .174, d = 0.22 | 0.4 spotkania na 10 (95% CI [−0.2, 1.1]); moc 80% dopiero dla d = 0.47, czyli około 9.0 punktu (0.9 spotkania) |
Wszystkie dane i wszystkie cytowania „[autorzy, rok]” w tym wpisie są fikcyjne. Przedział dla korelacji liczymy przez transformację Fishera (kod na końcu wpisu).
Co jest wspólne, a co się zmienia
Docherty i Smith (1999) proponują porządek, który dobrze przenosi się między dziedzinami: główny wynik, mocne i słabe strony badania, porównanie z innymi badaniami, znaczenie wyniku, pytania otwarte. STROBE, czyli wytyczne dla badań obserwacyjnych, ma w dyskusji osobne punkty dotyczące ostrożnej interpretacji i możliwości uogólniania (von Elm i in., 2007). Te elementy pojawiają się w każdej z pięciu wersji. Najbardziej zmienia się ostatni krok (rysunek 1).
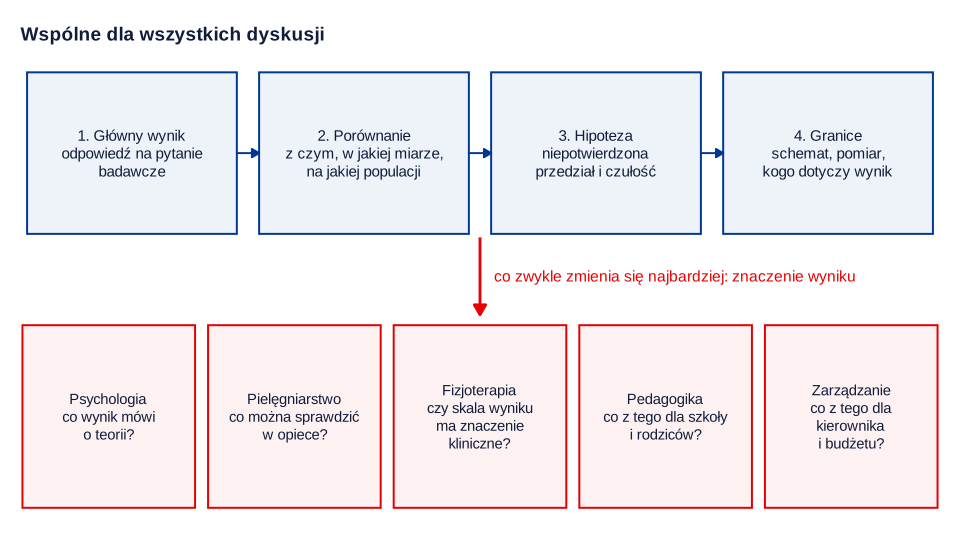
Pięć dyskusji jednego wyniku
Psychologia: poradnictwo psychologiczne i wkład teoretyczny
Co tu jest typowe i dlaczego. Tekst często zaczyna się od hipotezy i wraca do teorii, bo praca ma powiedzieć coś o wyjaśnieniu zjawiska (to obserwacja ogólna, więcej we wpisie jak napisać pracę z psychologii). Stąd miejsce na mechanizm, którego nie zmierzono. Wielkość efektu odnosi się do dziedziny: w badaniach różnic indywidualnych Gignac i Szodorai (2016) proponują traktować r = .30 jako wartość względnie dużą, co omawiamy w tekście czy korelacja .30 to dużo. Dane i cytowania w tym fragmencie są fikcyjne.
Pielęgniarstwo: edukacja pacjentów i praktyka bez przesady
Co tu jest typowe i dlaczego. W wielu pracach ciężar leży na pytaniu, co wynik znaczy dla opieki (zob. jak napisać pracę z pielęgniarstwa). Tu najłatwiej o przesadę. Prasad i in. (2013) przejrzeli badania obserwacyjne z czterech czołowych czasopism medycznych z 2010 roku: w 56% autorzy zalecali konkretną praktykę, a tylko w 14% z tych prac dodawali, że wymaga ona potwierdzenia w badaniu randomizowanym. Dlatego fragment mówi „można rozważyć” i oddziela to, co zaobserwowano, od tego, czego nie sprawdzano. Dane i cytowania w tym fragmencie są fikcyjne.
Fizjoterapia: rehabilitacja i znaczenie kliniczne
Co tu jest typowe i dlaczego. Pierwsze pytanie brzmi często „czy to ma znaczenie dla pacjenta?”, więc tekst przelicza wynik na sesje i zaczyna od tego, czym ta miara jest. Kazdin (1999) podkreśla, że ocenę znaczenia klinicznego trzeba wiązać z celami terapii, a tu celem nie była frekwencja. Dlatego fragment nie przykłada progu MCID do obecności, choć w pracy o efektach programu byłby na miejscu (zob. jak napisać pracę z fizjoterapii). Dane i cytowania w tym fragmencie są fikcyjne.
Pedagogika: zajęcia szkolne i wnioski dla szkoły
Co tu jest typowe i dlaczego. Przy polskiej konwencji problemów głównych i szczegółowych dyskusja często idzie po kolei za problemami, a kończy się wnioskami dla szkoły. Pokusa to zdanie „jeśli nauczyciele zrobią X, uczniowie zrobią Y”. Robinson i in. (2007) odnotowali, że w artykułach o nauczaniu i uczeniu się opartych na badaniach bez interwencji takie stwierdzenia przyczynowe pojawiły się w 34% prac z 1994 roku i w 43% z 2004 roku. Dane i cytowania w tym fragmencie są fikcyjne.
Zarządzanie: szkolenia firmowe i implikacje menedżerskie
Co tu jest typowe i dlaczego. Czytelnik chce przełożenia na jednostki biznesowe (zob. jak napisać pracę z zarządzania i ekonomii), dlatego pojawia się liczba obecności. Nie ma jednak wyliczenia zysku, bo musiałoby zakładać związek przyczynowy. Bartunek i Rynes (2010), analizując sekcje „implikacje dla praktyki” w czasopismach z zarządzania, opisują wyraźne rozbieżności co do tego, czy i na ile takie sekcje mają przybliżać badania praktykom. Skromna, sprawdzalna propozycja jest więc bezpieczniejsza niż lista zaleceń. Dane i cytowania w tym fragmencie są fikcyjne.
Pięć dyskusji w jednej tabeli
| Dziedzina | Często zaczyna od | Porównuje zwykle z | Na końcu omawia | Typowa przesada |
|---|---|---|---|---|
| Psychologia | Hipotezy i przewidywań teorii | Badaniami tego samego konstruktu i wielkościami efektu | Wkład teoretyczny, badanie mechanizmu | „Potwierdzono model”, gdy mechanizmu nie mierzono |
| Pielęgniarstwo | Problemu w opiece | Badaniami podobnych pacjentów i placówek | Znaczenie dla praktyki, granice uogólniania | Zalecenie zmiany postępowania na podstawie korelacji |
| Fizjoterapia | Miary i jej skali | Badaniami o podobnym programie i dawce | Znaczenie kliniczne | Korzyść kliniczna bez pomiaru efektu |
| Pedagogika | Problemu szczegółowego | Badaniami podobnego etapu edukacji | Wnioski dla szkoły | „Jeśli nauczyciele X, uczniowie Y” |
| Zarządzanie | Modelu i luki | Badaniami w podobnych organizacjach i branżach | Implikacje menedżerskie | Wyliczanie zysku ze związku |
Tabela to obserwacja ogólna, nie standard. Przed pisaniem przejrzyj kilka obronionych prac ze swojego kierunku i zapytaj promotora, czy implikacje mają być osobnym podrozdziałem.
Jak zachować język nieprzyczynowy
Korelacja nie przestaje być korelacją dlatego, że dziedzina jest praktyczna (zob. korelacja a przyczynowość oraz badanie korelacyjne w pracy). Trzy zasady działają we wszystkich pięciu wersjach:
- Czasowniki związku. „Wiązało się z”, „współwystępowało z”, „osoby o wyższym X częściej Y”. Unikaj: „wpływa”, „zwiększa”, „dzięki”, „prowadzi do”.
- Wymień konkurencyjne wyjaśnienie. Tutaj odwrotny kierunek zależności oraz zmienną zakłócającą (motywacja, stan zdrowia, obciążenie pracą). Nazwij je, a nie pisz ogólnie o „innych czynnikach”.
- Rekomendację zamień w coś do sprawdzenia. Zamiast „należy wprowadzić” napisz „można rozważyć i sprawdzić w badaniu z grupą porównawczą”. Szerzej o tym we wpisie o wnioskach i rekomendacjach.
Jak omówić hipotezę, która się nie potwierdziła
Nieistotny wynik nie jest dowodem braku różnicy (Greenland i in., 2016). Jak postępować z nim krok po kroku, opisują wpisy hipoteza się nie potwierdziła i jak opisać wynik nieistotny. W dyskusji wystarczą trzy ruchy, które widać w każdym z pięciu fragmentów: napisz wprost, że hipotezy nie potwierdzono, zinterpretuj przedział ufności w jednostkach programu i powiedz, czego wynik nie rozstrzyga (rysunek 2). Jeśli chcesz twierdzić, że różnicy o praktycznym znaczeniu nie ma, potrzebujesz testu równoważności z granicami ustalonymi przed analizą.
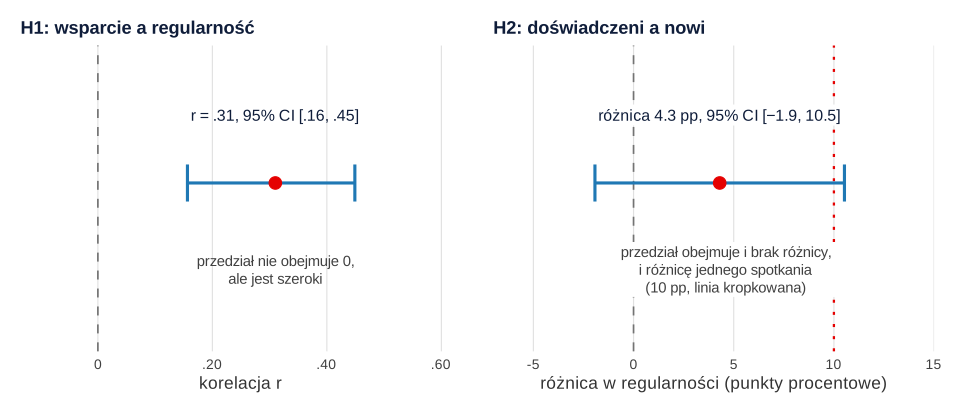
Osobną pułapką jest porównywanie podgrup przez wartości p. Załóżmy, że student liczy korelację osobno w obu grupach: u osób nowych r = .37 (n = 86, p < .001), a u doświadczonych r = .23 (n = 62, p = .072). Kusi zdanie „związek występuje tylko u nowych”. Gelman i Stern (2006) pokazują, że taka zmiana istotności sama nie musi być istotna. Bezpośrednie porównanie obu korelacji daje z = 0.91, p = .365, więc dane nie wskazują na różnicę między nimi (zob. jak porównać dwie korelacje i analiza podgrup – kiedy jej wierzyć).
Z czym porównywać
Dziedziny różnią się tym, co uznają za „podobne badanie”. W każdej z nich porównuj miarę z miarą: korelację z korelacją, a odsetek spotkań z odsetkiem liczonym tak samo. Sprawdź, czy populacja, program i sposób pomiaru pozwalają zestawić wyniki, a rozbieżności tłumacz ostrożnie. Docherty i Smith (1999) radzą nie udawać, że znasz ich przyczynę. Jak przeliczyć wyniki z artykułów na jedną miarę, pokazuje wpis porównanie wyników z literaturą, a jak mówić o granicach własnego badania – ograniczenia badania.
Jak bywa napisane i jak to poprawić
| Jak bywa napisane | Co nie tak | Poprawione |
|---|---|---|
| „Wsparcie bliskich zwiększa regularność korzystania z poradnictwa, co potwierdza model.” | Język przyczynowy przy korelacji; mechanizmu nie mierzono | „Wyższe wsparcie wiązało się z regularniejszym udziałem, co jest zgodne z modelem, ale nie testuje jego przyczynowej części.” |
| „Należy obowiązkowo włączać rodzinę do edukacji pacjentów.” | Zalecenie zmiany praktyki na podstawie związku z jednej placówki | „Pytanie o wsparcie rodziny można rozważyć w rozmowie przed edukacją; korzyść z angażowania rodziny wymaga sprawdzenia w badaniu z grupą porównawczą.” |
| „Większe wsparcie przynosi korzyść kliniczną, ponieważ pacjenci odbywają więcej sesji.” | Frekwencja nie jest miarą efektu | „Większe wsparcie wiązało się z udziałem w większej liczbie sesji; związku z efektem programu nie badano.” |
| „Wykazano, że doświadczenie nie ma znaczenia dla frekwencji uczniów.” | Brak istotności potraktowany jak dowód braku różnicy | „Nie potwierdzono różnicy; przedział ufności obejmuje zarówno jej brak, jak i różnicę rzędu jednego spotkania.” |
| „Zwiększenie wsparcia przełożonych o 1 SD da firmie 59 dodatkowych obecności na 1000.” | Przeliczenie związku na skutek działania | „Osoby o wsparciu wyższym o 1 SD uczestniczyły średnio w około 0.6 spotkania więcej; nie wiadomo, czy zmiana wsparcia przyniosłaby taki sam skutek.” |
Zdania są fikcyjne i służą wyłącznie do ćwiczenia.
Najczęstsze błędy
- Wymiana dziedziny tylko w nagłówku: ta sama dyskusja z dopisanym zdaniem o „praktyce”.
- Omówienie wyłącznie hipotezy potwierdzonej, a niepotwierdzonej jednym zdaniem albo wcale.
- Porównywanie wartości p z literaturą zamiast wielkości efektu.
- Implikacje, które nie mają związku ze zmiennymi w badaniu.
- Znaczenie kliniczne lub praktyczne ogłoszone bez miary, która mogłaby je pokazać.
- Uogólnianie z jednej placówki lub firmy na całą grupę zawodową.
Liczby z tego wpisu w R
Skrypt odtwarza wszystkie liczby z tekstu z fikcyjnych statystyk podsumowujących (bez danych surowych), więc wynik jest za każdym razem taki sam. Rysunki powstały w osobnym skrypcie na tych samych liczbach.
Przedział dla korelacji, test Welcha z podsumowań, czułość i podgrupy
R
# B476 – jeden fikcyjny wynik do pięciu dyskusji: przedziały ufności, podgrupy i skala wyniku
library(pwr)

n <- 148; r <- .31             # H1: wsparcie otoczenia a odsetek spotkań, na których uczestnik był
n1 <- 62; m1 <- 71.9; s1 <- 18.3  # H2: osoby z wcześniejszym doświadczeniem podobnego programu
n2 <- 86; m2 <- 67.6; s2 <- 19.7  # H2: osoby uczestniczące po raz pierwszy
spotkania <- 10                # liczba spotkań w programie (1 spotkanie = 10 punktów procentowych)

bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))  # zapis bez zera wiodącego

# H1: przedział ufności z transformacji Fishera i test korelacji
ci_r <- function(r, n, poziom = .95) {
  z <- atanh(r); se <- 1 / sqrt(n - 3); k <- qnorm(1 - (1 - poziom) / 2)
  tanh(c(z - k * se, z + k * se))
}
p_r <- function(r, n) { t <- r * sqrt((n - 2) / (1 - r^2)); 2 * pt(-abs(t), n - 2) }
t_r <- r * sqrt((n - 2) / (1 - r^2)); ci <- ci_r(r, n)
cat(sprintf("H1: r = %s, 95%% CI [%s, %s], t(%d) = %.2f, p = %s, r^2 = %s\n",
            bz(r), bz(ci[1], 3), bz(ci[2], 3), n - 2, t_r, bz(p_r(r, n), 5), bz(r^2, 3)))

# H2: test Welcha z podsumowań i standaryzowana różnica
roznica <- m1 - m2
se <- sqrt(s1^2 / n1 + s2^2 / n2)
df <- se^4 / ((s1^2 / n1)^2 / (n1 - 1) + (s2^2 / n2)^2 / (n2 - 1))
t_w <- roznica / se; p_w <- 2 * pt(-abs(t_w), df)
ci_w <- roznica + c(-1, 1) * qt(.975, df) * se
s_p <- sqrt(((n1 - 1) * s1^2 + (n2 - 1) * s2^2) / (n1 + n2 - 2)); d <- roznica / s_p
cat(sprintf("H2: różnica = %.1f pp, 95%% CI [%.2f, %.2f], t(%.1f) = %.2f, p = %s, d = %.2f\n",
            roznica, ci_w[1], ci_w[2], df, t_w, bz(p_w, 3), d))
cat(sprintf("H2 w spotkaniach: różnica %.2f, 95%% CI [%.2f, %.2f] z %d spotkań\n",
            roznica / 100 * spotkania, ci_w[1] / 100 * spotkania, ci_w[2] / 100 * spotkania, spotkania))

# Czułość: jaki efekt badanie mogło wykryć z mocą 80%
d80 <- pwr.t2n.test(n1 = n1, n2 = n2, power = .80, sig.level = .05)$d
cat(sprintf("Czułość H2: moc 80%% dla d = %.2f, czyli około %.1f pp (%.2f spotkania)\n",
            d80, d80 * s_p, d80 * s_p / 100 * spotkania))

# Skala H1: ile spotkań odpowiada różnicy 1 SD we wsparciu (przybliżenie przy znanym SD wyniku)
m_all <- (n1 * m1 + n2 * m2) / n
sd_all <- sqrt(((n1 - 1) * s1^2 + (n2 - 1) * s2^2 + n1 * (m1 - m_all)^2 + n2 * (m2 - m_all)^2) / (n - 1))
b <- c(r, ci) * sd_all
cat(sprintf("Regularność ogółem: M = %.1f, SD = %.1f\n", m_all, sd_all))
cat(sprintf("Różnica 1 SD we wsparciu: %.1f pp [%.1f, %.1f], czyli %.2f spotkania [%.2f, %.2f]\n",
            b[1], b[2], b[3], b[1] / 100 * spotkania, b[2] / 100 * spotkania, b[3] / 100 * spotkania))
cat(sprintf("Na 100 osób i %d spotkań: około %.0f obecności więcej na %d planowanych\n",
            spotkania, b[1] / 100 * spotkania * 100, spotkania * 100))

# Pułapka: korelacja osobno w podgrupach i właściwe porównanie obu korelacji
r_a <- .37; n_a <- n2; r_b <- .23; n_b <- n1
ci_a <- ci_r(r_a, n_a); ci_b <- ci_r(r_b, n_b)
z_roz <- (atanh(r_a) - atanh(r_b)) / sqrt(1 / (n_a - 3) + 1 / (n_b - 3))
cat(sprintf("Po raz pierwszy: r = %s, n = %d, 95%% CI [%s, %s], p = %s\n", bz(r_a), n_a, bz(ci_a[1]), bz(ci_a[2]), bz(p_r(r_a, n_a), 4)))
cat(sprintf("Z doświadczeniem: r = %s, n = %d, 95%% CI [%s, %s], p = %s\n", bz(r_b), n_b, bz(ci_b[1]), bz(ci_b[2]), bz(p_r(r_b, n_b), 3)))
cat(sprintf("Różnica korelacji: z = %.2f, p = %s\n", z_roz, bz(2 * pnorm(-abs(z_roz)), 3)))
Wynik w R
H1: r = .31, 95% CI [.156, .449], t(146) = 3.94, p = .00013, r^2 = .096
H2: różnica = 4.3 pp, 95% CI [-1.93, 10.53], t(136.9) = 1.37, p = .174, d = 0.22
H2 w spotkaniach: różnica 0.43, 95% CI [-0.19, 1.05] z 10 spotkań
Czułość H2: moc 80% dla d = 0.47, czyli około 9.0 pp (0.90 spotkania)
Regularność ogółem: M = 69.4, SD = 19.2
Różnica 1 SD we wsparciu: 5.9 pp [3.0, 8.6], czyli 0.59 spotkania [0.30, 0.86]
Na 100 osób i 10 spotkań: około 59 obecności więcej na 1000 planowanych
Po raz pierwszy: r = .37, n = 86, 95% CI [.17, .54], p = .0005
Z doświadczeniem: r = .23, n = 62, 95% CI [-.02, .45], p = .072
Różnica korelacji: z = 0.91, p = .365
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem pwr; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3-0): Champely, S. (2020). pwr: Basic functions for power analysis [R package]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz dyskusję, sprawdź…
- Czy pierwszy akapit odpowiada na pytanie badawcze i mówi, które hipotezy się potwierdziły?
- Czy każde zdanie o związku przekrojowym używa języka związku?
- Czy wymieniono konkretne konkurencyjne wyjaśnienia?
- Czy wynik niepotwierdzony ma przedział ufności i ocenę czułości badania?
- Czy porównujesz miary tego samego rodzaju i na podobnych populacjach?
- Czy znaczenie wyniku (teoretyczne, praktyczne, kliniczne, dla szkoły, menedżerskie) wynika z tego, co zmierzono?
- Czy zalecenia są sformułowane jako propozycje do sprawdzenia?
- Czy układ rozdziału zgadza się z wymaganiami uczelni i promotora?
Najczęstsze pytania
Czy przy korelacji r = .31 mogę napisać w dyskusji o wpływie zmiennej?
Nie, jeśli zmiennych nie manipulowano. Napisz, że wyższe wartości jednej zmiennej wiązały się z wyższymi wartościami drugiej, i wymień konkurencyjne wyjaśnienia: odwrotny kierunek zależności oraz zmienną zakłócającą. Ta zasada obowiązuje we wszystkich dziedzinach, także w tych nastawionych na praktykę.
Jak omówić w dyskusji niepotwierdzoną hipotezę o różnicy między grupami?
Napisz wprost, że hipotezy nie potwierdzono, zinterpretuj przedział ufności w jednostkach zmiennej i wskaż, czego badanie nie rozstrzyga. W przykładzie różnica wyniosła 4.3 punktu procentowego, a przedział od −1.9 do 10.5, więc dane są zgodne i z brakiem różnicy, i z różnicą jednego spotkania na dziesięć.
Czy dyskusja w pracy z pielęgniarstwa musi zawierać znaczenie dla praktyki?
W wielu pracach tak się robi, ale wymagania określa uczelnia i promotor. Jeśli piszesz o praktyce przy danych obserwacyjnych, formułuj to jako coś do rozważenia i sprawdzenia, a nie jako zalecenie zmiany postępowania.
Czy frekwencję na sesjach można odnieść do MCID?
Zwykle nie. Minimalna istotna klinicznie różnica dotyczy miary efektu, na przykład bólu czy funkcji, a nie liczby odbytych sesji. Frekwencję opisz jako realizację zaplanowanej dawki i przelicz ją na sesje, ale nie wnioskuj z niej o korzyści klinicznej, jeśli efektu nie mierzono.
Czy implikacje menedżerskie można przeliczyć na pieniądze?
Tylko gdy masz dane i schemat, które na to pozwalają. Związku z badania korelacyjnego nie należy przeliczać na zysk z działania, bo takie wyliczenie zakłada przyczynowość. Bezpieczniej podać skalę zjawiska w jednostkach organizacji i zaproponować pilotaż z grupą porównawczą.
Powiązane hasła
Przeczytaj też
Jak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikOgraniczenia badania – jak je opisać
Jak znaleźć ograniczenia, ocenić kierunek i wielkość błędu, wybrać najważniejsze i opisać je konkretnie. Przykład ankiety online z liczbami z R.
Czytaj →PoradnikPorównanie wyników z literaturą
Jak przeliczyć średnie i SD, t, F, r i OR z artykułów na g Hedgesa z przedziałem ufności, zestawić je z własnym wynikiem na jednym wykresie i napisać o tym w dyskusji – z przykładem w R.
Czytaj →PoradnikJedna praca, trzy kierunki
Ten sam temat jako praca z psychologii, pielęgniarstwa i fizjoterapii: fikcyjne fragmenty wszystkich rozdziałów i mapa różnic.
Czytaj →Piszesz dyskusję i nie wiesz, co wolno napisać na podstawie swoich wyników?
Sprawdzimy analizy w R lub SPSS, policzymy przedziały ufności i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bartunek, J. M., & Rynes, S. L. (2010). The construction and contributions of “implications for practice”: What’s in them and what might they offer? Academy of Management Learning & Education, 9(1), 100–117. https://doi.org/10.5465/amle.9.1.zqr100
- Docherty, M., & Smith, R. (1999). The case for structuring the discussion of scientific papers. BMJ, 318(7193), 1224–1225. https://doi.org/10.1136/bmj.318.7193.1224 ● Otwarty dostęp: pełny tekst
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74–78. https://doi.org/10.1016/j.paid.2016.06.069
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Kazdin, A. E. (1999). The meanings and measurement of clinical significance. Journal of Consulting and Clinical Psychology, 67(3), 332–339. https://doi.org/10.1037/0022-006x.67.3.332
- Prasad, V., Jorgenson, J., Ioannidis, J. P. A., & Cifu, A. (2013). Observational studies often make clinical practice recommendations: An empirical evaluation of authors' attitudes. Journal of Clinical Epidemiology, 66(4), 361–366.e4. https://doi.org/10.1016/j.jclinepi.2012.11.005
- Robinson, D. H., Levin, J. R., Thomas, G. D., Pituch, K. A., & Vaughn, S. (2007). The incidence of “causal” statements in teaching-and-learning research journals. American Educational Research Journal, 44(2), 400–413. https://doi.org/10.3102/0002831207302174
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@article{bartunek2010construction, author={Bartunek, Jean M. and Rynes, Sara L.}, title={{The construction and contributions of “implications for practice”: What’s in them and what might they offer?}}, journal={Academy of Management Learning \& Education}, year={2010}, volume={9}, number={1}, pages={100--117}, doi={10.5465/amle.9.1.zqr100}}@article{docherty1999case, author={Docherty, Michael and Smith, Richard}, title={{The case for structuring the discussion of scientific papers}}, journal={BMJ}, year={1999}, volume={318}, number={7193}, pages={1224--1225}, doi={10.1136/bmj.318.7193.1224}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{gignac2016effect, author={Gignac, Gilles E. and Szodorai, Eva T.}, title={{Effect size guidelines for individual differences researchers}}, journal={Personality and Individual Differences}, year={2016}, volume={102}, pages={74--78}, doi={10.1016/j.paid.2016.06.069}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{kazdin1999meanings, author={Kazdin, Alan E.}, title={{The meanings and measurement of clinical significance}}, journal={Journal of Consulting and Clinical Psychology}, year={1999}, volume={67}, number={3}, pages={332--339}, doi={10.1037/0022-006x.67.3.332}}@article{prasad2013observational, author={Prasad, Vinay and Jorgenson, Joel and Ioannidis, John P. A. and Cifu, Adam}, title={{Observational studies often make clinical practice recommendations: An empirical evaluation of authors' attitudes}}, journal={Journal of Clinical Epidemiology}, year={2013}, volume={66}, number={4}, pages={361--366.e4}, doi={10.1016/j.jclinepi.2012.11.005}}@article{robinson2007incidence, author={Robinson, Daniel H. and Levin, Joel R. and Thomas, Greg D. and Pituch, Keenan A. and Vaughn, Sharon}, title={{The incidence of “causal” statements in teaching-and-learning research journals}}, journal={American Educational Research Journal}, year={2007}, volume={44}, number={2}, pages={400--413}, doi={10.3102/0002831207302174}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}