Do czego służą tabele niestandardowe
W pracy dyplomowej rzadko wystarcza jedna tabela krzyżowa. Zwykle chcesz w jednej tabeli pokazać płeć, tryb studiów i średni wynik skali w kilku grupach. Crosstabs daje osobną tabelę dla każdej pary zmiennych, a średnie – inna procedura. Tabele niestandardowe (Custom Tables) budują całość w jednym oknie: przeciągasz zmienne do wierszy i kolumn, wybierasz statystyki i możesz dodać testy.
Nazwy menu i opcji podajemy po angielsku według dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b). Polska dokumentacja nazywa procedurę „Tabele użytkownika”, miejscami „Tabele niestandardowe”, a ścieżkę menu zostawia po angielsku. Polski interfejs może używać innych nazw. Według dokumentacji tabele niestandardowe należą do SPSS Statistics Standard Edition albo do opcji Custom Tables (IBM Corp., b.d.-b). Jeśli tej pozycji nie ma w menu, zobacz część Czego tabele niestandardowe nie zrobią.
Test chi-kwadrat z resztami i testem Fishera omawia wpis chi-kwadrat w SPSS, treść Tabeli 1 – Tabela 1 – charakterystyka próby, a pozostałe wydruki – jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Fikcyjna ankieta objęła 300 osób z trzech kierunków: pielęgniarstwa (n = 104), psychologii (n = 112) i zarządzania (n = 84). Zmienne: płeć, tryb studiów, lęk przed statystyką (10–50 pkt; u 9 osób brak) i pytanie „Z jakich źródeł korzystasz, ucząc się statystyki? (zaznacz wszystkie, które pasują)” z pięcioma opcjami zapisanymi jako zmienne 0/1.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav. Liczby w tabelach pochodzą z kodu R na końcu wpisu.
Przygotowanie danych: poziom pomiaru i zestaw odpowiedzi
Poziom pomiaru decyduje o tym, co pojawi się w komórce. Custom Tables traktuje zmienne nominalne i porządkowe jako kategorialne i domyślnie pokazuje dla nich liczebności. Zmienne ilościowe (Scale) dostają domyślnie średnią (IBM Corp., b.d.-b). Ustaw więc w Variable View kolumnę Measure: kierunek, plec i tryb – Nominal, lek – Scale. Bez etykiet wartości podgląd pokaże zastępcze „Category 1” i „Category 2” (IBM Corp., b.d.-b). Etykiety i braki danych ustawisz według wpisu przygotowanie danych w SPSS.
Pytanie wielokrotnego wyboru wymaga zestawu z menu Data. Wybierz Data → Define Multiple Response Sets (w polskiej dokumentacji: Dane → Zdefiniuj wiele zestawów odpowiedzi). Zaznacz pięć zmiennych zr_…, wybierz Dichotomies, w polu Counted Value wpisz 1, nadaj nazwę zrodla i kliknij Add. SPSS doda znak $ na początku nazwy. Jako źródło etykiet kategorii wybierz etykiety zmiennych (IBM Corp., b.d.-c). Zestaw zapiszesz w pliku .sav.
Uwaga na pułapkę: zestaw z Analyze → Multiple Response → Define Variable Sets (tak jak we wpisie pytania wielokrotnego wyboru – jak policzyć) działa tylko w procedurach wielokrotnych odpowiedzi i nie pojawi się w Custom Tables (IBM Corp., b.d.-c). Zmienne 0/1 z eksportu formularza przygotujesz według wpisu dane z Google Forms i LimeSurvey.
Budowa tabeli: przeciąganie, układanie, zagnieżdżanie
- Analyze → Tables → Custom Tables (IBM Corp., b.d.-b). Po lewej jest lista zmiennych, po prawej kanwa (canvas) z podglądem układu tabeli.
- Kolumny. Przeciągnij
kierunekdo obszaru Columns. Grupy, które porównujesz, umieszczaj w kolumnach, bo tylko wtedy zadziałają testy z karty Test Statistics (więcej niżej). - Wiersze. Przeciągnij
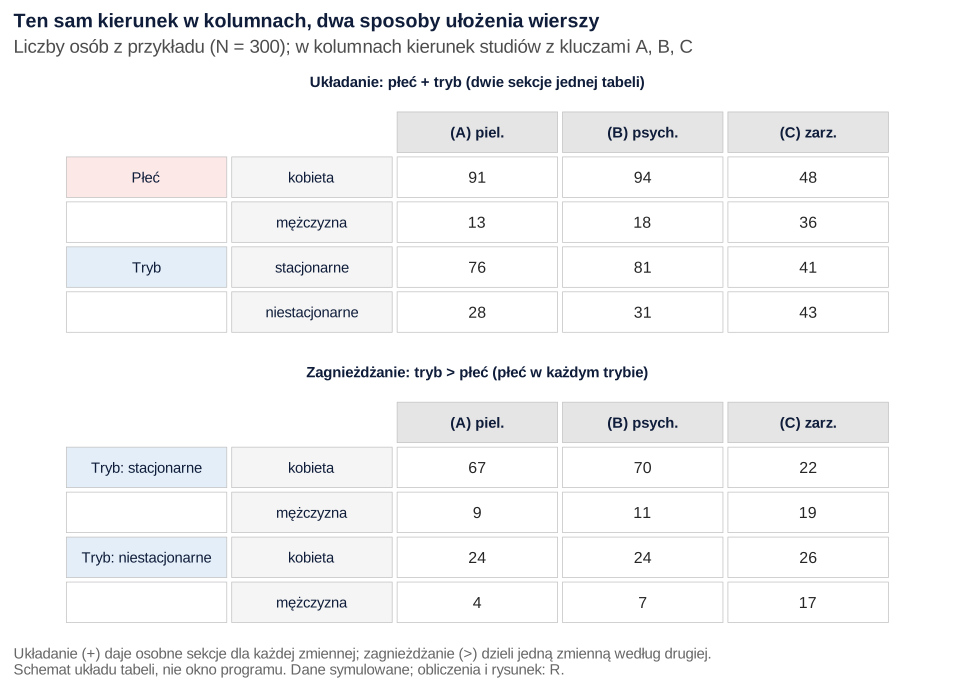
plecdo obszaru Rows, atrybupuść pod nią. Tak powstaje układanie (stacking): dwie sekcje jednej tabeli, każda z własnymi odsetkami. Gdy upuścisztrybobokplec, powstanie zagnieżdżanie (nesting): płeć osobno dla każdego trybu (IBM Corp., b.d.-b). Do tabeli charakterystyki próby zwykle potrzebujesz układania (rysunek 1). - Zmienna ilościowa.
lekwygodniej ująć w drugiej tabeli. Zmiennej ilościowej nie zagnieździsz w innej ilościowej (IBM Corp., b.d.-b). - Sumy. Kliknij prawym przyciskiem
kierunek, wybierz Categories and Totals i zaznacz Total. Dostaniesz kolumnę dla całej próby. - Paste zamiast OK. Przycisk Paste wkleja polecenie CTABLES do edytora składni. Zapisana składnia odtworzy tabelę po poprawkach w danych (IBM Corp., b.d.-b).
Statystyki w komórkach: liczebności, odsetki, średnie
Kliknij prawym przyciskiem plec na kanwie i wybierz Summary Statistics. Do listy Display dodaj Column N % obok Count, a potem kliknij Apply to All, żeby to samo dostała zmienna tryb (IBM Corp., b.d.-b). Column N % to odsetek w obrębie kolumny, czyli tu: jaka część danego kierunku to kobiety. Row N % odpowiada na inne pytanie: jaka część kobiet studiuje dany kierunek.
Dla zmiennej lek wybierz Mean, Standard Deviation i Valid N. Count liczy przypadki razem z brakami, a Valid N mówi, z ilu wyników policzono średnią (IBM Corp., b.d.-b) – tu 291 z 300. Średnia dostaje domyślnie format zmiennej z edytora danych, więc w kolumnie Format wybierz nnnn i 2 miejsca po przecinku.
Wynik z testami z następnej sekcji (litera to klucz kolumny o istotnie mniejszej wartości):
| pielęgniarstwo (A) | psychologia (B) | zarządzanie (C) | Total | |||||
|---|---|---|---|---|---|---|---|---|
| Count | Column N % | Count | Column N % | Count | Column N % | Count | Column N % | |
| Płeć: kobieta | 91 | 87.5% C | 94 | 83.9% C | 48 | 57.1% | 233 | 77.7% |
| Płeć: mężczyzna | 13 | 12.5% | 18 | 16.1% | 36 | 42.9% AB | 67 | 22.3% |
| Tryb: stacjonarne | 76 | 73.1% C | 81 | 72.3% C | 41 | 48.8% | 198 | 66.0% |
| Tryb: niestacjonarne | 28 | 26.9% | 31 | 27.7% | 43 | 51.2% AB | 102 | 34.0% |
| pielęgniarstwo (A) | psychologia (B) | zarządzanie (C) | Total | |
|---|---|---|---|---|
| Mean | 31.86 B | 29.08 | 31.07 | 30.61 |
| Standard Deviation | 8.07 | 8.10 | 7.60 | 8.02 |
| Valid N | 102 | 108 | 81 | 291 |
Testy w tabeli: karta Test Statistics
Karta Test Statistics (w polskiej dokumentacji „Testy”) ma trzy rodzaje testów (IBM Corp., b.d.-b):
- Tests of independence (Chi-square) – chi-kwadrat Pearsona dla każdej sekcji tabeli. Tu: płeć × kierunek χ²(2) = 28.73, tryb × kierunek χ²(2) = 15.38; SPSS wypisze „Sig. = .000”, a w pracy piszesz p < .001.
- Compare column proportions (z-tests) – testy z dla każdej pary kolumn w każdym wierszu (zob. test dla dwóch proporcji).
- Compare column means (t-tests) – testy t dla par kolumn. Wymagają zmiennej ilościowej w wierszach, kategorialnej w kolumnach i średniej wśród statystyk.
Przy porównaniach par wybierasz poziom istotności i korektę. Korekta Bonferroniego chroni przed choćby jednym fałszywym alarmem w rodzinie testów. Korekta Benjaminiego–Hochberga kontroluje odsetek fałszywych odkryć i jest mniej zachowawcza (IBM Corp., b.d.-a; Benjamini i Hochberg, 1995; zob. procedura Benjaminiego–Hochberga). W przykładzie z dokumentacji korekta Bonferroniego obejmuje pary kolumn w obrębie jednego wiersza. Przy trzech kierunkach to trzy pary na wiersz (IBM Corp., b.d.-b).
Jak czytać litery. Każda kolumna dostaje klucz (A, B, C). Przy oznaczeniu w tabeli głównej klucz kolumny o mniejszym odsetku lub średniej pojawia się w kolumnie o większej. „87.5% C” przy pielęgniarstwie znaczy więc, że odsetek kobiet jest tu istotnie większy niż na zarządzaniu (57.1%). Brak „B” oznacza, że różnicy z psychologią (83.9%) test nie wykazał. Opcja Use APA-style subscripts zamiast tego daje indeksy dolne. Wartości z różnymi literami w indeksie różnią się istotnie. Wartości p zobaczysz w wariancie z osobną tabelą (Display significance values).
Średni lęk różni się istotnie tylko między pielęgniarstwem a psychologią (31.86 wobec 29.08; p = .036 po korekcie Bonferroniego). Dla porównania jednoczynnikowa ANOVA daje F(2, 288) = 3.39, p = .035, η² = .02. Efekt jest mały, a litery nie zastąpią wielkości efektu (zob. ANOVA w SPSS).
Kiedy testy w tabeli to zły pomysł. Dziesięć zmiennych i trzy grupy to dziesiątki niezaplanowanych testów. Testuj tylko różnice, o które pytają hipotezy (zob. czy muszę stosować poprawkę). Przy losowym przydziale do grup testy charakterystyki wyjściowej nie mają sensu (zob. Tabela 1).
Pytanie wielokrotnego wyboru w tabeli
Zestaw $zrodla przeciągasz do wierszy jak zwykłą zmienną kategorialną. W Summary Statistics wybierz Count i Column N %. Przy zestawie odpowiedzi podstawą Column N % jest liczba osób w kolumnie, więc odsetki w kolumnie sumują się do ponad 100% (IBM Corp., b.d.-a). Tu kolumna Total daje 264.3%, bo przeciętna osoba zaznaczyła 2.64 opcji. Statystyki z przyrostkiem Responses % mają w mianowniku liczbę zaznaczeń. Filmy to 26.0% odpowiedzi, ale 68.7% osób. W pracy zwykle podajesz odsetek osób (zob. tabela i wykres dla pytania wielokrotnego wyboru).
| pielęgniarstwo (A) | psychologia (B) | zarządzanie (C) | Total | |
|---|---|---|---|---|
| Wykład i ćwiczenia | 72 (69.2%) | 80 (71.4% C) | 46 (54.8%) | 198 (66.0%) |
| Podręcznik | 57 (54.8% C) | 53 (47.3% C) | 25 (29.8%) | 135 (45.0%) |
| Filmy w internecie | 62 (59.6%) | 73 (65.2%) | 71 (84.5% AB) | 206 (68.7%) |
| Znajomi z roku | 37 (35.6%) | 56 (50.0% C) | 20 (23.8%) | 113 (37.7%) |
| Poradniki w internecie | 54 (51.9% B) | 39 (34.8%) | 48 (57.1% B) | 141 (47.0%) |
Porównania kolumn dla każdej opcji są poprawne: opcja to osobna zmienna 0/1, a kierunki – rozłączne grupy. Testu chi-kwadrat na całym zestawie nie używaj. Osoba trafia do kilku wierszy, więc statystyka Pearsona nie ma rozkładu chi-kwadrat (Loughin i Scherer, 1998). Tymczasem polecenie CTABLES domyślnie włącza zestawy odpowiedzi do testu chi-kwadrat (IBM Corp., b.d.-a). W tabeli zestawu nie zaznaczaj więc Tests of independence (Chi-square). W tabeli, która ma zestaw obok zwykłych zmiennych, wyłącz go z testu opcją Include multiple response variables in tests, a w składni – INCLUDEMRSETS=NO w podkomendzie SIGTEST. Zamiast tego policz osobny test dla każdej opcji: tu wszystkie pięć opcji różnicuje kierunki, a po korekcie Holma p mieści się między .004 a .035. Inne sposoby porównań opisuje wpis o porównaniu pytań wielokrotnego wyboru między grupami.
Wybór korekty ma znaczenie. Z 15 porównań par w tej tabeli 10 jest istotnych bez korekty, 9 po korekcie Benjaminiego–Hochberga i 8 po korekcie Bonferroniego. Korektę ustal z góry i nazwij w nocie tabeli.
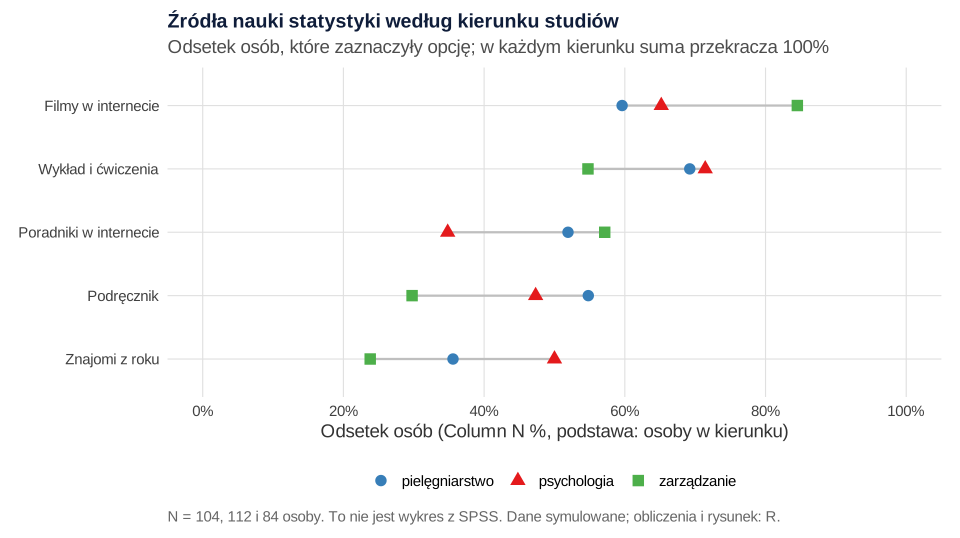
$zrodla. Każdy kierunek sumuje się do ponad 100%, bo osoby zaznaczały kilka opcji. To nie jest wykres z SPSS. Obliczenia i rysunek: R (dane symulowane).Z SPSS do Worda: tabela w stylu APA
Karta Titles dodaje tytuł, podpis i tekst w narożniku (IBM Corp., b.d.-b). W pracy numer i tytuł wstaw jednak w Wordzie poleceniem podpisu, żeby działały odsyłacze (zob. numeracja i podpisy tabel w Wordzie).
Eksport: w oknie wyników File → Export, format Word (*.docx), zakres – wszystkie, widoczne albo zaznaczone obiekty. Tabele trafią do Worda jako edytowalne tabele z formatowaniem SPSS. W Change Options ustawisz, czy szeroką tabelę zawinąć, czy zmniejszyć, i czy dołączyć przypisy (IBM Corp., b.d.-d).
Wyeksportowana tabela to surowiec. Według APA numer tabeli stoi nad tytułem, noty pod tabelą, a linii pionowych się nie stosuje (American Psychological Association, b.d.-b). Z tabeli SPSS zrób więc tabelę APA: połącz liczebność i odsetek w jedną komórkę „n (%)”, przetłumacz nagłówki, zamień „Column N %” na „%”, usuń kolumny, których nie omawiasz, a znaczenie liter przenieś do noty. Wzór ogólny: tabela statystyk opisowych w APA. Wersja do pracy:
| Zmienna | Pielęgniarstwo (n = 104) | Psychologia (n = 112) | Zarządzanie (n = 84) | Ogółem (N = 300) |
|---|---|---|---|---|
| Kobiety, n (%) | 91 (87.5)a | 94 (83.9)a | 48 (57.1)b | 233 (77.7) |
| Studia niestacjonarne, n (%) | 28 (26.9)a | 31 (27.7)a | 43 (51.2)b | 102 (34.0) |
| Lęk przed statystyką, M (SD) | 31.86 (8.07)a | 29.08 (8.10)b | 31.07 (7.60)ab | 30.61 (8.02) |
Nota. Dane fikcyjne. Wartości w wierszu z różnymi indeksami różnią się istotnie (p < .05 po korekcie Bonferroniego; odsetki – test z dla dwóch proporcji, średnie – test t). Lęk przed statystyką: skala 10–50, brak wyniku u 9 osób (n = 102, 108 i 81). Płeć: χ²(2) = 28.73, p < .001; tryb studiów: χ²(2) = 15.38, p < .001.
Czego tabele niestandardowe nie zrobią
- Nie zastąpią analizy. Dokumentacja karty testów wymienia tylko chi-kwadrat oraz porównania par proporcji i średnich (IBM Corp., b.d.-b) – bez wielkości efektu i testu Fishera. Do tego służy Crosstabs i procedury modeli.
- Nie policzą testów dla kategorii obliczanych (IBM Corp., b.d.-b).
- Nie pokażą przedziałów ufności dla zestawów wielokrotnych odpowiedzi (IBM Corp., b.d.-b).
- Nie naprawią braków danych. Kategorie braków zdefiniowanych przez użytkownika są domyślnie ukryte, a odsetki liczone bez nich (IBM Corp., b.d.-b). Braki pokaż osobno (Valid N, Missing); imputację opisuje wpis braki danych i wielokrotna imputacja w SPSS.
Gdy nie masz modułu. Złóż tabelę z kilku procedur: Frequencies (jedna zmienna), Crosstabs z odsetkami kolumn i porównaniami proporcji kolumn w oknie Cells (zob. chi-kwadrat w SPSS), statystyki opisowe w One-Way ANOVA dla średnich w grupach. Pytanie wielokrotnego wyboru policzysz w Analyze → Multiple Response → Crosstabs. Liczby przepisane ręcznie porównaj potem z wydrukami.
Opis tabeli w tekście
Akapit nie powtarza tabeli, tylko wskazuje, co z niej wynika. Wzór:
Zdania do innych analiz przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu poleceń MRSETS i CTABLES (podkomendy TABLE, CATEGORIES, TITLES, SIGTEST i COMPARETEST) w Command Syntax Reference (IBM Corp., b.d.-a, b.d.-c), ale nie uruchamialiśmy jej w SPSS. Wariant w tabelach to klucze literowe w tabeli głównej (STYLE=SIMPLE). Indeksy APA daje STYLE=APA. Podkomendy dotyczą poprzedzającego je /TABLE. Powtórzonej podkomendy nie użyjesz do dwóch rodzajów porównań, bo SPSS łączy powtórzenia i bierze ostatnią wartość, dlatego proporcje i średnie są w osobnych poleceniach.
Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel. Dokumentacja HTML nie podaje wzorów testów z i t, więc użyliśmy standardowych wersji: testu z dla dwóch proporcji z proporcją łączną i testu t z wariancją łączoną ze wszystkich trzech grup, oba z korektą Bonferroniego w obrębie wiersza. Przy wynikach bliskich progu litery w SPSS mogą wyjść inaczej.
1. Składnia SPSS: MRSETS i CTABLES z testami
SPSS
* Składnia zgodna z opisem MRSETS i CTABLES w Command Syntax Reference; nie była uruchamiana w SPSS.
* Krok 1. Zestaw wielokrotnych odpowiedzi (to samo co Data > Define Multiple Response Sets).
MRSETS
  /MDGROUP NAME=$zrodla LABEL='Źródła nauki statystyki'
    CATEGORYLABELS=VARLABELS
    VARIABLES=zr_wyklad zr_podrecznik zr_filmy zr_znajomi zr_poradniki
    VALUE=1
  /DISPLAY NAME=[$zrodla].

* Krok 2. Płeć i tryb (układane) według kierunku: liczebności, odsetki kolumn,
* chi-kwadrat i porównania proporcji kolumn z korektą Bonferroniego (litery w tabeli głównej).
CTABLES
  /TABLE plec [COUNT COLPCT.COUNT] + tryb [COUNT COLPCT.COUNT] BY kierunek
  /CATEGORIES VARIABLES=kierunek TOTAL=YES
  /TITLES TITLE='Płeć i tryb studiów według kierunku'
  /SIGTEST TYPE=CHISQUARE ALPHA=0.05
  /COMPARETEST TYPE=PROP ALPHA=0.05 ADJUST=BONFERRONI MERGE=YES STYLE=SIMPLE.

* Krok 3. Lęk przed statystyką (zmienna Scale) według kierunku: średnia, SD, Valid N
* i porównania średnich kolumn; wariancja ze wszystkich kategorii.
CTABLES
  /TABLE lek [MEAN F5.2 STDDEV F5.2 VALIDN F5.0] BY kierunek
  /CATEGORIES VARIABLES=kierunek TOTAL=YES
  /COMPARETEST TYPE=MEAN ALPHA=0.05 ADJUST=BONFERRONI MEANSVARIANCE=ALLCATS MERGE=YES STYLE=SIMPLE.

* Krok 4. Zestaw $zrodla według kierunku: odsetek osób (COLPCT ma za podstawę respondentów)
* i porównania proporcji kolumn dla każdej opcji; bez testu chi-kwadrat dla zestawu.
CTABLES
  /TABLE $zrodla [COUNT COLPCT.COUNT] BY kierunek
  /CATEGORIES VARIABLES=kierunek TOTAL=YES
  /COMPARETEST TYPE=PROP ALPHA=0.05 ADJUST=BONFERRONI INCLUDEMRSETS=YES MERGE=YES STYLE=SIMPLE.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B539 – tabele niestandardowe w SPSS: liczby do tabel w układzie Custom Tables
# Dane symulowane (fikcyjne), set.seed(539): ankieta wśród 300 osób z trzech kierunków
# (pielęgniarstwo, psychologia, zarządzanie): płeć, tryb studiów, lęk przed statystyką (10–50)
# i pytanie wielokrotnego wyboru o źródła nauki statystyki (5 opcji 0/1).
# Metody: liczebności i odsetki kolumnowe (Column N %), średnia, SD i Valid N,
# chi-kwadrat Pearsona, porównania par kolumn: test z dla dwóch proporcji (proporcja łączna)
# i test t dla dwóch średnich z wariancją łączoną ze wszystkich kolumn, korekta Bonferroniego
# (p razy liczba par w wierszu).
suppressPackageStartupMessages(library(haven))
options(width = 120)
set.seed(539)
n <- 300
kier <- sample(rep(1:3, c(104, 112, 84)))
plec <- 2 - rbinom(n, 1, c(.88, .80, .55)[kier])                 # 1 = kobieta, 2 = mężczyzna
tryb <- rbinom(n, 1, c(.30, .25, .55)[kier]) + 1                 # 1 = stacjonarne, 2 = niestacjonarne
lek <- round(pmin(50, pmax(10, rnorm(n, c(33, 29, 30)[kier], 7.5))))
lek[sample(n, 9)] <- NA                                          # 9 osób bez wyniku skali
pr <- rbind(c(.70, .55, .60, .35, .40),                          # prawdopodobieństwa zaznaczenia opcji
            c(.75, .45, .70, .50, .35),                          # (wiersze: kierunki)
            c(.55, .40, .75, .30, .60))
zr <- t(sapply(kier, function(k) { repeat { x <- rbinom(5, 1, pr[k, ]); if (sum(x) > 0) return(x) } }))
colnames(zr) <- paste0("zr_", c("wyklad", "podrecznik", "filmy", "znajomi", "poradniki"))
dane <- data.frame(id = 1:n, kierunek = kier, plec, tryb, lek, zr)

# Krok 1. Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$kierunek <- labelled(sav$kierunek, c("pielęgniarstwo" = 1, "psychologia" = 2, "zarządzanie" = 3), "Kierunek studiów")
sav$plec <- labelled(sav$plec, c("kobieta" = 1, "mężczyzna" = 2), "Płeć")
sav$tryb <- labelled(sav$tryb, c("stacjonarne" = 1, "niestacjonarne" = 2), "Tryb studiów")
sav$lek <- labelled(sav$lek, label = "Lęk przed statystyką (10–50)")
etyk <- c("Wykład i ćwiczenia", "Podręcznik", "Filmy w internecie", "Znajomi z roku", "Poradniki w internecie")
for (j in seq_along(etyk)) {
  v <- colnames(zr)[j]
  sav[[v]] <- labelled(sav[[v]], c("nie zaznaczono" = 0, "zaznaczono" = 1), etyk[j])
}
write_sav(sav, "tabele-niestandardowe-spss-dane.sav")
write.csv(dane, "tabele-niestandardowe-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

K <- c("pielęgniarstwo", "psychologia", "zarządzanie")
g <- factor(kier, levels = 1:3, labels = K)
klucz <- setNames(LETTERS[1:3], K)
pary <- combn(3, 2)
f1 <- function(x) formatC(x, format = "f", digits = 1)
f2 <- function(x) formatC(x, format = "f", digits = 2)
bz <- function(x, d = 3) sub("^0\\.", ".", formatC(x, format = "f", digits = d))

# Porównania par kolumn dla jednego wiersza: test z dla dwóch proporcji (proporcja łączna),
# p z korektą Bonferroniego; klucz mniejszej kolumny trafia do kolumny o większym odsetku
klucze_prop <- function(x01, gr) {
  k <- tapply(x01, gr, sum); m <- tapply(!is.na(x01), gr, sum); p <- k / m
  out <- setNames(rep("", 3), K); szczeg <- NULL
  for (j in 1:ncol(pary)) {
    a <- pary[1, j]; b <- pary[2, j]
    pp <- (k[a] + k[b]) / (m[a] + m[b])
    z <- (p[a] - p[b]) / sqrt(pp * (1 - pp) * (1 / m[a] + 1 / m[b]))
    padj <- min(1, 2 * pnorm(-abs(z)) * ncol(pary))
    szczeg <- rbind(szczeg, data.frame(para = paste(klucz[a], klucz[b], sep = "–"), z = round(z, 3), p_Bonf = bz(padj, 4)))
    if (padj <= .05) { w <- if (p[a] > p[b]) a else b; mn <- if (w == a) b else a; out[w] <- paste0(out[w], klucz[mn]) }
  }
  list(klucze = out, testy = szczeg)
}

# Krok 2. Tabela 1: płeć i tryb (Count, Column N %), lęk (Mean, Std. Deviation, Valid N)
tab_kat <- function(zm, poziomy, nazwa) {
  cat("\n", nazwa, "\n", sep = "")
  for (i in seq_along(poziomy)) {
    x01 <- as.integer(zm == i)
    kp <- klucze_prop(x01, g)
    cnt <- tapply(x01, g, sum); pct <- 100 * cnt / table(g)
    tot <- sum(x01); tpct <- 100 * tot / n
    cat(sprintf("  %-15s", poziomy[i]),
        sprintf("%4d %5s%% %-3s", cnt, f1(pct), kp$klucze),
        sprintf("| Total %4d %5s%%", tot, f1(tpct)), "\n")
    if (i == 1) print(kp$testy, row.names = FALSE)   # przy dwóch kategoriach drugi wiersz daje te same z
  }
  ch <- suppressWarnings(chisq.test(table(zm, g), correct = FALSE))
  cat(sprintf("  Pearson Chi-Square: %.3f, df = %d, Sig. = %s (p = %.1e), min. oczekiwana = %.1f\n",
              ch$statistic, ch$parameter, bz(ch$p.value), ch$p.value, min(ch$expected)))
}
cat("Liczebności kolumn (N):", table(g), " razem", n, "\n")
tab_kat(plec, c("kobieta", "mężczyzna"), "Płeć")
tab_kat(tryb, c("stacjonarne", "niestacjonarne"), "Tryb studiów")

cat("\nLęk przed statystyką (10–50)\n")
M <- tapply(lek, g, mean, na.rm = TRUE); SD <- tapply(lek, g, sd, na.rm = TRUE)
vn <- tapply(!is.na(lek), g, sum)
print(data.frame(kierunek = K, Mean = f2(M), SD = f2(SD), Valid_N = as.vector(vn),
                 Missing = as.vector(table(g) - vn)), row.names = FALSE)
cat(sprintf("Total: Mean = %s, SD = %s, Valid N = %d\n", f2(mean(lek, na.rm = TRUE)), f2(sd(lek, na.rm = TRUE)), sum(!is.na(lek))))
# test t dla par kolumn z wariancją łączoną ze wszystkich kolumn (jak w ANOVA), Bonferroni
fit <- lm(lek ~ g)
s2 <- summary(fit)$sigma^2; dfe <- fit$df.residual
cat("Wariancja łączona =", f2(s2), " df =", dfe, "\n")
km <- setNames(rep("", 3), K)
for (j in 1:ncol(pary)) {
  a <- pary[1, j]; b <- pary[2, j]
  tt <- (M[a] - M[b]) / sqrt(s2 * (1 / vn[a] + 1 / vn[b]))
  padj <- min(1, 2 * pt(-abs(tt), dfe) * ncol(pary))
  cat(sprintf("  %s–%s: różnica = %s, t(%d) = %.3f, p (Bonferroni) = %s\n",
              klucz[a], klucz[b], f2(M[a] - M[b]), dfe, tt, bz(padj, 4)))
  if (padj <= .05) { w <- if (M[a] > M[b]) a else b; mn <- if (w == a) b else a; km[w] <- paste0(km[w], klucz[mn]) }
}
print(km)
a1 <- anova(fit)
cat(sprintf("Dla porównania ANOVA: F(%d, %d) = %.2f, p = %s; eta2 = %.3f\n",
            a1$Df[1], a1$Df[2], a1$`F value`[1], bz(a1$`Pr(>F)`[1]), a1$`Sum Sq`[1] / sum(a1$`Sum Sq`)))

# Krok 3. Zestaw wielokrotnych odpowiedzi $zrodla (dychotomie, wartość liczona 1)
# Count i Column N % – podstawą odsetka jest liczba osób w kolumnie (każda zaznaczyła co najmniej 1 opcję)
cat("\nŹródła nauki statystyki ($zrodla): Count i Column N %; klucze: test z, Bonferroni\n")
cat("Osoby z co najmniej jedną opcją:", sum(rowSums(zr) > 0), "z", n, "\n")
mr <- NULL
for (j in seq_along(etyk)) {
  x01 <- zr[, j]
  kp <- klucze_prop(x01, g)
  cnt <- tapply(x01, g, sum); pct <- 100 * cnt / table(g)
  mr <- rbind(mr, data.frame(opcja = etyk[j], n_A = cnt[1], pct_A = f1(pct[1]), key_A = kp$klucze[1],
                             n_B = cnt[2], pct_B = f1(pct[2]), key_B = kp$klucze[2],
                             n_C = cnt[3], pct_C = f1(pct[3]), key_C = kp$klucze[3],
                             Total = sum(x01), pct_T = f1(100 * mean(x01))))
}
print(mr, row.names = FALSE)
cat("Suma odsetków kolumny Total:", f1(sum(100 * colMeans(zr))), "% ; średnio opcji na osobę:", f2(mean(rowSums(zr))), "\n")
cat("Odsetek odpowiedzi (od liczby zaznaczeń) dla filmów:", f1(100 * sum(zr[, 3]) / sum(zr)), "%\n")
# Osobny test chi-kwadrat dla każdej opcji (opcja zaznaczona tak/nie × kierunek), p z korektą Holma
pv <- sapply(1:5, function(j) chisq.test(table(zr[, j], g), correct = FALSE)$p.value)
st <- sapply(1:5, function(j) chisq.test(table(zr[, j], g), correct = FALSE)$statistic)
print(data.frame(opcja = etyk, chi2 = round(st, 2), df = 2, p = bz(pv), p_Holm = bz(p.adjust(pv, "holm"))), row.names = FALSE)
# Bonferroni a Benjamini–Hochberg dla 15 porównań par kolumn w tabeli $zrodla
pr_all <- unlist(lapply(1:5, function(j) {
  x01 <- zr[, j]; k <- tapply(x01, g, sum); m <- table(g); p <- k / m
  apply(pary, 2, function(ab) { a <- ab[1]; b <- ab[2]; pp <- (k[a] + k[b]) / (m[a] + m[b])
    2 * pnorm(-abs((p[a] - p[b]) / sqrt(pp * (1 - pp) * (1 / m[a] + 1 / m[b])))) })
}))
cat("Pary istotne bez korekty:", sum(pr_all <= .05), "; Bonferroni w wierszu (×3):", sum(pmin(1, 3 * pr_all) <= .05),
    "; Benjamini–Hochberg w wierszu:", sum(unlist(lapply(split(pr_all, rep(1:5, each = 3)), p.adjust, "BH")) <= .05), "\n")
Wynik:
Liczebności kolumn (N): 104 112 84  razem 300

Płeć
  kobieta           91  87.5% C     94  83.9% C     48  57.1%     | Total  233  77.7%
 para     z p_Bonf
  A–B 0.748 1.0000
  A–C 4.714  .0000
  B–C 4.154  .0001
  mężczyzna       13  12.5%       18  16.1%       36  42.9% AB  | Total   67  22.3%
  Pearson Chi-Square: 28.728, df = 2, Sig. = .000 (p = 5.8e-07), min. oczekiwana = 18.8

Tryb studiów
  stacjonarne       76  73.1% C     81  72.3% C     41  48.8%     | Total  198  66.0%
 para     z p_Bonf
  A–B 0.125 1.0000
  A–C 3.412  .0019
  B–C 3.360  .0023
  niestacjonarne    28  26.9%       31  27.7%       43  51.2% AB  | Total  102  34.0%
  Pearson Chi-Square: 15.378, df = 2, Sig. = .000 (p = 4.6e-04), min. oczekiwana = 28.6

Lęk przed statystyką (10–50)
       kierunek  Mean   SD Valid_N Missing
 pielęgniarstwo 31.86 8.07     102       2
    psychologia 29.08 8.10     108       4
    zarządzanie 31.07 7.60      81       3
Total: Mean = 30.61, SD = 8.02, Valid N = 291
Wariancja łączona = 63.24  df = 288
  A–B: różnica = 2.78, t(288) = 2.531, p (Bonferroni) = .0357
  A–C: różnica = 0.79, t(288) = 0.666, p (Bonferroni) = 1.0000
  B–C: różnica = -1.99, t(288) = -1.703, p (Bonferroni) = .2689
pielęgniarstwo    psychologia    zarządzanie
           "B"             ""             ""
Dla porównania ANOVA: F(2, 288) = 3.39, p = .035; eta2 = 0.023

Źródła nauki statystyki ($zrodla): Count i Column N %; klucze: test z, Bonferroni
Osoby z co najmniej jedną opcją: 300 z 300
                  opcja n_A pct_A key_A n_B pct_B key_B n_C pct_C key_C Total pct_T
     Wykład i ćwiczenia  72  69.2        80  71.4     C  46  54.8         198  66.0
             Podręcznik  57  54.8     C  53  47.3     C  25  29.8         135  45.0
     Filmy w internecie  62  59.6        73  65.2        71  84.5    AB   206  68.7
         Znajomi z roku  37  35.6        56  50.0     C  20  23.8         113  37.7
 Poradniki w internecie  54  51.9     B  39  34.8        48  57.1     B   141  47.0
Suma odsetków kolumny Total: 264.3 % ; średnio opcji na osobę: 2.64
Odsetek odpowiedzi (od liczby zaznaczeń) dla filmów: 26.0 %
                  opcja  chi2 df    p p_Holm
     Wykład i ćwiczenia  6.68  2 .035   .035
             Podręcznik 12.17  2 .002   .007
     Filmy w internecie 14.41  2 .001   .004
         Znajomi z roku 14.32  2 .001   .004
 Poradniki w internecie 11.15  2 .004   .008
Pary istotne bez korekty: 10 ; Bonferroni w wierszu (×3): 8 ; Benjamini–Hochberg w wierszu: 9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Grupy w wierszach. Porównania dotyczą kolumn.
- Row N % zamiast Column N % przy grupach w kolumnach.
- Zestaw odpowiedzi z menu Analyze → Multiple Response i zdziwienie, że nie ma go w Custom Tables.
- Chi-kwadrat na całym zestawie wielokrotnych odpowiedzi.
- Count zamiast Valid N pod średnią przy brakach danych.
- Tabela wklejona jako obraz albo z nagłówkami SPSS („Column N %”, „Sig.”) i „.000” zamiast p < .001.
Najczęstsze pytania
Gdzie w SPSS są tabele niestandardowe i dlaczego nie mam ich w menu?
Procedura jest w Analyze → Tables → Custom Tables. Dokumentacja IBM podaje, że należy do SPSS Statistics Standard Edition albo do opcji Custom Tables, więc w instalacji bez tej opcji pozycji nie będzie. Tę samą treść zbudujesz wtedy z procedur Frequencies, Crosstabs i statystyk opisowych w grupach, a liczby przepiszesz do jednej tabeli Worda.
Co oznaczają litery A, B, C przy odsetkach w tabeli niestandardowej?
Każda kolumna dostaje klucz literowy. Jeśli w komórce kolumny A stoi litera C, odsetek lub średnia w kolumnie A jest istotnie większa niż w kolumnie C, po wybranej korekcie na wielokrotne porównania. Brak litery oznacza, że test nie wykazał różnicy. W wersji z indeksami APA wartości z różnymi indeksami różnią się istotnie.
Dlaczego zestawu pytań wielokrotnego wyboru nie widać w Custom Tables?
Bo prawdopodobnie zdefiniowano go w Analyze → Multiple Response → Define Variable Sets. Taki zestaw działa tylko w procedurach wielokrotnych odpowiedzi. Dla tabel niestandardowych zestaw tworzy się w Data → Define Multiple Response Sets i można go zapisać w pliku .sav.
Czy w tabeli niestandardowej liczyć chi-kwadrat dla pytania wielokrotnego wyboru?
Nie dla całego zestawu. Jedna osoba trafia do kilku wierszy, więc zwykły test Pearsona traci rozkład chi-kwadrat (Loughin i Scherer, 1998). Porównuj kolumny osobno dla każdej opcji, a jeśli chcesz testów chi-kwadrat, licz je dla każdej opcji 0/1 z korektą na liczbę testów.
Jak przenieść tabelę niestandardową z SPSS do Worda w stylu APA?
W oknie wyników wybierz File → Export i format Word (*.docx). Tabela trafi do Worda jako edytowalna tabela. Potem połącz liczebność z odsetkiem, przetłumacz nagłówki, usuń linie pionowe, opisz litery lub indeksy w nocie, a numer i tytuł wstaw poleceniem podpisu w Wordzie.
Powiązane hasła
Przeczytaj też
Chi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →PoradnikTabela 1 – charakterystyka próby
M (SD) czy mediana z kwartylami, n (%), braki w osobnych wierszach, kolumny grup i wartości p w RCT – ze wzorem APA do skopiowania i kodem gtsummary w R.
Czytaj →PoradnikNumeracja i podpisy tabel w Wordzie
Podpisy, numer z rozdziałem, odsyłacze, spis tabel, tabela APA, wyniki ze SPSS i naprawa „Błąd! Nie można odnaleźć źródła odwołania”.
Czytaj →PoradnikPytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →Masz tabele z SPSS i nie wiesz, jak zrobić z nich tabele do pracy?
Sprawdzimy układ tabel, wybór odsetków i testów oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (b.d.-b). Table setup. APA Style. https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- IBM Corp. (b.d.-a). CTABLES. IBM SPSS Statistics 31.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/tables/syn_ctables.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Custom tables. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/custom_tables_container.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Defining Multiple Response Sets. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_idd_mrsets.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). Export output. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_exp_dialog.html ● Otwarty dostęp
- Loughin, T. M., & Scherer, P. N. (1998). Testing for association in contingency tables with multiple column responses. Biometrics, 54(2), 630–637. https://doi.org/10.2307/3109769
Cytowania BibTeX
@misc{apandtablesetup, author={{American Psychological Association}}, title={{Table setup}}, howpublished={APA Style}, year={b.d.-b}, publisher={American Psychological Association}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@misc{ibmndctablessyntax31, author={{IBM Corp.}}, title={{CTABLES}}, howpublished={IBM SPSS Statistics 31.0.0 Command Syntax Reference}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/tables/syn_ctables.html}}@misc{ibmndcustomtables31, author={{IBM Corp.}}, title={{Custom tables}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/custom_tables_container.html}}@misc{ibmnddefinemrsets31, author={{IBM Corp.}}, title={{Defining Multiple Response Sets}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_idd_mrsets.html}}@misc{ibmndexportoutput31, author={{IBM Corp.}}, title={{Export output}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_exp_dialog.html}}@article{loughin1998testing, author={Loughin, Thomas M. and Scherer, Peter N.}, title={{Testing for association in contingency tables with multiple column responses}}, journal={Biometrics}, year={1998}, volume={54}, number={2}, pages={630--637}, doi={10.2307/3109769}}